
Program
Yapay Zeka Uygulamaları Geliştirme
21 sa
Alibaba’nın Qwen araştırma ekibi tarafından geliştirilen (eski adıyla CodeQwen1.5) Qwen2.5-Coder serisi, Açık KodLLM’leri ilerletmeye adanmıştır. Seride, açık kaynak kod modelleri arasında yeni seviye belirleyen ve GPT-4o ile Gemini gibi tescilli devlerle rekabet eden Qwen 2.5-32B-Instruct gibi modeller bulunur.
Bu modeller şu şekilde sunulmaktadır:
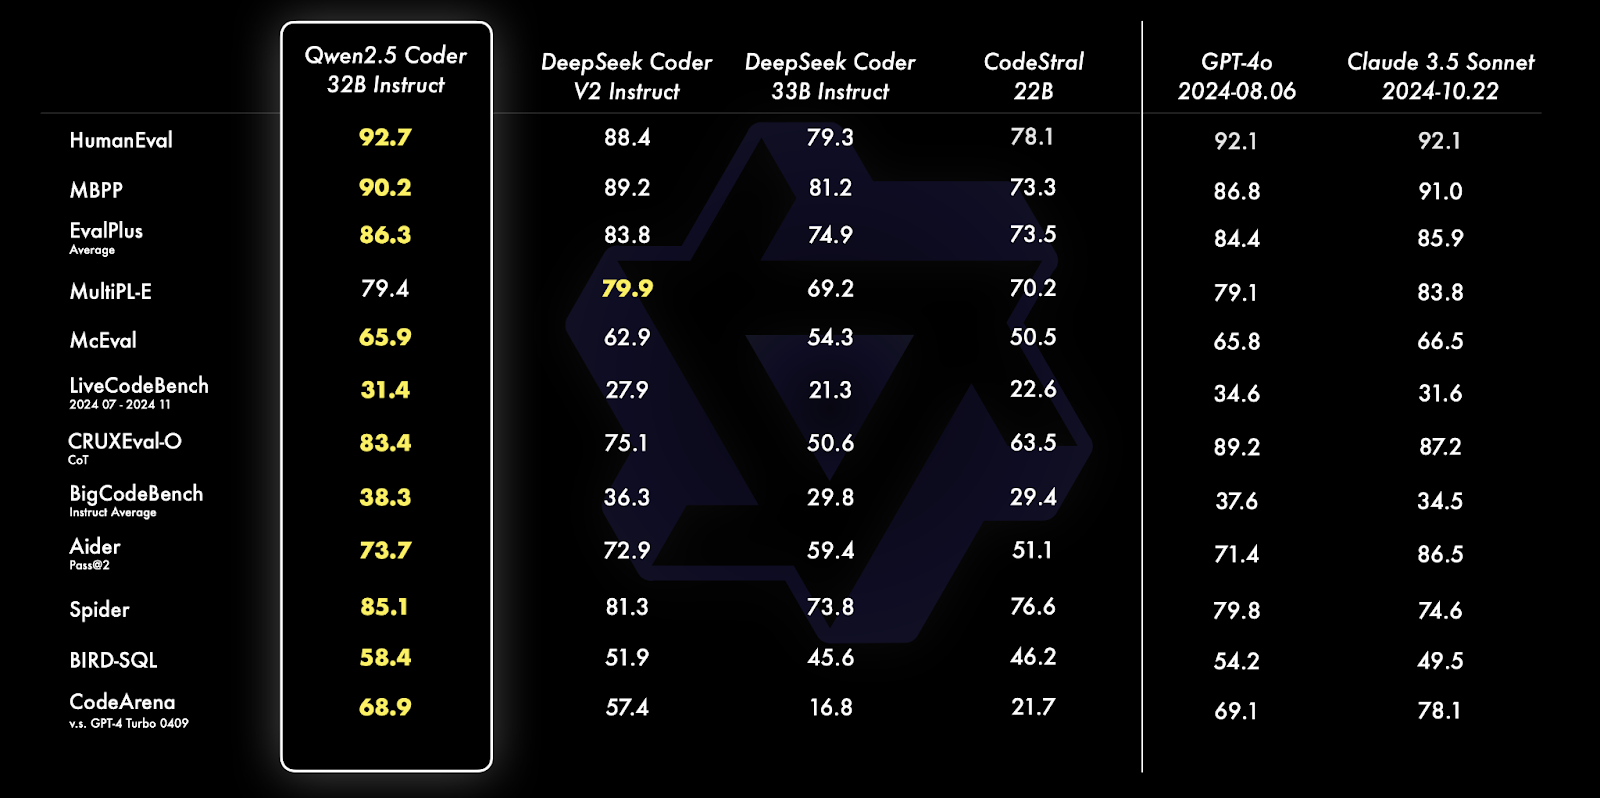
Kaynak: Qwen’in resmi blogu
Qwen 2.5 Coder 32B Instruct; HumanEval, MBPP ve Spider dahil birçok kıyaslamada muadillerini geride bırakarak olağanüstü kodlama ve problem çözme yetenekleri sergiliyor. SQL sorgusu üretimi, kod değerlendirme ve gerçek dünya programlama görevleri gibi çeşitli işlerde mükemmel performans göstererek GPT-4o ve Claude 3.5 Sonnet gibi modelleri geride bırakıyor.
Bu modellerin yetenekleri ve karşılaştırmaları hakkında daha fazla bilgi edinmek için Qwen2.5-Coder Serisi duyuru makalesini okuyun.
Bu bölümde, Gradio kullanarak kod inceleme asistanımızın kod uygulamasına dalacağız.
Gerekli önkoşulları kurmakla başlayacak, ardından modeli optimize edilmiş yapılandırmalarla başlatacağız.
Sonraki adımda, modelin instruct yeteneklerini kullanarak çekirdek işlevleri tanımlayacak ve bu bileşenleri kullanıcı dostu bir Gradio arayüzüne entegre ederek asistanla kolay etkileşim sağlayacağız.
Uygulamaya geçmeden önce, aşağıdaki araç ve kütüphanelerin yüklü olduğundan emin olalım:
Gerekli bağımlılıkları yüklemek için aşağıdaki komutları çalıştırın:
!pip install torch transformers gradio bitsandbytes -qYukarıdaki bağımlılıklar yüklendikten sonra aşağıdaki import komutlarını çalıştırın:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
Not: Google Colab’da Qwen2.5-Coder-32B-Instruct modelini çalıştırmak, yüksek RAM’li bir A100 GPU gerektirir. Kaynaklar sınırlıysa, 0.5B, 3B, 7B veya 14B gibi daha düşük parametreli modelleri kullanmayı düşünün.
Hugging Face Transformers kütüphanesi büyük modellerin yüklenmesini kolaylaştırır. Qwen2.5-Coder-32B-Instruct modelini HuggingFace’ten quantization ile başlatarak daha iyi performans elde edeceğiz:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
Yukarıdaki kod parçacığı, Qwen2.5-Coder-32B-Instruct modelini 8 bit quantization ile yüklememizi sağlar; bu da sınırlı kaynaklı cihazlarda verimli çalıştırma için bellek kullanımını azaltır.
Bu yapılandırma, quantization’ı etkinleştirmek için BitsAndBytesConfig kullanır, desteklenen GPU’larda optimize hesaplama için torch.float16’yı tercih eder ve donanımı otomatik tahsis etmek için device_map="auto" değerini ayarlar. HuggingFace’in transformers kütüphanesinden alınan tokenizer, metin işlemesini kolaylaştırır ve gerekirse bir pad_token_id atar. Bu kurulum, büyük modelleri tüketici sınıfı donanımlarda verimli şekilde çalıştırmayı kolaylaştırır.
Modeli ve tokenizer’ı yükledikten sonra, apply_chat_template yöntemini kullanarak modelden yanıt üreten bir işlev kuruyoruz.
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
Yukarıdaki işlev, Qwen2.5-Coder-32B-Instruct modeliyle bağlamsal yanıtlar üretmek için yardımcı bir araç görevi görür. Girdi olarak ("system" ve "user" gibi) roller içeren sohbet benzeri bir mesaj listesi alır ve şu adımları uygular:
apply_chat_template işleviyle mesajları biçimlendirir ve modelin sohbet tabanlı anlayışı için hazırlar.max_new_tokens=200; Bu parametre yanıt uzunluğunu 200 token ile sınırlar.temperature=0.7; Yanıttaki rastgeleliği kontrol ederek yaratıcılık ile tutarlılık arasında denge kurar.repetition_penalty=1.2; Çıktıda tekrarlayan ifadeleri caydırır.4. Son işleme: Bu adım, kesme işlemiyle oluşturulan çıktının giriş istemini kaldırır ve batch_decode işlevini kullanarak yanıtı insan tarafından okunabilir bir dizeye dönüştürür. İşlev, hazırlama, üretme ve kod çözme karmaşıklığını soyutlayarak hata ayıklama, kod analizi ve uygulanabilir geri bildirim üretme gibi çeşitli görevlerde tekrar kullanılabilir hâle getirir.
Sırada, uygulamamızın çekirdek özellikleri olan kod analizörü, kod iyileştirici ve kodlama standartları denetleyicisi için kodu kuruyoruz. Bir instruct modeli kullandığımız için, "system" ve "user" gibi rolleri kullanabilir ve bunları yanıta dönüştürmek üzere modelin istemine dahil edebiliriz.
İşte uygulamamızın üç çekirdek özelliği: sorun tespitçisi, kod kalitesi uzmanı ve kodlama standartları uzmanı.
Bu asistan, verilen koddaki sözdizimi hatalarını, mantıksal hataları ve olası güvenlik açıklarını belirler. Model için özel talimatlar şunlardır:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
Yukarıdaki kod; roller ve içerik barındıran mesajlardan ve modelin yardımsever bir kodlama asistanı gibi davranmasını sağlayan bir başlangıç isteminden oluşur. Bu mesaj daha sonra uygun bir yanıt döndürmesi için generate_response işlevine iletilir.
Bu asistan, kodun okunabilirliğini, verimliliğini ve sürdürülebilirliğini artırmaya yardımcı olur; optimizasyonlar ve kod kalitesi üzerine öneriler üretir.
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)Bu asistan, verilen kodun ideal kodlama standartlarını takip edip etmediğini denetler ve buna göre öneriler sunar.
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
Yukarıdaki işlev, modeli bir kodlama standartları uzmanı gibi davranmaya yönlendirir; PEP 8 uyumu, doğru fonksiyon adlandırma, sağlam hata yönetimi ve daha fazlası gibi ilkelere uygunluğu değerlendirir.
Gradio, asistanın dağıtımını basitleştirir ve kullanıcıların kod girişi yapıp sonuçları etkileşimli olarak görmesine imkân tanır. Önceki bölümlerdeki model yanıtları, sorunsuz biçimde bir Gradio arayüzüne entegre edilir.
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
review_code işlevi üç bileşeni entegre eder: analyze_code_issues, suggest_code_improvements ve check_coding_standards. Bu işlevler, sözdizimi hatalarını, bug’ları, optimizasyonları ve kodlama standartlarına uyumu belirler. Gradio arayüzü, kullanıcı girdisini bir metin kutusu üzerinden alır ve sonuçları üç metin alanı olarak döndürür. Geliştiricilerin kodlarını analiz edip iyileştirmesi için kullanımı kolay bir web arayüzü sağlar. Bu son hücreyi çalıştırdığımızda, aşağıda gösterilene benzer çalışan bir Gradio uygulaması arayüzü elde ederiz.
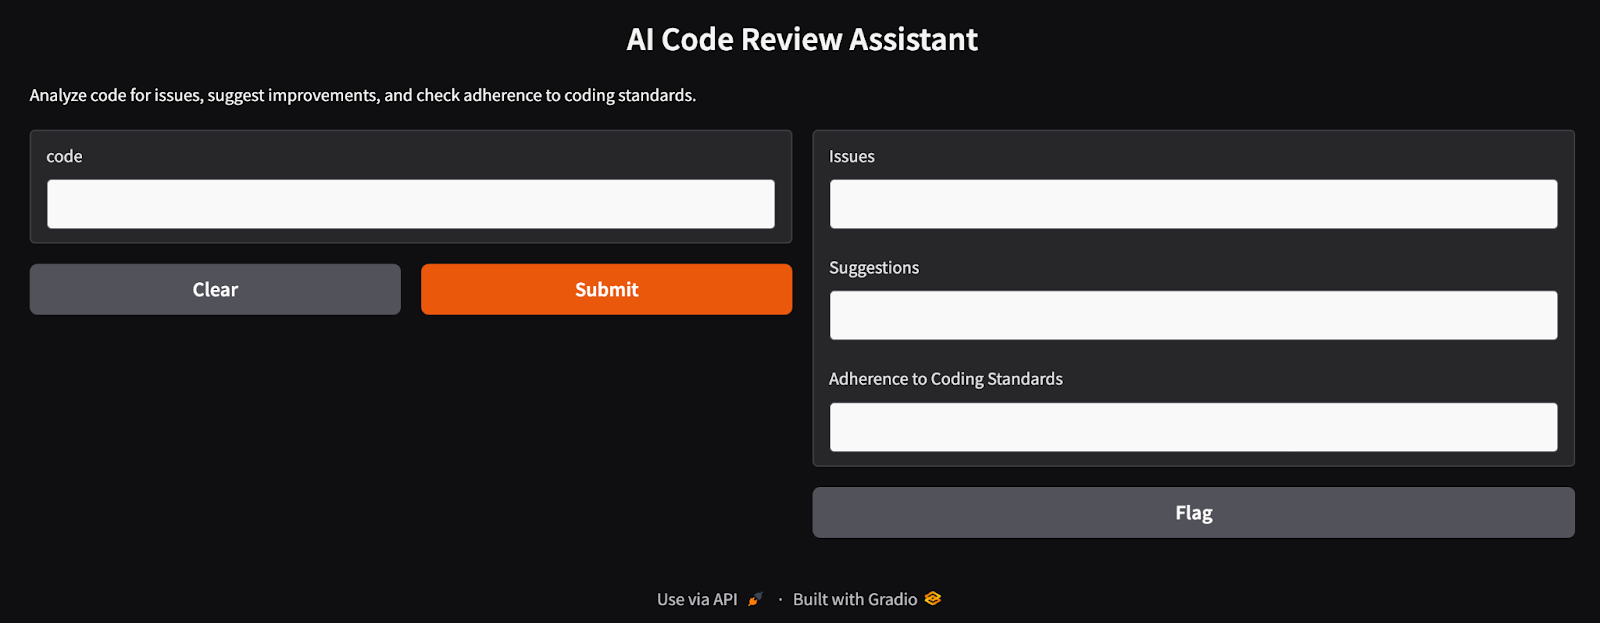
Gradio kullanılarak oluşturulan yapay zeka kod inceleme asistanı arayüzü
Bir kullanıcı Gradio uygulamasını çalıştırmak istemezse, aşağıdaki kodu çalıştırarak asistanı test edebilir. İşte asistanın hatalı bir Python fonksiyonunu nasıl analiz ettiğine dair bir örnek:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
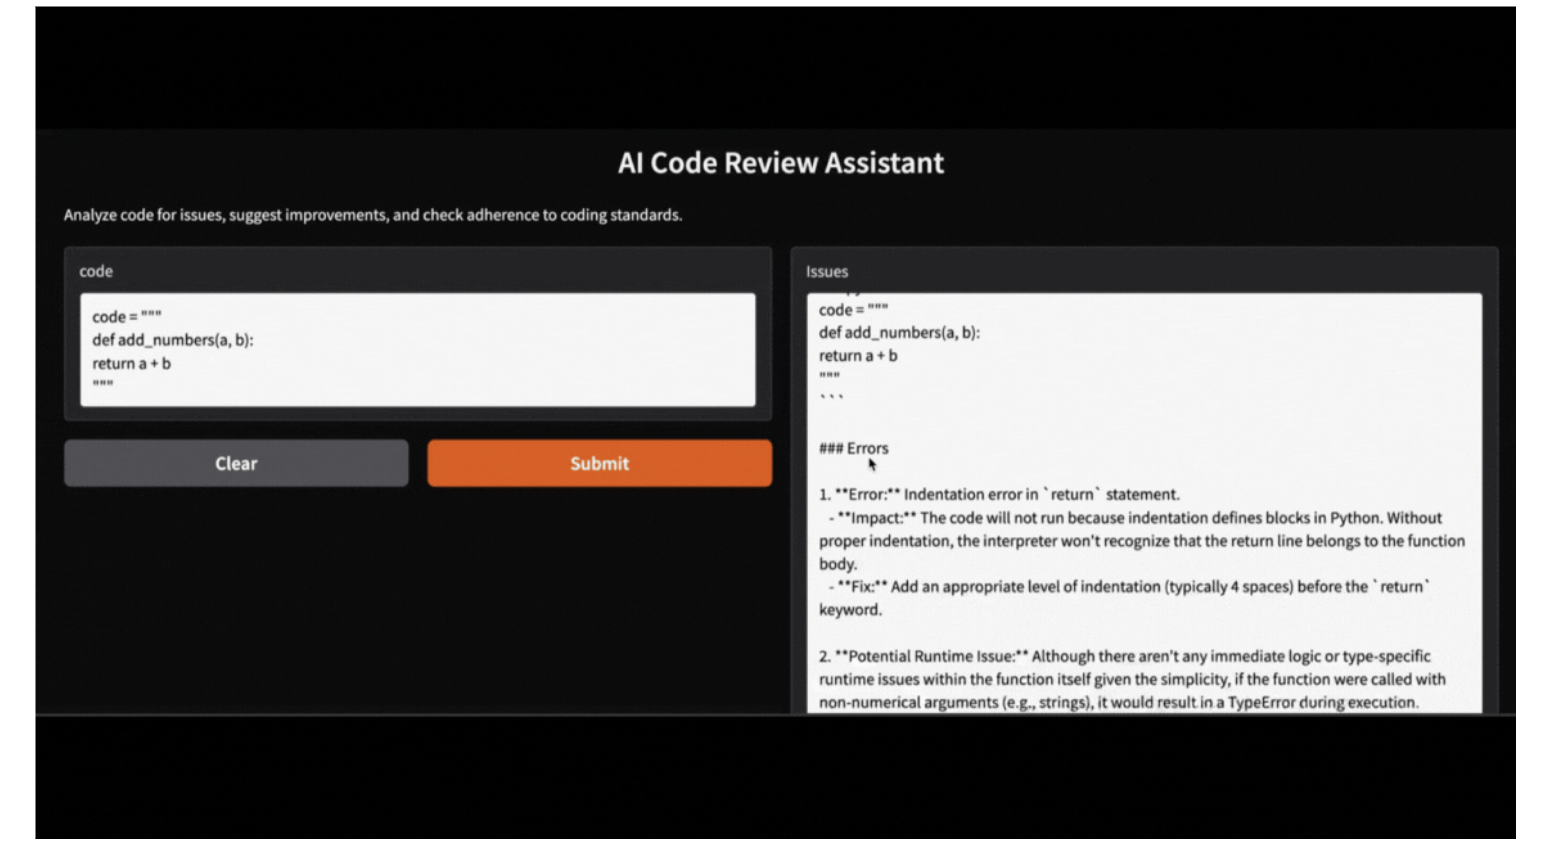
Bu Gradio uygulaması, Ollama üzerinden erişilebilen Qwen-2.5 modelini kullanarak yerel olarak da çalıştırılabilir. Yalnızca HF kütüphanesi modelini yerel Ollama kütüphane modeliyle değiştirin; uygulamanız sorunsuz şekilde çalışacaktır.
Bu yazıda, Qwen 2.5-Coder-32B-Instruct modelini Gradio ile birleştirerek bir yapay zeka kod inceleme asistanı oluşturmayı öğrendik. Bu araç, sözdizimi hatalarını analiz eder, optimizasyonlar önerir ve kodlama standartlarını uygular; böylece yazılım geliştirme sürecini düzenler.
Artık Qwen 2.5’i nasıl kuracağınızı bildiğinize göre, kendi projenizi oluşturmaya davet ediyorum!
Bu kurslarla yapay zekayı öğrenin!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




