
Programma
Sviluppare applicazioni AI
21 ore
La serie Qwen2.5-Coder (precedentemente nota come CodeQwen1.5), sviluppata dal team di ricerca Qwen di Alibaba, è dedicata all’avanzamento degli Open CodeLLM. La serie include modelli come Qwen 2.5-32B-Instruct, diventato lo stato dell’arte tra i modelli di codice open source, in grado di rivaleggiare con giganti proprietari come GPT-4o e Gemini.
Questi modelli vengono presentati come:
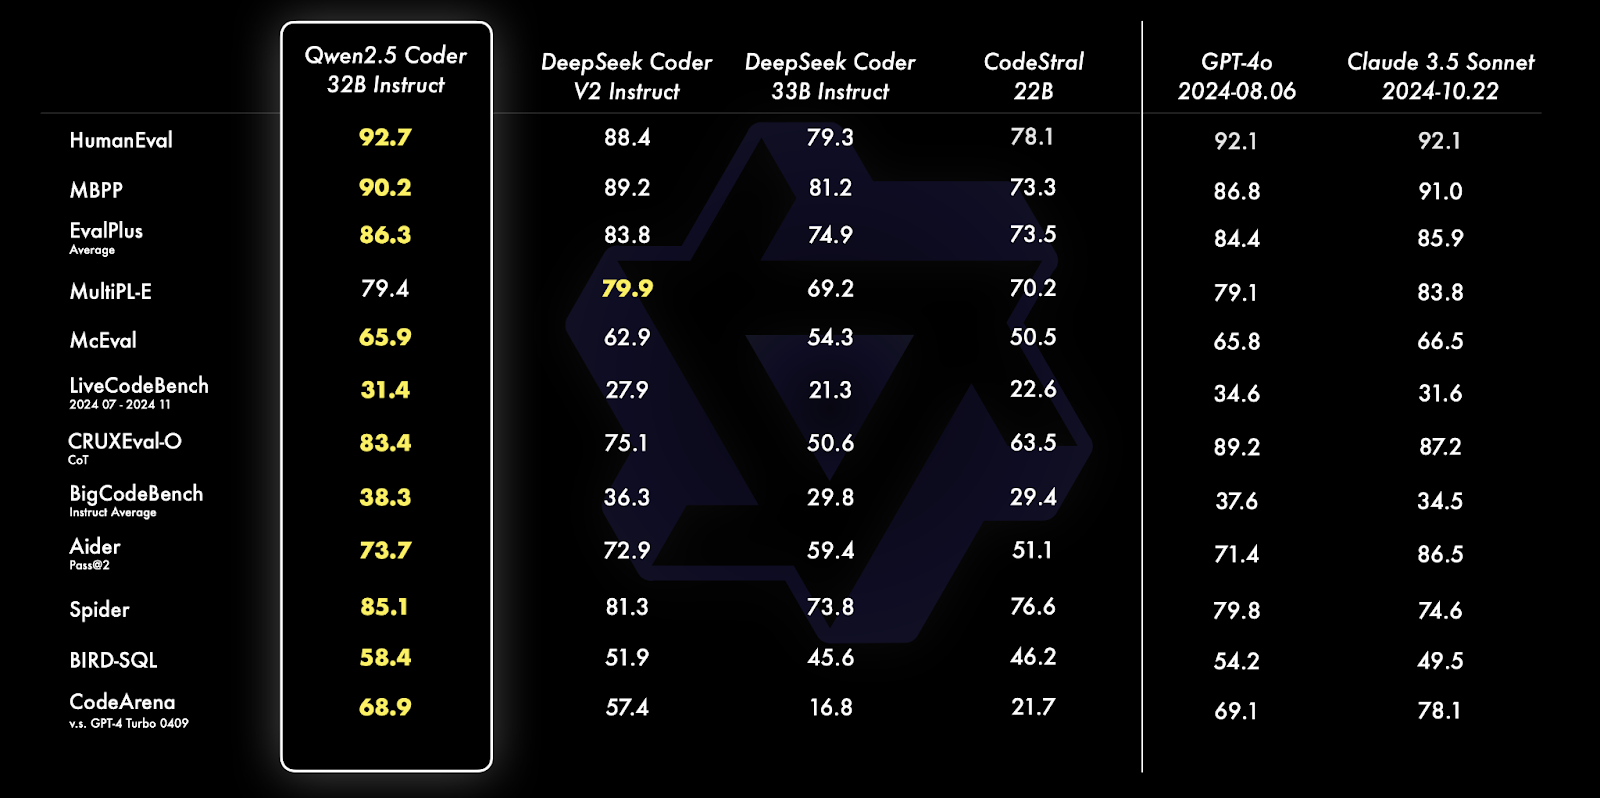
Fonte: blog ufficiale di Qwen
Qwen 2.5 Coder 32B Instruct supera i suoi omologhi in diversi benchmark, tra cui HumanEval, MBPP e Spider, dimostrando eccezionali capacità di coding e problem solving. Eccelle in attività diverse come la generazione di query SQL, la valutazione del codice e sfide di programmazione reali, superando modelli come GPT-4o e Claude 3.5 Sonnet.
Per approfondire funzionalità e confronti di questi modelli, leggi l’articolo di annuncio della serie Qwen2.5-Coder.
In questa sezione entreremo nel dettaglio dell’implementazione del nostro assistente di code review con Gradio.
Partiremo predisponendo i prerequisiti necessari, per poi inizializzare il modello con configurazioni ottimizzate.
Successivamente definiremo le funzionalità principali, sfruttando le capacità instruct del modello e integrando infine questi componenti in un’interfaccia Gradio intuitiva, per interagire facilmente con l’assistente.
Prima di entrare nell’implementazione, assicuriamoci di avere installati i seguenti strumenti e librerie:
Esegui i seguenti comandi per installare le dipendenze necessarie:
!pip install torch transformers gradio bitsandbytes -qUna volta installate le dipendenze, esegui i seguenti import:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
Nota: l’esecuzione del modello Qwen2.5-Coder-32B-Instruct su Google Colab richiede una GPU A100 con RAM elevata. Se le risorse sono limitate, valuta l’uso di modelli con meno parametri come 0.5B, 3B, 7B o 14B.
La libreria Transformers di Hugging Face semplifica il caricamento di modelli di grandi dimensioni. Iniziamo caricando il modello Qwen2.5-Coder-32B-Instruct da HuggingFace con quantizzazione per migliorare le prestazioni:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
Il codice sopra ci permette di caricare il modello Qwen2.5-Coder-32B-Instruct con quantizzazione a 8 bit, riducendo l’uso di memoria per un’esecuzione efficiente su dispositivi con risorse limitate.
Usa BitsAndBytesConfig per abilitare la quantizzazione, torch.float16 per ottimizzare il calcolo su GPU supportate e device_map="auto" per l’allocazione automatica dell’hardware. Il tokenizer della libreria transformers di HuggingFace garantisce un’elaborazione del testo semplice, assegnando un pad_token_id se non è già impostato. Questa configurazione rende più facile eseguire modelli di grandi dimensioni su hardware consumer in modo efficiente.
Una volta caricati modello e tokenizer, impostiamo una funzione per generare una risposta dal modello usando il metodo apply_chat_template.
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
La funzione sopra funge da utilità per interagire con il modello Qwen2.5-Coder-32B-Instruct per generare risposte contestuali. Prende in input un elenco di messaggi in stile chat (con ruoli come “system” e “user”) e svolge i seguenti passaggi:
apply_chat_template, preparandoli alla comprensione basata sulla chat del modello.max_new_tokens=200; limita la lunghezza della risposta a 200 token.temperature=0.7; aiuta a controllare la casualità nella risposta, bilanciando creatività e coerenza.repetition_penalty=1.2; scoraggia frasi ripetitive nell’output.4. Post-processing: rimuove il prompt di input dall’output generato tramite slicing e decodifica la risposta in una stringa leggibile con batch_decode. La funzione astrae la complessità di preparazione, generazione e decodifica delle risposte, rendendola riutilizzabile per vari compiti come debug, analisi del codice e generazione di feedback attuabili.
Ora impostiamo il codice per le funzionalità principali dell’applicazione: analizzatore del codice, miglioratore del codice e verificatore degli standard di codifica. Poiché stiamo usando un modello instruct, possiamo utilizzare ruoli come “system” e “user” e passarli al modello nel prompt per generare una risposta.
Ecco le tre funzionalità core della nostra app: rilevatore di problemi, esperto di qualità del codice ed esperto di standard di codifica.
Questo assistente individua errori di sintassi, bug logici e potenziali vulnerabilità nel codice fornito. Le istruzioni specifiche per il modello sono:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
Il codice sopra è composto da messaggi che contengono ruoli e contenuto insieme a un prompt iniziale affinché il modello si comporti come un assistente di programmazione utile. Questo messaggio viene poi passato alla funzione generate_response per ottenere una risposta adeguata.
Questo assistente aiuta a migliorare leggibilità, efficienza e manutenibilità del codice, generando suggerimenti su ottimizzazioni e qualità del codice.
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)Questo assistente verifica se il codice fornito segue standard di codifica ideali e fornisce suggerimenti di conseguenza.
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
La funzione sopra abilita il modello ad agire come esperto di standard di codifica, valutando il codice fornito rispetto a linee guida come conformità a PEP 8, corretta denominazione delle funzioni, gestione robusta degli errori e altro.
Gradio semplifica il deployment dell’assistente, consentendo agli utenti di inserire codice e vedere i risultati in modo interattivo. Le risposte del modello dalle sezioni precedenti vengono integrate senza soluzione di continuità in un’interfaccia Gradio.
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
La funzione review_code integra tre componenti: analyze_code_issues, suggest_code_improvements e check_coding_standards. Queste funzioni identificano errori di sintassi, bug, ottimizzazioni e aderenza agli standard di codifica. L’interfaccia Gradio riceve l’input dell’utente tramite una casella di testo e restituisce i risultati come tre campi di testo. Offre un’interfaccia web facile da usare per sviluppatori che vogliono analizzare e migliorare il proprio codice. Una volta eseguita questa cella finale, otterrai un’interfaccia Gradio in esecuzione come quella mostrata sotto.
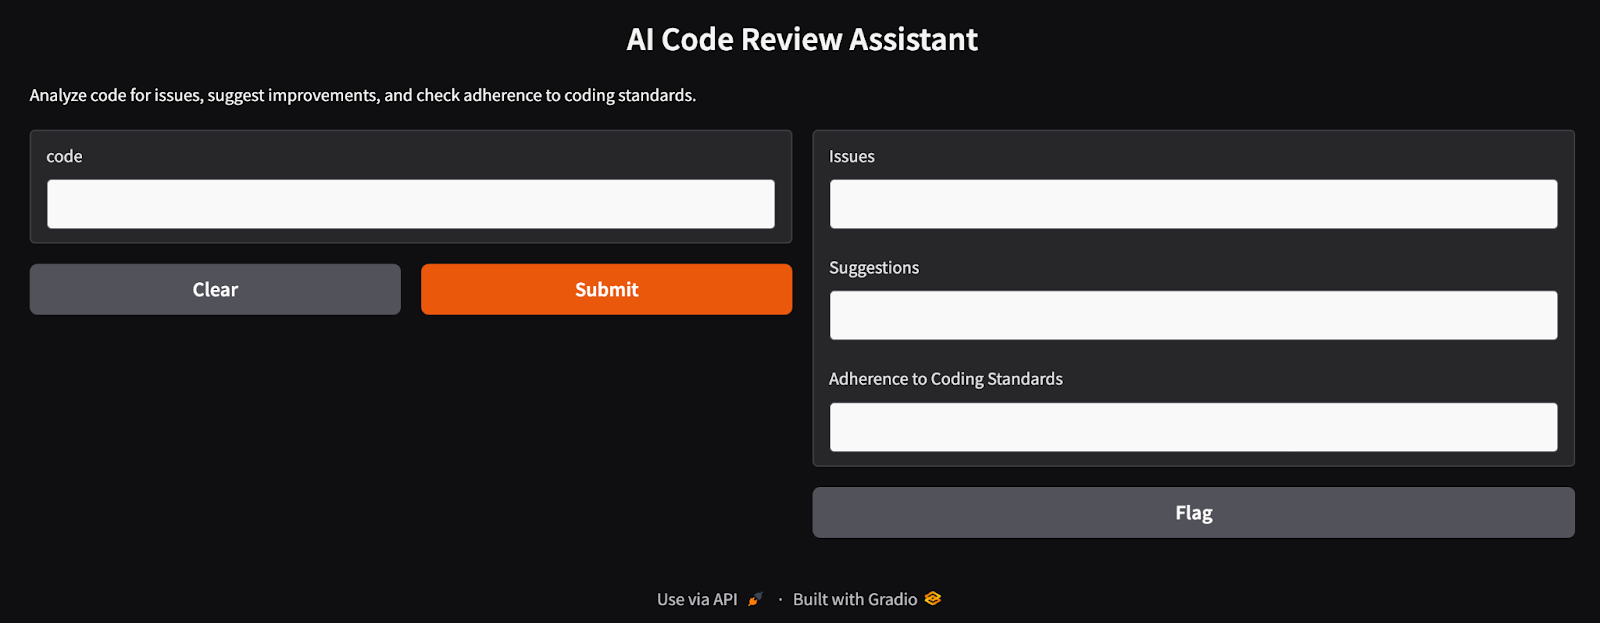
L’interfaccia dell’assistente AI per il code review creata con Gradio
Se un utente non vuole eseguire un’app Gradio, può testare l’assistente eseguendo il seguente codice. Ecco un esempio di come l’assistente analizza una funzione Python con bug:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
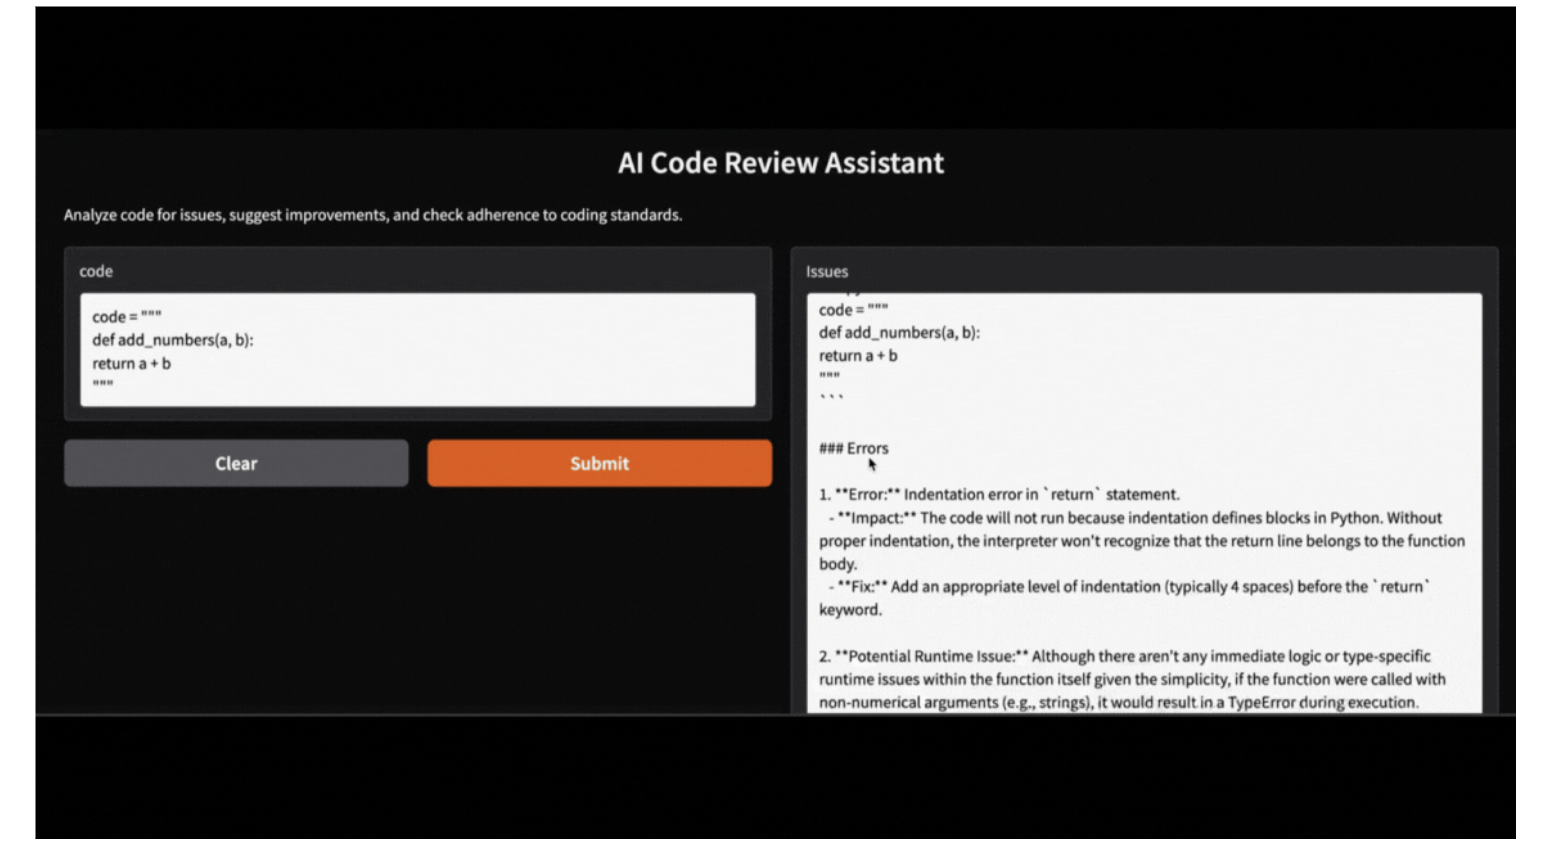
Questa app Gradio può essere eseguita anche in locale con il codice fornito, utilizzando il modello Qwen-2.5 accessibile tramite Ollama. Ti basta sostituire il modello della libreria HF con il modello locale della libreria Ollama e la tua app sarà operativa senza intoppi.
In questo articolo abbiamo visto come usare Qwen 2.5-Coder-32B-Instruct in combinazione con Gradio per creare un assistente AI per il code review. Questo strumento analizza il codice alla ricerca di errori di sintassi, suggerisce ottimizzazioni e fa rispettare gli standard di codifica, semplificando il processo di sviluppo software.
Ora che sai come configurare Qwen 2.5, ti invito a creare il tuo progetto!
Impara l'AI con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



