
Leerpad
AI-toepassingen ontwikkelen
21 uur
De Qwen2.5-Coder-serie (voorheen bekend als CodeQwen1.5), ontwikkeld door Alibaba’s Qwen-onderzoeksteam, is gericht op de ontwikkeling van Open CodeLLM’s. De serie bevat modellen zoals de Qwen 2.5-32B-Instruct, die is uitgegroeid tot het toonaangevende open-source codemodel en kan wedijveren met propriëtaire giganten als GPT-4o en Gemini.
Deze modellen worden gepresenteerd als:
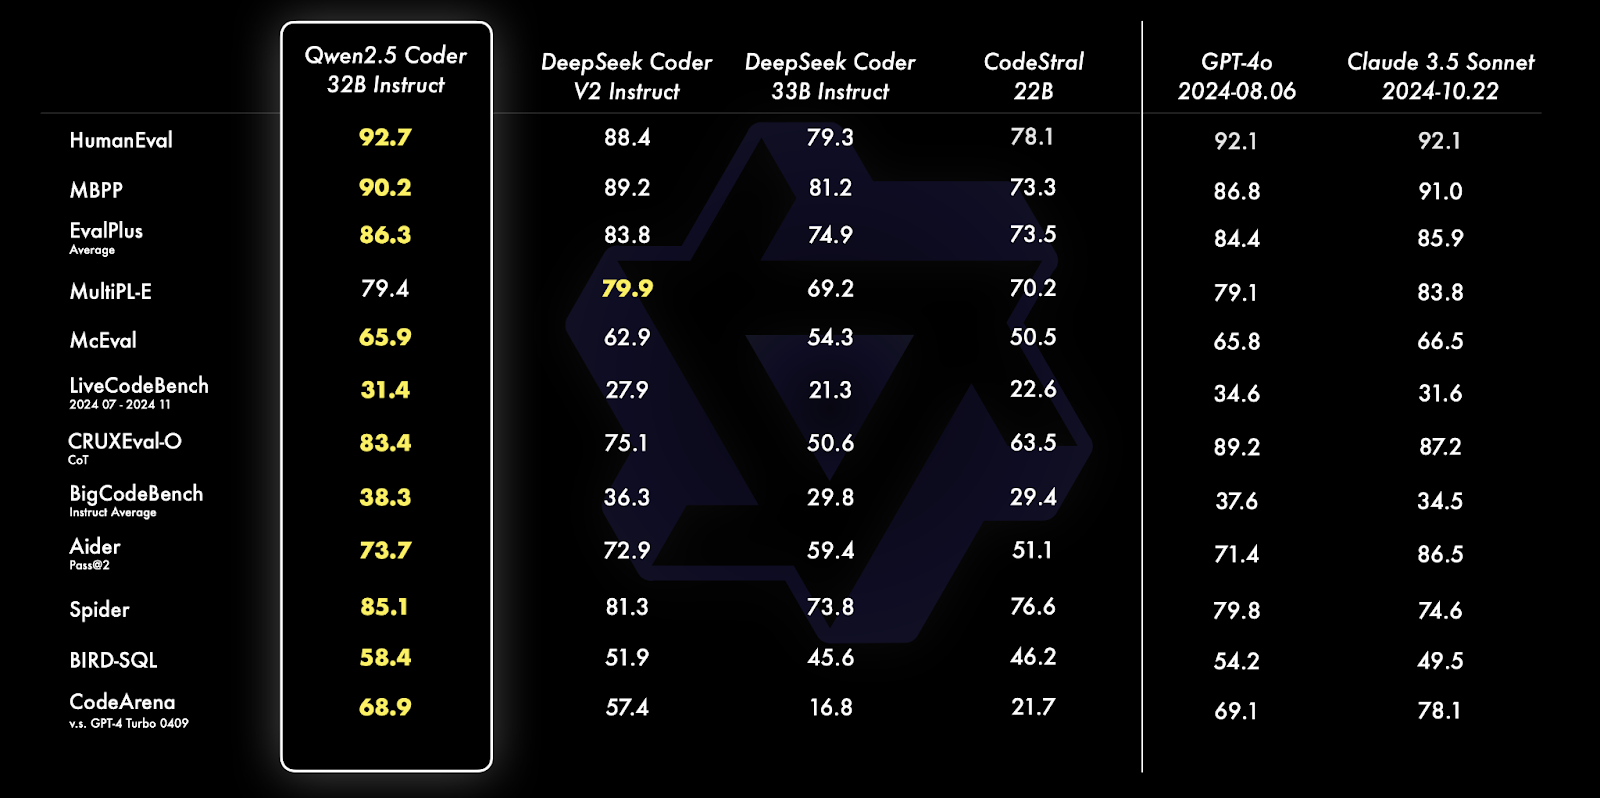
Bron: Qwen’s officiële blog
Qwen 2.5 Coder 32B Instruct presteert beter dan zijn tegenhangers op meerdere benchmarks, waaronder HumanEval, MBPP en Spider, en toont uitzonderlijke codeer- en probleemoplossende vaardigheden. Het blinkt uit in uiteenlopende taken zoals het genereren van SQL-queries, code-evaluatie en programmeeruitdagingen uit de praktijk, en overtreft modellen zoals GPT-4o en Claude 3.5 Sonnet.
Wil je meer weten over de mogelijkheden en vergelijkingen van deze modellen? Lees dan het aankondigingsartikel over de Qwen2.5-Coder-serie.
In dit onderdeel duiken we in de code-implementatie van onze codereview-assistent met Gradio.
We beginnen met het instellen van de vereiste randvoorwaarden, gevolgd door het initialiseren van het model met geoptimaliseerde configuraties.
Vervolgens definiëren we kernfunctionaliteiten met de instructiemogelijkheden van het model en integreren we deze componenten tot slot in een gebruiksvriendelijke Gradio-interface, zodat je eenvoudig met de assistent kunt samenwerken.
Voordat we met de implementatie beginnen, zorgen we ervoor dat we de volgende tools en libraries hebben geïnstalleerd:
Voer de volgende commando’s uit om de benodigde dependencies te installeren:
!pip install torch transformers gradio bitsandbytes -qZodra bovenstaande dependencies zijn geïnstalleerd, voer je de volgende import-commando’s uit:
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
import torch
Import gradio as gr
Let op: Het draaien van het Qwen2.5-Coder-32B-Instruct-model op Google Colab vereist een A100-GPU met veel RAM. Als resources beperkt zijn, overweeg dan modellen met lagere parameters zoals 0,5B, 3B, 7B of 14B.
De Hugging Face Transformers-library maakt het laden van grote modellen eenvoudig. We beginnen met het initialiseren van het Qwen2.5-Coder-32B-Instruct-model van HuggingFace met quantization voor betere prestaties:
# Define quantization configuration for optimized performance
bnb_config = BitsAndBytesConfig(load_in_8bit=True)
# Load the model and tokenizer
model_name = "Qwen/Qwen2.5-Coder-32B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=bnb_config
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = tokenizer.eos_token_id
Met bovenstaande code laden we het Qwen2.5-Coder-32B-Instruct-model met 8-bit quantization, waardoor het geheugenverbruik afneemt en uitvoering op apparaten met beperkte resources efficiënter wordt.
Het gebruikt BitsAndBytesConfig om quantization in te schakelen, torch.float16 voor geoptimaliseerde berekeningen op ondersteunde GPU’s en device_map="auto" voor automatische toewijzing aan hardware. De tokenizer uit HuggingFace’s transformers-library zorgt voor eenvoudige tekstverwerking en kent een pad_token_id toe als die nog niet is ingesteld. Met deze configuratie kun je grote modellen efficiënt draaien op hardware voor consumenten.
Zodra we het model en de tokenizer hebben geladen, stellen we een functie in om een reactie van het model te genereren met de methode apply_chat_template.
def generate_response(messages):
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        **model_inputs,
        max_new_tokens=200,
        temperature=0.7,
        repetition_penalty=1.2
    )
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0].strip()
    return response
De bovenstaande functie is een hulpprogramma om met het Qwen2.5-Coder-32B-Instruct-model te communiceren voor het genereren van contextbewuste reacties. Hij accepteert een lijst met chatachtige berichten (met rollen zoals “system” en “user”) als invoer en voert de volgende stappen uit:
apply_chat_template en bereidt ze voor op de chatgebaseerde interpretatie van het model.max_new_tokens=200; Deze parameter beperkt de lengte van de reactie tot 200 tokens.temperature=0.7; Hiermee regel je de willekeur in de reactie, zodat creativiteit en consistentie in balans blijven.repetition_penalty=1.2; Deze parameter ontmoedigt herhalende zinnen in de output.4. Naverwerking: Deze stap verwijdert de invoerprompt uit de gegenereerde output door te slicen en decodeert de reactie naar een voor mensen leesbare string met de functie batch_decode. De functie abstraheert de complexiteit van voorbereiden, genereren en decoderen, waardoor hij herbruikbaar is voor diverse taken zoals debuggen, code-analyse en het genereren van bruikbare feedback.
Vervolgens stellen we de code in voor de kernfuncties van onze app: de code-analyzer, codeverbetering en checker voor codestandaarden. Omdat we een instructiemodel gebruiken, kunnen we rollen zoals “system” en “user” gebruiken en ze in de prompt aan het model doorgeven om een reactie te genereren.
Dit zijn de drie kernfuncties van onze app: probleemdetector, expert in codekwaliteit en expert in codestandaarden.
Deze assistent identificeert syntaxfouten, logische bugs en potentiële kwetsbaarheden in de aangeleverde code. De specifieke instructies voor het model zijn:
def analyze_code_issues(code):
    messages = [
        {"role": "system", "content": "You are Qwen, a helpful coding assistant. Your job is to analyze and debug code."},
        {"role": "user", "content": f"""Review this code:
    {code}
    List all syntax errors, logical bugs, and potential runtime issues. Format as:
    - Error/Bug: [description]
    - Impact: [potential consequences]
    - Fix: [suggested solution]"""}
        ]
    return generate_response(messages)
De bovenstaande code bestaat uit berichten met rollen en inhoud, inclusief een initiële prompt voor het model om zich als behulpzame codeerassistent te gedragen. Dit bericht wordt vervolgens doorgegeven aan de functie generate_response om een passende reactie te krijgen.
Deze assistent helpt de leesbaarheid, efficiëntie en onderhoudbaarheid van de code te verbeteren door suggesties te genereren voor optimalisaties en codekwaliteit.
def suggest_code_improvements(code):
    messages = [
        {"role": "system", "content": "You are Qwen, an expert in code optimization. Help improve code quality."},
        {"role": "user", "content": f"""Review this code:
    {code}
    Provide specific optimization suggestions:
    1. Performance improvements
    2. Better variable names
    3. Simpler logic
    4. Memory efficiency
    Include code examples where relevant."""}
    ]
return generate_response(messages)Deze assistent controleert of de aangeleverde code voldoet aan ideale codestandaarden en geeft waar nodig suggesties.
messages = [
        {"role": "system", "content": "You are Qwen, a coding standards expert. Your task is to evaluate code adherence to best practices."},
        {"role": "user", "content": f"""Evaluate this code:
    {code}
    Check against these standards:
    1. PEP 8 compliance
    2. Function/variable naming
    3. Documentation completeness
    4. Error handling
    5. Code organization
    List violations with specific examples and corrections."""}
        ]
    return generate_response(messages)
De bovenstaande functie stelt het model in staat om als expert in codestandaarden op te treden en de aangeleverde code te beoordelen op naleving van richtlijnen zoals PEP 8-conformiteit, correcte functienamen, robuuste foutafhandeling en meer.
Gradio vereenvoudigt het uitrollen van de assistent, zodat gebruikers code kunnen invoeren en resultaten interactief kunnen bekijken. De modelreacties uit de vorige secties zijn naadloos geïntegreerd in een Gradio-interface.
def review_code(code):
    issues = analyze_code_issues(code)
    improvements = suggest_code_improvements(code)
    standards = check_coding_standards(code)
    return issues, improvements, standards
interface = gr.Interface(
    fn=review_code,
    inputs="textbox",
    outputs=["text", "text", "text"],
    title="AI Code Review Assistant",
    description="Analyze code for issues, suggest improvements, and check adherence to coding standards."
)
interface.launch(debug=True)
De functie review_code integreert drie componenten: analyze_code_issues, suggest_code_improvements en check_coding_standards. Deze functies identificeren syntaxfouten, bugs, optimalisaties en naleving van codestandaarden. De Gradio-interface neemt gebruikersinvoer aan via een tekstvak en geeft de resultaten weer als drie tekstvelden. Het biedt een gebruiksvriendelijke webinterface voor developers om hun code te analyseren en te verbeteren. Zodra we deze laatste cel draaien, krijgen we een draaiende Gradio-appinterface zoals hieronder weergegeven.
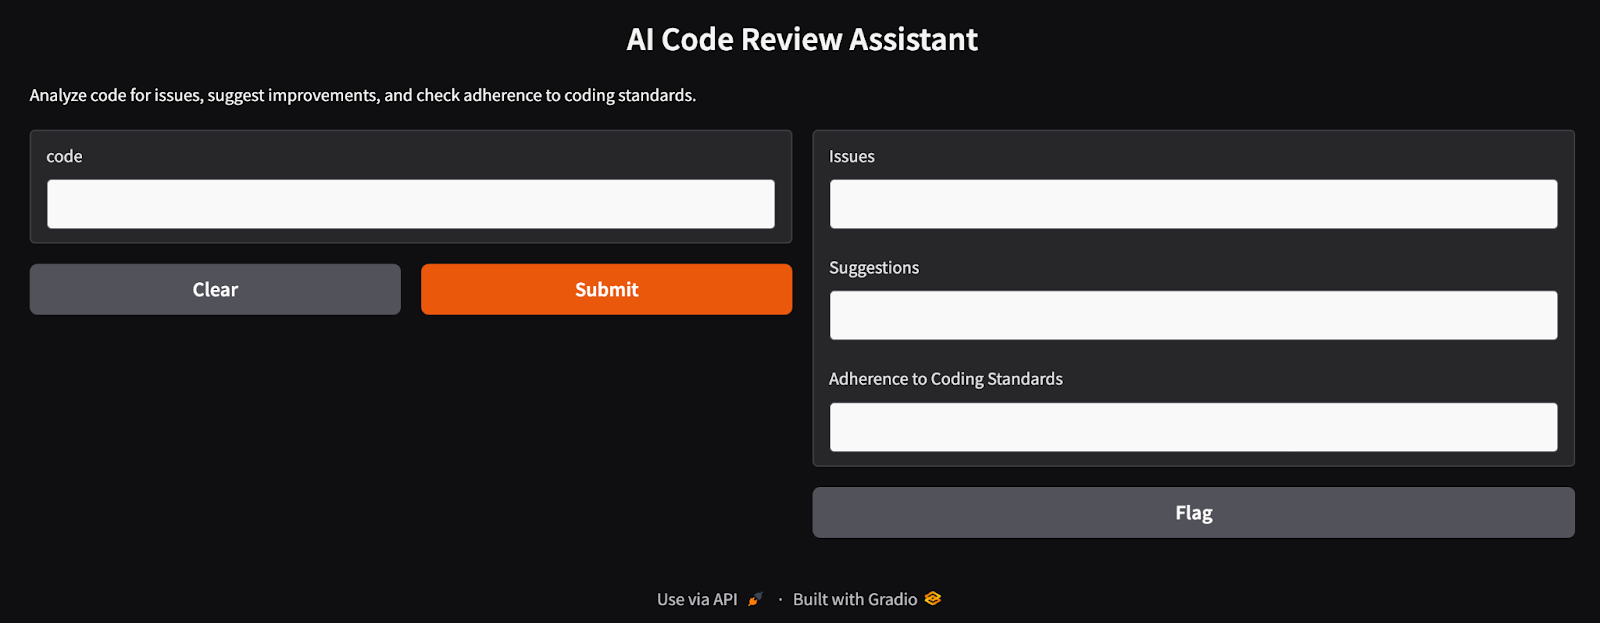
De AI-codereview-assistentinterface gebouwd met Gradio
Als een gebruiker geen Gradio-app wil draaien, kan die de assistent testen door de volgende code uit te voeren. Hier is een voorbeeld van hoe de assistent een buggy Python-functie analyseert:
code = """
def add_numbers(a, b):
return a + b
"""
issues, suggestions, standards = review_code(code)
print("Issues:", issues)
print("Suggestions:", suggestions)
print("Adherence to coding standards:", standards)
Issues:
Here's the review of your provided Python code:
```python
.
.
- **Fix:** Implement input validation or use exception handling to manage unexpected data types gracefully.
Suggestions:
Certainly! Let's review the provided function and suggest optimizations based on your criteria:
1. **Proper Indentation**
.
.
2. **Better Variable Names**
In this simple case, `a` and `b` could be considered generic enough as they represent arbitrary operands. However, more descriptive names can help when functions become complex.
Adherence to coding standards:
Certainly! Let's go through the provided Python function `add_numbers` according to the specified standards.
.
.
2. **Function/Variable Naming**
- The names `add_numbers`, `a`, and `b` follow good conventions for simplicity and clarity in their context (function name clearly indicates addition; variable names indicate they're operands). However, if you want more descriptive variable names (especially useful in larger functions), consider using something like `operand_one` or `num1`.
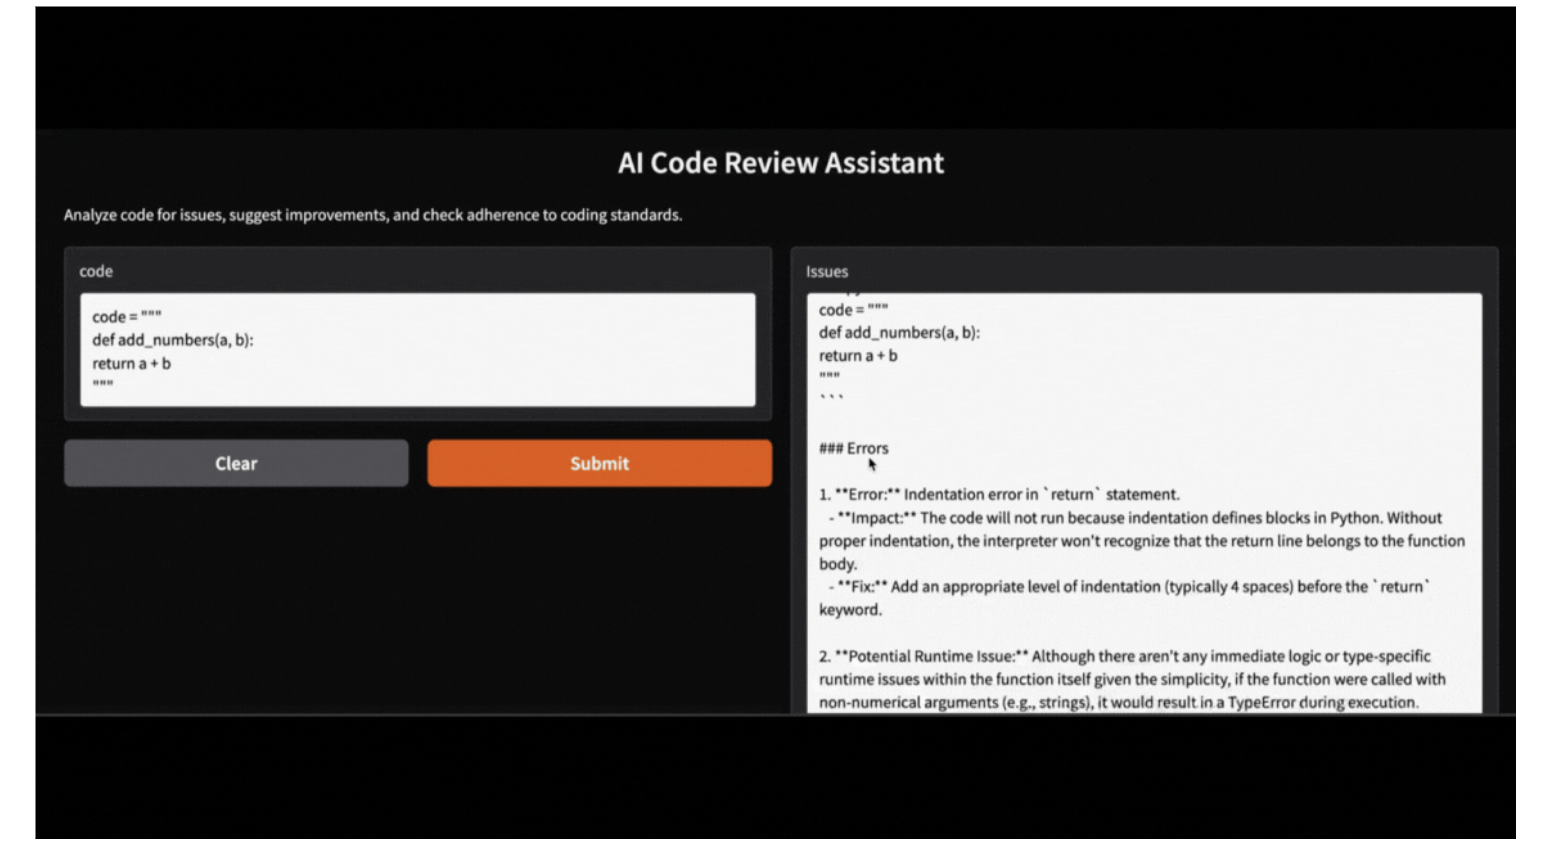
Deze Gradio-app kan ook lokaal worden uitgevoerd met de meegeleverde code, met gebruik van het Qwen-2.5-model dat beschikbaar is via Ollama. Vervang eenvoudig het HF-librarymodel door het lokale Ollama-librarymodel en je app draait naadloos.
In dit artikel leerden we hoe je Qwen 2.5-Coder-32B-Instruct in combinatie met Gradio kunt gebruiken om een AI-codereview-assistent te bouwen. Deze tool analyseert code op syntaxfouten, doet optimalisatievoorstellen en handhaaft codestandaarden, wat het softwareontwikkelproces stroomlijnt.
Nu je weet hoe je Qwen 2.5 instelt, daag ik je uit om je eigen project te bouwen!
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

