{count, plural, one {Kursus} other {Kursus}}
Pengantar R
{hours} jam
3.1M
Ikuti Ramnath Vaidyanathan di Twitter. Analisis ini awalnya dipublikasikan di Google Colab.
Kevin Systrom menerbitkan sebuah artikel yang sangat menarik tentang mengestimasi $R_t$, ukuran yang dikenal sebagai angka reproduksi efektif. Dalam artikelnya, Kevin menggambarkan angka ini sebagai:
Jumlah orang yang menjadi terinfeksi per satu orang infeksius pada waktu 𝑡
Kevin berbaik hati mempublikasikan kodenya sebagai notebook di github. Saya ingin melakukan lebih banyak dengan modelnya, dan juga menerapkannya ke negara lain. Namun, karena saya jauh lebih mahir dalam R, saya ingin terlebih dahulu mereplikasi hasilnya di R.
Sebelum Anda membaca sisa tulisan ini, saya sangat menyarankan Anda membaca artikel aslinya untuk memahami lebih rinci pendekatan pemodelan yang digunakan, karena tulisan ini lebih berfokus pada kode.
Seluruh kredit untuk pendekatan pemodelan dan kode diberikan kepada Kevin 👍. Notebook ini adalah upaya sederhana saya untuk menerjemahkan modelnya ke dalam R. Setiap kesalahan yang tersisa sepenuhnya menjadi tanggung jawab saya.
Kita akan menggunakan pendekatan yang sama seperti yang diuraikan Kevin dalam artikelnya, yang menggunakan makalah oleh Bettencourt & Ribeiro sebagai dasar utamanya.
Langkah pertama adalah memodelkan proses 'kedatangan' infeksi. Pilihan populer untuk distribusi kedatangan di kalangan ahli statistika adalah Distribusi Poisson. Sesuai hal tersebut, jika kita biarkan $\lambda$ merepresentasikan laju rata-rata infeksi per hari, maka probabilitas bahwa kita akan melihat $k$ kasus baru pada suatu hari diberikan oleh
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Dengan pengaturan ini, kita dapat membangun distribusi probabilitas kasus baru untuk sekumpulan $\lambda$. Sebelum mulai menulis kode, kita perlu memuat paket-paket tidyverse, dan menyesuaikan beberapa opsi plotting (ukuran plot, menggambarnya, dan sebagainya). Anda boleh melewati bagian ini, karena tidak kritis terhadap alur, tetapi pastikan untuk mengeksekusi kodenya.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Kita dapat menggunakan fungsi crossing dari purrr untuk menghitung densitas probabilitas di berbagai kombinasi $k$ dan $\lambda$. Ini adalah pendekatan yang elegan, meski kurang optimal secara komputasi, karena kita belum benar-benar memanfaatkan kemampuan vektorisasi dari dpois. Anda akan melihat pendekatan yang lebih efisien secara komputasi di bagian selanjutnya.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Kita dapat memvisualisasikan probabilitas ini menggunakan ggplot2. Perhatikan bagaimana kita memanfaatkan expression untuk merender simbol matematika pada plot. Anda dapat membaca lebih lanjut di dokumentasi plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
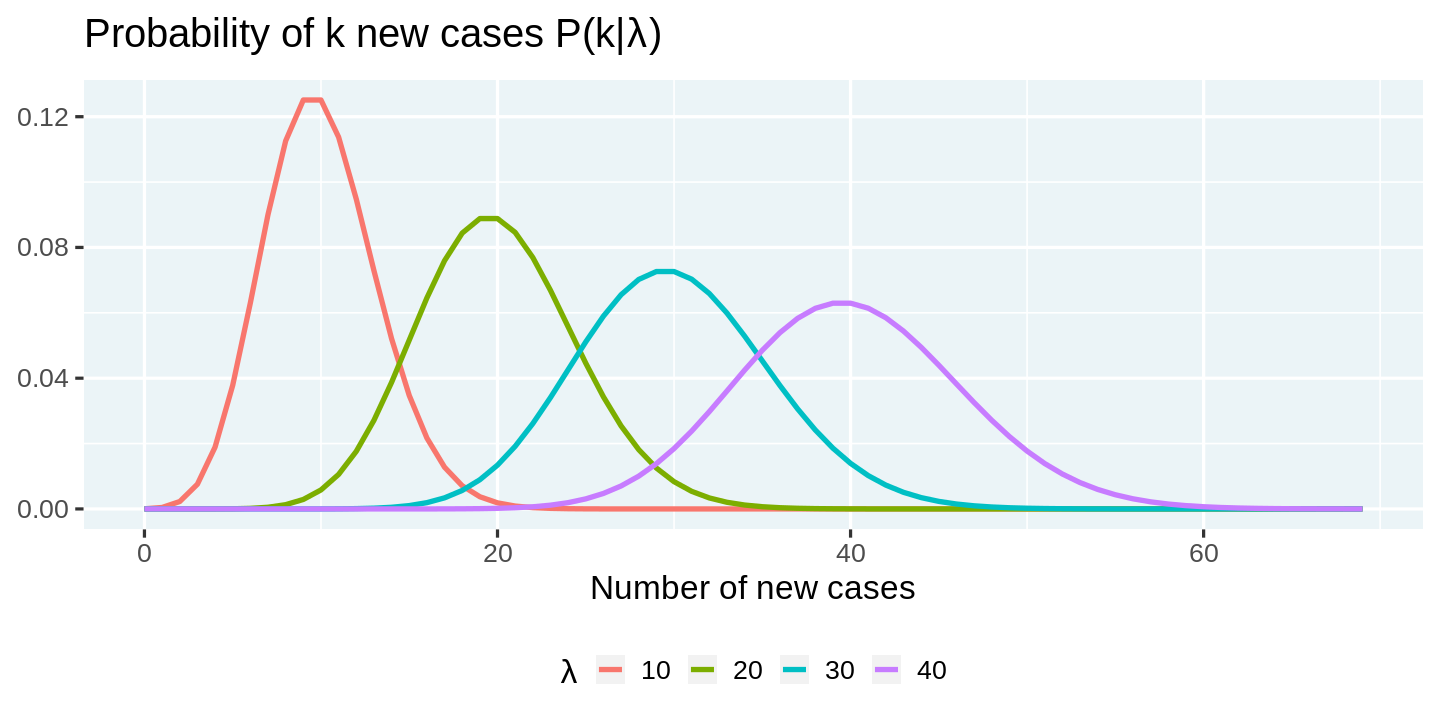
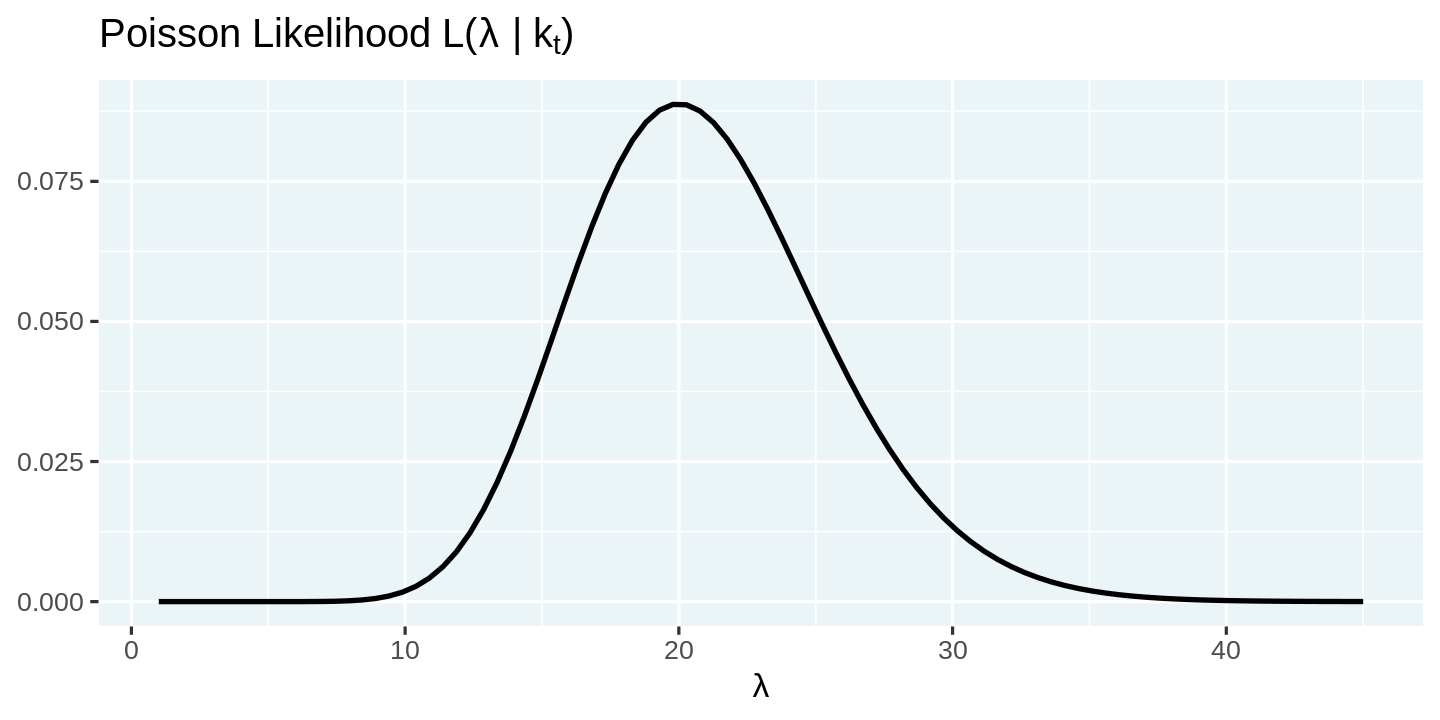
Pemodelan proses kedatangan sebagai distribusi Poisson memungkinkan kita memprediksi distribusi kasus baru dalam sehari sebagai fungsi dari laju kedatangan $\lambda$. Namun, pada kenyataannya, kita hanya mengamati jumlah kedatangan. Jadi pertanyaan kuncinya sekarang adalah bagaimana kita berangkat dari jumlah kedatangan yang diamati untuk memahami distribusi $\lambda$. Untungnya, jawabannya sederhana.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Distribusi $\lambda$ terhadap k disebut fungsi likelihood, dan memiliki ekspresi matematis yang sama dengan fungsi massa probabilitas yang kita gunakan sebelumnya. Kita dapat memvisualisasikan fungsi likelihood dengan menetapkan jumlah kasus baru yang diamati (k), dan menghitung fungsi likelihood pada berbagai nilai $\lambda$.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Semua ini bagus, namun Anda mungkin bertanya-tanya di mana laju infeksi efektif, $R_t$, yang kita bicarakan di awal. Bagaimana hubungannya dengan laju kedatangan $\lambda$. Menurut makalah Bettencourt & Ribeiro, hubungannya cukup sederhana
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Perhatikan bahwa $\gamma$ di sini adalah kebalikan dari interval serial (sekitar 4 hari untuk COVID-19), dan $k_{t-1}$ adalah jumlah kasus baru yang diamati pada interval waktu $t-1$.
Kita dapat menggunakan ekspresi untuk $\lambda$ ini dan merumuskan ulang fungsi likelihood dalam istilah $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Sebelum lanjut, mari tetapkan beberapa parameter inti.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
Kode di bawah ini menunjukkan cara yang lebih efisien secara komputasi untuk menghitung likelihood. Alih-alih menghasilkan lambda dan likelihood untuk setiap kombinasi secara terpisah, kita memanfaatkan sifat tervektor dari fungsi-fungsi di R, dan kemampuan untuk memiliki dataframe bertingkat. Ini memungkinkan kita menghasilkan vektor lambda dan likelihood untuk setiap hari, lalu menggunakan tidyr::unnest untuk membentangkannya menjadi tabel datar.
Selain efisiensi komputasi, saya berpendapat kode ini lebih mudah dibaca dan menerjemahkan rumus matematika dengan overhead minimal.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Sekarang kita dapat memplot likelihood bersyarat pada jumlah kasus baru yang diamati.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
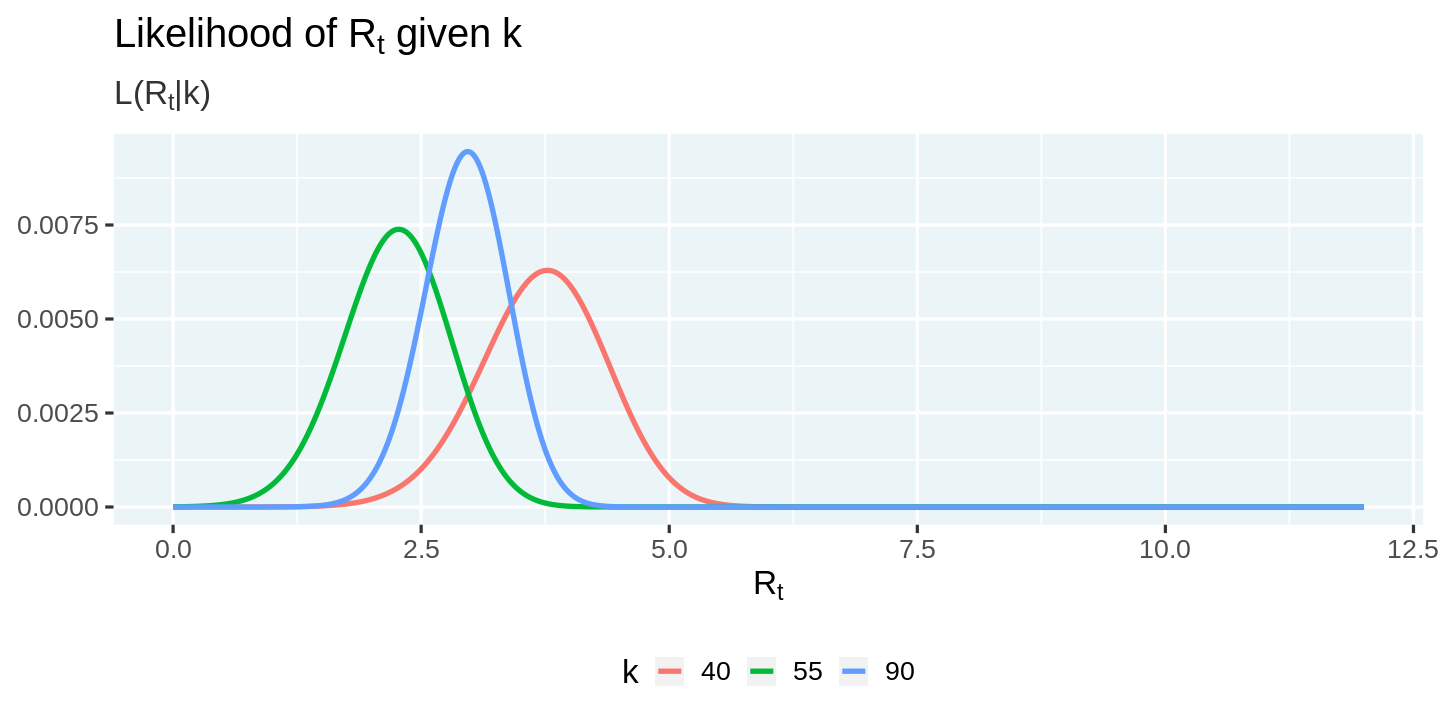
Kita telah membuat kemajuan yang baik dalam menghubungkan jumlah kasus baru, $k$, dan laju infeksi efektif, $R_t$. Namun, kita masih belum memiliki pendekatan nyata untuk mengestimasi nilainya dari deret waktu kasus baru yang diamati. Di sinilah aturan Bayes yang sangat terkenal menjadi sangat berguna. Bettencourt & Ribeiro mengekspresikan distribusi probabilitas $R_t$ sebagai
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin mengurai persamaan kompleks ini dalam istilah yang jauh lebih sederhana.
Ini menyatakan bahwa, setelah melihat 𝑘 kasus baru, kita meyakini distribusi 𝑅𝑡 sama dengan:
- prior keyakinan akan nilai $P(R_t)$ tanpa data ...
- dikalikan dengan likelihood melihat $k$ kasus baru mengingat $R_t$ ...
- dibagi dengan probabilitas melihat sebanyak ini secara umum.
Jika kita menggunakan probabilitas posterior periode sebelumnya, $P(R_{t-1} | k_{t-1})$, sebagai prior, $P(R_t)$, untuk periode saat ini, maka kita dapat menulis ulang persamaan sebelumnya sebagai:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Dengan mengiterasi ke belakang hingga $t = 0$, kita peroleh
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Dengan prior seragam $P(R_0)$, ini menjadi:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Sekarang kita dapat menggunakan ekspresi matematis ini untuk menghitung posterior dari likelihood. Sekali lagi, kita menggunakan fungsi tervektor cumprod untuk menghasilkan posterior untuk semua hari sekaligus, lalu menormalkannya.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Kini kita dapat memvisualisasikan distribusi posterior.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
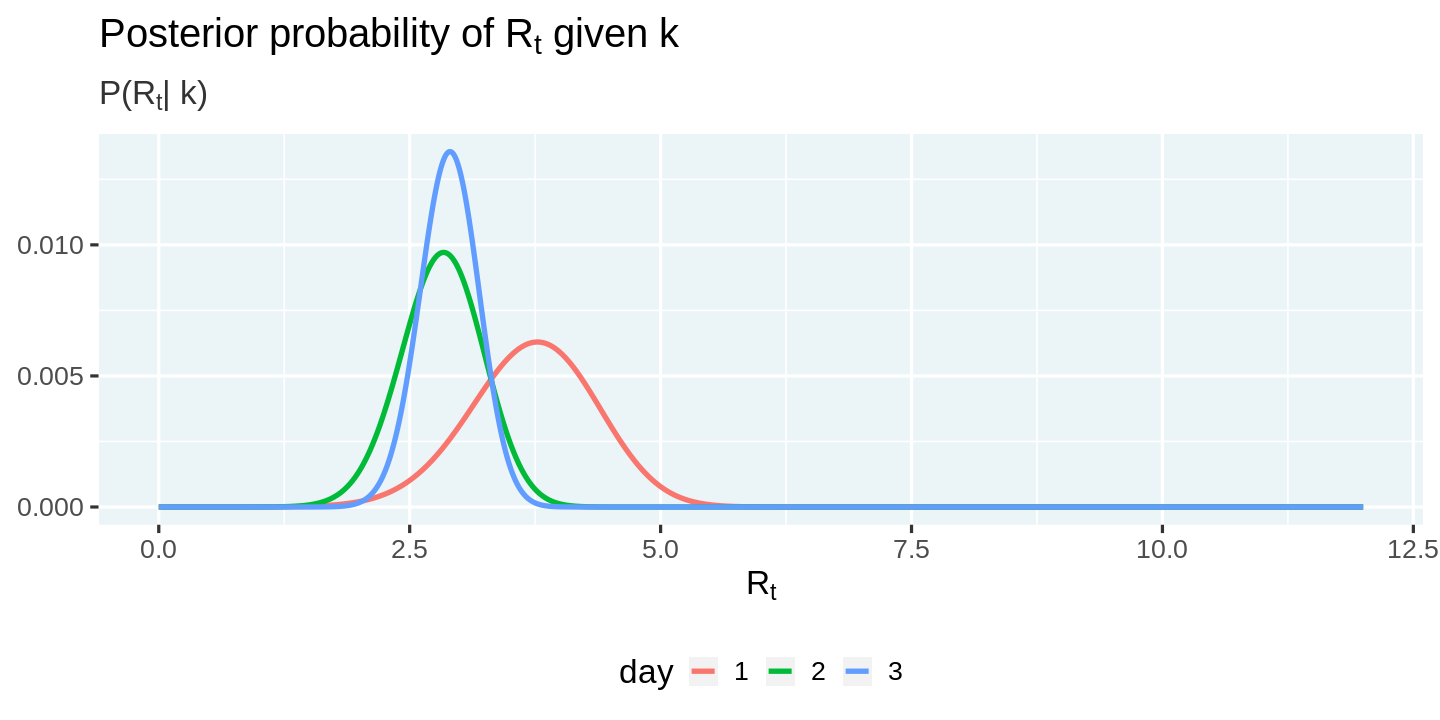
Posterior ini kini memungkinkan kita menjawab pertanyaan terpenting:
Berapakah nilai $R_t$ yang paling mungkin setiap hari?
Saat mengestimasi kuantitas apa pun, sangat penting untuk memberikan gambaran tentang galat di sekitar estimasi tersebut. Cara populer untuk melakukan ini adalah menggunakan highest density interval.
Cara lain untuk meringkas suatu distribusi adalah highest density interval, yang merangkum distribusi dengan menentukan sebuah interval yang mencakup sebagian besar distribusi, katakanlah 95% darinya, sedemikian sehingga setiap titik di dalam interval memiliki kredibilitas lebih tinggi daripada titik mana pun di luar interval.
Dalam artikelnya, Kevin mengimplementasikan algoritma brute force untuk menghitung HDI. Pengguna R lebih beruntung karena sudah ada paket, HDInterval, dengan implementasi tersebut 🎉.
Kita sekarang akan mengestimasi nilai $R_t$ yang paling mungkin, dan highest density interval di sekitarnya. Karena fungsi HDInterval::hdi hanya bekerja dengan vektor nilai acak dari sebuah distribusi, sementara kita hanya mengestimasi probabilitas posterior, kita perlu mensimulasikan nilai acak $R_t$ menggunakan probabilitas posterior untuk menghitung highest-density interval.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
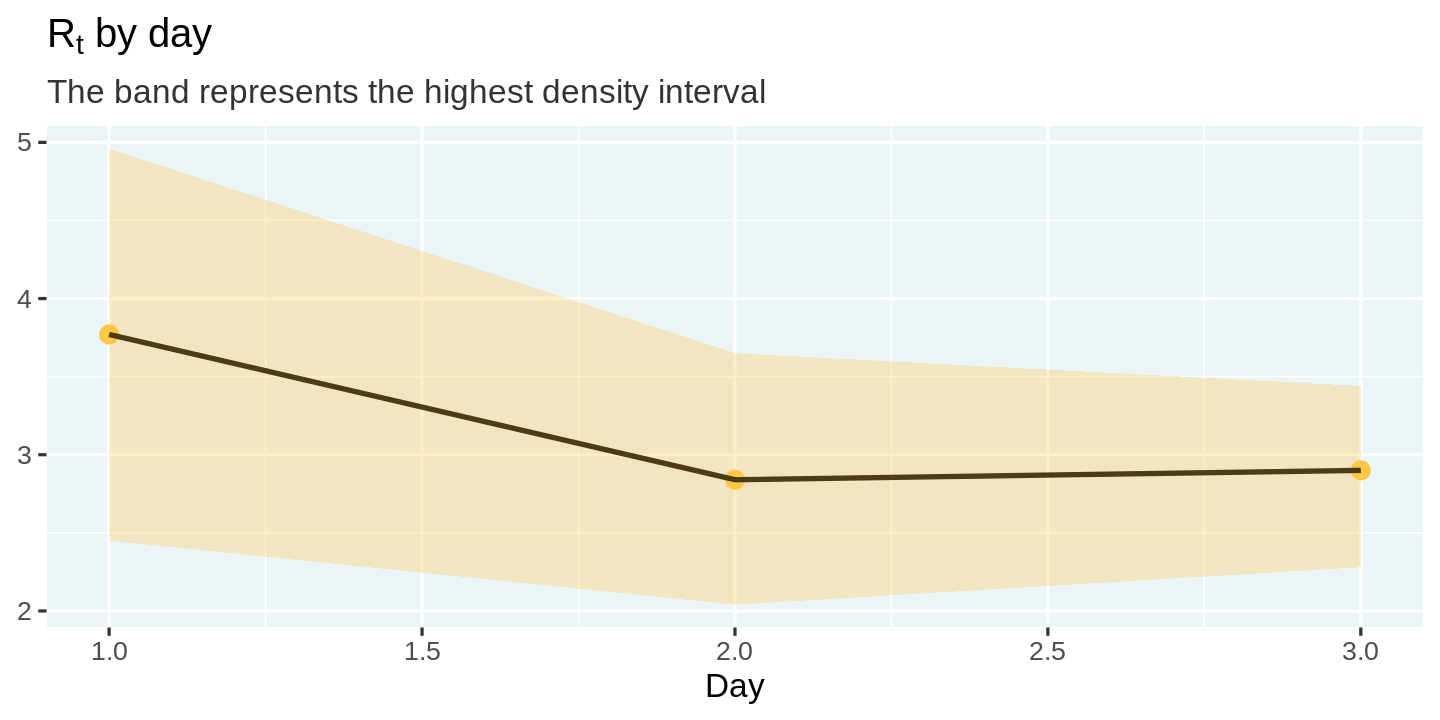
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
Kita dapat memvisualisasikan estimasi ini dan ketidakpastian di sekitarnya menggunakan plot garis dengan pita.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Meskipun pendekatan Bettencourt dan Ribeiro bekerja dengan baik, Kevin menyoroti masalah praktis (yang juga dicatat di makalah), yakni posterior bisa macet dan secara asimtotik mendekati 1, karena ketidakmampuannya melupakan masa ketika $R_t$ tinggi.
Untuk mengatasi masalah ini, Kevin menyarankan pendekatan berikut.
Jadi, saya mengusulkan agar hanya memasukkan $m$ hari terakhir dari fungsi likelihood. Dengan melakukan ini, prior algoritme dibangun berdasarkan masa lalu yang baru-baru ini yang jauh lebih berguna dibandingkan seluruh riwayat pandemi. Perubahan sederhana namun penting ini menghasilkan: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Kita akan menggunakan modifikasi ini untuk mengestimasi nilai $R_t$ di berbagai negara bagian di AS.
Sekarang saatnya menerapkan semua perangkat yang kita bangun pada data COVID dari negara bagian AS untuk mengestimasi laju infeksi efektif, $R_t$. Mari mulai dengan mengambil datanya. Kita akan menggunakan dataset COVID untuk AS yang disusun oleh New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
Langkah pertama adalah menyiapkan data dengan menghitung jumlah kasus baru setiap hari, dan menghaluskannya pada jendela bergulir. Penghalusan penting untuk mengakomodasi jeda dalam pelaporan. Jeda ini terutama terasa pada akhir pekan.
Mengikuti pendekatan Kevin, saya menggunakan penghalus gaussian dengan jendela 7 hari.
Perlu dicatat bahwa kita akan mengimplementasikan semua langkah pemrosesan data sebagai fungsi mandiri. Meskipun menambah overhead, ini memungkinkan kita menyusun langkah-langkah tersebut dengan rapi, dan juga menerapkannya ke satu atau lebih negara bagian, yang akan sangat berguna.
Kita akan menerapkan langkah-langkah ini pada satu negara bagian yang dipilih, agar lebih mudah melihat hasil dan memahaminya. Saya memilih New York, tetapi silakan ganti dengan negara bagian pilihan Anda!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
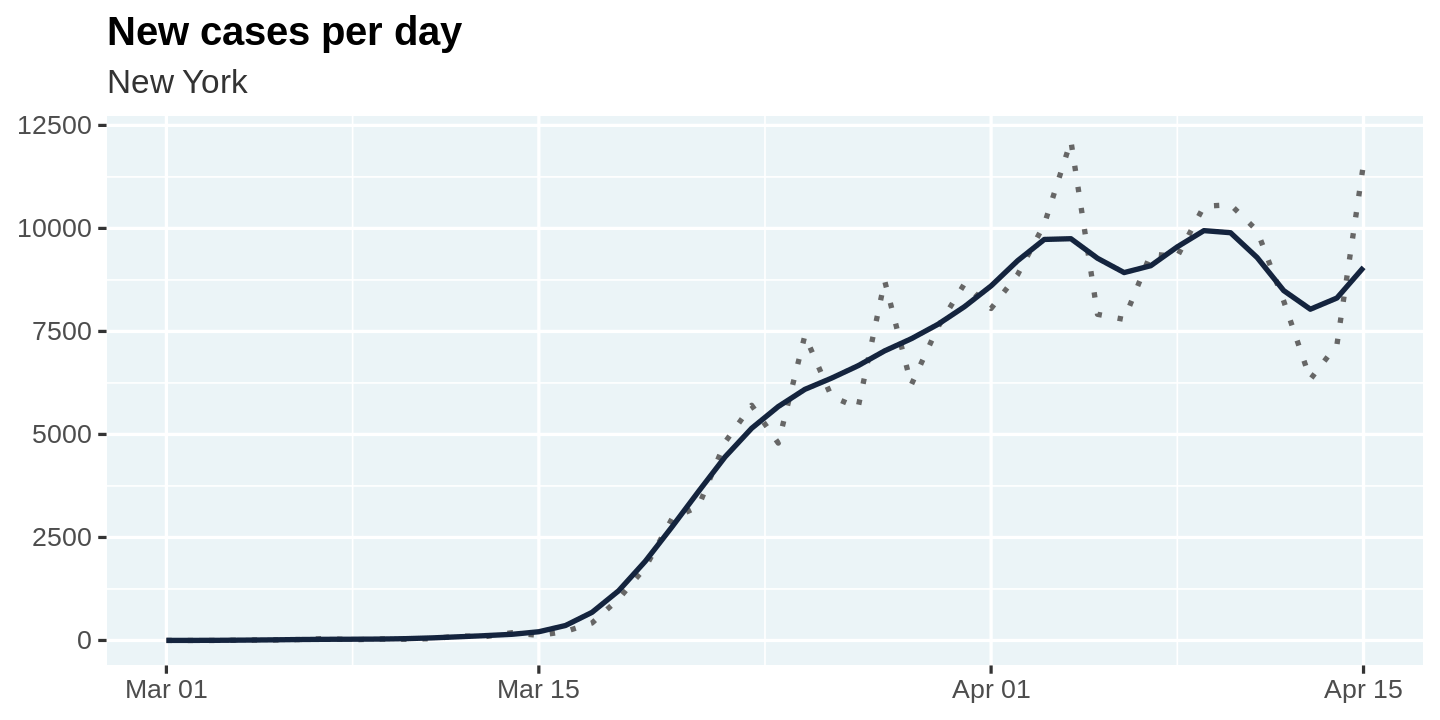
Mari kita plot nilai mentah maupun yang dihaluskan untuk new_cases agar kita bisa melihat apa yang dilakukan proses penghalusan.
🎩 Selalu merupakan praktik yang baik untuk memvisualisasikan hasil setelah Anda melakukan beberapa transformasi data. Ini membantu membangun intuisi dan juga memeriksa apakah transformasi Anda melakukan apa yang Anda maksudkan!
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
Langkah kedua adalah menghitung likelihood. Kita akan menggunakan pendekatan yang sama seperti sebelumnya, tetapi dengan satu perbedaan penting. Kita akan menghitung log-likelihood alih-alih likelihood. Ini akan memudahkan penghalusan pada jendela bergulir untuk menerapkan modifikasi yang disarankan Kevin, yaitu hanya menggunakan $m$ interval terakhir untuk menghitung $R_t$.
Seperti sebelumnya, kita akan menghitung likelihood untuk setiap hari sebagai daftar bertingkat dan kemudian membentangkan hasilnya menjadi tabel menggunakan tidyr::unnest.
🎩 Kolom daftar sangat berguna saat bekerja dengan data. Pola desain yang digunakan di sini sangat bermanfaat dalam banyak situasi.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
Langkah ketiga adalah menghitung probabilitas posterior. Ingat bahwa
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Kita dapat menulis ulang ini dalam bentuk log-likelihood
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Kita dapat menggunakan fungsi rollapplyr dari paket zoo untuk menghitung jumlah bergulir 7 hari dari log-likelihood, lalu mengeksponensialkannya untuk menghitung posterior. Terakhir, kita menormalkan posterior menjadi 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
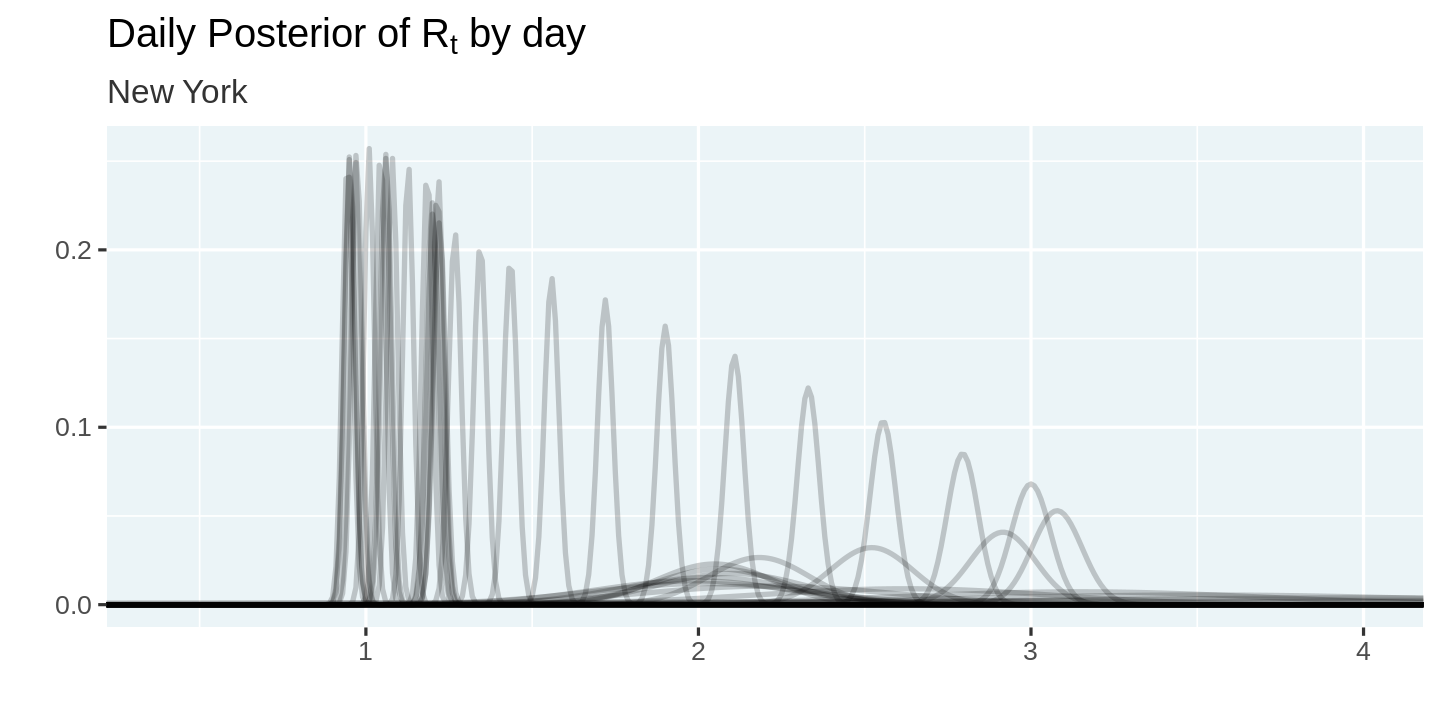
Mari memvisualisasikan probabilitas posterior yang kita hitung. Perhatikan bagaimana kita menetapkan alpha = 0.2 untuk mengurangi overplotting. Ini memungkinkan kita memvisualisasikan pergeseran posterior.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
Langkah terakhir adalah mengestimasi nilai $R_t$ dan highest density interval di sekitarnya. Ingat bahwa kita perlu mensimulasikan nilai acak untuk $r_t$ menggunakan probabilitas posterior agar dapat menerapkan fungsi HDIInterval::hdi untuk menghitung highest density interval.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Akhirnya, kita tiba pada saat yang menentukan! Mari memvisualisasikan nilai $R_t$ yang diestimasi
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
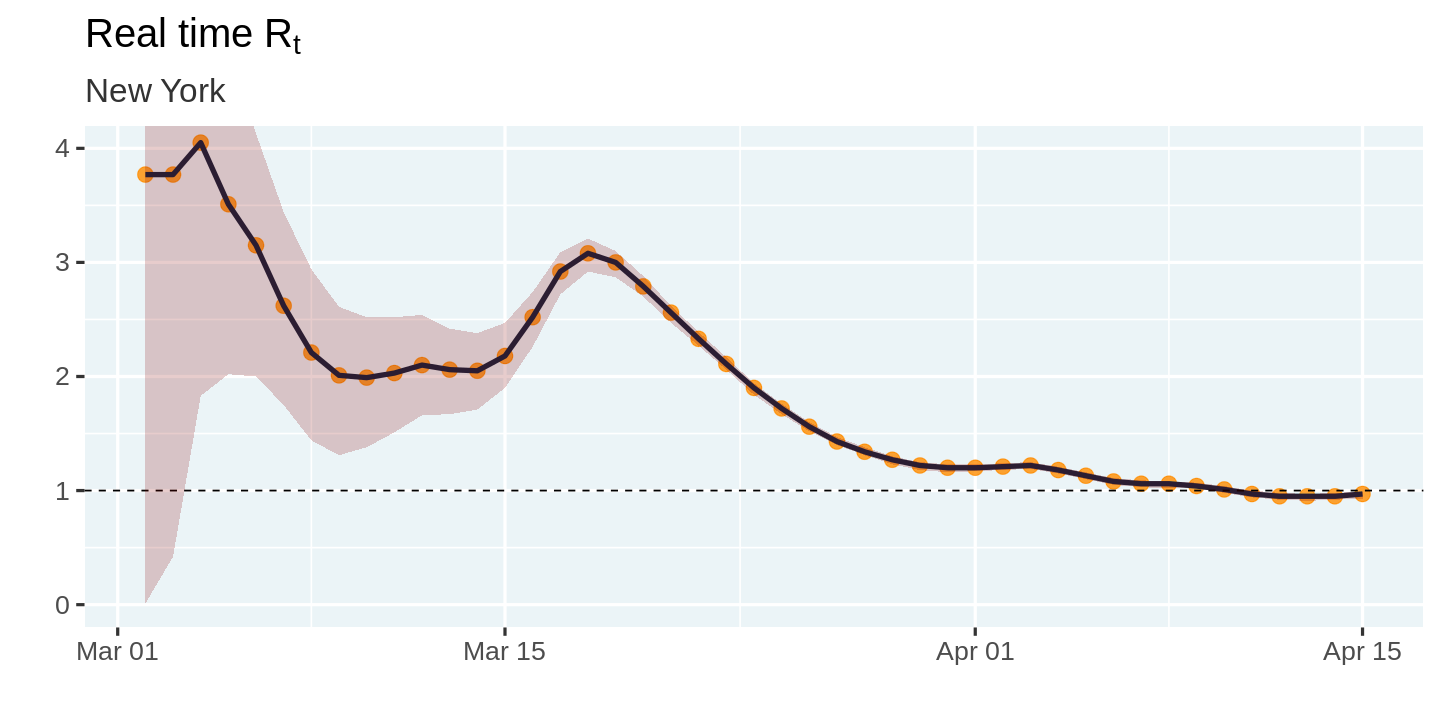
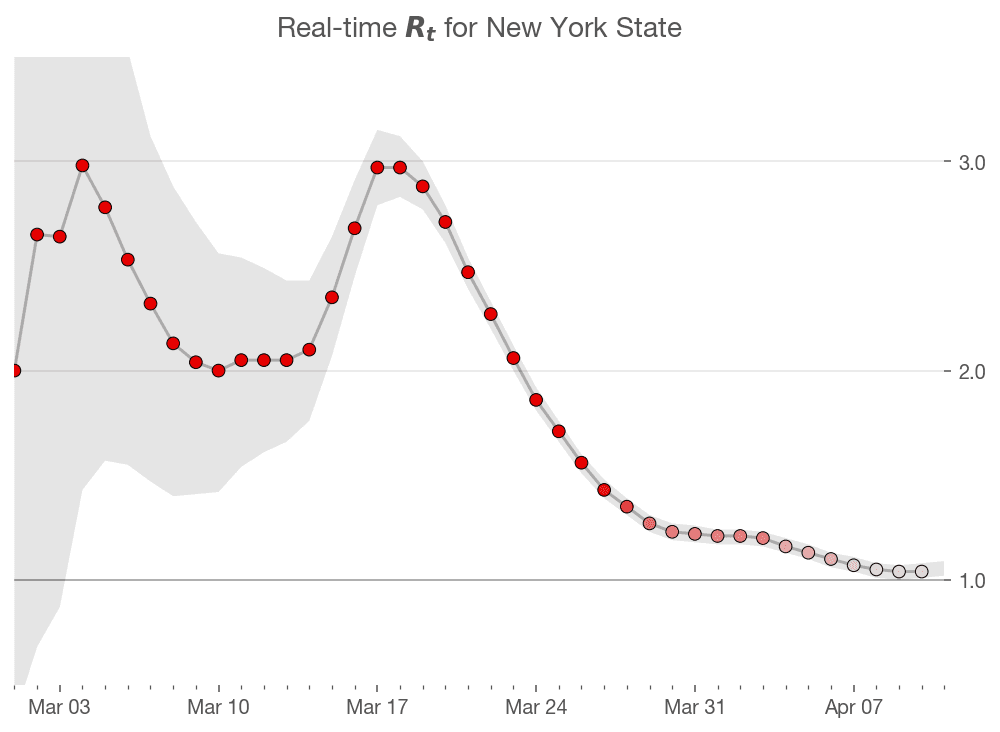
Lalu bagaimana ini dibandingkan dengan estimasi dari artikel Kevin. Tampaknya estimasi awal dalam model saya berbeda dari estimasi Kevin. Namun, itu bisa disebabkan perbedaan dalam algoritma penghalusan, atau ketidakpastian yang besar di sekitar estimasi awal. Bentuk kurva keseluruhan dan puncaknya tampak cukup selaras. Misi tercapai! 🎉
Sekarang saatnya melakukan loop di semua negara bagian dan menghitung estimasi ini. Kita dapat melakukannya dengan mudah dengan mengelompokkan berdasarkan state, membagi data menjadi satu tabel per negara bagian, dan menggunakan purrr::map_df untuk mengestimasi $R_t$ bagi setiap negara bagian lalu menggabungkannya kembali ke satu tabel.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
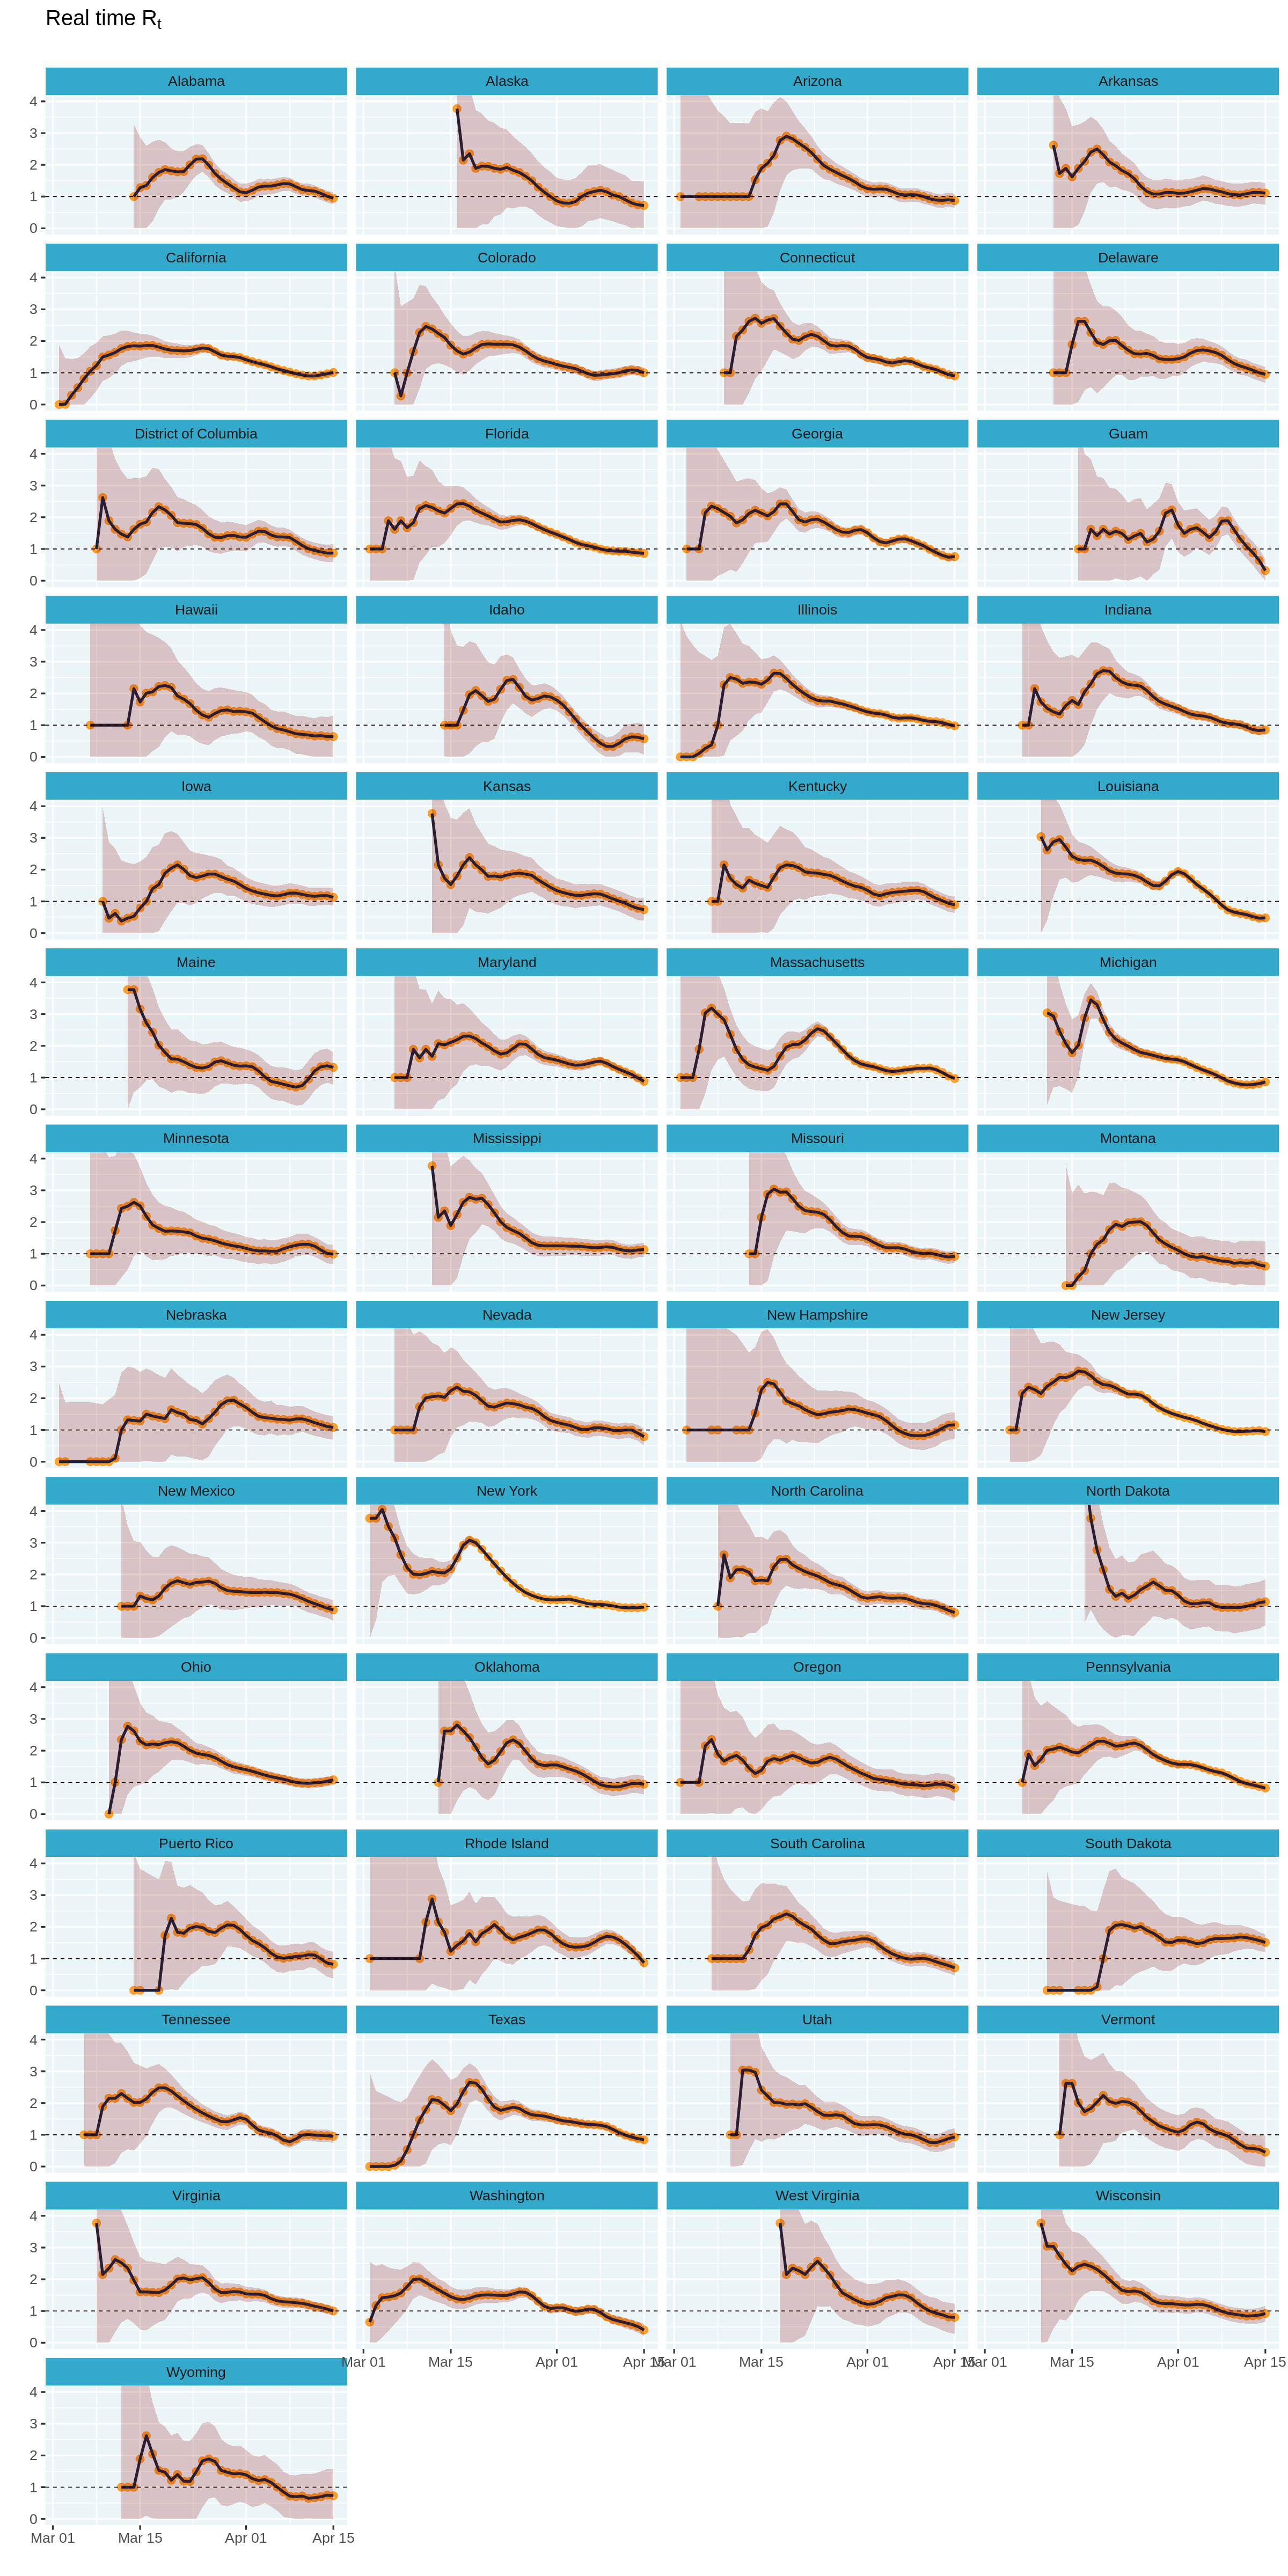
Kini kita dapat membuat plot small multiples dari estimasi di semua negara bagian. Penggunaan ggplot2 membuat ini sangat mudah dan kita hanya perlu menambahkan satu baris kode lagi!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
Meskipun plot small multiples sudah bagus, sulit menavigasi ke suatu negara bagian berdasarkan lokasinya secara geografis. Bagaimana jika kita dapat memplot setiap negara bagian mendekati lokasinya?
Untungnya, Ryan Hafen membuat paket geofacet yang memungkinkan kita menata small multiples pada grid geografis hanya dengan satu baris kode.
⚠️ Sayangnya, saya tidak dapat memasang paket geofacet di colab (saya menduga karena dependensi sistem yang dibutuhkan oleh paket sf), sehingga potongan kode di bawah akan gagal dieksekusi. Saya menyertakan versi plot yang tersimpan yang saya hasilkan secara lokal, agar Anda mendapat gambaran tampilannya.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

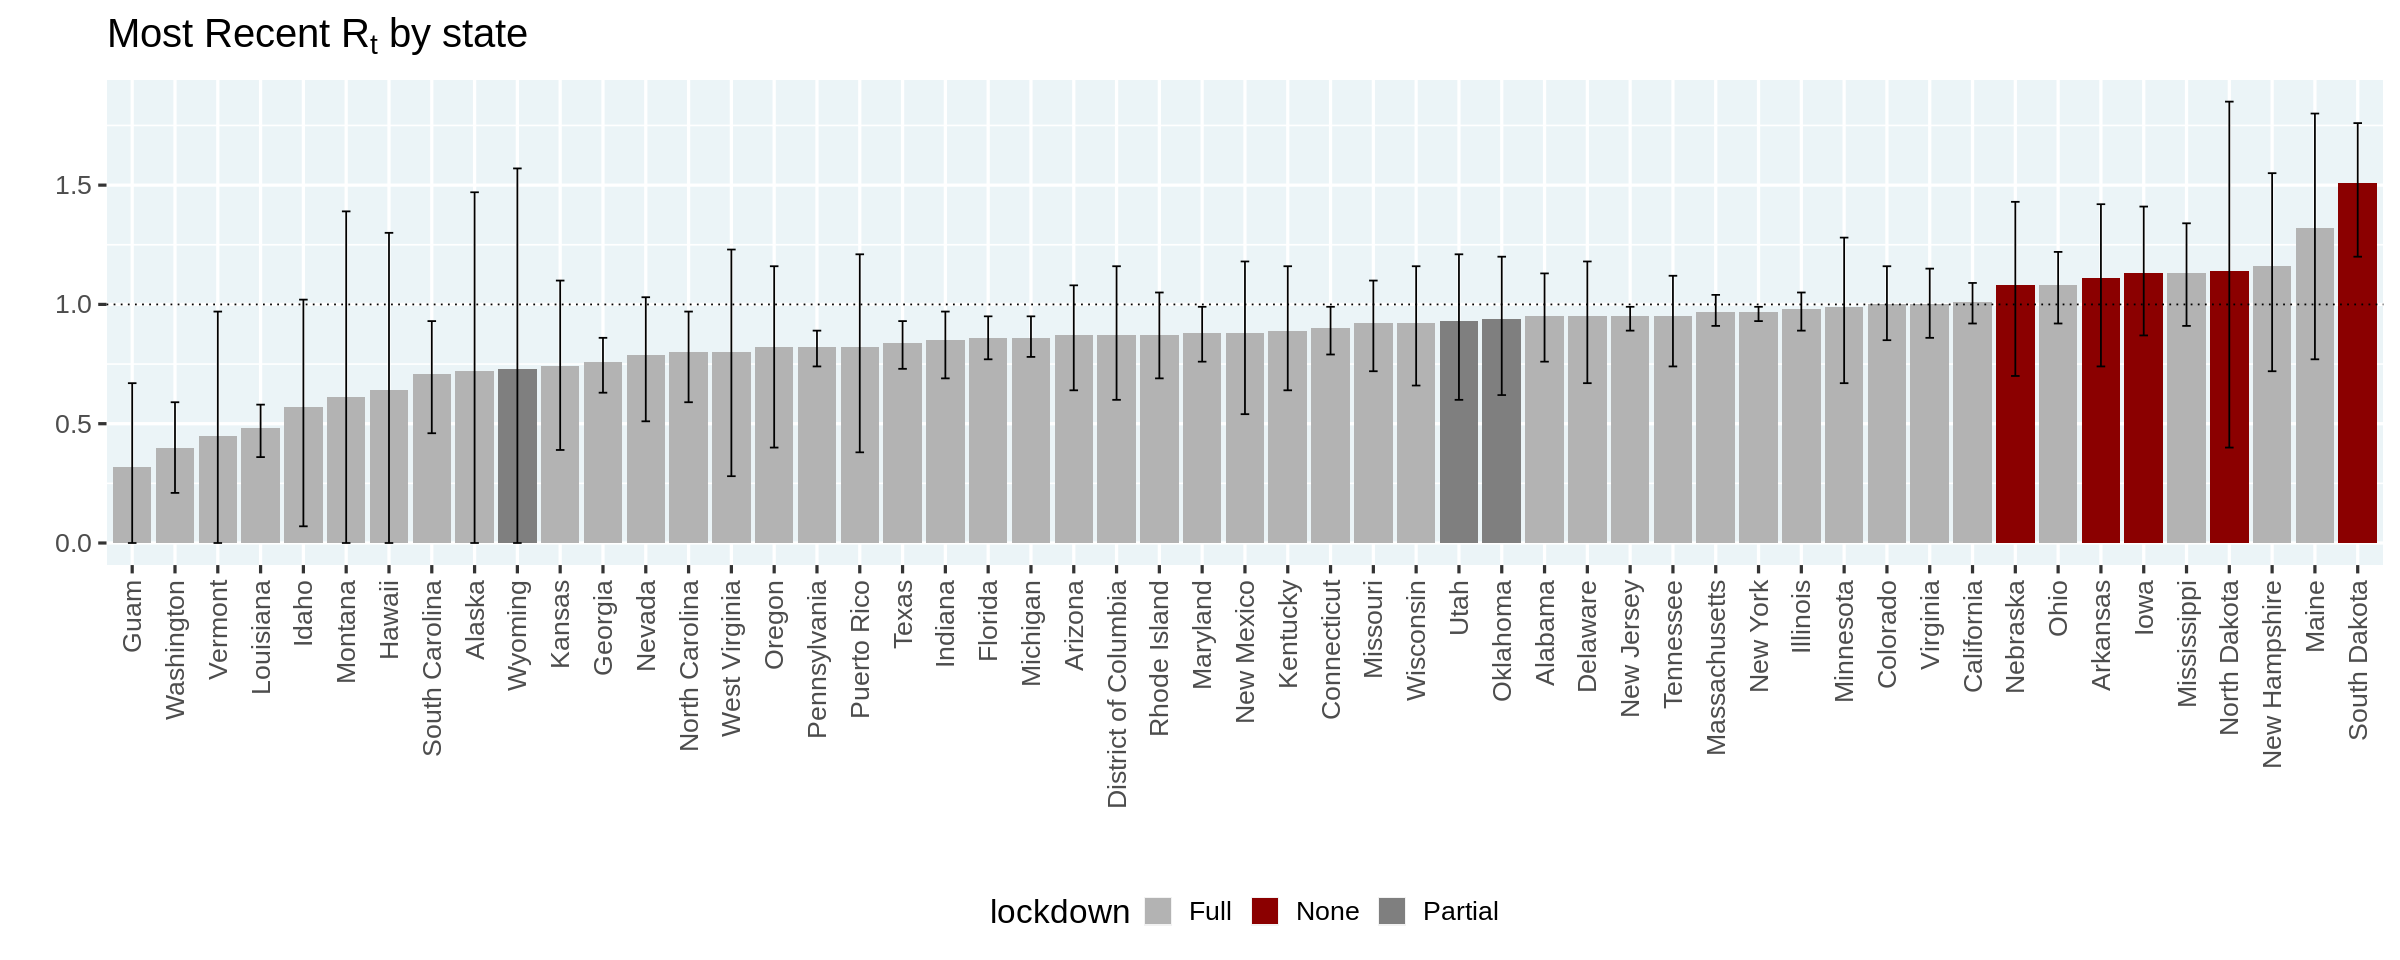
Terakhir, mari kita rekreasi plot dalam artikel Kevin yang mengurutkan negara bagian berdasarkan nilai estimasi $R_t$ yang paling mungkin, dan mewarnainya berdasarkan status lockdown.
⚠️ Harap dicatat bahwa ini adalah plot deskriptif semata dan tidak dapat digunakan untuk menarik kesimpulan tentang efektivitas lockdown
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
Dalam artikel ini, kita mereplikasi analisis Kevin di R, menggunakan tidyverse. Kita mempelajari beberapa trik berguna untuk menghitung likelihood dan posterior. Saya belajar banyak dalam proses ini!
Saya dapat memikirkan beberapa langkah lanjutan, tetapi akan menyoroti satu yang utama. Mengingat fungsi-fungsi yang dikembangkan dalam artikel ini bergantung pada tabel input yang cukup sederhana dengan tiga kolom: location, date, cases, langkah menarik berikutnya adalah mengubahnya menjadi paket R. Ini akan memudahkan mengestimasi $R_t$ untuk wilayah lain.
Saya ingin menutup dengan berterima kasih kepada Kevin Systrom karena telah menerbitkan tulisan yang menarik dan membagikan kodenya. Saya juga berterima kasih kepada rekan-rekan saya di DataCamp atas masukan yang sangat baik pada versi awal artikel ini.
Jika Anda memiliki masukan/komentar tentang artikel ini, atau ingin menyarankan pengembangan lain, Anda dapat menemukan saya di twitter @ramnath_vaidya dan github. Untuk mempelajari lebih lanjut tentang pemrograman R
Pelajari lebih lanjut tentang R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




