
Last chance! 50% off DataCamp Premium
Sale ends in
ट्विटर पर Ramnath Vaidyanathan को फ़ॉलो करें। यह विश्लेषण मूल रूप से Google Colab पर प्रकाशित हुआ था।
Kevin Systrom ने $R_t$ के आकलन पर एक बेहद रोचक लेख प्रकाशित किया, जिसे प्रभावी प्रजनन संख्या के रूप में जाना जाता है। अपने लेख में Kevin इस संख्या का वर्णन इस प्रकार करते हैं:
समय 𝑡 पर प्रति संक्रामक व्यक्ति औसतन कितने लोग संक्रमित होते हैं
Kevin ने उदारता से अपना कोड github पर एक नोटबुक के रूप में प्रकाशित किया। मैं उनके मॉडल के साथ और काम करना चाहता था, और इसे अन्य देशों पर भी लागू करना चाहता था। हालांकि, चूंकि मैं R में अधिक पारंगत हूं, इसलिए मैं पहले R में उनके परिणामों को दोहराना चाहता था।
इस पोस्ट का शेष भाग पढ़ने से पहले, मैं दृढ़ता से अनुशंसा करूंगा कि आप उपयोग किए गए मॉडलिंग दृष्टिकोण की अधिक विस्तृत समझ के लिए मूल लेख पढ़ें, क्योंकि यह पोस्ट अधिकतर कोड पर केंद्रित है।
मॉडलिंग दृष्टिकोण और कोड का सारा श्रेय Kevin को जाता है 👍। यह नोटबुक उनके मॉडल को R में अनुवादित करने का मेरा विनम्र प्रयास है। कोई भी शेष त्रुटियां केवल मेरी हैं।
हम Kevin के लेख में रेखांकित उसी दृष्टिकोण का उपयोग करेंगे, जो Bettencourt & Ribeiro के पेपर पर आधारित है।
पहला कदम संक्रमणों की 'आगमन' प्रक्रिया का मॉडलिंग करना है। सांख्यिकीविदों के बीच आगमन के वितरण के लिए एक लोकप्रिय विकल्प पॉइसन वितरण है। तदनुसार, यदि हम $\lambda$ को प्रति दिन संक्रमणों की औसत दर मानें, तो किसी दिन $k$ नए मामलों को देखने की संभावना इस प्रकार होगी
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
इस सेटअप के साथ, हम $\lambda$ के एक सेट के लिए नए मामलों का प्रायिकता वितरण बना सकते हैं। कोड लिखना शुरू करने से पहले, हमें tidyverse पैकेज समूह लोड करने होंगे, और कुछ प्लॉटिंग विकल्पों (प्लॉट का आकार, प्लॉटिंग आदि) को अनुकूलित करना होगा। आप चाहें तो इस अनुभाग को पढ़ना छोड़ सकते हैं, क्योंकि यह कथा के लिए महत्वपूर्ण नहीं है, लेकिन कोड अवश्य चलाएं।
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
हम purrr के crossing फ़ंक्शन का उपयोग $k$ और $\lambda$ के संयोजनों पर प्रायिकता घनत्वों की गणना के लिए कर सकते हैं। यह एक सुघड़ तरीका है, हालांकि संगणकीय रूप से उतना कुशल नहीं, क्योंकि हम वास्तव में dpois की वेक्टराइजेशन क्षमताओं का लाभ नहीं उठा रहे हैं। आप अगले अनुभाग में एक अधिक कुशल तरीका देखेंगे।
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
हम इन प्रायिकताओं को ggplot2 का उपयोग करके प्रदर्शित कर सकते हैं। ध्यान दें कि हम प्लॉट्स में गणितीय प्रतीकों को रेंडर करने के लिए expression का कैसे उपयोग करते हैं। इसके बारे में आप plotmath के दस्तावेज़ में अधिक पढ़ सकते हैं।
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
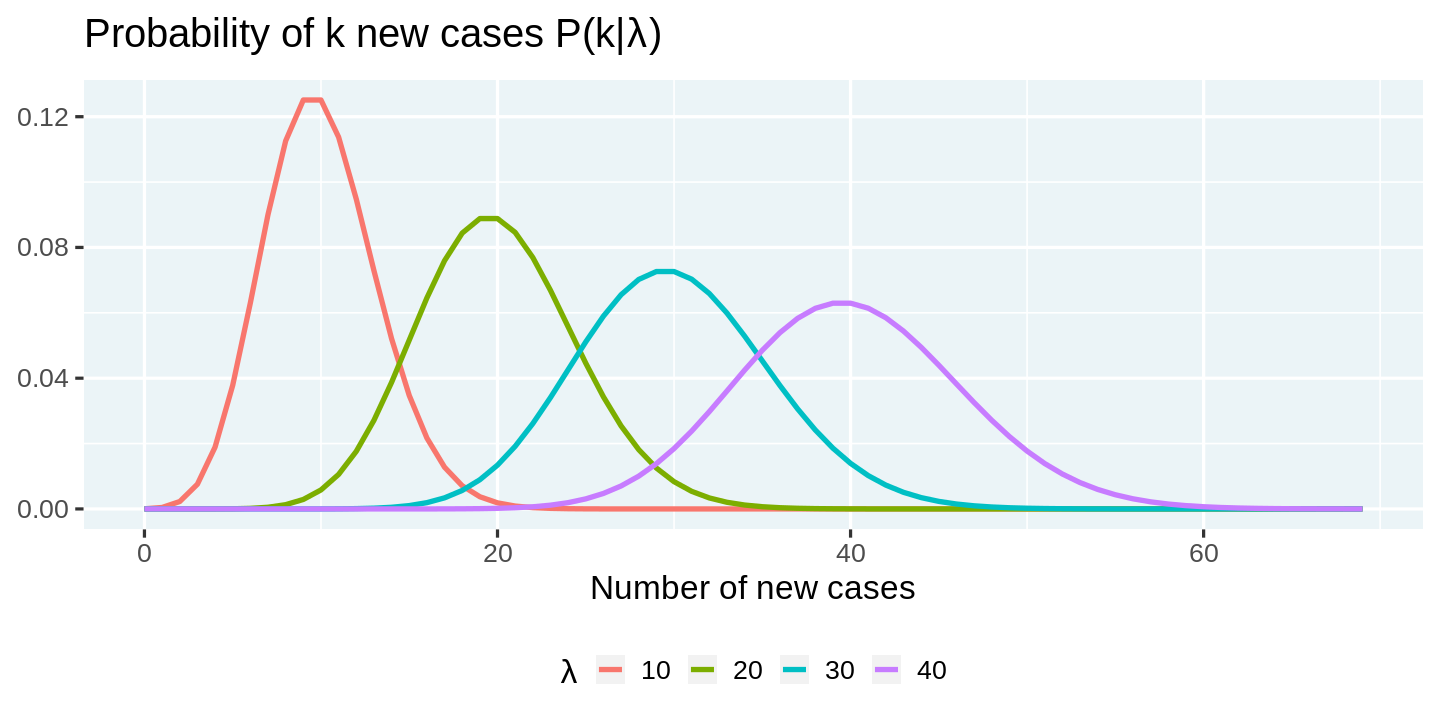
आगमन प्रक्रिया को पॉइसन वितरण के रूप में मॉडल करने से हमें आगमन दर $\lambda$ के एक फलन के रूप में किसी दिन नए मामलों के वितरण की भविष्यवाणी करने की सुविधा मिलती है। हालांकि, वास्तविकता में, हम केवल आगमन की संख्या का ही अवलोकन करते हैं। अब मुख्य प्रश्न यह है कि हम देखी गई आगमन संख्या से $\lambda$ के वितरण का आभास कैसे प्राप्त करें। सौभाग्य से, इसका उत्तर सरल है।
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
$k$ पर $\lambda$ का वितरण लाइकलीहुड फ़ंक्शन कहलाता है, और इसका वही गणितीय रूप है जो हमने पहले प्रायिकता द्रव्यमान फ़ंक्शन के लिए उपयोग किया था। हम देखे गए नए मामलों की संख्या (k) को स्थिर रखते हुए, और $\lambda$ के मानों की एक शृंखला पर लाइकलीहुड फ़ंक्शन की गणना करके इसे विज़ुअलाइज़ कर सकते हैं।
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
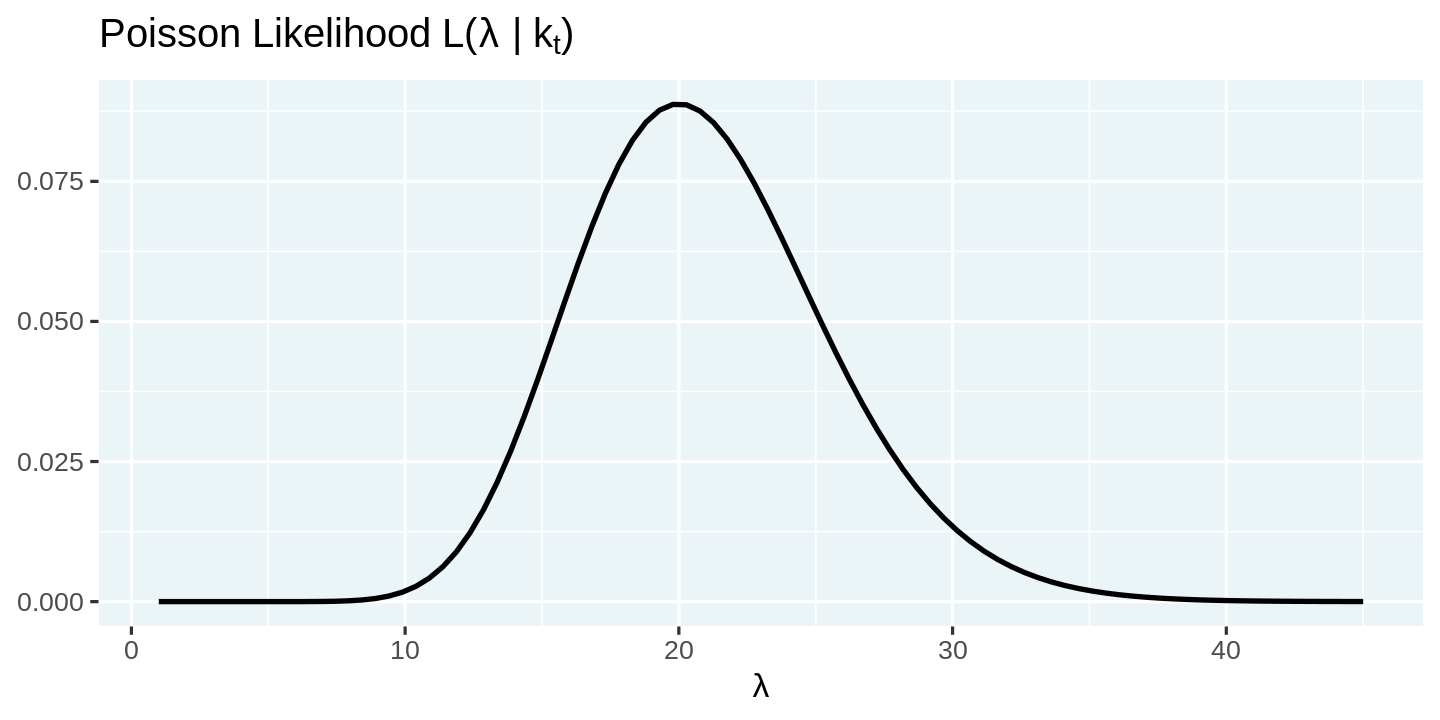
यह सब ठीक है, लेकिन आप सोच रहे होंगे कि शुरुआत में जिस प्रभावी संक्रमण दर $R_t$ की बात की थी, वह कहाँ है। इसका आगमन दर $\lambda$ से क्या संबंध है। Bettencourt & Ribeiro के इस पेपर के अनुसार, यह संबंध काफी सरल है
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
ध्यान दें कि यहाँ $\gamma$ सीरियल इंटरवल का व्युत्क्रम है (COVID19 के लिए लगभग 4 दिन), और $k_{t-1}$ समयांतराल $t-1$ में देखे गए नए मामलों की संख्या है।
हम $\lambda$ के इस व्यंजक का उपयोग कर सकते हैं और लाइकलीहुड फ़ंक्शन को $R_t$ के रूप में पुनर्परिभाषित कर सकते हैं।
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
आगे बढ़ने से पहले, कुछ मुख्य पैरामीटर सेट कर लेते हैं।
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
नीचे दिया गया कोड लाइकलीहुड की गणना का एक अधिक कुशल तरीका दिखाता है। प्रत्येक संयोजन के लिए अलग-अलग lambdas और लाइकलीहुड जनरेट करने के बजाय, हम R में फ़ंक्शनों की वेक्टराइज्ड प्रकृति और नेस्टेड डाटा फ़्रेम की क्षमता का उपयोग करते हैं। इससे हम प्रत्येक दिन के लिए lambdas और लाइकलीहुड का एक वेक्टर बनाते हैं, और फिर tidyr::unnest का उपयोग कर इसे फ्लैट टेबल में अनपैक करते हैं।
संगणकीय दक्षता के अलावा, मेरा मानना है कि यह कोड अधिक पठनीय है और गणितीय सूत्रों को न्यूनतम ओवरहेड के साथ अनुवादित करता है।
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
अब हम देखे गए नए मामलों की संख्या पर सापेक्ष लाइकलीहुड का प्लॉट बना सकते हैं।
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
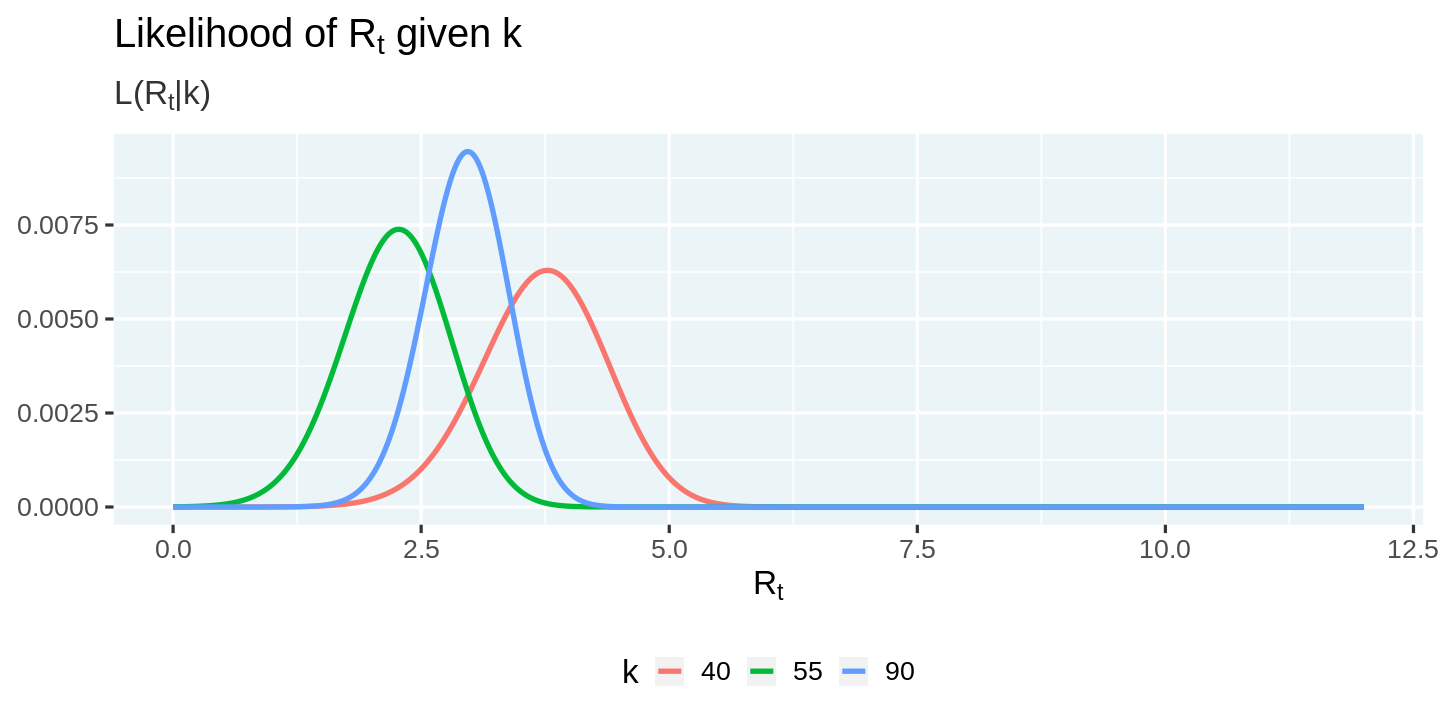
हमने नए मामलों की संख्या $k$ और प्रभावी संक्रमण दर $R_t$ को जोड़ने में अच्छी प्रगति की है। हालांकि, अभी भी हमारे पास देखे गए नए मामलों की समय-श्रृंखला से इसके मान का आकलन करने का ठोस तरीका नहीं है। यहीं पर सर्वव्यापी बेयस नियम बेहद सहायक होता है। Bettencourt & Ribeiro $R_t$ के प्रायिकता वितरण को इस प्रकार व्यक्त करते हैं
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin इस जटिल समीकरण को बहुत सरल शब्दों में समझाते हैं।
इसका अर्थ है कि 𝑘 नए मामलों को देखने के बाद, हम मानते हैं कि 𝑅𝑡 का वितरण बराबर है:
- डेटा के बिना $P(R_t)$ के मान के बारे में हमारी पूर्वधारणा ...
- गुणा उस लाइकलीहुड से कि $R_t$ दिए जाने पर $k$ नए मामले देखने की संभावना ...
- भाग उस सामान्य संभावना से कि इतने मामले दिखें।
यदि हम पिछले काल की पश्च-प्रायिकता, $P(R_{t-1} | k_{t-1})$, को वर्तमान काल के लिए पूर्वधारणा, $P(R_t)$, के रूप में उपयोग करें, तो हम पिछले समीकरण को इस प्रकार लिख सकते हैं:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
$t = 0$ तक सभी अवधियों पर इटरेट करते हुए, हमें मिलता है
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
समान पूर्वधारणा $P(R_0)$ के साथ, यह घटकर रह जाता है:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
अब हम इस गणितीय व्यंजक का उपयोग कर लाइकलीहुड से पश्च-प्रायिकता की गणना कर सकते हैं। एक बार फिर, हम वेक्टराइज्ड फ़ंक्शन cumprod का उपयोग करते हैं ताकि सभी दिनों के लिए एक साथ पोस्टेरियर्स जनरेट किए जा सकें, और फिर उन्हें सामान्यीकृत कर सकें।
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
अब हम पश्च-प्रायिकता वितरण का विज़ुअलाइज़ेशन कर सकते हैं।
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
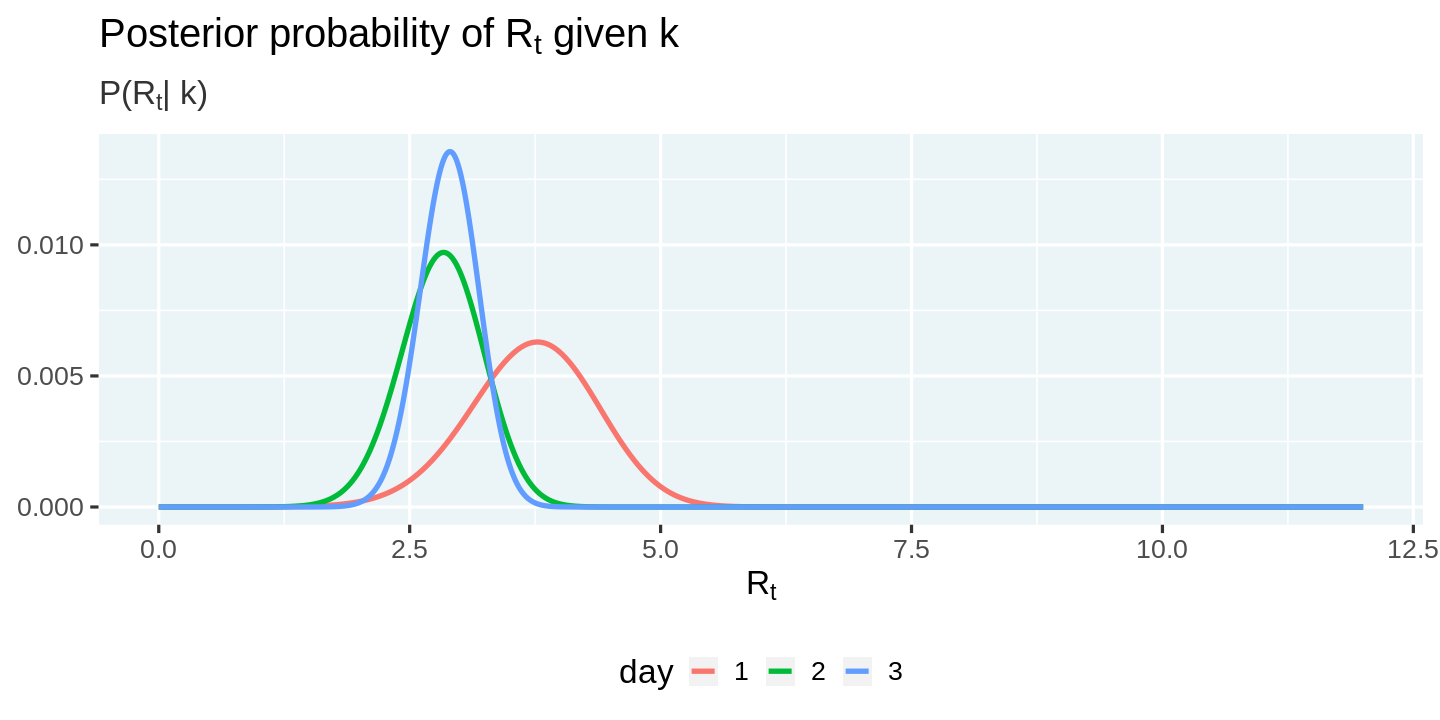
ये पोस्टेरियर अब हमें यह सबसे महत्वपूर्ण प्रश्न का उत्तर देने देते हैं:
प्रत्येक दिन $R_t$ का सबसे संभावित मान क्या है?
किसी भी मात्रा का आकलन करते समय, अनुमान के आस-पास की त्रुटि का बोध कराना बहुत महत्वपूर्ण है। ऐसा करने का एक लोकप्रिय तरीका उच्चतम घनत्व अंतराल का उपयोग करना है।
किसी वितरण को सारांशित करने का एक और तरीका उच्चतम घनत्व अंतराल है, जो वितरण के उस अंतराल को बताता है जो वितरण का अधिकांश भाग, मान लें 95%, कवर करता है, ताकि उस अंतराल के भीतर हर बिंदु की विश्वसनीयता अंतराल से बाहर किसी भी बिंदु से अधिक हो।
अपने लेख में, Kevin ने HDI की गणना के लिए ब्रूट-फोर्स एल्गोरिद्म लागू किया है। R उपयोगकर्ताओं के लिए सौभाग्य है कि पहले से ही HDInterval नामक एक पैकेज उपलब्ध है जिसमें इसका इम्प्लीमेंटेशन है 🎉।
अब हम $R_t$ के सबसे संभावित मान और उसके आस-पास के उच्चतम घनत्व अंतराल का अनुमान लगाएंगे। चूंकि HDInterval::hdi फ़ंक्शन किसी वितरण से प्राप्त रैंडम मानों के वेक्टर पर ही काम करता है, और हमने केवल पोस्टेरियर प्रायिकताएं ही आंकी हैं, इसलिए उच्चतम-घनत्व अंतराल की गणना के लिए हमें पोस्टेरियर प्रायिकताओं का उपयोग करके $R_t$ के रैंडम मान सिम्युलेट करने होंगे।
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
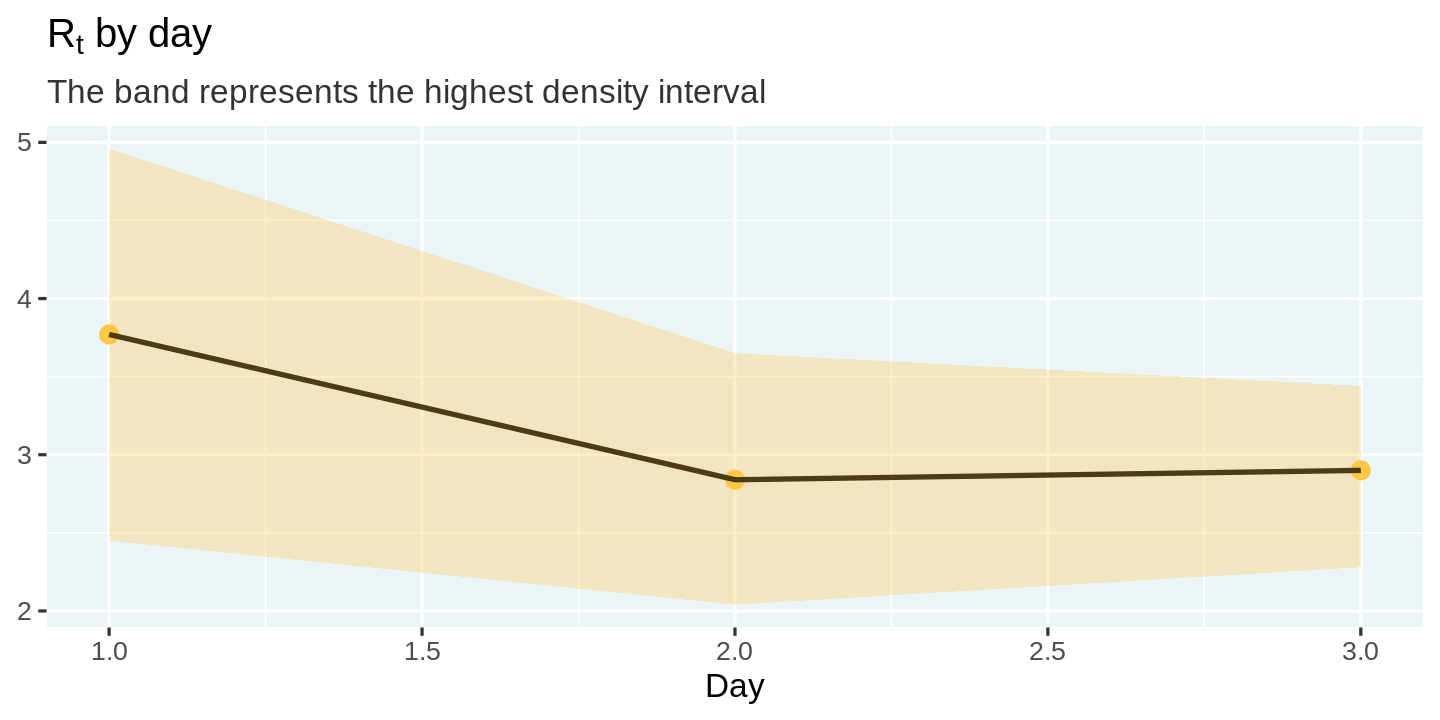
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
हम इन आकलनों और उनके चारों ओर की अनिश्चितता को रिबन सहित एक लाइन प्लॉट द्वारा विज़ुअलाइज़ कर सकते हैं।
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
हालांकि Bettencourt और Ribeiro का तरीका ठीक काम करता है, Kevin इसमें एक व्यावहारिक समस्या की ओर इशारा करते हैं (जिसका पेपर में भी उल्लेख है), कि पोस्टेरियर अटक सकता है और 1 के निकट विषमापवर्ती हो सकता है, क्योंकि यह उच्च $R_t$ वाले समयों को भूलने में असमर्थ होता है।
इस समस्या का समाधान करने के लिए, Kevin निम्नलिखित तरीका सुझाते हैं।
मैं लाइकलीहुड फ़ंक्शन के केवल पिछले $m$ दिनों को शामिल करने का प्रस्ताव करता हूं। ऐसा करने से, एल्गोरिद्म की पूर्वधारणा हाल के अतीत के आधार पर बनती है, जो महामारी के पूरे इतिहास की तुलना में अधिक उपयोगी पूर्वधारणा है। यह सरल, पर महत्वपूर्ण बदलाव निम्नलिखित की ओर ले जाता है: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
हम इस संशोधन का उपयोग करते हुए अमेरिका के विभिन्न राज्यों में $R_t$ के मानों का अनुमान लगाएंगे।
अब समय है कि हम बनाई गई इस समूची प्रणाली को लें और US राज्यों के COVID डेटा पर लागू करके प्रभावी संक्रमण दर $R_t$ का अनुमान लगाएं। आइए डेटा प्राप्त करने से शुरू करें। हम New York Times द्वारा निर्मित US के लिए COVID डेटासेट का उपयोग करेंगे।
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
पहला कदम डेटा तैयार करना है—हर दिन नए मामलों की संख्या निकालना, और उसे एक रोलिंग विंडो पर स्मूथ करना। स्मूथिंग रिपोर्टिंग में देरी को समायोजित करने के लिए आवश्यक है। यह देरी खासकर सप्ताहांत पर अधिक पाई गई है।
Kevin के दृष्टिकोण का अनुसरण करते हुए, मैं 7-दिन की रोलिंग विंडो के साथ एक गाउसियन स्मूथर का उपयोग करता हूं।
ध्यान दें कि हम सभी डेटा प्रोसेसिंग चरणों को स्टैंडअलोन फ़ंक्शनों के रूप में लागू करेंगे। इससे थोड़ा ओवरहेड तो बढ़ता है, लेकिन हम इन चरणों को साफ़-सुथरे ढंग से कंपोज़ कर सकते हैं, और इन्हें एक या अधिक राज्यों पर लागू भी कर सकते हैं—जो आगे बहुत काम आएगा।
हम इन चरणों को एक चयनित राज्य पर लागू करेंगे ताकि परिणामों को देखना और समझना आसान हो। मैंने New York चुना है, पर आप चाहें तो कोई और राज्य चुन सकते हैं!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
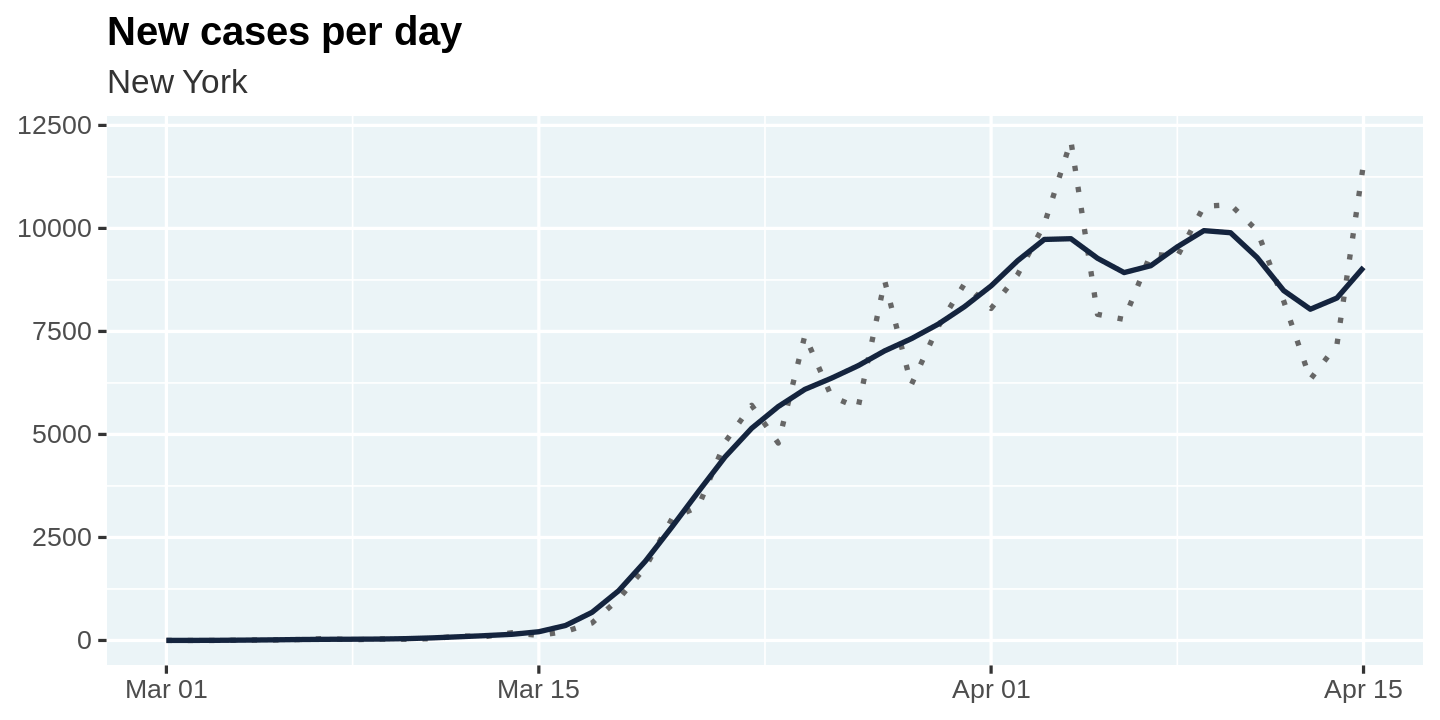
आइए new_cases के कच्चे मान और स्मूथ किए गए मान दोनों का प्लॉट बनाएं ताकि हम देख सकें कि स्मूथिंग प्रक्रिया क्या कर रही है।
🎩 जब भी आप कुछ डेटा ट्रांसफ़ॉर्मेशन करें, उसके बाद परिणामों को विज़ुअलाइज़ करना हमेशा अच्छी प्रैक्टिस है। इससे आपकी सहज समझ बनती है और यह भी परखा जा सकता है कि आपका ट्रांसफ़ॉर्मेशन वही कर रहा है जिसकी आपने अपेक्षा की थी!
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
दूसरा चरण लाइकलीहुड की गणना करना है। हम पहले जैसा ही तरीका अपनाएंगे, लेकिन एक उल्लेखनीय अंतर के साथ। हम लाइकलीहुड की बजाय लॉग-लाइकलीहुड की गणना करेंगे। इससे उन्हें रोलिंग विंडो पर स्मूथ करना आसान होगा ताकि Kevin द्वारा सुझाए गए संशोधन—केवल नवीनतम $m$ अंतरालों का उपयोग करके $R_t$ की गणना—को लागू किया जा सके।
पहले की तरह, हम प्रत्येक दिन के लिए लाइकलीहुड को एक नेस्टेड सूची के रूप में गणना करेंगे और फिर tidyr::unnest का उपयोग करके परिणामों को टेबल में फ्लैट करेंगे।
🎩 डेटा के साथ काम करते समय लिस्ट कॉलम बेहद उपयोगी होते हैं। यहाँ उपयोग किया गया डिज़ाइन पैटर्न कई परिस्थितियों में बहुत काम आता है।
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
तीसरा चरण पश्च-प्रायिकताओं की गणना करना है। याद करें कि
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
हम इसे लॉग-लाइकलीहुड के रूप में इस प्रकार लिख सकते हैं
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
हम zoo पैकेज के rollapplyr फ़ंक्शन का उपयोग करके लॉग-लाइकलीहुड का 7-दिन का रोलिंग योग निकाल सकते हैं, और फिर एक्सपोनेंशिएट करके पोस्टेरियर प्राप्त कर सकते हैं। अंत में, हम पोस्टेरियर को 1.0 पर सामान्यीकृत कर देते हैं।
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
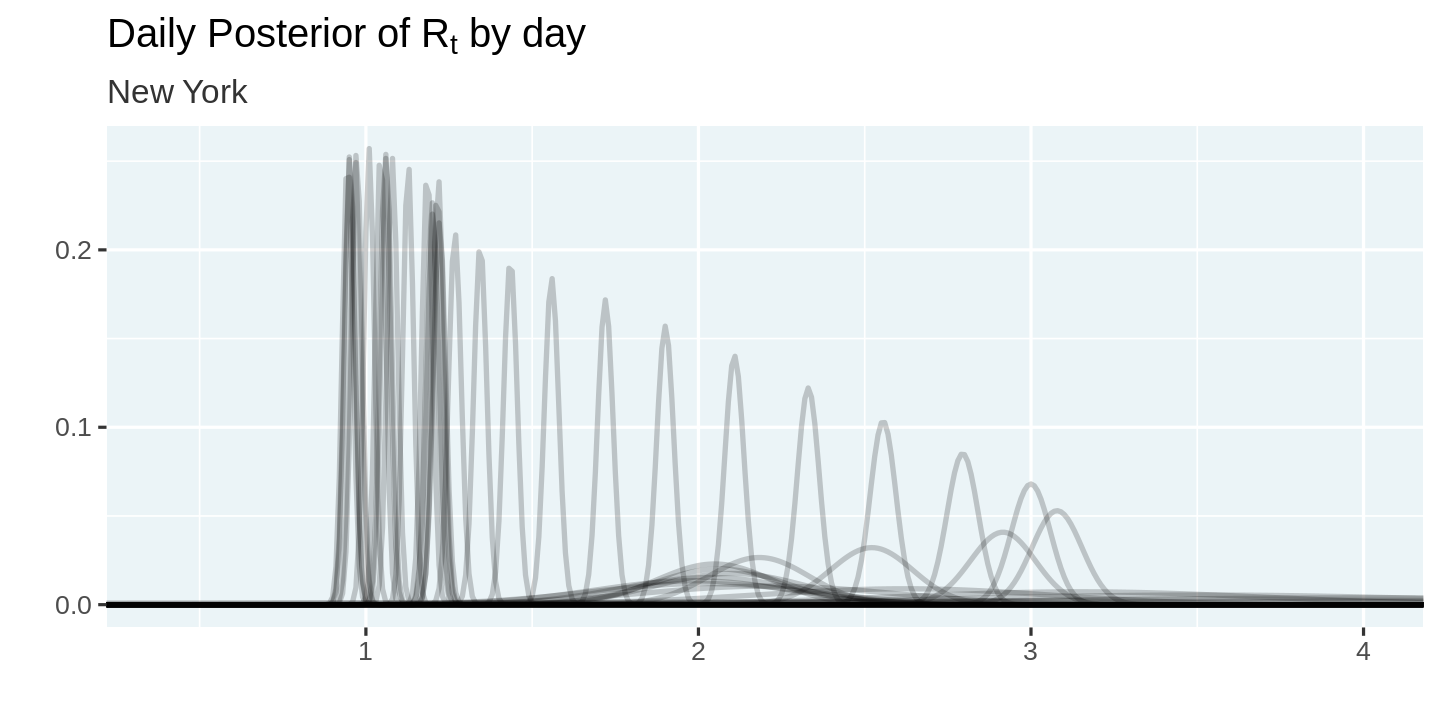
आइए उन posterior प्रायिकताओं को विज़ुअलाइज़ करें जिन्हें हमने गणना किया है। ध्यान दें कि हमने overplotting कम करने के लिए alpha = 0.2 सेट किया है। इससे बदलते हुए posteriors को विज़ुअलाइज़ करना आसान हो जाता है।
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
अंतिम चरण है $R_t$ के मानों और उनके आस-पास के उच्चतम घनत्व अंतरालों का आकलन करना। याद करें कि हमें उच्चतम घनत्व अंतराल निकालने के लिए HDIInterval::hdi फ़ंक्शन लागू करने हेतु posterior प्रायिकताओं का उपयोग करके $r_t$ के यादृच्छिक मानों का सिमुलेशन करना होगा।
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
आखिरकार, हम सच के क्षण पर पहुँच गए! आइए $R_t$ के आकलित मानों को विज़ुअलाइज़ करें
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
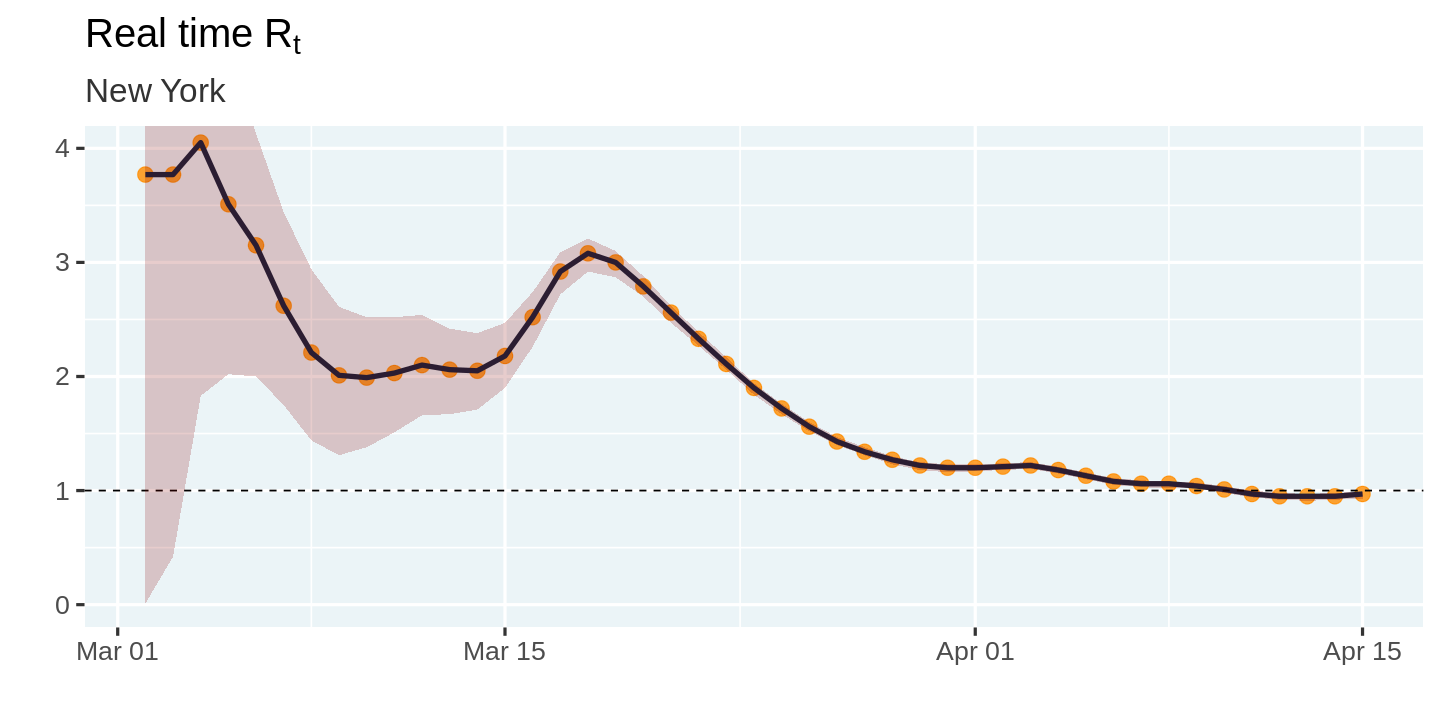
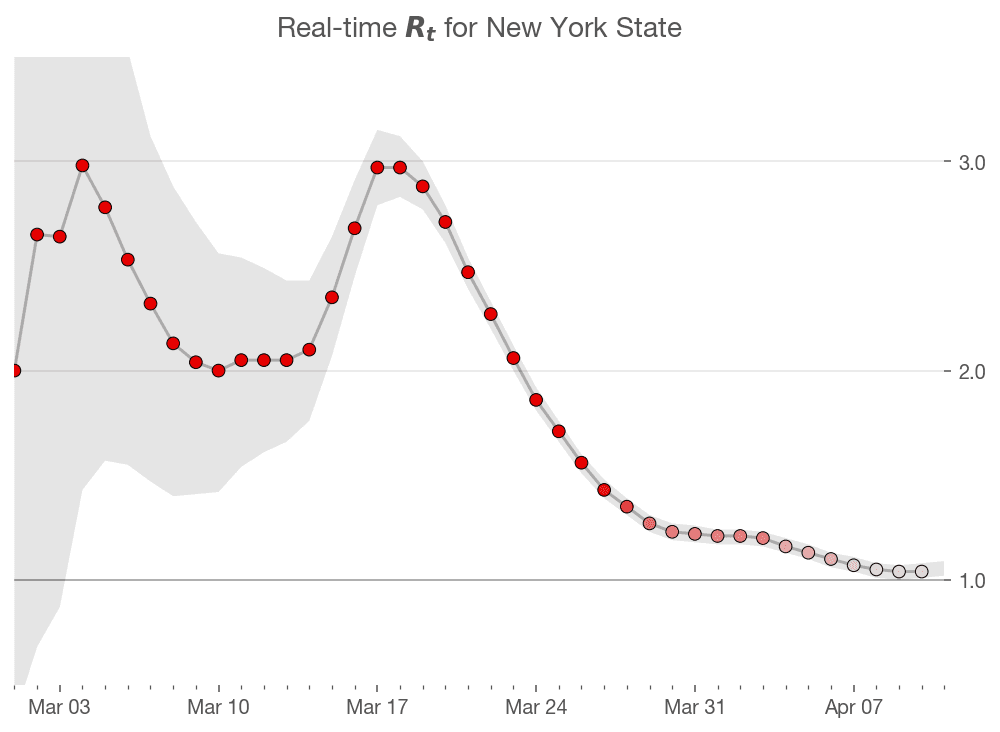
तो यह केविन के लेख के आकलनों से कैसे तुलना करता है। लगता है कि मेरे मॉडल में शुरुआती आकलन केविन के आकलनों से भिन्न हैं। हालांकि, यह स्मूथिंग एल्गोरिदम में अंतर या शुरुआती आकलनों के आसपास की बड़ी अनिश्चितता का परिणाम हो सकता है। वक्र का समग्र आकार और शिखर काफी हद तक मेल खाते दिखते हैं। मिशन पूरा! 🎉
अब समय है कि हम सभी राज्यों पर लूप चलाएँ और ये आकलन करें। हम यह आसानी से कर सकते हैं: state के आधार पर समूह बनाकर, डेटा को प्रति राज्य एक तालिका में विभाजित करके, और प्रत्येक राज्य के लिए $R_t$ का आकलन करने तथा उन्हें एक एकल तालिका में वापस संयोजित करने के लिए purrr::map_df का उपयोग करके।
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
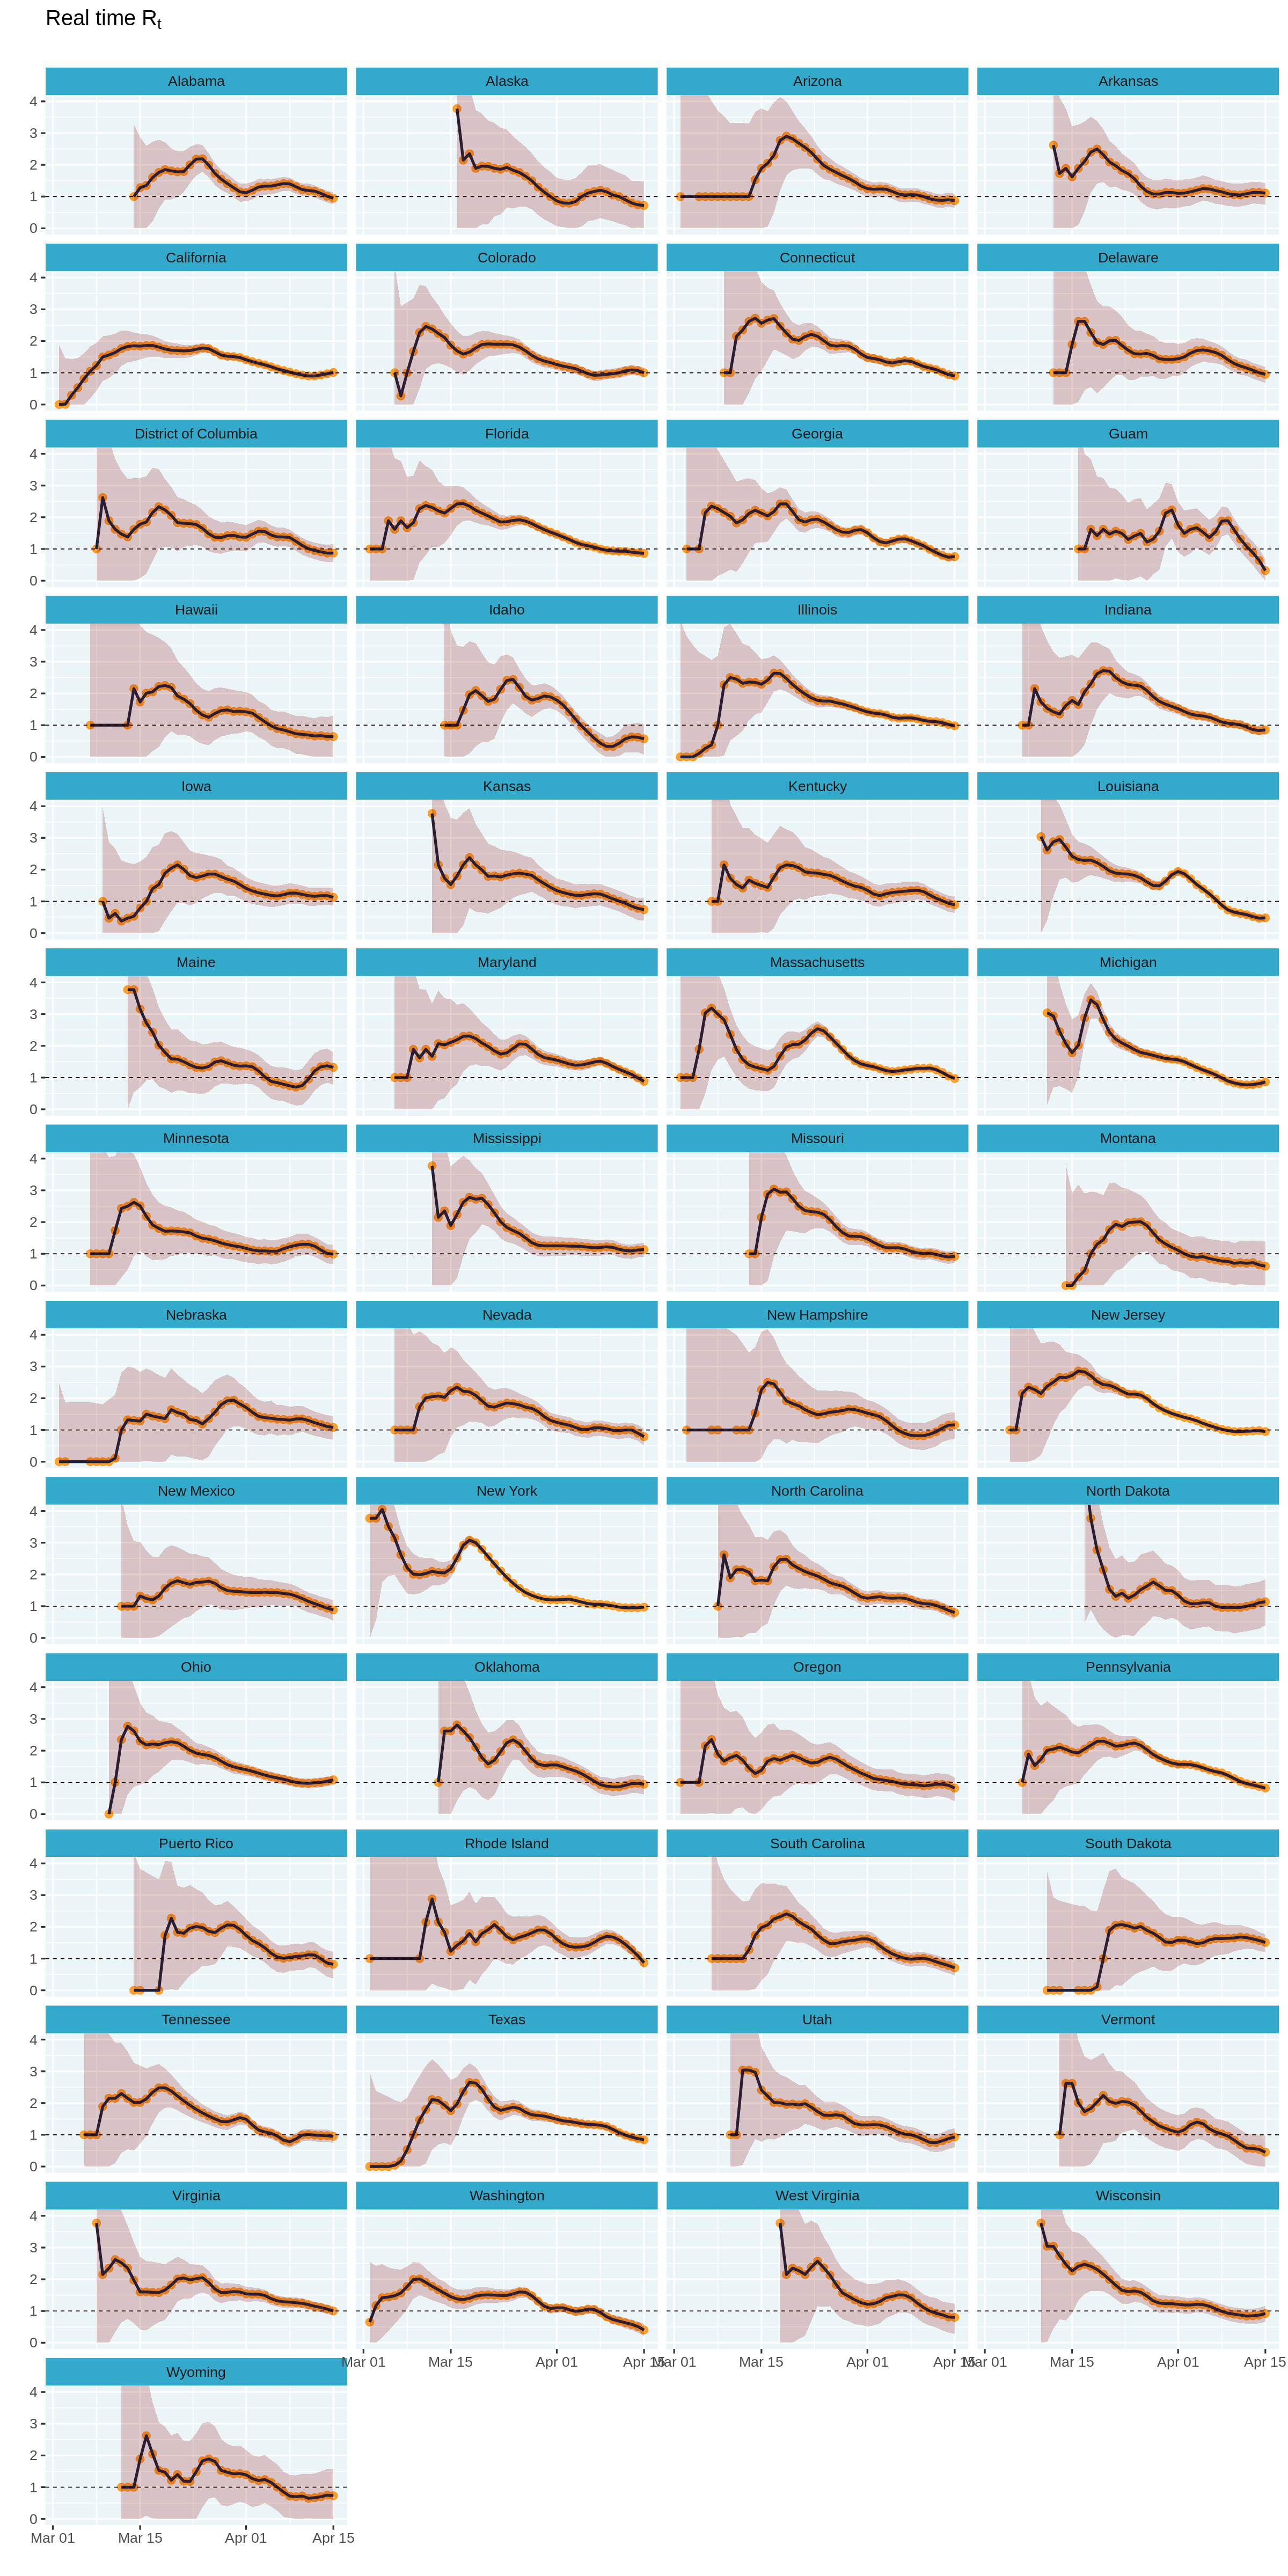
अब हम सभी राज्यों के आकलनों का एक स्मॉल-मल्टिपल्स प्लॉट बना सकते हैं। ggplot2 का उपयोग इसे बहुत आसान बना देता है और हमें बस एक अतिरिक्त कोड लाइन जोड़नी पड़ी!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
हालाँकि स्मॉल-मल्टिपल्स प्लॉट बढ़िया है, लेकिन भौगोलिक स्थिति के आधार पर किसी राज्य तक पहुँचना कठिन है। क्या होगा यदि हम प्रत्येक राज्य को उसकी भौगोलिक स्थिति के करीब प्लॉट कर सकें?
सौभाग्य से, Ryan Hafen ने geofacet पैकेज बनाया है जो हमें इन स्मॉल-मल्टिपल्स को एक भौगोलिक ग्रिड पर केवल एक लाइन कोड से व्यवस्थित करने देता है।
⚠️ दुर्भाग्यवश, मैं geofacet पैकेज को colab पर इंस्टॉल नहीं कर सका (मेरा संदेह है कि यह sf पैकेज द्वारा आवश्यक सिस्टम dependencies के कारण है), इसलिए नीचे दिया गया कोड खंड चलने में विफल होगा। मैंने स्थानीय रूप से जनरेट किए गए प्लॉट का एक सेव्ड संस्करण शामिल किया है, ताकि आप देख सकें यह कैसा दिखता है।
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

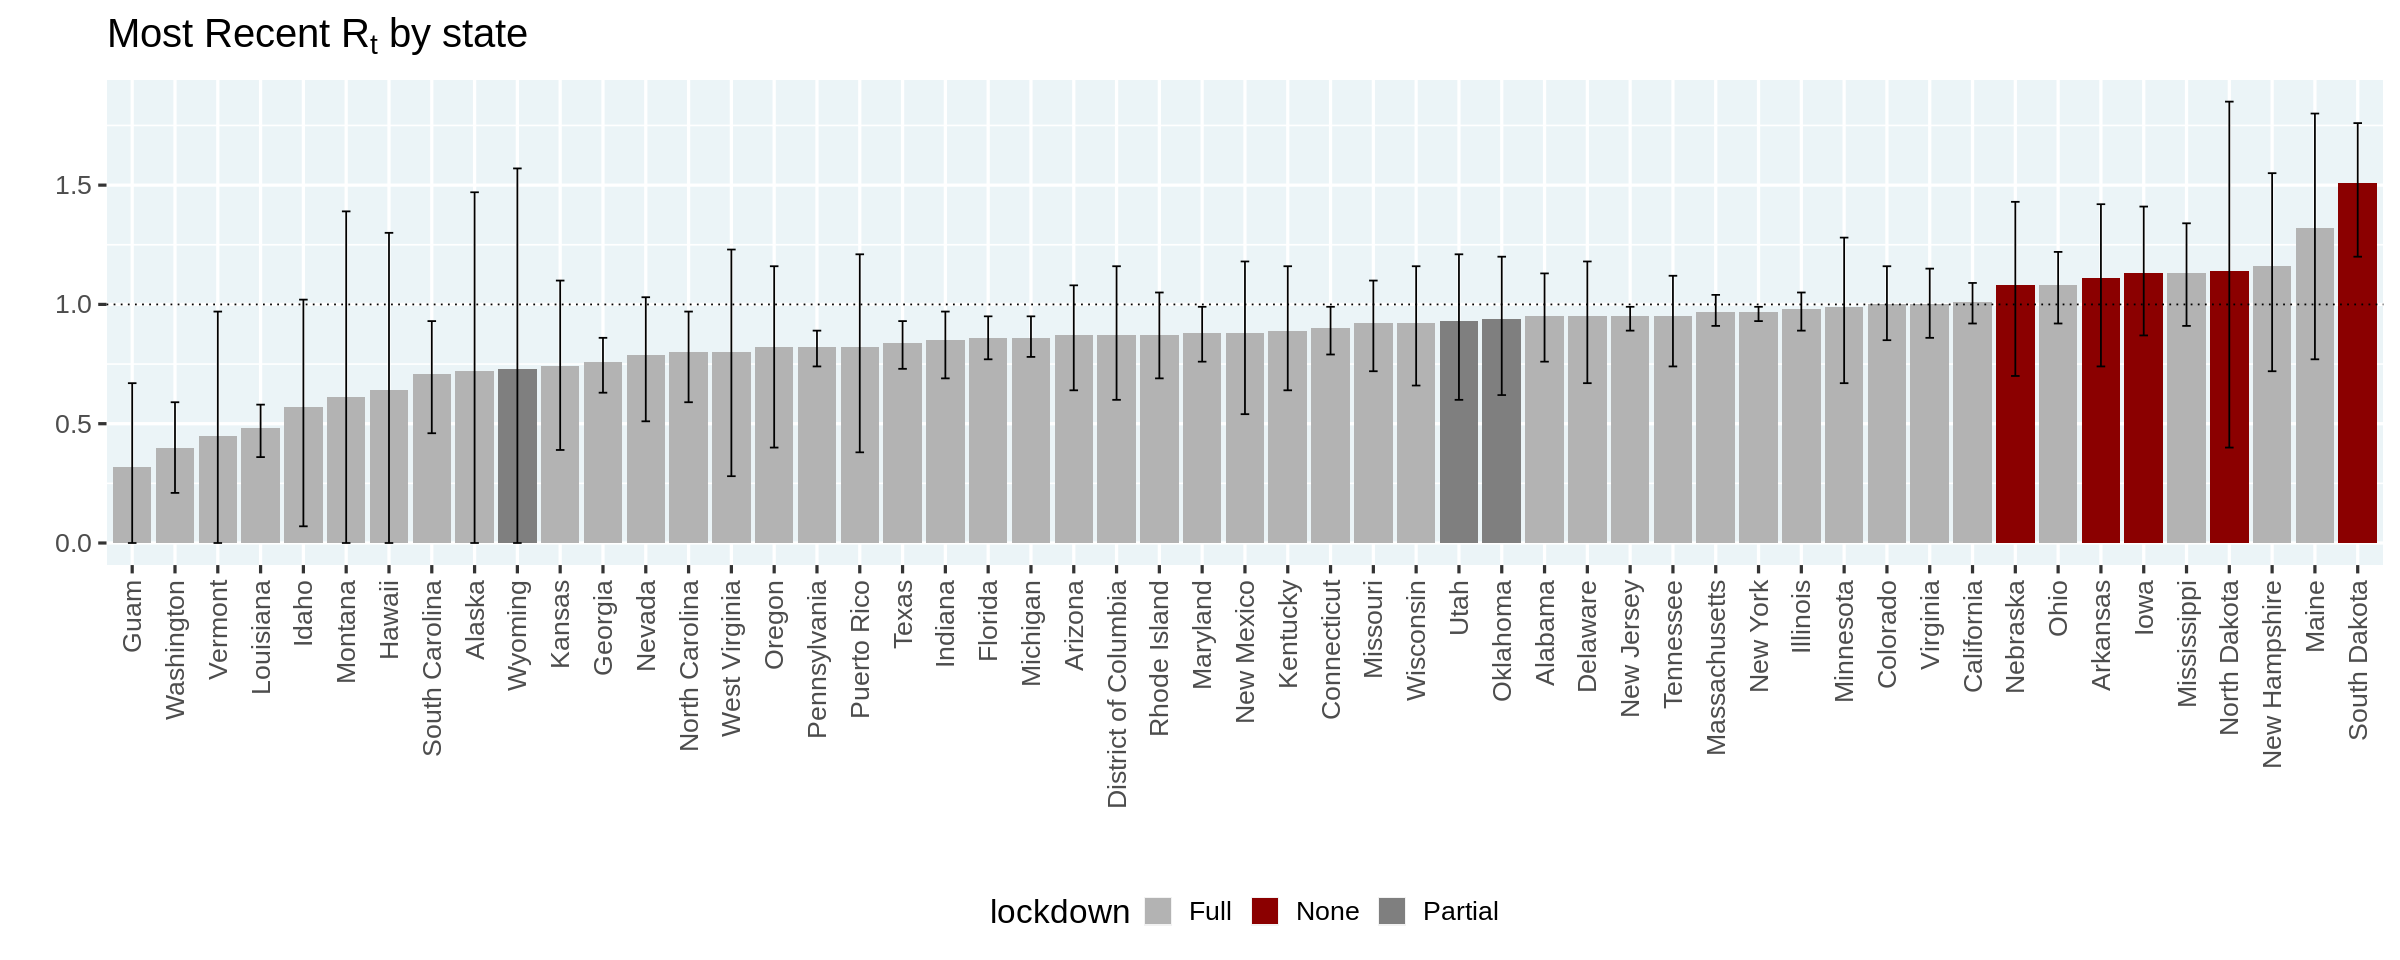
अंत में, आइए केविन के लेख में दिए गए उस प्लॉट को दोबारा बनाएँ जो राज्यों को $R_t$ के सर्वाधिक संभावित आकलित मान के आधार पर क्रमबद्ध करता है, और उन्हें लॉकडाउन की स्थिति के आधार पर रंग देता है।
⚠️ कृपया ध्यान दें कि यह एक पूर्णतः वर्णनात्मक प्लॉट है और इससे लॉकडाउन की प्रभावशीलता पर कोई निष्कर्ष नहीं निकाला जा सकता
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
इस लेख में, हमने tidyverse का उपयोग करते हुए R में केविन के विश्लेषण को दोहराया। हमने likelihoods और posteriors की गणना करने के लिए कुछ उपयोगी तकनीकें सीखीं। इस प्रक्रिया में मैंने बहुत कुछ सीखा!
मैं कई अगले कदमों के बारे में सोच सकता हूँ, लेकिन एक प्रमुख कदम पर प्रकाश डालूँगा जो दिमाग में आता है। चूँकि इस लेख में विकसित फ़ंक्शन तीन कॉलम वाली एक साधारण इनपुट तालिका पर निर्भर करते हैं: location, date, cases, तो अगला रोचक कदम इसे एक R पैकेज में बदलना होगा। इससे अन्य भौगोलिक क्षेत्रों के लिए $R_t$ का आकलन करना आसान हो जाएगा।
मैं Kevin Systrom को एक दिलचस्प पोस्ट प्रकाशित करने और अपना कोड साझा करने के लिए धन्यवाद देकर समाप्त करना चाहूँगा। मैं अपने सहयोगियों का भी DataCamp में इस लेख के प्रारंभिक संस्करण पर उनके उत्कृष्ट फीडबैक के लिए धन्यवाद देना चाहूँगा।
यदि आपके पास इस लेख पर कोई फीडबैक/टिप्पणियाँ हैं, या अन्य एक्सटेंशनों का सुझाव देना चाहते हैं, तो आप मुझे ट्विटर पर @ramnath_vaidya और github पर पा सकते हैं। R प्रोग्रामिंग के बारे में और जानने के लिए
R के बारे में और जानें
कोर्स
कोर्स
कोर्स