Cours
Introduction à R
4 h
3.1M
Suivez Ramnath Vaidyanathan sur Twitter. Cette analyse a été publiée à l’origine sur Google Colab.
Kevin Systrom a publié un article passionnant sur l’estimation de $R_t$, le nombre de reproduction effectif. Dans son article, Kevin décrit ce nombre comme :
Le nombre de personnes infectées par une personne contagieuse au temps 𝑡
Kevin a eu la gentillesse de partager son code sous forme de notebook sur GitHub. Je voulais aller plus loin avec son modèle et l’appliquer à d’autres pays. Étant bien plus à l’aise en R, j’ai d’abord souhaité répliquer ses résultats en R.
Avant de lire la suite, je vous recommande vivement de consulter l’article original pour bien comprendre l’approche de modélisation utilisée, car ce billet se concentre davantage sur le code.
Tout le crédit pour l’approche et le code revient à Kevin 👍. Ce notebook est ma modeste tentative de traduction de son modèle en R. Les éventuelles erreurs restantes sont entièrement les miennes.
Nous allons suivre l’approche décrite par Kevin, qui s’appuie sur l’article de Bettencourt & Ribeiro.
La première étape consiste à modéliser le processus « d’arrivée » des infections. Un choix courant chez les statisticiens pour modéliser des arrivées est la loi de Poisson. Si l’on note $\lambda$ le taux moyen d’infections par jour, la probabilité d’observer $k$ nouveaux cas un jour donné est
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Dans ce cadre, on peut construire la distribution de probabilité des nouveaux cas pour un ensemble de valeurs de $\lambda$. Avant d’écrire du code, chargeons les packages tidyverse et personnalisons quelques options de tracé (dimensions, thèmes, etc.). Vous pouvez ignorer la lecture de cette section si vous le souhaitez, mais pensez à exécuter le code.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Nous pouvons utiliser la fonction crossing de purrr pour calculer les densités de probabilité sur une combinaison de $k$ et de $\lambda$. C’est élégant, mais pas optimal en calcul, car on n’exploite pas la vectorisation de dpois. Vous verrez une approche plus efficace un peu plus loin.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Visualisons ces probabilités avec ggplot2. Remarquez l’usage de expression pour afficher des symboles mathématiques dans les graphiques. Plus d’infos dans la doc de plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
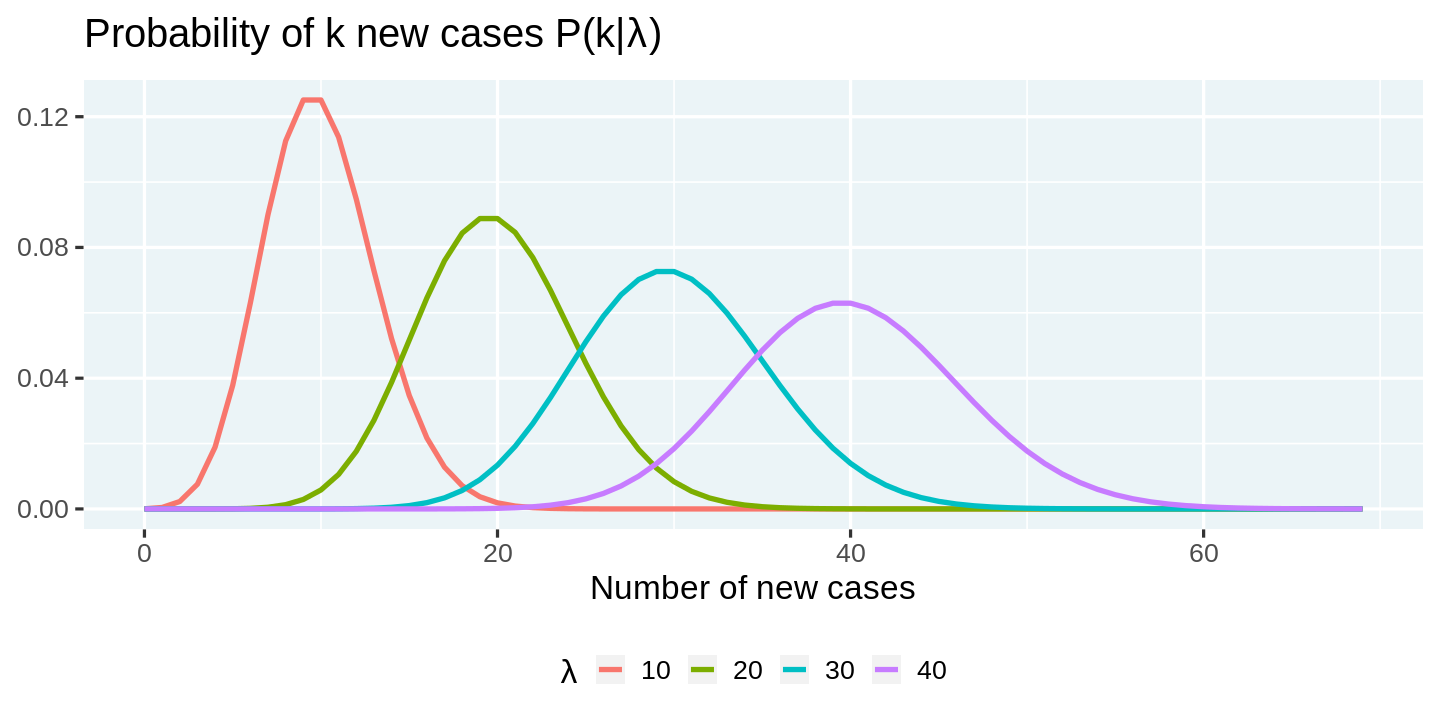
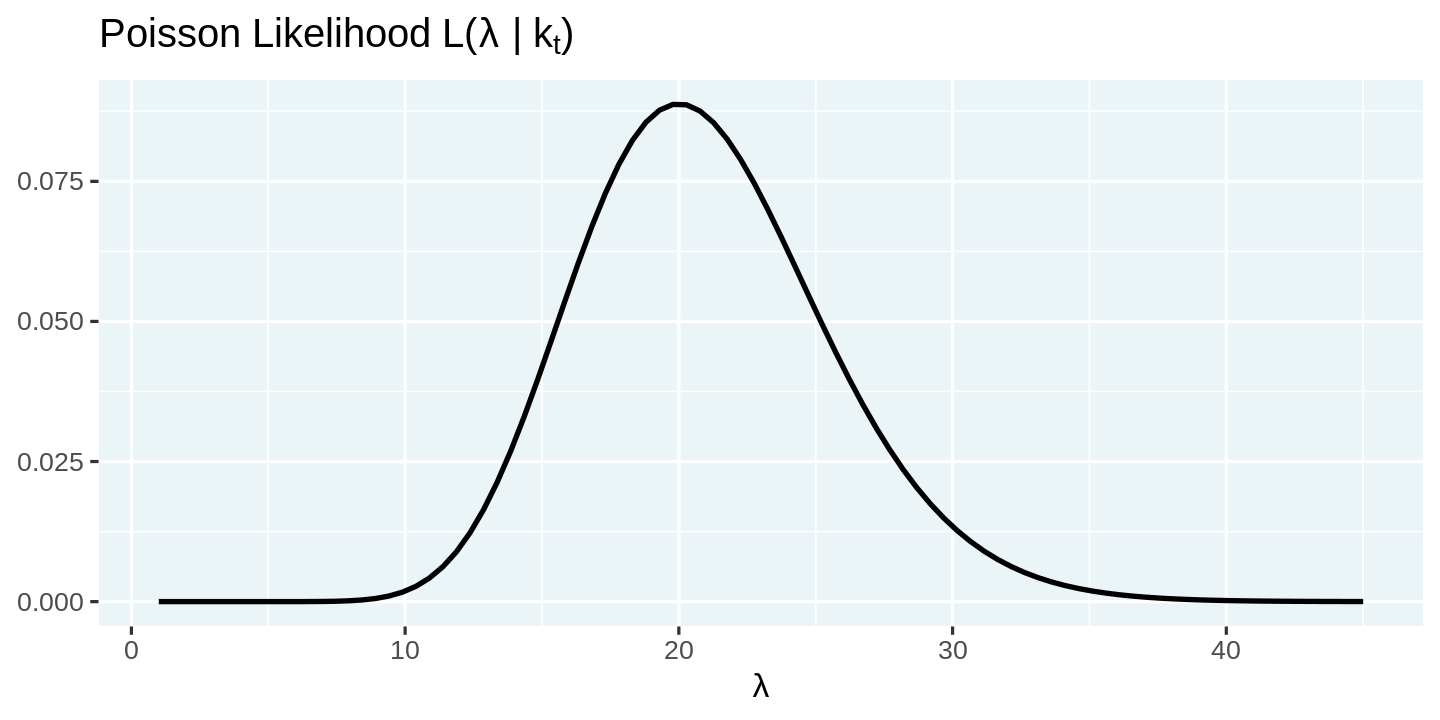
Modéliser les arrivées par une loi de Poisson permet de prédire la distribution des nouveaux cas en fonction du taux $\lambda$. En pratique, nous n’observons que le nombre d’arrivées. La question clé est donc : comment passer de ce nombre observé à une distribution plausible de $\lambda$ ? Heureusement, la réponse est simple.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
La distribution de $\lambda$ conditionnelle à k est la fonction de vraisemblance, et elle a la même forme que la fonction de masse de probabilité utilisée plus haut. On peut la visualiser en fixant k (nouveaux cas observés) et en évaluant $\lambda$ sur un intervalle.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Tout cela est bien, mais où intervient le taux d’infection effectif $R_t$ évoqué au début ? Quel lien avec $\lambda$ ? D’après Bettencourt & Ribeiro, la relation est simple :
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Ici, $\gamma$ est l’inverse de l’intervalle sériel (environ 4 jours pour la COVID-19) et $k_{t-1}$ est le nombre de nouveaux cas observés à l’intervalle $t-1$.
On peut utiliser cette expression de $\lambda$ et réécrire la vraisemblance en fonction de $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Avant d’aller plus loin, posons quelques paramètres clés.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
Le code ci-dessous illustre une manière plus efficace de calculer les vraisemblances. Plutôt que de générer $\lambda$ et les vraisemblances pour chaque combinaison séparément, on exploite la vectorisation de R et les data frames imbriqués. On obtient ainsi un vecteur de $\lambda$ et de vraisemblances par jour, puis on aplatit avec tidyr::unnest.
Au-delà du gain de performance, ce code est plus lisible et colle de près aux formules.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Nous pouvons maintenant tracer la vraisemblance conditionnelle au nombre de cas observés.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
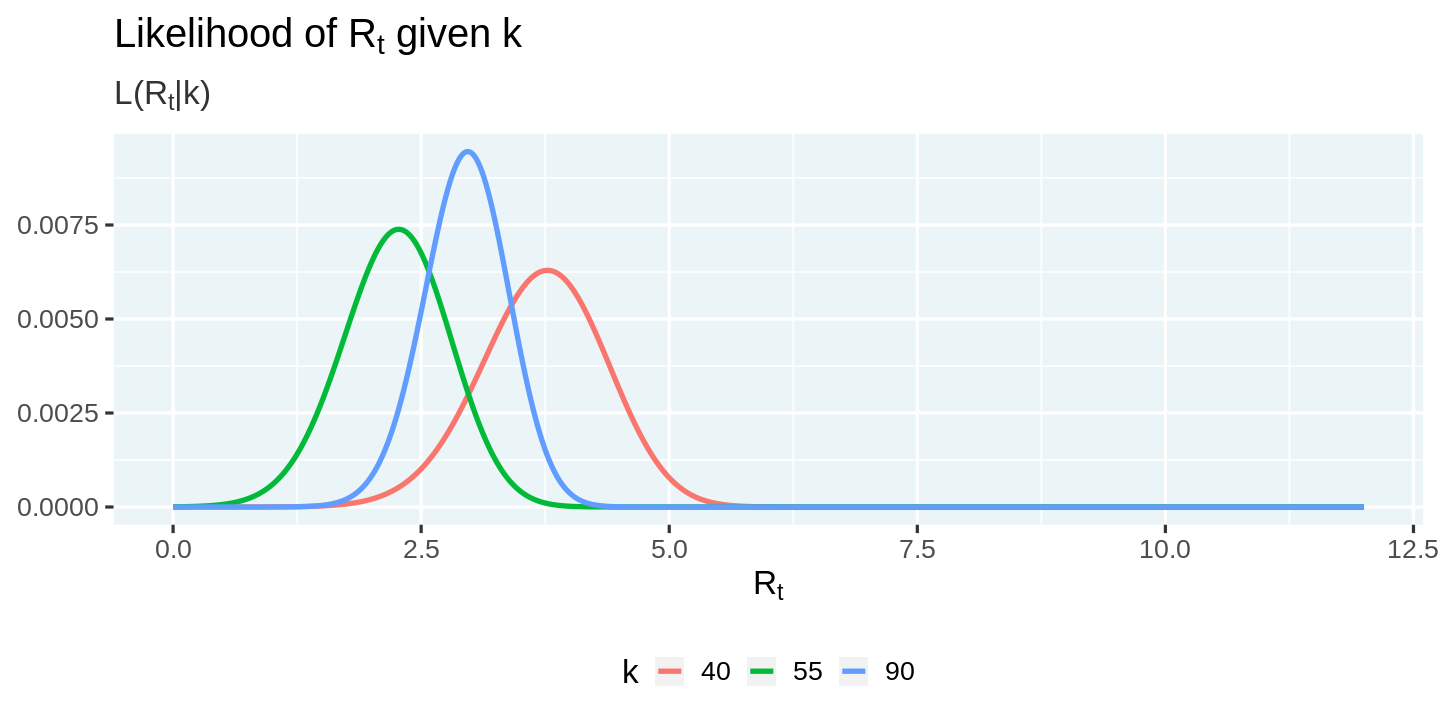
Nous avons bien avancé pour relier le nombre de nouveaux cas $k$ et le taux d’infection effectif $R_t$. Mais il nous manque encore une méthode concrète pour l’estimer à partir d’une série temporelle. C’est ici que la règle de Bayes est précieuse. Bettencourt & Ribeiro expriment la distribution de $R_t$ comme :
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin vulgarise ainsi cette équation :
Cela signifie qu’après avoir observé 𝑘 nouveaux cas, nous pensons que la distribution de 𝑅𝑡 est égale à :
- la distribution a priori $P(R_t)$ sans les données…
- multipliée par la vraisemblance d’observer $k$ nouveaux cas donné $R_t$…
- divisée par la probabilité d’observer autant de cas en général.
Si l’on utilise la probabilité a posteriori de la période précédente, $P(R_{t-1} | k_{t-1})$, comme a priori $P(R_t)$ pour la période courante, on peut réécrire :
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
En itérant jusqu’à $t = 0$, on obtient
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Avec un a priori uniforme $P(R_0)$, cela devient :
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Nous pouvons maintenant calculer l’a posteriori à partir des vraisemblances. On utilise la fonction vectorisée cumprod pour générer les postérieurs de tous les jours, puis on les normalise.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Visualisons maintenant la distribution a posteriori.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
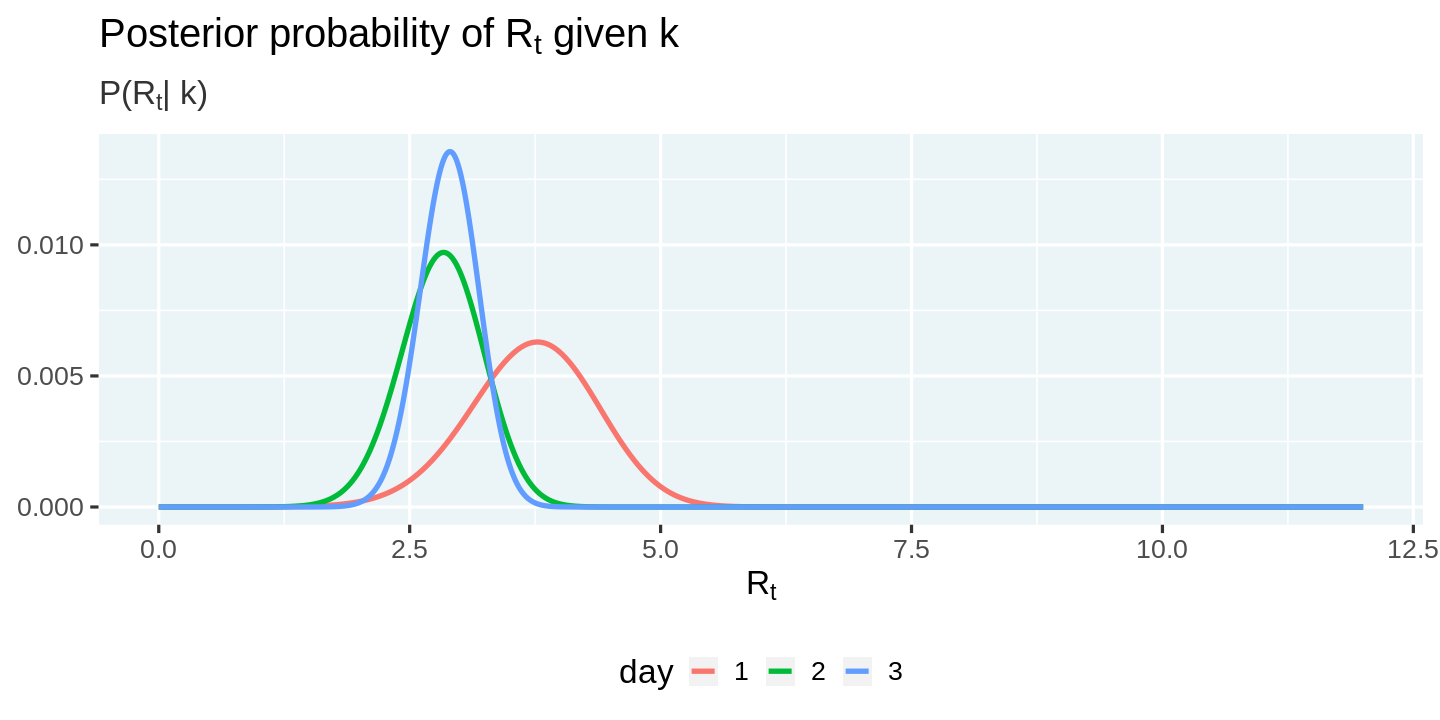
Ces postérieurs nous permettent de répondre à la question essentielle :
Quelle est la valeur la plus probable de $R_t$ chaque jour ?
Lorsqu’on estime une quantité, il est crucial d’indiquer l’incertitude. Une méthode répandue consiste à utiliser les intervalles de densité maximale (HDI).
Une autre façon de résumer une distribution est l’intervalle de densité maximale, qui spécifie un intervalle couvrant, par exemple, 95 % de la distribution, tel que chaque point à l’intérieur a une crédibilité supérieure à tout point à l’extérieur.
Dans son article, Kevin implémente un algorithme « brute force » pour calculer le HDI. Les utilisateurs R ont de la chance : le package HDInterval propose déjà une implémentation 🎉.
Nous allons maintenant estimer la valeur la plus probable de $R_t$ et l’intervalle de densité maximale associé. Comme HDInterval::hdi attend un échantillon aléatoire, et que nous n’avons que des probabilités a posteriori discrètes, nous allons simuler des valeurs de $R_t$ selon ces probabilités pour calculer le HDI.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
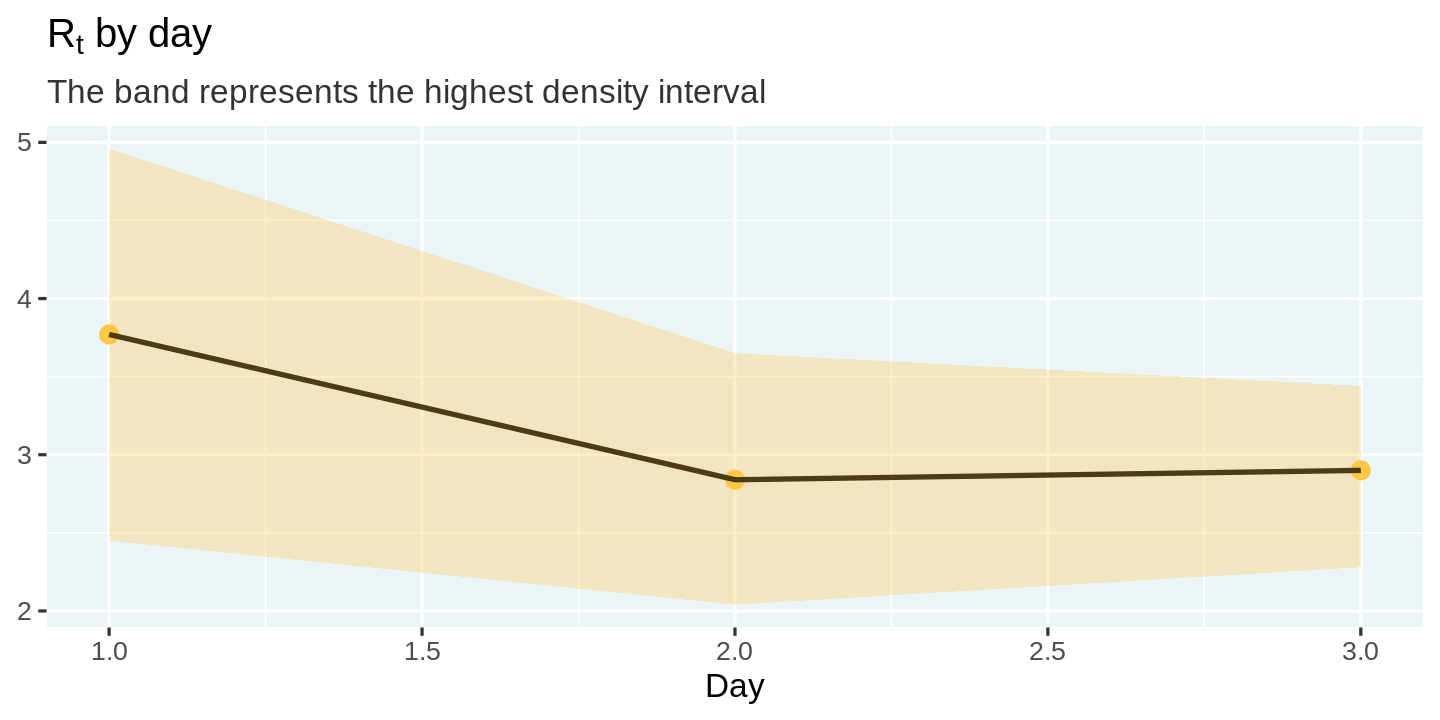
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
On peut visualiser ces estimations et leur incertitude avec une courbe et un ruban.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Si l’approche de Bettencourt et Ribeiro fonctionne, Kevin souligne un problème pratique (également noté dans l’article) : le posterior peut se figer et tendre asymptotiquement vers 1, faute « d’oublier » les périodes avec $R_t$ élevé.
Pour y remédier, Kevin propose :
Je ne prends en compte que les $m$ derniers jours dans la fonction de vraisemblance. Ainsi, l’a priori de l’algorithme est fondé sur le passé récent, bien plus pertinent que l’historique complet de l’épidémie. Ce simple mais important changement donne : $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Nous utiliserons cette modification pour estimer $R_t$ dans les différents États américains.
Mettons maintenant en pratique cette démarche sur les données COVID des États américains afin d’estimer $R_t$. Commençons par récupérer les données du New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
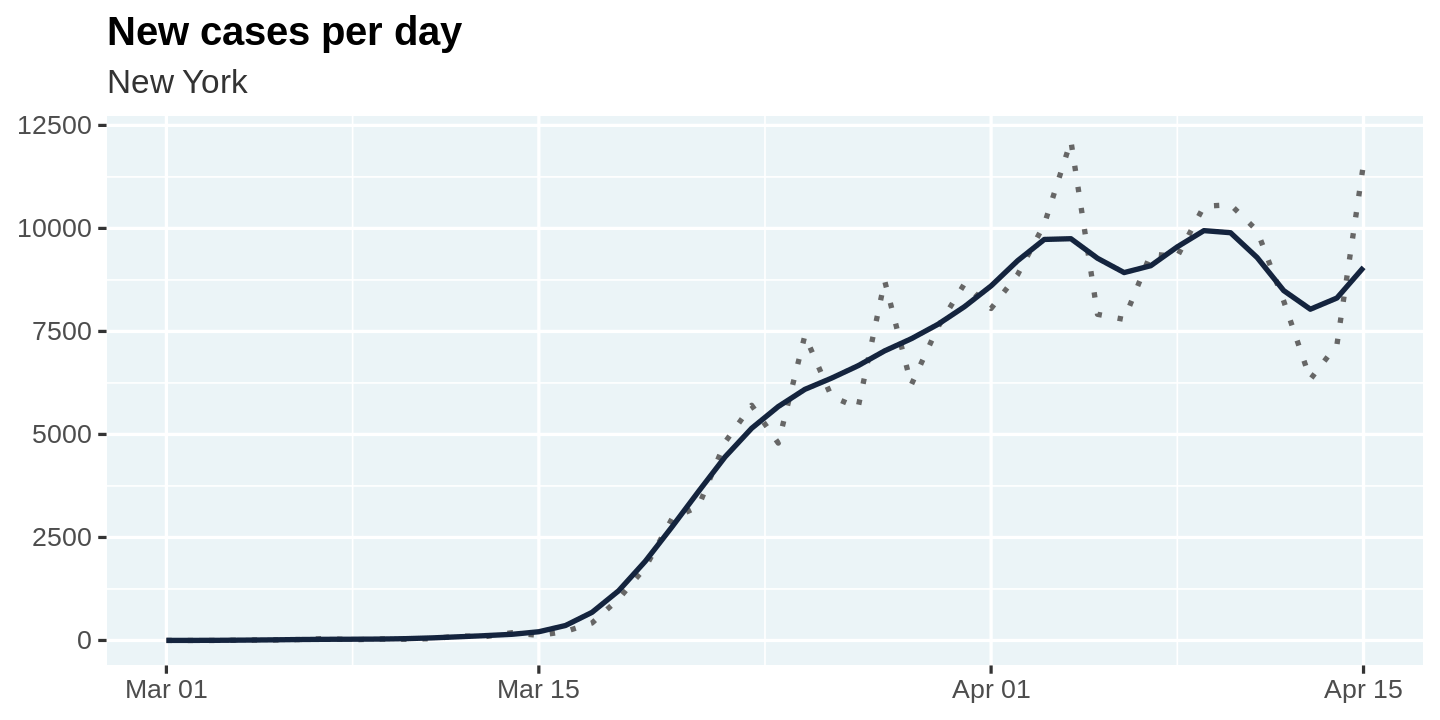
Première étape : préparer les données en calculant les nouveaux cas quotidiens, puis en les lissant avec une fenêtre glissante. Le lissage est essentiel pour corriger les retards de remontée, particulièrement marqués le week‑end.
Comme Kevin, j’utilise un lissage gaussien sur 7 jours.
Nous allons encapsuler chaque étape de préparation dans une fonction dédiée. Cela ajoute un peu de code, mais facilite la composition et l’application multi‑États.
Nous allons appliquer ces étapes à un État pour commencer, afin de mieux interpréter les résultats. J’ai choisi New York, mais changez d’État si vous préférez !
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
Traçons les valeurs brutes et lissées de new_cases pour voir l’effet du lissage.
🎩 Toujours visualiser après une transformation de données : cela renforce l’intuition et valide que la transformation produit l’effet recherché.
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
Deuxième étape : calculer les vraisemblances. Nous allons procéder comme plus haut, avec une différence notable : nous calculerons les log‑vraisemblances. Cela facilite le lissage sur une fenêtre glissante pour n’utiliser que les $m$ derniers intervalles, comme le suggère Kevin.
Comme précédemment, nous calculerons les vraisemblances par jour dans une liste imbriquée, puis nous aplatirons avec tidyr::unnest.
🎩 Les colonnes de listes sont très utiles dans de nombreux cas d’usage de données.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
Troisième étape : calculer les probabilités a posteriori. Rappel :
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
On peut réécrire en termes de log‑vraisemblances :
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Nous utilisons zoo::rollapplyr pour sommer sur 7 jours glissants les log‑vraisemblances, puis nous exponentions pour obtenir l’a posteriori et normalisons à 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
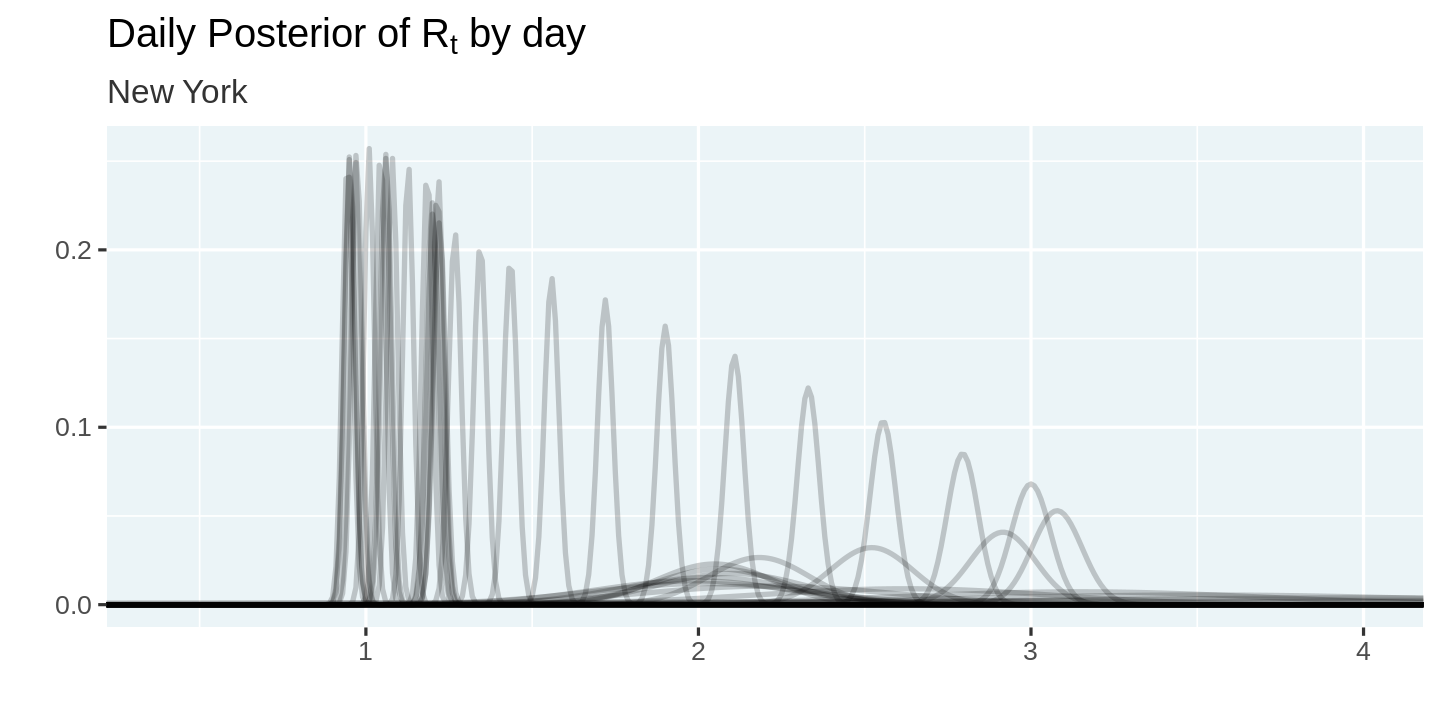
Traçons les probabilités a posteriori calculées. Notez l’alpha = 0.2 pour limiter le sur‑tracé et visualiser le glissement des postérieurs.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
Dernière étape : estimer les valeurs de $R_t$ et leurs intervalles de densité maximale. Rappel : nous devons simuler des valeurs de $r_t$ à partir des postérieurs pour utiliser HDIInterval::hdi.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Moment de vérité ! Visualisons les estimations de $R_t$.
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
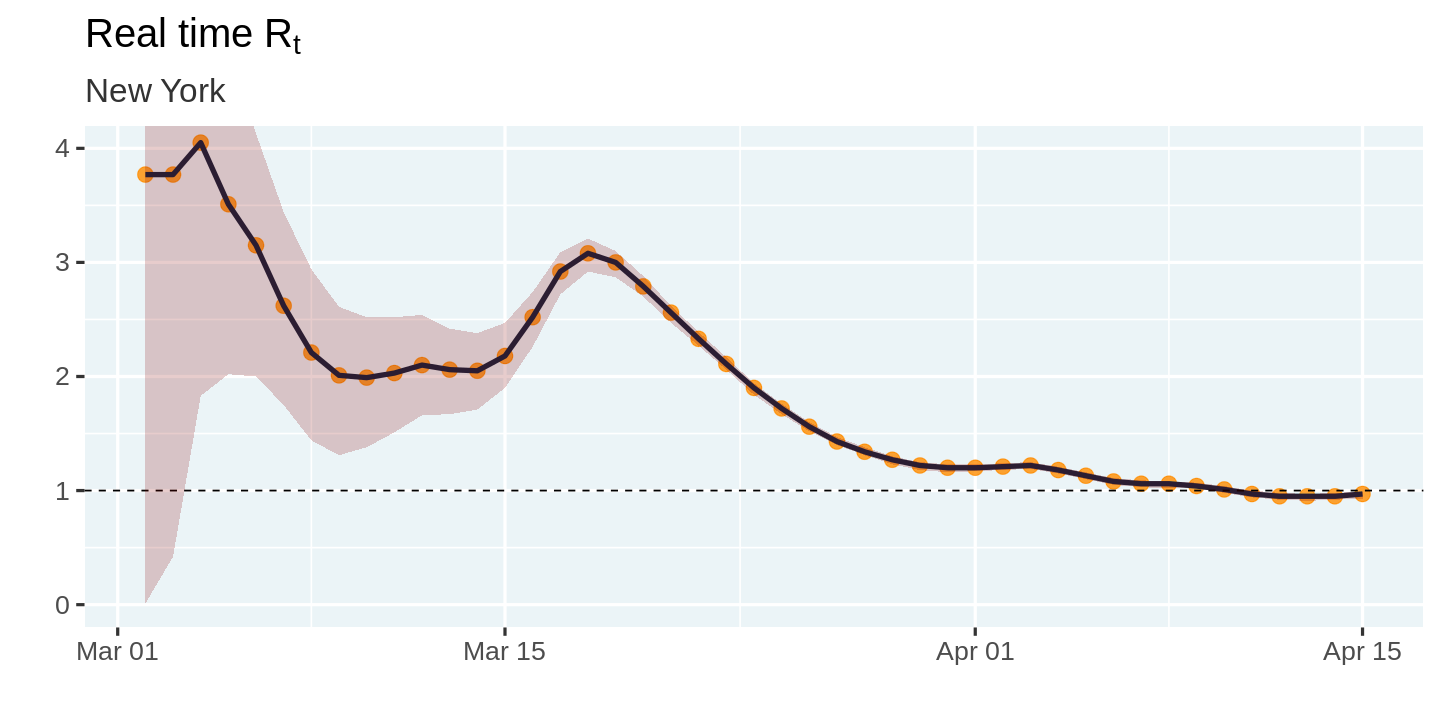
Comment cela se compare‑t‑il aux estimations de Kevin ? Mes estimations initiales semblent diverger un peu, sans doute en raison des différences de lissage ou de la forte incertitude au début. La forme globale et les pics concordent toutefois assez bien. Objectif atteint ! 🎉
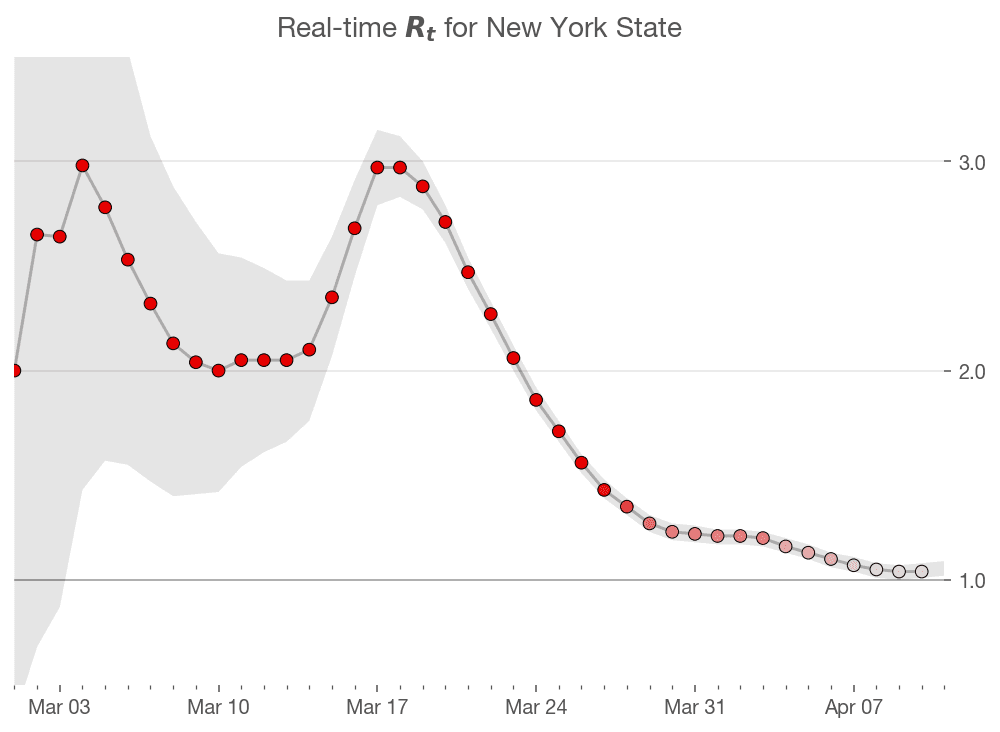
Il est temps de boucler sur tous les États et de calculer ces estimations. On peut le faire simplement en groupant par state, en scindant en une table par État, puis en utilisant purrr::map_df pour estimer $R_t$ et recombiner le tout.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
Créons à présent une grille de petits multiples pour tous les États. Avec ggplot2, c’est très simple : une seule ligne en plus !
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
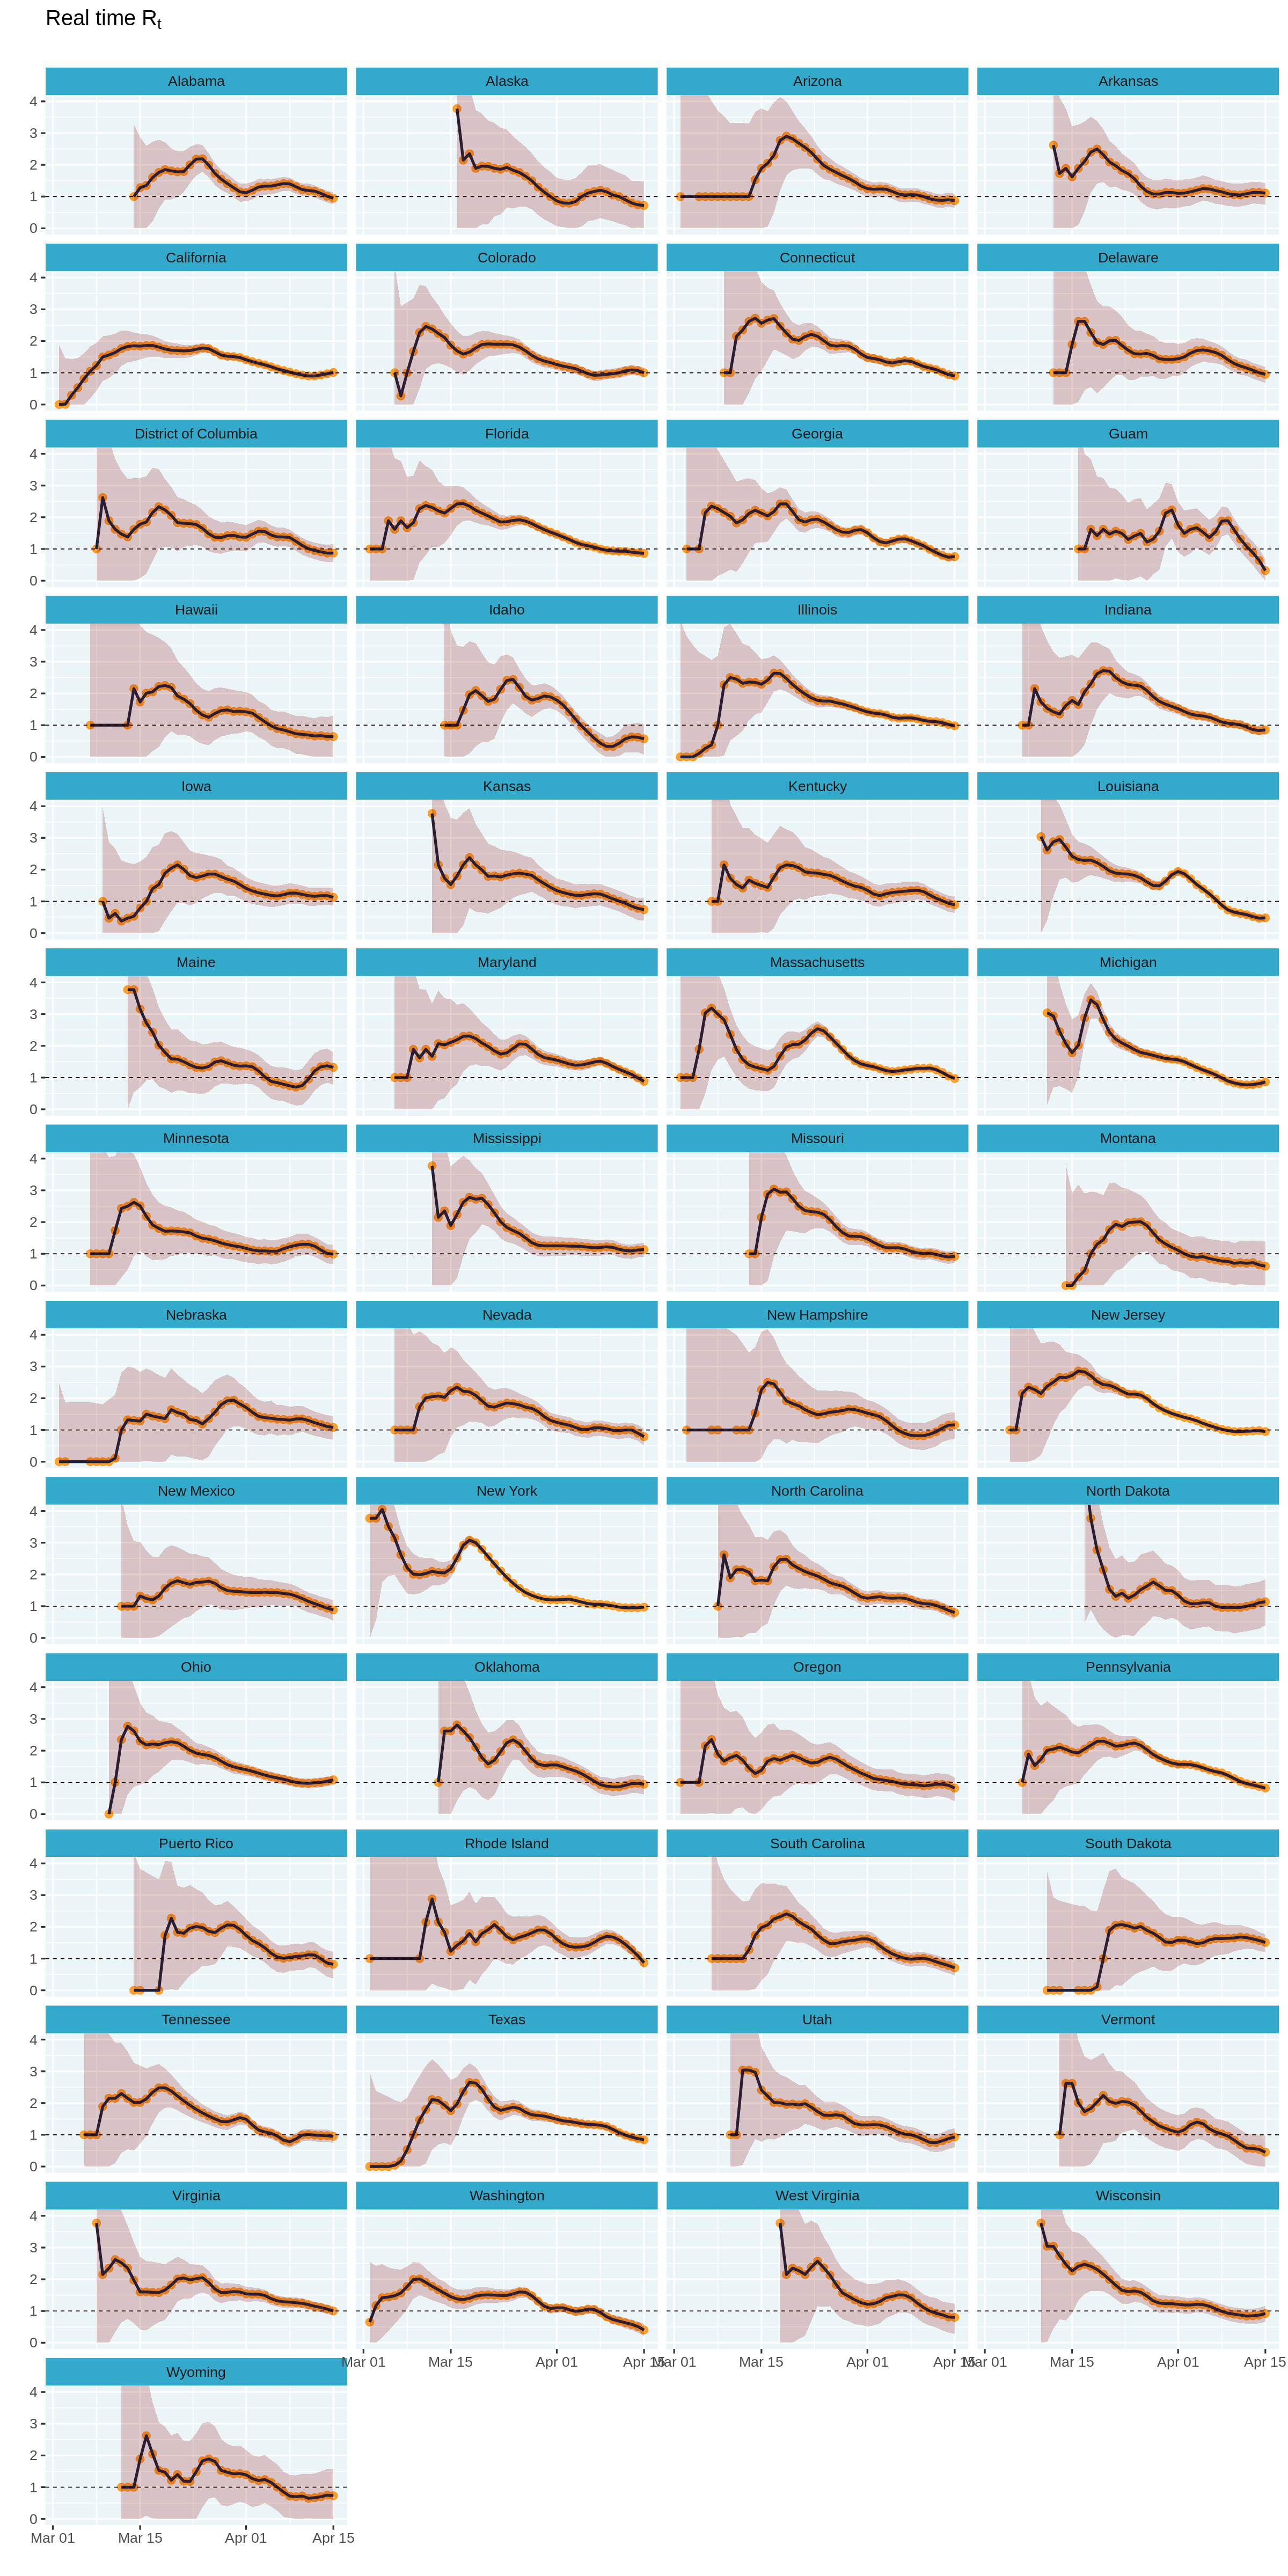
Bien que ces petits multiples soient utiles, il est difficile de naviguer par position géographique. Et si nous placions chaque État à peu près à son emplacement ?
Heureusement, Ryan Hafen a créé le package geofacet qui permet de disposer ces facettes sur une grille géographique en une seule ligne.
⚠️ Je n’ai pas pu installer geofacet sur Colab (probablement à cause de dépendances système requises par sf), le bloc ci‑dessous échouera donc. J’ai inclus une image générée localement pour donner une idée du rendu.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

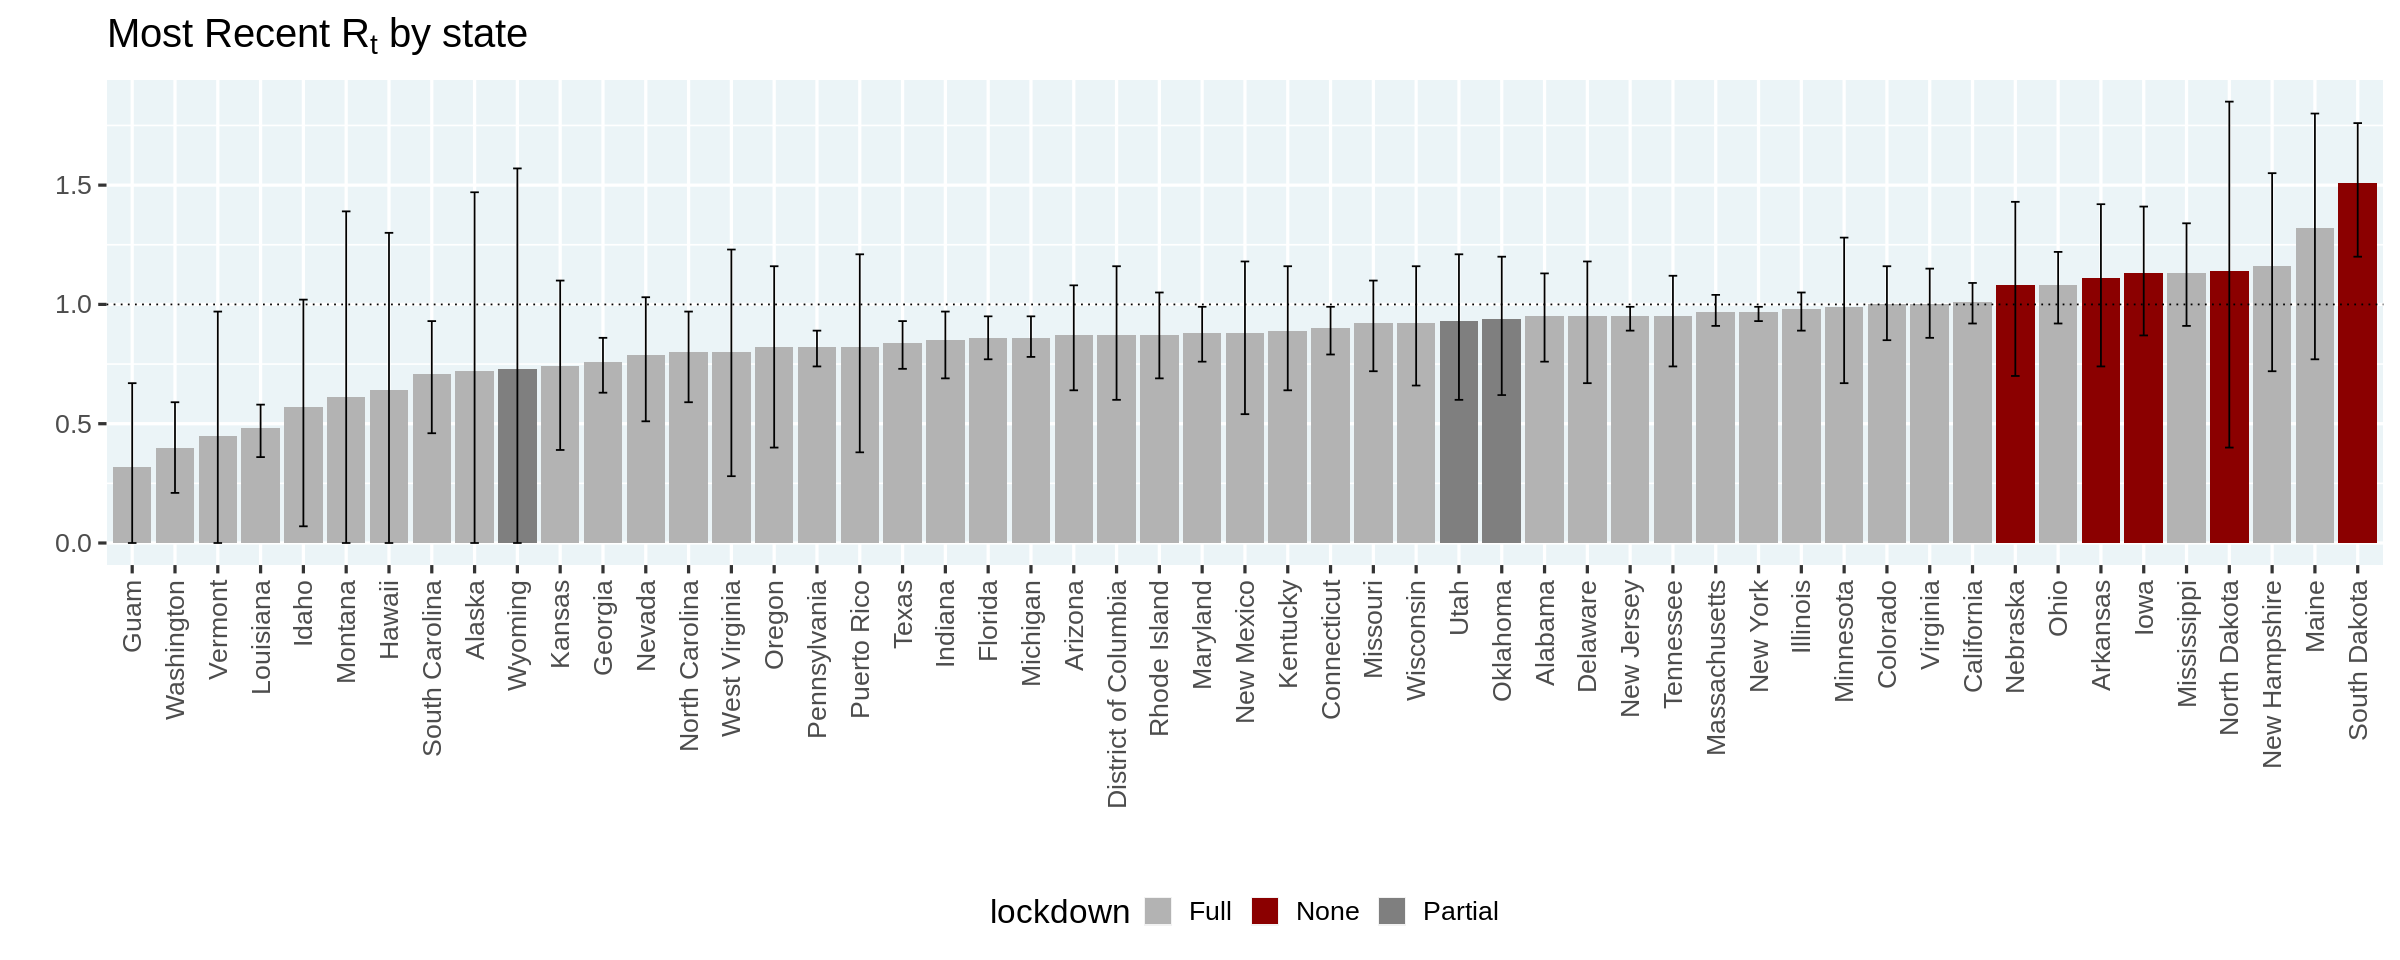
Enfin, recréons le graphique de l’article de Kevin qui classe les États selon la valeur estimée la plus probable de $R_t$, avec une couleur selon l’état du confinement.
⚠️ Attention : ce graphique est purement descriptif et ne permet pas de conclure sur l’efficacité des confinements.
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
Dans cet article, nous avons reproduit en R, avec le tidyverse, l’analyse de Kevin. Nous avons vu des astuces utiles pour calculer vraisemblances et postérieurs. J’ai énormément appris au passage !
Plusieurs suites sont possibles, mais j’en souligne une : comme nos fonctions reposent sur une table d’entrée simple à trois colonnes (location, date, cases), une piste intéressante serait d’en faire un package R. Cela faciliterait l’estimation de $R_t$ pour d’autres zones géographiques.
Je remercie Kevin Systrom pour son article et le partage de son code, ainsi que mes collègues chez DataCamp pour leurs excellents retours sur une première version.
Si vous avez des commentaires ou des idées d’extensions, retrouvez‑moi sur Twitter @ramnath_vaidya et sur GitHub. Pour en savoir plus sur la programmation R
Approfondir R
Cours
Cours
Cours