Curso
Introdução ao R
4 h
3.1M
Siga Ramnath Vaidyanathan no Twitter. Esta análise foi publicada originalmente no Google Colab.
Kevin Systrom publicou um artigo muito interessante sobre como estimar $R_t$, a medida conhecida como número reprodutivo efetivo. No artigo, Kevin descreve esse número como:
O número de pessoas que são infectadas por cada pessoa infecciosa no tempo 𝑡
Kevin gentilmente disponibilizou seu código em um notebook no github. Eu queria explorar mais o modelo e aplicá-lo a outros países. Porém, como sou bem mais proficiente em R, decidi primeiro replicar os resultados dele em R.
Antes de continuar, recomendo fortemente que você leia o artigo original para entender melhor a abordagem de modelagem usada, já que este post é mais focado no código.
Todo o crédito pela abordagem e pelo código é do Kevin 👍. Este notebook é minha tentativa humilde de traduzir o modelo dele para R. Quaisquer erros que restarem são de minha responsabilidade.
Vamos usar a mesma abordagem descrita pelo Kevin no artigo, que se baseia no trabalho de Bettencourt & Ribeiro.
O primeiro passo é modelar o processo de "chegada" das infecções. Uma escolha popular entre estatísticos para a distribuição de chegadas é a distribuição de Poisson. Assim, se deixarmos $\lambda$ representar a taxa média de infecções por dia, então a probabilidade de observarmos $k$ novos casos em um dia é dada por
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Com essa estrutura, podemos construir a distribuição de probabilidade de novos casos para um conjunto de valores de $\lambda$. Antes de partir para o código, precisamos carregar os pacotes do tidyverse e ajustar algumas opções de plotagem (dimensões, tema etc.). Se quiser, você pode pular esta seção — ela não é crítica para a narrativa — mas certifique-se de executar o código.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Podemos usar a função crossing do purrr para calcular densidades de probabilidade em todas as combinações de $k$ e $\lambda$. É uma abordagem elegante, embora não seja a mais eficiente computacionalmente, já que não aproveita a vetorização do dpois. Em uma seção mais adiante você verá uma forma mais eficiente.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Podemos visualizar essas probabilidades com ggplot2. Veja como usamos expression para renderizar símbolos matemáticos nos gráficos. Mais detalhes na documentação de plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
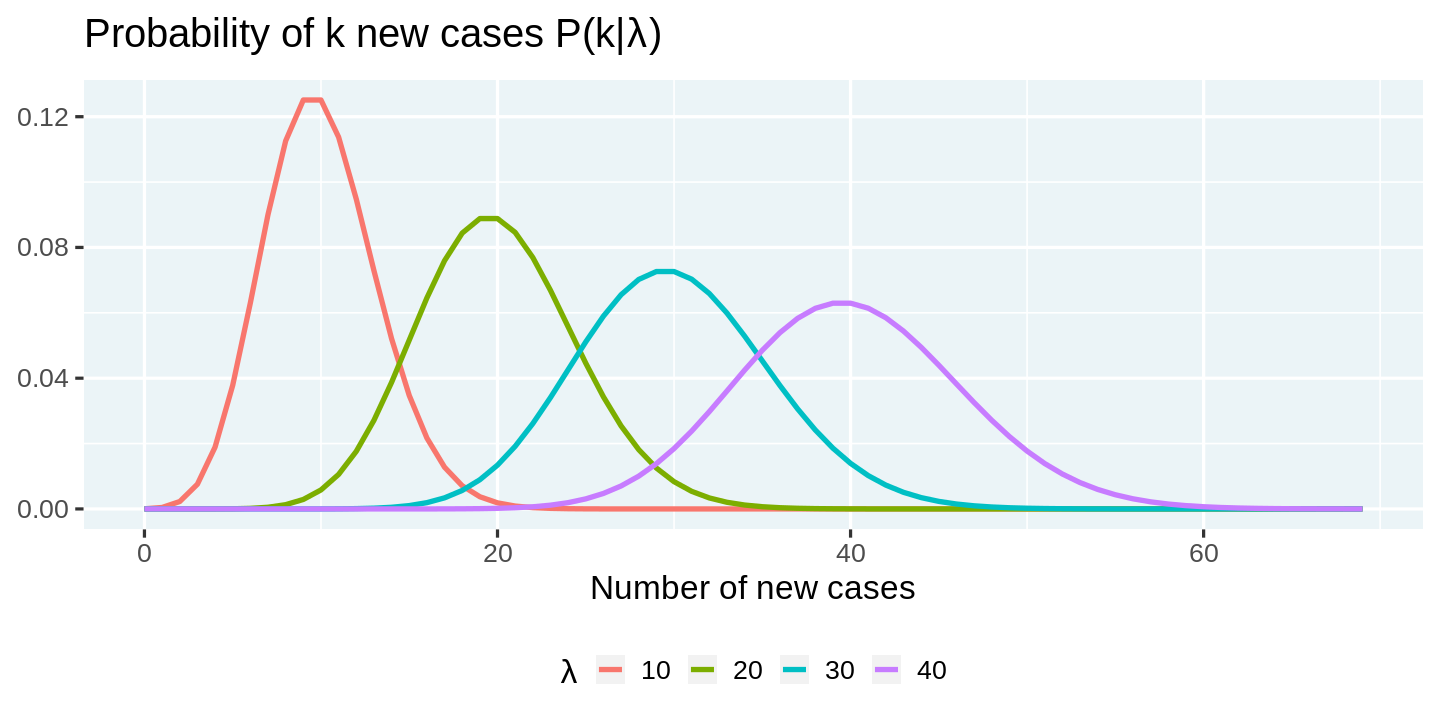
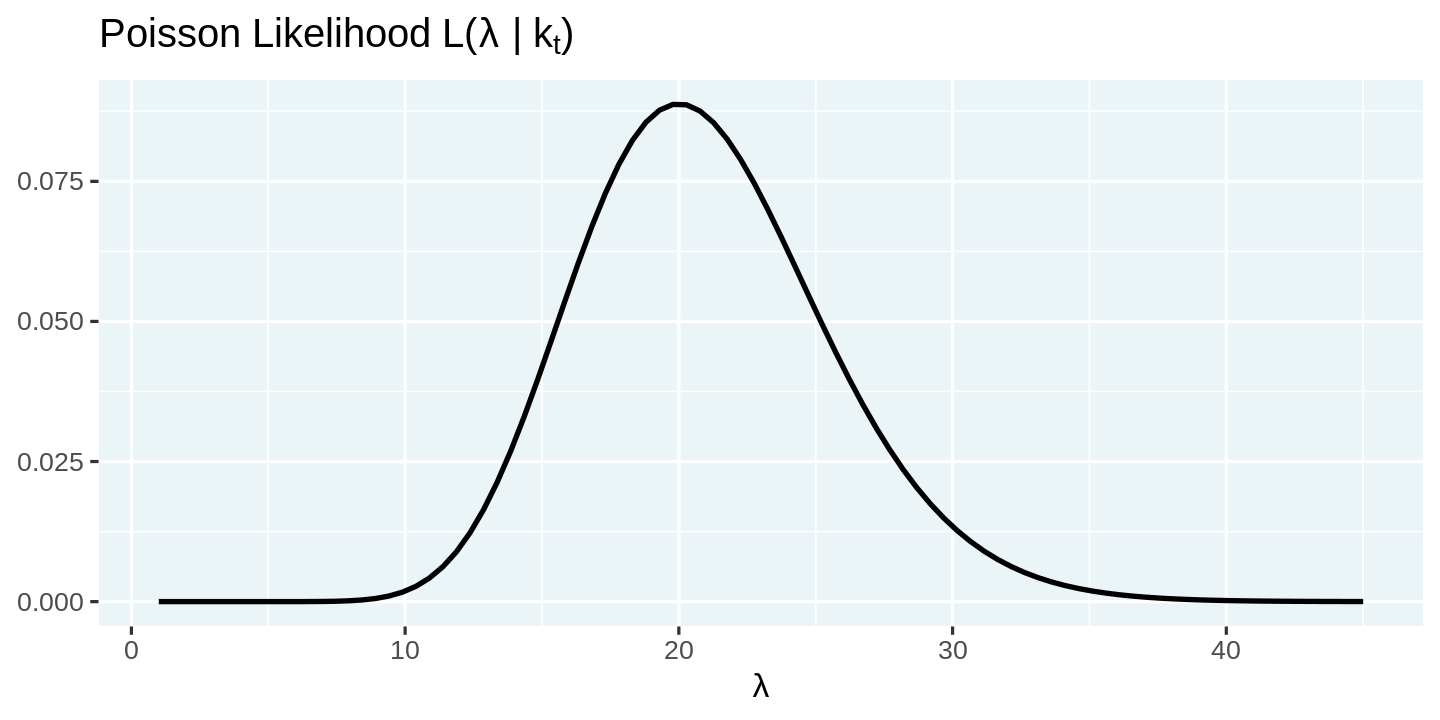
Modelar o processo de chegadas como Poisson nos permite prever a distribuição de novos casos em um dia como função da taxa $\lambda$. Porém, na prática, só observamos o número de chegadas. A pergunta-chave é: como passamos do número observado de chegadas para entender a distribuição de $\lambda$? Felizmente, a resposta é simples.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
A distribuição de $\lambda$ sobre k é chamada de função de verossimilhança, e tem a mesma expressão da função de massa de probabilidade que usamos antes. Podemos visualizar a verossimilhança fixando o número de novos casos observados (k) e calculando-a em uma faixa de valores de $\lambda$.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Tudo muito bom, mas onde entra o $R_t$, a taxa efetiva de infecção, que mencionamos no começo? Como ela se relaciona com a taxa $\lambda$? Segundo o artigo de Bettencourt & Ribeiro, a relação é bem simples:
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Observe que $\gamma$ é o recíproco do intervalo serial (cerca de 4 dias para COVID-19), e $k_{t-1}$ é o número de novos casos observados no intervalo $t-1$.
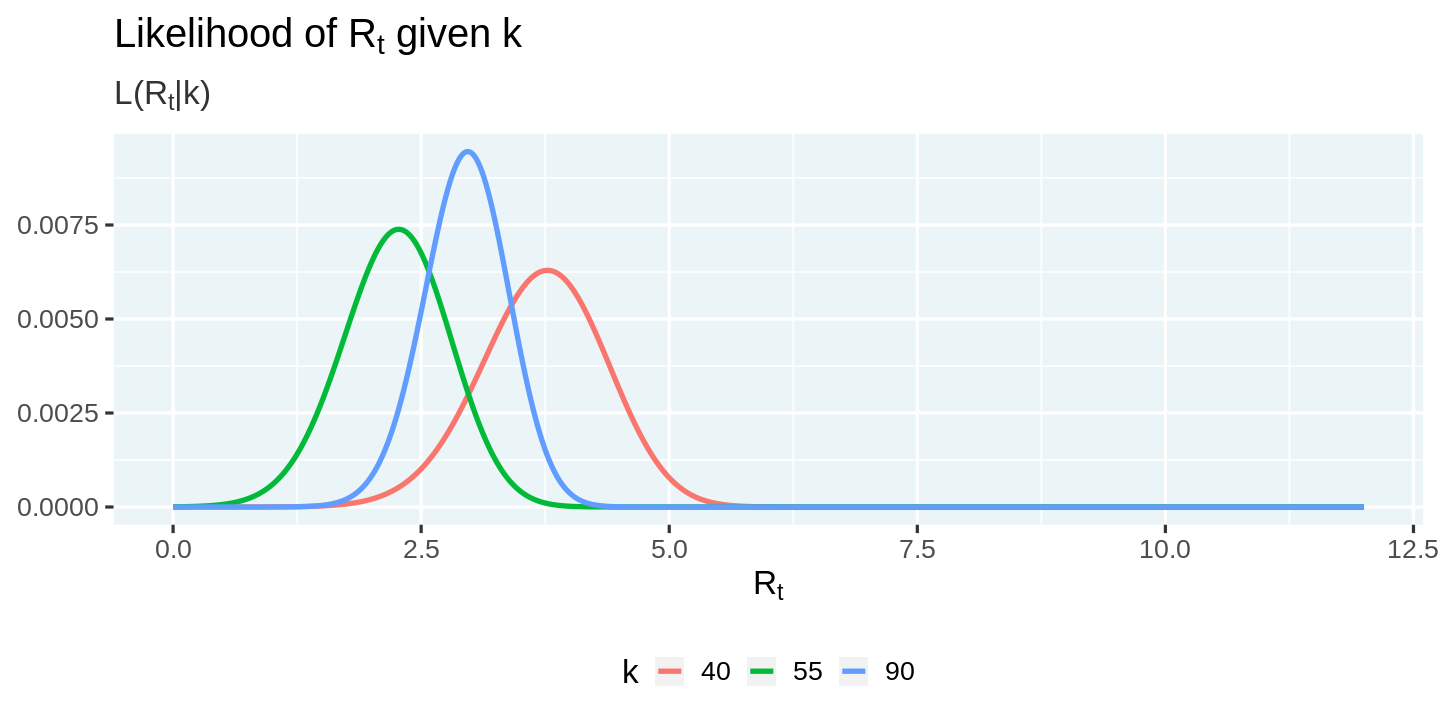
Podemos usar essa expressão para $\lambda$ e reescrever a verossimilhança em termos de $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Antes de avançar, vamos definir alguns parâmetros centrais.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
O código abaixo mostra uma forma mais eficiente de calcular as verossimilhanças. Em vez de gerar lambdas e verossimilhanças para cada combinação separadamente, aproveitamos a vetorização em R e data frames aninhados. Assim, geramos um vetor de lambdas e verossimilhanças por dia e, depois, usamos tidyr::unnest para "achatar" em uma tabela.
Além de eficiente, eu diria que esse código é mais legível e traduz as fórmulas com mínimo atrito.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Agora podemos plotar a verossimilhança condicional ao número de novos casos observados.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
Já avançamos bem ao relacionar o número de novos casos, $k$, com a taxa efetiva de infecção, $R_t$. Mas ainda falta um método prático para estimar seus valores a partir da série temporal de novos casos. É aqui que o onipresente teorema de Bayes ajuda bastante. Bettencourt & Ribeiro expressam a distribuição de $R_t$ como
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin traduz essa equação em termos mais simples.
Isso diz que, após observar 𝑘 novos casos, acreditamos que a distribuição de 𝑅𝑡 é igual a:
- as crenças prévias sobre o valor de $P(R_t)$ sem os dados ...
- vezes a verossimilhança de ver $k$ novos casos dado $R_t$ ...
- dividido pela probabilidade de ver essa quantidade de casos em geral.
Se usarmos a probabilidade a posteriori do período anterior, $P(R_{t-1} | k_{t-1})$, como a priori, $P(R_t)$, do período atual, podemos reescrever a equação como:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Iterando pelos períodos até $t = 0$, obtemos
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Com uma priori uniforme $P(R_0)$, isso se reduz a:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Agora podemos usar essa expressão para calcular a posterior a partir das verossimilhanças. Mais uma vez, usamos a função vetorizada cumprod para gerar as posteriores de todos os dias de uma vez e, depois, normalizamos.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Agora podemos visualizar a distribuição a posteriori.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
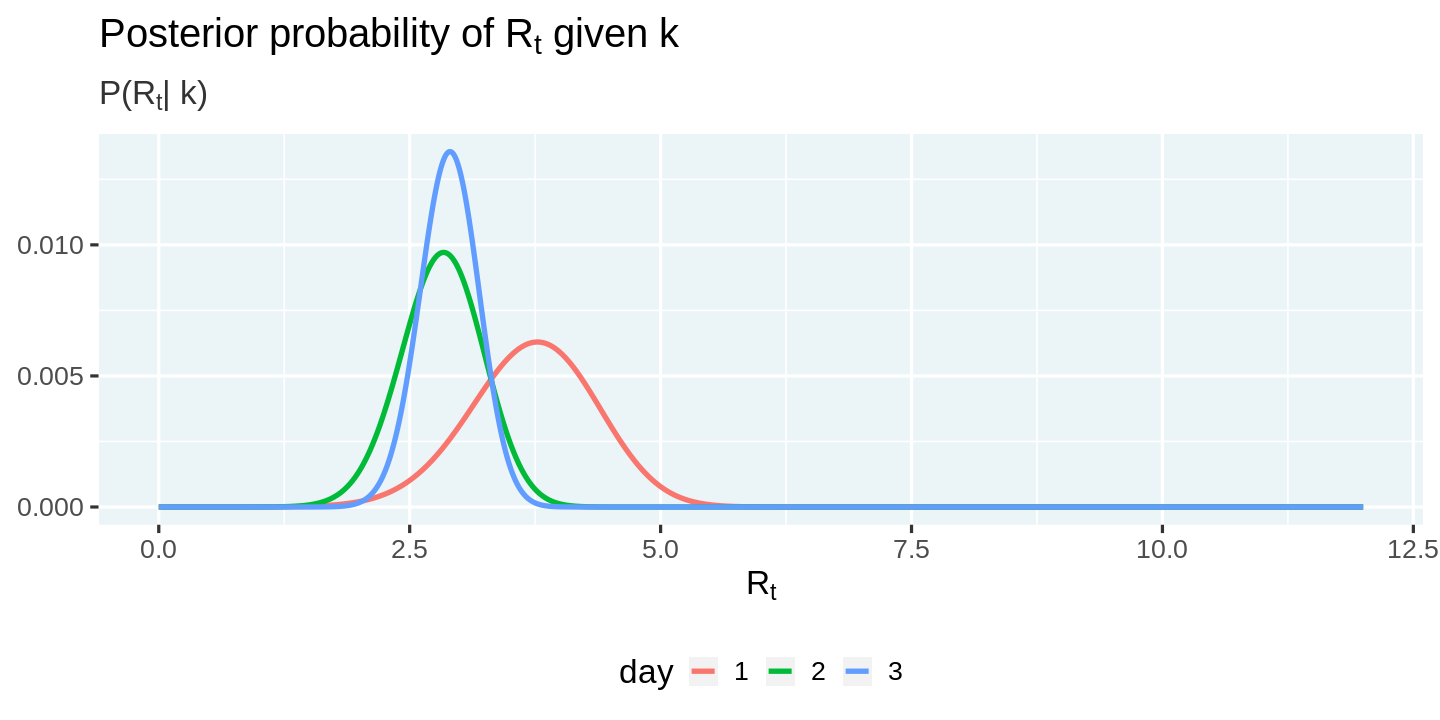
Essas posteriores nos permitem responder à pergunta que não quer calar:
Qual é o valor mais provável de $R_t$ em cada dia?
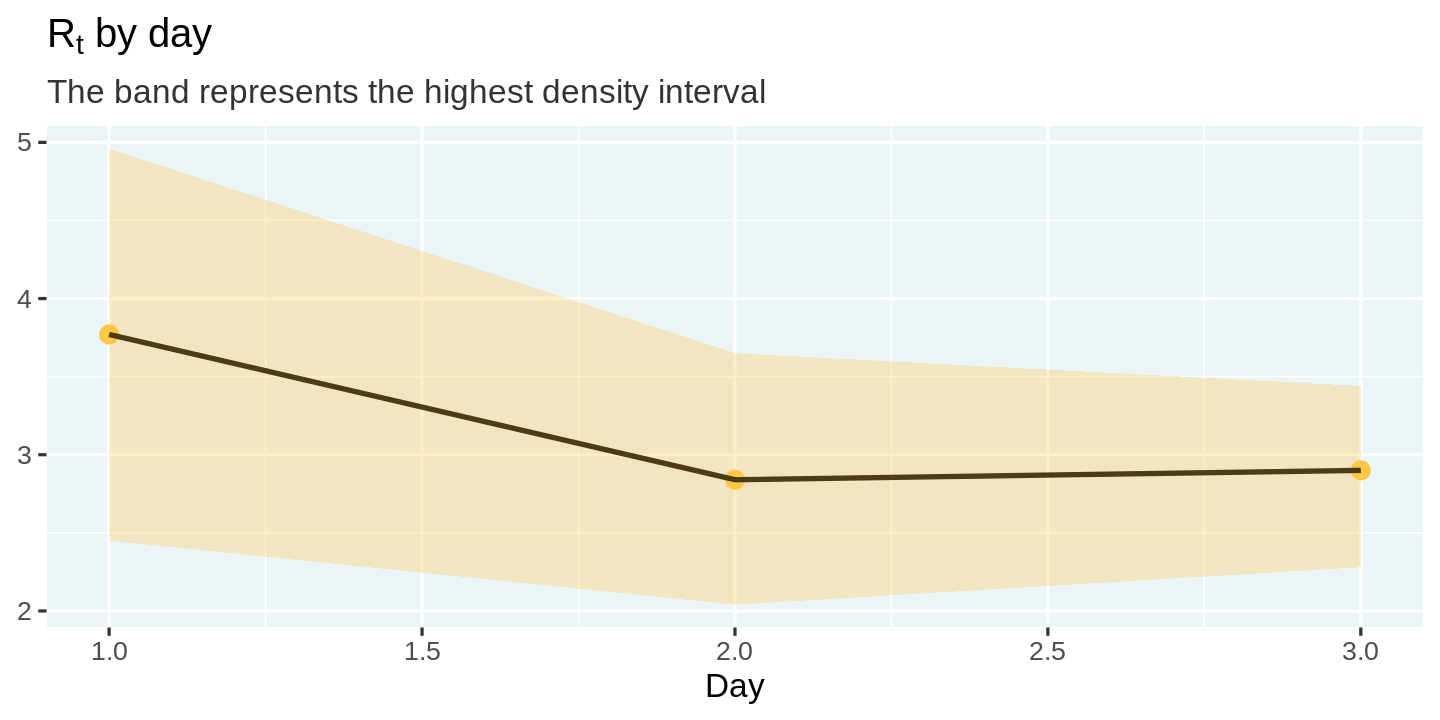
Ao estimar qualquer grandeza, é fundamental indicar a incerteza em torno da estimativa. Uma forma popular é usar os intervalos de maior densidade (HDI).
Outra maneira de resumir uma distribuição é o intervalo de maior densidade, que especifica um intervalo que cobre a maior parte da distribuição, digamos 95%, de modo que todo ponto dentro do intervalo tenha maior credibilidade do que qualquer ponto fora dele.
No artigo, Kevin implementa um algoritmo de força bruta para calcular o HDI. Usuários de R têm sorte: já existe o pacote HDInterval com essa implementação 🎉.
Agora vamos estimar o valor mais provável de $R_t$ e o intervalo de maior densidade ao redor dele. Como a função HDInterval::hdi trabalha com um vetor de amostras aleatórias de uma distribuição, e aqui estimamos apenas probabilidades a posteriori, precisamos simular valores de $R_t$ usando essas probabilidades para calcular o HDI.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
Podemos visualizar essas estimativas e sua incerteza com um gráfico de linhas e faixas.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Embora a abordagem de Bettencourt e Ribeiro funcione, Kevin aponta um problema prático (também observado no artigo): é possível que a posterior fique “presa” e tenda assimptoticamente a 1, por não “esquecer” períodos com $R_t$ alto.
Para contornar isso, Kevin sugere o seguinte:
Proponho incorporar apenas os últimos $m$ dias da função de verossimilhança. Assim, a priori do algoritmo é construída com base no passado recente, o que é bem mais útil do que toda a história da epidemia. Essa mudança simples, mas importante, leva a: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Usaremos essa modificação para estimar $R_t$ em diferentes estados dos EUA.
Hora de aplicar tudo isso aos dados de COVID dos estados dos EUA para estimar o $R_t$. Vamos começar buscando os dados. Usaremos o conjunto de dados do New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
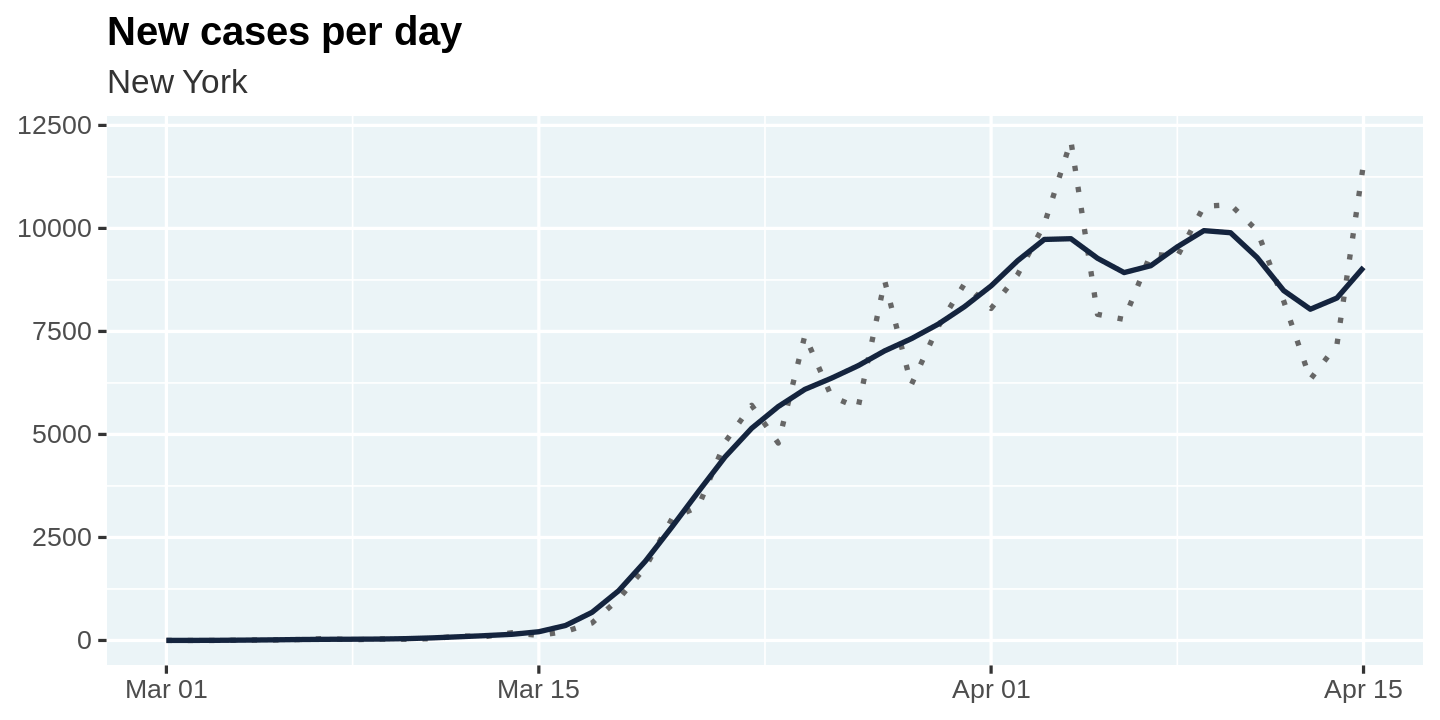
O primeiro passo é preparar os dados calculando o número diário de novos casos e suavizando-o com uma janela móvel. A suavização é essencial para compensar atrasos de notificação, especialmente mais pronunciados nos fins de semana.
Seguindo a abordagem do Kevin, uso um suavizador gaussiano com janela de 7 dias.
Observação: vamos implementar todas as etapas de processamento como funções independentes. Embora isso traga algum overhead, permite compor as etapas de forma limpa e aplicá-las a um ou mais estados, o que ajuda bastante.
Aplicaremos essas etapas a um estado selecionado, para facilitar a análise dos resultados. Escolhi Nova York, mas fique à vontade para trocar pelo seu estado preferido!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
Vamos plotar os valores brutos e os suavizados de new_cases para ver o efeito da suavização.
🎩 É sempre uma boa prática visualizar os resultados após transformações. Isso ajuda a criar intuição e a checar se a transformação fez o que você esperava!
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
O segundo passo é calcular as verossimilhanças. Vamos seguir a mesma lógica de antes, mas com uma diferença importante: calcularemos log-verossimilhanças em vez de verossimilhanças. Isso facilita a suavização em janela móvel para aplicar a modificação sugerida pelo Kevin — usar apenas os últimos $m$ intervalos para calcular $R_t$.
Como antes, calcularemos as verossimilhanças por dia como uma lista aninhada e depois “abriremos” com tidyr::unnest.
🎩 Colunas do tipo lista são extremamente úteis no trabalho com dados. O padrão usado aqui é valioso em muitas situações.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
O terceiro passo é calcular as probabilidades a posteriori. Lembre que
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Podemos reescrever em termos das log-verossimilhanças
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Usaremos rollapplyr do pacote zoo para somar, em janela móvel de 7 dias, as log-verossimilhanças e, então, exponenciar para obter a posterior. Por fim, normalizamos para somar 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
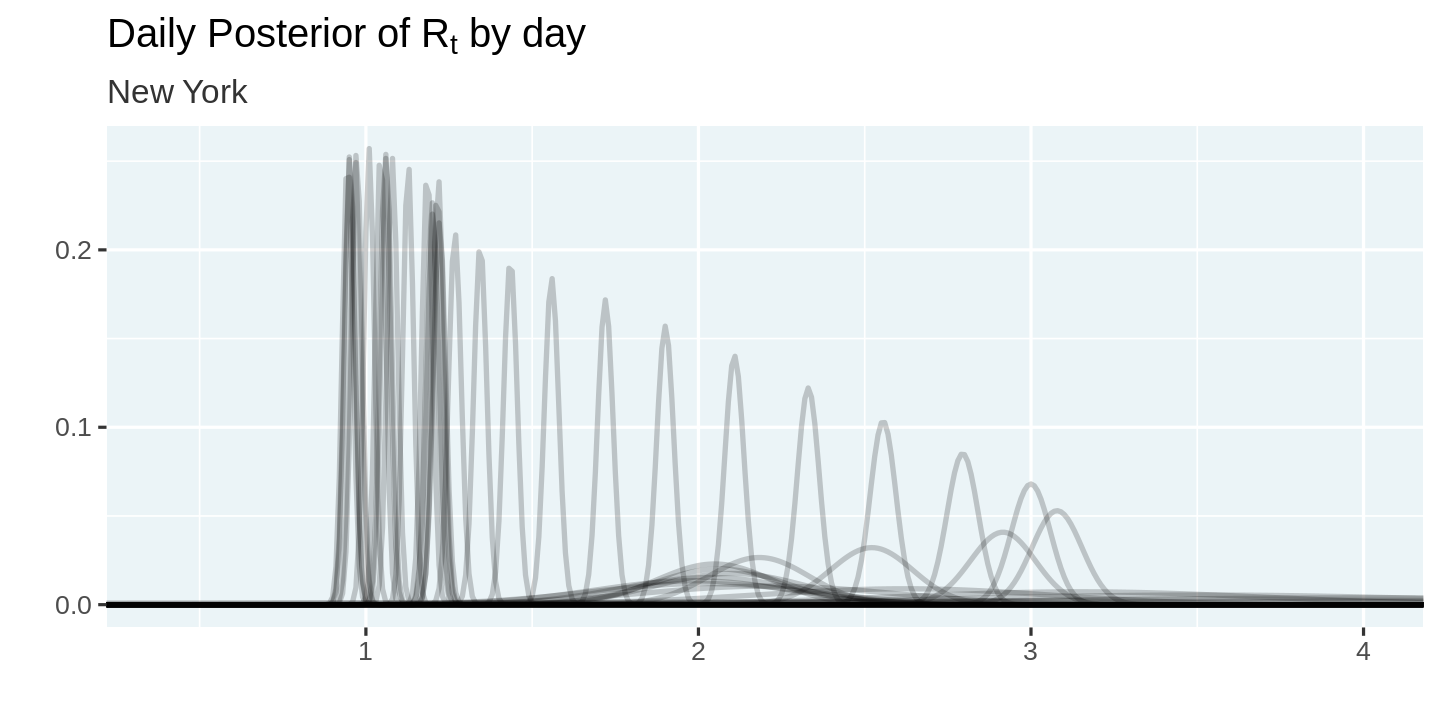
Vamos visualizar as posteriores calculadas. Note o uso de alpha = 0.2 para reduzir sobreposição e destacar o deslocamento das curvas.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
O passo final é estimar os valores de $R_t$ e seus intervalos de maior densidade. Lembre que precisamos simular valores de $r_t$ a partir das posteriores para usar HDIInterval::hdi e calcular os intervalos.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Enfim, a hora da verdade! Vamos visualizar os valores estimados de $R_t$
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
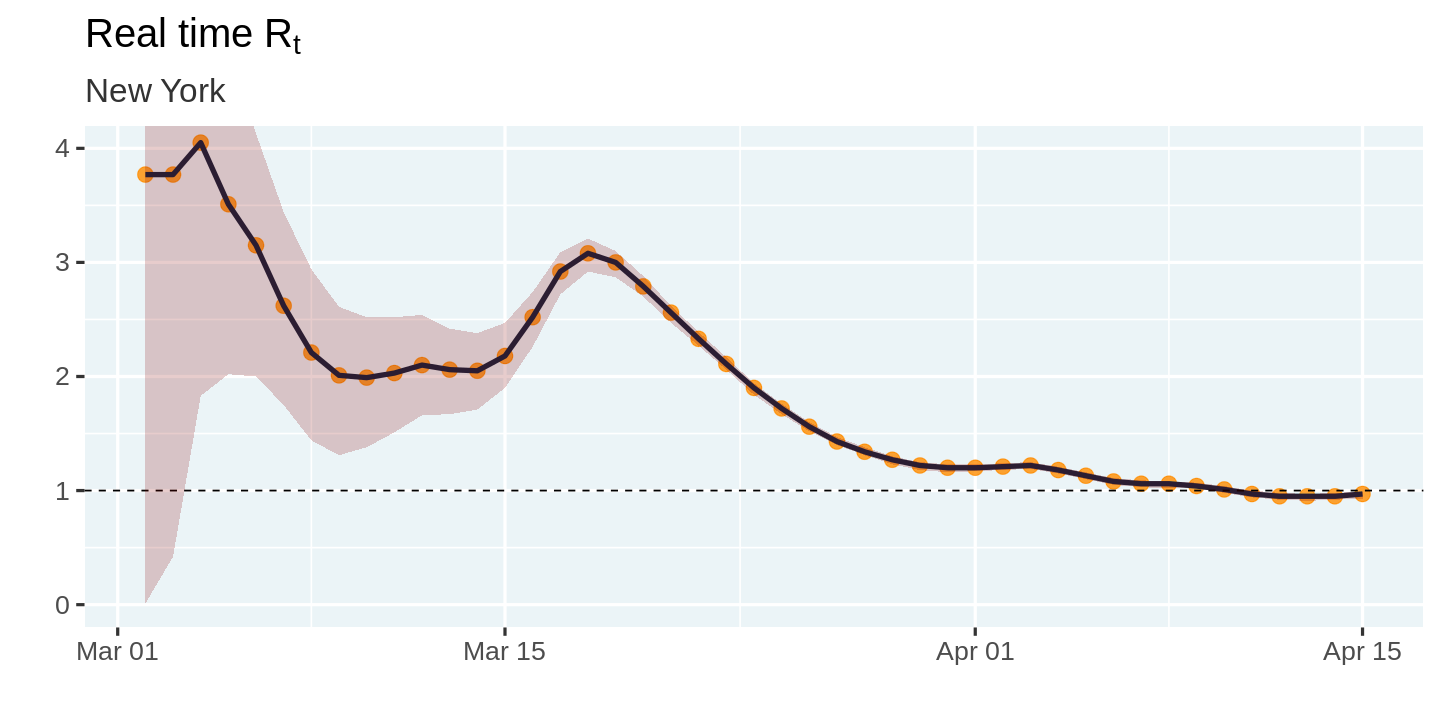
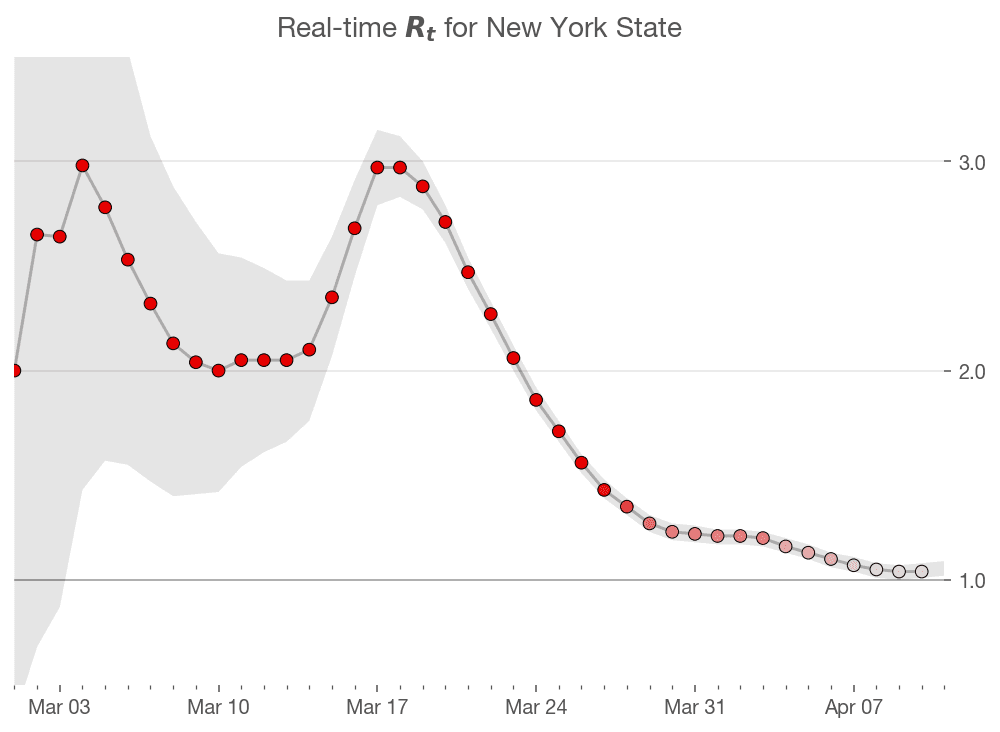
Como isso se compara às estimativas do artigo do Kevin? Parece que as estimativas iniciais do meu modelo diferem um pouco das dele. No entanto, isso pode ser efeito de diferenças na suavização ou da grande incerteza nas primeiras datas. O formato geral da curva e os picos batem bem de perto. Missão cumprida! 🎉
Hora de iterar por todos os estados e calcular as estimativas. Dá para fazer facilmente agrupando por state, dividindo os dados em uma tabela por estado e usando purrr::map_df para estimar $R_t$ de cada um e juntar tudo em uma única tabela.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
Agora podemos criar um gráfico de múltiplos pequenos (small multiples) com as estimativas de todos os estados. Com ggplot2 isso é fácil — foi só uma linha extra!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
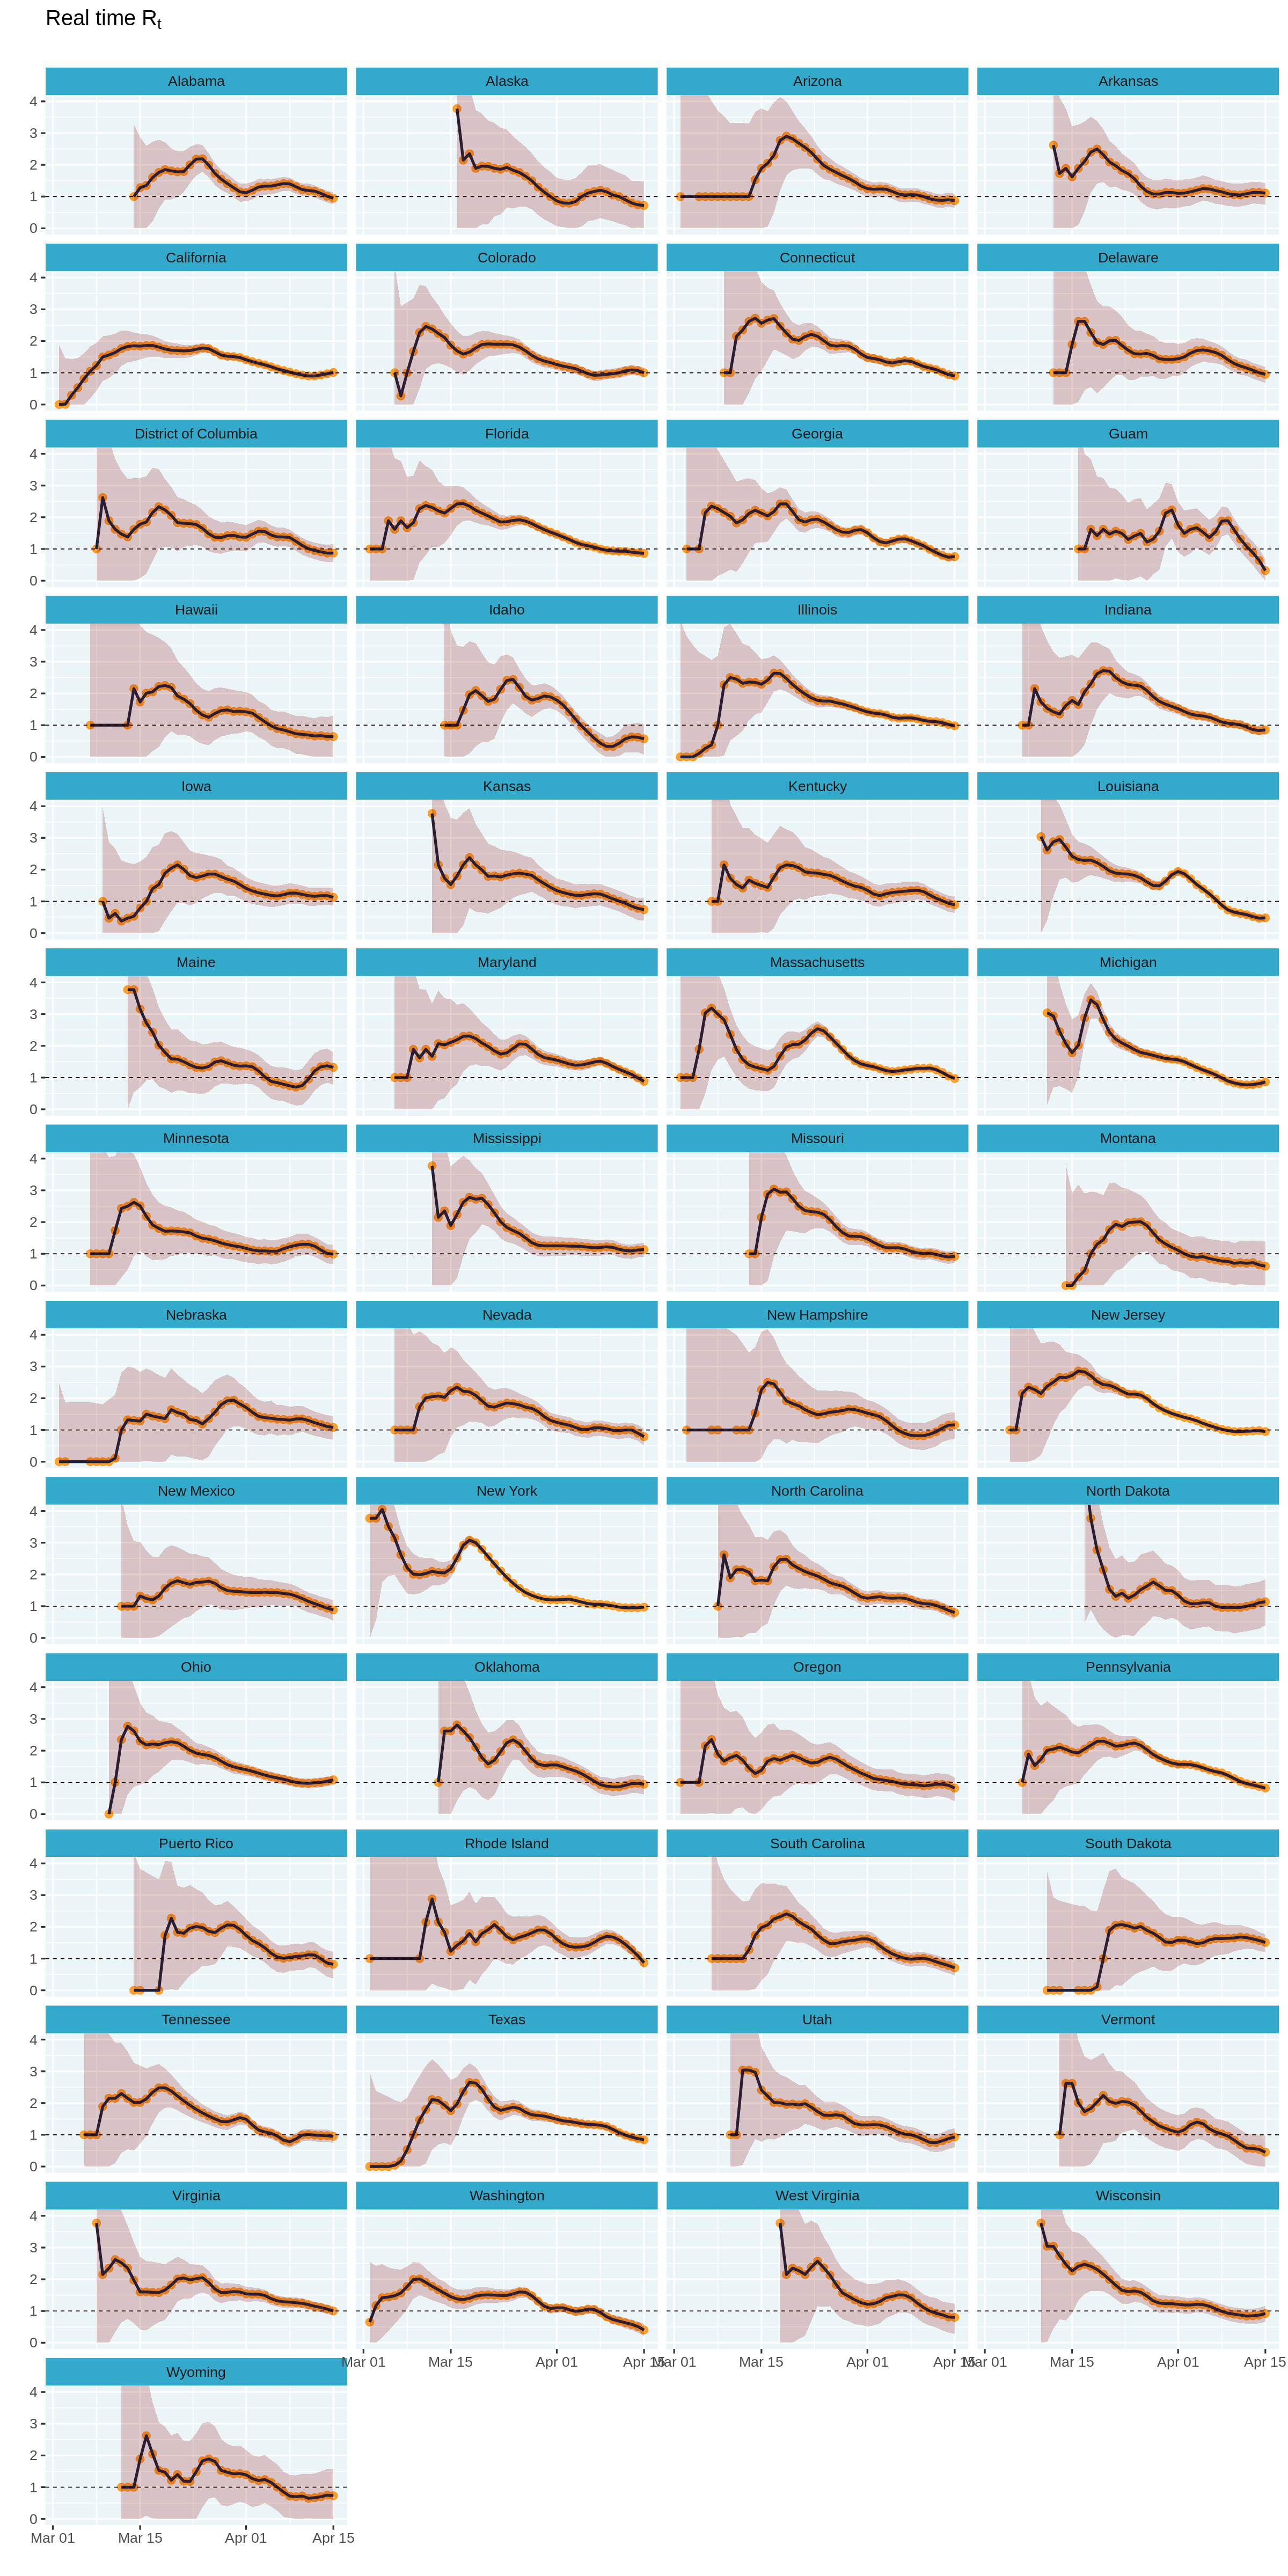
Embora o small multiples seja ótimo, é difícil localizar um estado pela sua posição geográfica. E se pudéssemos posicionar cada estado próximo à sua localização?
Felizmente, Ryan Hafen criou o pacote geofacet, que permite distribuir os pequenos painéis em uma grade geográfica com uma única linha de código.
⚠️ Infelizmente, não consegui instalar o geofacet no Colab (suspeito que por dependências do sistema exigidas pelo pacote sf), então o bloco abaixo vai falhar. Incluí uma imagem gerada localmente para você ter uma ideia de como fica.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

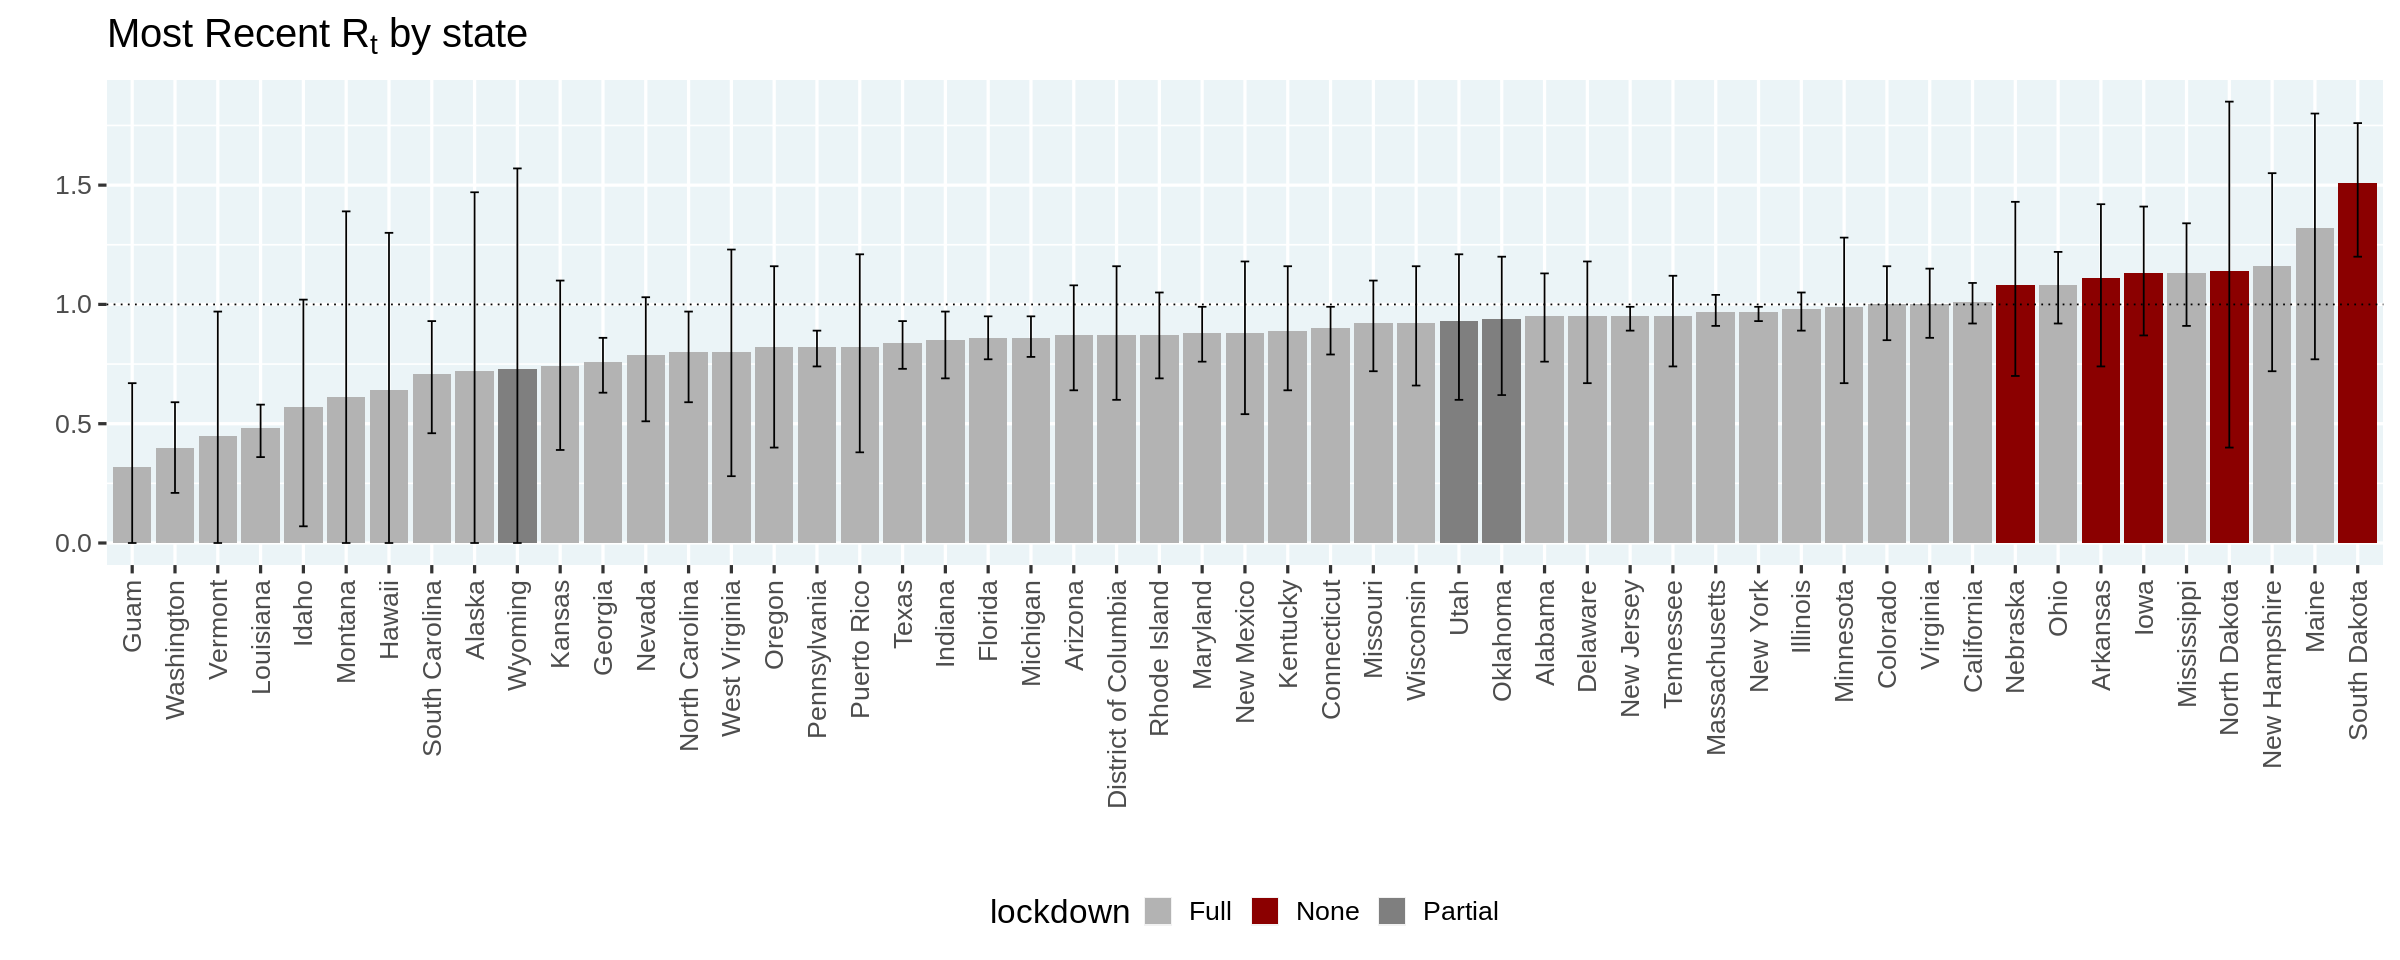
Por fim, vamos recriar o gráfico do artigo do Kevin que ordena os estados pelo valor mais provável de $R_t$ mais recente e colore de acordo com a situação de lockdown.
⚠️ Observação: este é um gráfico puramente descritivo e não permite tirar conclusões sobre a eficácia de lockdowns
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
Neste artigo, replicamos a análise do Kevin em R usando o tidyverse. Aprendemos alguns truques úteis para calcular verossimilhanças e posteriores. Eu aprendi demais nesse processo!
Penso em vários próximos passos, mas destaco um principal: como as funções aqui dependem de uma tabela simples com três colunas — location, date, cases — um passo interessante seria transformar tudo isso em um pacote R. Isso facilitaria estimar $R_t$ em outras geografias.
Quero encerrar agradecendo ao Kevin Systrom pelo post e por compartilhar o código. Agradeço também aos meus colegas na DataCamp pelo excelente feedback em uma versão inicial deste artigo.
Se tiver feedback/comentários ou quiser sugerir extensões, me encontre no Twitter @ramnath_vaidya e no github. Para aprender mais sobre programação em R
Saiba mais sobre R
Curso
Curso
Curso
blog
Summer Worsley
15 min
blog
Arun Nanda
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Vidhi Chugh
14 min