Cursus
Introductie tot R
4 uur
3.1M
Volg Ramnath Vaidyanathan op Twitter. Deze analyse is oorspronkelijk gepubliceerd op Google Colab.
Kevin Systrom publiceerde een heel interessant artikel over het schatten van $R_t$, de maatstaf die bekendstaat als de effectieve reproductiefactor. In zijn artikel beschrijft Kevin dit getal als:
Het aantal mensen dat besmet raakt per besmettelijke persoon op tijdstip 𝑡
Kevin was zo vriendelijk om zijn code te publiceren als een notebook op GitHub. Ik wilde meer doen met zijn model en het ook toepassen op andere landen. Maar aangezien ik beduidend vaardiger ben in R, wilde ik zijn resultaten eerst in R reproduceren.
Voordat je de rest van deze post leest, raad ik je sterk aan eerst het originele artikel te lezen voor een gedetailleerdere uitleg van de gebruikte modelaanpak, want deze post focust vooral op de code.
Alle eer voor de modelaanpak en code gaat naar Kevin 👍. Dit notebook is mijn bescheiden poging om zijn model naar R te vertalen. Eventuele resterende fouten zijn volledig voor mijn rekening.
We gebruiken dezelfde aanpak die Kevin in zijn artikel schetst, gebaseerd op het paper van Bettencourt & Ribeiro.
De eerste stap is het modelleren van het ‘aankomst’-proces van besmettingen. Een veelgebruikte keuze onder statistici voor de verdeling van aankomsten is de Poissonverdeling. Als we $\lambda$ laten staan voor het gemiddelde aantal besmettingen per dag, dan is de kans dat we op een dag $k$ nieuwe gevallen zien, gegeven door
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Met deze opzet kunnen we de kansverdeling van nieuwe gevallen construeren voor een set $\lambda$’s. Voordat we code schrijven, moeten we de tidyverse-pakketset laden en wat plotopties aanpassen (afmetingen, stijl enz.). Je kunt deze sectie gerust overslaan, want hij is niet cruciaal voor het verhaal, maar voer de code wel uit.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
We kunnen de functie crossing uit purrr gebruiken om kansdichtheden te berekenen voor combinaties van $k$’s en $\lambda$’s. Dit is een elegante aanpak, al is hij rekenkundig suboptimaal, omdat we niet echt gebruikmaken van de vectorisatie van dpois. Een efficiëntere aanpak zie je later.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
We kunnen deze kansen visualiseren met ggplot2. Let op hoe we expression gebruiken om wiskundesymbolen in plots weer te geven. Meer daarover in de documentatie van plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
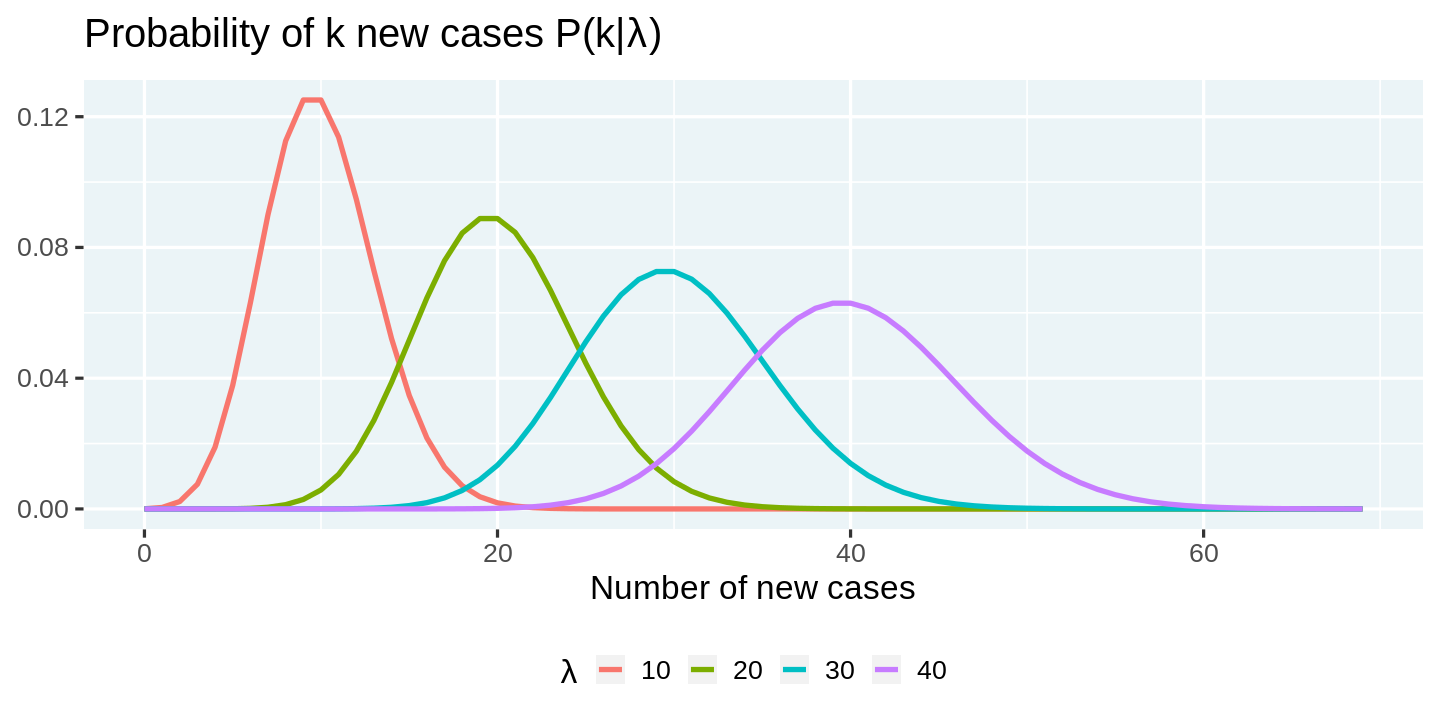
Door het aankomstproces als Poissonverdeling te modelleren, kunnen we de verdeling van nieuwe gevallen per dag voorspellen als functie van de aankomstsnelheid $\lambda$. In werkelijkheid observeren we echter alleen het aantal aankomsten. De kernvraag is dus: hoe gaan we van het geobserveerde aantal aankomsten naar een beeld van de verdeling van $\lambda$? Gelukkig is het antwoord eenvoudig.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
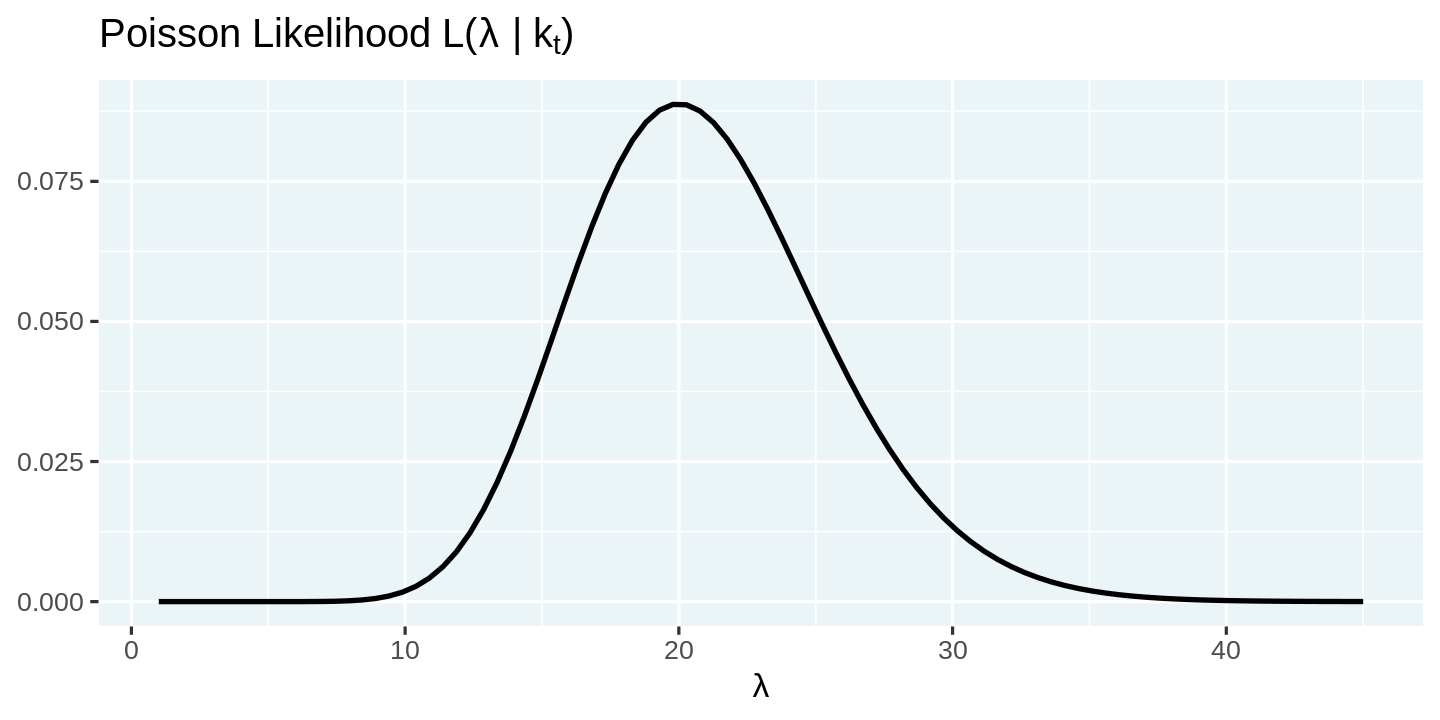
De verdeling van $\lambda$ over k heet de likelihood-functie en heeft dezelfde wiskundige vorm als de kansmassa-functie die we eerder gebruikten. We kunnen de likelihood visualiseren door het aantal geobserveerde nieuwe gevallen (k) vast te zetten en de likelihood te berekenen over een reeks waarden van $\lambda$.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Allemaal prima, maar je vraagt je misschien af waar de effectieve infectiegraad, $R_t$, blijft waar we het in het begin over hadden. Hoe hangt die samen met de aankomstsnelheid $\lambda$? Volgens het paper van Bettencourt & Ribeiro is de relatie vrij eenvoudig
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Merk op dat $\gamma$ hier de reciproke is van het seriële interval (ongeveer 4 dagen bij COVID-19), en $k_{t-1}$ het aantal nieuwe gevallen in de tijdsinterval $t-1$.
We kunnen deze uitdrukking voor $\lambda$ gebruiken en de likelihood herformuleren in termen van $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Voordat we verdergaan, zetten we enkele kernparameters klaar.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
De onderstaande code toont een efficiëntere manier om likelihoods te berekenen. In plaats van voor elke combinatie de lambdas en likelihoods te genereren, benutten we de gevectoriseerde functies in R en geneste dataframes. Zo maken we per dag een vector van lambdas en likelihoods en pakken die daarna uit met tidyr::unnest tot een vlakke tabel.
Behalve efficiënter is deze code naar mijn idee ook leesbaarder en vertaalt hij de formules met minimale overhead.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
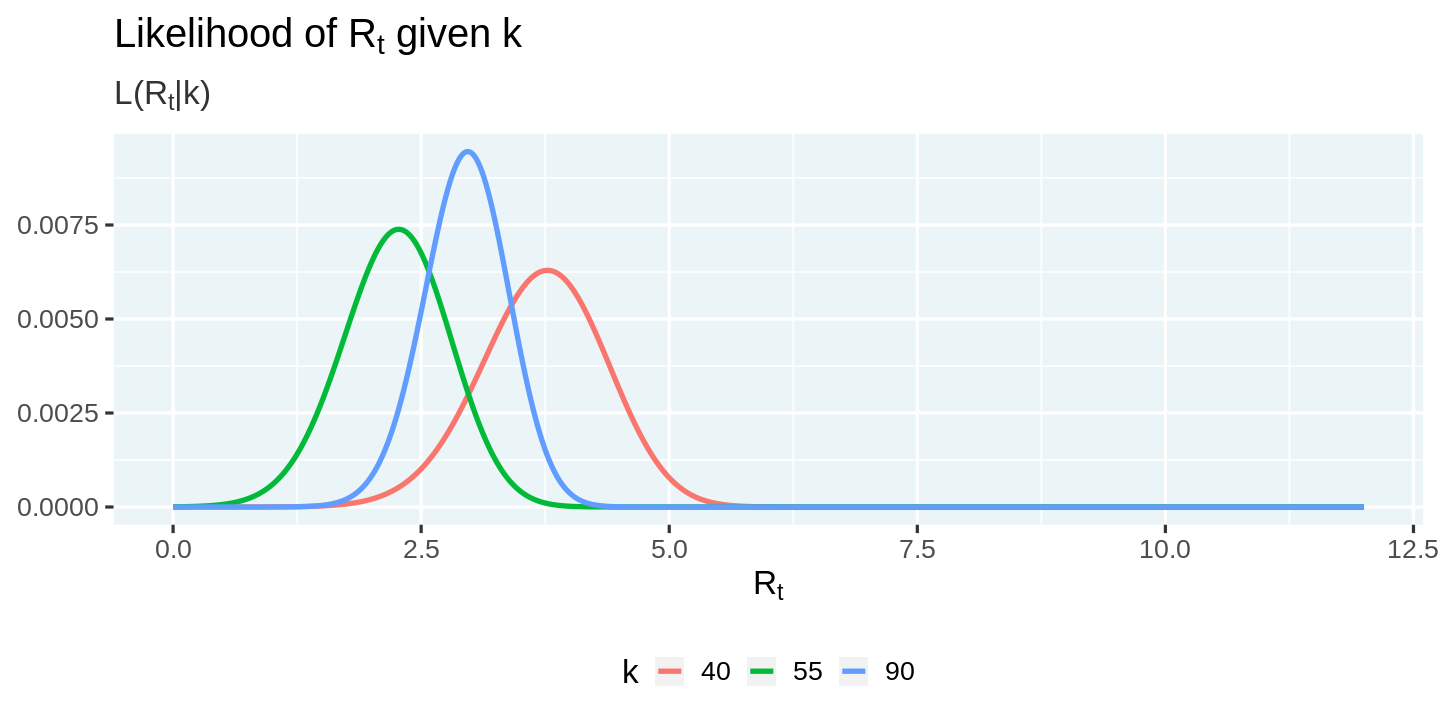
We kunnen nu de likelihood plotten, conditioneel op het aantal geobserveerde nieuwe gevallen.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
We hebben goed werk geleverd door het aantal nieuwe gevallen, $k$, te koppelen aan de effectieve infectiegraad, $R_t$. Maar we hebben nog geen tastbare aanpak om de waarden te schatten uit de tijdreeks van geobserveerde nieuwe gevallen. Hier komt de alomtegenwoordige regel van Bayes goed van pas. Bettencourt & Ribeiro drukken de kansverdeling van $R_t$ uit als
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin pakt deze complexe vergelijking uit in veel eenvoudigere termen.
Dit zegt dat, na het zien van 𝑘 nieuwe gevallen, we geloven dat de verdeling van 𝑅𝑡 gelijk is aan:
- De prior overtuigingen over de waarde van $P(R_t)$ zonder de data ...
- maal de likelihood om $k$ nieuwe gevallen te zien gegeven $R_t$ ...
- gedeeld door de kans om in het algemeen zoveel gevallen te zien.
Als we de posterior van de vorige periode, $P(R_{t-1} | k_{t-1})$, gebruiken als de prior, $P(R_t)$, voor de huidige periode, dan kunnen we de vorige vergelijking herschrijven als:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Door over perioden terug te itereren tot $t = 0$, krijgen we
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Met een uniforme prior $P(R_0)$ reduceert dit tot:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
We kunnen deze uitdrukking nu gebruiken om de posterior uit de likelihoods te berekenen. Opnieuw gebruiken we de gevectoriseerde functie cumprod om in één keer posteriors voor alle dagen te genereren, en normaliseren die daarna.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
We kunnen nu de posteriorverdeling visualiseren.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
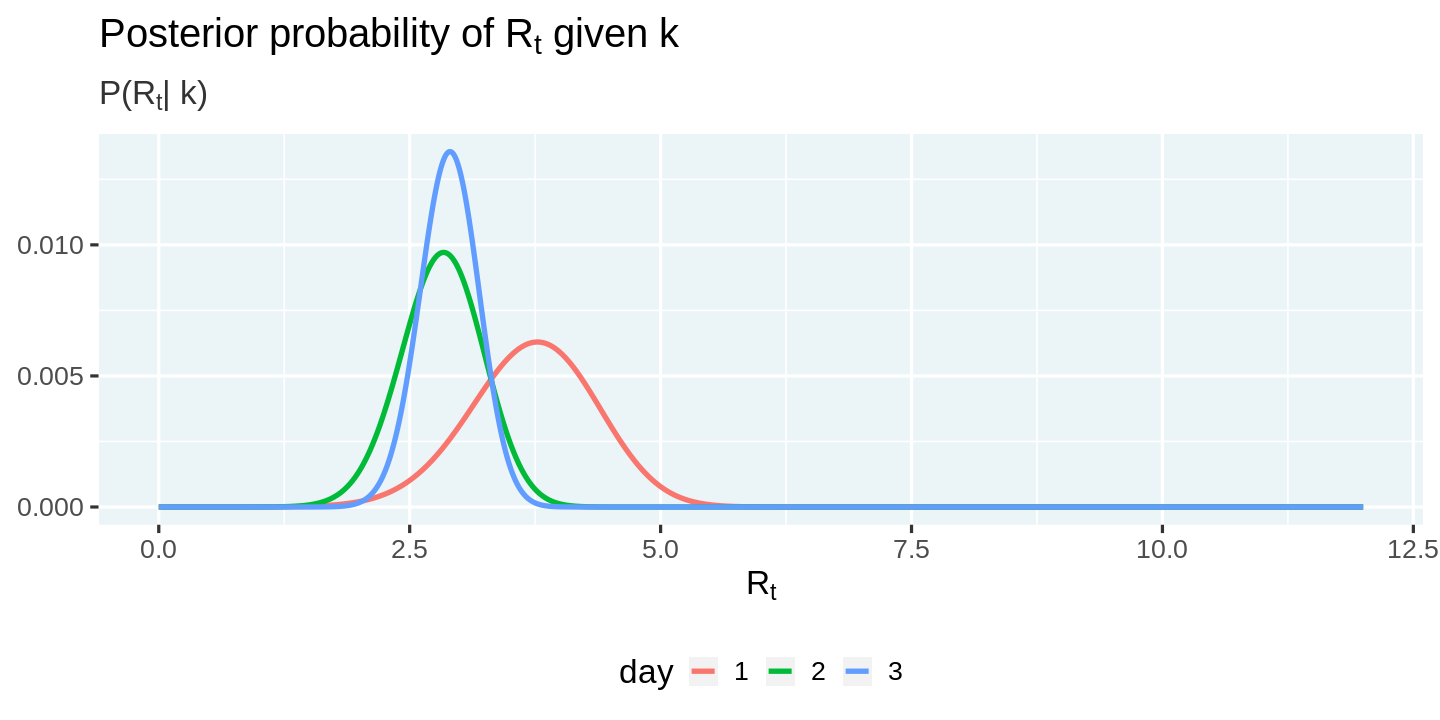
Met deze posteriors kunnen we nu de hamvraag beantwoorden:
Wat is elke dag de meest waarschijnlijke waarde van $R_t$?
Bij het schatten van een grootheid is het belangrijk om een beeld te geven van de fout rond de schatting. Een populaire manier is het gebruik van highest density intervals (HDI).
Een andere manier om een verdeling samen te vatten is het hoogste-dichtheidsinterval, dat de verdeling samenvat met een interval dat bijvoorbeeld 95% van de verdeling beslaat, zodanig dat elk punt binnen het interval geloofwaardiger is dan elk punt erbuiten.
In zijn artikel implementeerde Kevin een brute-force-algoritme om de HDI te berekenen. R-gebruikers hebben geluk: er is al een pakket, HDInterval, met een implementatie 🎉.
We schatten nu de meest waarschijnlijke waarde van $R_t$ en het bijbehorende hoogste-dichtheidsinterval. Omdat de functie HDInterval::hdi alleen werkt met een vector willekeurige waarden uit een verdeling, en wij enkel posterior-kansen hebben geschat, moeten we willekeurige waarden van $R_t$ simuleren op basis van de posterior-kansen om de HDI te kunnen berekenen.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

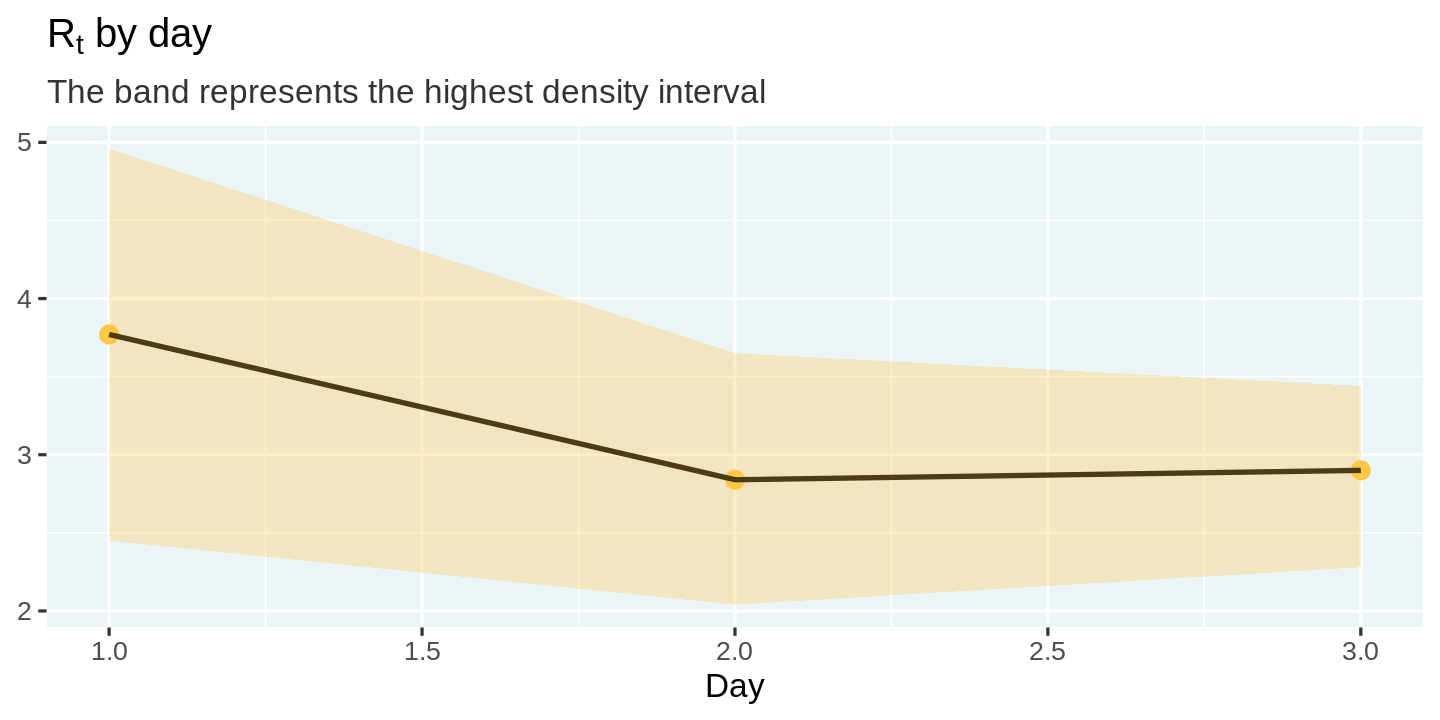
display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
We kunnen deze schattingen en de onzekerheid eromheen visualiseren met een lijnplot met ribbons.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Hoewel de aanpak van Bettencourt en Ribeiro goed werkt, wijst Kevin op een praktisch probleem (ook in het paper genoemd): het is mogelijk dat de posterior vastloopt en asymptotisch 1 nadert, doordat het model tijden met een hoge $R_t$ niet vergeet.
Om dit tegen te gaan, stelt Kevin het volgende voor.
Ik stel voor om alleen de laatste $m$ dagen van de likelihood te gebruiken. Zo wordt de prior van het algoritme gebaseerd op het recente verleden, wat nuttiger is dan de volledige geschiedenis van de epidemie. Deze eenvoudige maar belangrijke wijziging leidt tot: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
We gebruiken deze aanpassing om de waarden van $R_t$ voor verschillende staten in de VS te schatten.
Tijd om alle bouwstenen toe te passen op COVID-data uit Amerikaanse staten om de effectieve infectiegraad, $R_t$, te schatten. We beginnen met het ophalen van de data. We gebruiken de COVID-dataset voor de VS samengesteld door de New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
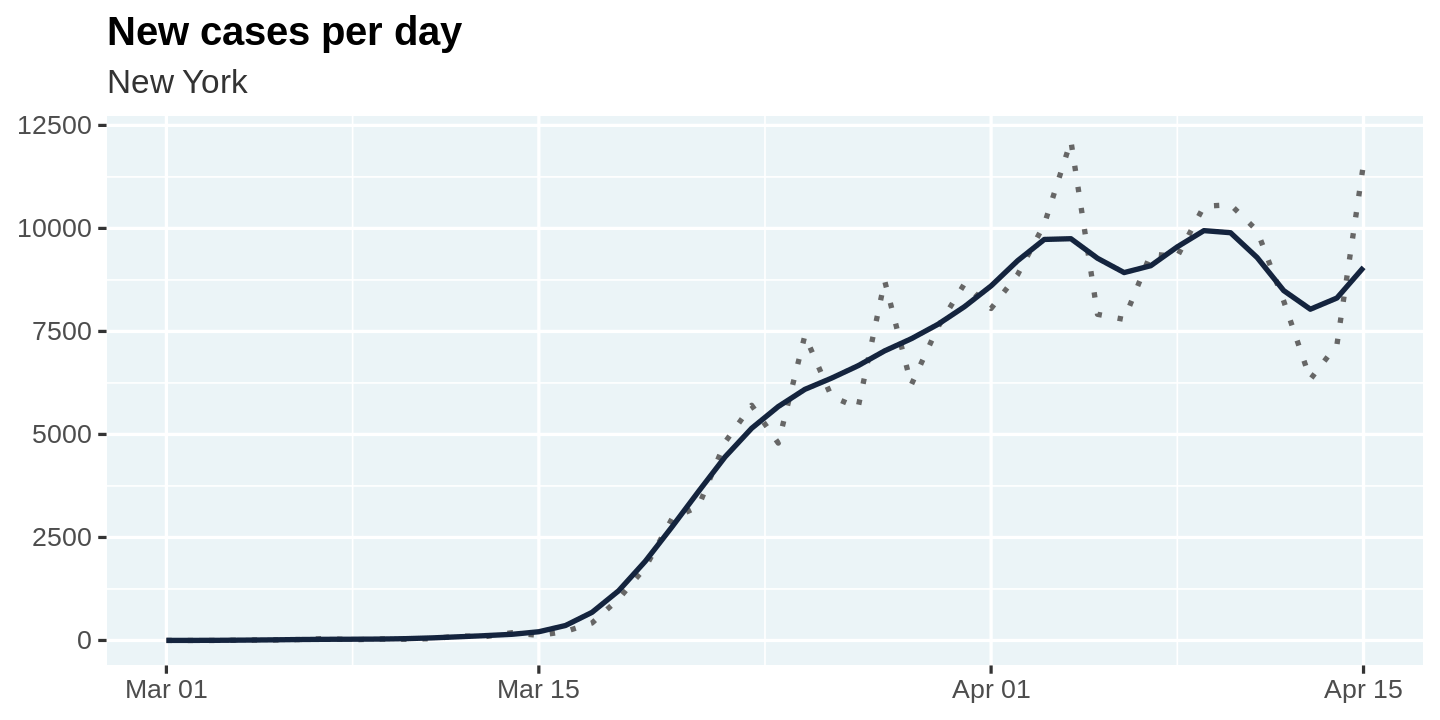
De eerste stap is het voorbereiden van de data door het aantal nieuwe gevallen per dag te berekenen en dit te gladstrijken over een schuivend venster. Het gladstrijken is essentieel om rapportagevertragingen op te vangen, die vooral in het weekend uitgesproken zijn.
Volgens Kevins aanpak gebruik ik een Gaussiaanse smoother met een 7-daags schuivend venster.
Let op dat we alle dataverwerkingsstappen als losse functies implementeren. Dat geeft wat overhead, maar maakt het eenvoudig om deze stappen netjes te componeren en op één of meerdere staten toe te passen — erg handig straks.
We passen deze stappen toe op één geselecteerde staat, zodat we de resultaten makkelijker kunnen bekijken en duiden. Ik heb New York gekozen, maar wissel gerust naar een staat naar keuze!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
Laten we de ruwe waarden én de gladgestreken waarden voor new_cases plotten om te zien wat het gladstrijken doet.
🎩 Het is altijd goed om na transformaties te visualiseren wat er gebeurt. Zo bouw je intuïtie op en check je of je transformatie doet wat je bedoelde!
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
De tweede stap is het berekenen van de likelihoods. We volgen dezelfde aanpak als eerder, met één belangrijk verschil: we berekenen log-likelihoods in plaats van likelihoods. Dat maakt het eenvoudiger om ze te gladstrijken over een schuivend venster om Kevins aanpassing toe te passen, waarbij we alleen de laatste $m$ intervallen gebruiken om $R_t$ te berekenen.
Zoals tevoren berekenen we de likelihoods per dag als geneste lijst en vlakken we ze daarna uit met tidyr::unnest.
🎩 Lijstkolommen zijn erg handig in dataverwerking. Het patroon dat we hier gebruiken is in veel situaties bruikbaar.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
De derde stap is het berekenen van de posterior-kansen. Herinner je dat
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
We kunnen dit in termen van de log-likelihoods herschrijven
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
We gebruiken de functie rollapplyr uit het zoo-pakket om een schuivende 7-daagse som van de log-likelihoods te berekenen en exponentiëren die vervolgens om de posterior te krijgen. Tot slot normaliseren we de posteriors tot 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
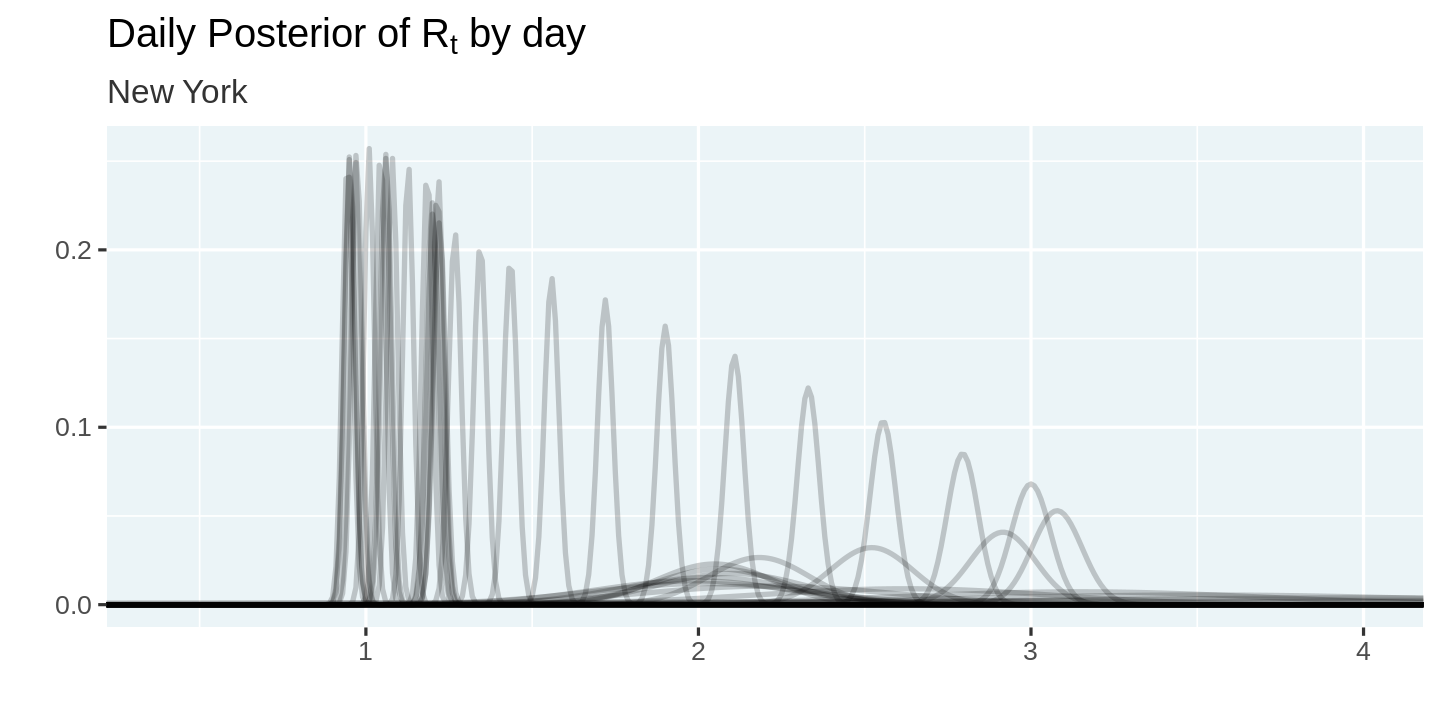
Laten we de berekende posterior-kansen visualiseren. Let op hoe we alpha = 0.2 zetten om overplotting te verminderen. Zo kun je verschuivende posteriors zien.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
De laatste stap is het schatten van de waarden van $R_t$ en de hoogste-dichtheidsintervallen eromheen. Vergeet niet dat we willekeurige waarden voor $r_t$ moeten simuleren met de posterior-kansen om de functie HDIInterval::hdi te kunnen toepassen.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
En dan nu het moment suprême! Laten we de geschatte waarden van $R_t$ visualiseren
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
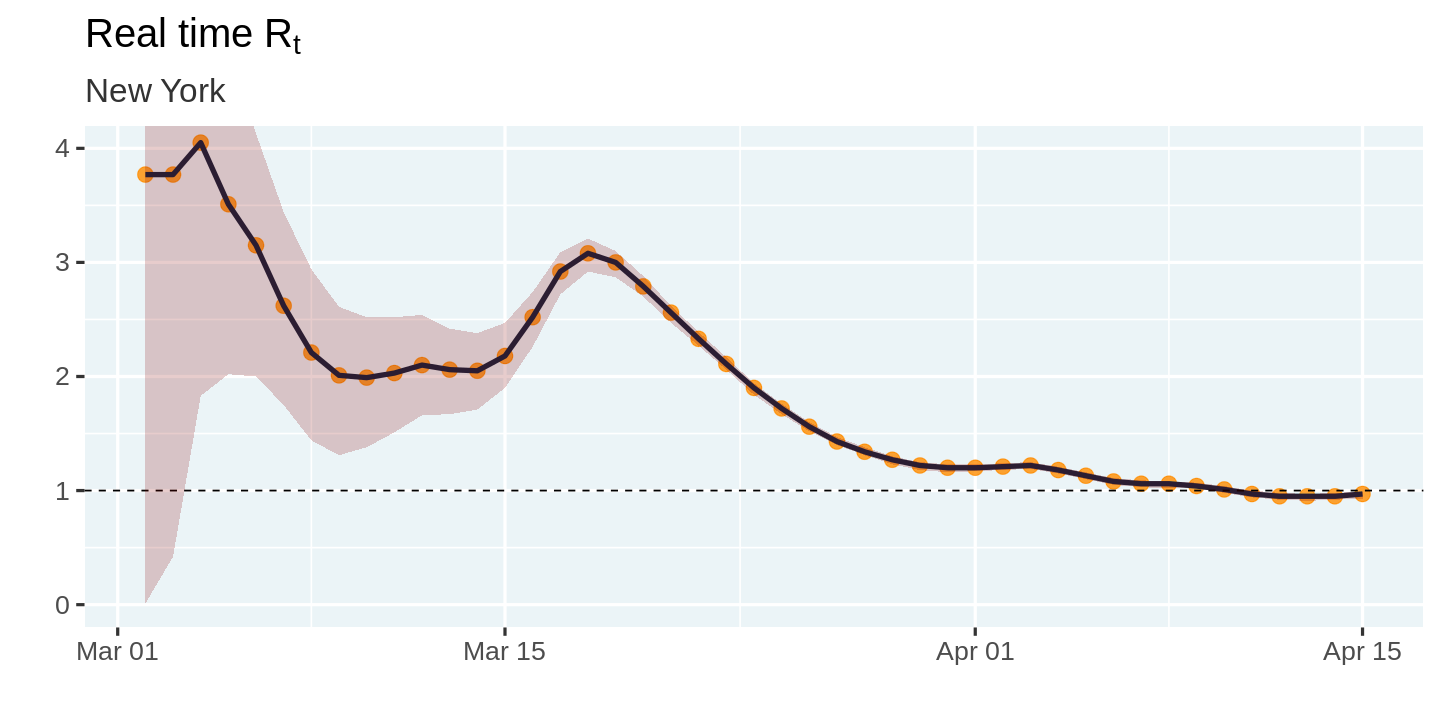
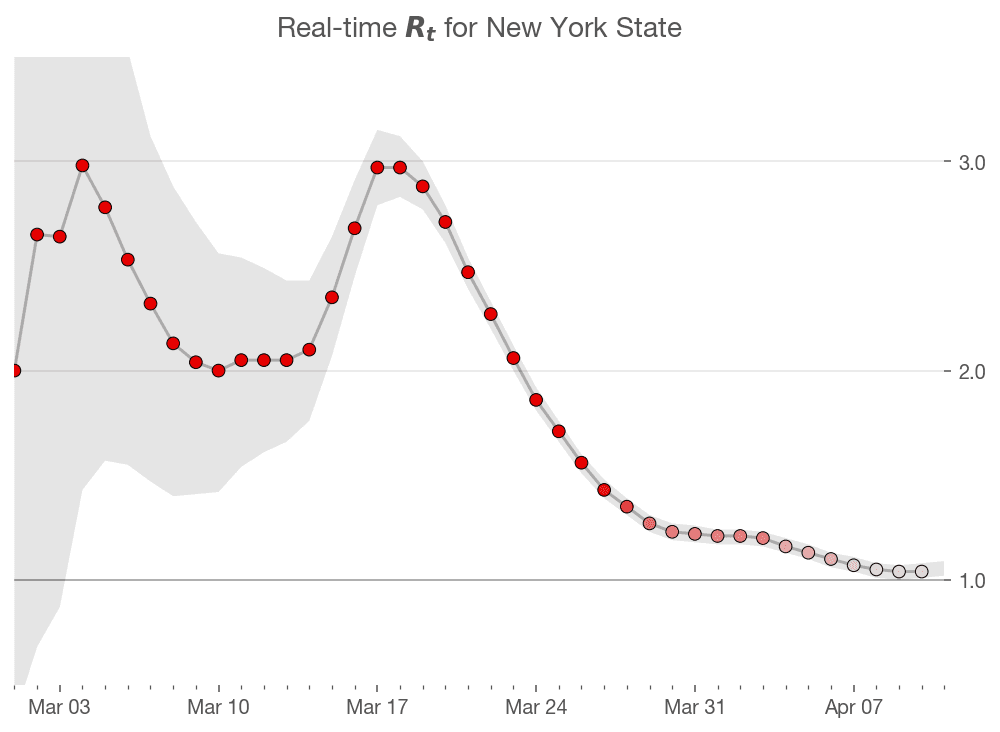
Hoe verhoudt dit zich tot de schattingen uit Kevins artikel? Het lijkt erop dat de eerste schattingen in mijn model afwijken van die van Kevin. Dat kan echter komen door verschillen in het gladstrijk-algoritme of de grote onzekerheid rond de eerste schattingen. De algemene vorm van de curve en de pieken komen behoorlijk overeen. Missie geslaagd! 🎉
Tijd om over alle staten te itereren en deze schattingen te berekenen. Dat kan eenvoudig door te groeperen op state, de data te splitsen in één tabel per staat en purrr::map_df te gebruiken om $R_t$ per staat te schatten en weer samen te voegen tot één tabel.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
We kunnen nu een small-multiples-plot maken van de schattingen over alle staten. Met ggplot2 is dat heel eenvoudig — we hoefden maar één regel toe te voegen!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
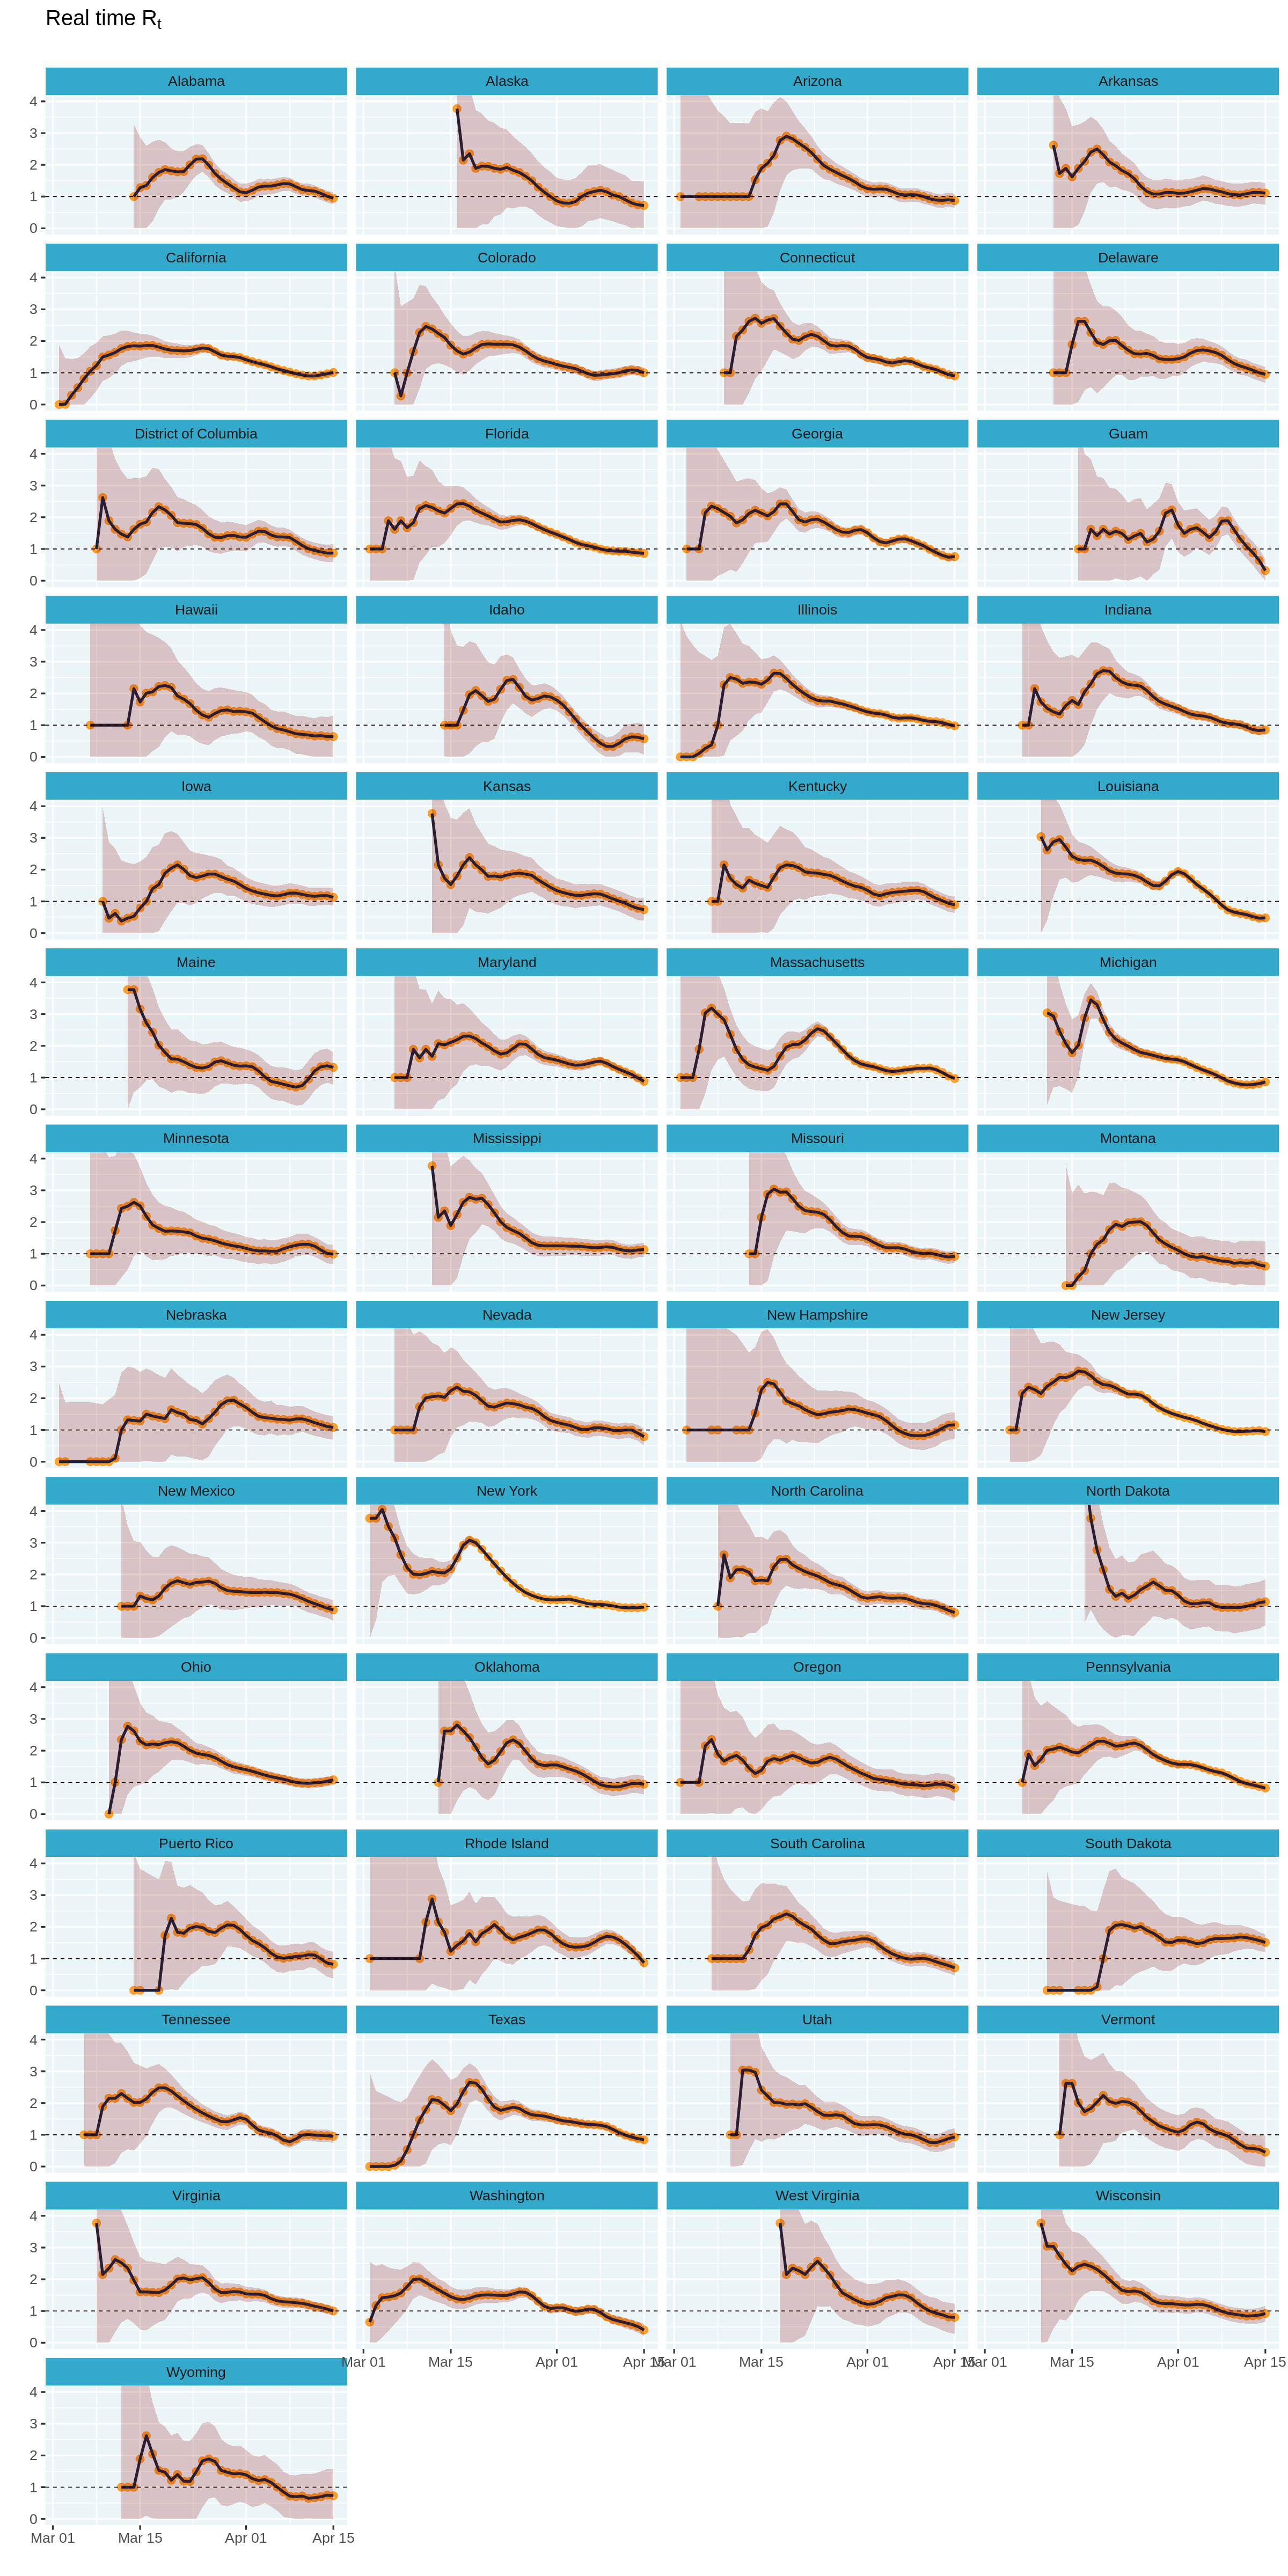
Hoewel de small multiples perfect zijn, is het lastig om op basis van geografie naar een staat te navigeren. Wat als we elke staat ongeveer op zijn geografische plek konden plotten?
Gelukkig heeft Ryan Hafen het pakket geofacet gemaakt, waarmee we deze small multiples met één regel code op een geografisch raster kunnen leggen.
⚠️ Helaas kon ik het pakket geofacet niet op Colab installeren (ik vermoed door systeema afhankelijkheden van het sf-pakket), waardoor de code hieronder zal falen. Ik heb een opgeslagen versie van de plot die ik lokaal heb gemaakt toegevoegd, zodat je een idee krijgt van het resultaat.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

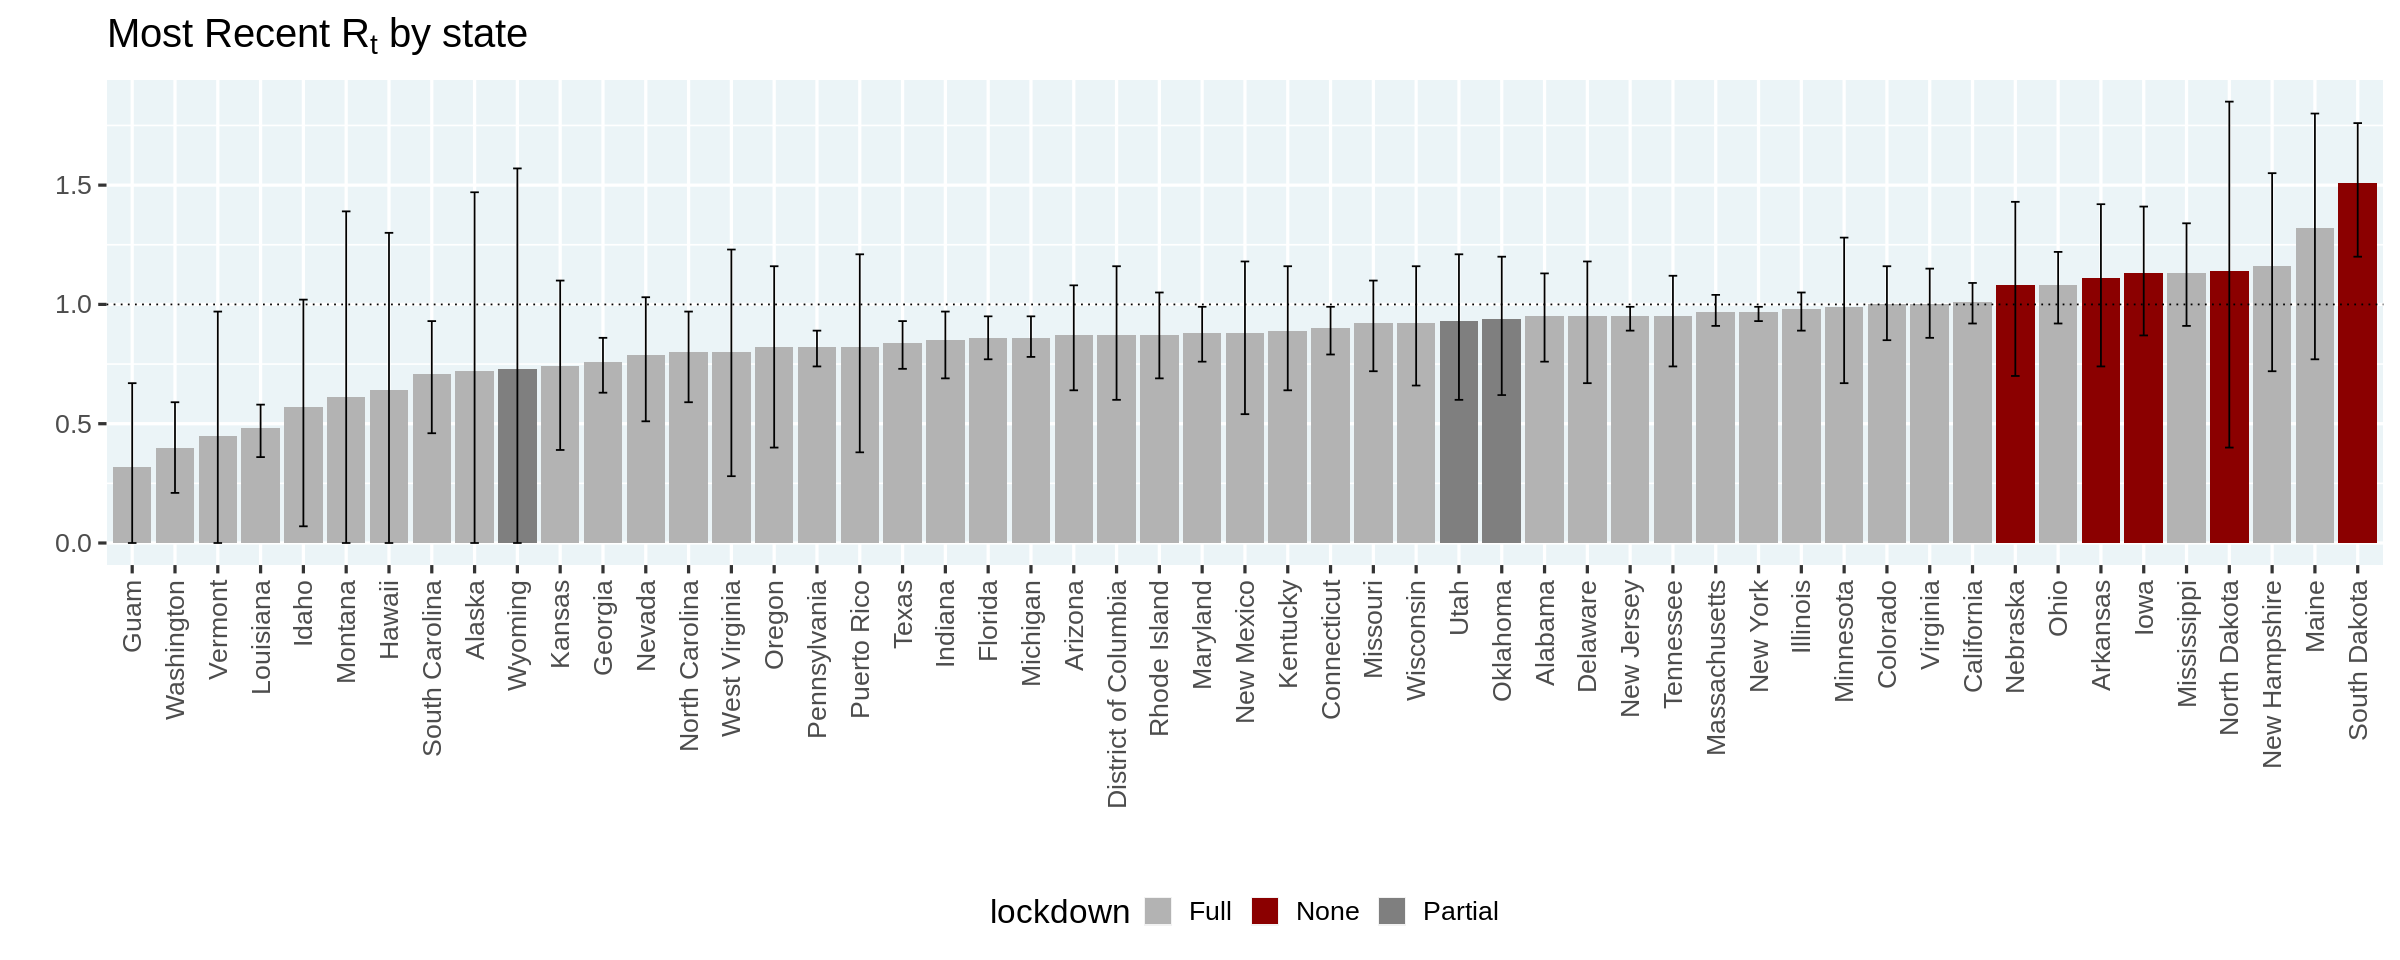
Tot slot reproduceren we de plot in Kevins artikel die de staten rangschikt op basis van de meest waarschijnlijke geschatte waarde van $R_t$, en inkleurt op basis van de staat van lockdown.
⚠️ Let op: dit is een puur beschrijvende plot; je kunt hieruit geen conclusies trekken over de effectiviteit van lockdowns
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
In dit artikel hebben we Kevins analyse in R gerepliceerd met de tidyverse. We leerden handige trucs om likelihoods en posteriors te berekenen. Ik heb hier enorm veel van opgestoken!
Ik kan meerdere volgende stappen bedenken, maar licht er één belangrijke uit. Aangezien de functies in dit artikel draaien op een vrij eenvoudige inputtabel met drie kolommen: location, date, cases, is een interessante volgende stap om dit om te zetten in een R-pakket. Dat maakt het makkelijker om $R_t$ voor andere gebieden te schatten.
Ik wil afsluiten met dank aan Kevin Systrom voor zijn interessante post en het delen van zijn code. Ook dank aan mijn collega’s bij DataCamp voor hun uitstekende feedback op een eerste versie van dit artikel.
Als je feedback/opmerkingen hebt over dit artikel of andere uitbreidingen wilt voorstellen, vind je me op Twitter @ramnath_vaidya en op GitHub. Wil je meer weten over R-programmeren
Leer meer over R
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

