Curso
Introducción a R
4 h
3.1M
Sigue a Ramnath Vaidyanathan en Twitter. Este análisis se publicó originalmente en Google Colab.
Kevin Systrom publicó un artículo realmente interesante sobre la estimación de $R_t$, la medida conocida como número reproductivo efectivo. En su artículo, Kevin describe este número como:
El número de personas que se infectan por cada persona infecciosa en el instante 𝑡
Kevin tuvo el detalle de publicar su código en un notebook en GitHub. Quería profundizar en su modelo y aplicarlo también a otros países. Sin embargo, como me manejo mucho mejor en R, primero quise replicar sus resultados en R.
Antes de seguir leyendo, te recomiendo encarecidamente que leas el artículo original para entender con más detalle el enfoque de modelado utilizado, ya que esta publicación se centra más en el código.
Todo el mérito del enfoque de modelado y del código es de Kevin 👍. Este notebook es mi modesta tentativa de traducir su modelo a R. Cualquier error que quede es exclusivamente mío.
Usaremos el mismo enfoque que detalla Kevin en su artículo, basado en el trabajo de Bettencourt y Ribeiro.
El primer paso es modelar el proceso de "llegada" de infecciones. Una elección habitual entre estadísticos para la distribución de llegadas es la distribución de Poisson. Así, si dejamos que $\lambda$ represente la tasa media de infecciones por día, entonces la probabilidad de observar $k$ casos nuevos en un día viene dada por
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Con esta base, podemos construir la distribución de probabilidades de casos nuevos para un conjunto de valores de $\lambda$. Antes de escribir código, debemos cargar el conjunto de paquetes tidyverse y personalizar algunas opciones de gráficos (dimensiones, estilos, etc.). Puedes saltarte esta sección si quieres, no es crítica para la narrativa, pero asegúrate de ejecutar el código.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Podemos usar la función crossing de purrr para calcular densidades de probabilidad a través de combinaciones de $k$ y $\lambda$. Es un enfoque elegante, aunque no óptimo computacionalmente, ya que no aprovechamos la vectorización de dpois. Más adelante verás una alternativa más eficiente.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Podemos visualizar estas probabilidades con ggplot2. Observa cómo usamos expression para mostrar símbolos matemáticos en los gráficos. Puedes leer más en la documentación de plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
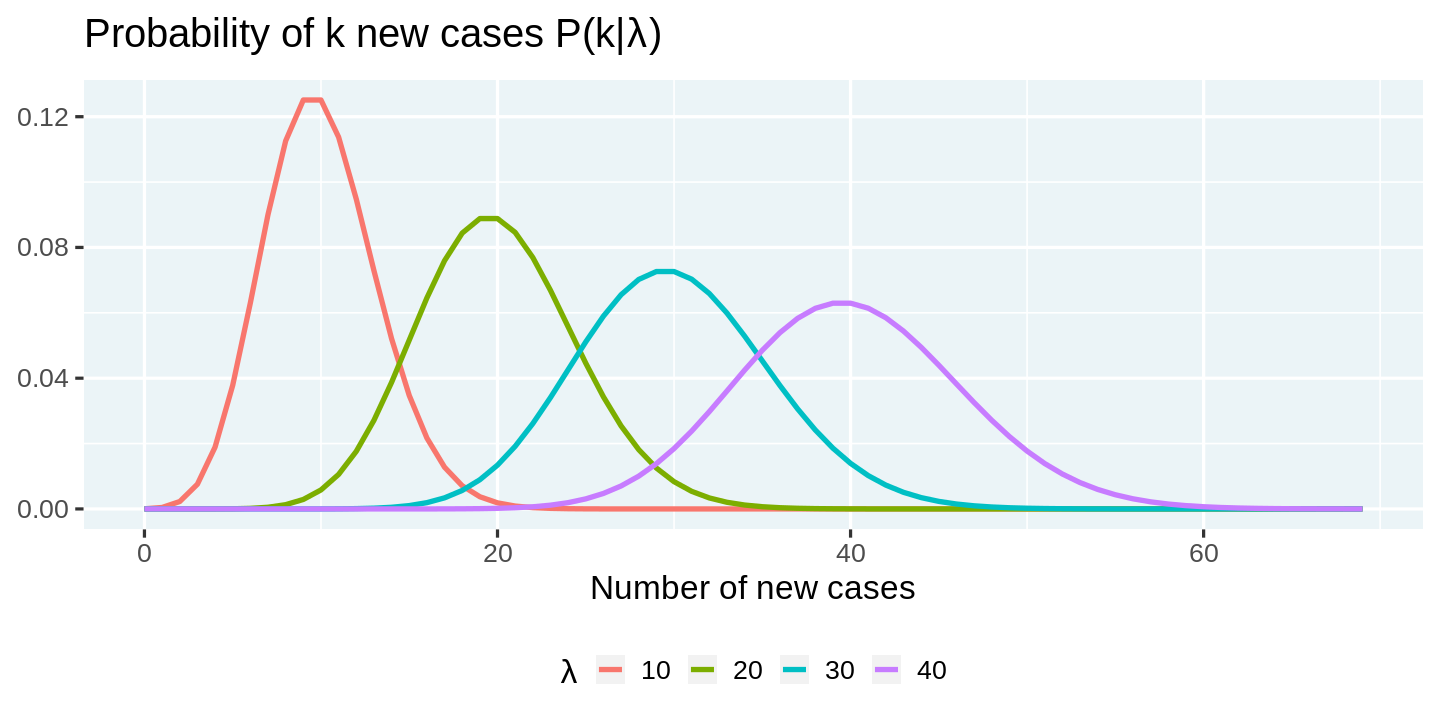
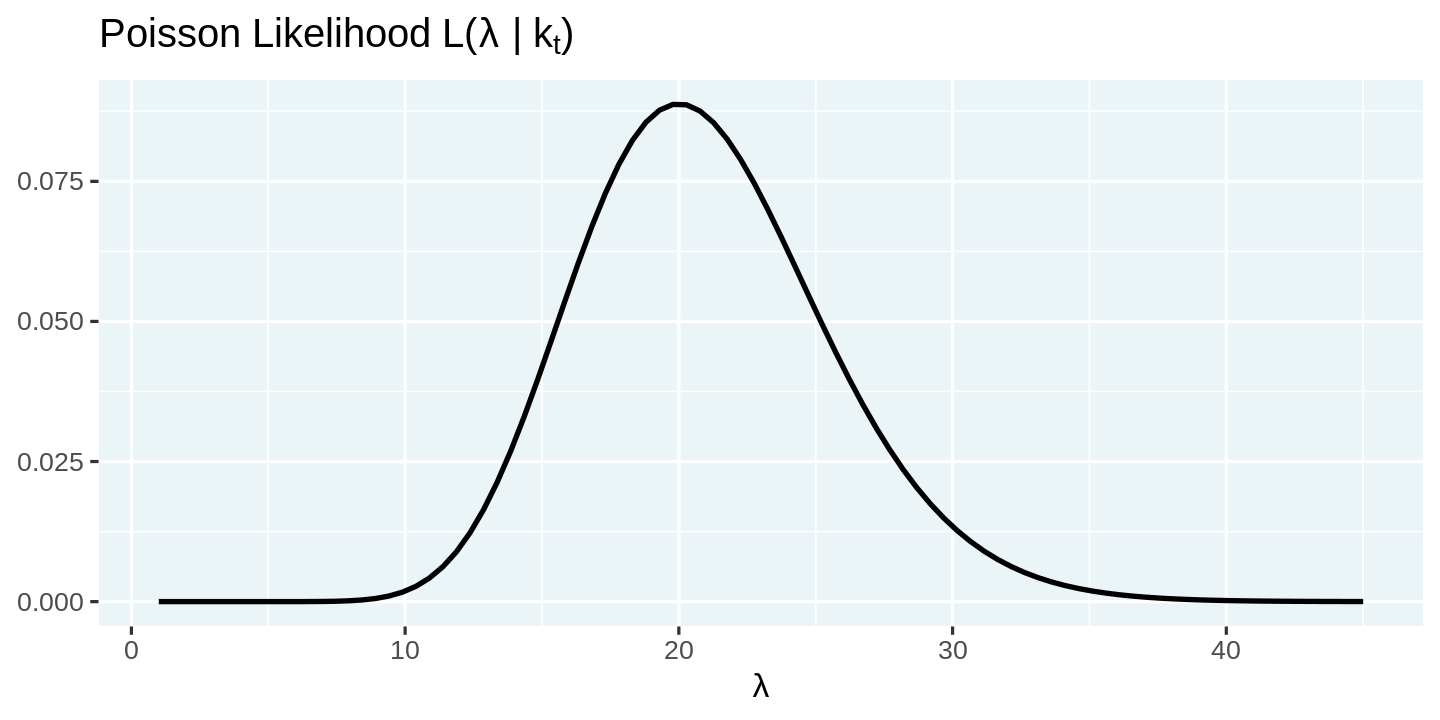
Modelar el proceso de llegadas con una distribución de Poisson nos permite predecir la distribución de casos nuevos en un día en función de la tasa $\lambda$. Pero en la práctica solo observamos el número de llegadas. La pregunta clave es: ¿cómo pasamos del número observado de llegadas a una idea de la distribución de $\lambda$? Por suerte, la respuesta es sencilla.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
La distribución de $\lambda$ dado k se llama función de verosimilitud, y tiene la misma expresión que la función de masa de probabilidad que usamos antes. Podemos visualizarla fijando el número observado de casos nuevos (k) y calculándola en un rango de valores de $\lambda$.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Todo esto está bien, pero quizá te preguntes dónde aparece el número reproductivo efectivo, $R_t$, del que hablamos al principio. ¿Cómo se relaciona con la tasa de llegada $\lambda$? Según el trabajo de Bettencourt y Ribeiro, la relación es bastante simple:
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Ten en cuenta que $\gamma$ es el recíproco del intervalo serial (aproximadamente 4 días para la COVID‑19), y $k_{t-1}$ es el número de casos nuevos observados en el intervalo $t-1$.
Podemos usar esta expresión de $\lambda$ y reformular la verosimilitud en términos de $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Antes de continuar, definamos algunos parámetros clave.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
El siguiente código muestra una forma más eficiente de calcular las verosimilitudes. En lugar de generar lambdas y verosimilitudes por cada combinación, aprovechamos la vectorización de R y los data frames anidados. Así generamos un vector de lambdas y verosimilitudes por día, y luego usamos tidyr::unnest para aplanarlo.
Además de ser más eficiente, diría que este código es más legible y traduce las fórmulas con la mínima complejidad.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Ya podemos representar la verosimilitud condicionada al número de casos nuevos observados.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
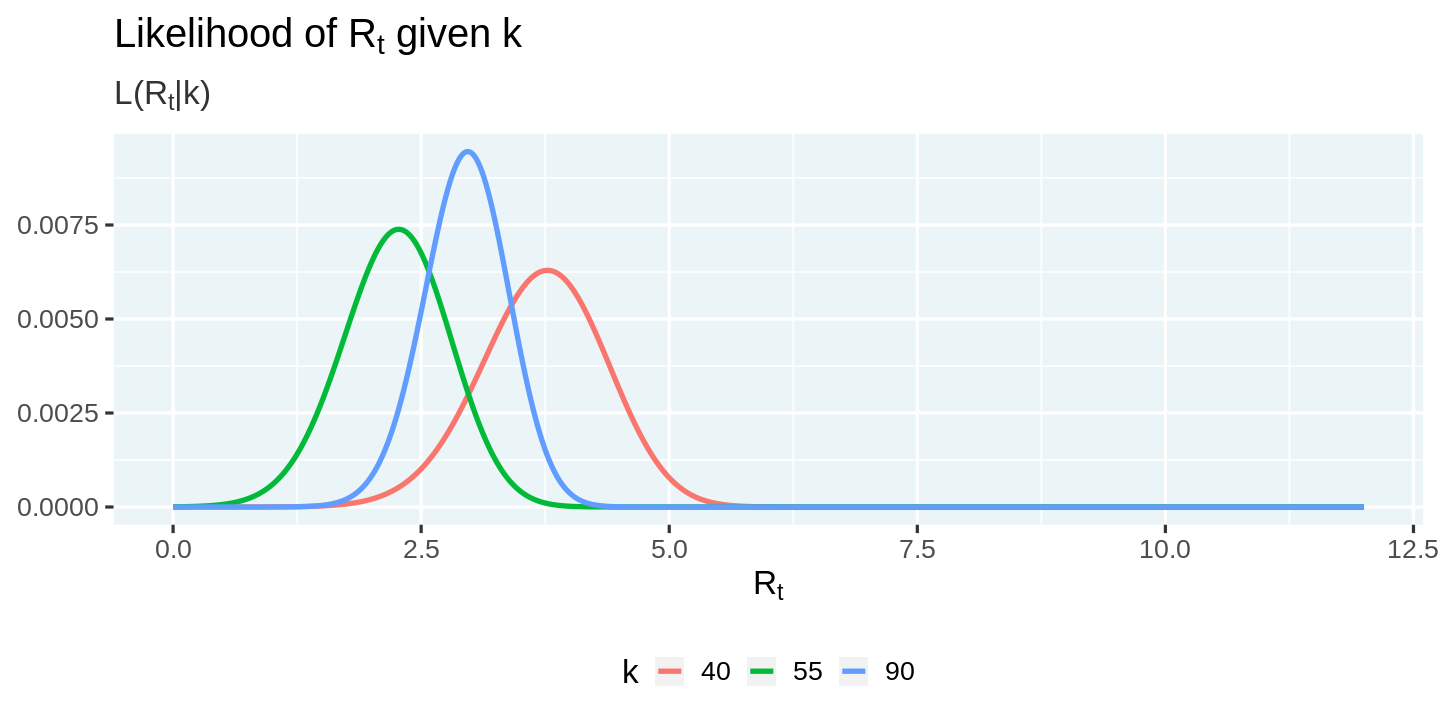
Hemos avanzado bien conectando el número de casos nuevos, $k$, con el número reproductivo efectivo, $R_t$. Pero aún no tenemos un método tangible para estimar sus valores a partir de la serie temporal de casos observados. Aquí es donde la omnipresente regla de Bayes viene de perlas. Bettencourt y Ribeiro expresan la distribución de probabilidad de $R_t$ como
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin desglosa esta ecuación compleja en términos mucho más sencillos.
Esto dice que, tras observar 𝑘 casos nuevos, creemos que la distribución de 𝑅𝑡 es igual a:
- las creencias previas sobre el valor de $P(R_t)$ sin los datos…
- por la verosimilitud de ver $k$ casos nuevos dado $R_t$…
- dividido por la probabilidad de ver tantos casos en general.
Si usamos la probabilidad posterior del periodo anterior, $P(R_{t-1} | k_{t-1})$, como previa, $P(R_t)$, para el periodo actual, podemos reescribir la ecuación como:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Iterando hacia atrás hasta $t = 0$, obtenemos
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Con una previa uniforme $P(R_0)$, esto se reduce a:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Ahora podemos usar esta expresión para calcular la posterior a partir de las verosimilitudes. De nuevo, usamos la función vectorizada cumprod para generar las posteriores de todos los días a la vez y luego normalizarlas.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Ahora podemos visualizar la distribución posterior.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
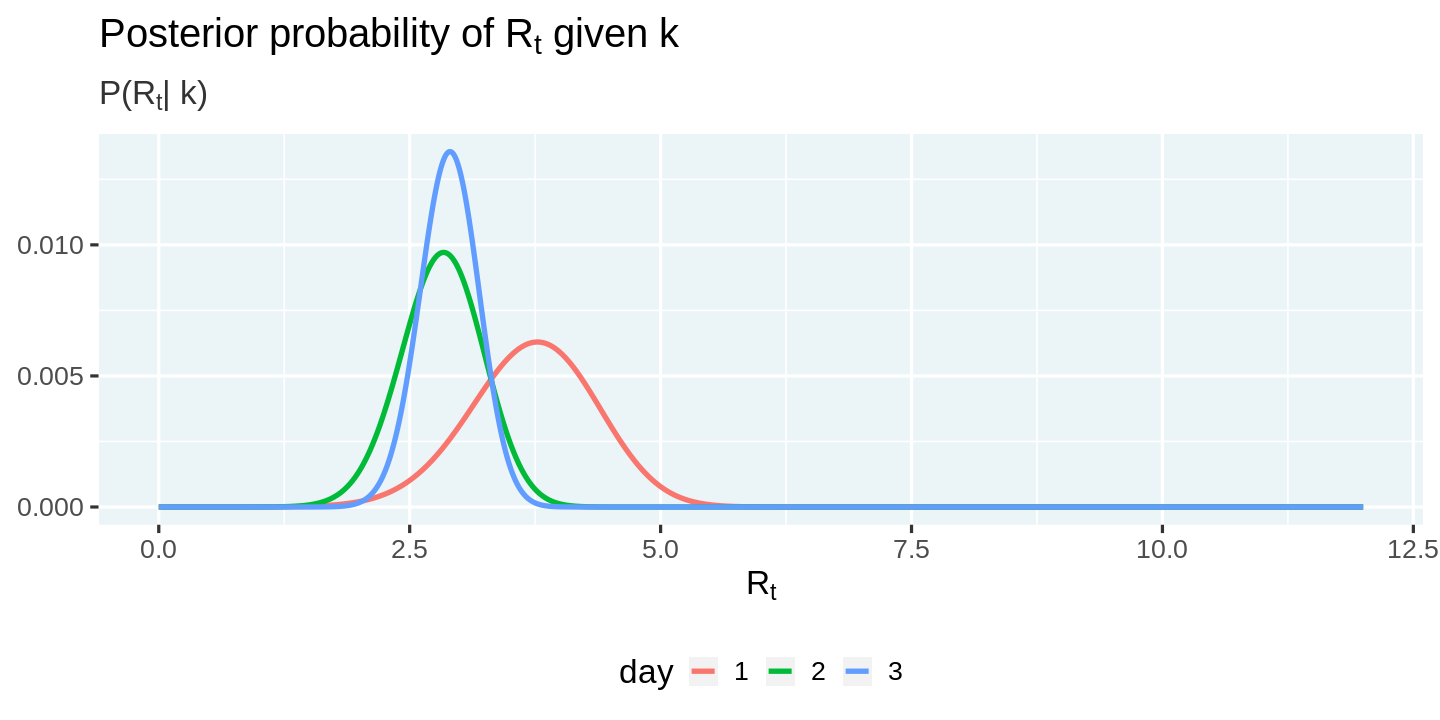
Estas posteriores nos permiten responder la pregunta clave:
¿Cuál es el valor más probable de $R_t$ cada día?
Al estimar cualquier magnitud, es importante dar una idea del error asociado. Una forma popular es usar los intervalos de máxima densidad (HDI).
Otra forma de resumir una distribución es el intervalo de máxima densidad, que especifica un intervalo que abarca, por ejemplo, el 95% de la distribución, de modo que cada punto dentro del intervalo tiene mayor credibilidad que cualquier punto fuera de él.
En su artículo, Kevin implementa un algoritmo de fuerza bruta para calcular el HDI. Quienes usamos R tenemos suerte: ya existe un paquete, HDInterval, con una implementación 🎉.
Ahora estimaremos el valor más probable de $R_t$ y su intervalo de máxima densidad. Dado que HDInterval::hdi solo funciona con un vector de valores aleatorios de una distribución, y nosotros solo hemos estimado probabilidades posteriores, tendremos que simular valores aleatorios de $R_t$ usando dichas probabilidades para poder calcular los HDI.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
Podemos visualizar estas estimaciones y su incertidumbre con una línea y una banda.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
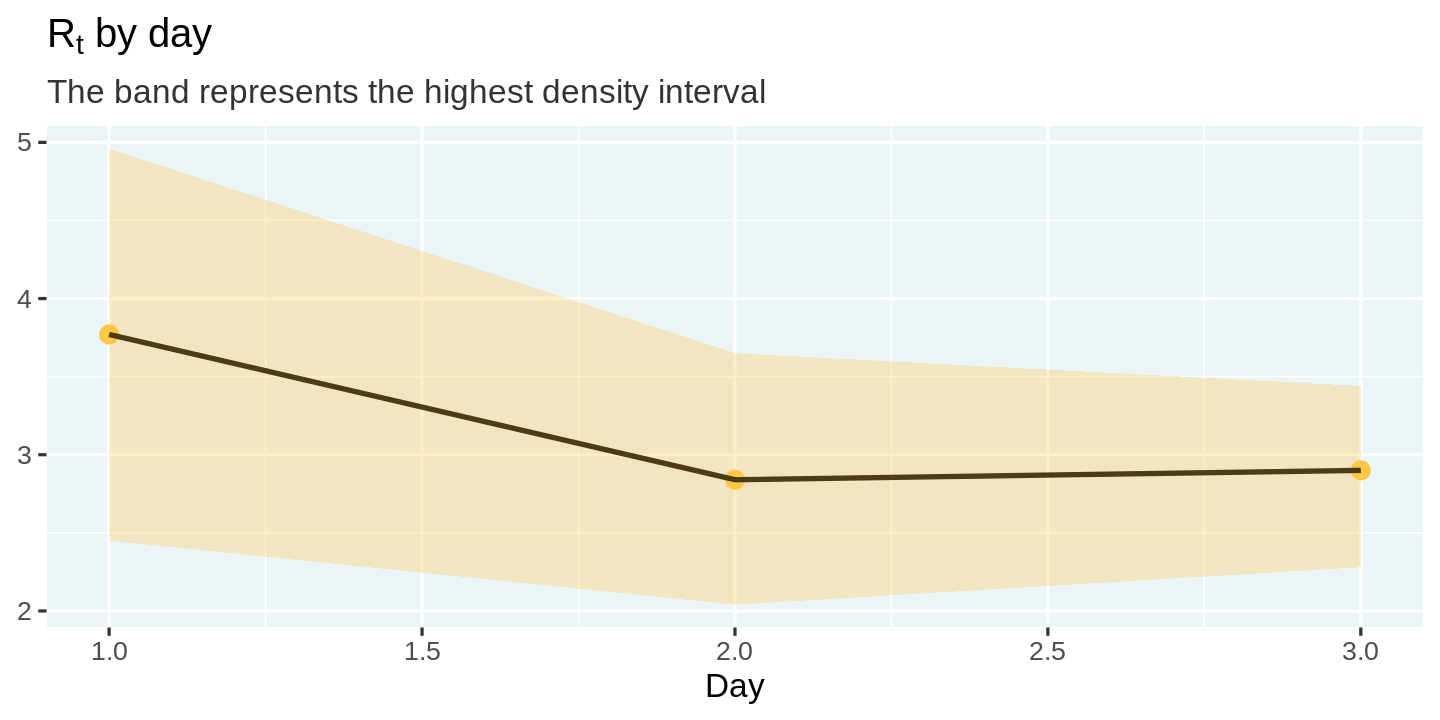
Aun siendo válido el enfoque de Bettencourt y Ribeiro, Kevin señala un problema práctico (también mencionado en el artículo): es posible que la posterior se quede atascada y tienda asintóticamente a 1, por su incapacidad de olvidar periodos con $R_t$ alto.
Para contrarrestarlo, Kevin sugiere lo siguiente.
Propongo incorporar solo los últimos $m$ días de la función de verosimilitud. Así, la previa del algoritmo se construye a partir del pasado reciente, lo cual es mucho más útil que usar todo el historial de la epidemia. Este simple pero importante cambio conduce a: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Usaremos esta modificación para estimar $R_t$ en los distintos estados de EE. UU.
Es momento de aplicar toda esta maquinaria a los datos de la COVID para estimar el número reproductivo efectivo, $R_t$. Empecemos obteniendo los datos. Usaremos el conjunto para EE. UU. elaborado por The New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
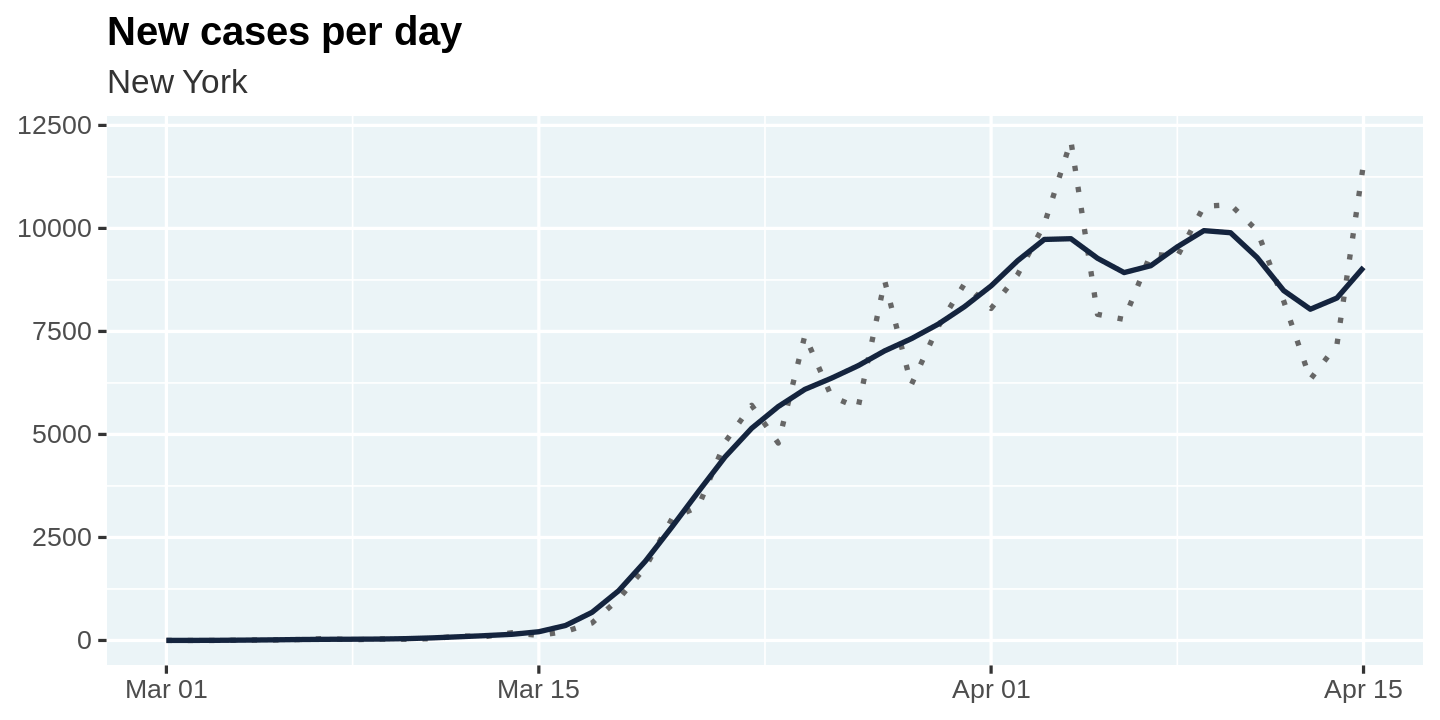
El primer paso es preparar los datos calculando los casos nuevos diarios y suavizándolos con una ventana móvil. El suavizado es esencial para compensar retrasos en la notificación, especialmente acusados los fines de semana.
Siguiendo el enfoque de Kevin, utilizo un suavizado gaussiano con una ventana de 7 días.
Implementaremos todos los pasos de procesamiento como funciones independientes. Aunque añade algo de trabajo, nos permitirá componerlos con claridad y aplicarlos a uno o varios estados, algo muy útil.
Aplicaremos estos pasos a un estado concreto para facilitar la interpretación. He elegido Nueva York, pero puedes cambiarlo por el que prefieras.
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
Grafiquemos los valores en bruto y los suavizados de new_cases para ver qué hace el proceso de suavizado.
🎩 Visualizar tras transformar datos siempre es buena práctica: te ayuda a crear intuición y verificar que la transformación hace lo que esperas.
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
El segundo paso es calcular las verosimilitudes. Seguiremos el mismo enfoque que antes, con una diferencia notable: calcularemos log-verosimilitudes en lugar de verosimilitudes. Así será más fácil suavizarlas con una ventana móvil para aplicar la modificación de Kevin, usando solo los últimos $m$ intervalos para calcular $R_t$.
Como antes, calcularemos las verosimilitudes por día como una lista anidada y después aplanaremos con tidyr::unnest.
🎩 Las columnas de listas son muy útiles al trabajar con datos. El patrón que usamos aquí funciona en muchas situaciones.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
El tercer paso es calcular las probabilidades posteriores. Recuerda que
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Podemos reescribirlo en términos de log-verosimilitudes
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Usaremos rollapplyr de zoo para calcular una suma móvil de 7 días de log-verosimilitudes, y luego exponentiarlas para obtener la posterior. Finalmente, normalizamos a 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
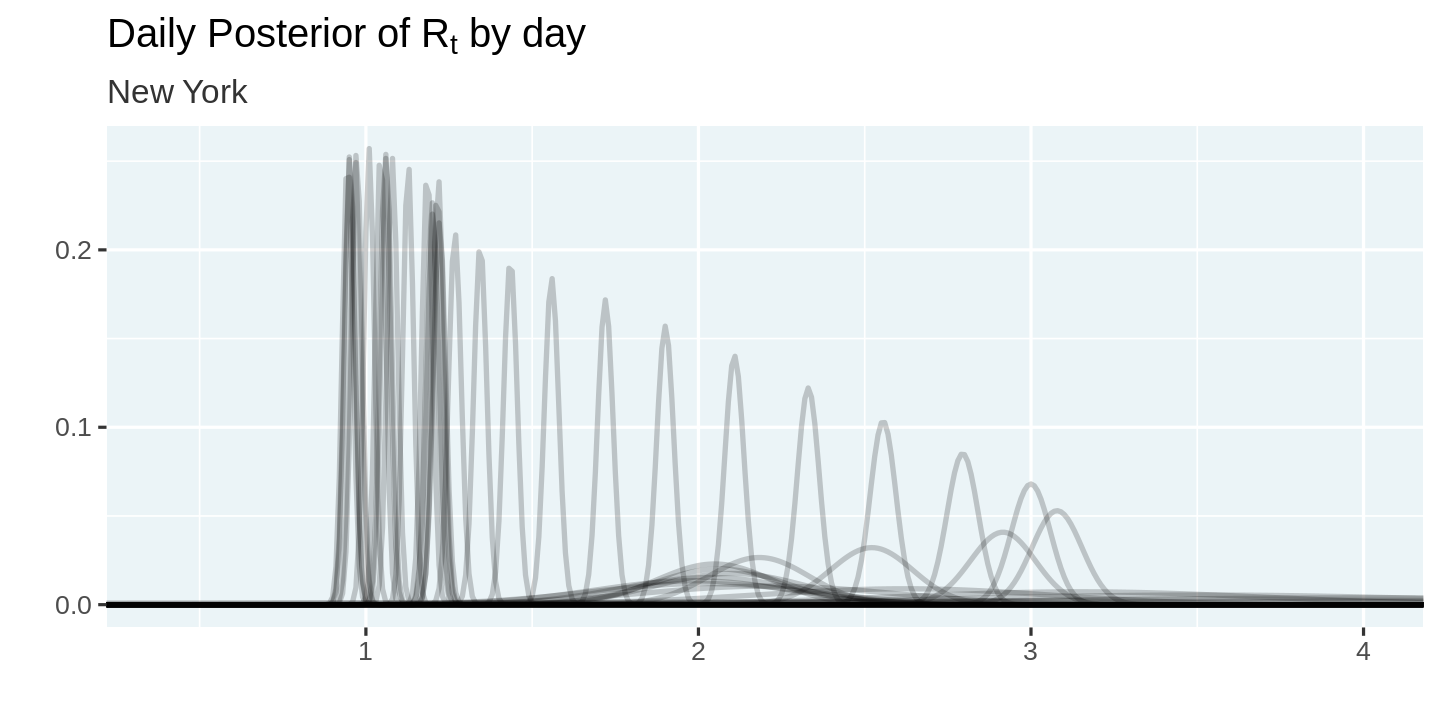
Visualicemos las probabilidades posteriores que hemos calculado. Observa cómo ajustamos alpha = 0.2 para reducir el solapamiento y ver cómo se desplazan.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
El último paso es estimar los valores de $R_t$ y sus intervalos de máxima densidad. Recuerda que debemos simular valores aleatorios de $r_t$ usando las probabilidades posteriores para aplicar HDIInterval::hdi.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Y ahora, el momento de la verdad. Visualicemos los valores estimados de $R_t$.
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
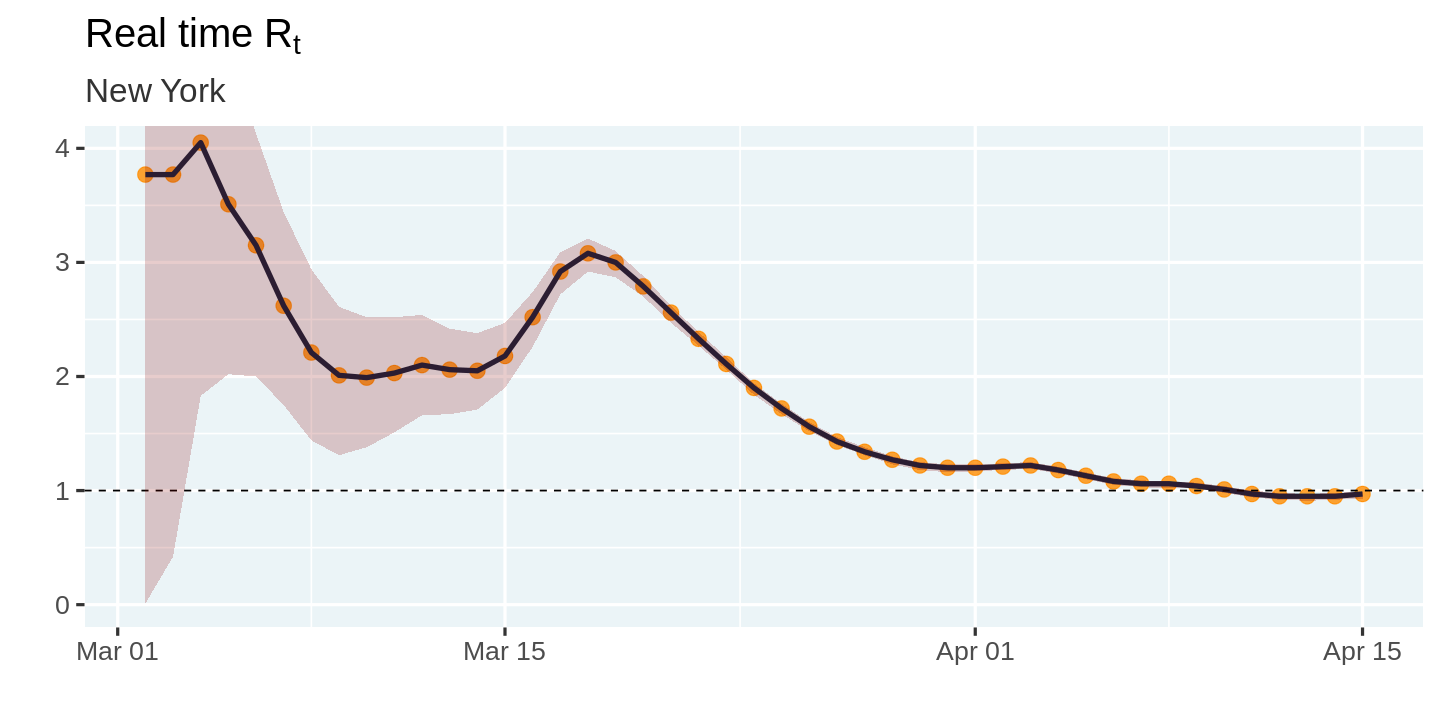
¿Cómo se compara esto con las estimaciones del artículo de Kevin? Parece que las estimaciones iniciales de mi modelo difieren de las suyas. No obstante, podría deberse a diferencias en el algoritmo de suavizado o a la gran incertidumbre de las primeras estimaciones. La forma general de la curva y los picos sí coinciden bastante. ¡Misión cumplida! 🎉
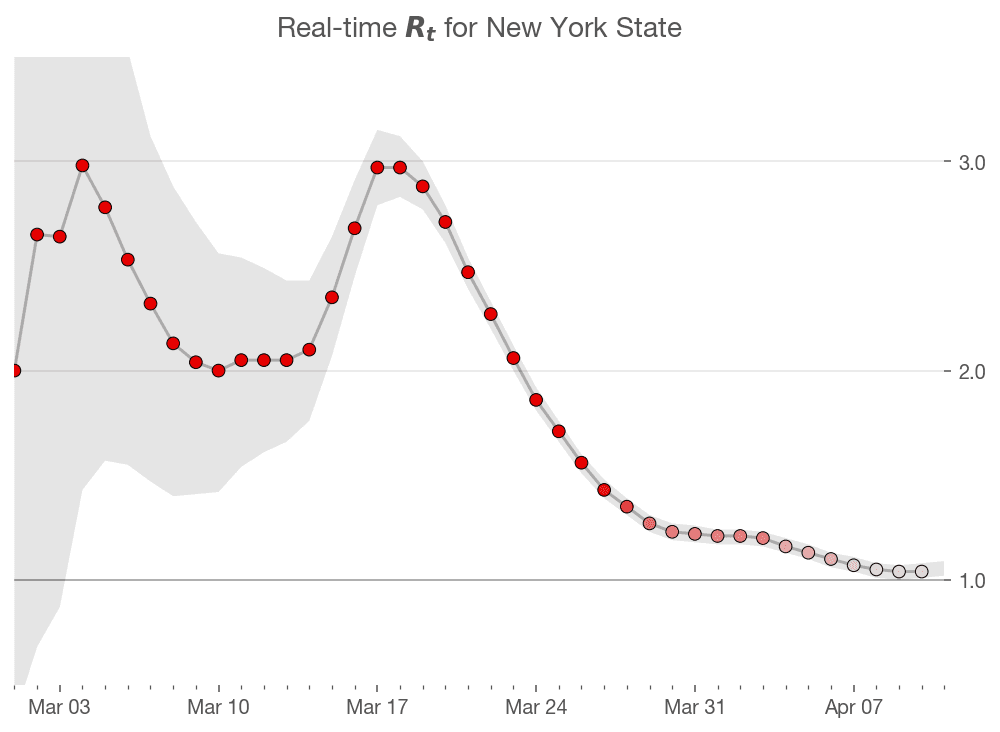
Ha llegado el momento de iterar por todos los estados y calcular estas estimaciones. Podemos hacerlo fácilmente agrupando por state, dividiendo en una tabla por estado y usando purrr::map_df para estimar $R_t$ en cada estado y recombinarlo en una sola tabla.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
Ahora podemos crear un pequeño múltiple de gráficos con las estimaciones por estado. Con ggplot2 es muy sencillo: ¡solo añadimos una línea!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
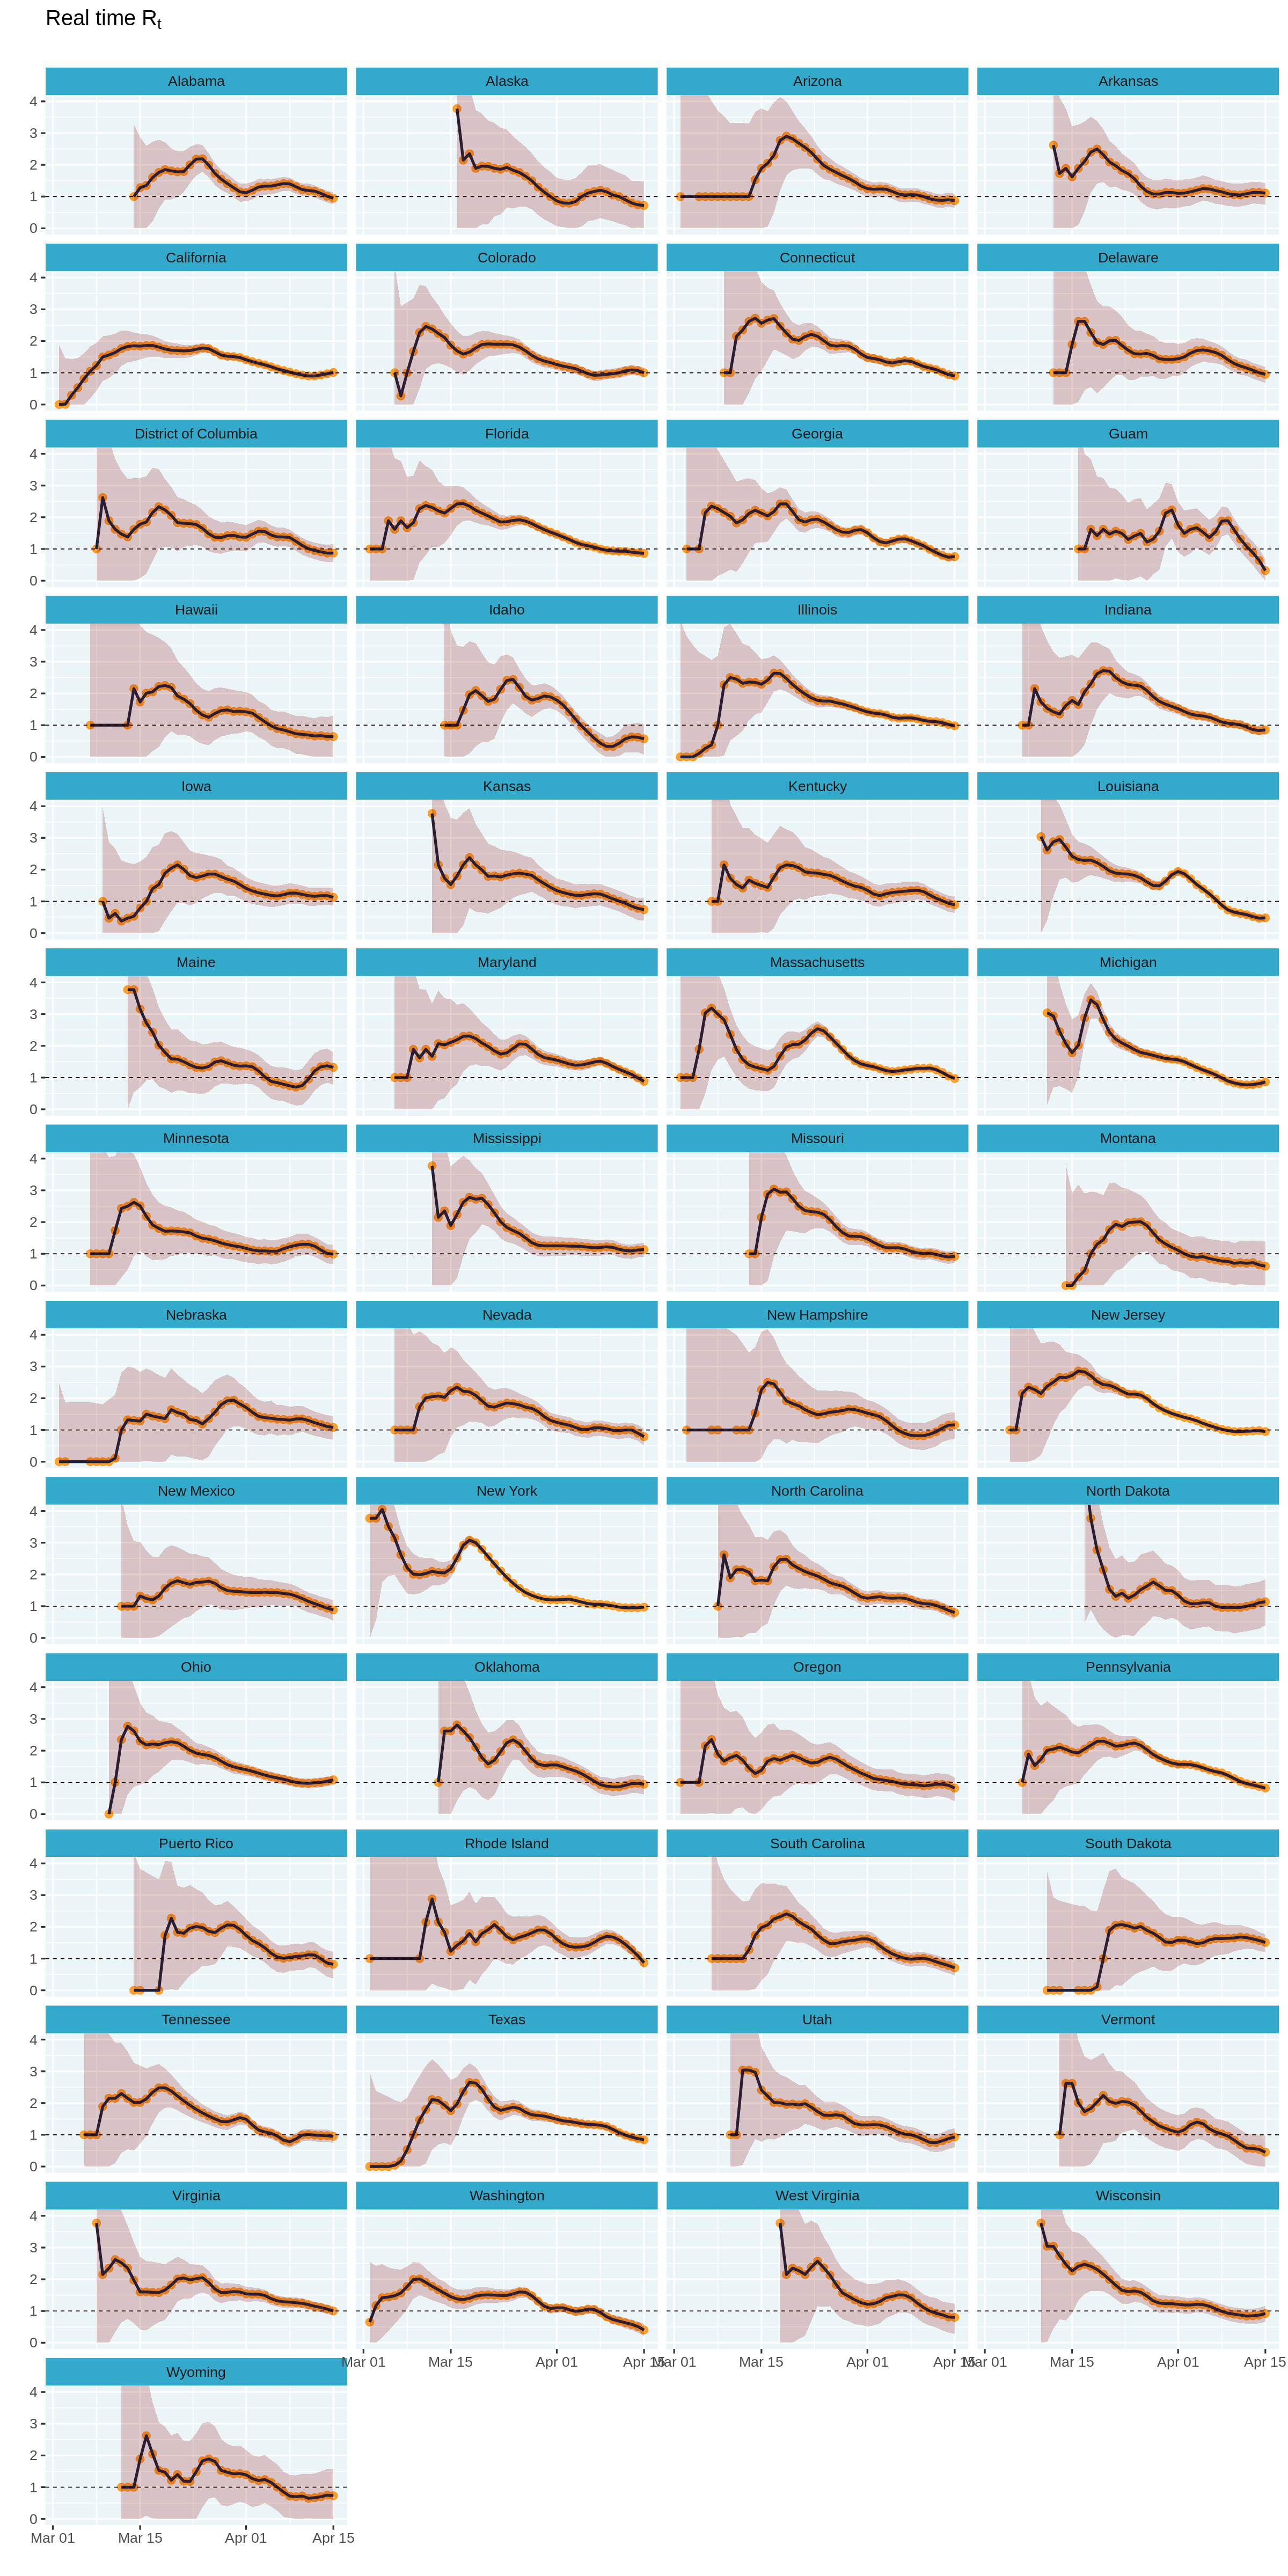
Aunque el panel de pequeños múltiplos es útil, cuesta ubicar un estado por su posición geográfica. ¿Y si pudiéramos colocar cada estado cerca de su ubicación real?
Por suerte, Ryan Hafen creó el paquete geofacet que permite disponer estos pequeños múltiplos en una cuadrícula geográfica con una sola línea de código.
⚠️ Por desgracia, no pude instalar geofacet en Colab (sospecho que por dependencias de sistema del paquete sf), así que el siguiente bloque fallará. He incluido una versión guardada del gráfico generado localmente para que veas el resultado.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

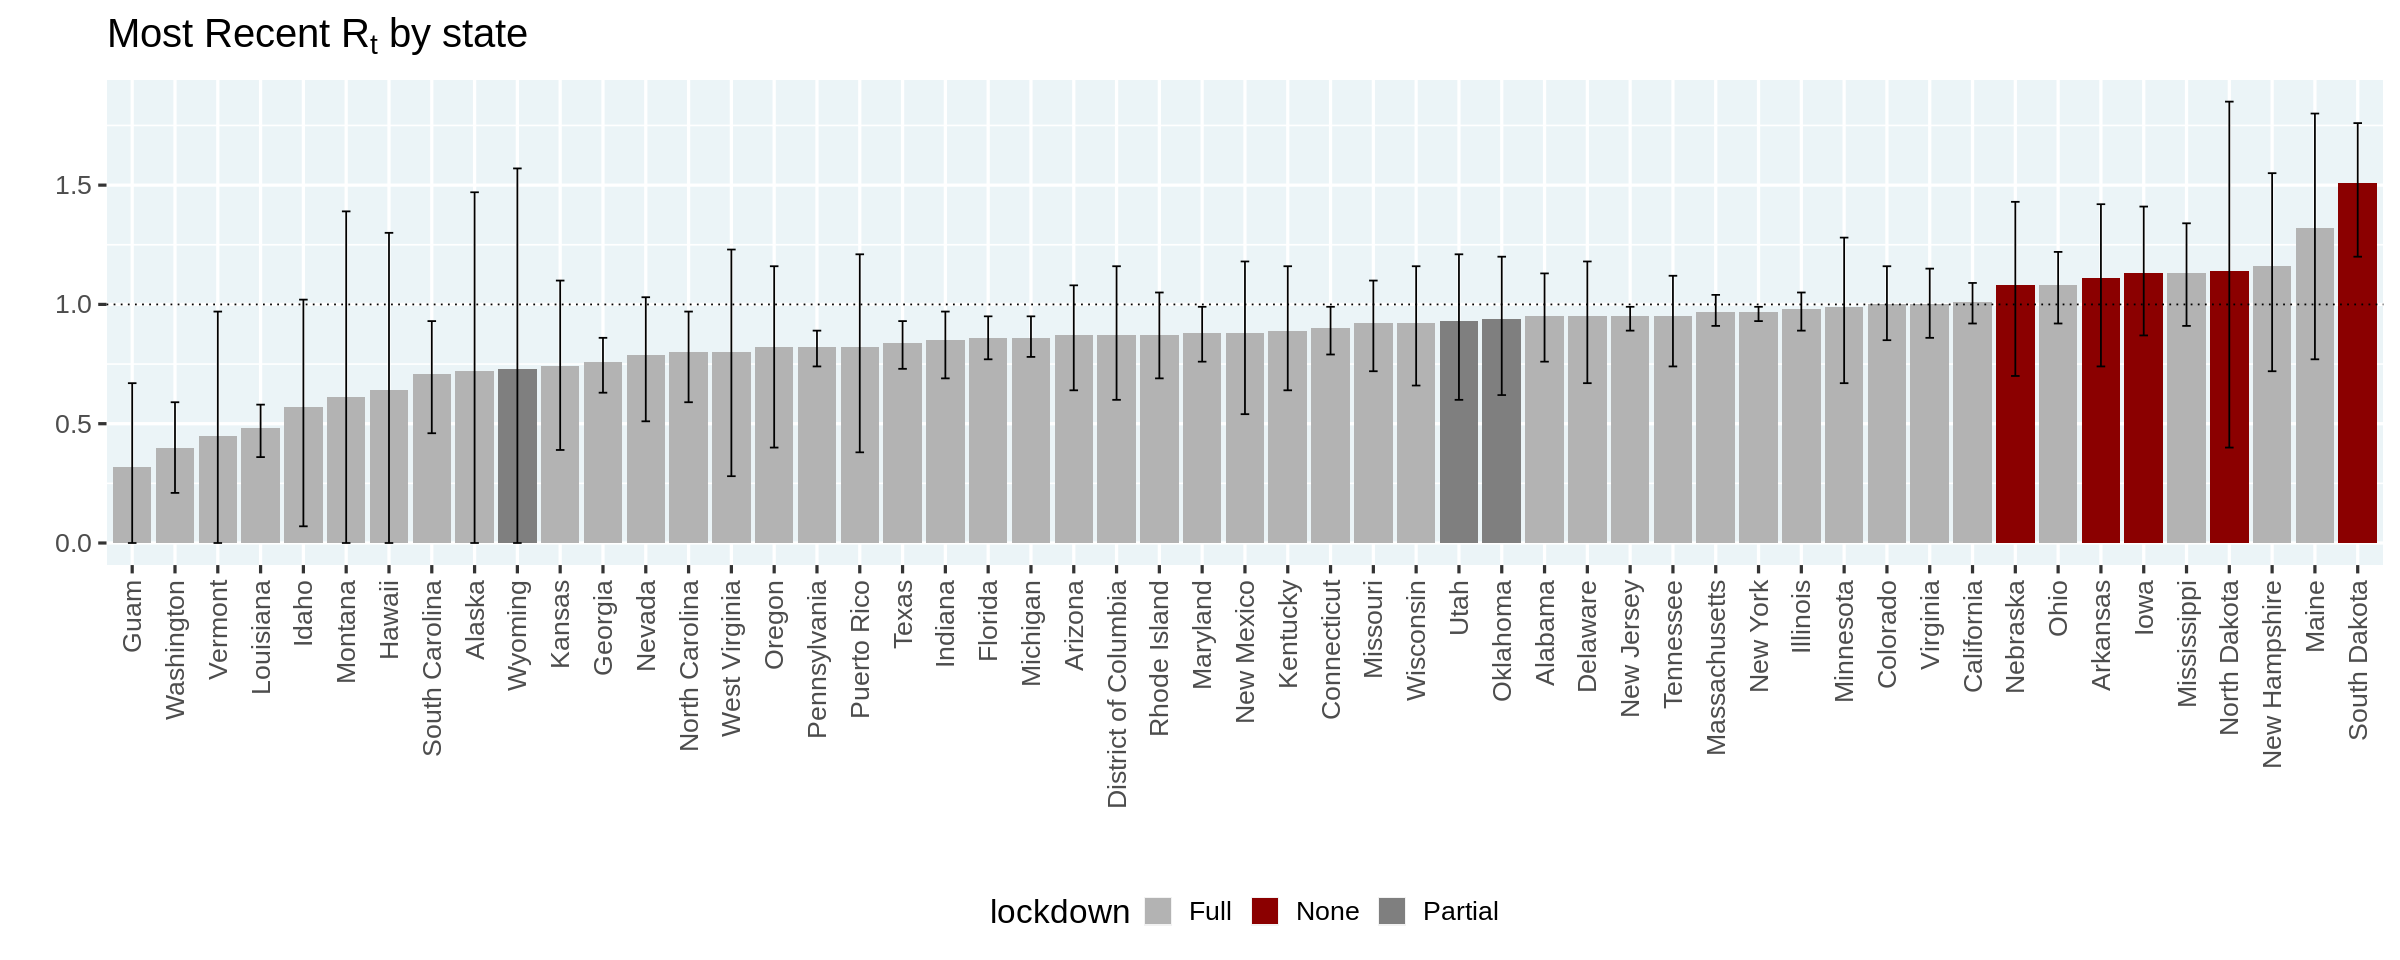
Por último, recreemos el gráfico del artículo de Kevin que ordena los estados según el valor más probable de $R_t$ y los colorea según la situación de confinamiento.
⚠️ Ten en cuenta que es un gráfico puramente descriptivo y no permite extraer conclusiones sobre la eficacia de los confinamientos.
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
En este artículo replicamos el análisis de Kevin en R usando el tidyverse. Aprendimos trucos útiles para calcular verosimilitudes y posteriores. ¡He aprendido muchísimo en el proceso!
Se me ocurren varios próximos pasos, pero destaco uno: dado que las funciones desarrolladas aquí dependen de una tabla de entrada bastante simple con tres columnas: location, date, cases, un paso interesante sería convertir esto en un paquete de R. Así sería más fácil estimar $R_t$ para otras geografías.
Quiero terminar dando las gracias a Kevin Systrom por publicar un artículo tan interesante y compartir su código. También a mis colegas de DataCamp por sus excelentes comentarios sobre una versión inicial.
Si tienes comentarios o sugerencias sobre este artículo, puedes encontrarme en Twitter @ramnath_vaidya y en github. Para aprender más sobre programación en R
Aprende más sobre R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
blog
Summer Worsley
15 min
Tutorial
Łukasz Deryło
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
12 min