
Last chance! 50% off DataCamp Premium
Sale ends in
Segui Ramnath Vaidyanathan su Twitter. Questa analisi è stata pubblicata originariamente su Google Colab.
Kevin Systrom ha pubblicato un articolo davvero interessante sulla stima di $R_t$, la misura nota come numero di riproduzione effettivo. Nel suo articolo, Kevin descrive questo numero come:
Il numero di persone che si infettano per ogni persona contagiosa al tempo 𝑡
Kevin è stato così gentile da pubblicare il suo codice come notebook su github. Volevo fare di più con il suo modello e applicarlo anche ad altri paesi. Tuttavia, dato che sono molto più a mio agio con R, ho voluto prima replicare i suoi risultati in R.
Prima di leggere il resto di questo post, ti consiglierei vivamente di leggere l’articolo originale per capire più nel dettaglio l’approccio di modellazione usato, dato che questo post è più focalizzato sul codice.
Tutti i crediti per l’approccio di modellazione e il codice vanno a Kevin 👍. Questo notebook è il mio umile tentativo di tradurre il suo modello in R. Eventuali errori restanti sono solo miei.
Useremo lo stesso approccio delineato da Kevin nel suo articolo, che utilizza come base il paper di Bettencourt & Ribeiro.
Il primo passo è modellare il processo di “arrivo” delle infezioni. Una scelta comune tra gli statistici per la distribuzione degli arrivi è la distribuzione di Poisson. Di conseguenza, se lasciamo che $\lambda$ rappresenti il tasso medio di infezioni al giorno, allora la probabilità di osservare $k$ nuovi casi in un giorno è data da
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Dato questo impianto, possiamo costruire la distribuzione di probabilità dei nuovi casi per un insieme di valori di $\lambda$. Prima di scrivere codice, dobbiamo caricare il set di pacchetti tidyverse e personalizzare alcune opzioni di plotting (dimensioni, impostazioni, ecc.). Puoi saltare pure questa sezione, non è cruciale per il racconto, ma assicurati di eseguire il codice.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Possiamo usare la funzione crossing di purrr per calcolare le densità di probabilità su una combinazione di $k$ e $\lambda$. È un approccio elegante, anche se computazionalmente subottimale, dato che non sfruttiamo davvero le capacità di vettorizzazione di dpois. Vedrai un approccio più efficiente in una sezione successiva.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Possiamo visualizzare queste probabilità usando ggplot2. Nota come utilizziamo expression per rendere i simboli matematici nei grafici. Puoi leggere di più nella documentazione di plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
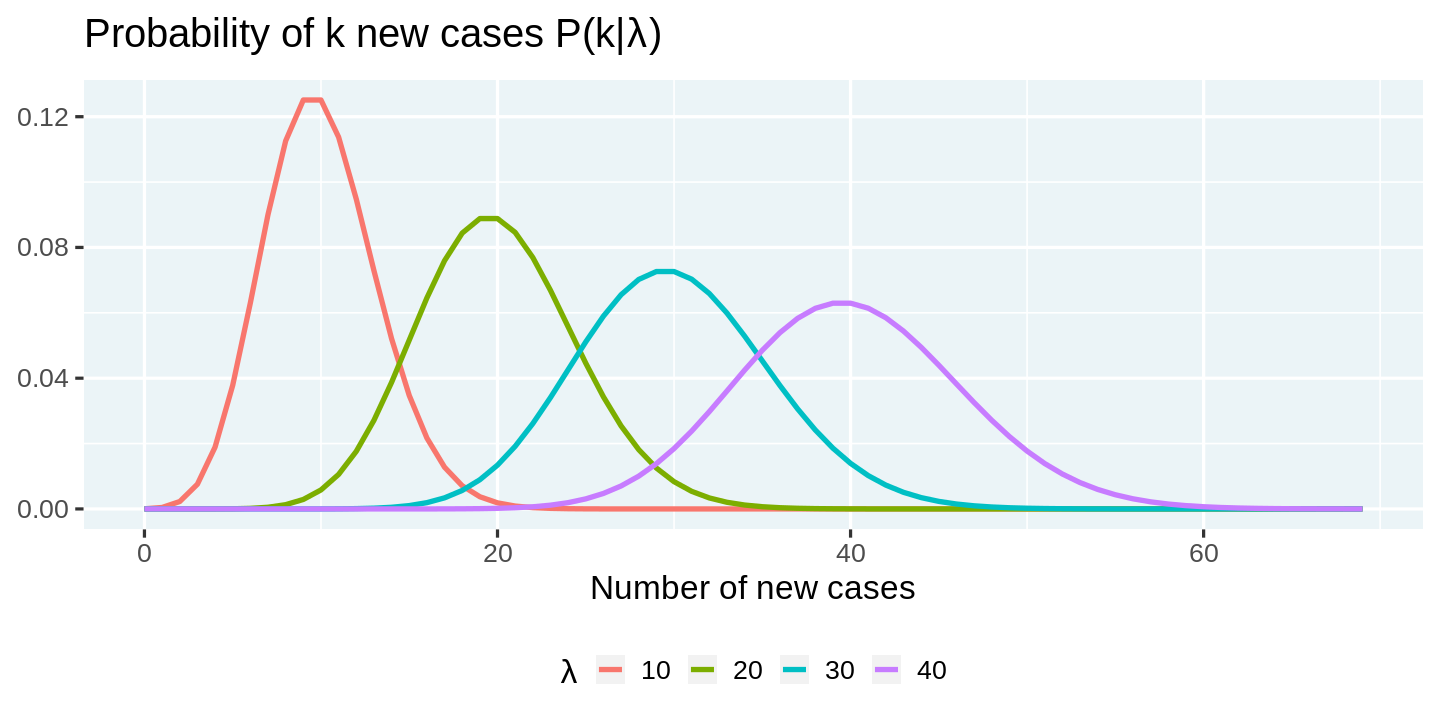
Modellare il processo di arrivo con una distribuzione di Poisson ci consente di prevedere la distribuzione dei nuovi casi in un giorno in funzione del tasso di arrivo $\lambda$. Tuttavia, nella realtà osserviamo solo il numero di arrivi. Quindi la domanda chiave è: come passiamo dal numero di arrivi osservato a una stima della distribuzione di $\lambda$? Per fortuna, la risposta è semplice.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
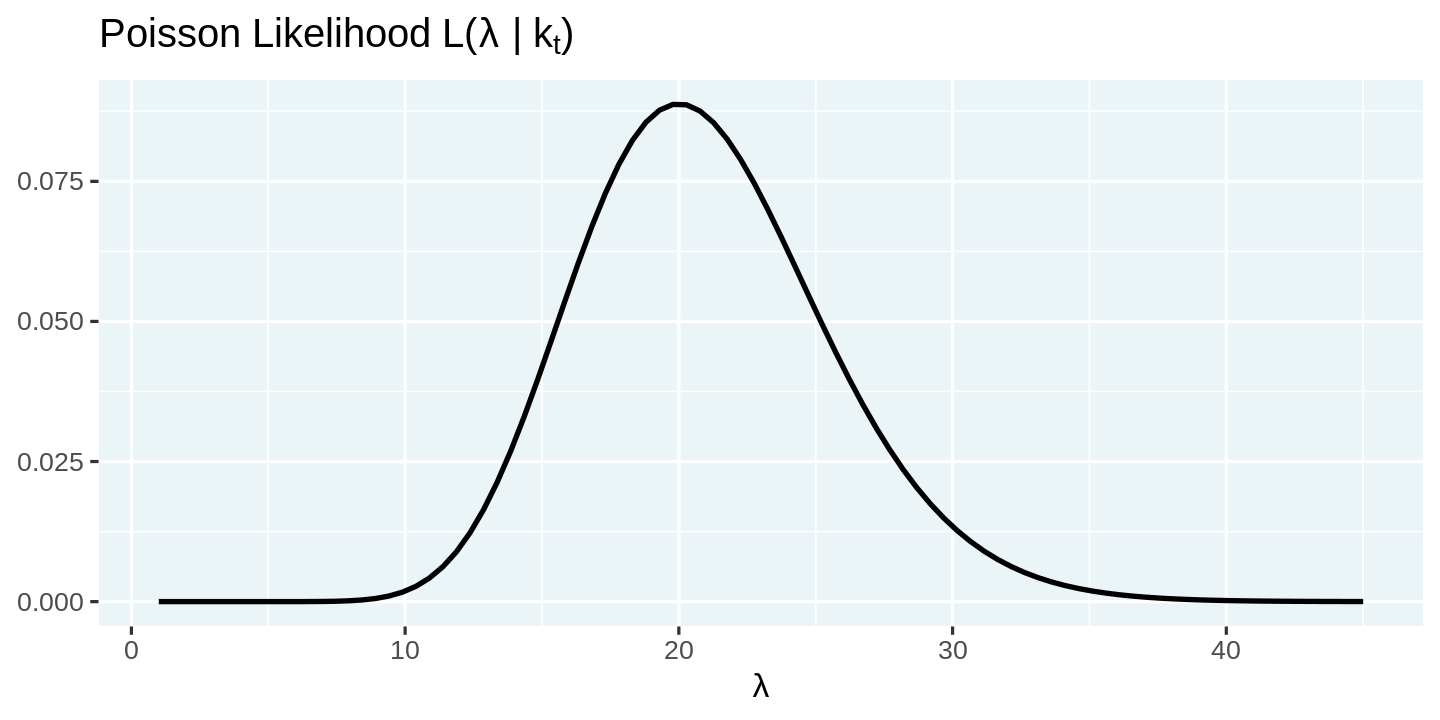
La distribuzione di $\lambda$ su k è detta funzione di verosimiglianza e ha la stessa espressione matematica della funzione di massa di probabilità usata prima. Possiamo visualizzare la funzione di verosimiglianza fissando il numero di nuovi casi osservati (k) e calcolandola su un intervallo di valori di $\lambda$.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
Tutto bene, ma forse ti stai chiedendo dove sia il tasso di infezione effettivo, $R_t$, di cui abbiamo parlato all’inizio. Come è collegato al tasso di arrivo $\lambda$? Secondo il paper di Bettencourt & Ribeiro, la relazione è piuttosto semplice
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Nota che $\gamma$ qui è il reciproco dell’intervallo seriale (circa 4 giorni per COVID19), e $k_{t-1}$ è il numero di nuovi casi osservati nell’intervallo temporale $t-1$.
Possiamo usare questa espressione per $\lambda$ e riformulare la funzione di verosimiglianza in termini di $R_t$.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Prima di proseguire, impostiamo alcuni parametri di base.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
Il codice seguente mostra un modo più efficiente dal punto di vista computazionale per calcolare le verosimiglianze. Invece di generare le lambda e le verosimiglianze separatamente per ogni combinazione, usiamo la natura vettoriale delle funzioni in R e la possibilità di avere dataframe annidati. Questo ci consente di generare un vettore di lambda e verosimiglianze per ogni giorno e poi usare tidyr::unnest per “spacchettarlo” in una tabella piatta.
Oltre all’efficienza computazionale, direi che questo codice è più leggibile e traduce le formule matematiche con un sovraccarico minimo.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Ora possiamo tracciare la verosimiglianza condizionata al numero di nuovi casi osservati.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
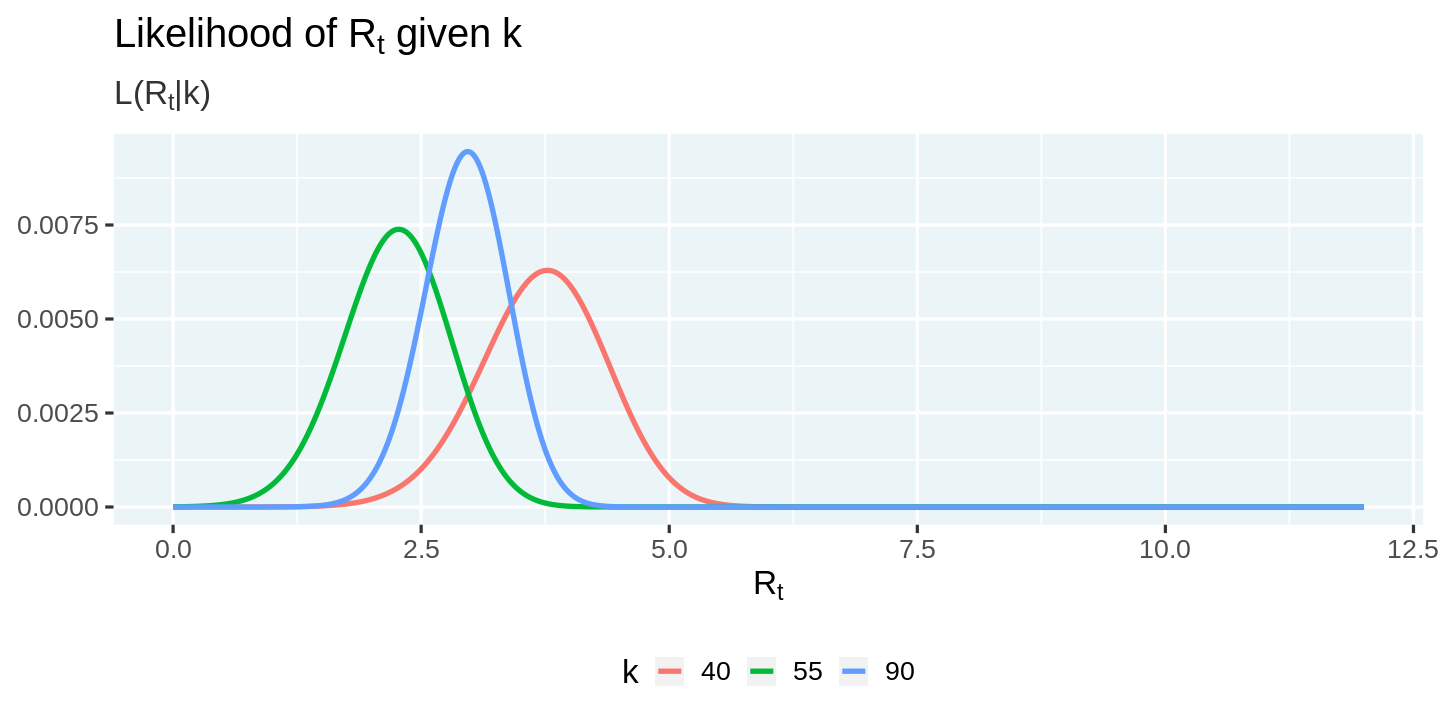
Abbiamo fatto buoni progressi nel collegare il numero di nuovi casi, $k$, e il tasso di infezione effettivo, $R_t$. Tuttavia, non abbiamo ancora un approccio concreto per stimarne i valori a partire dalla serie storica dei nuovi casi osservati. Qui torna utilissima la regola di Bayes. Bettencourt & Ribeiro esprimono la distribuzione di probabilità di $R_t$ come
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin scompone questa equazione complessa in termini molto più semplici.
Questo dice che, avendo osservato 𝑘 nuovi casi, riteniamo che la distribuzione di 𝑅𝑡 sia uguale a:
- le credenze a priori sul valore di $P(R_t)$ senza i dati ...
- moltiplicate per la verosimiglianza di osservare $k$ nuovi casi dato $R_t$ ...
- divise per la probabilità di osservare in generale così tanti casi.
Se usiamo la probabilità a posteriori del periodo precedente, $P(R_{t-1} | k_{t-1})$, come prior, $P(R_t)$, per il periodo corrente, allora possiamo riscrivere l’equazione precedente come:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Iterando indietro nel tempo fino a $t = 0$, otteniamo
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Con un prior uniforme $P(R_0)$, questo si riduce a:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Possiamo ora usare questa espressione matematica per calcolare il posteriore a partire dalle verosimiglianze. Ancora una volta, usiamo la funzione vettorializzata cumprod per generare i posteriori per tutti i giorni in una volta, e poi normalizzarli.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Ora possiamo visualizzare la distribuzione a posteriori.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
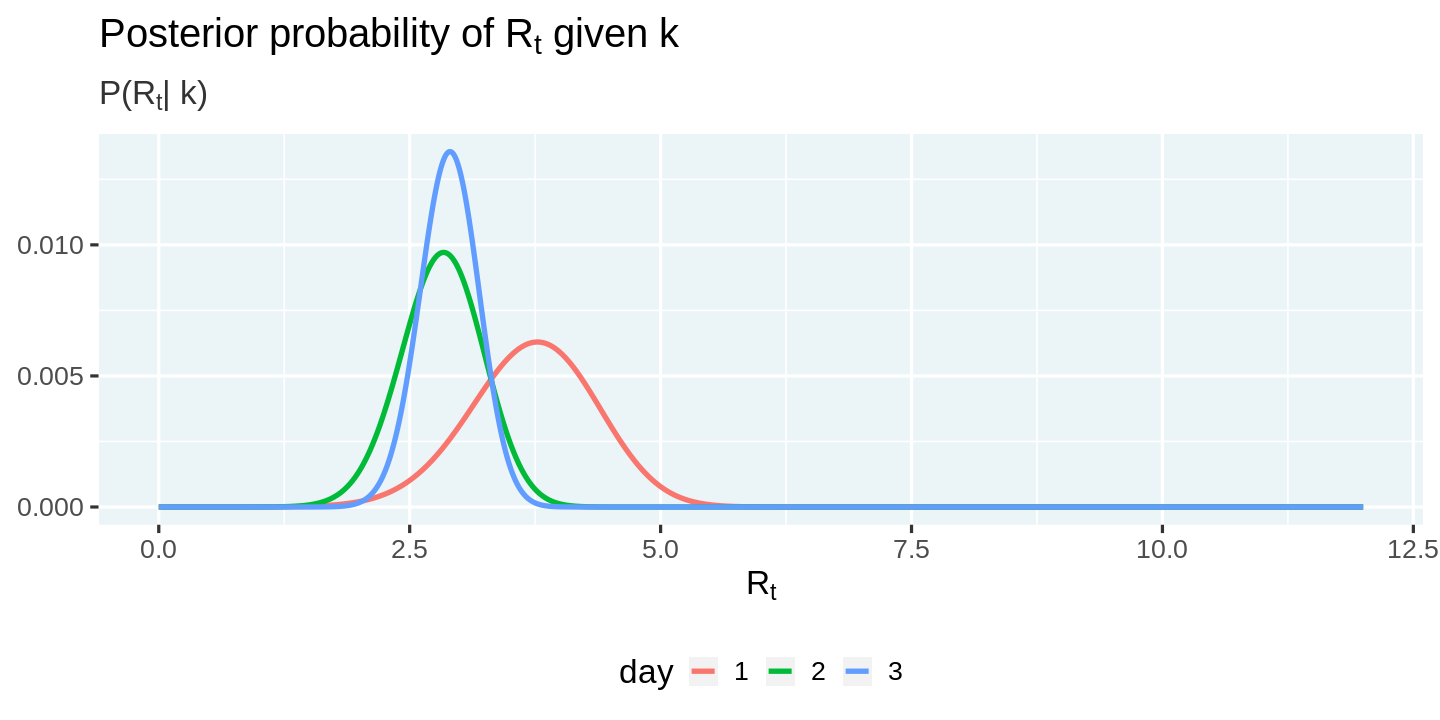
Questi posteriori ora ci consentono di rispondere alla domanda più importante:
Qual è il valore più probabile di $R_t$ ogni giorno?
Nello stimare qualsiasi quantità, è molto importante fornire un’idea dell’errore attorno alla stima. Un modo diffuso per farlo è usare gli intervalli di massima densità.
Un altro modo per riassumere una distribuzione è l’intervallo di massima densità, che riassume la distribuzione specificando un intervallo che copre la maggior parte della distribuzione, diciamo il 95%, tale che ogni punto all’interno dell’intervallo abbia credibilità superiore a qualsiasi punto al di fuori dell’intervallo.
Nel suo articolo, Kevin ha implementato un algoritmo brute force per calcolare l’HDI. Gli utenti R sono più fortunati: esiste già un pacchetto, HDInterval, con un’implementazione 🎉.
Ora stimeremo il valore più probabile di $R_t$ e l’intervallo di massima densità che lo circonda. Dato che la funzione HDInterval::hdi funziona solo con un vettore di valori casuali da una distribuzione, e noi abbiamo stimato soltanto le probabilità a posteriori, dovremo simulare valori casuali di $R_t$ usando le probabilità a posteriori per poter calcolare gli intervalli di massima densità.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

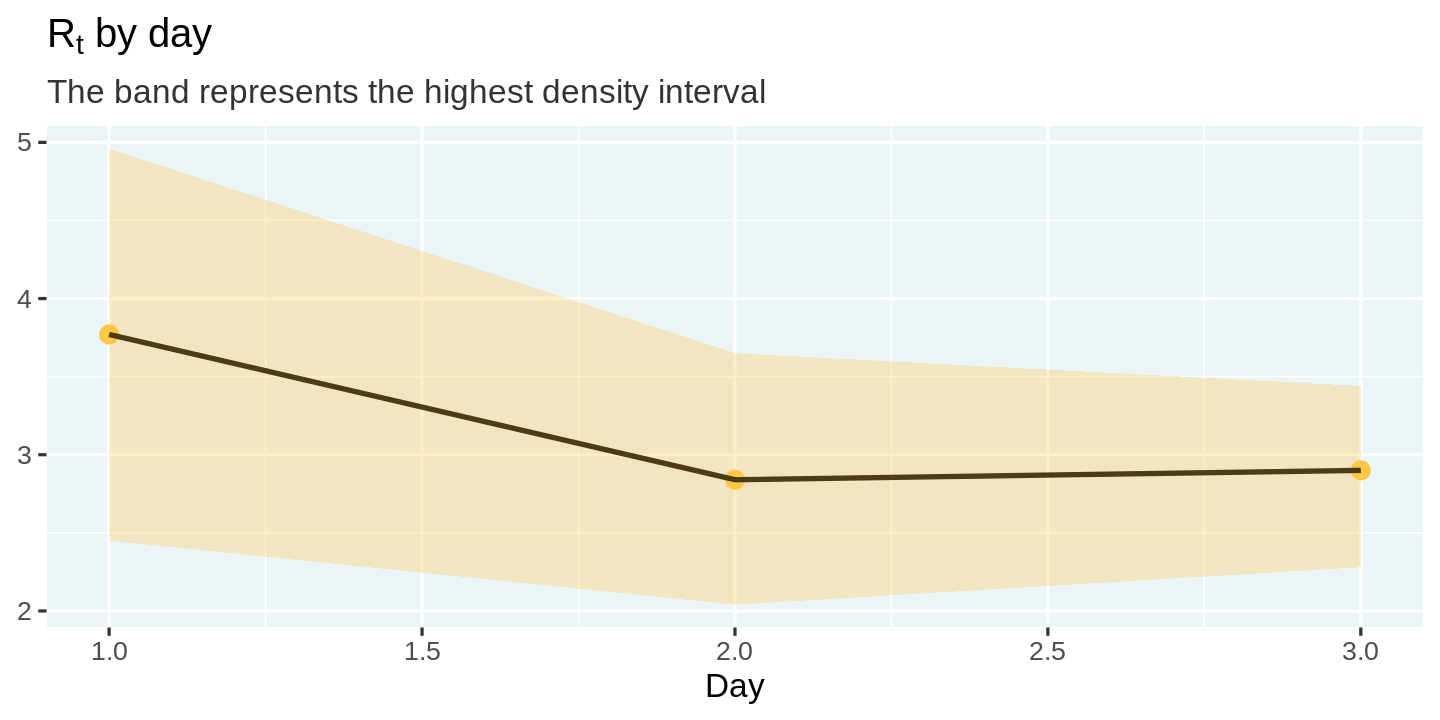
display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
Possiamo visualizzare queste stime e l’incertezza che le circonda usando un grafico a linee con bande.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Sebbene l’approccio di Bettencourt e Ribeiro funzioni, Kevin evidenzia un problema pratico (notato anche nel paper): è possibile che il posteriore si blocchi e si avvicini asintoticamente a 1, a causa dell’incapacità di “dimenticare” i periodi con $R_t$ elevato.
Per ovviare a questo problema, Kevin suggerisce il seguente approccio.
Propongo di incorporare solo gli ultimi $m$ giorni della funzione di verosimiglianza. In questo modo, il prior dell’algoritmo è costruito sul passato recente, che è molto più utile dell’intera storia dell’epidemia. Questo semplice ma importante cambiamento porta a: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Useremo questa modifica per stimare i valori di $R_t$ nei vari stati USA.
È il momento di mettere in pratica tutta questa “macchina” sui dati COVID degli stati USA per stimare il tasso di infezione effettivo, $R_t$. Iniziamo recuperando i dati. Useremo il dataset COVID per gli USA costruito dal New York Times.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
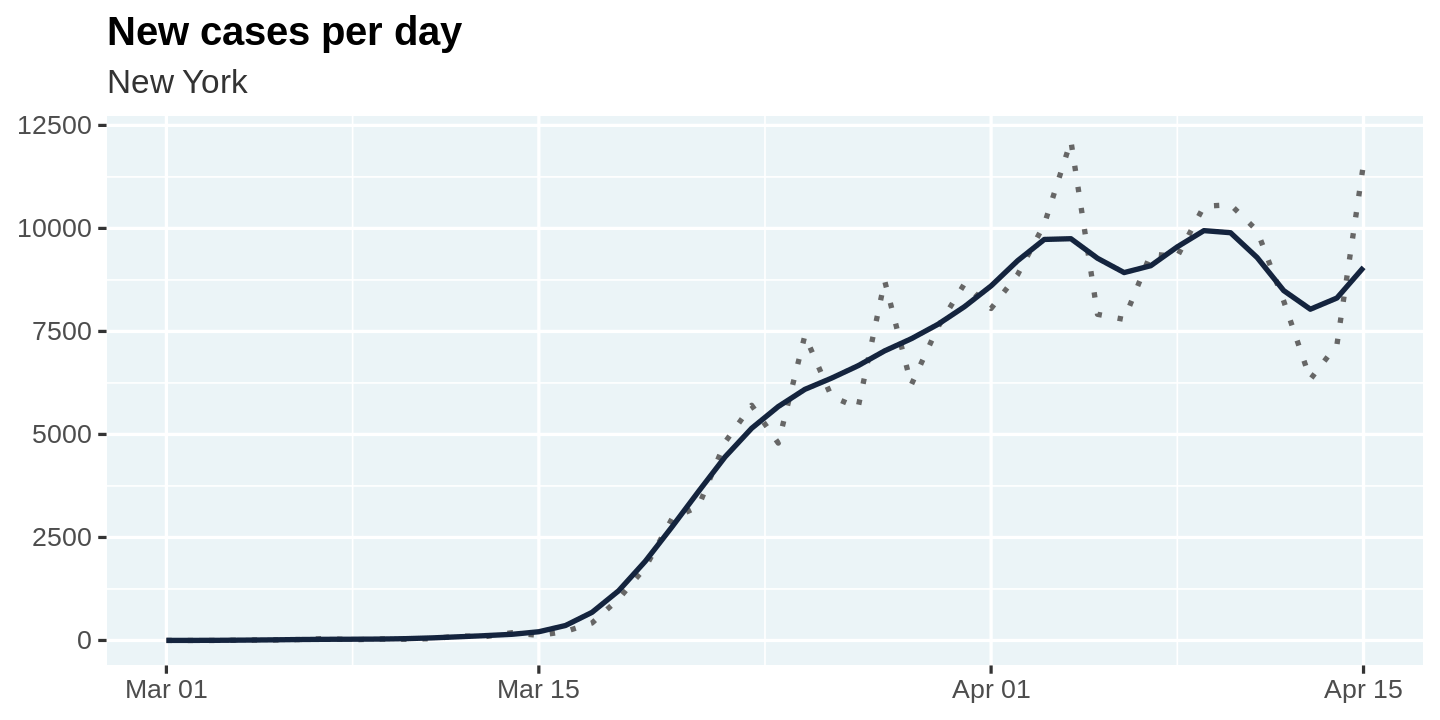
Il primo passo è preparare i dati calcolando il numero di nuovi casi ogni giorno e smussandolo su una finestra mobile. Lo smoothing è essenziale per tener conto dei ritardi di reporting. Il ritardo risulta particolarmente pronunciato nei weekend.
Seguendo l’approccio di Kevin, utilizzo un smoother gaussiano con finestra mobile di 7 giorni.
Nota che implementeremo tutti i passaggi di elaborazione dati come funzioni autonome. Anche se aggiunge un po’ di overhead, ci permette di comporre i passaggi in modo pulito e di applicarli a uno o più stati, cosa molto utile.
Applicheremo questi passaggi a uno stato selezionato, così è più semplice guardare i risultati e interpretarli. Ho scelto New York, ma sentiti libero di cambiarlo con uno stato a tua scelta!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
Tracciamo i valori grezzi e quelli smussati di new_cases così possiamo visualizzare cosa fa il processo di smoothing.
🎩 È sempre una buona pratica visualizzare i risultati dopo aver fatto trasformazioni sui dati. Ti aiuta a farti un’intuizione e a verificare che la trasformazione faccia ciò che intendevi!
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
Il secondo passo è calcolare le verosimiglianze. Useremo lo stesso approccio visto prima, con una differenza notevole: calcoleremo le log-verosimiglianze invece delle verosimiglianze. Questo renderà più semplice smussarle su una finestra mobile per applicare la modifica suggerita da Kevin, ovvero usare solo gli ultimi $m$ intervalli per calcolare $R_t$.
Come prima, calcoleremo le verosimiglianze per ciascun giorno come lista annidata e poi appiattiremo i risultati in una tabella usando tidyr::unnest.
🎩 Le colonne di tipo lista sono estremamente utili quando si lavora con i dati. Il pattern usato qui è molto utile in molte situazioni.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
Il terzo passo è calcolare le probabilità a posteriori. Ricorda che
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Possiamo riscriverlo in termini di log-verosimiglianze
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Possiamo usare la funzione rollapplyr del pacchetto zoo per calcolare una somma mobile a 7 giorni delle log-verosimiglianze, ed esponenziarla per ottenere il posteriore. Infine, normalizziamo i posteriori a 1,0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
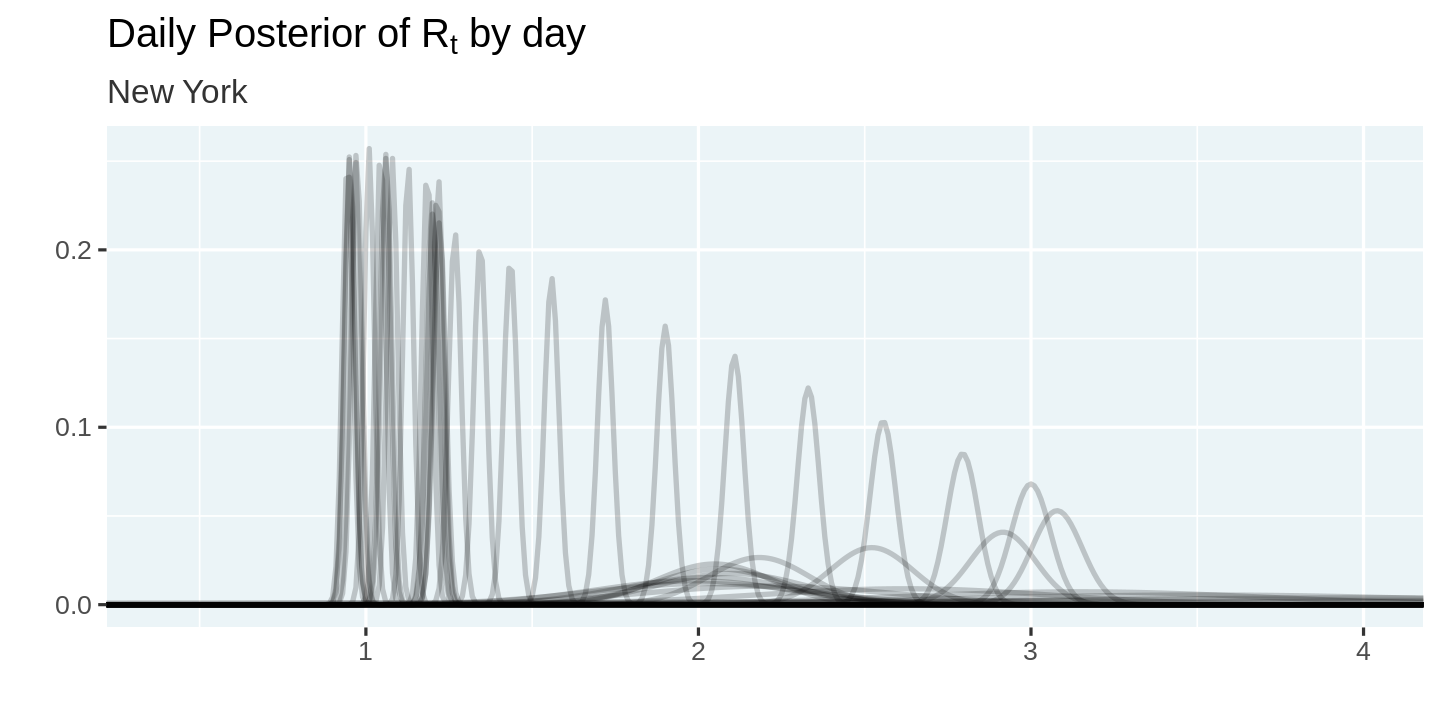
Visualizziamo le probabilità a posteriori calcolate. Nota come impostiamo alpha = 0.2 per ridurre il sovrapporsi delle linee. Questo ci permette di vedere lo spostamento dei posteriori.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
L’ultimo passo è stimare i valori di $R_t$ e gli intervalli di massima densità attorno a essi. Ricorda che dobbiamo simulare valori casuali per $r_t$ usando le probabilità a posteriori per applicare la funzione HDIInterval::hdi e calcolare gli intervalli di massima densità.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Finalmente, il momento della verità! Visualizziamo i valori stimati di $R_t$
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
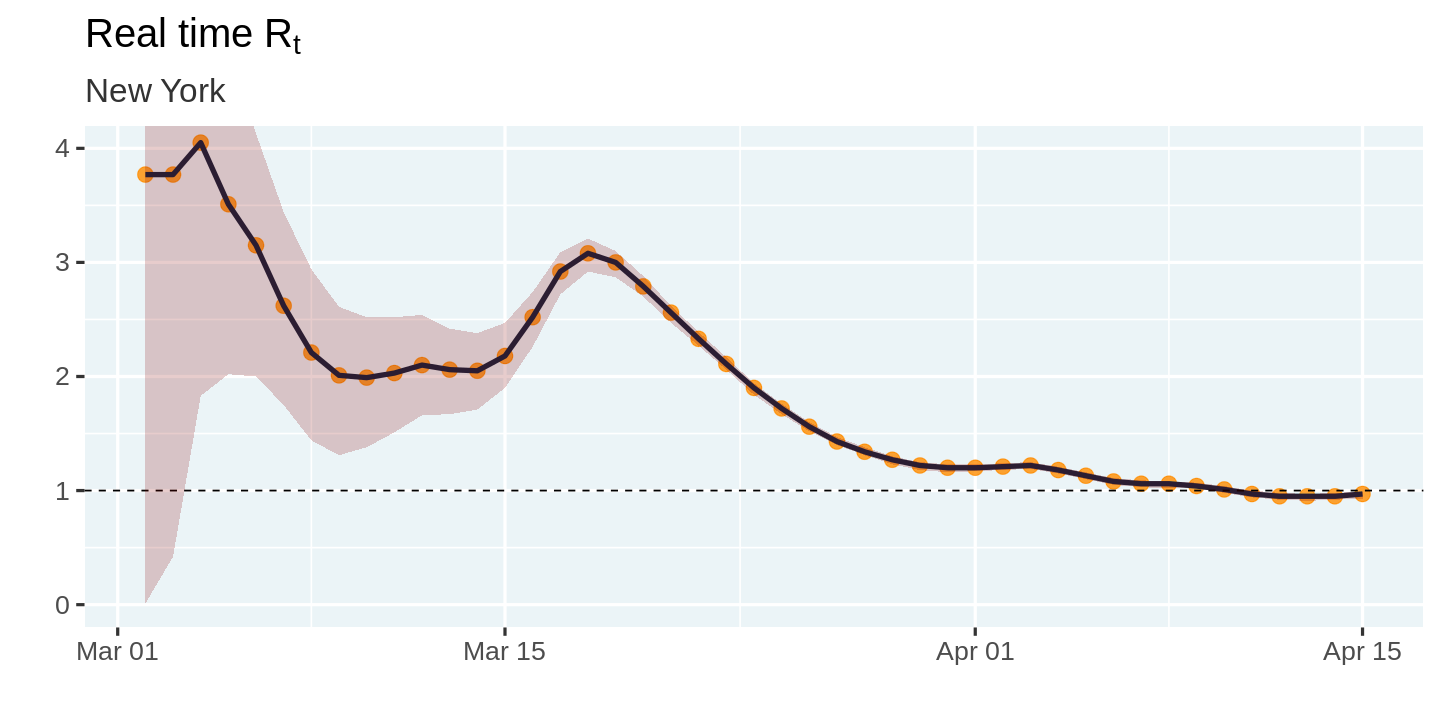
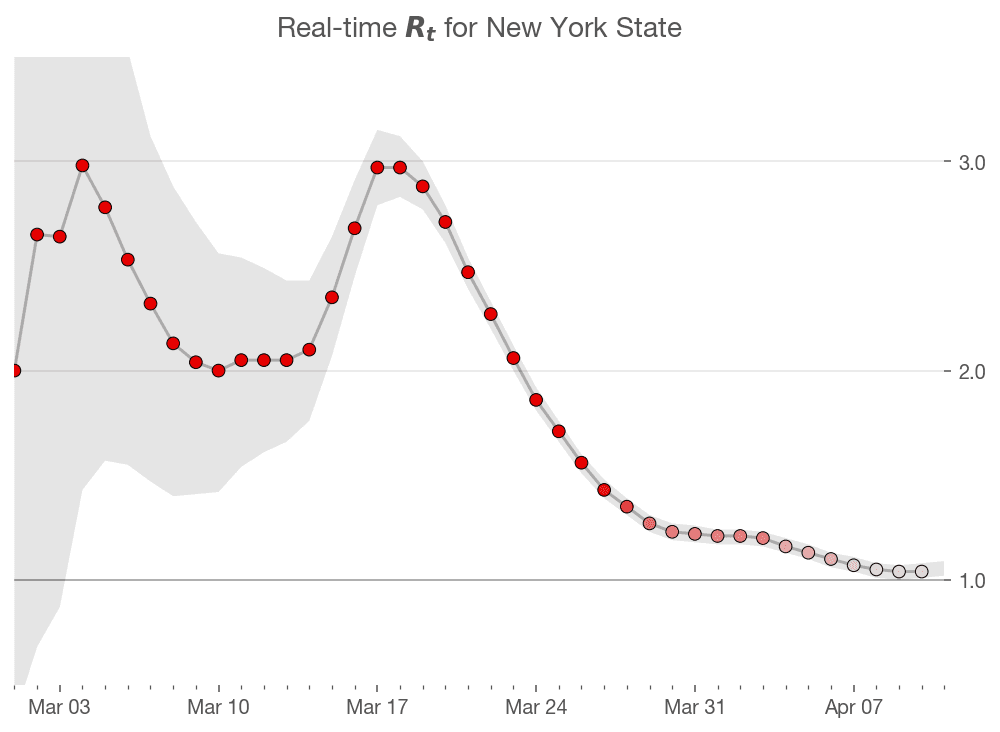
Come si confronta questo con le stime dell’articolo di Kevin? Sembra che le stime iniziali del mio modello differiscano da quelle di Kevin. Tuttavia, potrebbe dipendere dalle differenze nell’algoritmo di smoothing o dalla grande incertezza che circonda le stime iniziali. La forma complessiva della curva e i picchi sembrano però allinearsi piuttosto bene. Missione compiuta! 🎉
È ora di iterare su tutti gli stati e calcolare queste stime. Possiamo farlo facilmente raggruppando per state, suddividendo i dati in una tabella per stato e usando purrr::map_df per stimare $R_t$ per ciascuno stato e ricombinarli in un’unica tabella.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
Ora possiamo creare un “small multiples” delle stime per tutti gli stati. L’uso di ggplot2 lo rende davvero facile e ci è bastata una sola riga in più!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
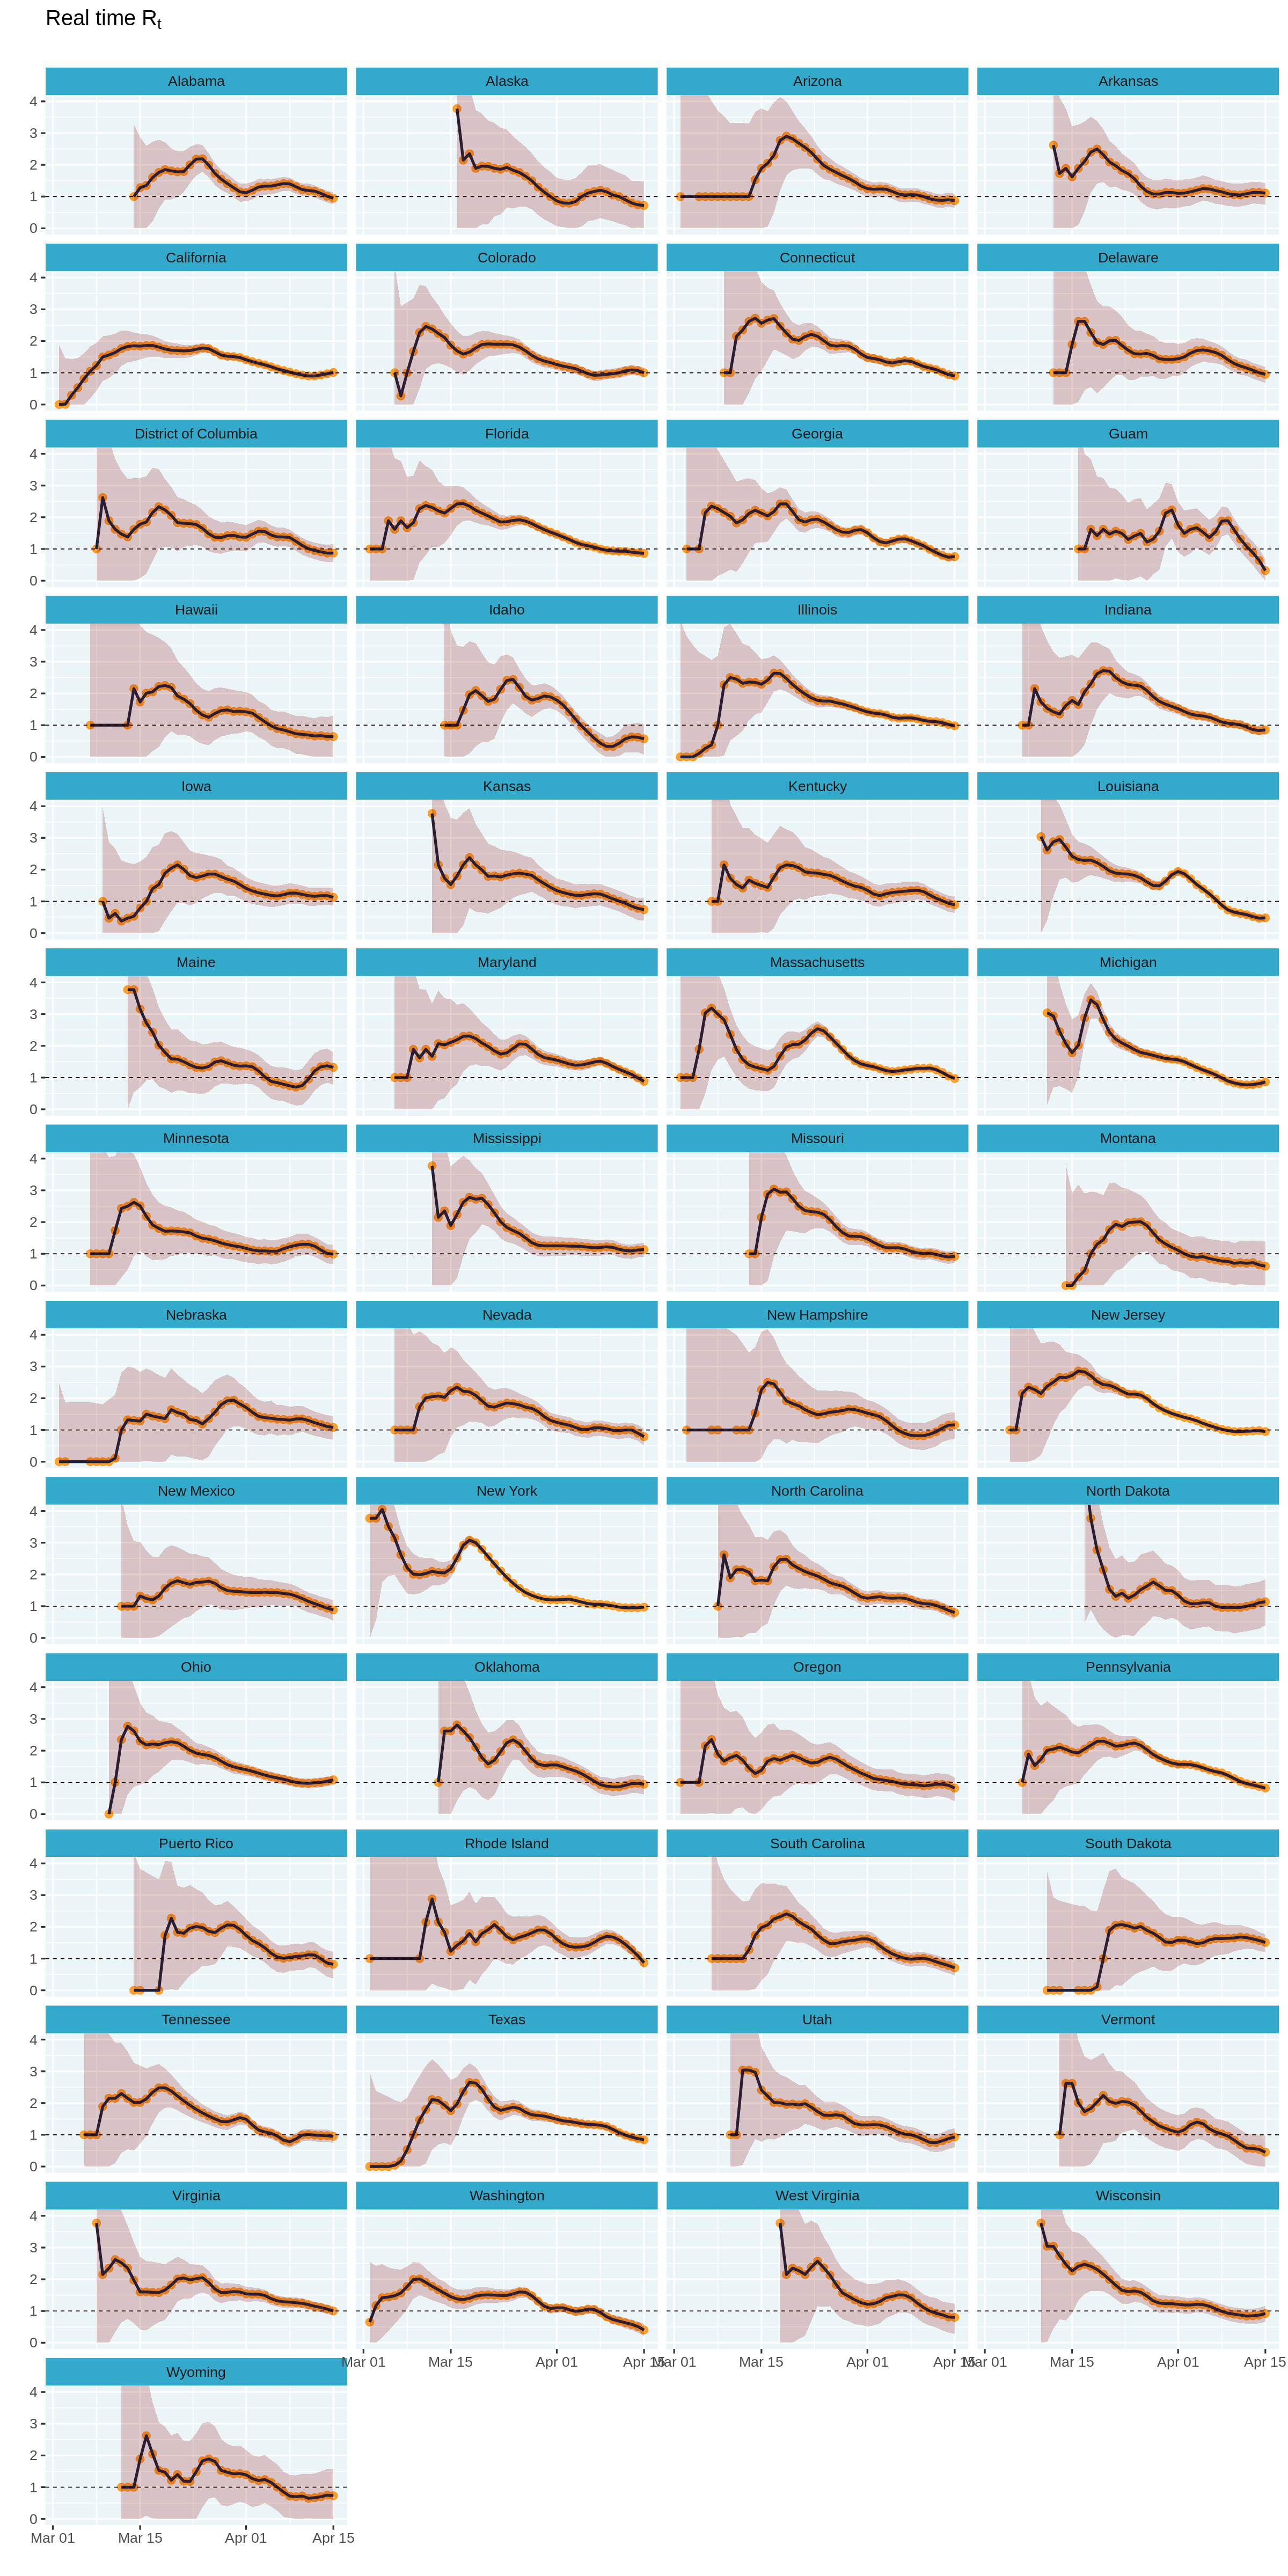
Sebbene il grafico a piccoli multipli sia perfetto, è difficile individuare uno stato in base alla sua posizione geografica. E se potessimo disporre ogni stato vicino alla sua posizione geografica?
Per fortuna, Ryan Hafen ha creato il pacchetto geofacet che ci permette di disporre questi piccoli multipli su una griglia geografica con una singola riga di codice.
⚠️ Purtroppo non sono riuscito a installare il pacchetto geofacet su colab (sospetto per dipendenze di sistema richieste da sf), quindi il blocco di codice sotto fallirà. Ho incluso una versione salvata del grafico generato in locale, così puoi farti un’idea di come appare.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

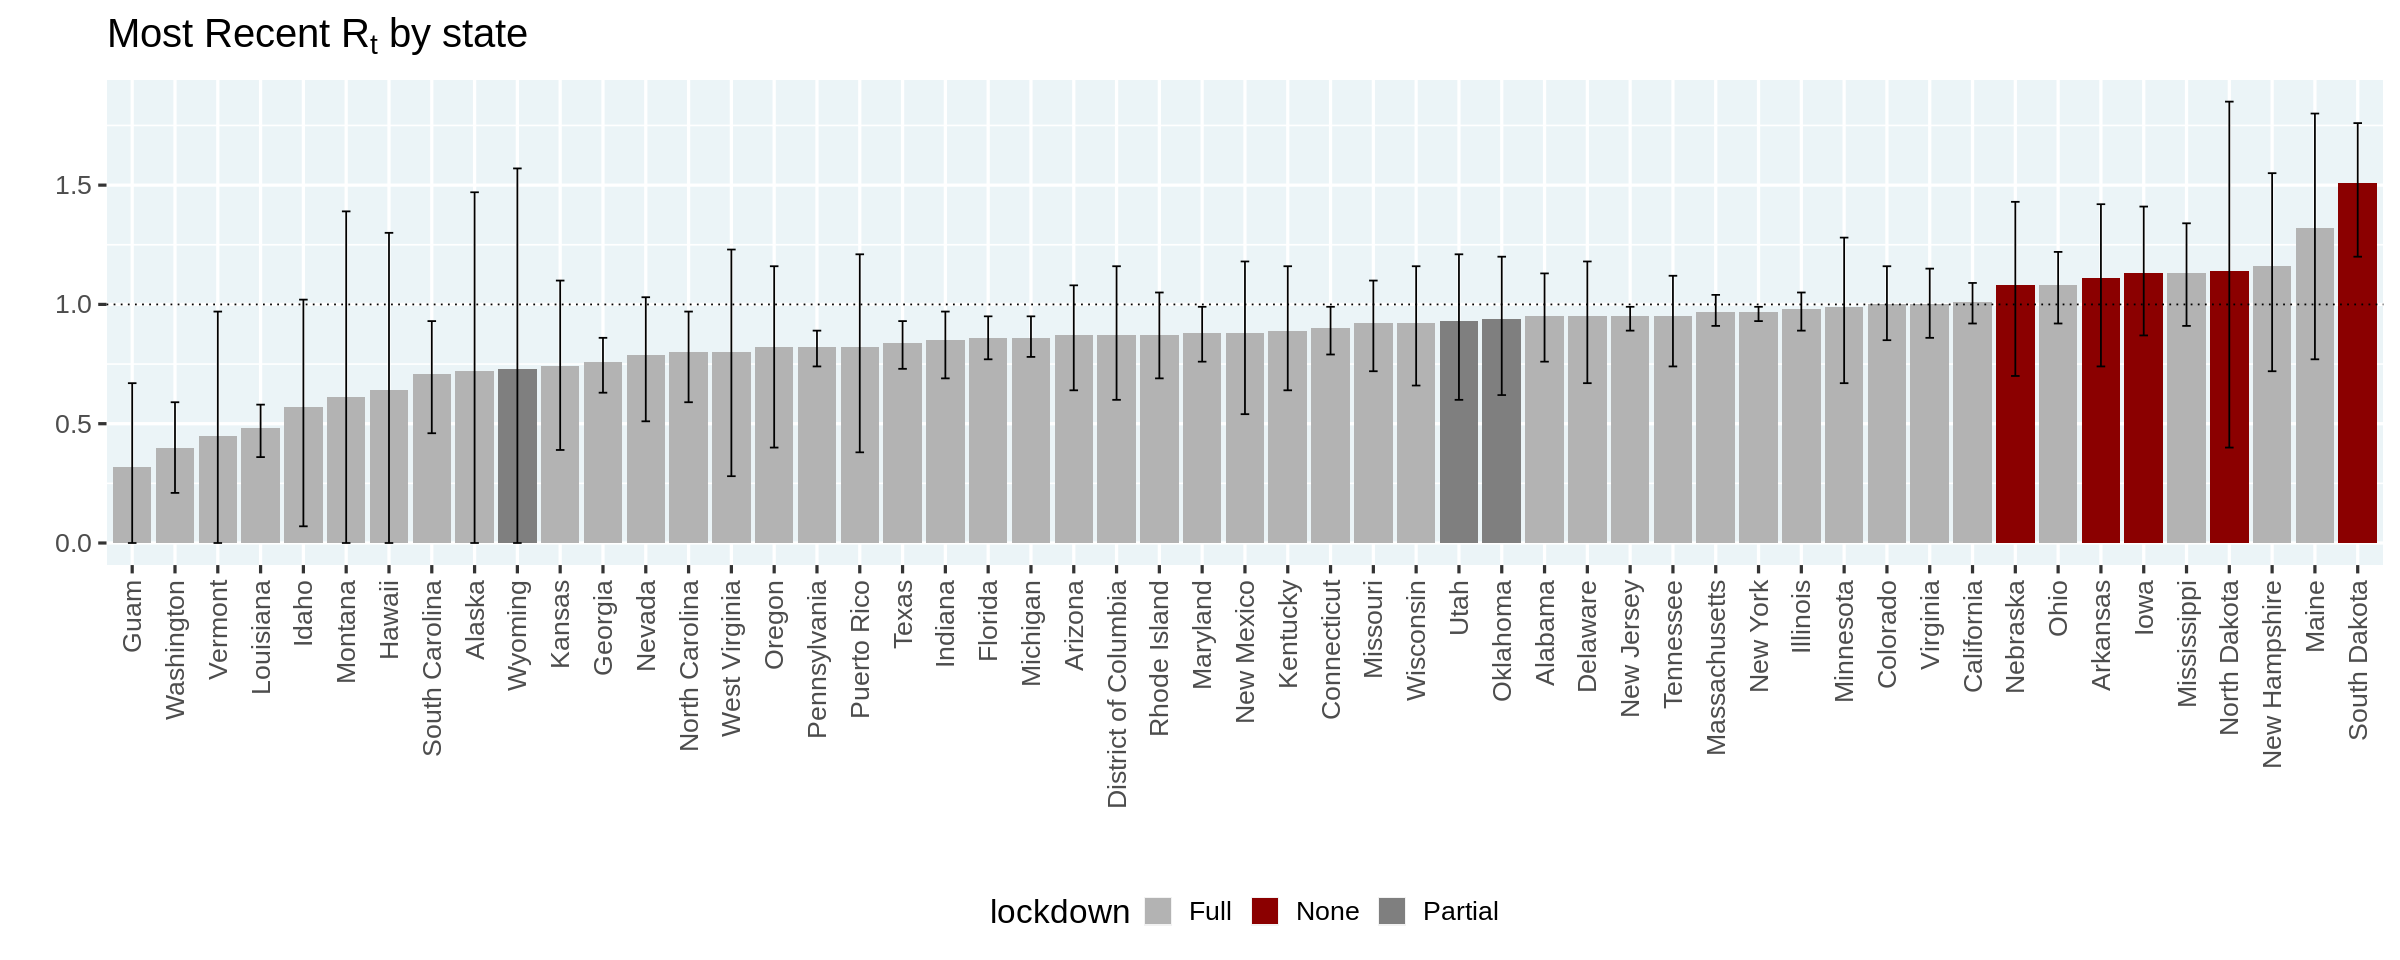
Infine, ricreiamo il grafico dell’articolo di Kevin che ordina gli stati in base al valore stimato più probabile di $R_t$ e li colora in base allo stato del lockdown.
⚠️ Tieni presente che questo è un grafico puramente descrittivo e non si possono trarre conclusioni sull’efficacia dei lockdown
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
In questo articolo abbiamo replicato l’analisi di Kevin in R usando il tidyverse. Abbiamo imparato alcuni trucchi utili per calcolare verosimiglianze e posteriori. Io ho imparato un sacco in questo processo!
Mi vengono in mente diversi passi successivi, ma ne evidenzierò uno principale. Dato che le funzioni sviluppate in questo articolo si basano su una tabella di input piuttosto semplice con tre colonne: location, date, cases, un passo interessante sarebbe trasformare il tutto in un pacchetto R. Questo renderebbe più facile stimare $R_t$ per altre aree geografiche.
Vorrei concludere ringraziando Kevin Systrom per aver pubblicato un post interessante e condiviso il suo codice. Ringrazio anche i miei colleghi di DataCamp per l’ottimo feedback su una versione iniziale di questo articolo.
Se hai feedback/commenti su questo articolo o vuoi suggerire altre estensioni, puoi trovarmi su Twitter @ramnath_vaidya e su github. Per saperne di più sulla programmazione in R
Scopri di più su R
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



