Kurs
Einführung in R
4 Std.
3.1M
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleFolg Ramnath Vaidyanathan auf Twitter. Diese Analyse wurde ursprünglich auf Google Colab veröffentlicht.
Kevin Systrom hat einen sehr lesenswerten Artikel zur Schätzung von $R_t$ publiziert, also der sogenannten effektiven Reproduktionszahl. Kevin beschreibt diese Zahl so:
Die Anzahl der Personen, die sich zu Zeitpunkt 𝑡 pro infektiöser Person neu anstecken.
Kevin war so freundlich, seinen Code als Notebook auf GitHub zu veröffentlichen. Ich wollte mehr mit seinem Modell machen und es auch auf andere Länder anwenden. Da ich jedoch in R deutlich versierter bin, wollte ich seine Ergebnisse zunächst in R nachbauen.
Bevor du weiterliest, empfehle ich dir dringend, den Originalartikel zu lesen, um ein besseres Verständnis des Modellierungsansatzes zu bekommen. Dieser Beitrag konzentriert sich stärker auf den Code.
Alle Anerkennung für Ansatz und Code gebührt Kevin 👍. Dieses Notebook ist mein bescheidener Versuch, sein Modell in R zu übertragen. Verbleibende Fehler gehen allein auf meine Kappe.
Wir verwenden denselben Ansatz, den Kevin in seinem Artikel skizziert, basierend auf dem Paper von Bettencourt & Ribeiro.
Als Erstes modellieren wir den „Eintreff“-Prozess von Infektionen. Unter Statistiker:innen ist hierfür die Poisson-Verteilung eine beliebte Wahl. Lassen wir $\lambda$ die durchschnittliche Anzahl täglicher Neuinfektionen sein, dann ist die Wahrscheinlichkeit, an einem Tag $k$ neue Fälle zu sehen,
$$P(k|\lambda) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Mit dieser Annahme können wir die Wahrscheinlichkeitsverteilung neuer Fälle für eine Menge von $\lambda$-Werten aufspannen. Bevor wir mit dem Code starten, laden wir das Paketbündel tidyverse und passen einige Plot-Optionen an (Größen, Darstellung etc.). Du kannst diesen Abschnitt gern überspringen, führ den Code aber auf jeden Fall aus.
# Load packages
library(tidyverse)

# Plot options

## Jupyter notebooks use the repr package to create viewable representations
## of R objects (https://github.com/IRkernel/repr). I am updating the default
## plot dimensions to 12 x 6.
options(repr.plot.width = 12, repr.plot.height = 6)

## We will use ggplot2 for all plots. I am defining a custom theme here
## that mainly updates the backgrounds and legend position. We set this
## custom theme as the default, and also update the default for line size.
theme_custom <- function(base_size, ...){
  ggplot2::theme_gray(base_size = base_size, ...) +
  ggplot2::theme(
    plot.title = element_text(face = 'bold'),
    plot.subtitle = element_text(color = '#333333'),
    panel.background = element_rect(fill = "#EBF4F7"),
    strip.background = element_rect(fill = "#33AACC"),
    legend.position = "bottom"
  )
}
ggplot2::theme_set(theme_custom(base_size = 20))
ggplot2::update_geom_defaults("line", list(size = 1.5))

# Utility functions

## We will use a utility function to display the head of dataframes.
## Note that we need this hack mainly to add the class 'dataframe' to
## the tables that are printed. This should ideally be handled
## by the `repr` package, and I will be sending a PR.
display_df <- function(x){
  d <- as.character(
    knitr::kable(x, format = 'html', table.attr = "class='dataframe'")
  )
  IRdisplay::display_html(d)
}

display_head <- function(x, n = 6){
   display_df(head(x, n))
}

display_random <- function(x, n = 6){
   display_df(dplyr::sample_n(x, n))
}
── [1mAttaching packages[22m ─────────────────────────────────────── tidyverse 1.3.0 ──
[32m✔[39m [34mggplot2[39m 3.3.0 [32m✔[39m [34mpurrr [39m 0.3.3
[32m✔[39m [34mtibble [39m 3.0.0 [32m✔[39m [34mdplyr [39m 0.8.5
[32m✔[39m [34mtidyr [39m 1.0.2 [32m✔[39m [34mstringr[39m 1.4.0
[32m✔[39m [34mreadr [39m 1.3.1 [32m✔[39m [34mforcats[39m 0.5.0
── [1mConflicts[22m ────────────────────────────────────────── tidyverse_conflicts() ──
[31m✖[39m [34mdplyr[39m::[32mfilter()[39m masks [34mstats[39m::filter()
[31m✖[39m [34mdplyr[39m::[32mlag()[39m masks [34mstats[39m::lag()
Mit der Funktion crossing aus purrr können wir Dichten für Kombinationen aus $k$ und $\lambda$ berechnen. Das ist elegant, aber nicht optimal performant, weil wir die Vektorisierung von dpois nicht ausnutzen. Eine effizientere Variante folgt später.
# Number of new cases observed in a day
k = 0:69

# Arrival rate of new infections per day
lambda = c(10, 20, 30, 40)

poisson_densities = crossing(lambda = lambda, k = k) %>%
  mutate(p = dpois(k, lambda))

display_head(poisson_densities)
| lambda | k | p |
|---|---|---|
| 10 | 0 | 0.0000454 |
| 10 | 1 | 0.0004540 |
| 10 | 2 | 0.0022700 |
| 10 | 3 | 0.0075667 |
| 10 | 4 | 0.0189166 |
| 10 | 5 | 0.0378333 |
Visualisieren können wir das mit ggplot2. Beachte, wie wir expression nutzen, um Mathe-Symbole in Plots darzustellen. Mehr dazu in der Doku zu plotmath.
poisson_densities %>%
  # We convert lambda to a factor so that each line gets a discrete color
  mutate(lambda = factor(lambda)) %>%
  ggplot(aes(x = k, y = p, color = lambda)) +
  geom_line() +
  labs(
    title = expression(paste("Probability of k new cases P(k|", lambda, ")")),
    x = 'Number of new cases',
    y = NULL,
    color = expression(lambda)
  )
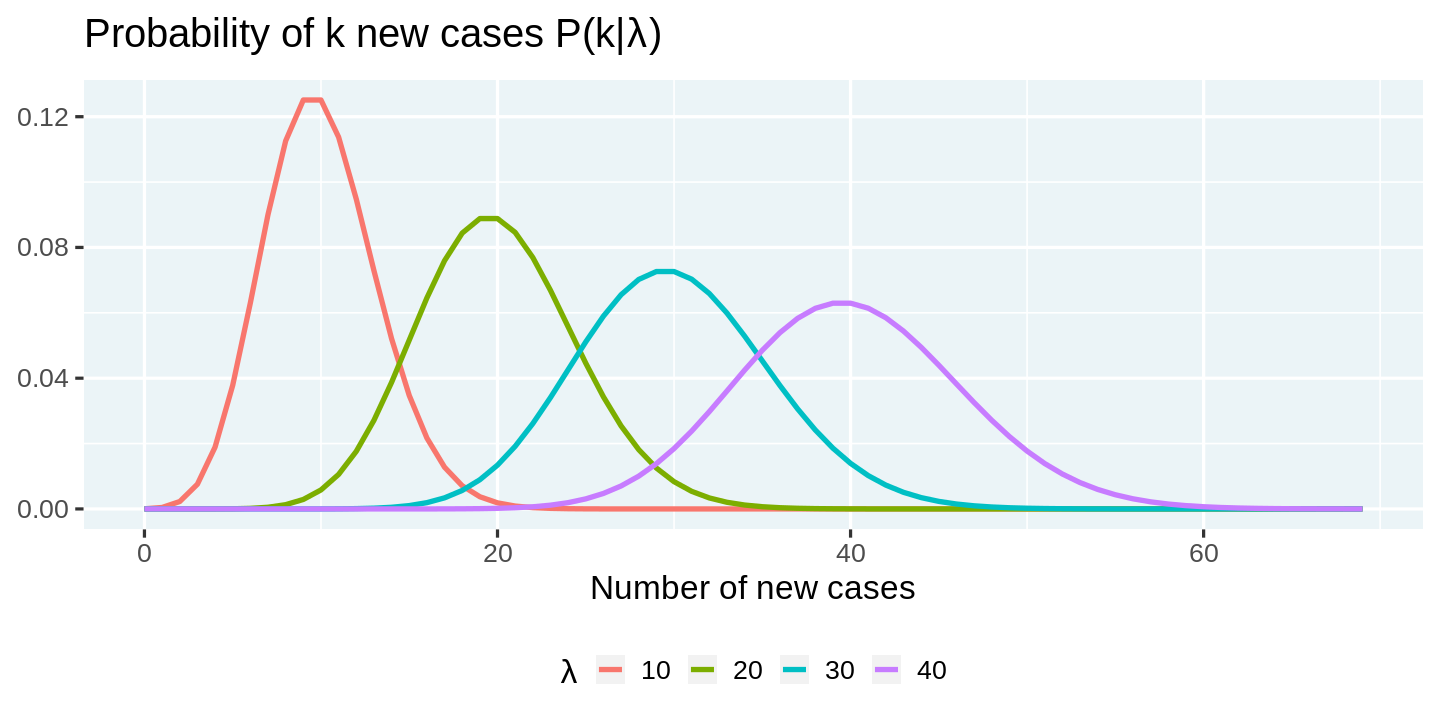
Wenn wir den Eintreffprozess als Poisson-Verteilung modellieren, können wir die Verteilung neuer Fälle pro Tag als Funktion von $\lambda$ vorhersagen. In der Realität beobachten wir aber nur die Anzahl der Fälle. Die Schlüsselfrage ist also: Wie leiten wir aus der beobachteten Anzahl Rückschlüsse auf die Verteilung von $\lambda$ ab? Zum Glück ist das einfach.
$$L(\lambda| k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Die Verteilung von $\lambda$ über k heißt Likelihood-Funktion und hat dieselbe Form wie die zuvor genutzte Wahrscheinlichkeitsfunktion. Wir können sie visualisieren, indem wir k fixieren und die Likelihood über einen Bereich von $\lambda$-Werten berechnen.
# Number of new cases observed in a day
k = 20

# Arrival rates of new infections per day
lambdas = seq(1, 45, length = 90)

# Compute likelihood and visualize them
tibble(lambda = lambdas, p = dpois(k, lambdas)) %>%
  ggplot(aes(x = lambda, y = p)) +
  geom_line(color = 'black') +
  labs(
    title = expression(paste("Poisson Likelihood L(", lambda, " | k"[t], ")")),
    x = expression(lambda),
    y = NULL
  )
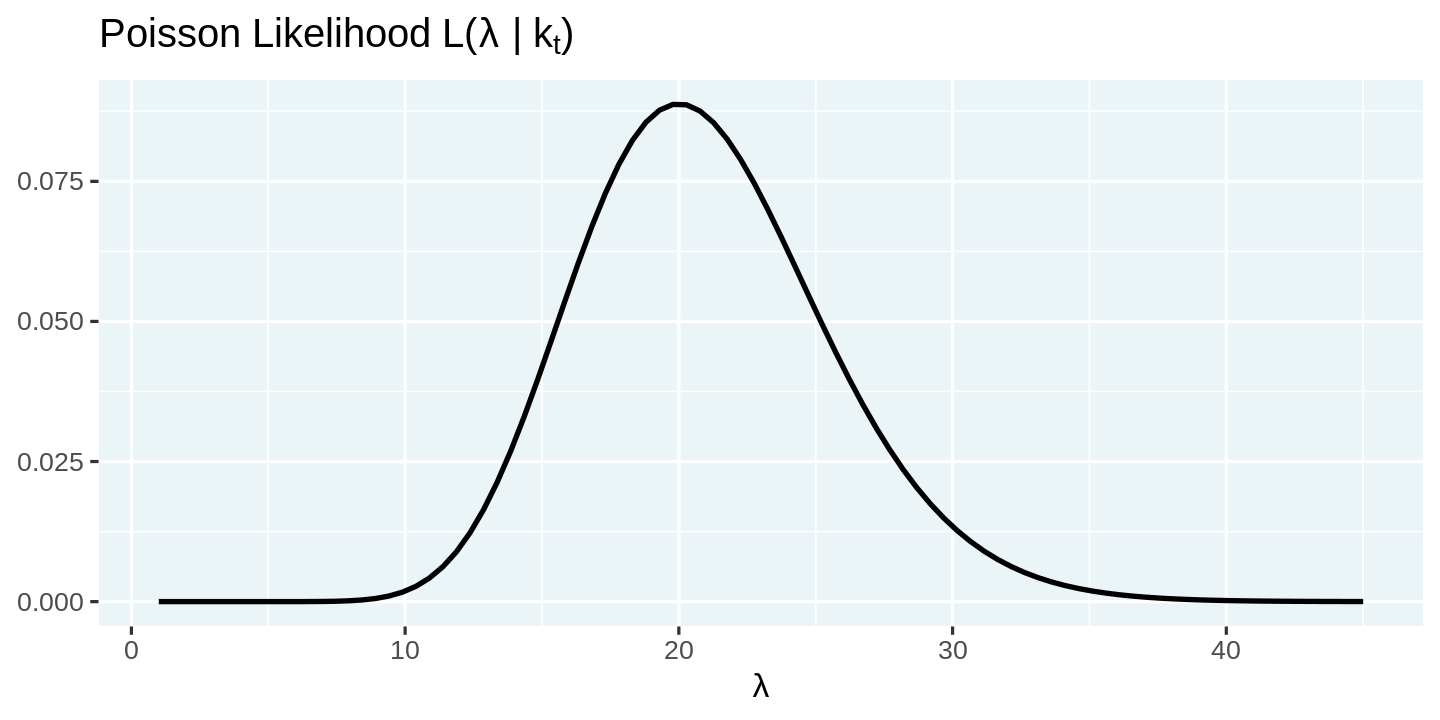
Soweit so gut — aber wo ist nun die effektive Reproduktionszahl $R_t$, von der eingangs die Rede war? Wie hängt sie mit $\lambda$ zusammen? Laut Bettencourt & Ribeiro ist die Beziehung recht einfach:
$$ \lambda = k_{t-1}e^{\gamma(R_t-1)}$$
Dabei ist $\gamma$ der Kehrwert des seriellen Intervalls (bei COVID‑19 etwa 4 Tage), und $k_{t-1}$ ist die Anzahl neuer Fälle im Intervall $t-1$.
Mit diesem Ausdruck für $\lambda$ können wir die Likelihood in Abhängigkeit von $R_t$ formulieren.
$$\mathcal{L}\left(R_t|k\right) = \frac{\lambda^k e^{-\lambda}}{k!}$$
Bevor es weitergeht, definieren wir ein paar Kernparameter.
# r_t_range is a vector of possible values for R_t
R_T_MAX = 12
r_t_range = seq(0, R_T_MAX, length = R_T_MAX*100 + 1)

# Gamma is 1/serial interval
# https://wwwnc.cdc.gov/eid/article/26/6/20-0357_article
GAMMA = 1/4

# New cases by day
k =  c(20, 40, 55, 90)
Der folgende Code zeigt eine performantere Berechnung der Likelihoods. Statt für jede Kombination separat Lambdas und Likelihoods zu erzeugen, nutzen wir die Vektorisierung in R und verschachtelte Dataframes. So erzeugen wir je Tag einen Vektor von Lambdas und Likelihoods und packen ihn mit tidyr::unnest wieder aus.
Neben der Effizienz ist der Code auch gut lesbar und überträgt die Formeln mit wenig Overhead.
likelihoods <- tibble(day = seq_along(k) - 1, k = k) %>%
  # Compute a vector of likelihoods
  mutate(
    r_t = list(r_t_range),
    lambda = map(lag(k, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
    likelihood_r_t = map2(k, lambda, ~ dpois(.x, .y)/sum(dpois(.x, .y)))
  ) %>%
  # Ignore the 0th day
  filter(day > 0) %>%
  # Unnest the data to flatten it.
  select(-lambda) %>%
  unnest(c(r_t, likelihood_r_t))

display_random(likelihoods)
| day | k | r_t | likelihood_r_t |
|---|---|---|---|
| 1 | 40 | 7.26 | 0.0000000 |
| 1 | 40 | 2.54 | 0.0011292 |
| 2 | 55 | 3.54 | 0.0003426 |
| 2 | 55 | 5.62 | 0.0000000 |
| 1 | 40 | 7.03 | 0.0000000 |
| 3 | 90 | 10.84 | 0.0000000 |
Jetzt können wir die Likelihood bedingt auf die beobachteten Neuinfektionen plotten.
likelihoods %>%
  ggplot(aes(x = r_t, y = likelihood_r_t, color = factor(k))) +
  geom_line() +
  labs(
    title = expression(paste("Likelihood of R"[t], " given k")),
    subtitle = expression(paste("L(R"[t], "|k)")),
    x = expression("R"[t]),
    y = NULL, color = 'k'
  )
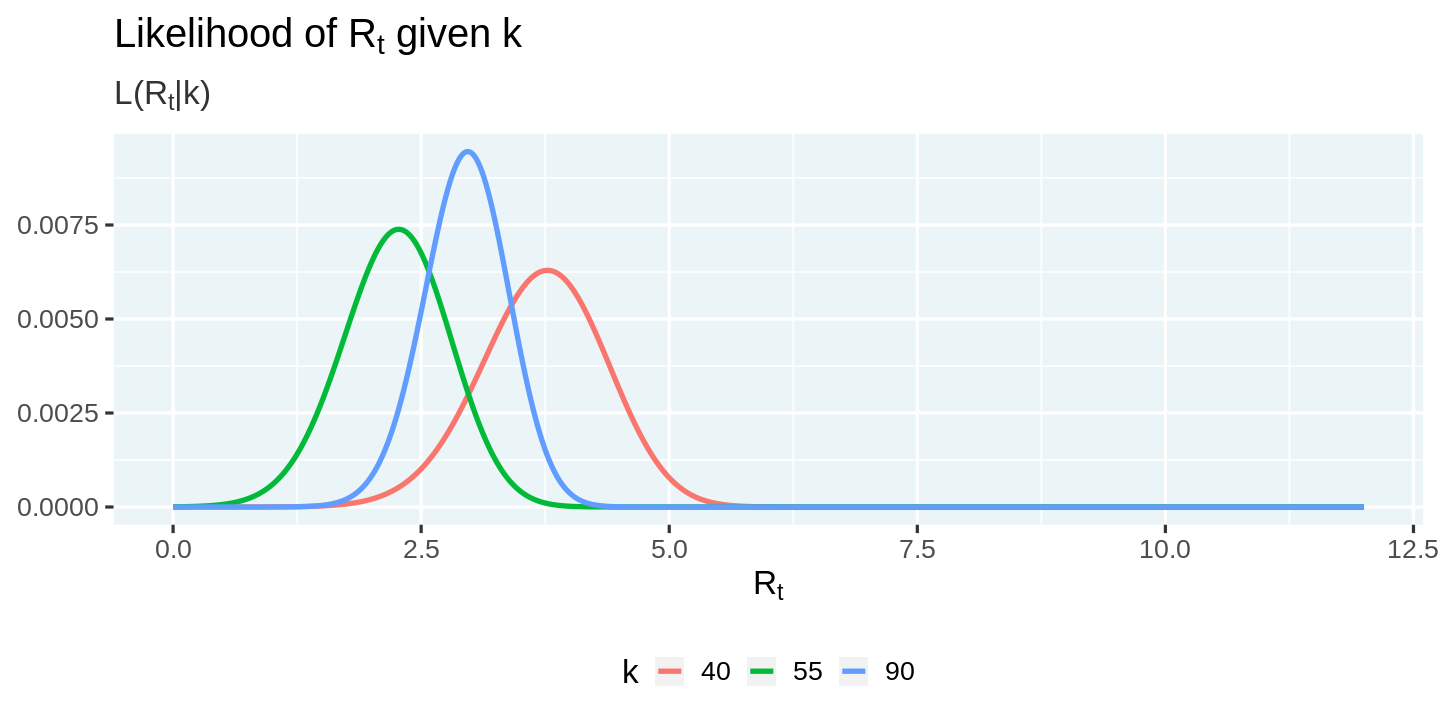
Wir haben $k$ und $R_t$ verknüpft, aber noch keinen konkreten Weg, $R_t$ aus der Zeitreihe der Neuinfektionen zu schätzen. Hier hilft die allgegenwärtige Bayes-Regel. Bettencourt & Ribeiro schreiben die Verteilung von $R_t$ als
$$ P(R_t|k_t)=\frac{P(R_t)\cdot\mathcal{L}(k_t|R_t)}{P(k_t)} $$
Kevin erklärt das in einfachen Worten:
Nachdem wir 𝑘 neue Fälle gesehen haben, ist die Verteilung von 𝑅𝑡 gleich:
- Der Prior $P(R_t)$ ohne die Daten ...
- multipliziert mit der Likelihood, 𝑘 neue Fälle gegeben $R_t$ zu sehen ...
- geteilt durch die allgemeine Wahrscheinlichkeit, so viele Fälle zu sehen.
Wenn wir die Posterior-Verteilung der Vorperiode, $P(R_{t-1} | k_{t-1})$, als Prior $P(R_t)$ für die aktuelle Periode verwenden, wird daraus:
$$ P(R_t|k_t) \propto P(R_{t-1}|k_{t-1})\cdot\mathcal{L}(k_t|R_t) $$
Über alle Perioden bis $t = 0$ iteriert ergibt sich
$$ P(R_t|k_t) \propto P(R_0) \cdot {\displaystyle \prod^{T}_{t=0}}\mathcal{L}(k_t|R_t) $$
Mit einem uniformen Prior $P(R_0)$ reduziert sich das zu:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=0}}\mathcal{L}\left(k_t|R_t\right) $$
Diese Formel nutzen wir nun, um aus den Likelihoods die Posterior-Verteilungen zu berechnen. Wieder hilft uns die vektorisierte Funktion cumprod, anschließend normalisieren wir.
posteriors <- likelihoods %>%
  group_by(r_t) %>%
  arrange(day) %>%
  mutate(posterior = cumprod(likelihood_r_t)) %>%
  group_by(k) %>%
  mutate(posterior = posterior / sum(posterior)) %>%
  ungroup()

display_random(posteriors)
| day | k | r_t | likelihood_r_t | posterior |
|---|---|---|---|---|
| 3 | 90 | 5.85 | 0.0000000 | 0.0000000 |
| 3 | 90 | 2.35 | 0.0033847 | 0.0025235 |
| 3 | 90 | 7.68 | 0.0000000 | 0.0000000 |
| 2 | 55 | 0.01 | 0.0000047 | 0.0000000 |
| 1 | 40 | 0.79 | 0.0000009 | 0.0000009 |
| 3 | 90 | 10.81 | 0.0000000 | 0.0000000 |
Nun visualisieren wir die Posterior-Verteilungen.
posteriors %>%
  ggplot(aes(x = r_t, y = posterior, color = factor(day))) +
  geom_line() +
  labs(
    title = expression(paste("Posterior probability of R"[t], " given k")),
    subtitle = expression(paste("P(R"[t], "| k)")),
    x = expression("R"[t]), y = NULL, color = 'day'
  )
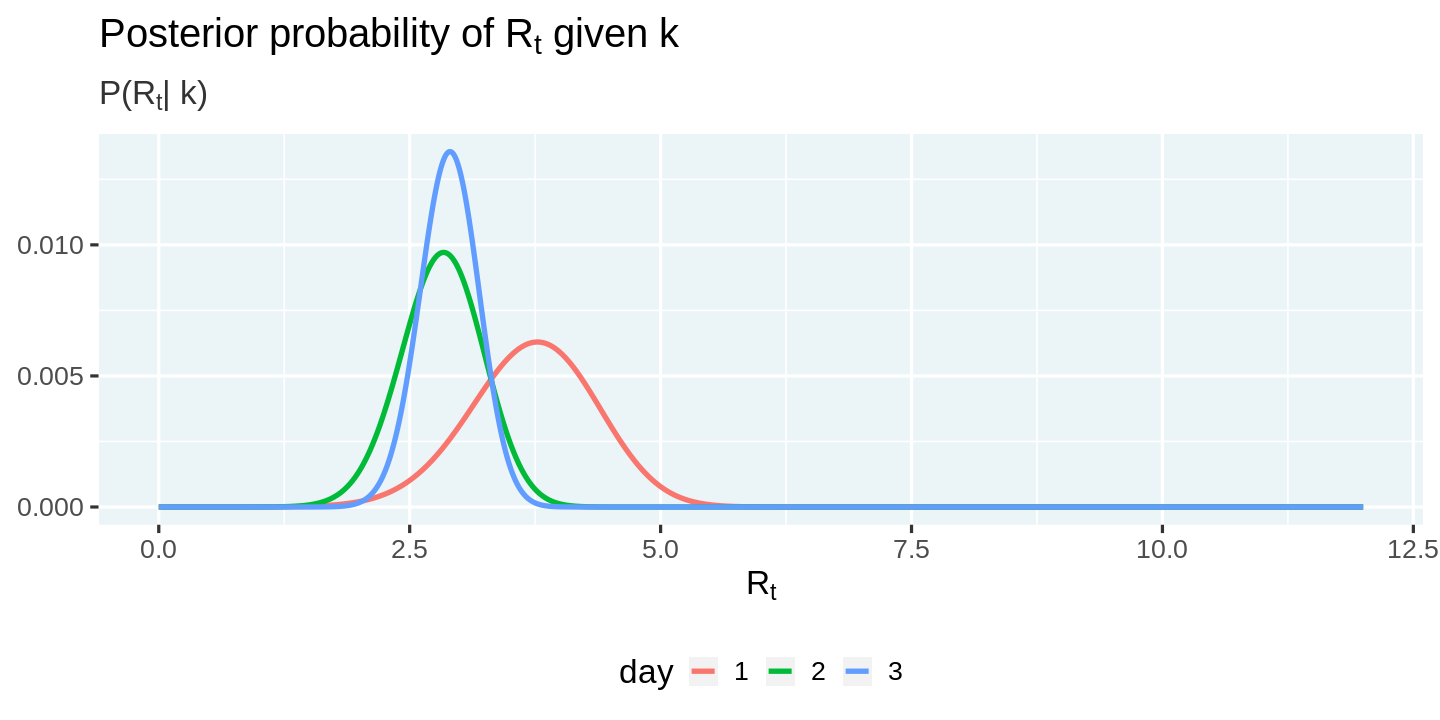
Diese Posterioren erlauben uns jetzt die zentrale Frage zu beantworten:
Welcher Wert von $R_t$ ist an jedem Tag am wahrscheinlichsten?
Bei jeder Schätzung ist es wichtig, die Unsicherheit anzugeben. Eine verbreitete Methode sind Highest-Density-Intervalle (HDI).
Eine weitere Möglichkeit, eine Verteilung zusammenzufassen, ist das Highest-Density-Intervall: ein Intervall, das z. B. 95% der Verteilung abdeckt, sodass jeder Punkt im Intervall wahrscheinlicher ist als alle Punkte außerhalb.
Kevin implementiert im Artikel einen Brute-Force-Algorithmus für HDI. In R gibt es dafür schon das Paket HDInterval 🎉.
Wir schätzen nun den wahrscheinlichsten Wert von $R_t$ und das zugehörige HDI. Da HDInterval::hdi mit Zufallsstichproben aus der Verteilung arbeitet und wir Posterior-Wahrscheinlichkeiten haben, simulieren wir $R_t$-Werte gemäß den Posterioren.
# Install and load HDInterval package
install.packages("HDInterval")
library(HDInterval)

# Compute the most likely value of r_t and the highest-density interval
estimates <- posteriors %>%
  group_by(day) %>%
  summarize(
    r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
    r_t_most_likely = r_t_range[which.max(posterior)]
  ) %>%
  mutate(
    r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
    r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
  ) %>%
  select(-r_t_simulated)

display_head(estimates)
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| day | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|
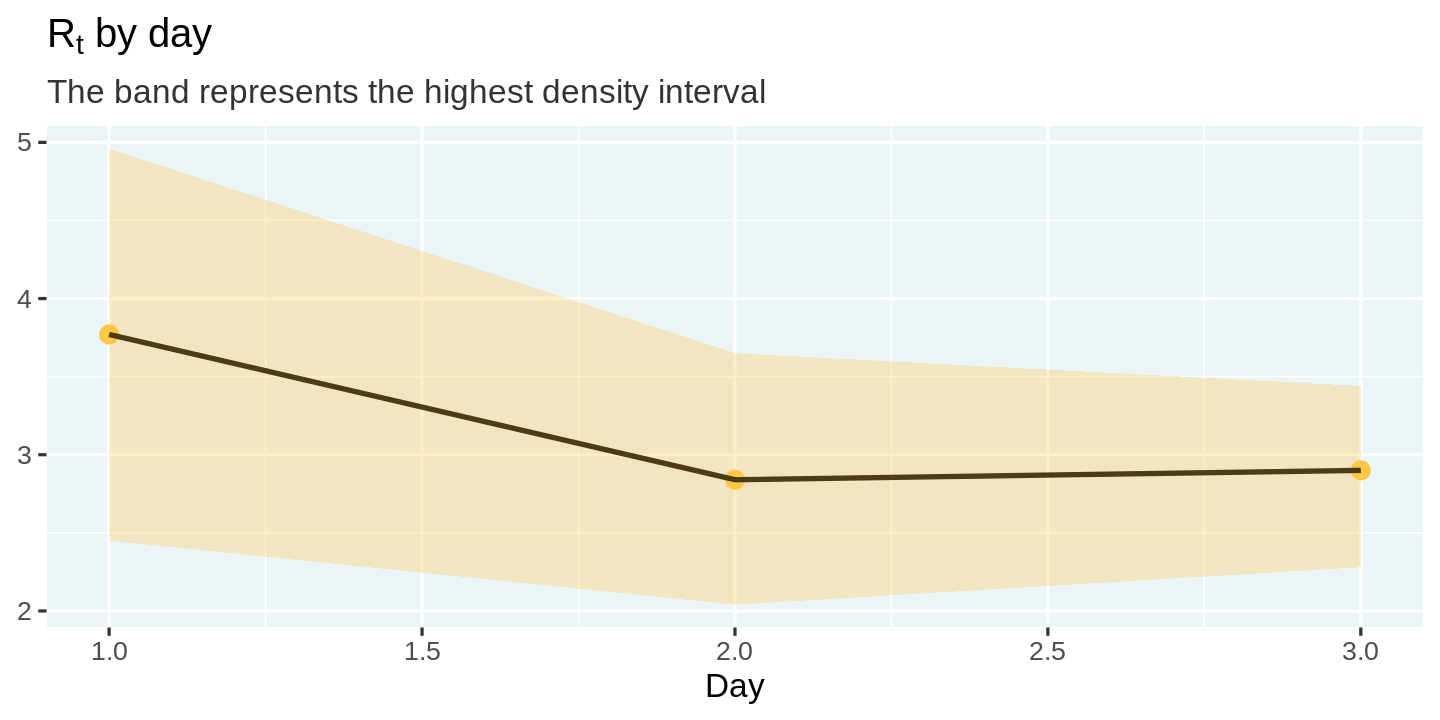
| 1 | 3.77 | 2.45 | 4.96 |
| 2 | 2.84 | 2.04 | 3.65 |
| 3 | 2.90 | 2.28 | 3.44 |
Diese Schätzungen und ihre Unsicherheit lassen sich gut mit einer Linie und einem Band darstellen.
estimates %>%
  ggplot(aes(x = day, y = r_t_most_likely)) +
  geom_point(color = "#ffc844", size = 5) +
  geom_line(color = 'black') +
  geom_ribbon(aes(ymin = r_t_lo, ymax = r_t_hi), fill = "#ffc844", alpha = 0.3) +
  labs(
    title = expression(paste('R'[t], ' by day')),
    subtitle = "The band represents the highest density interval",
    x = 'Day', y = NULL
  )
Der Ansatz von Bettencourt und Ribeiro funktioniert gut, hat aber ein praktisches Problem (auch im Paper erwähnt): Es kann passieren, dass sich der Posterior festfährt und asymptotisch gegen 1 geht, weil frühere Phasen mit hohem $R_t$ nicht „vergessen“ werden.
Kevin schlägt daher vor:
Wir berücksichtigen nur die letzten $m$ Tage in der Likelihood. So basiert der Prior auf der jüngsten Vergangenheit — weitaus nützlicher als die gesamte Historie. Das führt zu: $$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
Mit dieser Modifikation schätzen wir $R_t$ für US-Bundesstaaten.
Jetzt setzen wir alles auf COVID-Daten aus US-Bundesstaaten an, um $R_t$ zu schätzen. Zuerst laden wir die Daten. Wir nutzen den vom New York Times-Team kuratierten Datensatz.
url = 'https://raw.githubusercontent.com/nytimes/covid-19-data/master/us-states.csv'
covid_cases <- readr::read_csv(url)

display_head(covid_cases)
Parsed with column specification:
cols(
date = [34mcol_date(format = "")[39m,
state = [31mcol_character()[39m,
fips = [31mcol_character()[39m,
cases = [32mcol_double()[39m,
deaths = [32mcol_double()[39m
)
| date | state | fips | cases | deaths |
|---|---|---|---|---|
| 2020-01-21 | Washington | 53 | 1 | 0 |
| 2020-01-22 | Washington | 53 | 1 | 0 |
| 2020-01-23 | Washington | 53 | 1 | 0 |
| 2020-01-24 | Illinois | 17 | 1 | 0 |
| 2020-01-24 | Washington | 53 | 1 | 0 |
| 2020-01-25 | California | 06 | 1 | 0 |
Als Nächstes bereiten wir die Daten auf: tägliche Neuinfektionen berechnen und über ein rollierendes Fenster glätten. Das ist wichtig, um Meldeverzögerungen abzufedern — vor allem an Wochenenden treten sie häufig auf.
Nach Kevins Ansatz nutze ich einen gaußschen Glätter mit einem 7‑Tage-Fenster.
Wir implementieren alle Verarbeitungsschritte als eigenständige Funktionen. Das macht die Schritte gut kombinierbar und erleichtert die Anwendung auf mehrere Bundesstaaten.
Wir demonstrieren das an einem Bundesstaat, damit die Ergebnisse leichter nachvollziehbar sind. Ich habe New York gewählt — du kannst gern einen anderen Staat einsetzen!
# Install the smoother package
install.packages("smoother")

#' Compute new cases and smooth them
smooth_new_cases <- function(cases){
  cases %>%
    arrange(date) %>%
    mutate(new_cases = c(cases[1], diff(cases))) %>%
    mutate(new_cases_smooth = round(
      smoother::smth(new_cases, window = 7, tails = TRUE)
    )) %>%
    select(state, date, new_cases, new_cases_smooth)
}

state_selected <- "New York"
covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  display_head()
Installing package into ‘/usr/local/lib/R/site-library’
(as ‘lib’ is unspecified)
| state | date | new_cases | new_cases_smooth |
|---|---|---|---|
| New York | 2020-03-01 | 1 | 1 |
| New York | 2020-03-02 | 0 | 2 |
| New York | 2020-03-03 | 1 | 4 |
| New York | 2020-03-04 | 9 | 9 |
| New York | 2020-03-05 | 11 | 15 |
| New York | 2020-03-06 | 22 | 23 |
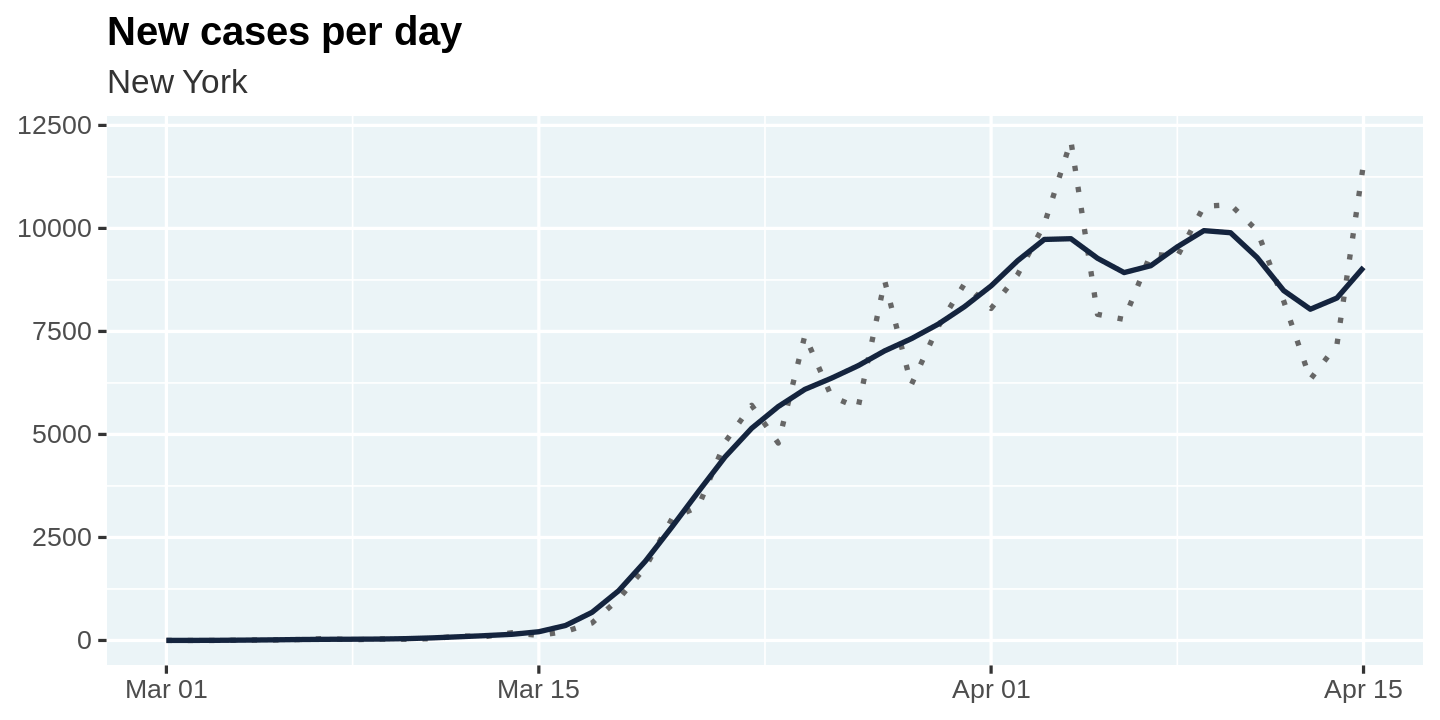
Nun plotten wir Roh- und Glättungswerte von new_cases, um den Effekt der Glättung zu sehen.
🎩 Gute Praxis: Nach Transformationen immer visualisieren. Das schärft Intuition und prüft, ob die Schritte wie beabsichtigt wirken.
plot_new_cases <- function(cases){
  cases %>%
    ggplot(aes(x = date, y = new_cases)) +
    geom_line(linetype = 'dotted', color = 'gray40') +
    geom_line(aes(y = new_cases_smooth), color = "#14243e") +
    labs(
      title = "New cases per day",
      subtitle = unique(cases$state),
      x = NULL, y = NULL
    )
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  plot_new_cases()
Als zweiten Schritt berechnen wir die Likelihoods. Wir folgen dem vorherigen Vorgehen, mit einem Unterschied: Wir arbeiten mit Log-Likelihoods. Das erleichtert das Glätten über ein rollierendes Fenster, um Kevins Modifikation umzusetzen, nur die letzten $m$ Intervalle für $R_t$ zu nutzen.
Wie zuvor berechnen wir pro Tag Likelihoods als geschachtelte Liste und entpacken sie mit tidyr::unnest.
🎩 Listenkolumnen sind extrem nützlich. Das hier gezeigte Pattern hilft in vielen Szenarien.
compute_likelihood <- function(cases){
  likelihood <- cases %>%
    filter(new_cases_smooth > 0) %>%
    mutate(
      r_t = list(r_t_range),
      lambda = map(lag(new_cases_smooth, 1), ~ .x * exp(GAMMA * (r_t_range - 1))),
      likelihood_r_t = map2(new_cases_smooth, lambda, dpois, log = TRUE)
    ) %>%
    slice(-1) %>%
    select(-lambda) %>%
    unnest(c(likelihood_r_t, r_t))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | likelihood_r_t |
|---|---|---|---|---|---|
| New York | 2020-03-24 | 4790 | 5677 | 5.36 | -4010.9111 |
| New York | 2020-03-21 | 3254 | 3614 | 7.33 | -5054.4656 |
| New York | 2020-04-07 | 9378 | 9094 | 5.90 | -10331.2552 |
| New York | 2020-03-13 | 95 | 118 | 7.01 | -144.3349 |
| New York | 2020-04-10 | 10575 | 9895 | 11.69 | -107594.6949 |
| New York | 2020-04-10 | 10575 | 9895 | 8.46 | -35816.2131 |
Im dritten Schritt berechnen wir die Posterior-Wahrscheinlichkeiten. Erinnern wir uns:
$$ P(R_t|k_t) \propto {\displaystyle \prod^{T}_{t=T-m}}\mathcal{L}\left(k_t|R_t\right) $$
In Log-Form geschrieben:
$$ P(R_t|k_t) \propto {\displaystyle \exp \big( \sum^{T}_{t=T-m}}\log(\mathcal{L}\left(k_t|R_t\right)) \big) $$
Mit zoo::rollapplyr bilden wir eine 7‑Tage-Rollsumme der Log-Likelihoods, exponentieren zu Posterioren und normalisieren auf 1.0.
compute_posterior <- function(likelihood){
  likelihood %>%
    arrange(date) %>%
    group_by(r_t) %>%
    mutate(posterior = exp(
      zoo::rollapplyr(likelihood_r_t, 7, sum, partial = TRUE)
    )) %>%
    group_by(date) %>%
    mutate(posterior = posterior / sum(posterior, na.rm = TRUE)) %>%
    # HACK: NaNs in the posterior create issues later on. So we remove them.
    mutate(posterior = ifelse(is.nan(posterior), 0, posterior)) %>%
    ungroup() %>%
    select(-likelihood_r_t)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  display_random()
| state | date | new_cases | new_cases_smooth | r_t | posterior |
|---|---|---|---|---|---|
| New York | 2020-04-14 | 7177 | 8311 | 0.51 | 0.0000000 |
| New York | 2020-03-19 | 1770 | 1921 | 11.62 | 0.0000000 |
| New York | 2020-03-25 | 7401 | 6094 | 5.46 | 0.0000000 |
| New York | 2020-03-22 | 4812 | 4455 | 0.53 | 0.0000000 |
| New York | 2020-03-20 | 2950 | 2753 | 8.64 | 0.0000000 |
| New York | 2020-03-05 | 11 | 15 | 2.44 | 0.0020211 |
Visualisieren wir die Posterioren. Mit alpha = 0.2 reduzieren wir Overplotting, so werden Verschiebungen sichtbar.
plot_posteriors <- function(posteriors){
  posteriors %>%
    ggplot(aes(x = r_t, y = posterior, group = date)) +
    geom_line(alpha = 0.2) +
    labs(
      title = expression(paste("Daily Posterior of R"[t], " by day")),
      subtitle = unique(posteriors$state),
      x = '',
      y = ''
    ) +
    coord_cartesian(xlim = c(0.4, 4)) +
    theme(legend.position = 'none')
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  plot_posteriors()
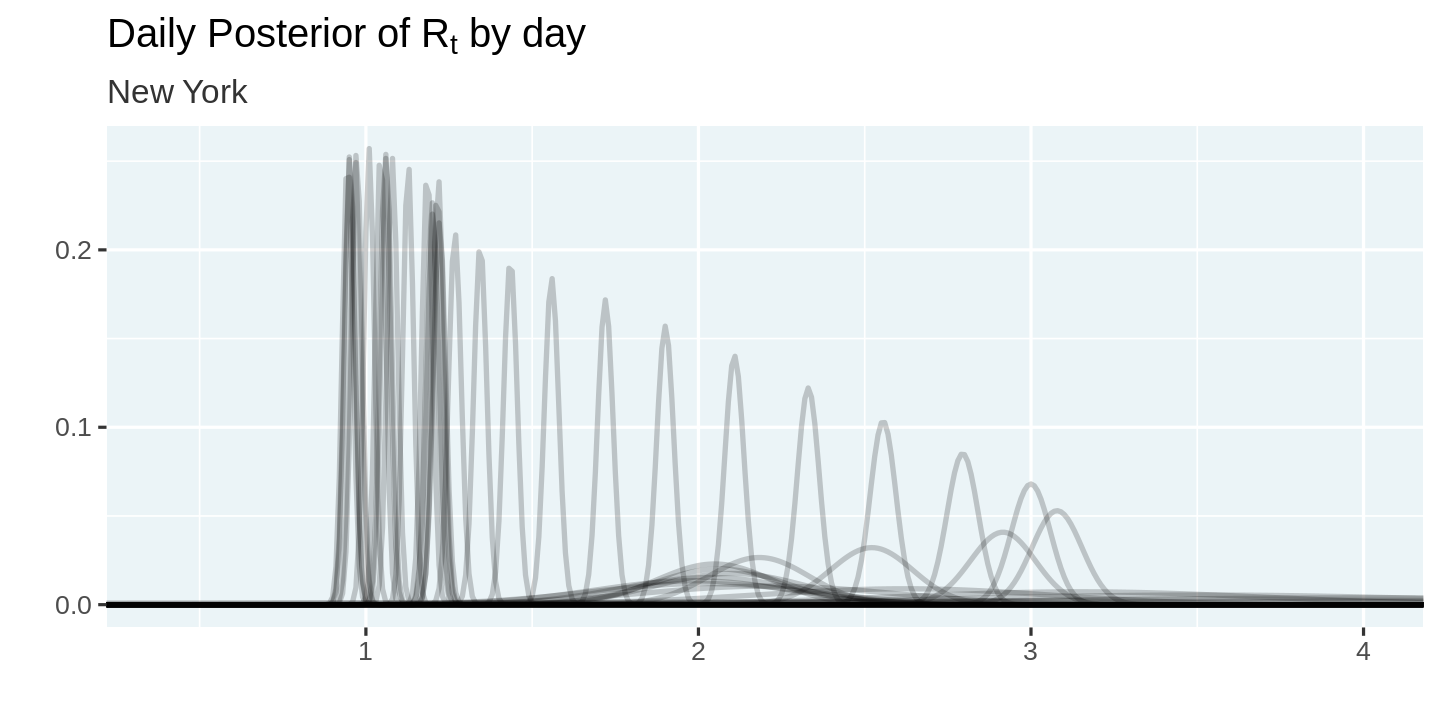
Zum Schluss schätzen wir $R_t$ samt Highest-Density-Intervall. Erinner dich: Für HDIInterval::hdi simulieren wir Zufallswerte für $r_t$ gemäß den Posterioren.
# Estimate R_t and a 95% highest-density interval around it
estimate_rt <- function(posteriors){
  posteriors %>%
    group_by(state, date) %>%
    summarize(
      r_t_simulated = list(sample(r_t_range, 10000, replace = TRUE, prob = posterior)),
      r_t_most_likely = r_t_range[which.max(posterior)]
    ) %>%
    mutate(
      r_t_lo = map_dbl(r_t_simulated, ~ hdi(.x)[1]),
      r_t_hi = map_dbl(r_t_simulated, ~ hdi(.x)[2])
    ) %>%
    select(-r_t_simulated)
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New York | 2020-03-14 | 2.05 | 1.68 | 2.36 |
| New York | 2020-03-22 | 2.33 | 2.27 | 2.39 |
| New York | 2020-03-07 | 2.62 | 1.73 | 3.46 |
| New York | 2020-03-09 | 2.01 | 1.32 | 2.63 |
| New York | 2020-04-04 | 1.18 | 1.15 | 1.21 |
| New York | 2020-04-06 | 1.08 | 1.05 | 1.11 |
Der Moment der Wahrheit: Visualisieren wir die geschätzten $R_t$-Werte.
plot_estimates <- function(estimates){
  estimates %>%
    ggplot(aes(x = date, y = r_t_most_likely)) +
    geom_point(color = "darkorange", alpha = 0.8, size = 4) +
    geom_line(color = "#14243e") +
    geom_hline(yintercept = 1, linetype = 'dashed') +
    geom_ribbon(
      aes(ymin = r_t_lo, ymax = r_t_hi),
      fill = 'darkred',
      alpha = 0.2
    ) +
    labs(
      title = expression('Real time R'[t]), x = '', y = '',
      subtitle = unique(estimates$state)
    ) +
    coord_cartesian(ylim = c(0, 4))
}

covid_cases %>%
  filter(state == state_selected) %>%
  smooth_new_cases() %>%
  compute_likelihood() %>%
  compute_posterior() %>%
  estimate_rt() %>%
  plot_estimates()
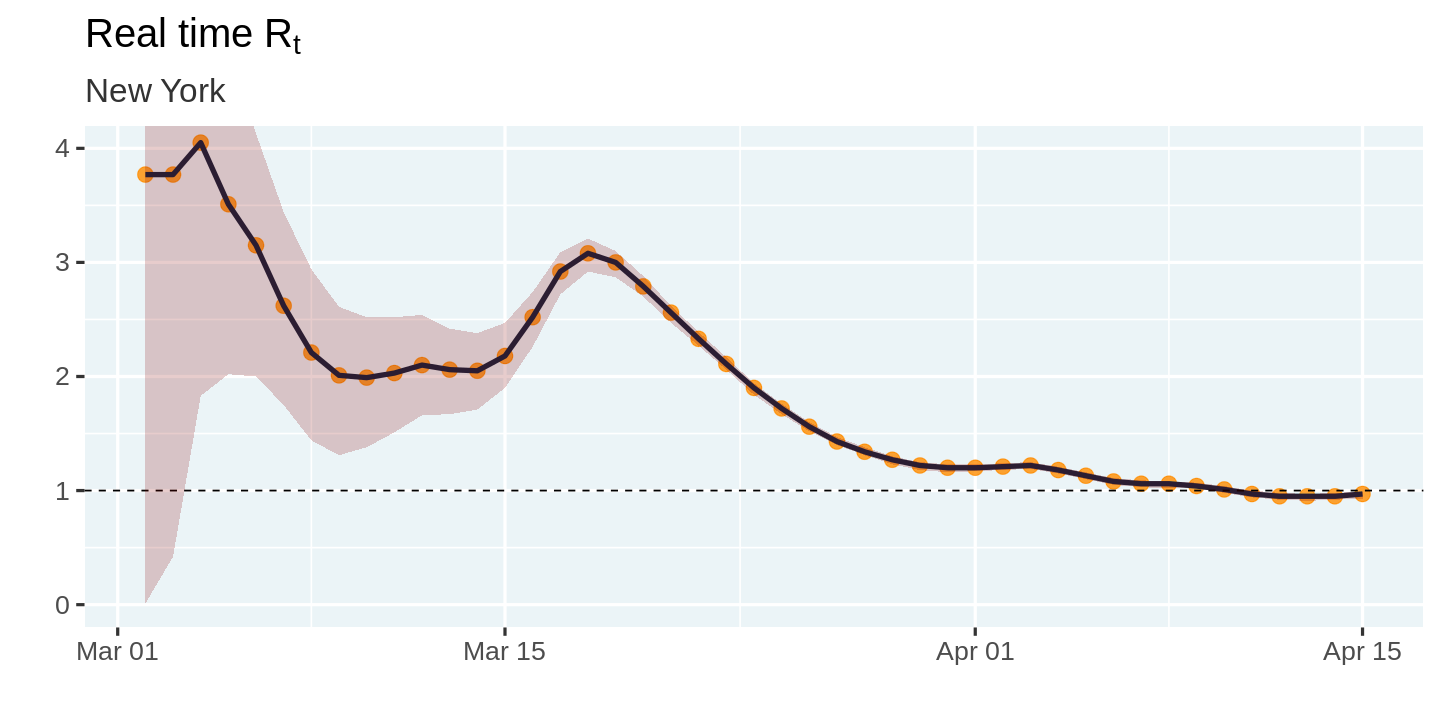
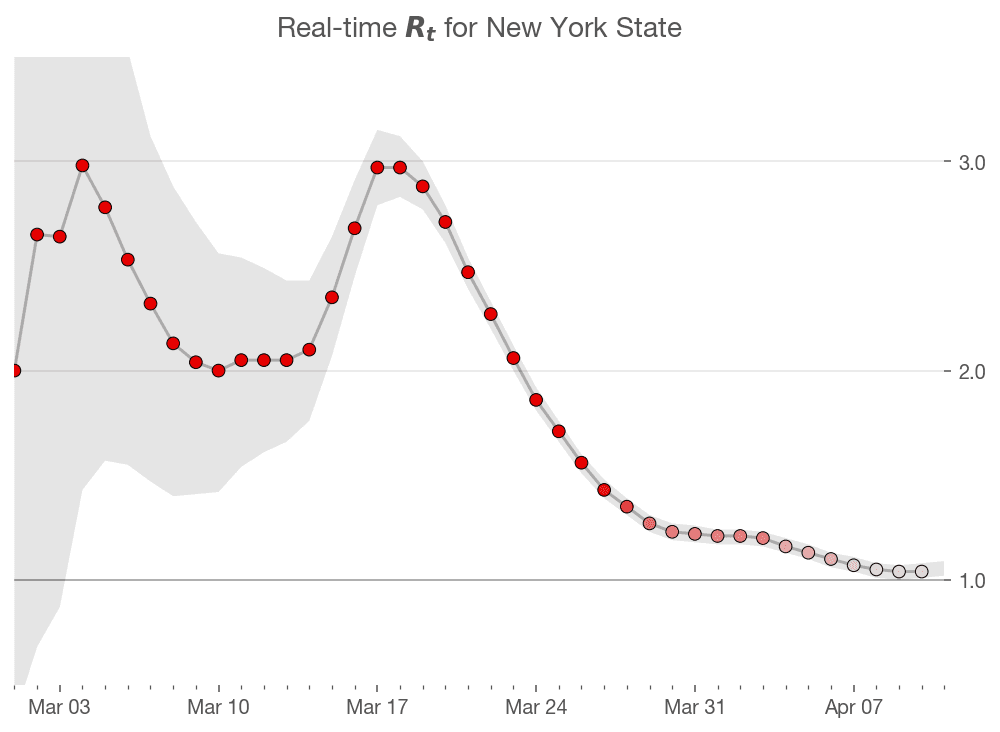
Wie passt das zu Kevins Schätzungen? Die anfänglichen Werte weichen etwas ab. Das kann an Unterschieden in der Glättung oder der hohen Unsicherheit zu Beginn liegen. Der Verlauf und die Peaks stimmen jedoch gut überein. Ziel erreicht! 🎉
Jetzt berechnen wir die Schätzungen für alle Bundesstaaten. Wir gruppieren nach state, teilen die Daten in je eine Tabelle pro Staat und nutzen purrr::map_df, um $R_t$ je Staat zu schätzen und wieder zu vereinen.
# ⚠️This function can take a couple of minutes to run
#   as it loops across all states
estimates_all <- covid_cases %>%
  filter(date >= "2020-03-01") %>%
  group_by(state) %>%
  # Ignore states that have not reached 100 infections
  filter(max(cases) > 100 ) %>%
  group_split() %>%
  map_df(~ {
    .x %>%
      smooth_new_cases() %>%
      compute_likelihood() %>%
      compute_posterior() %>%
      estimate_rt()
  }) %>%
  ungroup()
estimates_all %>%
  display_random()
| state | date | r_t_most_likely | r_t_lo | r_t_hi |
|---|---|---|---|---|
| New Jersey | 2020-03-15 | 2.72 | 2.01 | 3.42 |
| Alaska | 2020-04-02 | 0.80 | 0.04 | 1.54 |
| Maryland | 2020-03-12 | 1.67 | 0.00 | 3.33 |
| Washington | 2020-03-10 | 2.01 | 1.49 | 2.52 |
| New Mexico | 2020-03-28 | 1.58 | 0.89 | 2.17 |
| South Dakota | 2020-04-08 | 1.63 | 1.12 | 2.09 |
Nun erstellen wir ein Small-Multiples-Diagramm der Schätzungen über alle Staaten. Mit ggplot2 geht das fast von selbst — nur eine Zeile zusätzlich!
# Increase plot height and width
options(repr.plot.height = 40, repr.plot.width = 20)
estimates_all %>%
  plot_estimates() +
  facet_wrap(~ state, ncol = 4) +
  labs(subtitle = "")

# Reset plot dimensions
options(repr.plot.height = 12, repr.plot.width = 8)
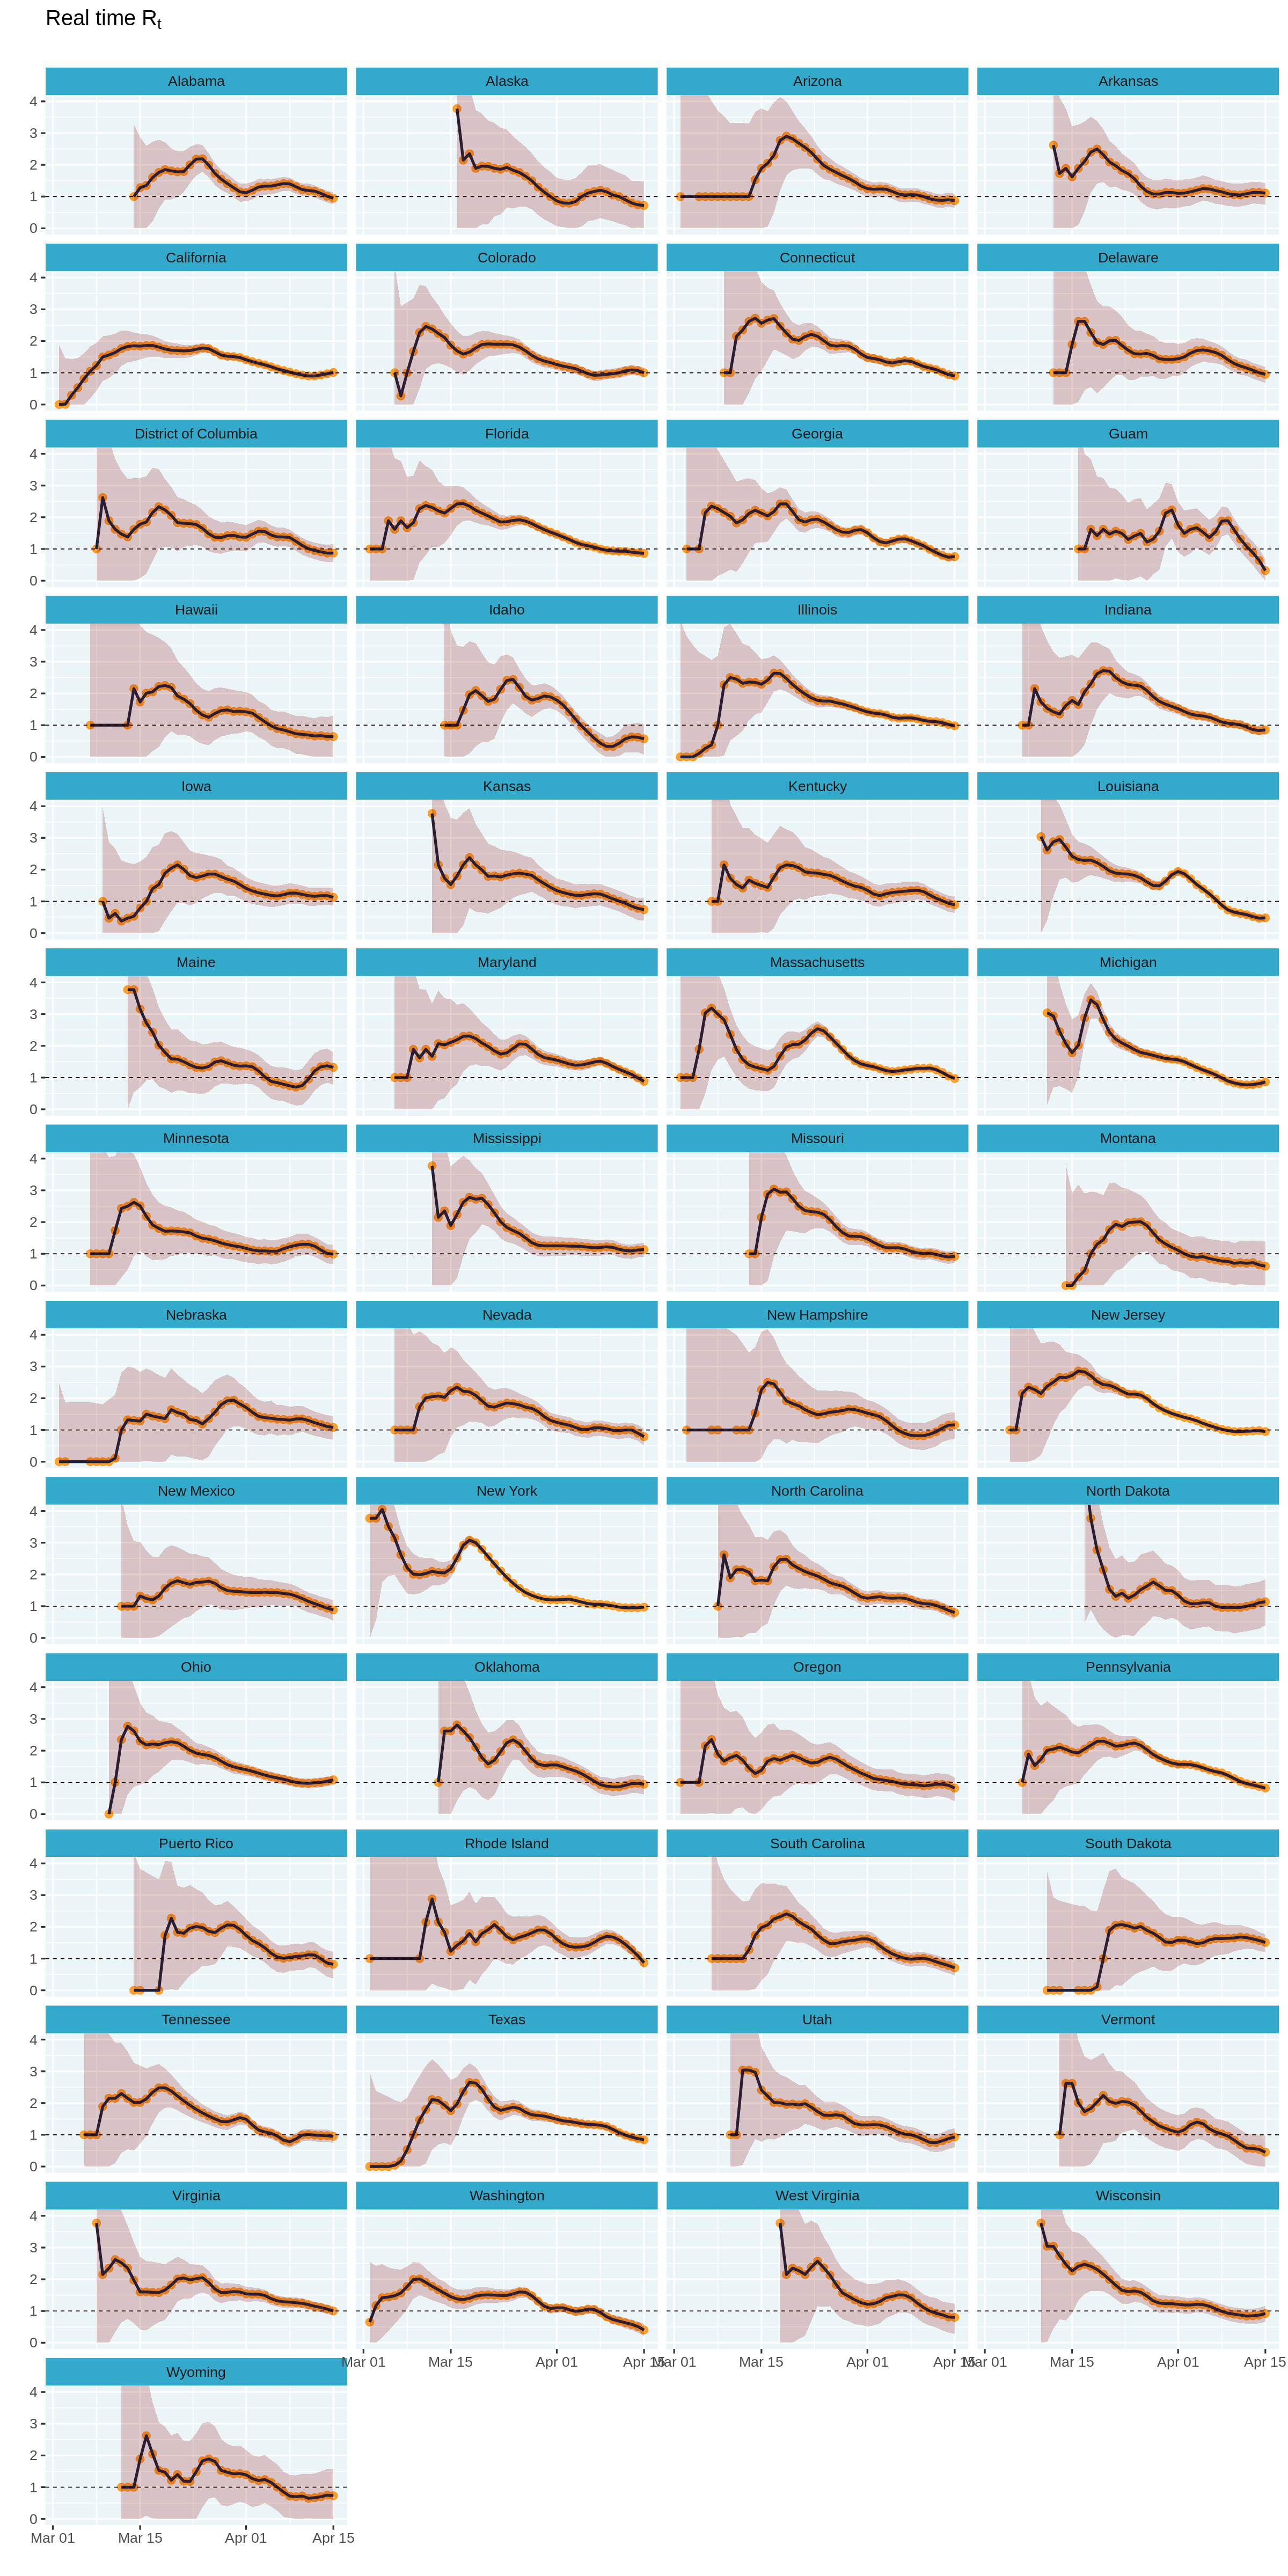
Das Raster ist gut, aber man findet Staaten so schwer anhand ihrer geografischen Lage. Was, wenn wir die Panels geografisch anordnen?
Zum Glück gibt es von Ryan Hafen das Paket geofacet, mit dem wir Small Multiples mit einer einzigen Codezeile in einem geografischen Raster anordnen.
⚠️ Leider ließ sich geofacet auf Colab nicht installieren (vermutlich wegen Systemabhängigkeiten von sf), daher schlägt der folgende Code dort fehl. Ein lokal erzeugter Plot ist beigefügt, damit du einen Eindruck bekommst.
# ⚠️ CAUTION: This code will error on colab
# options(repr.plot.height = 40, repr.plot.width = 20)
# estimates_all %>%
#  mutate(state = state.abb[match(state, state.name)]) %>%
#  plot_estimates() +
#  geofacet::facet_geo(~ state, ncol = 4) +
#  labs(subtitle = "") +
#  theme(strip.text = element_text(hjust = 0))
# options(repr.plot.height = 12, repr.plot.width = 8)

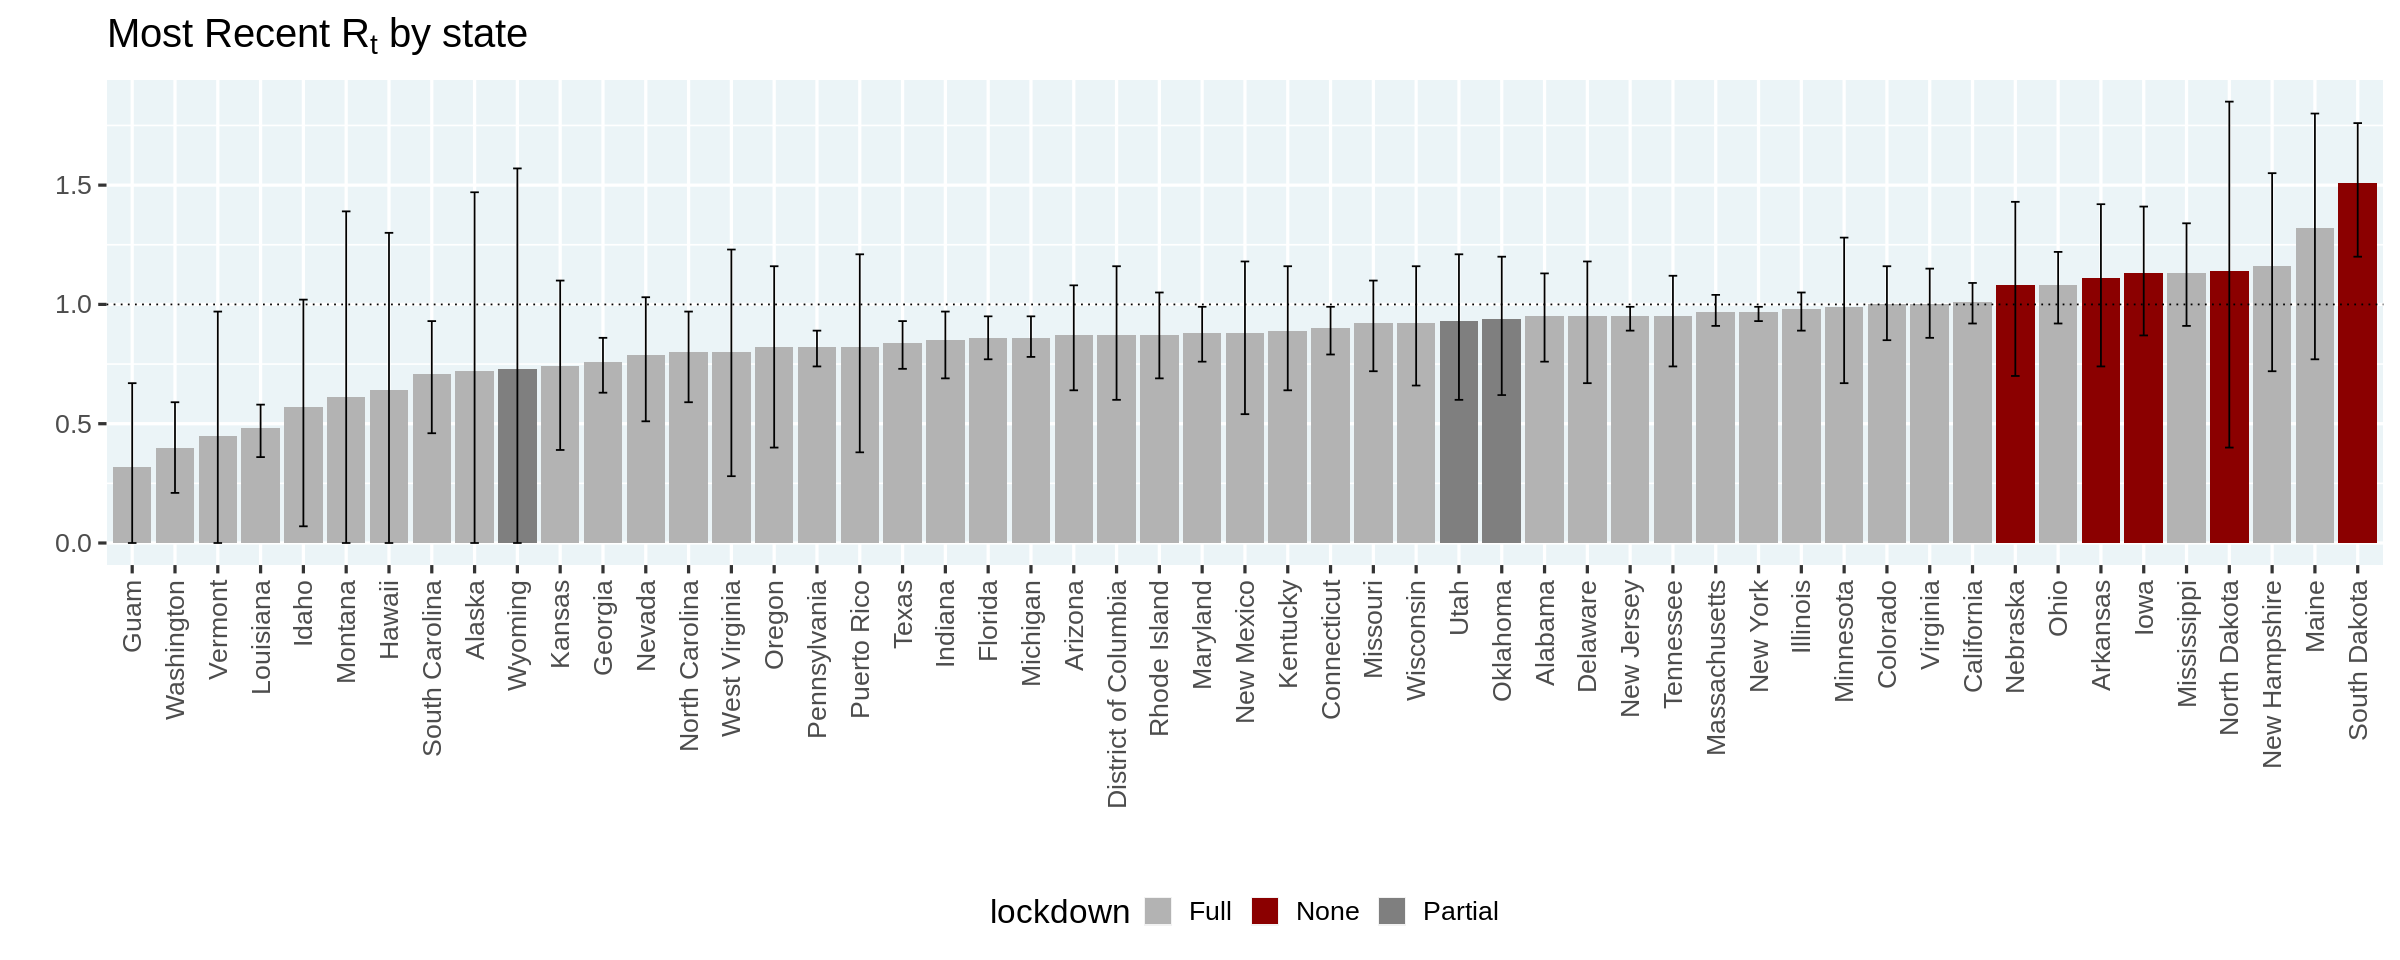
Zum Schluss rekonstruieren wir die Darstellung aus Kevins Artikel: Staaten sortiert nach dem aktuell wahrscheinlichsten $R_t$ und eingefärbt nach Lockdown-Status.
⚠️ Hinweis: Das ist rein deskriptiv. Aussagen zur Wirksamkeit von Lockdowns lassen sich daraus nicht ableiten.
options(repr.plot.width = 20, repr.plot.height = 8)
no_lockdown = c('North Dakota', 'South Dakota', 'Nebraska', 'Iowa', 'Arkansas')
partial_lockdown = c('Utah', 'Wyoming', 'Oklahoma')
estimates_all %>%
  group_by(state) %>%
  filter(date == max(date)) %>%
  ungroup() %>%
  mutate(state = forcats::fct_reorder(state, r_t_most_likely)) %>%
  mutate(lockdown = case_when(
    state %in% no_lockdown ~ 'None',
    state %in% partial_lockdown ~ 'Partial',
    TRUE ~ "Full"
  )) %>%
  ggplot(aes(x = state, y = r_t_most_likely)) +
  geom_col(aes(fill = lockdown)) +
  geom_hline(yintercept = 1, linetype = 'dotted') +
  geom_errorbar(aes(ymin = r_t_lo, ymax = r_t_hi), width = 0.2) +
  scale_fill_manual(values = c(None = 'darkred', Partial = 'gray50', Full = 'gray70')) +
  labs(
    title = expression(paste("Most Recent R"[t], " by state")),
    x = '', y = ''
  ) +
  theme(axis.text.x.bottom = element_text(angle = 90, hjust = 1, vjust = 0.5))
options(repr.plot.width = 12, repr.plot.height = 5)
In diesem Artikel haben wir Kevins Analyse in R mit dem tidyverse repliziert und nützliche Tricks zum Berechnen von Likelihoods und Posterioren gelernt. Ich habe dabei enorm viel mitgenommen!
Es gibt viele mögliche Erweiterungen, eine liegt besonders nahe: Da die Funktionen hier mit einer einfachen Eingabetabelle mit drei Spalten arbeiten — location, date, cases — wäre ein nächster Schritt, daraus ein R-Paket zu machen. So ließe sich $R_t$ für andere Regionen leichter schätzen.
Zum Schluss ein Dank an Kevin Systrom für den spannenden Beitrag und das Teilen seines Codes. Danke auch an meine Kolleg:innen bei DataCamp für wertvolles Feedback zur ersten Version dieses Artikels.
Wenn du Feedback oder Ideen für Erweiterungen hast, erreichst du mich auf Twitter unter @ramnath_vaidya und auf GitHub. Um mehr über R zu lernen
Erfahre mehr über R
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Nathaniel Taylor-Leach
Tutorial
Josef Waples
8 Min.
Tutorial
Allan Ouko
7 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Josef Waples
3 Min.