Tidak semua hubungan mengikuti garis lurus.
Anda mungkin melihat bahwa ketika anggaran pemasaran meningkat, konversi pelanggan cenderung membaik, tetapi tidak dengan laju yang konstan. Atau mungkin, seiring pendapatan naik, kebahagiaan sering meningkat, lalu mendatar. Polanya jelas, tetapi tidak linier. Apa yang bisa Anda lakukan untuk mengukurnya?
Korelasi digunakan untuk menggambarkan bagaimana dua variabel bergerak bersama. Korelasi umum yang akan Anda lihat adalah Koefisien Korelasi Pearson, yang work dengan sangat baik untuk hubungan linier. Namun, banyak hubungan dunia nyata tidak linier. Hubungan tersebut bisa melengkung, mendatar, atau mengikuti tren yang konsisten tanpa membentuk garis lurus. Dalam beberapa kasus, nilai pastinya kurang penting dibanding urutan kemunculannya. Di sinilah Koefisien Korelasi Peringkat Spearman berperan.
Korelasi Spearman bekerja dengan peringkat alih-alih nilai mentah, mengukur apakah dua variabel cenderung meningkat atau menurun bersama secara konsisten. Ini membuatnya sangat cocok untuk hubungan monoton. Ini juga membuatnya lebih tangguh terhadap keanehan data tertentu, seperti pencilan atau jarak yang tidak merata.
Apa itu Korelasi Peringkat Spearman?
Koefisien Korelasi Peringkat Spearman adalah ukuran kekuatan dan arah hubungan antara dua variabel. Ukuran ini didasarkan pada peringkat nilai-nilainya, bukan nilai itu sendiri.
Untuk melihat cara kerjanya, bayangkan Anda menganalisis lagu di platform streaming. Anda mungkin membandingkan jumlah pemutaran lagu dengan peringkatnya di tangga lagu “Top 100”. Hubungan ini mungkin tidak sepenuhnya linier; menggandakan jumlah pemutaran tidak serta-merta menggandakan posisi lagu. Namun secara umum, lagu dengan lebih banyak pemutaran cenderung memiliki peringkat lebih tinggi.
Korelasi Spearman menangkap pola semacam ini dengan berfokus pada urutan data, bukan nilai pastinya.
Ini sangat berguna ketika hubungan tidak linier namun masih mengikuti tren yang jelas, data secara alami diekspresikan sebagai peringkat, atau data mengandung pencilan yang bisa mendistorsi pengukuran linier.
Berbeda dengan korelasi Pearson, yang bekerja langsung dengan nilai mentah, korelasi Spearman terlebih dahulu mengonversi data menjadi peringkat dan kemudian mengukur seberapa selaras peringkat tersebut.
Secara teknis, korelasi Spearman mengukur hubungan monoton. Suatu hubungan bersifat monoton jika satu variabel cenderung meningkat saat yang lain meningkat, atau menurun saat yang lain menurun, tanpa berganti arah.
Hubungan monoton vs. linier
Jadi apa tepatnya perbedaan antara hubungan linier dan monoton?
Hubungan linier adalah hubungan di mana data mengikuti pola garis lurus. Jika Anda memplot datanya, Anda akan melihat titik-titik yang kira-kira membentuk garis.
Sebaliknya, hubungan monoton lebih longgar. Ini hanya berarti bahwa hubungan bergerak dalam satu arah. Intinya, kedua variabel bergerak bersama, tetapi tidak harus dalam garis lurus. Polanya bisa melengkung, mendatar, atau berubah laju, selama tidak berbalik arah.
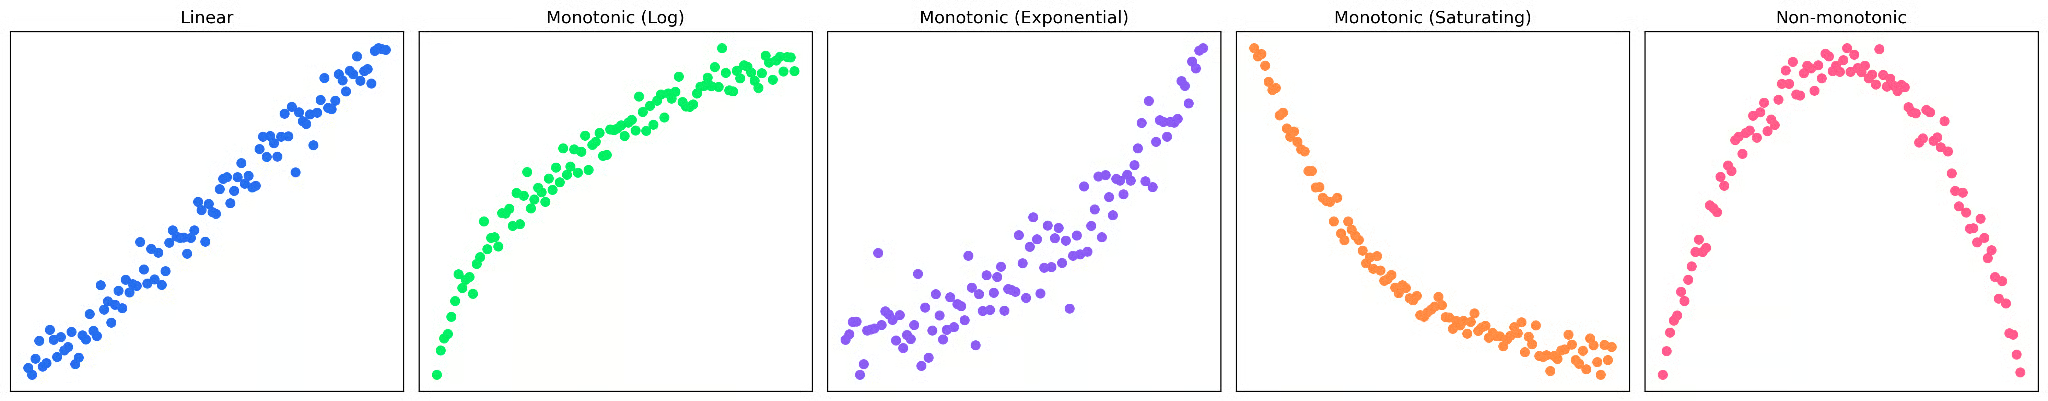
Pada grafik di atas, Anda dapat melihat empat contoh berbeda hubungan monoton, dan hanya yang pertama yang linier. Grafik terakhir tidak monoton, karena polanya beralih arah, dimulai sebagai asosiasi positif dan berakhir sebagai yang negatif.
|
Jenis Hubungan |
Deskripsi |
Tampilannya |
|
Linier |
Variabel meningkat atau menurun dengan laju konstan |
Garis lurus |
|
Monoton (Namun Nonlinier) |
Variabel bergerak dalam satu arah, tetapi lajunya berubah |
Tren melengkung, mendatar, atau mempercepat |
|
Non-monoton |
Hubungan berganti arah (meningkat lalu menurun, atau sebaliknya) |
Bentuk U, U terbalik, atau pola bergelombang |
Cara Menemukan Korelasi Peringkat Spearman Langkah demi Langkah
Secara garis besar, Koefisien Korelasi Peringkat Spearman bekerja dengan mengonversi data Anda menjadi peringkat lalu mengukur seberapa mirip peringkat antarvariabel.
Mari kita kerjakan contoh kecil. Misalkan kita melihat hubungan antara jam yang dihabiskan untuk berlatih alat musik dan peringkat penampilan dalam sebuah kompetisi.
|
Siswa |
Jam Latihan (X) |
Skor Penampilan (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Pertama, mari plot datanya.
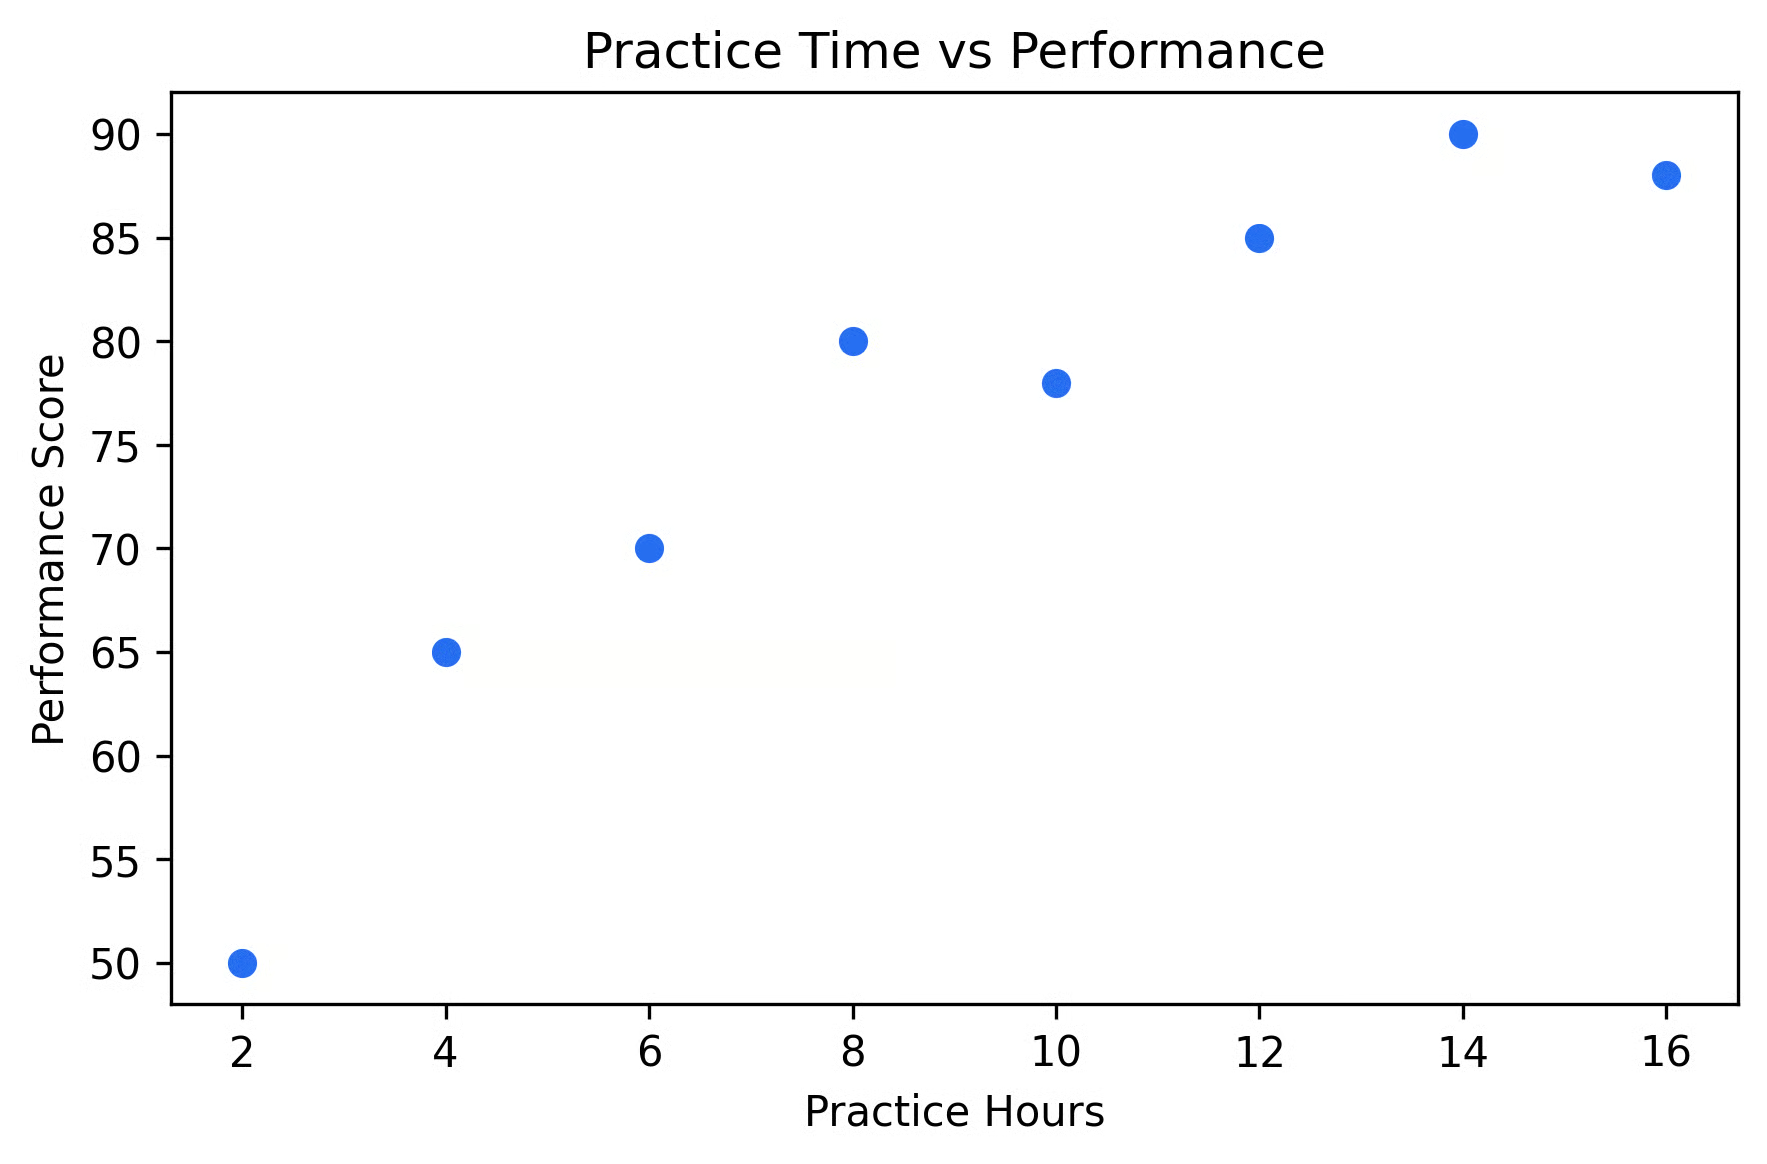
Secara visual, tampak bahwa lebih banyak latihan menghasilkan skor penampilan yang lebih tinggi, tetapi polanya tidak tampak sempurna linier. Sepertinya ada hasil yang menurun saat latihan terlalu banyak. Mari kita coba menerapkan Peringkat Spearman untuk mengkuantifikasi hubungan ini.
Langkah 1: konversi data menjadi peringkat
Pertama, mari kita tetapkan peringkat untuk setiap nilai. Di dalam tiap variabel, kita memberikan peringkat pada setiap nilai dari yang terkecil hingga yang terbesar. Nilai terkecil dalam sebuah variabel mendapat peringkat 1, yang terkecil kedua mendapat peringkat 2, dan seterusnya.
|
Siswa |
Jam Latihan (X) |
Peringkat (X) |
Skor Penampilan (Y) |
Peringkat (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Perhatikan bahwa peringkat Y berada dalam urutan yang agak berbeda dari X. Inilah variasi yang akan diukur oleh korelasi Spearman.
Langkah 2: hitung selisih peringkat
Selanjutnya, kita menghitung selisih antara peringkat untuk setiap pengamatan.
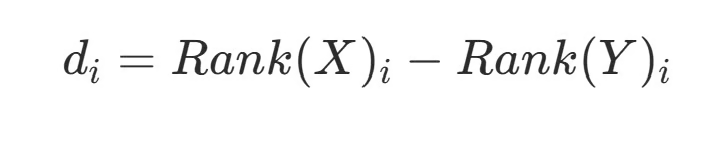
Lalu kuadratkan setiap selisih:
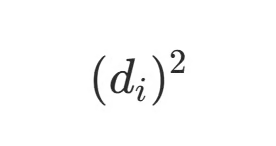
|
Siswa |
Peringkat(X) |
Peringkat(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Sekarang kita jumlahkan selisih kuadrat pada kolom terakhir tabel kita.
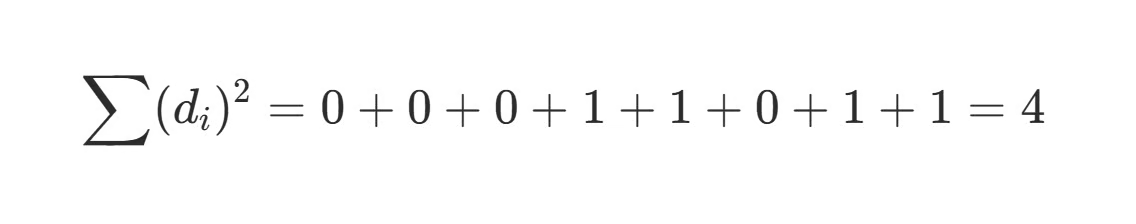
Langkah 3: terapkan rumus
Terakhir, kita perlu memasukkan nilai-nilai tersebut ke dalam rumus korelasi Spearman.
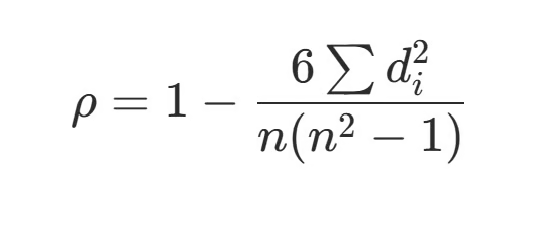
Kita sudah tahu bahwa (di)2=4 dari perhitungan sebelumnya. n pada penyebut adalah ukuran sampel, yang bagi kita adalah 8. Memasukkannya, kita mendapatkan:
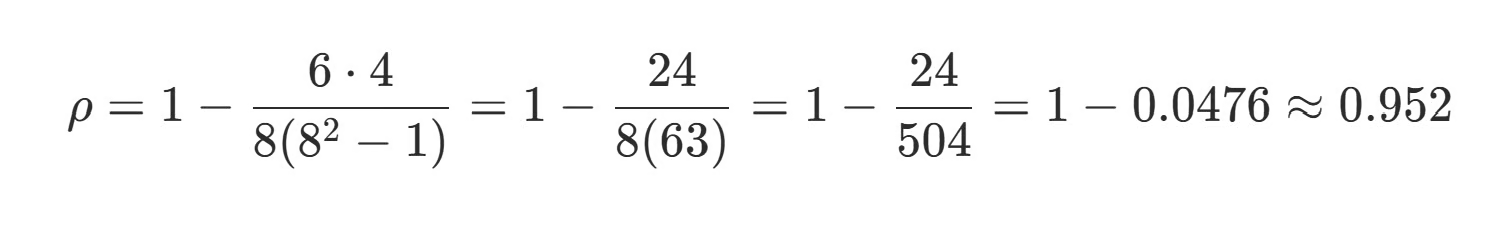
Menafsirkan hasil
Hasil akhir kita adalah ρ ~ 0,95. Karena nilai ini mendekati +1, ini menunjukkan hubungan positif yang kuat antara waktu latihan dan penampilan. Meskipun hubungannya tidak sepenuhnya linier, peringkatnya sangat mirip. Ini berarti ketika nilai x berubah, nilai y cenderung berubah secara konsisten bersamanya.
Dalam situasi nyata, sangat jarang menghitung ini secara manual. Sebagian besar perangkat lunak menangani pemeringkatan, nilai seri, dan perhitungan secara otomatis, yang bagus karena umumnya kita memiliki ukuran sampel yang jauh lebih besar!
Menghitung Korelasi Spearman Menggunakan Perangkat Lunak
Sebagian besar perangkat lunak statistik saat ini dapat melakukan perhitungan ini dalam hitungan detik. Mari kita bahas secara singkat beberapa perangkat lunak yang paling umum.
Python
Di Python, Anda biasanya menggunakan scipy atau pandas, bergantung pada alur kerja Anda. Jika Anda bekerja dengan array atau daftar, scipy menyediakan cara langsung untuk menghitung korelasi Spearman.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Ini mengembalikan koefisien korelasi dan p-value, yang berguna jika Anda melakukan pengujian statistik.
Jika Anda bekerja dengan data tabular, pandas sering kali lebih nyaman.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Ini menghitung matriks korelasi, memudahkan untuk membandingkan beberapa variabel sekaligus.
Atau, jika Anda hanya menginginkan korelasi antara dua kolom tertentu, Anda bisa dengan mudah menentukannya.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
Di R, korelasi Spearman sudah tersedia dalam fungsi statistik inti.
Untuk perhitungan cepat, Anda dapat menggunakan cor() dan menentukan bahwa Anda ingin menggunakan metode Spearman.
cor(x, y, method = "spearman")Jika Anda juga menginginkan p-value dan detail statistik tambahan, cor.test() menyediakannya dengan mudah.
cor.test(x,y,method="spearman")Excel
Excel tidak memiliki fungsi Spearman bawaan, tetapi Anda dapat menghitungnya dalam dua langkah cepat: pertama, beri peringkat data, lalu ambil korelasi dari peringkat tersebut.
Berikut contoh kecil:
|
A (X) |
B (Y) |
C (Peringkat X) |
D (Peringkat Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Anda dapat membuat peringkat (kolom C dan D) menggunakan fungsi RANK.AVG. Misalnya:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Lalu, cukup hitung korelasi Spearman.
=CORREL(C2:C6, D2:D6)Di semua alat ini, proses dasarnya sama: konversi nilai menjadi peringkat lalu hitung korelasi dari peringkat tersebut.
Cara Menafsirkan Korelasi Peringkat Spearman
Jika Anda pernah menggunakan Korelasi Pearson, maka kemungkinan Anda sudah memiliki intuisi yang cukup baik untuk menafsirkan Korelasi Peringkat Spearman, karena interpretasinya pada dasarnya sama.
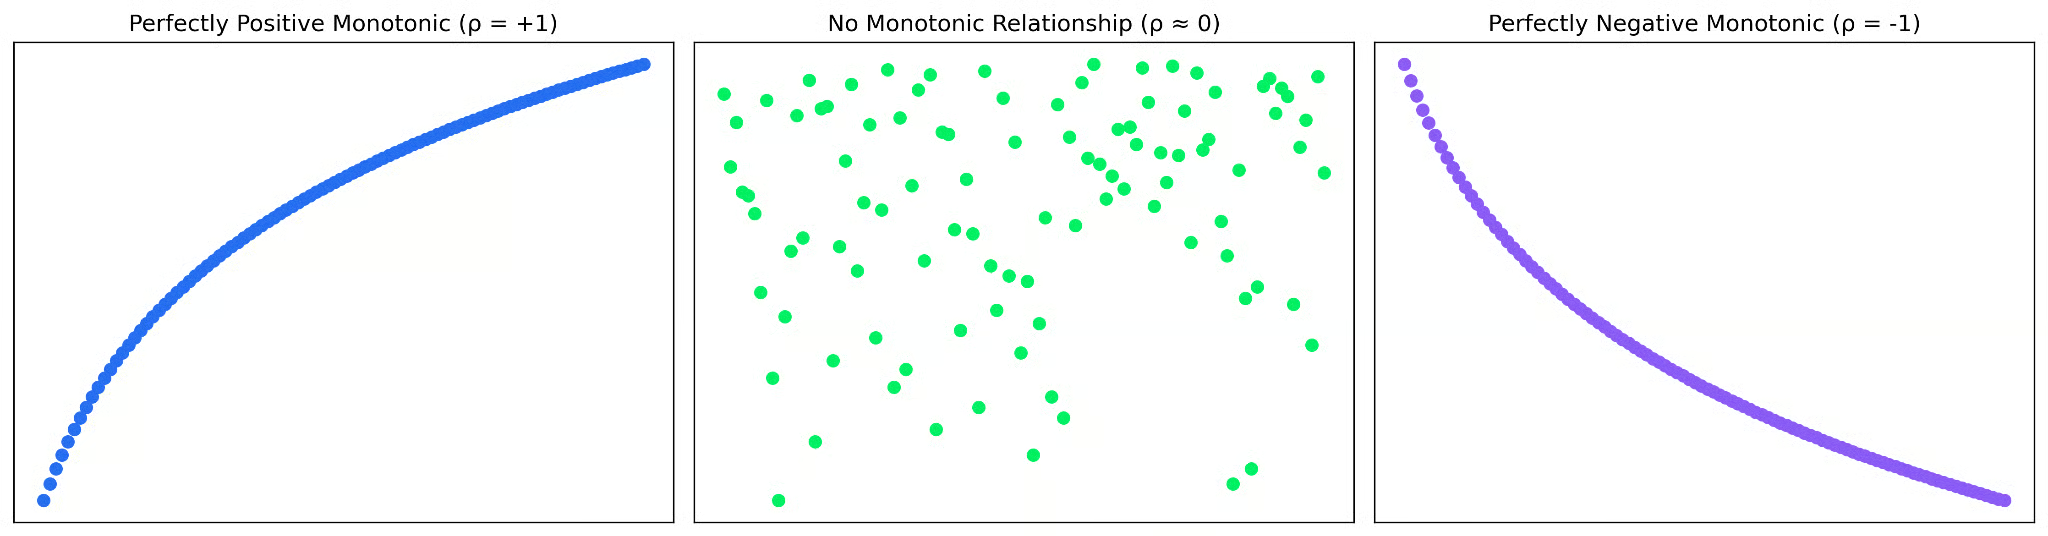
Peringkat Spearman memberi Anda nilai antara -1 dan 1. Ini memberi tahu Anda arah dan kekuatan hubungan monoton.
Nilai +1 menunjukkan hubungan monoton yang meningkat sempurna; ketika satu variabel meningkat, yang lain selalu meningkat. Ini terjadi ketika peringkat setiap pasangan nilai persis sama.
Nilai -1 menunjukkan hubungan monoton yang menurun sempurna; ketika satu variabel meningkat, yang lain selalu menurun. Ini terjadi ketika peringkat setiap pasangan nilai persis terbalik.
Nilai 0 menunjukkan tidak ada hubungan monoton. Ini terjadi ketika tidak ada tren yang konsisten dalam peringkat.
Satu perbedaan penting dari Koefisien Korelasi Pearson adalah bahwa korelasi Spearman mencerminkan seberapa baik urutan data selaras, bukan seberapa dekat nilai aktual mengikuti garis lurus. Ini berarti korelasi Spearman yang kuat menunjukkan tren yang jelas dalam peringkat, dan tidak serta-merta bahwa hubungannya linier atau berjarak merata.
Karena itu, selalu merupakan ide bagus untuk memasangkan nilai korelasi dengan visualisasi cepat agar paling memahami pola yang mendasarinya.
Menangani Seri (Ties) dalam Peringkat
Semua ini terdengar baik-baik saja sampai Anda menemukan dataset di mana beberapa pengamatan memiliki nilai yang sama. Apa yang harus Anda lakukan? Ini disebut seri (ties), dan memerlukan penyesuaian kecil saat memberikan peringkat.
Sebagai contoh, pertimbangkan nilai: 10, 20, 20, 30. Dua nilai 20 biasanya menempati peringkat 2 dan 3. Namun, karena nilainya sama, alih-alih memberikan peringkat berbeda, kita memberikan masing-masing nilai rata-rata dari peringkat tersebut; kedua 20 mendapat peringkat 2,5. Pendekatan ini memastikan nilai seri diperlakukan adil dan keseluruhan pemeringkatan tetap konsisten.
Karena Koefisien Korelasi Peringkat Spearman sepenuhnya didasarkan pada peringkat, jika seri tidak ditangani dengan benar, korelasinya dapat terdistorsi.
Keterbatasan Korelasi Spearman
Meskipun Koefisien Korelasi Peringkat Spearman merupakan ukuran yang fleksibel dan banyak digunakan, ada beberapa keterbatasan.
Yang paling penting, ukuran ini hanya dapat menangkap hubungan monoton. Jika sebuah hubungan berganti arah, seperti pola berbentuk U atau gelombang sinus, korelasinya bisa mendekati nol meski ada pola yang jelas. Dalam kasus ini, Anda akan lebih terbantu dengan model nonlinier, seperti regresi polinomial.
Selain itu, karena korelasi Spearman berbasis peringkat, ia mengabaikan jarak aktual antar nilai. Ini membuatnya lebih baik dalam menangani pencilan, tetapi juga berarti sebagian informasi hilang. Besaran hubungan lebih sulit ditafsirkan dengan Korelasi Spearman dibanding Korelasi Pearson karenanya. Spearman memberi tahu apakah variabel bergerak bersama dalam urutan, tetapi bukan seberapa banyak satu variabel berubah relatif terhadap yang lain.
Terakhir, ketika banyak nilai yang seri, proses pemeringkatan menjadi kurang presisi. Ini dapat menghasilkan nilai korelasi yang lebih lemah, yang berpotensi tidak merepresentasikan tingkat hubungan secara penuh.
Spearman vs. Pearson: Kapan Menggunakan Masing-Masing
Korelasi yang paling umum digunakan mungkin adalah Koefisien Korelasi Pearson. Sekilas, itu tampak seperti statistik yang sangat mirip dengan Koefisien Korelasi Spearman. Namanya pun hampir identik! Namun keduanya menjawab pertanyaan yang sedikit berbeda.
Pearson bertanya, “Apakah variabel-variabel ini mengikuti hubungan garis lurus?”, sementara Spearman bertanya, “Apakah variabel-variabel ini bergerak dalam urutan yang sama?”
Jika data Anda mengikuti pola garis lurus secara kasar dan jarak aktual antar nilai bermakna, Korelasi Pearson biasanya pilihan yang tepat. Namun jika hubungan melengkung atau mendatar, Spearman cenderung lebih cocok.
Spearman juga lebih pemaaf. Karena bekerja dengan peringkat, bukan nilai mentah, ia kurang sensitif terhadap pencilan dan tidak terlalu bergantung pada asumsi tentang data. Konsekuensinya, Spearman tidak sebaik Pearson dalam menangkap perbedaan besaran antar nilai.
Dalam praktiknya, aturan jempol yang baik adalah: jika hubungannya linier, gunakan Pearson; jika monoton namun tidak linier, gunakan Spearman. Dan seperti biasa, plot data Anda sebelum mengambil keputusan.
Kesimpulan
Koefisien Korelasi Spearman adalah alat yang sangat baik untuk menangkap pola monoton, terutama pada dataset yang tidak terlayani dengan baik oleh Korelasi Pearson. Dengan bekerja menggunakan peringkat, ia kurang sensitif terhadap pencilan dan lebih akomodatif terhadap data nonlinier.
Anda dapat membaca lebih lanjut tentang memilih korelasi terbaik untuk dataset Anda di Memahami Korelasi: Mengukur Hubungan dalam Data. Anda juga mungkin tertarik pada Memahami Kovarians: Panduan Pengantar.