Nie wszystkie zależności układają się w linię prostą.
Możesz zauważyć, że wraz ze wzrostem budżetu marketingowego konwersja klientów zwykle się poprawia, ale nie w stałym tempie. Albo że wraz ze wzrostem dochodów poziom szczęścia często rośnie, a potem się wypłaszcza. Wzorzec jest wyraźny, ale nie jest liniowy. Jak to zmierzyć?
Korelacja opisuje, jak dwie zmienne zmieniają się razem. Powszechnie spotykanym współczynnikiem korelacji jest współczynnik korelacji Pearsona, który doskonale sprawdza się dla zależności liniowych. Jednak wiele relacji w rzeczywistości nie jest liniowych. Mogą się zakrzywiać, spłaszczać lub podążać za stałym trendem bez tworzenia prostej. W niektórych przypadkach mniej istotne są dokładne wartości, a bardziej kolejność ich występowania. Tu wkracza współczynnik korelacji rang Spearmana.
Korelacja Spearmana działa na rangach zamiast na wartościach surowych, mierząc, czy dwie zmienne mają tendencję do wspólnego wzrostu lub spadku w spójny sposób. Dzięki temu świetnie nadaje się do relacji monotonicznych. Jest też bardziej odporna na pewne osobliwości danych, jak wartości odstające czy nierówne odstępy.
Czym jest korelacja rang Spearmana?
Współczynnik korelacji rang Spearmana to miara siły i kierunku zależności między dwiema zmiennymi. Opiera się na rangach ich wartości, a nie na samych wartościach.
Aby zobaczyć, jak to działa, wyobraź sobie, że analizujesz piosenki na platformie streamingowej. Możesz porównać liczbę odtworzeń utworu z jego pozycją na liście „Top 100”. Zależność może nie być idealnie liniowa — podwojenie liczby odtworzeń niekoniecznie podwaja pozycję utworu. Ogólnie jednak piosenki z większą liczbą odtworzeń mają wyższe miejsca w rankingu.
Korelacja Spearmana uchwytuje taki wzorzec, skupiając się na kolejności danych zamiast na ich dokładnych wartościach.
Jest to szczególnie przydatne, gdy relacja nie jest liniowa, ale wciąż podąża wyraźnym trendem, dane naturalnie wyrażone są jako rankingi albo zawierają wartości odstające, które mogłyby zniekształcić pomiar liniowy.
W przeciwieństwie do korelacji Pearsona, która pracuje bezpośrednio na wartościach surowych, korelacja Spearmana najpierw przekształca dane w rangi, a następnie mierzy, jak ściśle te rankingi się pokrywają.
Technicznie rzecz biorąc, korelacja Spearmana mierzy zależności monotoniczne. Zależność jest monotoniczna, jeśli jedna zmienna ma tendencję do wzrostu wraz ze wzrostem drugiej lub do spadku wraz z jej spadkiem, bez zmiany kierunku.
Relacje monotoniczne vs. liniowe
Jaka jest więc dokładnie różnica między zależnościami liniowymi a monotonicznymi?
Relacja liniowa to taka, w której dane układają się w wzór prostej. Na wykresie punkty tworzyłyby w przybliżeniu linię.
Relacja monotoniczna jest mniej restrykcyjna. Oznacza po prostu, że związek porusza się w jednym kierunku. Innymi słowy, obie zmienne zmieniają się razem, ale niekoniecznie po linii prostej. Wzorzec może się zakrzywiać, wypłaszczać lub zmieniać tempo, o ile nie odwraca kierunku.
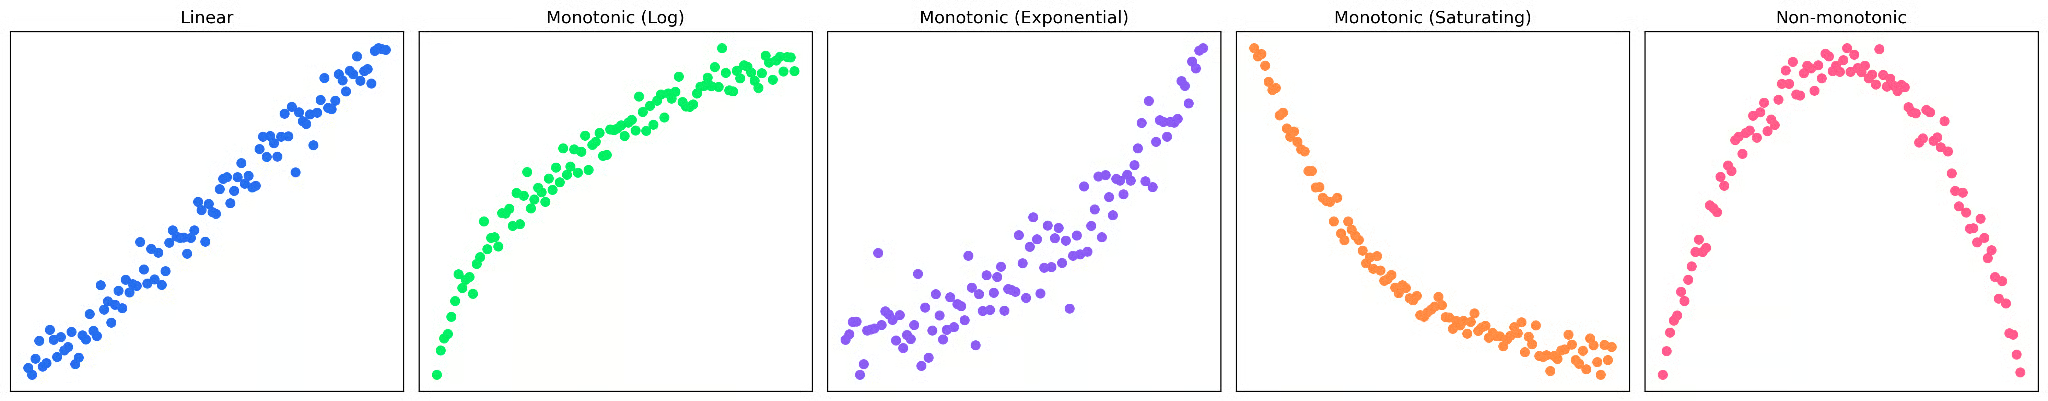
Na powyższych wykresach widać cztery różne przykłady relacji monotonicznych, z których tylko pierwsza jest liniowa. Ostatni wykres nie jest monotoniczny, ponieważ wzorzec zmienia kierunek — zaczyna się jako dodatnia zależność, a kończy jako ujemna.
|
Typ relacji |
Opis |
Jak wygląda |
|
Liniowa |
Zmienne rosną lub maleją w stałym tempie |
Linia prosta |
|
Monotoniczna (ale nieliniowa) |
Zmienne poruszają się w jednym kierunku, ale tempo się zmienia |
Trend zakrzywiony, wypłaszczający się lub przyspieszający |
|
Niemonotoniczna |
Relacja zmienia kierunek (najpierw rośnie, potem maleje, lub odwrotnie) |
Kształt U, odwrócone U lub falujący wzór |
Jak krok po kroku obliczyć korelację rang Spearmana
W skrócie, współczynnik Spearmana działa tak, że przekształca dane w rangi, a następnie mierzy, jak podobne są rankingi między zmiennymi.
Przejdźmy przez mały przykład. Załóżmy, że analizujemy zależność między liczbą godzin poświęconych na ćwiczenie gry na instrumencie a miejscem w rankingu w konkursie.
|
Uczeń |
Godziny ćwiczeń (X) |
Wynik występu (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Najpierw narysujmy wykres danych.
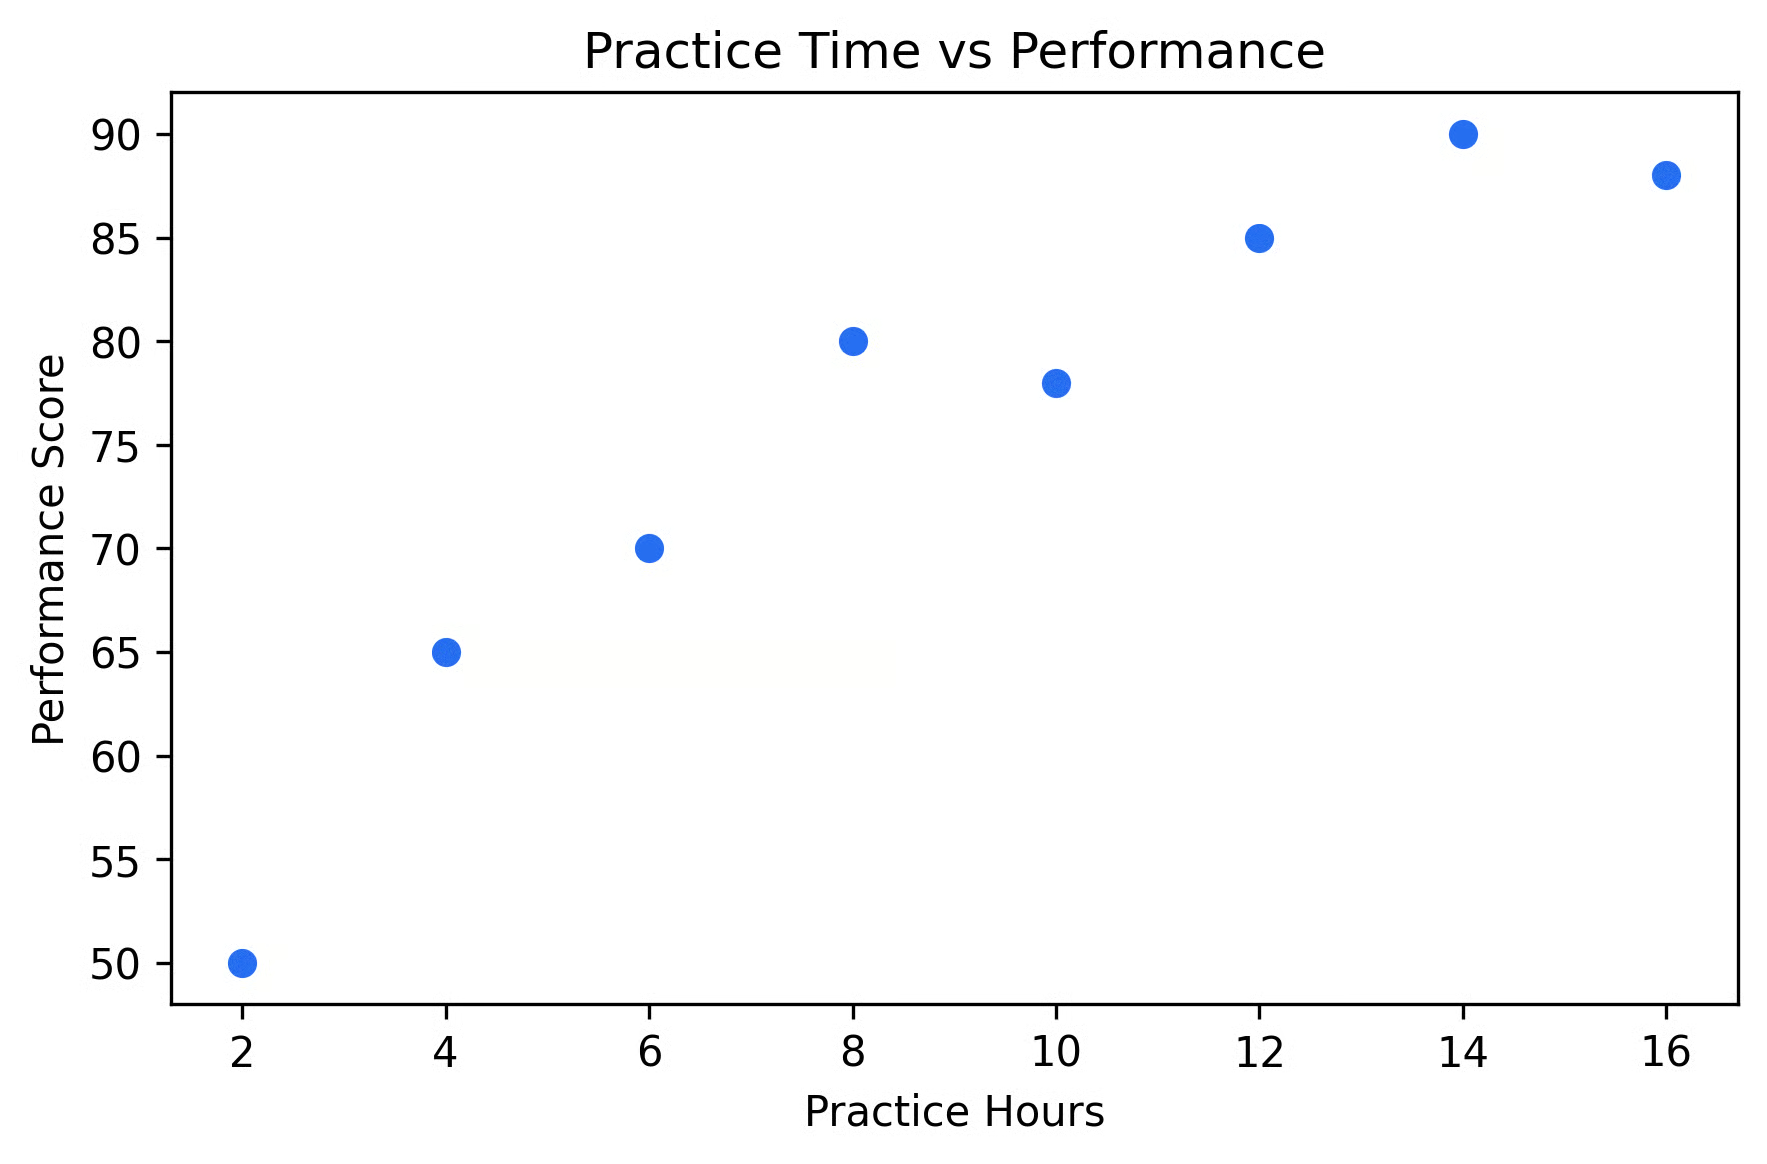
Wizualnie wygląda na to, że więcej ćwiczeń przekłada się na wyższe wyniki, ale wzorzec nie jest idealnie liniowy. Wygląda na to, że zbyt intensywne ćwiczenie może przynosić malejące korzyści. Spróbujmy zastosować rangi Spearmana, aby to zquantyfikować.
Krok 1: przekształć dane na rangi
Najpierw przypiszmy każdej wartości rangę. W obrębie każdej zmiennej przypisujemy rangi od najmniejszej do największej. Najmniejsza wartość w zmiennej otrzymuje rangę 1, druga najmniejsza rangę 2 i tak dalej.
|
Uczeń |
Godziny ćwiczeń (X) |
Ranga (X) |
Wynik występu (Y) |
Ranga (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Zauważ, że rankingi dla Y są w nieco innej kolejności niż dla X. Właśnie tę zmienność mierzy korelacja Spearmana.
Krok 2: oblicz różnice rang
Następnie obliczamy różnicę między rangami dla każdej obserwacji.
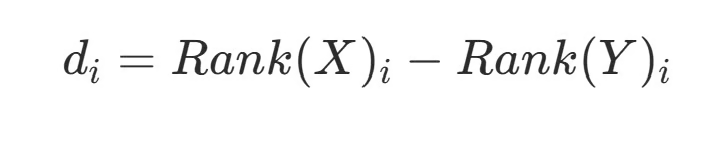
Następnie podnieś każdą różnicę do kwadratu:
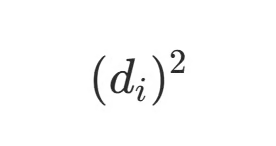
|
Uczeń |
Ranga(X) |
Ranga(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Teraz zsumuj kwadraty różnic w ostatniej kolumnie tabeli.
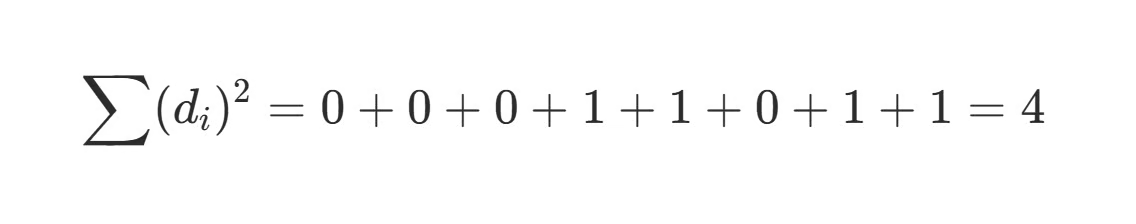
Krok 3: zastosuj wzór
Na koniec podstawiamy wartości do wzoru na korelację Spearmana.
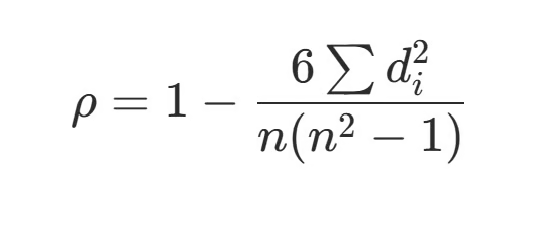
Wcześniej obliczyliśmy, że (di)2=4. n w mianowniku to liczebność próby, u nas 8. Podstawiając, otrzymujemy:
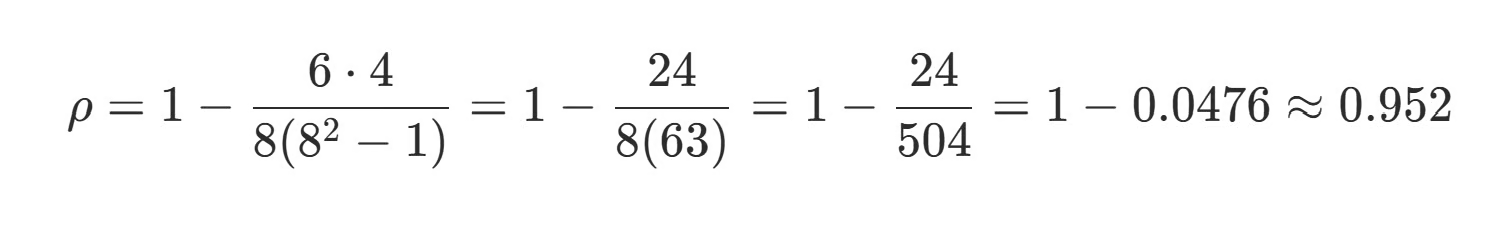
Interpretacja wyniku
Ostateczny wynik to ρ ~ 0,95. Ponieważ wartość jest bliska +1, wskazuje na silną dodatnią zależność między czasem ćwiczeń a wynikiem. Mimo że relacja nie jest idealnie liniowa, rankingi są bardzo podobne. Oznacza to, że gdy zmienia się wartość x, wartość y ma tendencję do spójnej zmiany wraz z nią.
W praktyce rzadko liczy się to ręcznie. Większość oprogramowania automatycznie obsługuje rangowanie, remisy i obliczenia — i dobrze, bo zwykle mamy znacznie większe próby!
Obliczanie korelacji Spearmana w oprogramowaniu
Większość współczesnych narzędzi statystycznych poradzi sobie z tym obliczeniem w kilka sekund. Krótko omówmy najpopularniejsze.
Python
W Pythonie zwykle użyjesz scipy albo pandas, w zależności od sposobu pracy. Jeśli pracujesz na tablicach lub listach, scipy oferuje bezpośredni sposób obliczenia korelacji Spearmana.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Zwraca to zarówno współczynnik korelacji, jak i p-value, co przydaje się przy testowaniu statystycznym.
Jeśli pracujesz z danymi tabelarycznymi, pandas bywa wygodniejsze.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
To oblicza macierz korelacji, ułatwiając porównanie wielu zmiennych naraz.
Alternatywnie, jeśli chcesz korelację tylko między dwiema konkretnymi kolumnami, łatwo to wskazać.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
W R korelacja Spearmana jest wbudowana w podstawowe funkcje statystyczne.
Do szybkiego obliczenia możesz użyć cor() i wskazać metodę Spearmana.
cor(x, y, method = "spearman")Jeśli chcesz również p-value i dodatkowe szczegóły statystyczne, cor.test() dostarcza je w prosty sposób.
cor.test(x,y,method="spearman")Excel
Excel nie ma wbudowanej funkcji Spearmana, ale możesz to policzyć w dwóch szybkich krokach: najpierw nadaj danym rangi, potem policz korelację tych rang.
Oto mały przykład:
|
A (X) |
B (Y) |
C (ranga X) |
D (ranga Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Rangi (kolumny C i D) możesz utworzyć funkcją RANK.AVG. Przykładowo:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Następnie po prostu oblicz korelację Spearmana.
=CORREL(C2:C6, D2:D6)We wszystkich tych narzędziach proces jest ten sam: przekształć wartości w rangi, a potem policz korelację tych rang.
Jak interpretować korelację rang Spearmana
Jeśli używałeś wcześniej korelacji Pearsona, masz już dobrą intuicję, jak interpretować korelację rang Spearmana — interpretacja jest w zasadzie taka sama.
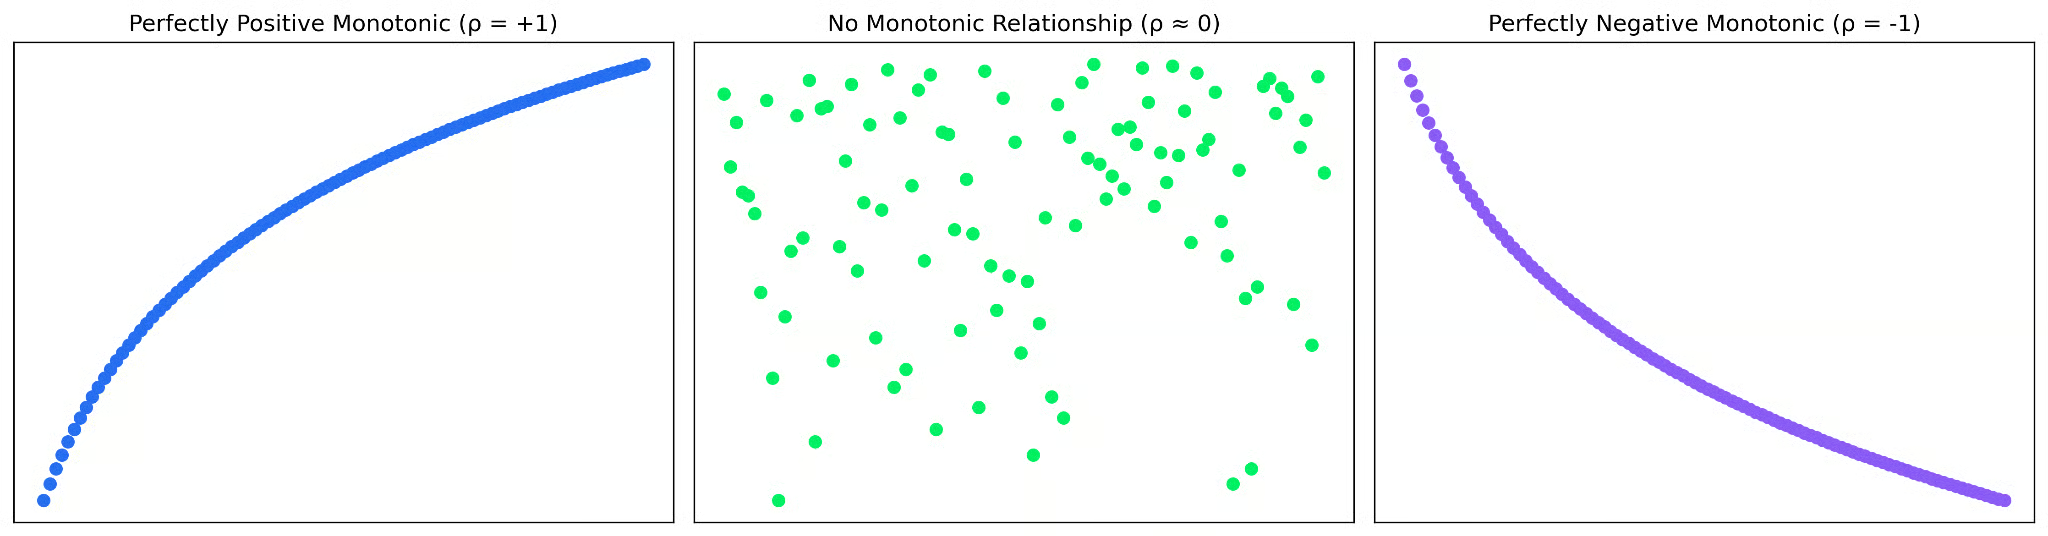
Spearman zwraca wartość między -1 a 1. Informuje ona zarówno o kierunku, jak i sile relacji monotonicznej.
Wartość +1 oznacza idealnie rosnącą relację monotoniczną: gdy jedna zmienna rośnie, druga zawsze rośnie. Dzieje się tak, gdy rankingi każdej pary wartości są dokładnie takie same.
Wartość -1 oznacza idealnie malejącą relację monotoniczną: gdy jedna zmienna rośnie, druga zawsze maleje. Dzieje się tak, gdy rankingi każdej pary wartości są dokładnie odwrócone.
Wartość 0 oznacza brak relacji monotonicznej. Dzieje się tak, gdy w rankingach nie ma spójnego trendu.
Ważna różnica względem współczynnika Pearsona jest taka, że korelacja Spearmana odzwierciedla zgodność kolejności danych, a nie to, jak ściśle wartości podążają za linią prostą. Oznacza to, że silna korelacja Spearmana wskazuje wyraźny trend w rankingach, a niekoniecznie relację liniową czy równomierne odstępy.
Dlatego zawsze warto zestawić wartość korelacji z szybką wizualizacją, by najlepiej zrozumieć leżący u podstaw wzorzec.
Obsługa remisów w rankingach
Wszystko brzmi dobrze, dopóki nie trafisz na zbiór danych, w którym wiele obserwacji ma tę samą wartość. Co wtedy? To tzw. remisy (ties) i wymagają drobnej korekty przy nadawaniu rang.
Na przykład, rozważ wartości: 10, 20, 20, 30. Dwie dwudziestki normalnie zajęłyby rangi 2 i 3. Ponieważ jednak są takie same, zamiast przydzielać im różne rangi, przypisujemy każdej średnią tych rang; obie 20 otrzymują rangę 2,5. Dzięki temu rozwiązaniu wartości remisowe są traktowane sprawiedliwie, a ogólny ranking pozostaje spójny.
Ponieważ współczynnik Spearmana opiera się w całości na rangach, nieprawidłowa obsługa remisów może zniekształcić korelację.
Ograniczenia korelacji Spearmana
Choć współczynnik rang Spearmana jest elastyczną i szeroko stosowaną miarą, ma pewne ograniczenia.
Przede wszystkim, potrafi uchwycić tylko relacje monotoniczne. Jeśli związek zmienia kierunek, np. ma kształt U lub przebiega jak sinusoida, korelacja może być bliska zeru, mimo że istnieje wyraźny wzorzec. W takich przypadkach lepiej sprawdzą się modele nieliniowe, np. regresja wielomianowa.
Poza tym, ponieważ korelacja Spearmana opiera się na rangach, ignoruje rzeczywiste odległości między wartościami. Dzięki temu lepiej radzi sobie z wartościami odstającymi, ale też oznacza utratę części informacji. Przez to trudniej interpretować wielkość efektu niż w korelacji Pearsona. Mówi, czy zmienne podążają razem w tej samej kolejności, ale nie o tym, jak bardzo jedna zmienia się względem drugiej.
Wreszcie, gdy wiele wartości jest remisowych, proces rangowania staje się mniej precyzyjny. Może to skutkować słabszą wartością korelacji, potencjalnie niedoszacowującą siłę relacji.
Spearman vs Pearson: kiedy której użyć
Najczęściej używanym współczynnikiem korelacji jest prawdopodobnie współczynnik Pearsona. Na pierwszy rzut oka wydaje się bardzo podobny do korelacji Spearmana. Nawet nazwy mają niemal identyczne! Jednak odpowiadają na nieco inne pytania.
Pearson pyta: „Czy te zmienne podążają zależnością liniową?”, a Spearman: „Czy te zmienne poruszają się w tej samej kolejności?”
Jeśli twoje dane układają się mniej więcej po linii prostej, a odległości między wartościami mają znaczenie, zwykle wybierz korelację Pearsona. Jeśli jednak relacja się zakrzywia lub wypłaszcza, lepszym wyborem będzie Spearman.
Spearman jest też bardziej wyrozumiały. Ponieważ działa na rangach zamiast na wartościach surowych, jest mniej wrażliwy na wartości odstające i w mniejszym stopniu opiera się na założeniach o danych. Ceną jest to, że gorzej wychwytuje różnice w wielkości między wartościami.
W praktyce dobra zasada jest taka: jeśli relacja jest liniowa — użyj Pearsona; jeśli jest monotoniczna, ale nieliniowa — użyj Spearmana. I jak zawsze, zanim zdecydujesz, narysuj dane.
Podsumowanie
Współczynnik korelacji Spearmana to świetne narzędzie do uchwycenia wzorców monotonicznych, zwłaszcza w zbiorach danych, które nie są dobrze obsługiwane przez korelację Pearsona. Dzięki pracy na rangach jest mniej wrażliwy na wartości odstające i lepiej radzi sobie z danymi nieliniowymi.
Więcej o wyborze najlepszej korelacji dla twojego zbioru danych przeczytasz w Understanding Correlation: Measuring Relationships in Data. Może cię też zainteresować Understanding Covariance: An Introductory Guide.