ไม่ใช่ทุกความสัมพันธ์จะเป็นเส้นตรง
อาจเห็นได้ว่าเมื่อเพิ่มงบการตลาด การเปลี่ยนลูกค้าเป็นผู้ซื้อก็มักจะดีขึ้น แต่ไม่ได้เพิ่มขึ้นในอัตราคงที่ หรืออาจเป็นว่าความสุขเพิ่มขึ้นตามรายได้ แล้วค่อย ๆ ทรงตัว รูปแบบเห็นได้ชัด แต่ไม่ใช่เชิงเส้น แล้วจะวัดปริมาณสิ่งนี้อย่างไรได้บ้าง?
สหสัมพันธ์ใช้เพื่อบรรยายว่าตัวแปรสองตัวเคลื่อนไปด้วยกันอย่างไร สหสัมพันธ์ที่พบได้บ่อยคือ ค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สัน ซึ่งทำงานได้ดีมากกับความสัมพันธ์เชิงเส้น อย่างไรก็ตาม ความสัมพันธ์ในโลกแห่งความจริงจำนวนมากไม่ใช่เชิงเส้น อาจโค้ง ทรงตัว หรือเป็นแนวโน้มที่สม่ำเสมอโดยไม่เป็นเส้นตรง ในบางกรณี ค่าที่แน่นอนไม่สำคัญเท่าลำดับที่เกิดขึ้น ตรงนี้เองที่ค่าสัมประสิทธิ์สหสัมพันธ์อันดับของสเปียร์แมนเข้ามามีบทบาท
สหสัมพันธ์ของสเปียร์แมนทำงานกับ "อันดับ" แทนค่าดิบ โดยวัดว่าตัวแปรสองตัวมีแนวโน้มจะเพิ่มหรือลดไปด้วยกันอย่างสม่ำเสมอเพียงใด จึงเหมาะอย่างยิ่งกับความสัมพันธ์แบบโมโนโทนิก และยังทนทานต่อความผิดปกติของข้อมูลบางอย่าง เช่น ค่าผิดปกติหรือช่วงห่างที่ไม่สม่ำเสมอ
สหสัมพันธ์อันดับของสเปียร์แมนคืออะไร?
ค่าสัมประสิทธิ์สหสัมพันธ์อันดับของสเปียร์แมนเป็นการวัดความแรงและทิศทางของความสัมพันธ์ระหว่างตัวแปรสองตัว โดยอิงจากอันดับของค่า แทนที่จะใช้ค่าจริง
เพื่อให้เห็นภาพ ลองนึกถึงการวิเคราะห์เพลงบนแพลตฟอร์มสตรีมมิง อาจเปรียบเทียบจำนวนครั้งที่เพลงถูกเล่นกับอันดับบนชาร์ต “Top 100” ความสัมพันธ์อาจไม่เชิงเส้นสมบูรณ์ การเพิ่มจำนวนสตรีมเป็นสองเท่าไม่ได้ทำให้อันดับเพลงดีขึ้นเป็นสองเท่าเสมอไป แต่โดยทั่วไป เพลงที่มียอดสตรีมมากกว่ามักได้อันดับสูงกว่า
สหสัมพันธ์ของสเปียร์แมนจับรูปแบบลักษณะนี้ได้ด้วยการโฟกัสที่ลำดับของข้อมูล มากกว่าค่าที่แน่นอน
จึงมีประโยชน์อย่างยิ่งเมื่อความสัมพันธ์ไม่เชิงเส้นแต่ยังคงมีแนวโน้มชัดเจน ข้อมูลถูกแสดงออกตามธรรมชาติเป็นการจัดอันดับ หรือข้อมูลมีค่าผิดปกติที่อาจบิดเบือนการวัดเชิงเส้น
ต่างจากสหสัมพันธ์ของเพียร์สันที่ทำงานกับค่าดิบโดยตรง สหสัมพันธ์ของสเปียร์แมนจะแปลงข้อมูลเป็นอันดับก่อน แล้วจึงวัดว่าการจัดอันดับของสองตัวแปรสอดคล้องกันเพียงใด
ในทางเทคนิค สหสัมพันธ์ของสเปียร์แมนวัดความสัมพันธ์แบบโมโนโทนิก ความสัมพันธ์ถือว่าเป็นโมโนโทนิก หากตัวแปรหนึ่งมีแนวโน้มเพิ่มขึ้นเมื่อตัวแปรอีกตัวเพิ่มขึ้น หรือมีแนวโน้มลดลงเมื่อตัวแปรอีกตัวลดลง โดยไม่เปลี่ยนทิศทาง
ความสัมพันธ์แบบโมโนโทนิก vs. ความสัมพันธ์เชิงเส้น
แล้วความแตกต่างระหว่างความสัมพันธ์เชิงเส้นกับโมโนโทนิกคืออะไรแน่?
ความสัมพันธ์เชิงเส้นคือกรณีที่ข้อมูลเป็นรูปแบบเส้นตรง หากพล็อตข้อมูล จะเห็นจุดเรียงตัวคล้ายเส้นตรง
ส่วนความสัมพันธ์แบบโมโนโทนิกนั้นเข้มงวดน้อยกว่า เพียงหมายความว่าความสัมพันธ์เคลื่อนไปในทิศทางเดียว กล่าวคือ ทั้งสองตัวแปรเคลื่อนไปด้วยกัน แต่ไม่จำเป็นต้องเป็นเส้นตรง รูปแบบอาจโค้ง ทรงตัว หรือเปลี่ยนอัตรา ตราบใดที่ไม่กลับทิศ
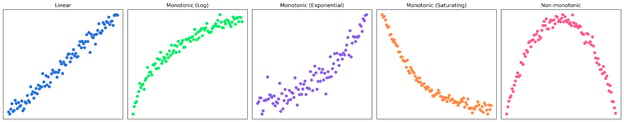
จากกราฟด้านบน จะเห็นตัวอย่างความสัมพันธ์แบบโมโนโทนิก 4 แบบ โดยมีเพียงแบบแรกเท่านั้นที่เป็นเชิงเส้น กราฟสุดท้ายไม่ใช่โมโนโทนิก เนื่องจากรูปแบบเปลี่ยนทิศ จากการเชื่อมโยงเชิงบวกไปสู่เชิงลบ
|
ประเภทความสัมพันธ์
|
คำอธิบาย
|
ลักษณะที่เห็น
|
|
เชิงเส้น
|
ตัวแปรเพิ่มหรือลดด้วยอัตราคงที่
|
เส้นตรง
|
|
โมโนโทนิก
(แต่ไม่เชิงเส้น)
|
ตัวแปรเคลื่อนไปในทิศทางเดียวกัน แต่อัตราการเปลี่ยนแปลงไม่คงที่
|
แนวโน้มโค้ง ทรงตัว หรือเร่งขึ้น
|
|
ไม่ใช่โมโนโทนิก
|
ความสัมพันธ์เปลี่ยนทิศ (เพิ่มแล้วลด หรือกลับกัน)
|
รูปตัว U, ตัว U กลับหัว หรือรูปคลื่น
|
วิธีหาสหสัมพันธ์อันดับของสเปียร์แมนแบบทีละขั้น
ในระดับสูง สหสัมพันธ์อันดับของสเปียร์แมนทำงานโดยแปลงข้อมูลเป็นอันดับ แล้ววัดว่าการจัดอันดับระหว่างตัวแปรคล้ายกันเพียงใด
มาลองดูตัวอย่างเล็ก ๆ สมมติว่ากำลังดูความสัมพันธ์ระหว่างชั่วโมงที่ใช้ฝึกเครื่องดนตรีกับอันดับผลการแสดงในการแข่งขัน
|
นักเรียน
|
ชั่วโมงฝึก (X)
|
คะแนนการแสดง (Y)
|
|
Aladdin
|
2
|
50
|
|
Bonnie
|
4
|
65
|
|
Clyde
|
6
|
70
|
|
Daniel
|
8
|
80
|
|
Eloise
|
10
|
78
|
|
Franny
|
12
|
85
|
|
Gemma
|
14
|
90
|
|
Harris
|
16
|
88
|
ก่อนอื่น มาลองพล็อตข้อมูล
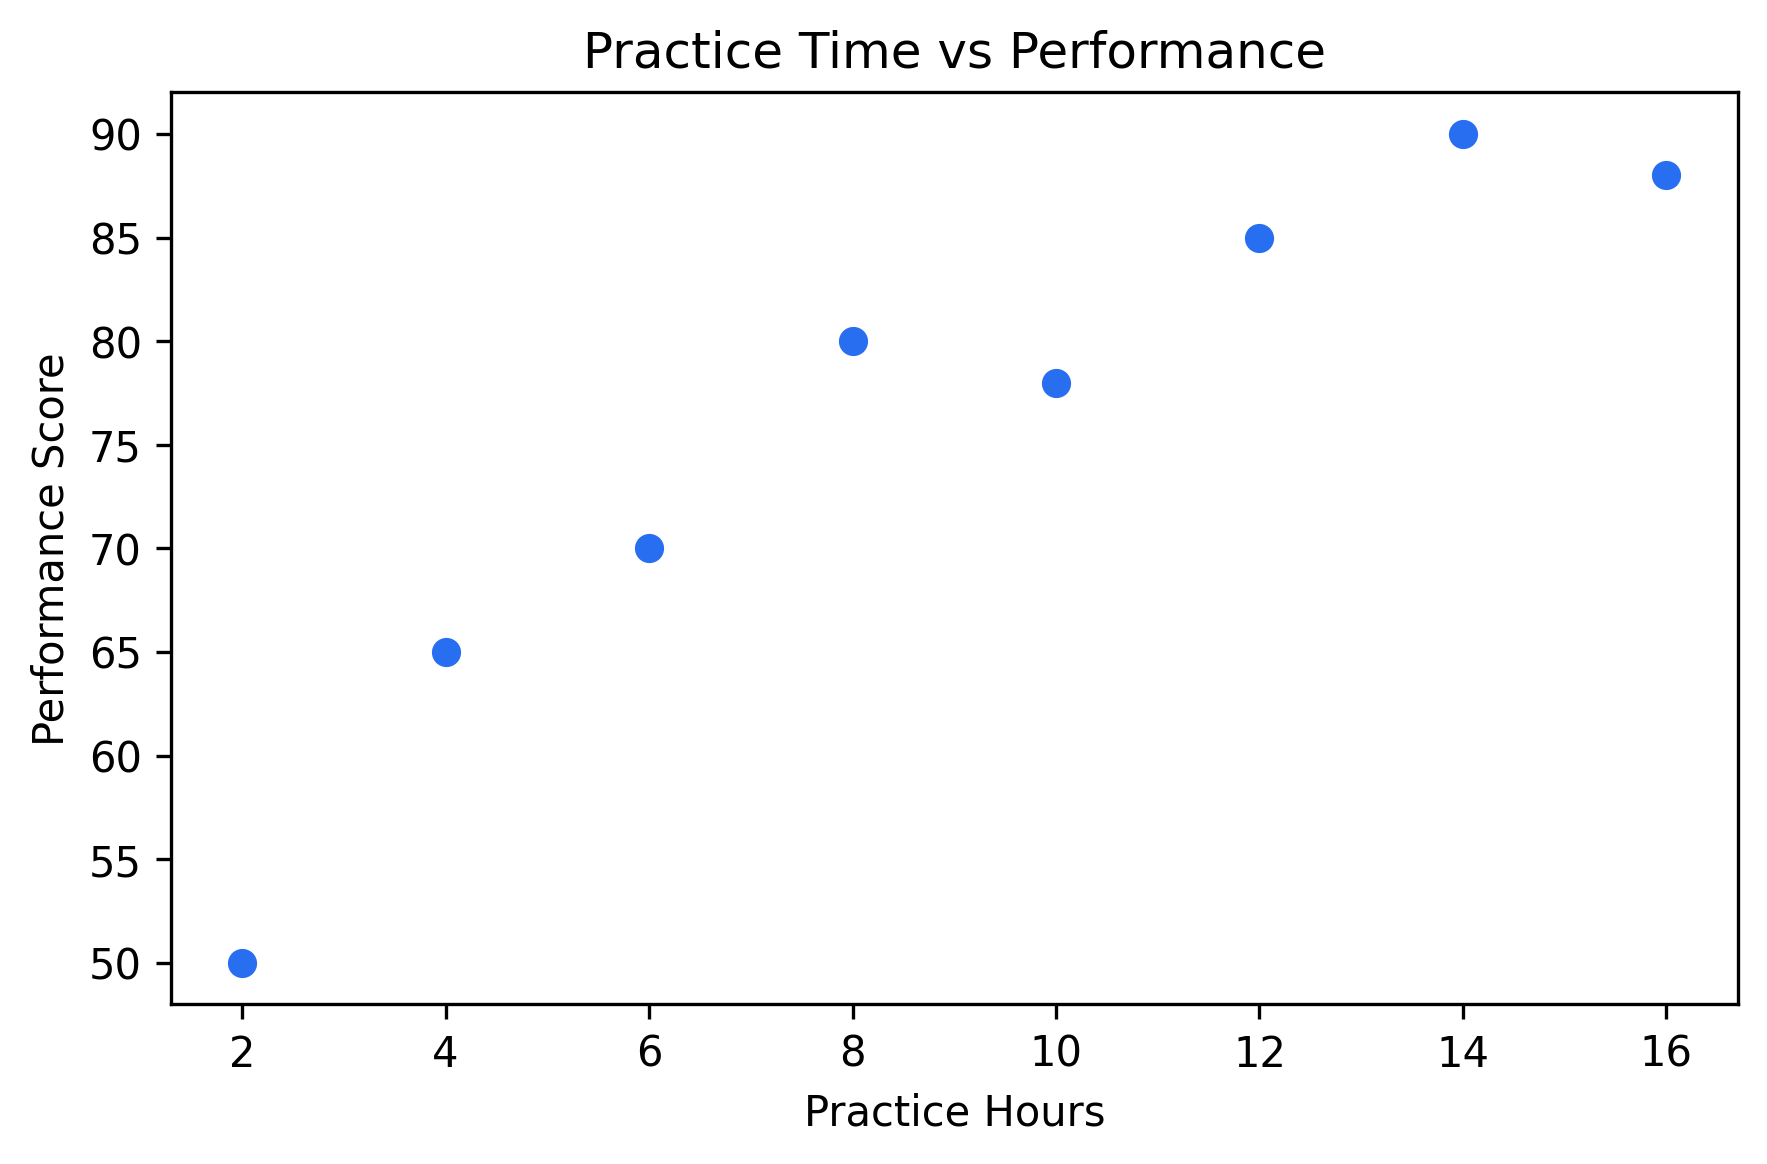
จากภาพ ดูเหมือนว่าการฝึกมากขึ้นนำไปสู่คะแนนการแสดงที่สูงขึ้น แต่รูปแบบไม่เชิงเส้นสมบูรณ์ เหมือนมีผลตอบแทนที่ลดลงเมื่อฝึกมากเกินไป ลองใช้สหอันดับของสเปียร์แมนเพื่อวัดความสัมพันธ์นี้
ขั้นที่ 1: แปลงข้อมูลเป็นอันดับ
ก่อนอื่น กำหนดอันดับให้แต่ละค่า ภายในแต่ละตัวแปร ให้จัดอันดับค่าจากน้อยไปมาก ค่าที่น้อยที่สุดได้อันดับ 1 ค่าที่น้อยเป็นอันดับสองได้อันดับ 2 และต่อเนื่องไป
|
นักเรียน
|
ชั่วโมงฝึก (X)
|
อันดับ (X)
|
คะแนนการแสดง (Y)
|
อันดับ (Y)
|
|
Aladdin
|
2
|
1
|
50
|
1
|
|
Bonnie
|
4
|
2
|
65
|
2
|
|
Clyde
|
6
|
3
|
70
|
3
|
|
Daniel
|
8
|
4
|
80
|
5
|
|
Eloise
|
10
|
5
|
78
|
4
|
|
Franny
|
12
|
6
|
85
|
6
|
|
Gemma
|
14
|
7
|
90
|
8
|
|
Harris
|
16
|
8
|
88
|
7
|
สังเกตว่าอันดับของ Y มีลำดับต่างจาก X เล็กน้อย ความแตกต่างนี้เองที่สหสัมพันธ์ของสเปียร์แมนจะวัด
ขั้นที่ 2: คำนวณส่วนต่างของอันดับ
ต่อไป คำนวณส่วนต่างระหว่างอันดับของแต่ละคู่สังเกต
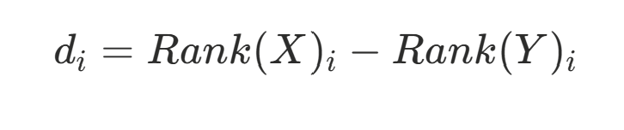
จากนั้นยกกำลังสองของแต่ละส่วนต่าง
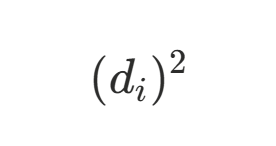
|
นักเรียน
|
อันดับ(X)
|
อันดับ(Y)
|
di
|
(di)2
|
|
A
|
1
|
1
|
0
|
0
|
|
B
|
2
|
2
|
0
|
0
|
|
C
|
3
|
3
|
0
|
0
|
|
D
|
4
|
5
|
-1
|
1
|
|
E
|
5
|
4
|
1
|
1
|
|
F
|
6
|
6
|
0
|
0
|
|
G
|
7
|
8
|
-1
|
1
|
|
H
|
8
|
7
|
1
|
1
|
ตอนนี้ให้นำผลรวมของค่ากำลังสองในคอลัมน์สุดท้ายในตารางของเรา
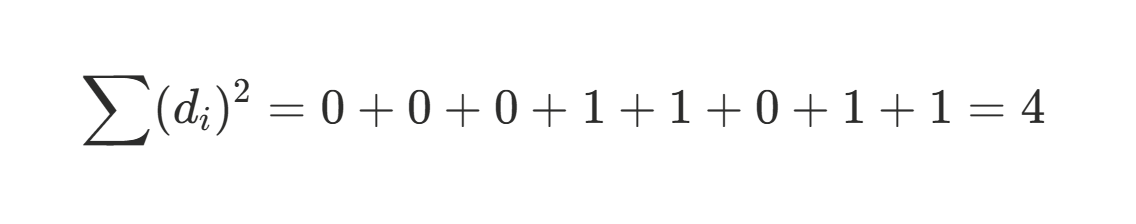
ขั้นที่ 3: ใส่ค่าในสูตร
สุดท้าย ใส่ค่าลงในสูตรสหสัมพันธ์ของสเปียร์แมน
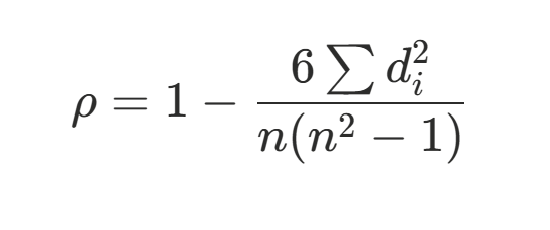
เราทราบแล้วว่า (di)2=4 จากการคำนวณก่อนหน้า ค่า n ในตัวส่วนคือขนาดตัวอย่าง ซึ่งสำหรับเราคือ 8 เมื่อนำไปแทนค่า จะได้ว่า
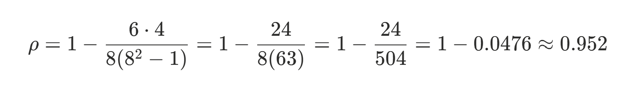
การตีความผลลัพธ์
ผลลัพธ์สุดท้ายคือ ρ ~ 0.95 เนื่องจากค่านี้เข้าใกล้ +1 จึงบ่งชี้ถึงความสัมพันธ์เชิงบวกที่แข็งแรงระหว่างเวลาในการฝึกกับผลการแสดง แม้ว่าความสัมพันธ์จะไม่เชิงเส้นสมบูรณ์ แต่อันดับมีความคล้ายคลึงกันมาก นั่นหมายความว่าเมื่อค่า x เปลี่ยน ค่า y ก็มีแนวโน้มจะเปลี่ยนตามอย่างสม่ำเสมอ
ในสถานการณ์จริง แทบไม่ค่อยคำนวณด้วยมือ ซอฟต์แวร์ส่วนใหญ่จัดการทั้งการจัดอันดับ กรณีเสมอภาค และการคำนวณให้อัตโนมัติ ซึ่งเป็นเรื่องดีเพราะโดยทั่วไปเรามีขนาดตัวอย่างใหญ่กว่านี้มาก
การคำนวณสหสัมพันธ์ของสเปียร์แมนด้วยซอฟต์แวร์
ซอฟต์แวร์สถิติส่วนใหญ่ในปัจจุบันคำนวณสิ่งนี้ได้ภายในไม่กี่วินาที มาดูตัวเลือกยอดนิยมกันอย่างคร่าว ๆ
Python
ใน Python โดยทั่วไปจะใช้ scipy หรือ pandas แล้วแต่เวิร์กโฟลว์ หากทำงานกับอาเรย์หรือรายการ scipy มีวิธีคำนวณสหสัมพันธ์ของสเปียร์แมนโดยตรง
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)ขับเคลื่อนโดย
คำสั่งนี้คืนทั้งค่าสัมประสิทธิ์สหสัมพันธ์และค่า p ซึ่งมีประโยชน์เมื่อทำการทดสอบทางสถิติ
หากทำงานกับข้อมูลเชิงตาราง pandas มักสะดวกกว่า
corr_matrix = df.corr(method="spearman")
print(corr_matrix)ขับเคลื่อนโดย
สิ่งนี้จะคำนวณเมทริกซ์สหสัมพันธ์ ทำให้เปรียบเทียบตัวแปรหลายตัวพร้อมกันได้ง่าย
หรือหากต้องการเฉพาะสหสัมพันธ์ระหว่างสองคอลัมน์ ก็สามารถระบุได้โดยตรง
corr=df["column_1"].corr(df["column_2"],method="spearman")ขับเคลื่อนโดย
R
ใน R สหสัมพันธ์ของสเปียร์แมนถูกรวมอยู่ในฟังก์ชันสถิติหลักแล้ว
หากต้องการคำนวณอย่างรวดเร็ว สามารถใช้ cor() และกำหนดให้ใช้วิธีของสเปียร์แมน
cor(x, y, method = "spearman")ขับเคลื่อนโดย
หากต้องการค่า p และรายละเอียดทางสถิติเพิ่มเติม cor.test() ก็ให้ข้อมูลนี้ได้ง่าย
cor.test(x,y,method="spearman")ขับเคลื่อนโดย
Excel
Excel ไม่มีฟังก์ชันสเปียร์แมนแบบสำเร็จรูป แต่สามารถคำนวณได้สองขั้นตอนง่าย ๆ คือ จัดอันดับข้อมูลก่อน แล้วจึงหาสหสัมพันธ์ของอันดับเหล่านั้น
ตัวอย่างเล็ก ๆ ดังต่อไปนี้
|
A (X)
|
B (Y)
|
C (Rank X)
|
D (Rank Y)
|
|
2
|
50
|
1
|
1
|
|
4
|
65
|
2
|
2
|
|
6
|
70
|
3
|
3
|
|
8
|
80
|
5
|
5
|
|
10
|
78
|
4
|
4
|
สามารถสร้างอันดับ (คอลัมน์ C และ D) ด้วยฟังก์ชัน RANK.AVG เช่น
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)ขับเคลื่อนโดย
จากนั้นคำนวณสหสัมพันธ์ของสเปียร์แมนได้เลย
=CORREL(C2:C6, D2:D6)ขับเคลื่อนโดย
ไม่ว่าบนเครื่องมือใด กระบวนการพื้นฐานเหมือนกัน คือแปลงค่าเป็นอันดับ แล้วคำนวณสหสัมพันธ์ของอันดับเหล่านั้น
วิธีตีความสหสัมพันธ์อันดับของสเปียร์แมน
หากเคยใช้สหสัมพันธ์ของเพียร์สันมาก่อน ก็น่าจะมีสัญชาตญาณที่ดีในการตีความสหสัมพันธ์อันดับของสเปียร์แมน เพราะการตีความแทบจะเหมือนกัน
สหอันดับของสเปียร์แมนให้ค่าระหว่าง -1 ถึง 1 ซึ่งบอกทั้งทิศทางและความแรงของความสัมพันธ์แบบโมโนโทนิก
ค่า +1 บ่งชี้ความสัมพันธ์แบบโมโนโทนิกที่เพิ่มขึ้นอย่างสมบูรณ์ กล่าวคือเมื่อตัวแปรหนึ่งเพิ่ม อีกตัวก็เพิ่มเสมอ กรณีนี้เกิดเมื่ออันดับของแต่ละคู่ค่าเหมือนกันทุกประการ
ค่า -1 บ่งชี้ความสัมพันธ์แบบโมโนโทนิกที่ลดลงอย่างสมบูรณ์ กล่าวคือเมื่อตัวแปรหนึ่งเพิ่ม อีกตัวจะลดเสมอ กรณีนี้เกิดเมื่ออันดับของแต่ละคู่ค่ากลับกันพอดี
ค่า 0 บ่งชี้ว่าไม่มีความสัมพันธ์แบบโมโนโทนิก เกิดขึ้นเมื่อไม่มีแนวโน้มที่สม่ำเสมอในอันดับ
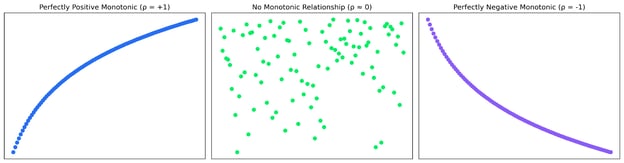
ประเด็นที่ต่างจากค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สันอย่างสำคัญคือ สหสัมพันธ์ของสเปียร์แมนสะท้อนว่าลำดับของข้อมูลสอดคล้องกันดีเพียงใด ไม่ใช่ว่าค่าจริงเกาะตามเส้นตรงได้ใกล้เพียงใด นั่นหมายความว่าค่าสเปียร์แมนที่สูงบ่งชี้แนวโน้มที่ชัดเจนในอันดับ ไม่จำเป็นต้องแปลว่าความสัมพันธ์เชิงเส้นหรือระยะห่างสม่ำเสมอ
เพราะเหตุนี้ การจับคู่ค่าความสัมพันธ์กับการมองภาพอย่างรวดเร็วจึงเป็นความคิดที่ดีเสมอ เพื่อเข้าใจรูปแบบพื้นฐานให้ดีที่สุด
การจัดการกรณีเสมอภาคของอันดับ
ทุกอย่างดูราบรื่น จนกระทั่งเจอชุดข้อมูลที่หลายรายการมีค่าเท่ากัน แล้วทำอย่างไรดี? นี่เรียกว่า ties หรือกรณีเสมอภาค ซึ่งต้องปรับเล็กน้อยตอนกำหนดอันดับ
เช่น ค่าชุด 10, 20, 20, 30 ค่าสองตัวที่เป็น 20 ปกติจะได้อันดับ 2 และ 3 แต่เนื่องจากค่าเท่ากัน แทนที่จะให้อันดับต่างกัน ให้ใช้อันดับเฉลี่ยของตำแหน่งนั้นแทน จึงให้อันดับ 2.5 กับทั้งสองค่า วิธีนี้ทำให้ค่าที่เสมอกันได้รับการปฏิบัติอย่างยุติธรรมและทำให้การจัดอันดับโดยรวมสอดคล้อง
เนื่องจากสหสัมพันธ์อันดับของสเปียร์แมนอิงกับอันดับล้วน ๆ หากจัดการกรณีเสมอภาคไม่ถูกต้อง ค่าสหสัมพันธ์อาจบิดเบือนได้
ข้อจำกัดของสหสัมพันธ์ของสเปียร์แมน
แม้ค่าสหสัมพันธ์อันดับของสเปียร์แมนจะยืดหยุ่นและนิยมใช้แพร่หลาย แต่ก็มีข้อจำกัด
ที่สำคัญที่สุด คือจับได้เฉพาะความสัมพันธ์แบบโมโนโทนิก หากความสัมพันธ์เปลี่ยนทิศ เช่น รูปตัวยูหรือคลื่นไซน์ ค่าสหสัมพันธ์อาจเข้าใกล้ศูนย์ แม้จะมีรูปแบบชัดเจนก็ตาม ในกรณีนี้ การใช้แบบจำลองไม่เชิงเส้น เช่น รีเกรสชันพหุนาม จะเหมาะกว่า
นอกจากนี้ เนื่องจากสหสัมพันธ์ของสเปียร์แมนอิงกับอันดับ จึงไม่สนใจระยะห่างที่แท้จริงระหว่างค่า ทำให้รับมือค่าผิดปกติได้ดีกว่า แต่ก็ทำให้ข้อมูลบางส่วนสูญหาย ความแรงเชิงขนาดของความสัมพันธ์ตีความได้ยากกว่าสำหรับสเปียร์แมนเมื่อเทียบกับเพียร์สัน เพราะมันบอกเพียงว่าตัวแปรเคลื่อนไปด้วยกันตามลำดับหรือไม่ ไม่ได้บอกว่าค่าหนึ่งเปลี่ยนไปมากน้อยเพียงใดเมื่ออีกค่าหนึ่งเปลี่ยน
สุดท้าย เมื่อมีค่าที่เสมอภาคมาก การจัดอันดับจะมีความแม่นยำลดลง ซึ่งอาจทำให้ค่าสหสัมพันธ์อ่อนลงและอาจไม่สะท้อนความสัมพันธ์ได้เต็มที่
สเปียร์แมน vs. เพียร์สัน: ควรใช้เมื่อใด
สหสัมพันธ์ที่อาจใช้กันมากที่สุดคือค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สัน เมื่อมองผิวเผิน ดูคล้ายกับสหสัมพันธ์ของสเปียร์แมนมาก ชื่อก็ยังคล้ายกัน แต่จริง ๆ แล้วตอบคำถามต่างกันเล็กน้อย
เพียร์สันถามว่า “ตัวแปรเหล่านี้สัมพันธ์กันแบบเส้นตรงหรือไม่?” ส่วนสเปียร์แมนถามว่า “ตัวแปรเหล่านี้เคลื่อนไปในลำดับเดียวกันหรือไม่?”
หากข้อมูลมีรูปแบบค่อนข้างเป็นเส้นตรง และระยะห่างระหว่างค่ามีความหมาย สหสัมพันธ์ของเพียร์สันมักเป็นตัวเลือกที่เหมาะสม แต่ถ้าความสัมพันธ์โค้งหรือทรงตัว สเปียร์แมนมักเหมาะกว่า
สเปียร์แมนยังหยวนกว่า เนื่องจากทำงานกับอันดับแทนค่าดิบ จึงไวต่อค่าผิดปกติได้น้อยกว่า และไม่พึ่งพาสมมติฐานเกี่ยวกับข้อมูลมากนัก แลกมากับการที่จับความแตกต่างด้านขนาดของค่าได้ไม่ดีเท่า
ในทางปฏิบัติ แนวทางจำง่ายคือ ถ้าความสัมพันธ์เป็นเชิงเส้น ใช้เพียร์สัน ถ้าเป็นโมโนโทนิกแต่ไม่เชิงเส้น ใช้สเปียร์แมน และเช่นเคย ควรพล็อตข้อมูลก่อนตัดสินใจ
สรุป
ค่าสัมประสิทธิ์สหสัมพันธ์ของสเปียร์แมนเป็นเครื่องมือที่ดีเยี่ยมสำหรับการจับรูปแบบแบบโมโนโทนิก โดยเฉพาะกับชุดข้อมูลที่สหสัมพันธ์ของเพียร์สันอาจไม่เหมาะนัก การทำงานด้วยอันดับทำให้ไวต่อค่าผิดปกติน้อยลง และรองรับข้อมูลที่ไม่เชิงเส้นได้มากกว่า
อ่านเพิ่มเติมเกี่ยวกับการเลือกสหสัมพันธ์ที่เหมาะกับชุดข้อมูลได้ที่ Understanding Correlation: Measuring Relationships in Data และอาจสนใจ Understanding Covariance: An Introductory Guide ด้วย


ไม่ใช่ทุกความสัมพันธ์จะเป็นเส้นตรง
อาจเห็นได้ว่าเมื่อเพิ่มงบการตลาด การเปลี่ยนลูกค้าเป็นผู้ซื้อก็มักจะดีขึ้น แต่ไม่ได้เพิ่มขึ้นในอัตราคงที่ หรืออาจเป็นว่าความสุขเพิ่มขึ้นตามรายได้ แล้วค่อย ๆ ทรงตัว รูปแบบเห็นได้ชัด แต่ไม่ใช่เชิงเส้น แล้วจะวัดปริมาณสิ่งนี้อย่างไรได้บ้าง?
สหสัมพันธ์ใช้เพื่อบรรยายว่าตัวแปรสองตัวเคลื่อนไปด้วยกันอย่างไร สหสัมพันธ์ที่พบได้บ่อยคือ ค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สัน ซึ่งทำงานได้ดีมากกับความสัมพันธ์เชิงเส้น อย่างไรก็ตาม ความสัมพันธ์ในโลกแห่งความจริงจำนวนมากไม่ใช่เชิงเส้น อาจโค้ง ทรงตัว หรือเป็นแนวโน้มที่สม่ำเสมอโดยไม่เป็นเส้นตรง ในบางกรณี ค่าที่แน่นอนไม่สำคัญเท่าลำดับที่เกิดขึ้น ตรงนี้เองที่ค่าสัมประสิทธิ์สหสัมพันธ์อันดับของสเปียร์แมนเข้ามามีบทบาท
สหสัมพันธ์ของสเปียร์แมนทำงานกับ "อันดับ" แทนค่าดิบ โดยวัดว่าตัวแปรสองตัวมีแนวโน้มจะเพิ่มหรือลดไปด้วยกันอย่างสม่ำเสมอเพียงใด จึงเหมาะอย่างยิ่งกับความสัมพันธ์แบบโมโนโทนิก และยังทนทานต่อความผิดปกติของข้อมูลบางอย่าง เช่น ค่าผิดปกติหรือช่วงห่างที่ไม่สม่ำเสมอ
สหสัมพันธ์อันดับของสเปียร์แมนคืออะไร?
ค่าสัมประสิทธิ์สหสัมพันธ์อันดับของสเปียร์แมนเป็นการวัดความแรงและทิศทางของความสัมพันธ์ระหว่างตัวแปรสองตัว โดยอิงจากอันดับของค่า แทนที่จะใช้ค่าจริง
เพื่อให้เห็นภาพ ลองนึกถึงการวิเคราะห์เพลงบนแพลตฟอร์มสตรีมมิง อาจเปรียบเทียบจำนวนครั้งที่เพลงถูกเล่นกับอันดับบนชาร์ต “Top 100” ความสัมพันธ์อาจไม่เชิงเส้นสมบูรณ์ การเพิ่มจำนวนสตรีมเป็นสองเท่าไม่ได้ทำให้อันดับเพลงดีขึ้นเป็นสองเท่าเสมอไป แต่โดยทั่วไป เพลงที่มียอดสตรีมมากกว่ามักได้อันดับสูงกว่า
สหสัมพันธ์ของสเปียร์แมนจับรูปแบบลักษณะนี้ได้ด้วยการโฟกัสที่ลำดับของข้อมูล มากกว่าค่าที่แน่นอน
จึงมีประโยชน์อย่างยิ่งเมื่อความสัมพันธ์ไม่เชิงเส้นแต่ยังคงมีแนวโน้มชัดเจน ข้อมูลถูกแสดงออกตามธรรมชาติเป็นการจัดอันดับ หรือข้อมูลมีค่าผิดปกติที่อาจบิดเบือนการวัดเชิงเส้น
ต่างจากสหสัมพันธ์ของเพียร์สันที่ทำงานกับค่าดิบโดยตรง สหสัมพันธ์ของสเปียร์แมนจะแปลงข้อมูลเป็นอันดับก่อน แล้วจึงวัดว่าการจัดอันดับของสองตัวแปรสอดคล้องกันเพียงใด
ในทางเทคนิค สหสัมพันธ์ของสเปียร์แมนวัดความสัมพันธ์แบบโมโนโทนิก ความสัมพันธ์ถือว่าเป็นโมโนโทนิก หากตัวแปรหนึ่งมีแนวโน้มเพิ่มขึ้นเมื่อตัวแปรอีกตัวเพิ่มขึ้น หรือมีแนวโน้มลดลงเมื่อตัวแปรอีกตัวลดลง โดยไม่เปลี่ยนทิศทาง
ความสัมพันธ์แบบโมโนโทนิก vs. ความสัมพันธ์เชิงเส้น
แล้วความแตกต่างระหว่างความสัมพันธ์เชิงเส้นกับโมโนโทนิกคืออะไรแน่?
ความสัมพันธ์เชิงเส้นคือกรณีที่ข้อมูลเป็นรูปแบบเส้นตรง หากพล็อตข้อมูล จะเห็นจุดเรียงตัวคล้ายเส้นตรง
ส่วนความสัมพันธ์แบบโมโนโทนิกนั้นเข้มงวดน้อยกว่า เพียงหมายความว่าความสัมพันธ์เคลื่อนไปในทิศทางเดียว กล่าวคือ ทั้งสองตัวแปรเคลื่อนไปด้วยกัน แต่ไม่จำเป็นต้องเป็นเส้นตรง รูปแบบอาจโค้ง ทรงตัว หรือเปลี่ยนอัตรา ตราบใดที่ไม่กลับทิศ
จากกราฟด้านบน จะเห็นตัวอย่างความสัมพันธ์แบบโมโนโทนิก 4 แบบ โดยมีเพียงแบบแรกเท่านั้นที่เป็นเชิงเส้น กราฟสุดท้ายไม่ใช่โมโนโทนิก เนื่องจากรูปแบบเปลี่ยนทิศ จากการเชื่อมโยงเชิงบวกไปสู่เชิงลบ
ประเภทความสัมพันธ์
คำอธิบาย
ลักษณะที่เห็น
เชิงเส้น
ตัวแปรเพิ่มหรือลดด้วยอัตราคงที่
เส้นตรง
โมโนโทนิก
(แต่ไม่เชิงเส้น)
ตัวแปรเคลื่อนไปในทิศทางเดียวกัน แต่อัตราการเปลี่ยนแปลงไม่คงที่
แนวโน้มโค้ง ทรงตัว หรือเร่งขึ้น
ไม่ใช่โมโนโทนิก
ความสัมพันธ์เปลี่ยนทิศ (เพิ่มแล้วลด หรือกลับกัน)
รูปตัว U, ตัว U กลับหัว หรือรูปคลื่น
วิธีหาสหสัมพันธ์อันดับของสเปียร์แมนแบบทีละขั้น
ในระดับสูง สหสัมพันธ์อันดับของสเปียร์แมนทำงานโดยแปลงข้อมูลเป็นอันดับ แล้ววัดว่าการจัดอันดับระหว่างตัวแปรคล้ายกันเพียงใด
มาลองดูตัวอย่างเล็ก ๆ สมมติว่ากำลังดูความสัมพันธ์ระหว่างชั่วโมงที่ใช้ฝึกเครื่องดนตรีกับอันดับผลการแสดงในการแข่งขัน
นักเรียน
ชั่วโมงฝึก (X)
คะแนนการแสดง (Y)
Aladdin
2
50
Bonnie
4
65
Clyde
6
70
Daniel
8
80
Eloise
10
78
Franny
12
85
Gemma
14
90
Harris
16
88
ก่อนอื่น มาลองพล็อตข้อมูล
จากภาพ ดูเหมือนว่าการฝึกมากขึ้นนำไปสู่คะแนนการแสดงที่สูงขึ้น แต่รูปแบบไม่เชิงเส้นสมบูรณ์ เหมือนมีผลตอบแทนที่ลดลงเมื่อฝึกมากเกินไป ลองใช้สหอันดับของสเปียร์แมนเพื่อวัดความสัมพันธ์นี้
ขั้นที่ 1: แปลงข้อมูลเป็นอันดับ
ก่อนอื่น กำหนดอันดับให้แต่ละค่า ภายในแต่ละตัวแปร ให้จัดอันดับค่าจากน้อยไปมาก ค่าที่น้อยที่สุดได้อันดับ 1 ค่าที่น้อยเป็นอันดับสองได้อันดับ 2 และต่อเนื่องไป
นักเรียน
ชั่วโมงฝึก (X)
อันดับ (X)
คะแนนการแสดง (Y)
อันดับ (Y)
Aladdin
2
1
50
1
Bonnie
4
2
65
2
Clyde
6
3
70
3
Daniel
8
4
80
5
Eloise
10
5
78
4
Franny
12
6
85
6
Gemma
14
7
90
8
Harris
16
8
88
7
สังเกตว่าอันดับของ Y มีลำดับต่างจาก X เล็กน้อย ความแตกต่างนี้เองที่สหสัมพันธ์ของสเปียร์แมนจะวัด
ขั้นที่ 2: คำนวณส่วนต่างของอันดับ
ต่อไป คำนวณส่วนต่างระหว่างอันดับของแต่ละคู่สังเกต
จากนั้นยกกำลังสองของแต่ละส่วนต่าง
นักเรียน
อันดับ(X)
อันดับ(Y)
di
(di)2
A
1
1
0
0
B
2
2
0
0
C
3
3
0
0
D
4
5
-1
1
E
5
4
1
1
F
6
6
0
0
G
7
8
-1
1
H
8
7
1
1
ตอนนี้ให้นำผลรวมของค่ากำลังสองในคอลัมน์สุดท้ายในตารางของเรา
ขั้นที่ 3: ใส่ค่าในสูตร
สุดท้าย ใส่ค่าลงในสูตรสหสัมพันธ์ของสเปียร์แมน
เราทราบแล้วว่า (di)2=4 จากการคำนวณก่อนหน้า ค่า n ในตัวส่วนคือขนาดตัวอย่าง ซึ่งสำหรับเราคือ 8 เมื่อนำไปแทนค่า จะได้ว่า
การตีความผลลัพธ์
ผลลัพธ์สุดท้ายคือ ρ ~ 0.95 เนื่องจากค่านี้เข้าใกล้ +1 จึงบ่งชี้ถึงความสัมพันธ์เชิงบวกที่แข็งแรงระหว่างเวลาในการฝึกกับผลการแสดง แม้ว่าความสัมพันธ์จะไม่เชิงเส้นสมบูรณ์ แต่อันดับมีความคล้ายคลึงกันมาก นั่นหมายความว่าเมื่อค่า x เปลี่ยน ค่า y ก็มีแนวโน้มจะเปลี่ยนตามอย่างสม่ำเสมอ
ในสถานการณ์จริง แทบไม่ค่อยคำนวณด้วยมือ ซอฟต์แวร์ส่วนใหญ่จัดการทั้งการจัดอันดับ กรณีเสมอภาค และการคำนวณให้อัตโนมัติ ซึ่งเป็นเรื่องดีเพราะโดยทั่วไปเรามีขนาดตัวอย่างใหญ่กว่านี้มาก
การคำนวณสหสัมพันธ์ของสเปียร์แมนด้วยซอฟต์แวร์
ซอฟต์แวร์สถิติส่วนใหญ่ในปัจจุบันคำนวณสิ่งนี้ได้ภายในไม่กี่วินาที มาดูตัวเลือกยอดนิยมกันอย่างคร่าว ๆ
Python
ใน Python โดยทั่วไปจะใช้ scipy หรือ pandas แล้วแต่เวิร์กโฟลว์ หากทำงานกับอาเรย์หรือรายการ scipy มีวิธีคำนวณสหสัมพันธ์ของสเปียร์แมนโดยตรง
คำสั่งนี้คืนทั้งค่าสัมประสิทธิ์สหสัมพันธ์และค่า p ซึ่งมีประโยชน์เมื่อทำการทดสอบทางสถิติ
หากทำงานกับข้อมูลเชิงตาราง pandas มักสะดวกกว่า
สิ่งนี้จะคำนวณเมทริกซ์สหสัมพันธ์ ทำให้เปรียบเทียบตัวแปรหลายตัวพร้อมกันได้ง่าย
หรือหากต้องการเฉพาะสหสัมพันธ์ระหว่างสองคอลัมน์ ก็สามารถระบุได้โดยตรง
R
ใน R สหสัมพันธ์ของสเปียร์แมนถูกรวมอยู่ในฟังก์ชันสถิติหลักแล้ว
หากต้องการคำนวณอย่างรวดเร็ว สามารถใช้ cor() และกำหนดให้ใช้วิธีของสเปียร์แมน
หากต้องการค่า p และรายละเอียดทางสถิติเพิ่มเติม cor.test() ก็ให้ข้อมูลนี้ได้ง่าย
Excel
Excel ไม่มีฟังก์ชันสเปียร์แมนแบบสำเร็จรูป แต่สามารถคำนวณได้สองขั้นตอนง่าย ๆ คือ จัดอันดับข้อมูลก่อน แล้วจึงหาสหสัมพันธ์ของอันดับเหล่านั้น
ตัวอย่างเล็ก ๆ ดังต่อไปนี้
A (X)
B (Y)
C (Rank X)
D (Rank Y)
2
50
1
1
4
65
2
2
6
70
3
3
8
80
5
5
10
78
4
4
สามารถสร้างอันดับ (คอลัมน์ C และ D) ด้วยฟังก์ชัน RANK.AVG เช่น
จากนั้นคำนวณสหสัมพันธ์ของสเปียร์แมนได้เลย
ไม่ว่าบนเครื่องมือใด กระบวนการพื้นฐานเหมือนกัน คือแปลงค่าเป็นอันดับ แล้วคำนวณสหสัมพันธ์ของอันดับเหล่านั้น
วิธีตีความสหสัมพันธ์อันดับของสเปียร์แมน
หากเคยใช้สหสัมพันธ์ของเพียร์สันมาก่อน ก็น่าจะมีสัญชาตญาณที่ดีในการตีความสหสัมพันธ์อันดับของสเปียร์แมน เพราะการตีความแทบจะเหมือนกัน
สหอันดับของสเปียร์แมนให้ค่าระหว่าง -1 ถึง 1 ซึ่งบอกทั้งทิศทางและความแรงของความสัมพันธ์แบบโมโนโทนิก
ค่า +1 บ่งชี้ความสัมพันธ์แบบโมโนโทนิกที่เพิ่มขึ้นอย่างสมบูรณ์ กล่าวคือเมื่อตัวแปรหนึ่งเพิ่ม อีกตัวก็เพิ่มเสมอ กรณีนี้เกิดเมื่ออันดับของแต่ละคู่ค่าเหมือนกันทุกประการ
ค่า -1 บ่งชี้ความสัมพันธ์แบบโมโนโทนิกที่ลดลงอย่างสมบูรณ์ กล่าวคือเมื่อตัวแปรหนึ่งเพิ่ม อีกตัวจะลดเสมอ กรณีนี้เกิดเมื่ออันดับของแต่ละคู่ค่ากลับกันพอดี
ค่า 0 บ่งชี้ว่าไม่มีความสัมพันธ์แบบโมโนโทนิก เกิดขึ้นเมื่อไม่มีแนวโน้มที่สม่ำเสมอในอันดับ
ประเด็นที่ต่างจากค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สันอย่างสำคัญคือ สหสัมพันธ์ของสเปียร์แมนสะท้อนว่าลำดับของข้อมูลสอดคล้องกันดีเพียงใด ไม่ใช่ว่าค่าจริงเกาะตามเส้นตรงได้ใกล้เพียงใด นั่นหมายความว่าค่าสเปียร์แมนที่สูงบ่งชี้แนวโน้มที่ชัดเจนในอันดับ ไม่จำเป็นต้องแปลว่าความสัมพันธ์เชิงเส้นหรือระยะห่างสม่ำเสมอ
เพราะเหตุนี้ การจับคู่ค่าความสัมพันธ์กับการมองภาพอย่างรวดเร็วจึงเป็นความคิดที่ดีเสมอ เพื่อเข้าใจรูปแบบพื้นฐานให้ดีที่สุด
การจัดการกรณีเสมอภาคของอันดับ
ทุกอย่างดูราบรื่น จนกระทั่งเจอชุดข้อมูลที่หลายรายการมีค่าเท่ากัน แล้วทำอย่างไรดี? นี่เรียกว่า ties หรือกรณีเสมอภาค ซึ่งต้องปรับเล็กน้อยตอนกำหนดอันดับ
เช่น ค่าชุด 10, 20, 20, 30 ค่าสองตัวที่เป็น 20 ปกติจะได้อันดับ 2 และ 3 แต่เนื่องจากค่าเท่ากัน แทนที่จะให้อันดับต่างกัน ให้ใช้อันดับเฉลี่ยของตำแหน่งนั้นแทน จึงให้อันดับ 2.5 กับทั้งสองค่า วิธีนี้ทำให้ค่าที่เสมอกันได้รับการปฏิบัติอย่างยุติธรรมและทำให้การจัดอันดับโดยรวมสอดคล้อง
เนื่องจากสหสัมพันธ์อันดับของสเปียร์แมนอิงกับอันดับล้วน ๆ หากจัดการกรณีเสมอภาคไม่ถูกต้อง ค่าสหสัมพันธ์อาจบิดเบือนได้
ข้อจำกัดของสหสัมพันธ์ของสเปียร์แมน
แม้ค่าสหสัมพันธ์อันดับของสเปียร์แมนจะยืดหยุ่นและนิยมใช้แพร่หลาย แต่ก็มีข้อจำกัด
ที่สำคัญที่สุด คือจับได้เฉพาะความสัมพันธ์แบบโมโนโทนิก หากความสัมพันธ์เปลี่ยนทิศ เช่น รูปตัวยูหรือคลื่นไซน์ ค่าสหสัมพันธ์อาจเข้าใกล้ศูนย์ แม้จะมีรูปแบบชัดเจนก็ตาม ในกรณีนี้ การใช้แบบจำลองไม่เชิงเส้น เช่น รีเกรสชันพหุนาม จะเหมาะกว่า
นอกจากนี้ เนื่องจากสหสัมพันธ์ของสเปียร์แมนอิงกับอันดับ จึงไม่สนใจระยะห่างที่แท้จริงระหว่างค่า ทำให้รับมือค่าผิดปกติได้ดีกว่า แต่ก็ทำให้ข้อมูลบางส่วนสูญหาย ความแรงเชิงขนาดของความสัมพันธ์ตีความได้ยากกว่าสำหรับสเปียร์แมนเมื่อเทียบกับเพียร์สัน เพราะมันบอกเพียงว่าตัวแปรเคลื่อนไปด้วยกันตามลำดับหรือไม่ ไม่ได้บอกว่าค่าหนึ่งเปลี่ยนไปมากน้อยเพียงใดเมื่ออีกค่าหนึ่งเปลี่ยน
สุดท้าย เมื่อมีค่าที่เสมอภาคมาก การจัดอันดับจะมีความแม่นยำลดลง ซึ่งอาจทำให้ค่าสหสัมพันธ์อ่อนลงและอาจไม่สะท้อนความสัมพันธ์ได้เต็มที่
สเปียร์แมน vs. เพียร์สัน: ควรใช้เมื่อใด
สหสัมพันธ์ที่อาจใช้กันมากที่สุดคือค่าสัมประสิทธิ์สหสัมพันธ์ของเพียร์สัน เมื่อมองผิวเผิน ดูคล้ายกับสหสัมพันธ์ของสเปียร์แมนมาก ชื่อก็ยังคล้ายกัน แต่จริง ๆ แล้วตอบคำถามต่างกันเล็กน้อย
เพียร์สันถามว่า “ตัวแปรเหล่านี้สัมพันธ์กันแบบเส้นตรงหรือไม่?” ส่วนสเปียร์แมนถามว่า “ตัวแปรเหล่านี้เคลื่อนไปในลำดับเดียวกันหรือไม่?”
หากข้อมูลมีรูปแบบค่อนข้างเป็นเส้นตรง และระยะห่างระหว่างค่ามีความหมาย สหสัมพันธ์ของเพียร์สันมักเป็นตัวเลือกที่เหมาะสม แต่ถ้าความสัมพันธ์โค้งหรือทรงตัว สเปียร์แมนมักเหมาะกว่า
สเปียร์แมนยังหยวนกว่า เนื่องจากทำงานกับอันดับแทนค่าดิบ จึงไวต่อค่าผิดปกติได้น้อยกว่า และไม่พึ่งพาสมมติฐานเกี่ยวกับข้อมูลมากนัก แลกมากับการที่จับความแตกต่างด้านขนาดของค่าได้ไม่ดีเท่า
ในทางปฏิบัติ แนวทางจำง่ายคือ ถ้าความสัมพันธ์เป็นเชิงเส้น ใช้เพียร์สัน ถ้าเป็นโมโนโทนิกแต่ไม่เชิงเส้น ใช้สเปียร์แมน และเช่นเคย ควรพล็อตข้อมูลก่อนตัดสินใจ
สรุป
ค่าสัมประสิทธิ์สหสัมพันธ์ของสเปียร์แมนเป็นเครื่องมือที่ดีเยี่ยมสำหรับการจับรูปแบบแบบโมโนโทนิก โดยเฉพาะกับชุดข้อมูลที่สหสัมพันธ์ของเพียร์สันอาจไม่เหมาะนัก การทำงานด้วยอันดับทำให้ไวต่อค่าผิดปกติน้อยลง และรองรับข้อมูลที่ไม่เชิงเส้นได้มากกว่า
อ่านเพิ่มเติมเกี่ยวกับการเลือกสหสัมพันธ์ที่เหมาะกับชุดข้อมูลได้ที่ Understanding Correlation: Measuring Relationships in Data และอาจสนใจ Understanding Covariance: An Introductory Guide ด้วย