Toutes les relations ne suivent pas une droite.
Vous observez peut-être qu’en augmentant le budget marketing, le taux de conversion progresse, mais pas de manière constante. Ou encore que, lorsque le revenu augmente, le niveau de bonheur s’accroît puis se stabilise. Le schéma est clair, mais il n’est pas linéaire. Comment le quantifier ?
La corrélation décrit la manière dont deux variables évoluent ensemble. La corrélation la plus courante est le coefficient de corrélation de Pearson, qui fonctionne très bien pour les relations linéaires. Cependant, de nombreuses relations réelles ne sont pas linéaires. Elles peuvent être courbes, se plafonner ou suivre une tendance régulière sans former une ligne droite. Dans certains cas, l’ordre des valeurs compte davantage que leur valeur exacte. C’est là qu’intervient le coefficient de corrélation de rang de Spearman.
La corrélation de Spearman travaille sur des rangs plutôt que sur des valeurs brutes, et mesure si deux variables ont tendance à augmenter ou diminuer ensemble de manière cohérente. Elle convient donc particulièrement aux relations monotones. Elle est aussi plus robuste face à certains écueils des données, comme les valeurs aberrantes ou les espacements irréguliers.
Qu’est-ce que la corrélation de rang de Spearman ?
Le coefficient de corrélation de rang de Spearman mesure l’intensité et le sens de la relation entre deux variables. Il se base sur le rang de leurs valeurs et non sur les valeurs elles-mêmes.
Pour comprendre, imaginez que vous analysiez des morceaux sur une plateforme de streaming. Vous pourriez comparer le nombre d’écoutes d’un titre à son rang dans un « Top 100 ». La relation n’est pas parfaitement linéaire : doubler le nombre d’écoutes ne double pas nécessairement la position. Mais en général, plus un morceau est écouté, plus il se classe haut.
La corrélation de Spearman capture ce type de schéma en se concentrant sur l’ordre des données plutôt que sur leurs valeurs exactes.
Elle est particulièrement utile lorsque la relation n’est pas linéaire mais suit une tendance claire, lorsque les données se prêtent naturellement à un classement, ou lorsque des valeurs aberrantes pourraient biaiser une mesure linéaire.
Contrairement à la corrélation de Pearson, qui travaille directement sur les valeurs, la corrélation de Spearman convertit d’abord les données en rangs puis mesure la proximité de ces classements entre variables.
Techniquement, la corrélation de Spearman mesure les relations monotones. Une relation est monotone si une variable a tendance à augmenter quand l’autre augmente, ou à diminuer quand l’autre diminue, sans changer de direction.
Relations monotones vs. linéaires
Quelle est exactement la différence entre une relation linéaire et une relation monotone ?
Une relation linéaire est celle où les données suivent un schéma en droite. Si vous les tracez, les points forment approximativement une ligne.
Une relation monotone, en revanche, est moins stricte. Elle signifie simplement que la relation va dans un seul sens. En substance, les deux variables évoluent ensemble, mais pas nécessairement selon une ligne droite. Le schéma peut se courber, se stabiliser ou changer de rythme, tant qu’il ne s’inverse pas.
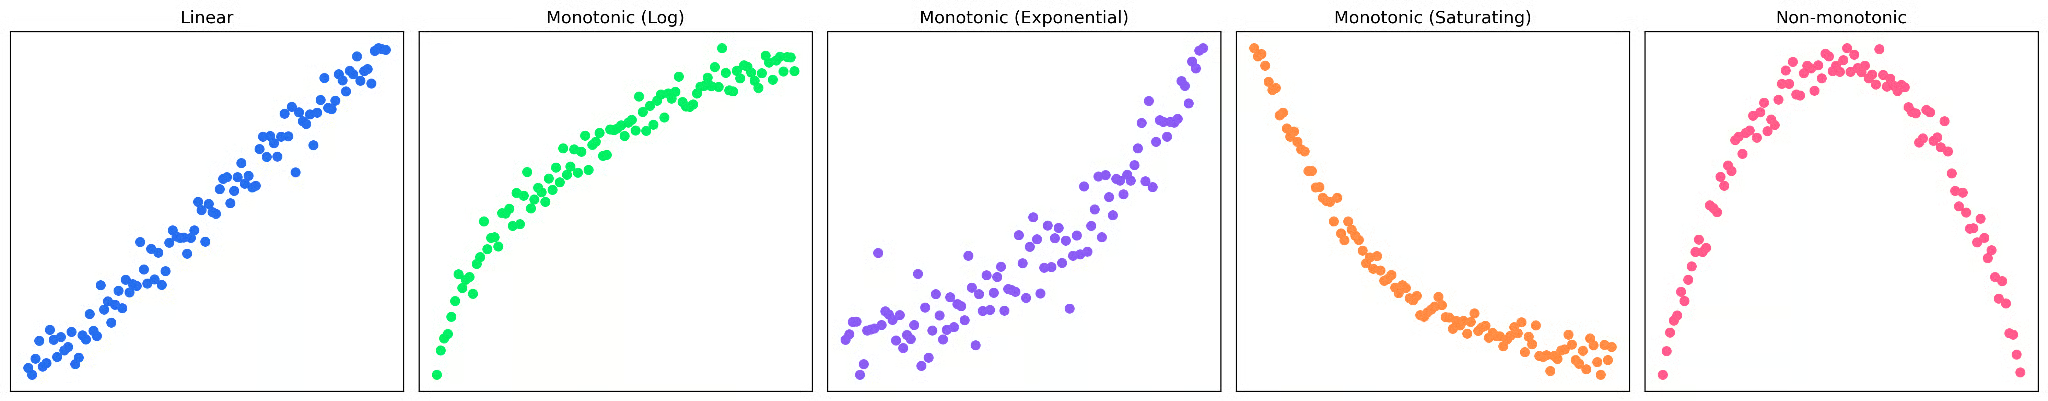
Sur les graphiques ci-dessus, vous voyez quatre exemples de relations monotones, dont un seul est linéaire. Le dernier graphique n’est pas monotone, car le schéma change de sens : il commence par une association positive et se termine par une association négative.
|
Type de relation |
Description |
Aspect visuel |
|
Linéaire |
Les variables augmentent ou diminuent à un rythme constant |
Ligne droite |
|
Monotone (mais non linéaire) |
Les variables évoluent dans le même sens, mais le rythme change |
Tendance courbe, qui se stabilise ou qui accélère |
|
Non monotone |
La relation change de direction (augmente puis diminue, ou inversement) |
Forme en U, U inversé ou motif en vagues |
Comment calculer pas à pas la corrélation de Spearman
En bref, le coefficient de Spearman consiste à convertir vos données en rangs puis à mesurer la similarité des classements entre les variables.
Parcourons un petit exemple. Supposons que nous examinions la relation entre les heures de pratique d’un instrument et le classement à un concours.
|
Élève |
Heures de pratique (X) |
Score de performance (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Traçons d’abord les données.
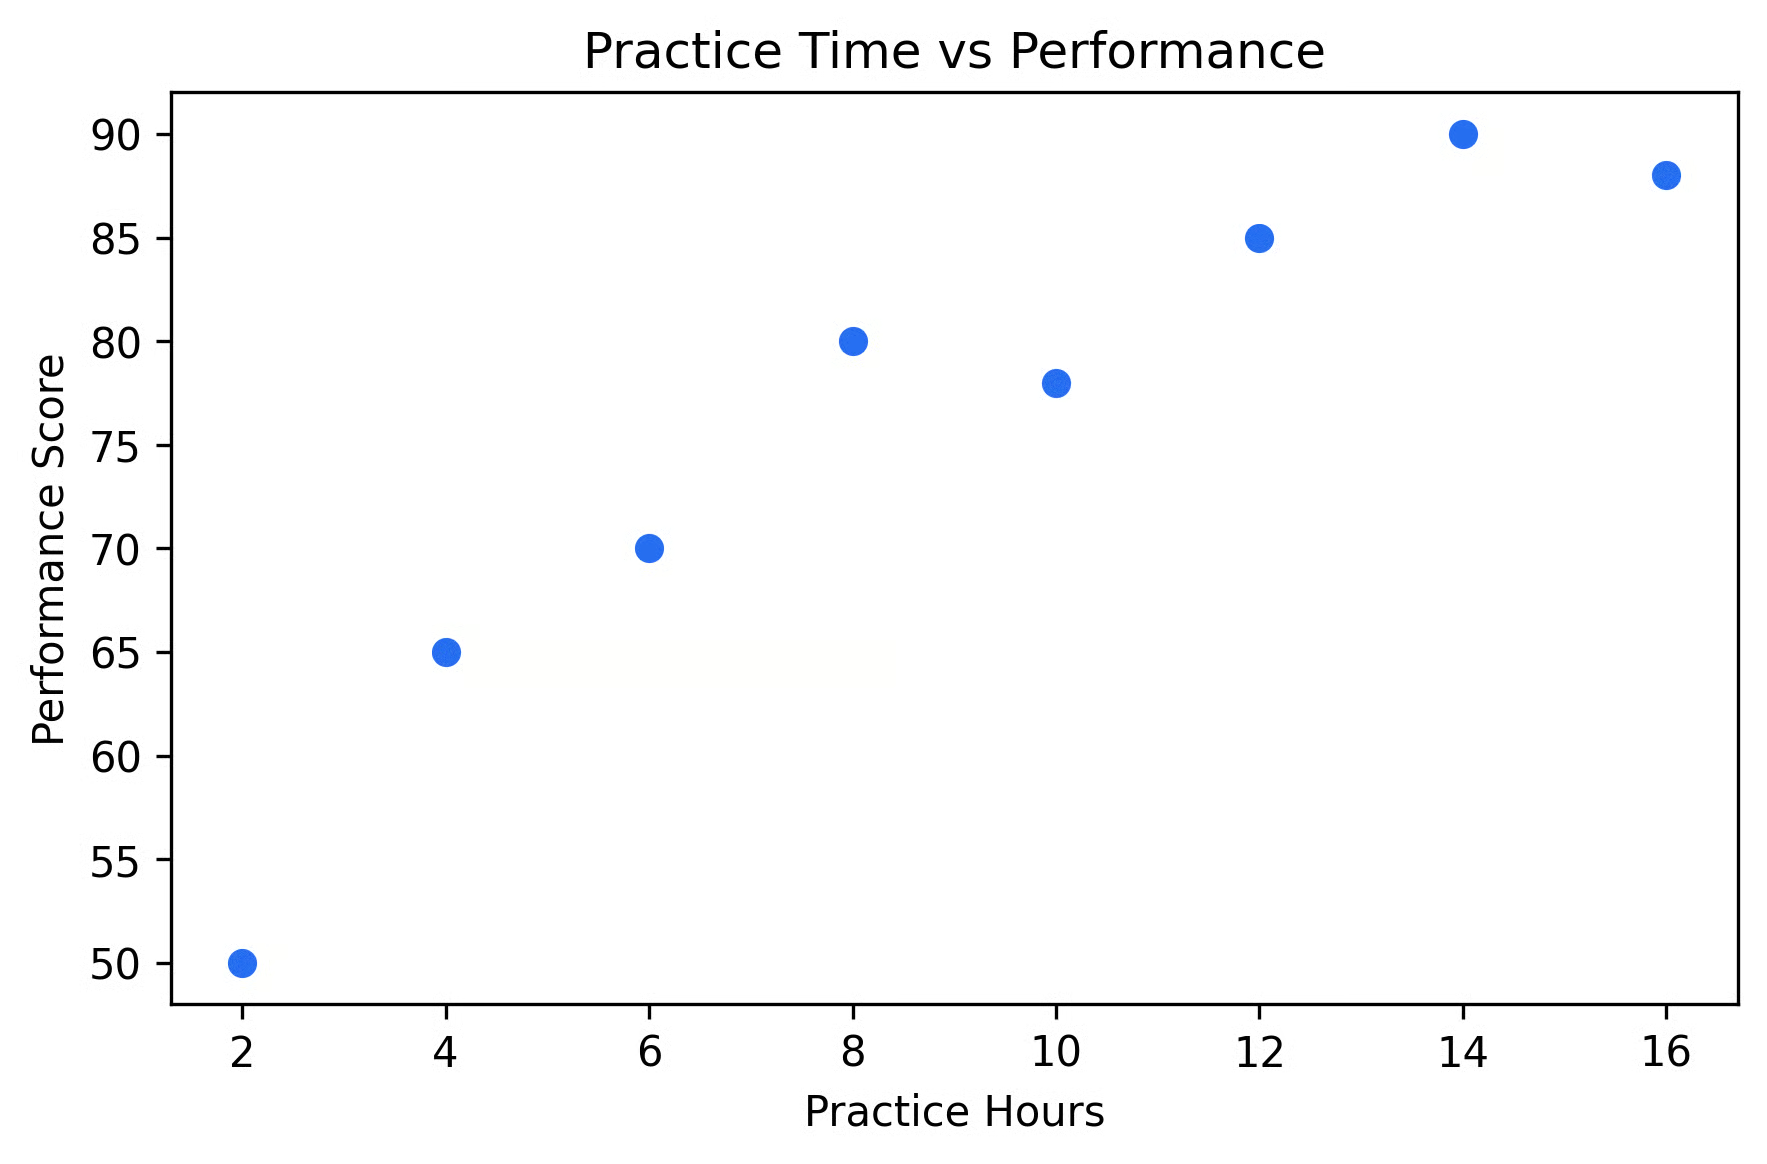
Visuellement, plus on pratique, plus le score de performance augmente, mais le schéma n’est pas parfaitement linéaire. On observe sans doute des rendements décroissants lorsque la pratique devient très élevée. Appliquons le rang de Spearman pour quantifier cette relation.
Étape 1 : convertir les données en rangs
Attribuons d’abord à chaque valeur son rang. Pour chaque variable, on classe les valeurs de la plus petite à la plus grande. La plus petite reçoit le rang 1, la deuxième plus petite le rang 2, et ainsi de suite.
|
Élève |
Heures de pratique (X) |
Rang (X) |
Score de performance (Y) |
Rang (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Remarquez que les classements pour Y diffèrent légèrement de ceux de X. C’est précisément cette variation que mesurera la corrélation de Spearman.
Étape 2 : calculer les différences de rangs
Ensuite, nous calculons la différence entre les rangs pour chaque observation.
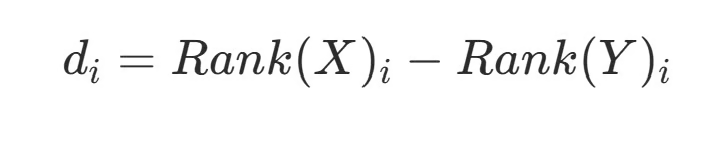
Puis nous élevons chaque différence au carré :
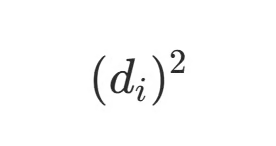
|
Élève |
Rang(X) |
Rang(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Additionnons maintenant les carrés des différences dans la dernière colonne du tableau.
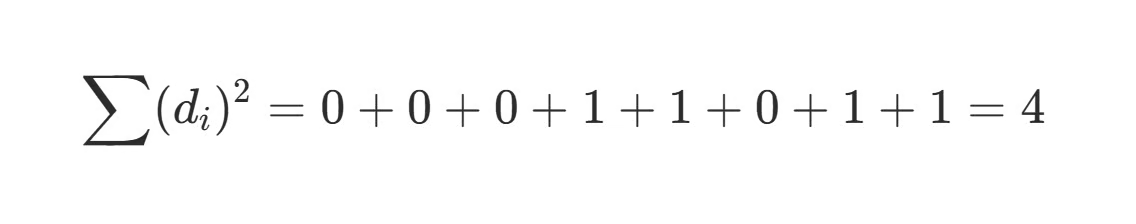
Étape 3 : appliquer la formule
Enfin, insérons les valeurs dans la formule de la corrélation de Spearman.
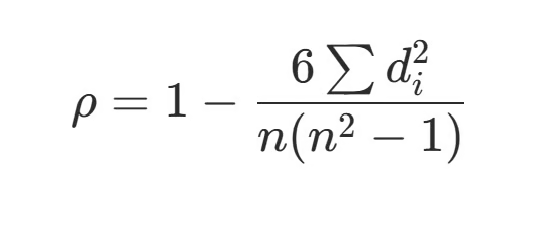
Nous savons déjà que (di)2=4 d’après nos calculs précédents. Le n au dénominateur est la taille de l’échantillon, ici 8. En remplaçant, on obtient :
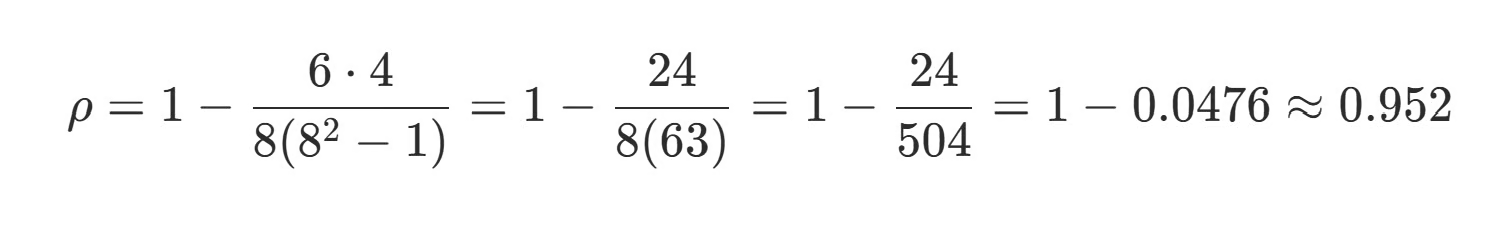
Interprétation du résultat
Notre résultat final est ρ ~ 0,95. Cette valeur étant proche de +1, elle indique une forte relation positive entre le temps de pratique et la performance. Même si la relation n’est pas parfaitement linéaire, les classements sont très proches. Autrement dit, lorsque la valeur de x change, celle de y a tendance à évoluer de manière cohérente.
Dans la pratique, il est rare de faire ce calcul à la main. La plupart des logiciels gèrent automatiquement les rangs, les ex æquo et le calcul, ce qui est utile avec des échantillons bien plus volumineux !
Calculer la corrélation de Spearman avec des logiciels
La plupart des outils statistiques réalisent ce calcul en quelques secondes. Parcourons rapidement les plus courants.
Python
En Python, vous utiliserez généralement scipy ou pandas, selon votre flux de travail. Si vous travaillez avec des tableaux ou des listes, scipy permet de calculer directement la corrélation de Spearman.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Cette fonction retourne à la fois le coefficient de corrélation et une p-valeur, utile pour les tests statistiques.
Si vous travaillez avec des données tabulaires, pandas est souvent plus pratique.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Cela calcule la matrice de corrélation, pratique pour comparer plusieurs variables d’un coup.
Sinon, si vous ne souhaitez que la corrélation entre deux colonnes précises, vous pouvez la spécifier facilement.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
En R, la corrélation de Spearman est disponible dans les fonctions statistiques de base.
Pour un calcul rapide, utilisez cor() en précisant la méthode Spearman.
cor(x, y, method = "spearman")Si vous souhaitez également une p-valeur et des détails supplémentaires, cor.test() fournit cela simplement.
cor.test(x,y,method="spearman")Excel
Excel n’a pas de fonction Spearman native, mais vous pouvez le calculer en deux étapes : classer d’abord les données, puis corréler ces rangs.
Voici un petit exemple :
|
A (X) |
B (Y) |
C (rang X) |
D (rang Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Vous pouvez créer les rangs (colonnes C et D) avec la fonction RANK.AVG. Par exemple :
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Ensuite, calculez simplement la corrélation de Spearman.
=CORREL(C2:C6, D2:D6)Quel que soit l’outil, la démarche est la même : convertir les valeurs en rangs puis calculer la corrélation de ces rangs.
Comment interpréter la corrélation de rang de Spearman
Si vous avez déjà utilisé la corrélation de Pearson, vous avez sans doute une bonne intuition de l’interprétation de la corrélation de Spearman : c’est globalement la même lecture.
Le rang de Spearman renvoie une valeur comprise entre -1 et 1. Elle indique à la fois le sens et l’intensité d’une relation monotone.
Une valeur de +1 indique une relation monotone parfaitement croissante : quand une variable augmente, l’autre augmente toujours. Cela se produit lorsque les classements de chaque paire de valeurs sont exactement identiques.
Une valeur de -1 indique une relation monotone parfaitement décroissante : quand une variable augmente, l’autre diminue toujours. Cela se produit lorsque les classements de chaque paire de valeurs sont exactement inversés.
Une valeur de 0 indique l’absence de relation monotone. Cela se produit lorsqu’il n’y a pas de tendance cohérente dans les classements.
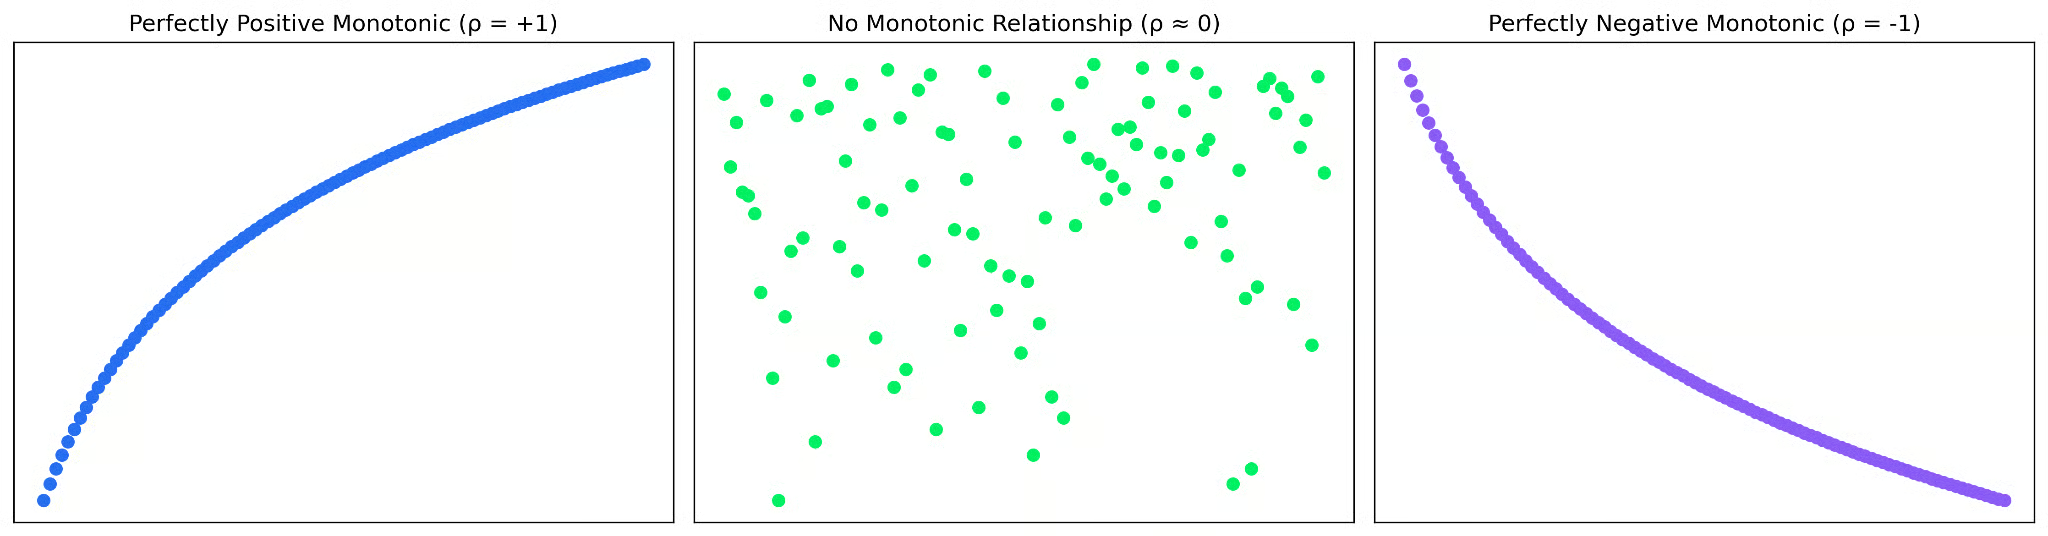
Une différence importante par rapport au coefficient de Pearson est que la corrélation de Spearman reflète l’alignement de l’ordre des données, et non la proximité des valeurs avec une droite. Ainsi, une forte corrélation de Spearman indique une tendance claire dans les classements, sans impliquer que la relation soit linéaire ou régulièrement espacée.
Pour cette raison, il est toujours recommandé d’accompagner une corrélation d’une visualisation rapide, afin de bien comprendre le schéma sous-jacent.
Gérer les ex æquo dans les classements
Tout cela paraît simple jusqu’à tomber sur un jeu de données où plusieurs observations ont la même valeur. Que faire alors ? On parle d’ex æquo, et il faut ajuster légèrement l’attribution des rangs.
Par exemple, pour les valeurs : 10, 20, 20, 30. Les deux valeurs 20 occuperaient normalement les rangs 2 et 3. Comme elles sont identiques, au lieu d’assigner des rangs différents, on leur attribue la moyenne de ces rangs : les deux 20 reçoivent le rang 2,5. Cette approche garantit un traitement équitable des ex æquo et un classement cohérent.
Comme la corrélation de Spearman repose entièrement sur les rangs, une mauvaise gestion des ex æquo peut fausser la corrélation.
Limites de la corrélation de Spearman
Bien que le coefficient de Spearman soit flexible et très utilisé, il présente des limites.
La plus importante : il ne capture que les relations monotones. Si la relation change de sens, par exemple en forme de U ou comme une sinusoïde, la corrélation peut être proche de zéro alors même qu’un schéma clair existe. Dans ces cas, un modèle non linéaire, comme une régression polynomiale, sera plus adapté.
De plus, comme la corrélation de Spearman se base sur des rangs, elle ignore les distances réelles entre valeurs. Cela la rend plus robuste aux valeurs aberrantes, mais implique aussi une perte d’information. L’ampleur de la relation est plus difficile à interpréter qu’avec la corrélation de Pearson : Spearman indique si les variables évoluent ensemble dans l’ordre, mais pas de combien l’une change par rapport à l’autre.
Enfin, lorsqu’il y a beaucoup d’ex æquo, le classement devient moins précis. La corrélation peut alors sembler plus faible et ne pas refléter toute l’ampleur de la relation.
Spearman vs Pearson : quand utiliser l’un ou l’autre
La corrélation la plus utilisée est sans doute celle de Pearson. À première vue, elle semble très proche de la corrélation de Spearman. Les noms sont presque identiques ! Mais elles répondent à des questions légèrement différentes.
Pearson demande : « Ces variables suivent-elles une relation en ligne droite ? », tandis que Spearman demande : « Ces variables évoluent-elles dans le même ordre ? »
Si vos données suivent approximativement une droite et que les distances réelles entre valeurs sont pertinentes, la corrélation de Pearson est généralement le bon choix. Mais si la relation se courbe ou se stabilise, Spearman sera souvent plus adapté.
Spearman est aussi plus tolérant. Comme il travaille sur des rangs et non sur des valeurs brutes, il est moins sensible aux valeurs aberrantes et repose moins sur des hypothèses fortes. En contrepartie, il capture moins bien les différences d’ampleur entre valeurs.
En pratique, une bonne règle empirique est la suivante : si la relation est linéaire, utilisez Pearson ; si elle est monotone mais non linéaire, utilisez Spearman. Et, comme toujours, visualisez vos données avant de décider.
Conclusion
Le coefficient de corrélation de Spearman est un excellent outil pour saisir des schémas monotones, surtout lorsque les données ne se prêtent pas bien à la corrélation de Pearson. En travaillant sur des rangs, il est moins sensible aux valeurs aberrantes et plus accommodant avec des données non linéaires.
Pour en savoir plus sur le choix de la meilleure corrélation pour votre jeu de données, consultez Comprendre la corrélation : mesurer les relations dans les données. Vous pourriez aussi être intéressé par Comprendre la covariance : guide d’introduction.