हर संबंध सीधी रेखा का अनुसरण नहीं करता।
आप देख सकते हैं कि जैसे-जैसे मार्केटिंग बजट बढ़ता है, ग्राहक रूपांतरण बेहतर होता जाता है, लेकिन एक समान दर से नहीं। या हो सकता है कि आय बढ़ने पर खुशी अक्सर बढ़ती है, फिर स्थिर हो जाती है। पैटर्न स्पष्ट है, लेकिन रैखिक नहीं। आप इसे कैसे मात्रात्मक करेंगे?
सहसंबंध का उपयोग यह बताने के लिए किया जाता है कि दो चर एक साथ कैसे बदलते हैं। एक सामान्य सहसंबंध जो आप देखेंगे वह है पीयरसन का सहसंबंध गुणांक, जो रैखिक संबंधों के लिए बहुत अच्छा काम करता है। हालांकि, कई वास्तविक दुनिया के संबंध रैखिक नहीं होते। वे मुड़ सकते हैं, ठहराव ले सकते हैं, या बिना सीधी रेखा बनाए एक सुसंगत प्रवृत्ति का पालन कर सकते हैं। कुछ मामलों में, सटीक मानों से अधिक महत्वपूर्ण होता है कि वे किस क्रम में आते हैं। यहीं पर स्पीयरमैन का रैंक सहसंबंध गुणांक काम आता है।
स्पीयरमैन का सहसंबंध कच्चे मानों की बजाय रैंकों के साथ काम करता है, यह मापता है कि क्या दो चर एक सुसंगत तरीके से साथ-साथ बढ़ने या घटने की प्रवृत्ति रखते हैं। यह इसे मोनोटोनिक संबंधों के लिए उपयुक्त बनाता है। यह कुछ डेटा विशेषताओं, जैसे अपवाद मानों (outliers) या असमान अंतराल, के प्रति अधिक मजबूत भी बनाता है।
स्पीयरमैन का रैंक सहसंबंध क्या है?
स्पीयरमैन का रैंक सहसंबंध गुणांक दो चरों के बीच संबंध की शक्ति और दिशा का माप है। यह मानों के बजाय उनके रैंकों पर आधारित होता है।
देखने के लिए कि यह कैसे काम करता है, कल्पना कीजिए कि आप किसी स्ट्रीमिंग प्लेटफ़ॉर्म पर गीतों का विश्लेषण कर रहे हैं। आप किसी गीत के प्ले की संख्या की तुलना उसके “टॉप 100” चार्ट पर रैंक से कर सकते हैं। संबंध पूरी तरह रैखिक न भी हो; स्ट्रीम्स दोगुनी होने से रैंकिंग दोगुनी नहीं हो जाती। लेकिन सामान्यतः, जिन गीतों के स्ट्रीम अधिक होते हैं वे ऊँचा रैंक करते हैं।
स्पीयरमैन का सहसंबंध इस तरह के पैटर्न को सटीक मानों की बजाय डेटा के क्रम पर ध्यान देकर पकड़ता है।
यह विशेष रूप से तब उपयोगी होता है जब संबंध रैखिक न हो लेकिन फिर भी एक स्पष्ट प्रवृत्ति का पालन करता हो, डेटा स्वाभाविक रूप से रैंकिंग के रूप में व्यक्त किया जाता हो, या डेटा में ऐसे अपवाद मान हों जो रैखिक माप को विकृत कर सकते हैं।
पीयरसन के सहसंबंध के विपरीत, जो सीधे कच्चे मानों के साथ काम करता है, स्पीयरमैन का सहसंबंध पहले डेटा को रैंकों में बदलता है और फिर यह मापता है कि ये रैंकिंग्स कितनी निकटता से मेल खाती हैं।
तकनीकी रूप से, स्पीयरमैन का सहसंबंध मोनोटोनिक संबंधों को मापता है। कोई संबंध मोनोटोनिक होता है यदि एक चर के बढ़ने पर दूसरा बढ़ने की, या एक के घटने पर दूसरा घटने की प्रवृत्ति रखता है, बिना दिशा बदले।
मोनोटोनिक बनाम रैखिक संबंध
तो रैखिक और मोनोटोनिक संबंधों में अंतर क्या है?
रैखिक संबंध वह है जहाँ डेटा सीधी रेखा के पैटर्न का अनुसरण करता है। यदि आप डेटा को प्लॉट करें, तो बिंदु मिलकर लगभग एक रेखा बनाते दिखेंगे।
दूसरी ओर, मोनोटोनिक संबंध कम सख्त होता है। इसका सरल अर्थ है कि संबंध एक ही दिशा में चलता है। मूल रूप से, दोनों चर साथ-साथ चलते हैं, लेकिन जरूरी नहीं कि सीधी रेखा में हों। पैटर्न मुड़ सकता है, समतल हो सकता है या गति बदल सकती है, बशर्ते दिशा न बदले।
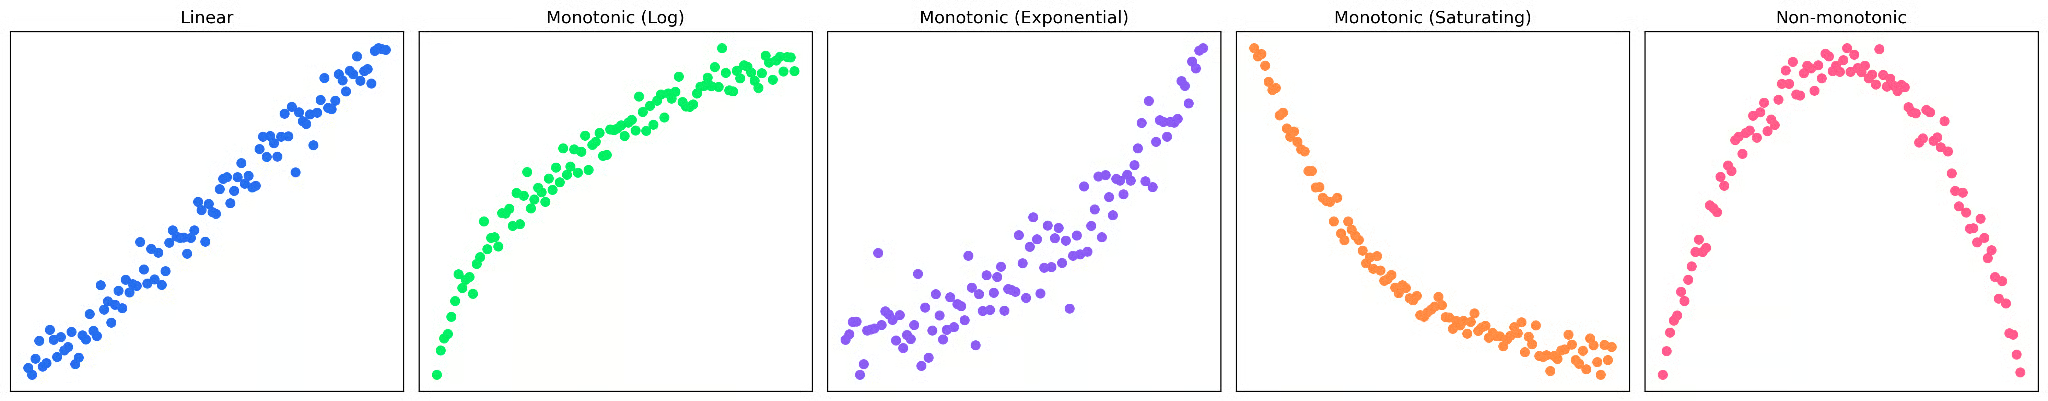
ऊपर के ग्राफ़ों में, आप मोनोटोनिक संबंधों के चार अलग-अलग उदाहरण देख सकते हैं, जिनमें से केवल पहला रैखिक है। आखिरी ग्राफ़ मोनोटोनिक नहीं है, क्योंकि पैटर्न दिशा बदलता है—एक सकारात्मक संबद्धता से शुरू होकर एक नकारात्मक पर खत्म होता है।
|
संबंध का प्रकार |
विवरण |
दिखने में कैसा |
|
रैखिक |
चर एक समान दर से बढ़ते या घटते हैं |
सीधी रेखा |
|
मोनोटोनिक (परंतु गैर-रैखिक) |
चर एक ही दिशा में चलते हैं, लेकिन दर बदलती रहती है |
मुड़ा हुआ, समतल होता हुआ, या तीव्र होती प्रवृत्ति |
|
गैर-मोनोटोनिक |
संबंध दिशा बदलता है (पहले बढ़ता, फिर घटता, या इसके विपरीत) |
यू-आकार, उल्टा यू, या तरंग जैसा पैटर्न |
स्पीयरमैन का रैंक सहसंबंध कैसे खोजें: चरण-दर-चरण
ऊँचे स्तर पर, स्पीयरमैन का रैंक सहसंबंध गुणांक आपके डेटा को रैंकों में बदलता है और फिर चरों के बीच रैंकिंग्स की समानता को मापता है।
चलिए एक छोटे उदाहरण से समझते हैं। मान लीजिए हम’ किसी वाद्य यंत्र का अभ्यास करने में बिताए घंटों और प्रतियोगिता में प्रदर्शन रैंकिंग के बीच संबंध देख रहे हैं।
|
छात्र |
अभ्यास घंटे (X) |
प्रदर्शन स्कोर (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
पहले, डेटा को प्लॉट करें।
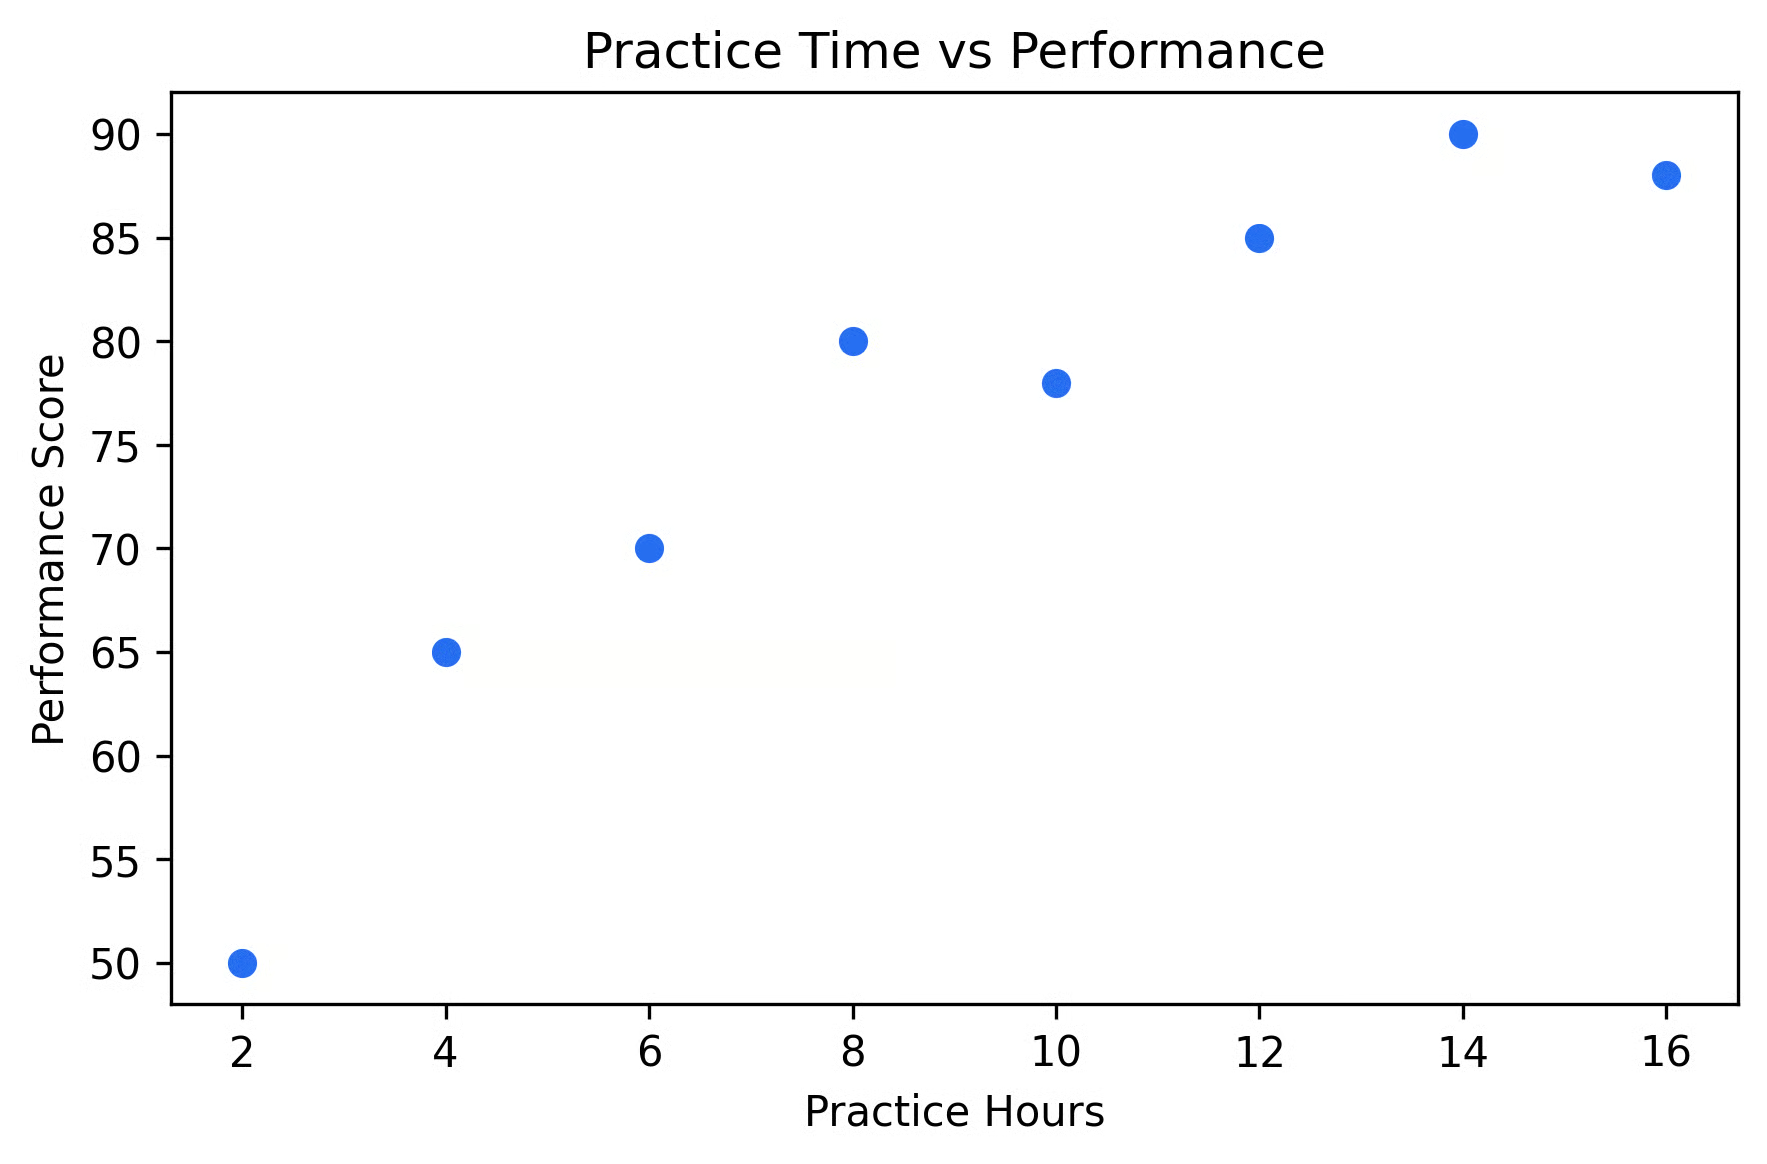
दृश्य रूप से, लगता है कि अधिक अभ्यास से उच्च प्रदर्शन स्कोर मिलते हैं, लेकिन पैटर्न पूरी तरह रैखिक नहीं है। ऐसा लगता है कि बहुत अधिक अभ्यास करने पर घटते प्रतिफल हो सकते हैं। इस संबंध को मात्रात्मक करने के लिए स्पीयरमैन रैंक लागू करके देखते हैं।
चरण 1: डेटा को रैंक में बदलें
सबसे पहले, प्रत्येक मान को उसका रैंक सौंपते हैं। प्रत्येक चर के भीतर, हम सबसे छोटे से सबसे बड़े तक रैंक देते हैं। किसी चर के भीतर सबसे छोटे मान को रैंक 1 मिलता है, दूसरे सबसे छोटे को रैंक 2, और इसी तरह।
|
छात्र |
अभ्यास घंटे (X) |
रैंक (X) |
प्रदर्शन स्कोर (Y) |
रैंक (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
ध्यान दें कि Y की रैंकिंग X से थोड़े अलग क्रम में है। स्पीयरमैन का सहसंबंध इसी भिन्नता को मापेगा।
चरण 2: रैंकों का अंतर निकालें
इसके बाद, हर प्रेक्षण के लिए रैंकों के बीच का अंतर निकालते हैं।
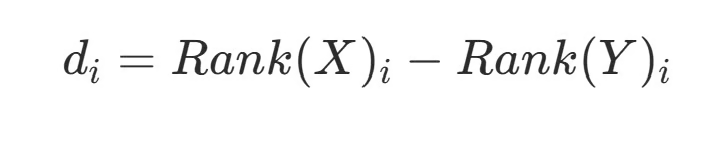
फिर प्रत्येक अंतर का वर्ग करें:
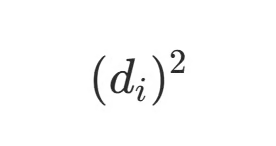
|
छात्र |
रैंक(X) |
रैंक(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
अब हम अपनी तालिका के अंतिम स्तंभ में वर्गांतरों का योग निकालते हैं।
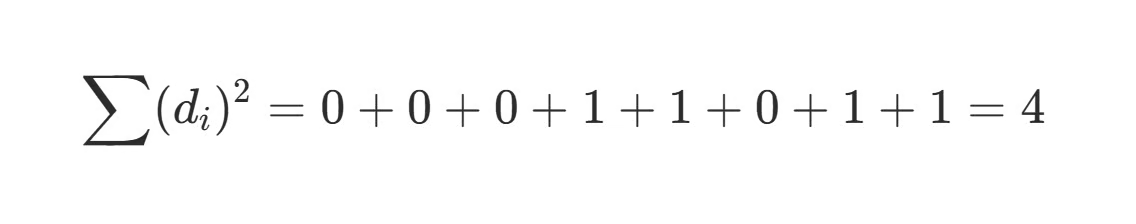
चरण 3: सूत्र लागू करें
अंत में, हमें मानों को स्पीयरमैन सहसंबंध के सूत्र में रखना है।
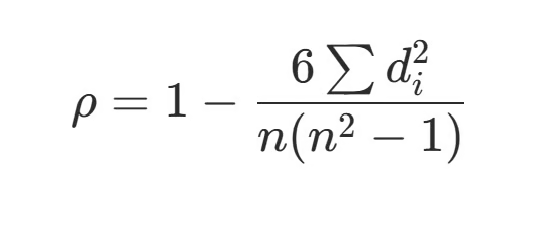
हमें पहले से पता है कि (di)2=4 हमारी पिछली गणनाओं से। हर (हर) में n नमूना आकार है, जो हमारे लिए 8 है। मान रखने पर हमें मिलता है:
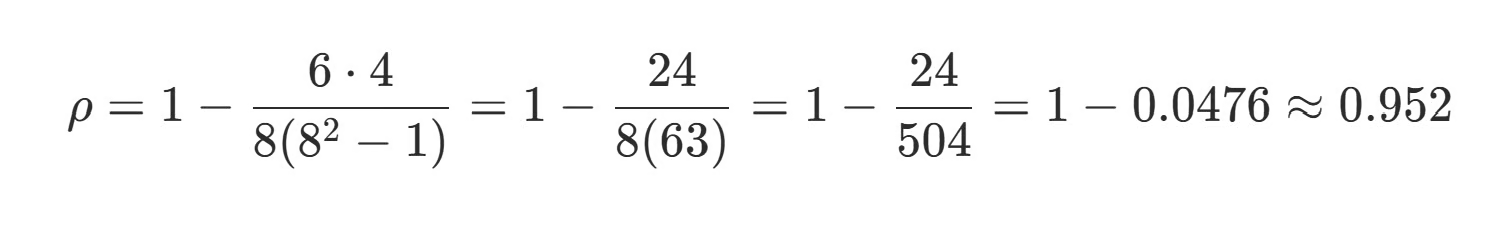
परिणाम की व्याख्या
हमारा अंतिम परिणाम है ρ ~ 0.95। क्योंकि यह मान +1 के क़रीब है, यह अभ्यास समय और प्रदर्शन के बीच एक मजबूत सकारात्मक संबंध दर्शाता है। भले ही संबंध पूरी तरह रैखिक नहीं है, रैंकिंग्स बहुत मिलती-जुलती हैं। इसका मतलब है कि जब x मान बदलता है, तो y मान भी उसके साथ सुसंगत रूप से बदलता है।
वास्तविक जीवन में, इसे हाथ से गणना करना काफी दुर्लभ है। ज़्यादातर सॉफ़्टवेयर रैंकिंग, टाई और गणना स्वतः कर लेते हैं, जो अच्छा है क्योंकि सामान्यतः हमारे नमूने काफ़ी बड़े होते हैं!
सॉफ़्टवेयर का उपयोग करके स्पीयरमैन का सहसंबंध निकालना
आजकल ज़्यादातर सांख्यिकीय सॉफ़्टवेयर यह गणना सेकंडों में कर देते हैं। चलिए सबसे सामान्य सॉफ़्टवेयर का संक्षेप में ज़िक्र करते हैं।
Python
Python में, आप आमतौर पर अपने वर्कफ़्लो पर निर्भर करते हुए scipy या pandas में से किसी एक का उपयोग करेंगे। यदि आप arrays या lists के साथ काम कर रहे हैं, तो scipy स्पीयरमैन का सहसंबंध निकालने का सीधा तरीका देता है।
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
यह सहसंबंध गुणांक और p-value दोनों लौटाता है, जो सांख्यिकीय परीक्षण करते समय सहायक होता है।
यदि आप टेबुलर डेटा के साथ काम कर रहे हैं, तो pandas अक्सर अधिक सुविधाजनक होता है।
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
यह सहसंबंध मैट्रिक्स की गणना करता है, जिससे एक साथ कई चरों की तुलना करना आसान हो जाता है।
वैकल्पिक रूप से, यदि आप केवल दो विशिष्ट स्तंभों के बीच सहसंबंध चाहते हैं, तो आप उसे आसानी से निर्दिष्ट कर सकते हैं।
corr=df["column_1"].corr(df["column_2"],method="spearman")R
R में, स्पीयरमैन का सहसंबंध मूल सांख्यिकीय फ़ंक्शनों में अंतर्निहित है।
त्वरित गणना के लिए, आप cor() का उपयोग कर सकते हैं और यह निर्दिष्ट कर सकते हैं कि आप स्पीयरमैन विधि चाहते हैं।
cor(x, y, method = "spearman")यदि आप p-value और अतिरिक्त सांख्यिकीय विवरण भी चाहते हैं, तो cor.test() इसे आसानी से प्रदान करता है।
cor.test(x,y,method="spearman")Excel
Excel में स्पीयरमैन के लिए बिल्ट-इन फ़ंक्शन नहीं है, लेकिन आप इसे दो त्वरित चरणों में निकाल सकते हैं: पहले डेटा को रैंक करें, फिर उन रैंकों का सहसंबंध लें।
यहाँ एक छोटा सा उदाहरण है:
|
A (X) |
B (Y) |
C (Rank X) |
D (Rank Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
आप रैंकों (स्तंभ C और D) को RANK.AVG फ़ंक्शन से बना सकते हैं। उदाहरण के लिए:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
फिर, बस स्पीयरमैन का सहसंबंध निकालें।
=CORREL(C2:C6, D2:D6)इन सभी टूल्स में, अंतर्निहित प्रक्रिया एक ही है: मानों को रैंक में बदलें और फिर उन रैंकों का सहसंबंध निकालें।
स्पीयरमैन के रैंक सहसंबंध की व्याख्या कैसे करें
यदि आपने पहले पीयरसन का सहसंबंध उपयोग किया है, तो संभवतः आपको स्पीयरमैन के रैंक सहसंबंध की व्याख्या का अच्छा अंदाज़ा होगा, क्योंकि मूलतः इसकी व्याख्या भी वैसी ही है।
स्पीयरमैन रैंक -1 और 1 के बीच एक मान देता है। यह मोनोटोनिक संबंध की दिशा और शक्ति दोनों बताता है।
+1 का मान एक पूर्णतः बढ़ते मोनोटोनिक संबंध को दर्शाता है; जैसे एक चर बढ़ता है, दूसरा हमेशा बढ़ता है। यह तब होता है जब प्रत्येक मान-युग्म की रैंकिंग बिल्कुल समान होती है।
-1 का मान एक पूर्णतः घटते मोनोटोनिक संबंध को दर्शाता है; जैसे एक चर बढ़ता है, दूसरा हमेशा घटता है। यह तब होता है जब प्रत्येक मान-युग्म की रैंकिंग बिल्कुल उलटी होती है।
0 का मान कोई मोनोटोनिक संबंध न होने को दर्शाता है। यह तब होता है जब रैंकिंग में कोई सुसंगत प्रवृत्ति नहीं होती।
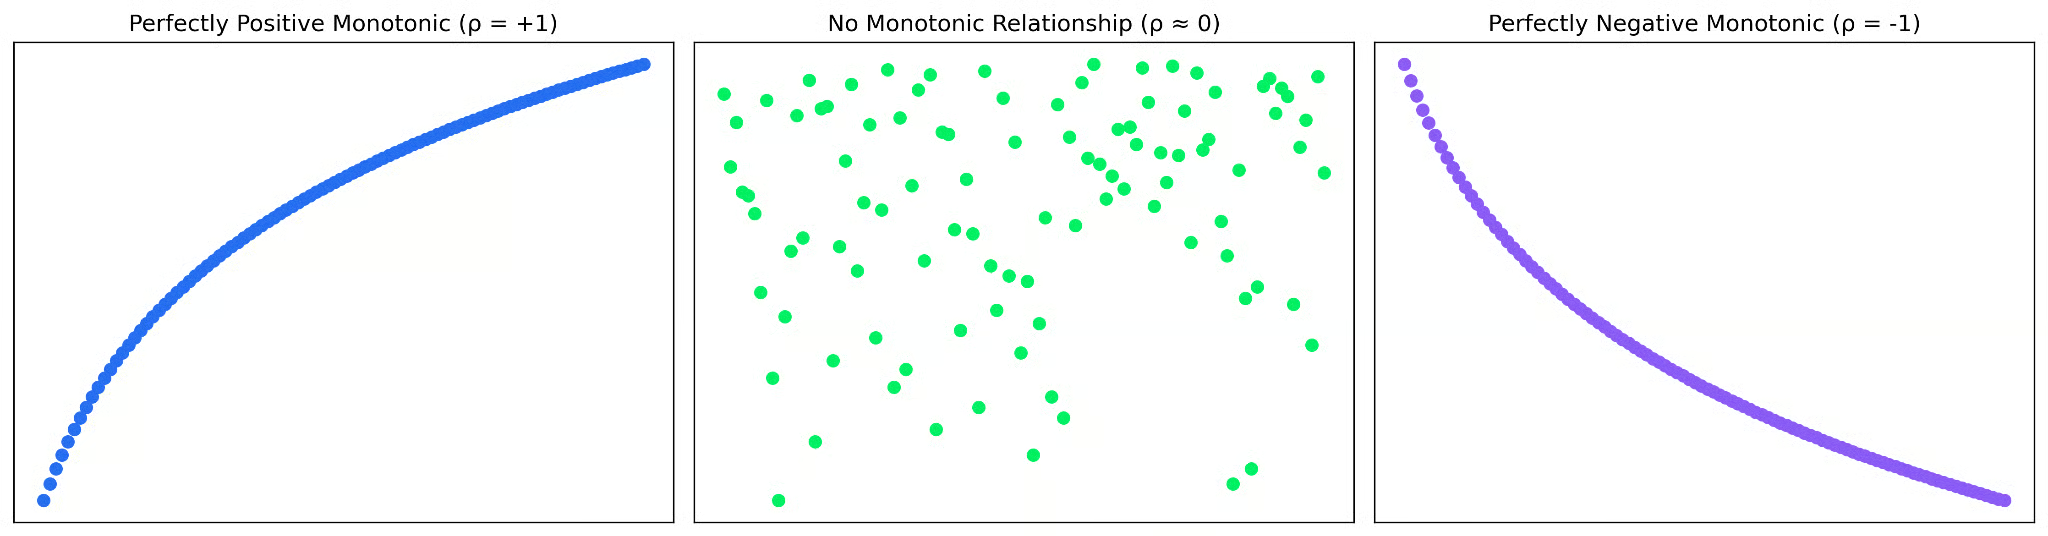
पीयरसन के सहसंबंध गुणांक से एक महत्वपूर्ण अंतर यह है कि स्पीयरमैन का सहसंबंध यह दर्शाता है कि डेटा का क्रम कितना अच्छी तरह मेल खाता है, न कि यह कि वास्तविक मान कितनी निकटता से सीधी रेखा का अनुसरण करते हैं। इसका अर्थ है कि एक मजबूत स्पीयरमैन सहसंबंध रैंकिंग में एक स्पष्ट प्रवृत्ति को इंगित करता है, और जरूरी नहीं कि संबंध रैखिक या समान अंतराल वाला हो।
इसी कारण, अंतर्निहित पैटर्न को समझने के लिए सहसंबंध मानों को एक त्वरित दृश्यांकन के साथ देखना हमेशा अच्छा विचार है।
रैंकिंग में टाई को संभालना
सब कुछ ठीक लगता है, जब तक कि आपको ऐसा डेटा न मिल जाए जिसमें कई प्रेक्षणों के मान समान हों। तब क्या करें? इन्हें टाई कहा जाता है, और रैंक सौंपते समय एक छोटा समायोजन आवश्यक होता है।
उदाहरण के लिए, मान लें मान हैं: 10, 20, 20, 30। 20 के दोनों मान सामान्यतः रैंक 2 और 3 पर आते। लेकिन चूँकि वे समान हैं, अलग-अलग रैंक देने के बजाय, हम उन रैंकों का औसत देते हैं; दोनों 20 का रैंक 2.5 होगा। यह तरीका सुनिश्चित करता है कि टाई मानों के साथ निष्पक्षता बरती जाए और समग्र रैंकिंग सुसंगत रहे।
क्योंकि स्पीयरमैन का रैंक सहसंबंध गुणांक पूरी तरह रैंकों पर आधारित है, यदि टाई को सही ढंग से नहीं संभाला गया, तो सहसंबंध विकृत हो सकता है।
स्पीयरमैन के सहसंबंध की सीमाएँ
हालाँकि स्पीयरमैन का रैंक सहसंबंध गुणांक एक लचीला और व्यापक रूप से प्रयुक्त माप है, इसकी कुछ सीमाएँ भी हैं।
सबसे महत्वपूर्ण, यह केवल मोनोटोनिक संबंधों को पकड़ सकता है। यदि कोई संबंध दिशा बदलता है, जैसे यू-आकार का पैटर्न या साइन तरंग, तो स्पष्ट पैटर्न होने पर भी सहसंबंध शून्य के क़रीब हो सकता है। ऐसे मामलों में, बहुपद प्रतिगमन जैसे गैर-रैखिक मॉडल अधिक उपयुक्त होंगे।
साथ ही, क्योंकि स्पीयरमैन का सहसंबंध रैंकों पर आधारित है, यह मानों के वास्तविक अंतराल को अनदेखा करता है। इससे यह अपवाद मानों को बेहतर संभालता है, लेकिन कुछ जानकारी खो भी जाती है। इसी कारण स्पीयरमैन के सहसंबंध में परिमाण (magnitude) की व्याख्या पीयरसन की तुलना में कठिन होती है। यह बताता है कि क्या चर क्रम में साथ-साथ चलते हैं, लेकिन यह नहीं कि एक दूसरे की तुलना में कितना बदलता है।
अंततः, जब कई मान टाई होते हैं, तो रैंकिंग प्रक्रिया कम सटीक हो जाती है। इससे सहसंबंध का मान कमजोर पड़ सकता है और संभवतः संबंध की पूरी सीमा को नहीं दर्शा पाता।
स्पीयरमैन बनाम पीयरसन: कब किसका उपयोग करें
सबसे अधिक उपयोग में आने वाला सहसंबंध संभवतः पीयरसन का सहसंबंध गुणांक है। पहली नज़र में, यह स्पीयरमैन के सहसंबंध गुणांक से बहुत मिलता-जुलता लगता है। उनके नाम भी लगभग एक जैसे हैं! लेकिन वे थोड़े अलग प्रश्नों का उत्तर देते हैं।
पीयरसन पूछता है, “क्या ये चर सीधी रेखीय संबंध का पालन करते हैं?”, जबकि स्पीयरमैन पूछता है, “क्या ये चर एक ही क्रम में चलते हैं?”
यदि आपका डेटा लगभग सीधी रेखीय पैटर्न का अनुसरण करता है और मानों के बीच वास्तविक दूरी मायने रखती है, तो पीयरसन का सहसंबंध सामान्यतः सही विकल्प है। लेकिन यदि संबंध मुड़ता है या समतल हो जाता है, तो स्पीयरमैन बेहतर साबित होता है।
स्पीयरमैन अधिक क्षमाशील भी है। क्योंकि यह कच्चे मानों की बजाय रैंकों के साथ काम करता है, यह अपवाद मानों के प्रति कम संवेदनशील होता है और डेटा के बारे में सख्त मान्यताओं पर कम निर्भर करता है। इसकी कीमत यह है कि यह मानों के बीच परिमाण के अंतर को पकड़ने में उतना अच्छा नहीं है।
व्यवहार में, एक अच्छा thumb rule यह है: यदि संबंध रैखिक है, तो पीयरसन का उपयोग करें; यदि यह मोनोटोनिक है, लेकिन रैखिक नहीं, तो स्पीयरमैन का उपयोग करें। और हमेशा की तरह, निर्णय लेने से पहले अपना डेटा प्लॉट करें।
निष्कर्ष
स्पीयरमैन का सहसंबंध गुणांक मोनोटोनिक पैटर्न को पकड़ने का एक बेहतरीन उपकरण है, विशेषकर ऐसे डेटासेट्स में जहाँ पीयरसन का सहसंबंध अच्छा काम नहीं करता। रैंकों के साथ काम करके, यह अपवाद मानों के प्रति कम संवेदनशील और गैर-रैखिक डेटा के प्रति अधिक अनुकूल होता है।
आप अपने डेटासेट के लिए सबसे अच्छा सहसंबंध चुनने पर और पढ़ सकते हैं Understanding Correlation: Measuring Relationships in Data में। आप यह भी देखना चाहेंगे Understanding Covariance: An Introductory Guide।