Не все зависимости описываются прямой линией.
Вы можете заметить: по мере роста маркетингового бюджета конверсия клиентов улучшается, но не с постоянной скоростью. Или, например, с ростом дохода уровень счастья часто повышается, а затем выходит на плато. Узор очевиден, но он не линейный. Как это количественно оценить?
Корреляция описывает, как две переменные изменяются вместе. Наиболее часто встречается коэффициент корреляции Пирсона, который wеликолепно работает для линейных зависимостей. Однако многие реальные связи не линейны: они могут изгибаться, выходить на плато или следовать устойчивому тренду без прямой линии. В некоторых случаях важнее не точные значения, а их порядок. Здесь на помощь приходит ранговая корреляция Спирмена.
Корреляция Спирмена использует ранги вместо исходных значений и измеряет, склонны ли две переменные согласованно возрастать или убывать. Это делает её подходящей для монотонных зависимостей. Она также устойчивее к некоторым особенностям данных, таким как выбросы или неравномерные интервалы.
Что такое ранговая корреляция Спирмена?
Коэффициент ранговой корреляции Спирмена измеряет силу и направление связи между двумя переменными. Он основан на рангах их значений, а не на самих значениях.
Представьте, что вы анализируете песни на стриминговой платформе. Вы сравниваете, сколько раз песня была проиграна, и её позицию в чарте «Top 100». Зависимость может быть не идеально линейной: удвоение числа прослушиваний не обязательно поднимет песню вдвое выше. Но в целом песни с большим числом прослушиваний занимают более высокие места.
Корреляция Спирмена фиксирует такой паттерн, фокусируясь на порядке данных, а не на их точных значениях.
Это особенно полезно, когда зависимость не линейна, но следует отчётливому тренду, данные естественно выражены в виде рангов или содержат выбросы, и линейная мера может исказиться.
В отличие от корреляции Пирсона, которая работает с исходными значениями, корреляция Спирмена сначала преобразует данные в ранги, а затем измеряет, насколько согласованы эти ранги.
Технически корреляция Спирмена измеряет монотонные зависимости. Зависимость монотонна, если одна переменная имеет тенденцию увеличиваться при увеличении другой или уменьшаться при её уменьшении, не меняя направления.
Монотонные и линейные зависимости
В чём же именно разница между линейными и монотонными зависимостями?
Линейная зависимость — это когда данные следуют шаблону прямой линии. Если построить график, точки примерно выстроятся в линию.
Монотонная зависимость — менее строгая. Она означает, что связь движется в одном направлении. По сути, обе переменные меняются согласованно, но не обязательно по прямой. Паттерн может изгибаться, выходить на плато или менять скорость, пока не меняется направление.
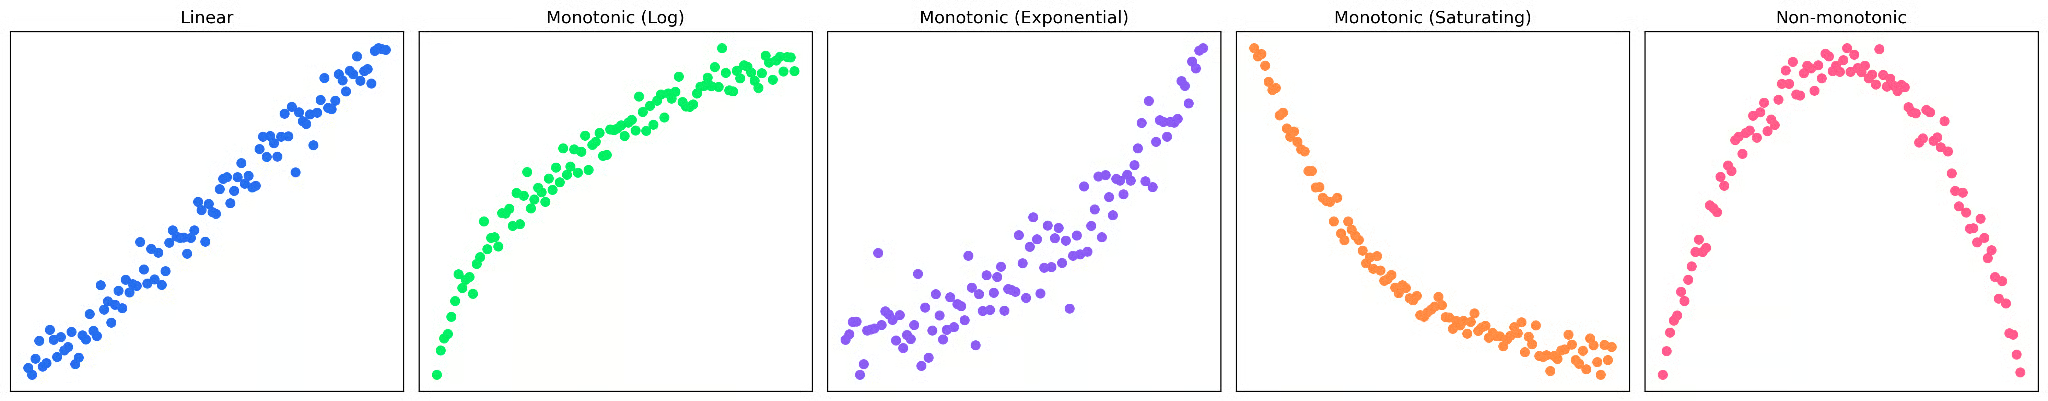
На графиках выше вы видите четыре примера монотонных зависимостей, и только первый из них — линейный. Последний график не является монотонным, так как паттерн меняет направление: начинается положительной связью и заканчивается отрицательной.
|
Тип зависимости |
Описание |
Как выглядит |
|
Линейная |
Переменные увеличиваются или уменьшаются с постоянной скоростью |
Прямая линия |
|
Монотонная (но нелинейная) |
Переменные движутся в одном направлении, но скорость меняется |
Изогнутый тренд, плато или ускорение |
|
Немонотонная |
Зависимость меняет направление (сначала растёт, затем падает, или наоборот) |
U-образная, перевёрнутая U или волнообразная форма |
Как найти ранговую корреляцию Спирмена: пошагово
В общих чертах коэффициент Спирмена работает так: вы преобразуете данные в ранги, а затем измеряете, насколько похожи ранжирования между переменными.
Разберём небольшой пример. Предположим, мы’ изучаем связь между часами, потраченными на практику игры на музыкальном инструменте, и результатом выступления на конкурсе.
|
Студент |
Часы практики (X) |
Оценка выступления (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Сначала построим график данных.
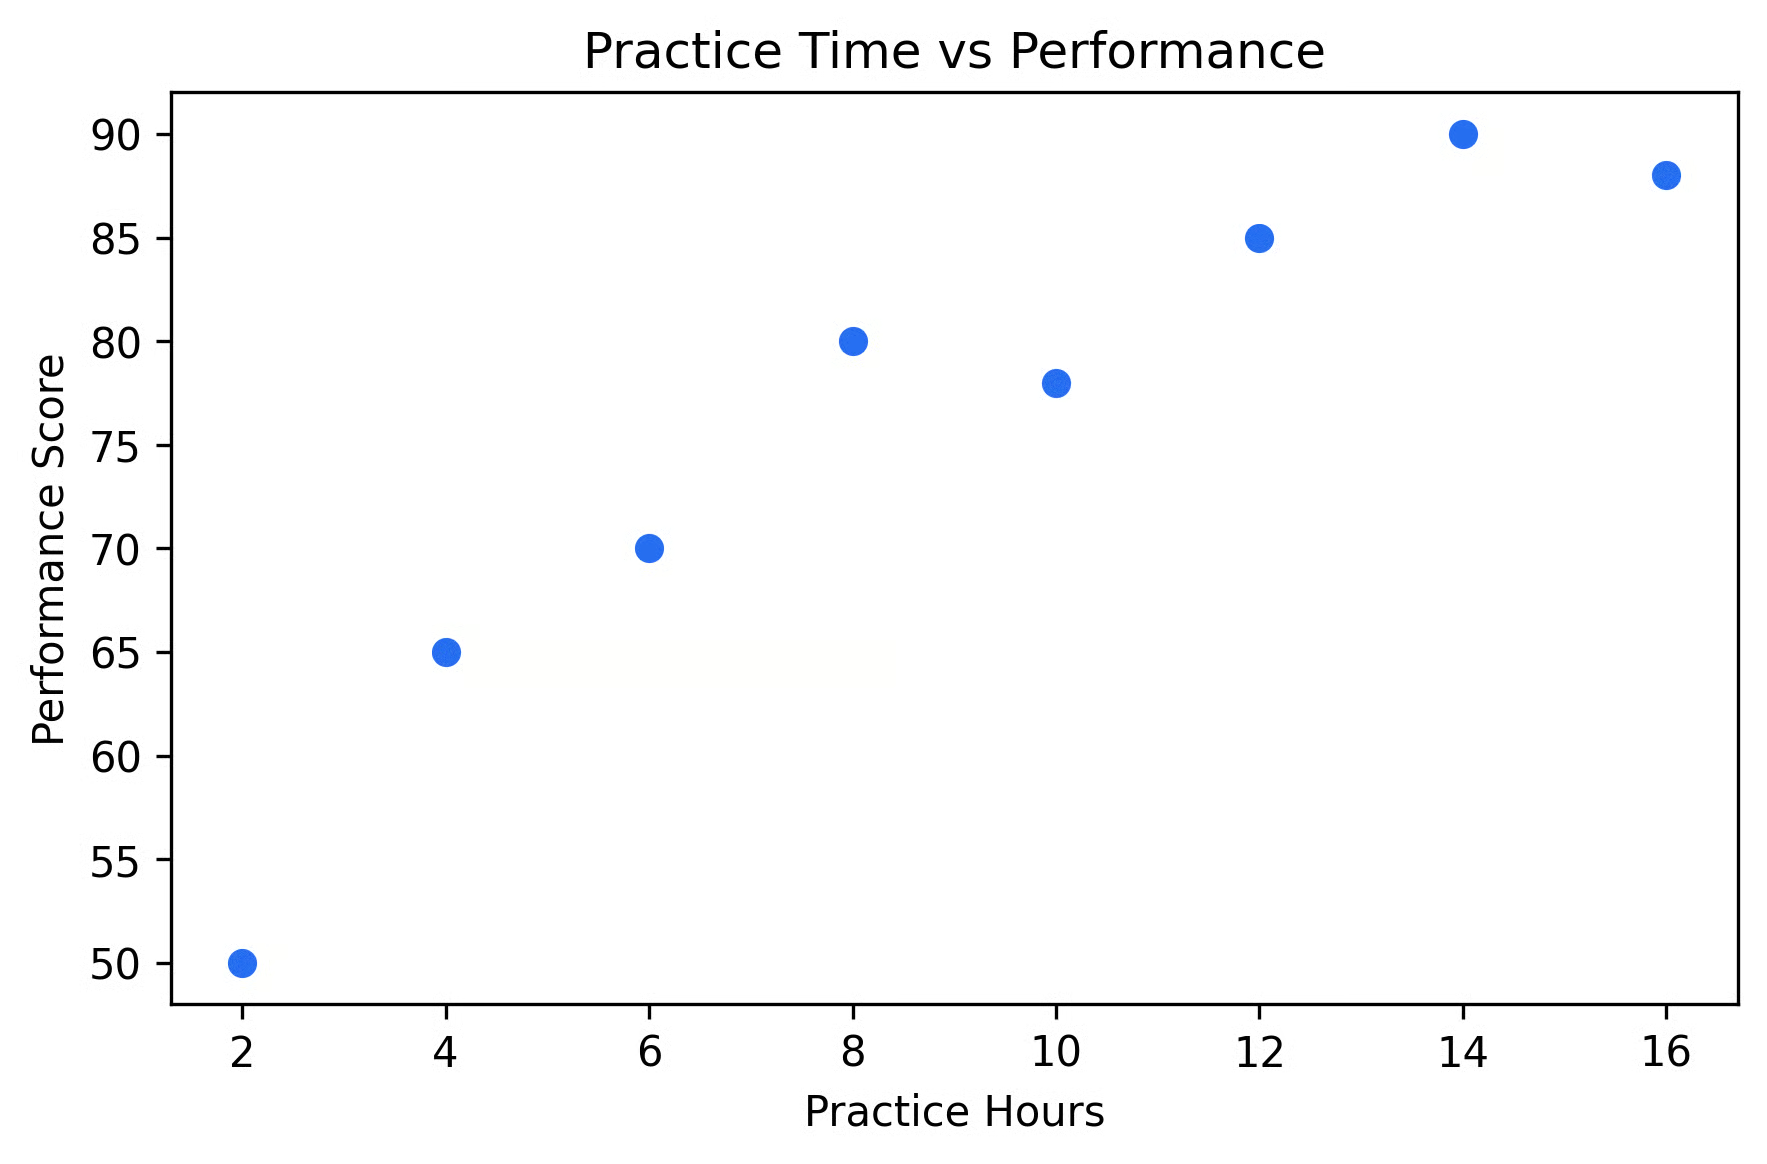
Визуально видно: больше практики — выше оценки, но зависимость не идеально линейная. Похоже, что есть убывающая отдача от чрезмерной практики. Попробуем применить ранги Спирмена, чтобы количественно оценить эту связь.
Шаг 1: преобразовать данные в ранги
Сначала присвоим каждому значению его ранг. Внутри каждой переменной мы ранжируем значения от наименьшего к наибольшему. Наименьшее получает ранг 1, второе по величине — ранг 2 и так далее.
|
Студент |
Часы практики (X) |
Ранг (X) |
Оценка выступления (Y) |
Ранг (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Обратите внимание, что ранги для Y немного отличаются по порядку от X. Именно эту вариацию измеряет корреляция Спирмена.
Шаг 2: вычислить разности рангов
Далее вычисляем разность между рангами для каждого наблюдения.
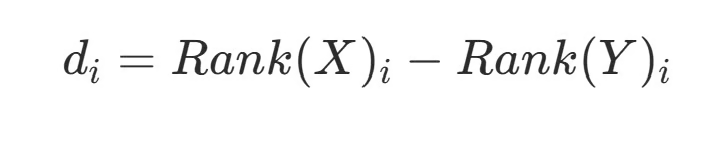
Затем возводим каждую разность в квадрат:
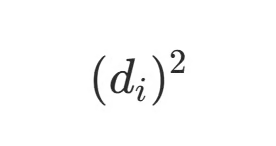
|
Студент |
Ранг(X) |
Ранг(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Теперь суммируем квадраты разностей в последнем столбце нашей таблицы.
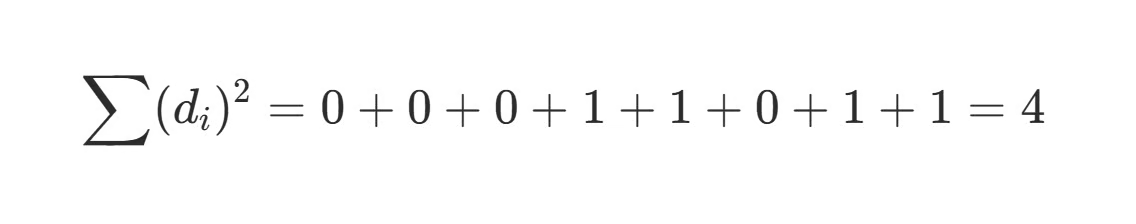
Шаг 3: применить формулу
Наконец, подставим значения в формулу корреляции Спирмена.
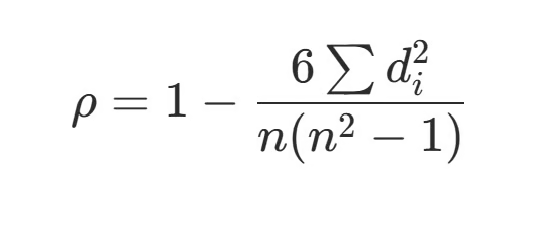
Мы уже знаем, что (di)2=4 из наших расчётов выше. n в знаменателе — объём выборки, у нас это 8. Подставив, получаем:
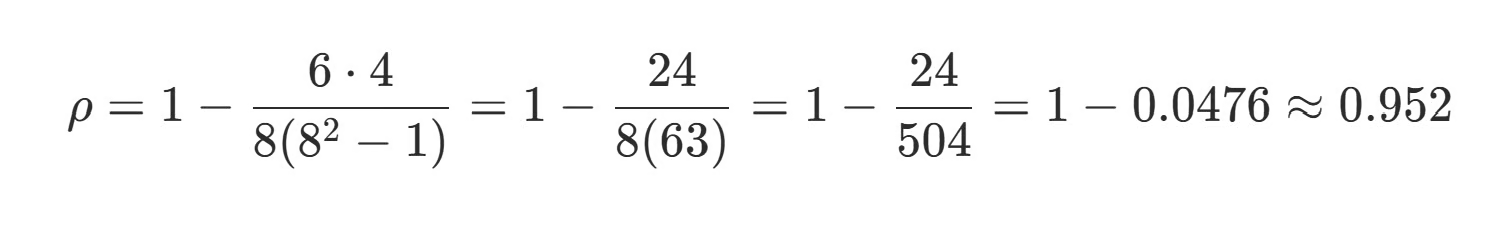
Интерпретация результата
Итоговый результат: ρ ~ 0,95. Поскольку значение близко к +1, это указывает на сильную положительную связь между временем практики и результатом. Хотя зависимость не идеально линейная, ранги очень похожи. Это означает, что при изменении x значение y, как правило, меняется согласованно.
В реальной практике такие расчёты редко выполняют вручную. Большинство программ автоматически обрабатывают ранжирование, учёт совпадений и вычисления — и это хорошо, ведь обычно объёмы данных намного больше!
Вычисление корреляции Спирмена в программах
Сегодня большинство статистических пакетов выполняют этот расчёт за секунды. Кратко рассмотрим самые распространённые варианты.
Python
В Python обычно используют либо scipy, либо pandas — в зависимости от рабочего процесса. Если вы работаете с массивами или списками, scipy предоставляет прямой способ вычислить корреляцию Спирмена.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Функция возвращает сам коэффициент корреляции и p-значение — полезно для статистической проверки гипотез.
Если вы работаете с табличными данными, pandas часто удобнее.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Это вычисляет корреляционную матрицу, что удобно для одновременного сравнения нескольких переменных.
Либо, если нужна корреляция только между двумя конкретными столбцами, это легко указать.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
В R корреляция Спирмена встроена в базовые статистические функции.
Для быстрого расчёта можно использовать cor() и указать метод Спирмена.
cor(x, y, method = "spearman")Если нужен p-значение и дополнительные статистические детали, cor.test() позволяет легко их получить.
cor.test(x,y,method="spearman")Excel
В Excel нет встроенной функции Спирмена, но можно вычислить его в два шага: сначала присвоить ранги, затем взять корреляцию этих рангов.
Небольшой пример:
|
A (X) |
B (Y) |
C (Ранг X) |
D (Ранг Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Ранги (столбцы C и D) можно создать с помощью функции RANK.AVG. Например:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Затем просто вычислите корреляцию Спирмена.
=CORREL(C2:C6, D2:D6)Во всех инструментах суть одна: преобразовать значения в ранги и вычислить корреляцию этих рангов.
Как интерпретировать ранговую корреляцию Спирмена
Если вы уже использовали корреляцию Пирсона, у вас, вероятно, есть хорошая интуиция, как интерпретировать коэффициент Спирмена — по сути, трактовка та же.
Коэффициент Спирмена принимает значения от -1 до 1. Он показывает и направление, и силу монотонной зависимости.
Значение +1 указывает на идеально возрастающую монотонную зависимость: при увеличении одной переменной другая всегда увеличивается. Это происходит, когда ранги каждой пары значений совпадают.
Значение -1 указывает на идеально убывающую монотонную зависимость: при увеличении одной переменной другая всегда уменьшается. Это происходит, когда ранги каждой пары значений полностью противоположны.
Значение 0 означает отсутствие монотонной зависимости. Это когда в рангах нет устойчивого тренда.
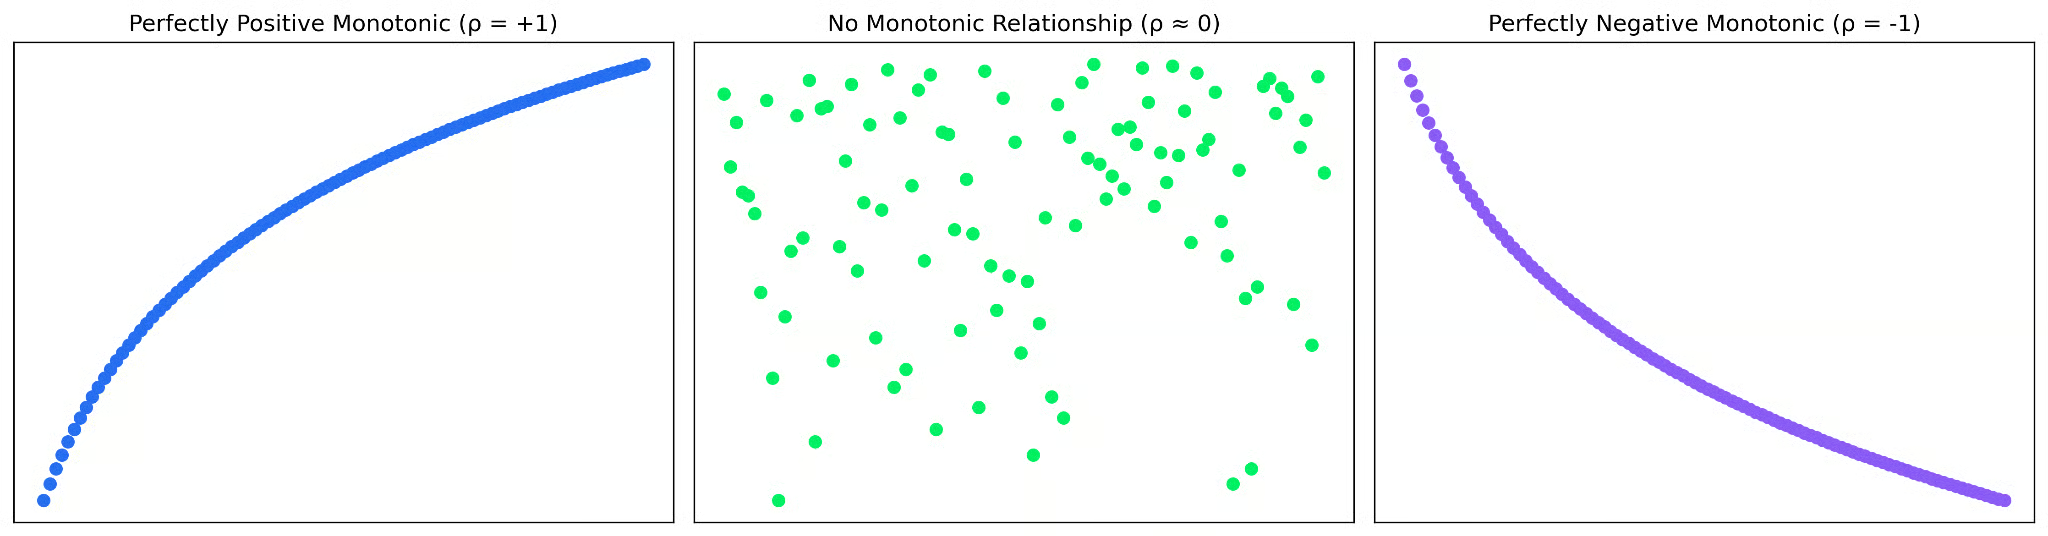
Важно отличие от коэффициента Пирсона: корреляция Спирмена отражает, насколько хорошо согласован порядок данных, а не насколько близко значения ложатся на прямую. То есть сильная корреляция Спирмена указывает на чёткий тренд в рангах, но не обязательно на линейность или равномерность интервалов.
Поэтому всегда полезно дополнять коэффициент корреляции быстрой визуализацией, чтобы лучше понять скрытый паттерн.
Обработка совпадающих рангов
Всё звучит хорошо, пока вы не столкнётесь с набором данных, где несколько наблюдений имеют одинаковое значение. Что делать? Это так называемые совпадения (ties), и при присвоении рангов требуется небольшая корректировка.
Например, значения: 10, 20, 20, 30. Два значения 20 обычно заняли бы ранги 2 и 3. Однако, поскольку они одинаковые, вместо разных рангов каждому присваивается среднее этих рангов: оба 20 получают ранг 2,5. Такой подход обеспечивает корректное обращение с равными значениями и сохраняет согласованность ранжирования.
Поскольку коэффициент Спирмена полностью основан на рангах, некорректная обработка совпадений может исказить корреляцию.
Ограничения корреляции Спирмена
Хотя коэффициент ранговой корреляции Спирмена универсален и широко используется, у него есть ограничения.
Прежде всего, он улавливает только монотонные зависимости. Если зависимость меняет направление — например, U-образная кривая или синусоида, — коэффициент может быть близок к нулю, даже при наличии чёткого паттерна. В таких случаях лучше использовать нелинейные модели, например полиномиальную регрессию.
Кроме того, поскольку корреляция Спирмена основана на рангах, она игнорирует реальные расстояния между значениями. Это помогает устойчивее относиться к выбросам, но означает потерю части информации. Из-за этого величину (масштаб) зависимости сложнее интерпретировать по Спирмену, чем по Пирсону: он показывает, движутся ли переменные «по порядку» вместе, но не то, насколько одна меняется относительно другой.
Наконец, когда много значений совпадают, ранжирование становится менее точным. Это может привести к более слабому значению корреляции и недооценке силы зависимости.
Спирмен vs Пирсон: когда что использовать
Самый распространённый коэффициент — вероятно, корреляция Пирсона. На первый взгляд она похожа на коэффициент Спирмена: названия почти идентичны! Но они отвечают на немного разные вопросы.
Пирсон спрашивает: «Следуют ли переменные линейной зависимости?», а Спирмен — «Движутся ли переменные в одном порядке?»
Если ваши данные примерно ложатся на прямую, и важны реальные расстояния между значениями, обычно подходит корреляция Пирсона. Но если зависимость изгибается или выходит на плато, лучше подходит Спирмен.
Спирмен также более «прощает». Поскольку он работает с рангами, а не с исходными значениями, он менее чувствителен к выбросам и меньше зависит от предположений о данных. Обратная сторона — хуже передаёт различия в величине между значениями.
Практическое правило: если зависимость линейная — используйте Пирсона; если монотонная, но не линейная — Спирмена. И, как всегда, сначала визуализируйте данные, прежде чем принимать решение.
Выводы
Коэффициент корреляции Спирмена — отличный инструмент для выявления монотонных паттернов, особенно в наборах данных, где корреляция Пирсона работает хуже. Использование рангов делает его менее чувствительным к выбросам и более приспособленным к нелинейным данным.
Подробнее о выборе подходящего коэффициента корреляции для вашего набора данных — в статье Understanding Correlation: Measuring Relationships in Data. Также может быть полезна статья Understanding Covariance: An Introductory Guide.