Alla samband följer inte en rak linje.
Du kan till exempel se att kundkonverteringen tenderar att förbättras när marknadsföringsbudgeten ökar, men inte i en jämn takt. Eller att lyckan ofta ökar i takt med inkomsten, men sedan planar ut. Mönstret är tydligt, men det är inte linjärt. Hur kan du kvantifiera det?
Korrelation används för att beskriva hur två variabler samvarierar. En vanlig korrelation du kommer att stöta på är Pearsons korrelationskoefficient, som w fungerar mycket bra för linjära samband. Men många verkliga samband är inte linjära. De kan svänga, plana ut eller följa en konsekvent trend utan att bilda en rak linje. I vissa fall är den exakta storleken mindre viktig än ordningen i vilken värdena förekommer. Det är här Spearmans rangkorrelationskoefficient kommer in.
Spearmans korrelation arbetar med rangordningar i stället för råvärden och mäter om två variabler tenderar att öka eller minska tillsammans på ett konsekvent sätt. Det gör den väl lämpad för monotona samband. Den är också mer robust mot vissa egenheter i data, som avvikare eller ojämna avstånd.
Vad är Spearmans rangkorrelation?
Spearmans rangkorrelationskoefficient är ett mått på styrkan och riktningen i ett samband mellan två variabler. Den bygger på värdenas rangordning i stället för värdena själva.
Föreställ dig till exempel att du analyserar låtar på en streamingplattform. Du kanske jämför hur många gånger en låt spelas med dess placering på en ”Top 100”-lista. Sambandet är kanske inte perfekt linjärt – att dubbla antalet strömmar fördubblar inte nödvändigtvis låtens position. Men generellt tenderar låtar med fler strömmar att placera sig högre.
Spearmans korrelation fångar den här typen av mönster genom att fokusera på ordningen i datan snarare än på exakta värden.
Det gör den särskilt användbar när sambandet inte är linjärt men ändå följer en tydlig trend, när data naturligt uttrycks som rangordningar eller när datan innehåller avvikare som kan förvränga ett linjärt mått.
Till skillnad från Pearsons korrelation, som arbetar direkt med råvärden, konverterar Spearmans korrelation först datan till rangordningar och mäter sedan hur väl dessa rangordningar stämmer överens.
Tekniskt sett mäter Spearmans korrelation monotona samband. Ett samband är monotont om den ena variabeln tenderar att öka när den andra ökar, eller minska när den andra minskar, utan att byta riktning.
Monotona vs. linjära samband
Vad är då egentligen skillnaden mellan linjära och monotona samband?
Ett linjärt samband är ett där datan följer ett raklinjigt mönster. Om du plottade datan skulle du se punkter som ungefär bildar en linje.
Ett monotont samband är å andra sidan mindre strikt. Det betyder helt enkelt att sambandet rör sig i en riktning. I praktiken rör sig båda variablerna tillsammans, men inte nödvändigtvis i en rak linje. Mönstret kan svänga, plana ut eller ändra takt, så länge det inte vänder riktning.
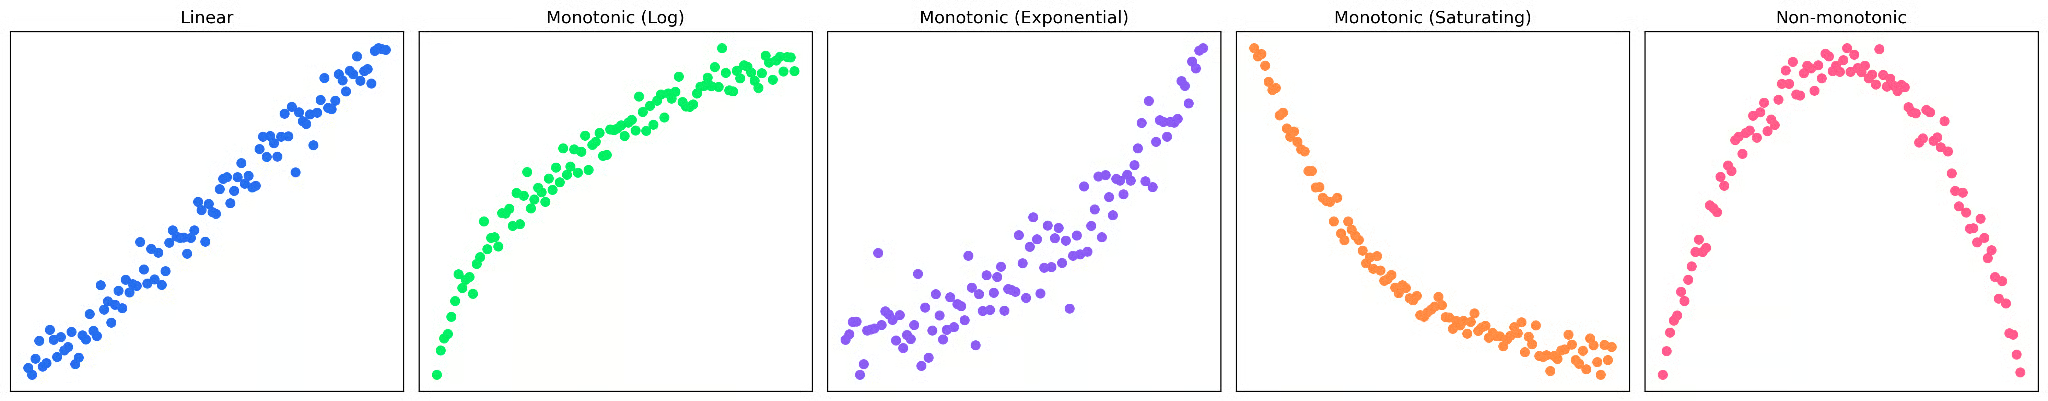
I diagrammen ovan ser du fyra olika exempel på monotona samband, varav bara det första är linjärt. Det sista diagrammet är inte monotont, eftersom mönstret byter riktning – det börjar som ett positivt samband och slutar som ett negativt.
|
Typ av samband |
Beskrivning |
Så ser det ut |
|
Linjärt |
Variabler ökar eller minskar i jämn takt |
Rak linje |
|
Monotont (men icke-linjärt) |
Variabler rör sig i en riktning, men takten förändras |
Kurvigt, avplanande eller accelererande mönster |
|
Icke-monotont |
Sambandet byter riktning (ökar, sedan minskar, eller tvärtom) |
U-form, inverterad U eller vågformigt mönster |
Så hittar du Spearmans rangkorrelation steg för steg
På en övergripande nivå fungerar Spearmans rangkorrelationskoefficient genom att konvertera din data till rangordningar och sedan mäta hur lika rangordningarna är mellan variablerna.
Låt oss gå igenom ett litet exempel. Anta att vi tittar på sambandet mellan antal timmar som läggs på att öva ett musikinstrument och prestationsrankning i en tävling.
|
Elev |
Övningstimmar (X) |
Prestationspoäng (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Först plottar vi datan.
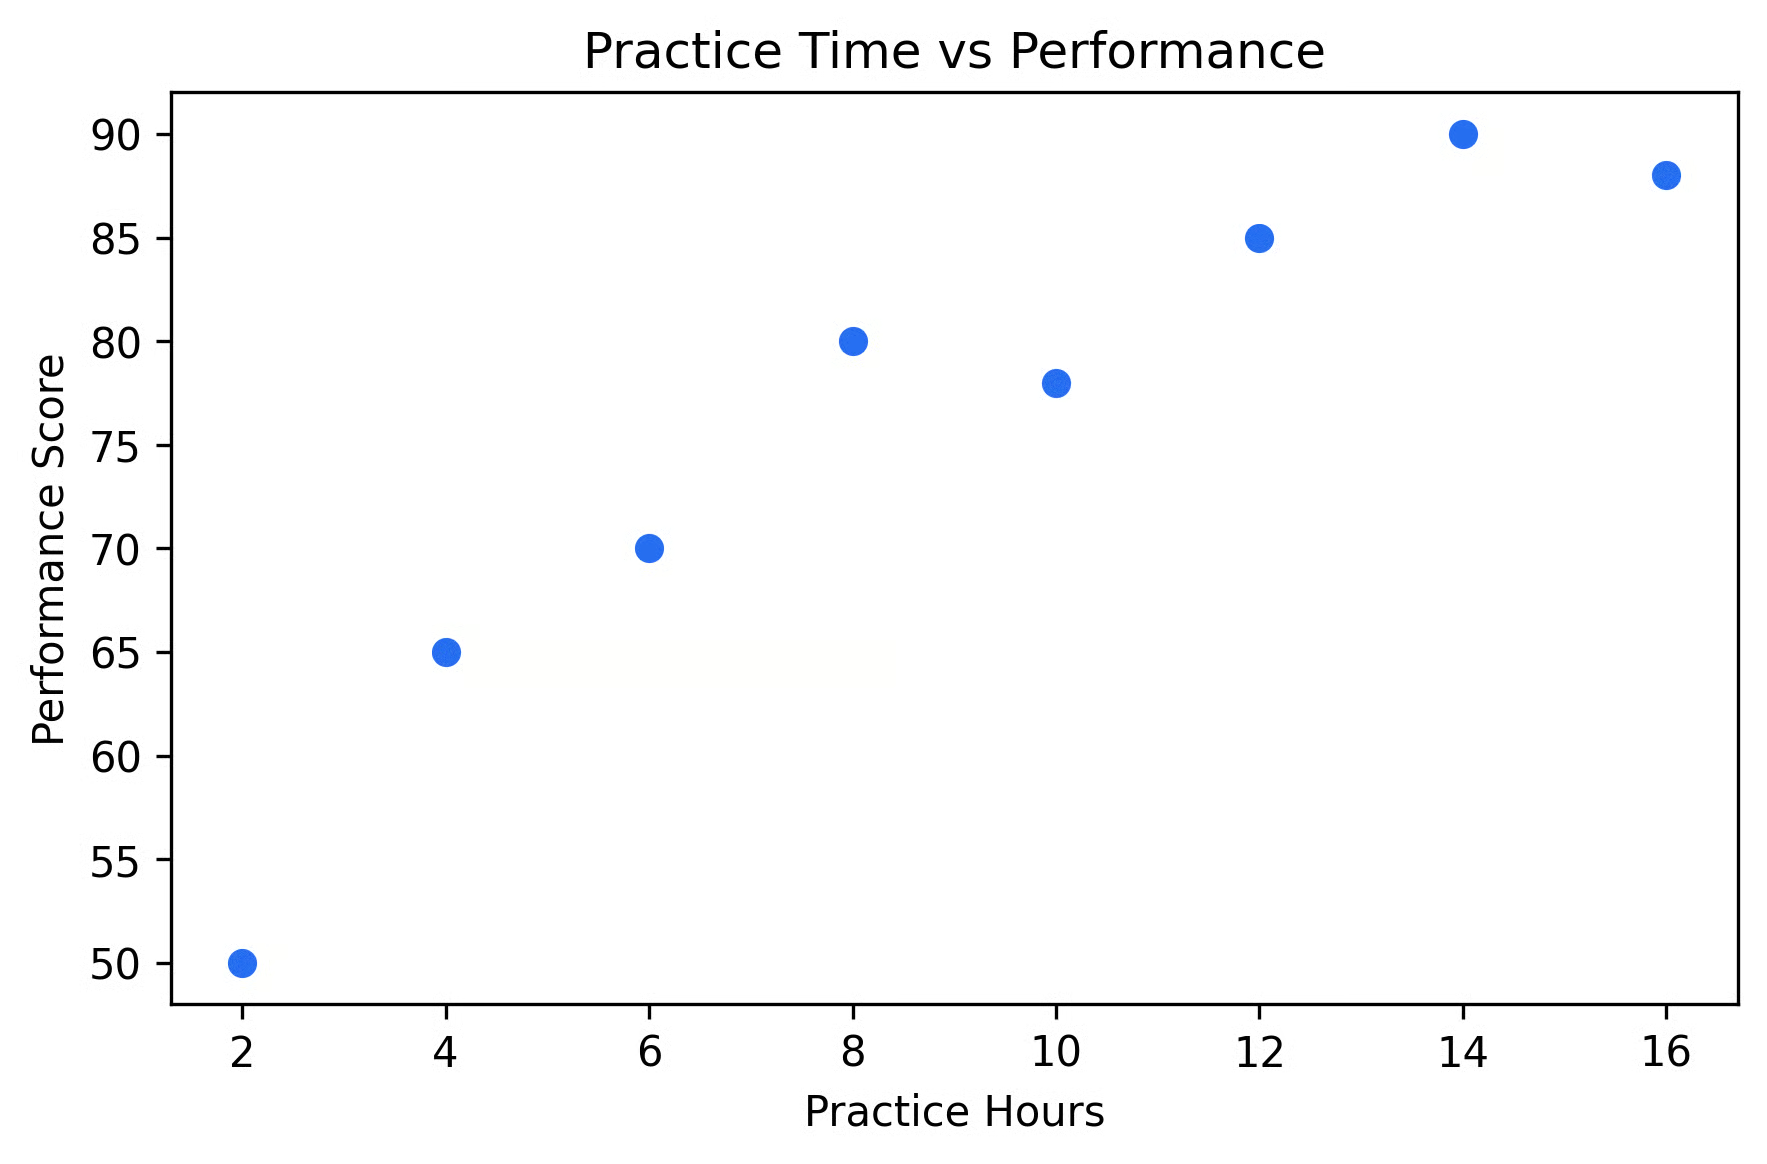
Visuellt verkar mer övning ge högre prestationspoäng, men mönstret ser inte perfekt linjärt ut. Det verkar finnas avtagande avkastning av att öva för mycket. Låt oss prova Spearmans rang för att kvantifiera detta samband.
Steg 1: konvertera data till rangordningar
Vi börjar med att ge varje värde en rang. Inom varje variabel tilldelar vi en rang till varje värde från minst till störst. Det minsta värdet inom en variabel får rang 1, det näst minsta får rang 2, och så vidare.
|
Elev |
Övningstimmar (X) |
Rang (X) |
Prestationspoäng (Y) |
Rang (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Observera att rangordningarna för Y är i en något annan ordning än X. Det är denna variation som Spearmans korrelation mäter.
Steg 2: beräkna skillnader i rang
Nästa steg är att beräkna skillnaden mellan rangordningarna för varje observation.
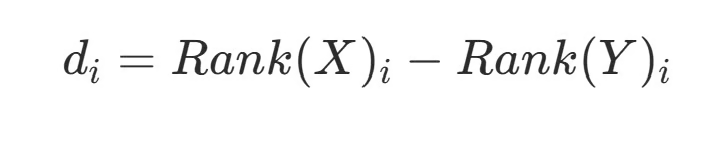
Kvadrera sedan varje skillnad:
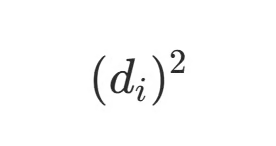
|
Elev |
Rang(X) |
Rang(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Nu summerar vi de kvadrerade skillnaderna i den sista kolumnen i tabellen.
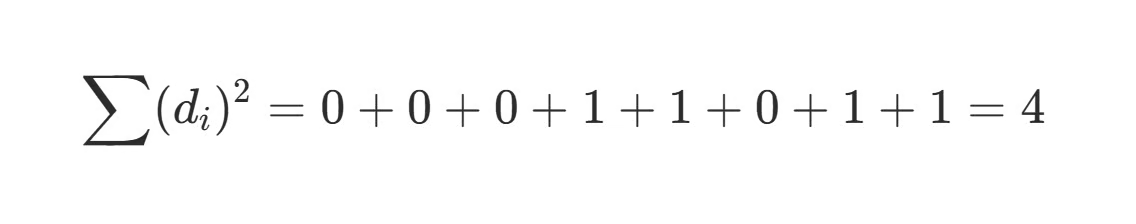
Steg 3: tillämpa formeln
Till sist sätter vi in värdena i Spearmans korrelationsformel.
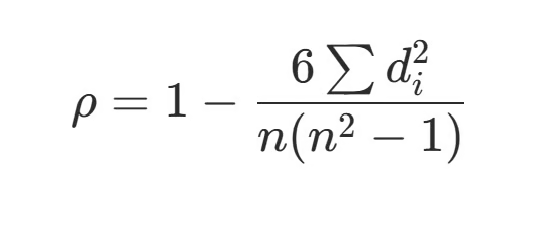
Vi vet redan att (di)2=4 från våra tidigare beräkningar. n i nämnaren är stickprovsstorleken, som för oss är 8. Med det insatt får vi:
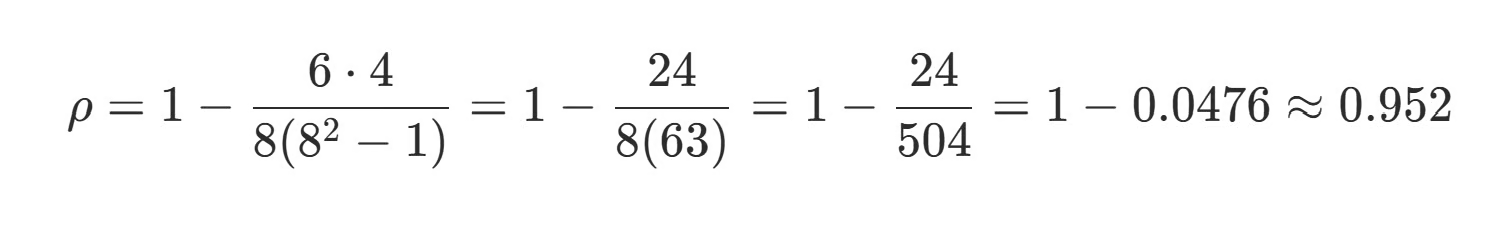
Tolka resultatet
Vårt slutliga resultat är ρ ~ 0,95. Eftersom värdet ligger nära +1 indikerar det ett starkt positivt samband mellan övningstid och prestation. Även om sambandet inte är perfekt linjärt är rangordningarna mycket lika. Det betyder att när x-värdet ändras tenderar y-värdet att ändras konsekvent tillsammans med det.
I verkligheten räknar man sällan detta för hand. De flesta program hanterar rangordning, ties och beräkning automatiskt, vilket är bra eftersom vi oftast har mycket större stickprov!
Beräkna Spearmans korrelation med programvara
De flesta statistiska program i dag kan göra denna beräkning på några sekunder. Låt oss kort gå igenom några av de vanligaste.
Python
I Python använder du vanligtvis antingen scipy eller pandas, beroende på arbetsflöde. Om du arbetar med arrayer eller listor ger scipy ett direkt sätt att beräkna Spearmans korrelation.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Detta returnerar både korrelationskoefficienten och ett p-värde, vilket är användbart om du gör statistiska tester.
Om du arbetar med tabulär data är pandas ofta smidigare.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Detta beräknar korrelationsmatrisen, vilket gör det enkelt att jämföra flera variabler samtidigt.
Alternativt, om du bara vill ha korrelationen mellan två specifika kolumner, är det lätt att ange det.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
I R är Spearmans korrelation inbyggd i de grundläggande statistiska funktionerna.
För en snabb beräkning kan du använda cor() och ange att du vill använda Spearmans metod.
cor(x, y, method = "spearman")Om du också vill ha ett p-värde och ytterligare statistiska detaljer ger cor.test() detta enkelt.
cor.test(x,y,method="spearman")Excel
Excel har ingen inbyggd Spearman-funktion, men du kan beräkna den i två snabba steg: först rangordnar du datan, sedan tar du korrelationen av dessa rangordningar.
Här är ett litet exempel:
|
A (X) |
B (Y) |
C (Rang X) |
D (Rang Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Du kan skapa rangordningarna (kolumnerna C och D) med funktionen RANK.AVG. Till exempel:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Beräkna sedan enkelt Spearmans korrelation.
=CORREL(C2:C6, D2:D6)I alla dessa verktyg är processen densamma: konvertera värden till rangordningar och beräkna sedan korrelationen av dessa rangordningar.
Hur man tolkar Spearmans rangkorrelation
Om du har använt Pearsons korrelation tidigare har du förmodligen ganska bra intuition för hur du tolkar Spearmans rangkorrelation, eftersom tolkningen i princip är densamma.
Spearmans rang ger dig ett värde mellan -1 och 1. Detta talar om både riktning och styrka i ett monotont samband.
Ett värde på +1 indikerar ett perfekt ökande monotont samband; när den ena variabeln ökar ökar den andra alltid. Detta sker när rangordningarna i varje värdepar är exakt desamma.
Ett värde på -1 indikerar ett perfekt avtagande monotont samband; när den ena variabeln ökar minskar den andra alltid. Detta sker när rangordningarna i varje värdepar är exakt omvända.
Ett värde på 0 indikerar inget monotont samband. Detta sker när det inte finns någon konsekvent trend i rangordningarna.
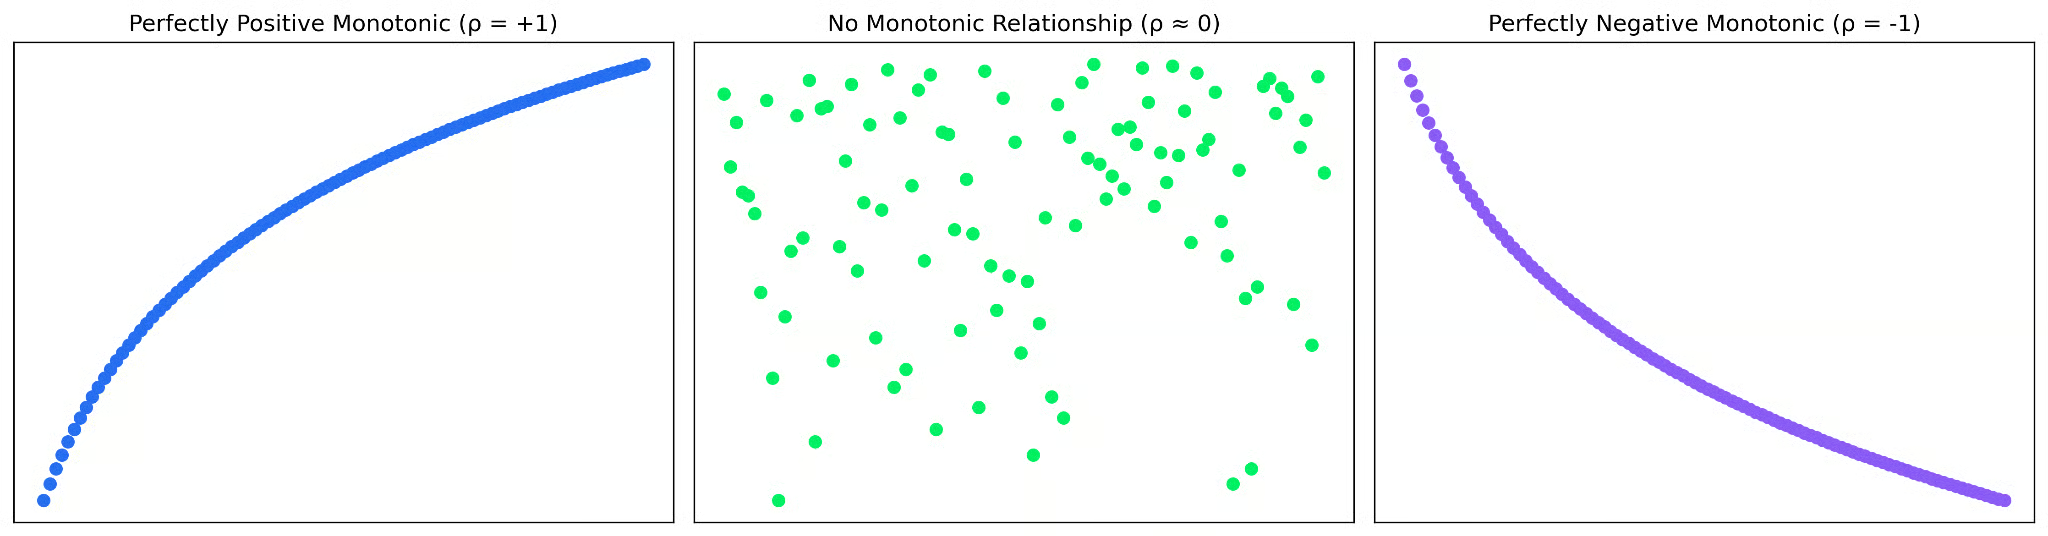
En viktig skillnad mot Pearsons korrelationskoefficient är att Spearmans korrelation speglar hur väl ordningen i datan stämmer överens, inte hur nära de faktiska värdena följer en rak linje. Det betyder att en stark Spearman-korrelation indikerar en tydlig trend i rangordningarna, men inte nödvändigtvis att sambandet är linjärt eller jämnt fördelat.
Av den anledningen är det alltid en bra idé att kombinera korrelationsvärden med en snabb visualisering för att bäst förstå det underliggande mönstret.
Hantering av ties i rangordningar
Allt detta låter bra tills du stöter på en datamängd där flera observationer har samma värde. Vad gör du då? Dessa kallas ties, och de kräver en liten justering när man tilldelar rang.
Betrakta till exempel värdena: 10, 20, 20, 30. De två värdena 20 skulle normalt uppta rang 2 och 3. Eftersom de är lika tilldelar vi dem i stället medelvärdet av dessa rangordningar; båda 20:orna får rang 2,5. Detta tillvägagångssätt säkerställer att lika värden behandlas rättvist och att den övergripande rangordningen förblir konsekvent.
Eftersom Spearmans rangkorrelationskoefficient helt bygger på rangordningar kan korrelationen förvrängas om ties inte hanteras korrekt.
Begränsningar med Spearmans korrelation
Även om Spearmans rangkorrelationskoefficient är ett flexibelt och allmänt använt mått har den vissa begränsningar.
Framför allt kan den bara fånga monotona samband. Om ett samband byter riktning, till exempel ett U-format mönster eller en sinusvåg, kan korrelationen ligga nära noll även när ett tydligt mönster finns. I dessa fall är en icke-linjär modell, såsom polynomregression, oftast bättre.
Och eftersom Spearmans korrelation bygger på rangordningar ignorerar den de faktiska avstånden mellan värden. Det gör den bättre på att hantera avvikare, men innebär också att viss information går förlorad. Storleken på sambandet är svårare att tolka med Spearmans korrelation än med Pearsons, just därför. Den talar om huruvida variabler rör sig tillsammans i ordning, men inte hur mycket den ena förändras relativt den andra.
Slutligen, när många värden är lika blir rangordningsprocessen mindre precis. Detta kan resultera i ett svagare korrelationsvärde som potentiellt inte speglar sambandet fullt ut.
Spearman vs. Pearson: när ska du använda vilken?
Det mest använda korrelationsmåttet är sannolikt Pearsons korrelationskoefficient. Vid första anblick kan det verka mycket likt Spearmans korrelationskoefficient. De har till och med nästan identiska namn! Men de besvarar något olika frågor.
Pearson frågar: ”Följer dessa variabler ett raklinjigt samband?”, medan Spearman frågar: ”Rör sig dessa variabler i samma ordning?”
Om din data följer ett ungefärligt raklinjigt mönster och de faktiska avstånden mellan värden är meningsfulla är Pearsons korrelation oftast rätt val. Men om sambandet svänger eller planar ut är Spearman oftast en bättre passform.
Spearman är också mer förlåtande. Eftersom den arbetar med rangordningar i stället för råvärden är den mindre känslig för avvikare och förlitar sig inte lika mycket på antaganden om datan. Nackdelen är att den inte är lika bra på att fånga skillnader i storlek mellan värden.
I praktiken kan du följa denna tumregel: om sambandet är linjärt, använd Pearson; om det är monotont men inte linjärt, använd Spearman. Och som alltid, plotta din data innan du bestämmer dig.
Slutsats
Spearmans korrelationskoefficient är ett utmärkt verktyg för att fånga monotona mönster, särskilt i datamängder där Pearsons korrelation inte fungerar lika bra. Genom att arbeta med rangordningar är den mindre känslig för avvikare och mer tillåtande för icke-linjär data.
Du kan läsa mer om hur du väljer bästa korrelationen för din datamängd i Understanding Correlation: Measuring Relationships in Data. Du kanske också är intresserad av Understanding Covariance: An Introductory Guide.