Non tutte le relazioni seguono una linea retta.
Potresti notare che all’aumentare del budget marketing il tasso di conversione migliora, ma non a un ritmo costante. Oppure, con l’aumentare del reddito, la felicità spesso cresce, poi si stabilizza. Il pattern è chiaro, ma non lineare. Come puoi quantificarlo?
La correlazione descrive come due variabili si muovono insieme. Una correlazione comune è il coefficiente di correlazione di Pearson, che funziona molto bene per relazioni lineari. Tuttavia, molte relazioni del mondo reale non sono lineari. Possono curvare, appiattirsi o seguire un trend costante senza formare una linea retta. In alcuni casi, contano meno i valori esatti rispetto all’ordine in cui si presentano. Qui entra in gioco il coefficiente di correlazione per ranghi di Spearman.
La correlazione di Spearman lavora con i ranghi invece che con i valori grezzi, misurando se due variabili tendono ad aumentare o diminuire insieme in modo coerente. È quindi adatta alle relazioni monotone. Inoltre è più robusta a certe particolarità dei dati, come outlier o spaziature irregolari.
Che cos’è la correlazione per ranghi di Spearman?
Il coefficiente di correlazione per ranghi di Spearman misura l’intensità e la direzione della relazione tra due variabili. Si basa sul rango dei loro valori invece che sui valori stessi.
Per capire come funziona, immagina di analizzare brani su una piattaforma di streaming. Potresti confrontare il numero di riproduzioni con la posizione in una classifica “Top 100”. La relazione potrebbe non essere perfettamente lineare: raddoppiare gli ascolti non raddoppia necessariamente la posizione in classifica. Ma in generale, i brani con più stream tendono a posizionarsi più in alto.
La correlazione di Spearman cattura questo tipo di pattern concentrandosi sull’ordine dei dati invece che sui valori esatti.
È particolarmente utile quando la relazione non è lineare ma segue comunque un trend chiaro, quando i dati sono naturalmente espressi come classifiche, o quando ci sono outlier che potrebbero distorcere una misura lineare.
A differenza della correlazione di Pearson, che lavora direttamente con i valori grezzi, la correlazione di Spearman prima converte i dati in ranghi e poi misura quanto questi ranghi siano allineati tra loro.
In termini tecnici, la correlazione di Spearman misura le relazioni monotone. Una relazione è monotona se una variabile tende ad aumentare quando l’altra aumenta, o a diminuire quando l’altra diminuisce, senza invertire direzione.
Relazioni monotone vs. lineari
Qual è esattamente la differenza tra relazioni lineari e monotone?
Una relazione lineare è quella in cui i dati seguono un andamento a linea retta. Se li tracci, vedresti punti che formano approssimativamente una linea.
Una relazione monotona, invece, è meno rigida. Significa semplicemente che la relazione si muove in un’unica direzione. In sostanza, le due variabili si muovono insieme, ma non necessariamente in linea retta. Il pattern può curvare, appiattirsi o cambiare ritmo, purché non inverta direzione.
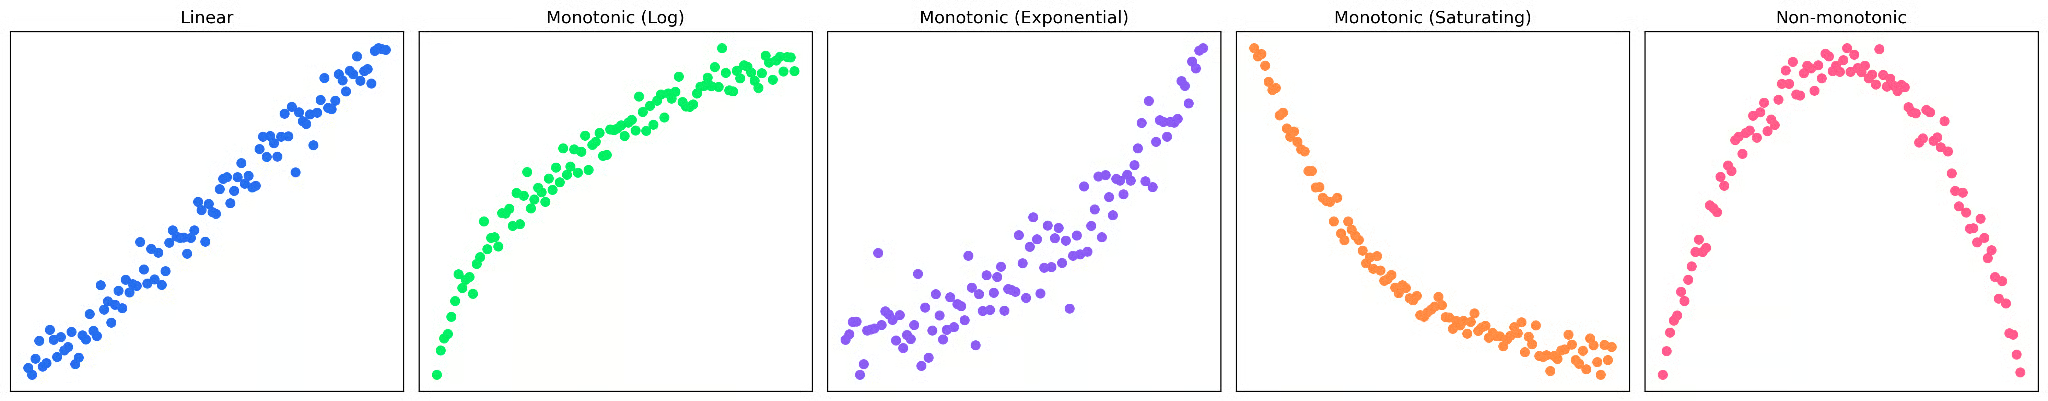
Nei grafici sopra, puoi vedere quattro esempi diversi di relazioni monotone, di cui solo il primo è lineare. L’ultimo grafico non è monotono, perché il pattern cambia direzione, iniziando come un’associazione positiva e finendo come una negativa.
|
Tipo di relazione |
Descrizione |
Come appare |
|
Lineare |
Le variabili aumentano o diminuiscono a un ritmo costante |
Linea retta |
|
Monotona (ma non lineare) |
Le variabili si muovono in un’unica direzione, ma il ritmo cambia |
Trend curvo, che si appiattisce o accelera |
|
Non monotona |
La relazione cambia direzione (prima aumenta, poi diminuisce, o viceversa) |
Forma a U, U rovesciata o andamento ondulato |
Come trovare la correlazione di Spearman passo dopo passo
A livello generale, il coefficiente di correlazione per ranghi di Spearman funziona convertendo i dati in ranghi e poi misurando quanto i ranghi siano simili tra le variabili.
Vediamolo con un piccolo esempio. Supponi che stiamo osservando la relazione tra ore passate a esercitarsi con uno strumento musicale e il posizionamento in una gara.
|
Studente |
Ore di pratica (X) |
Punteggio di performance (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Per prima cosa, tracciamo i dati.
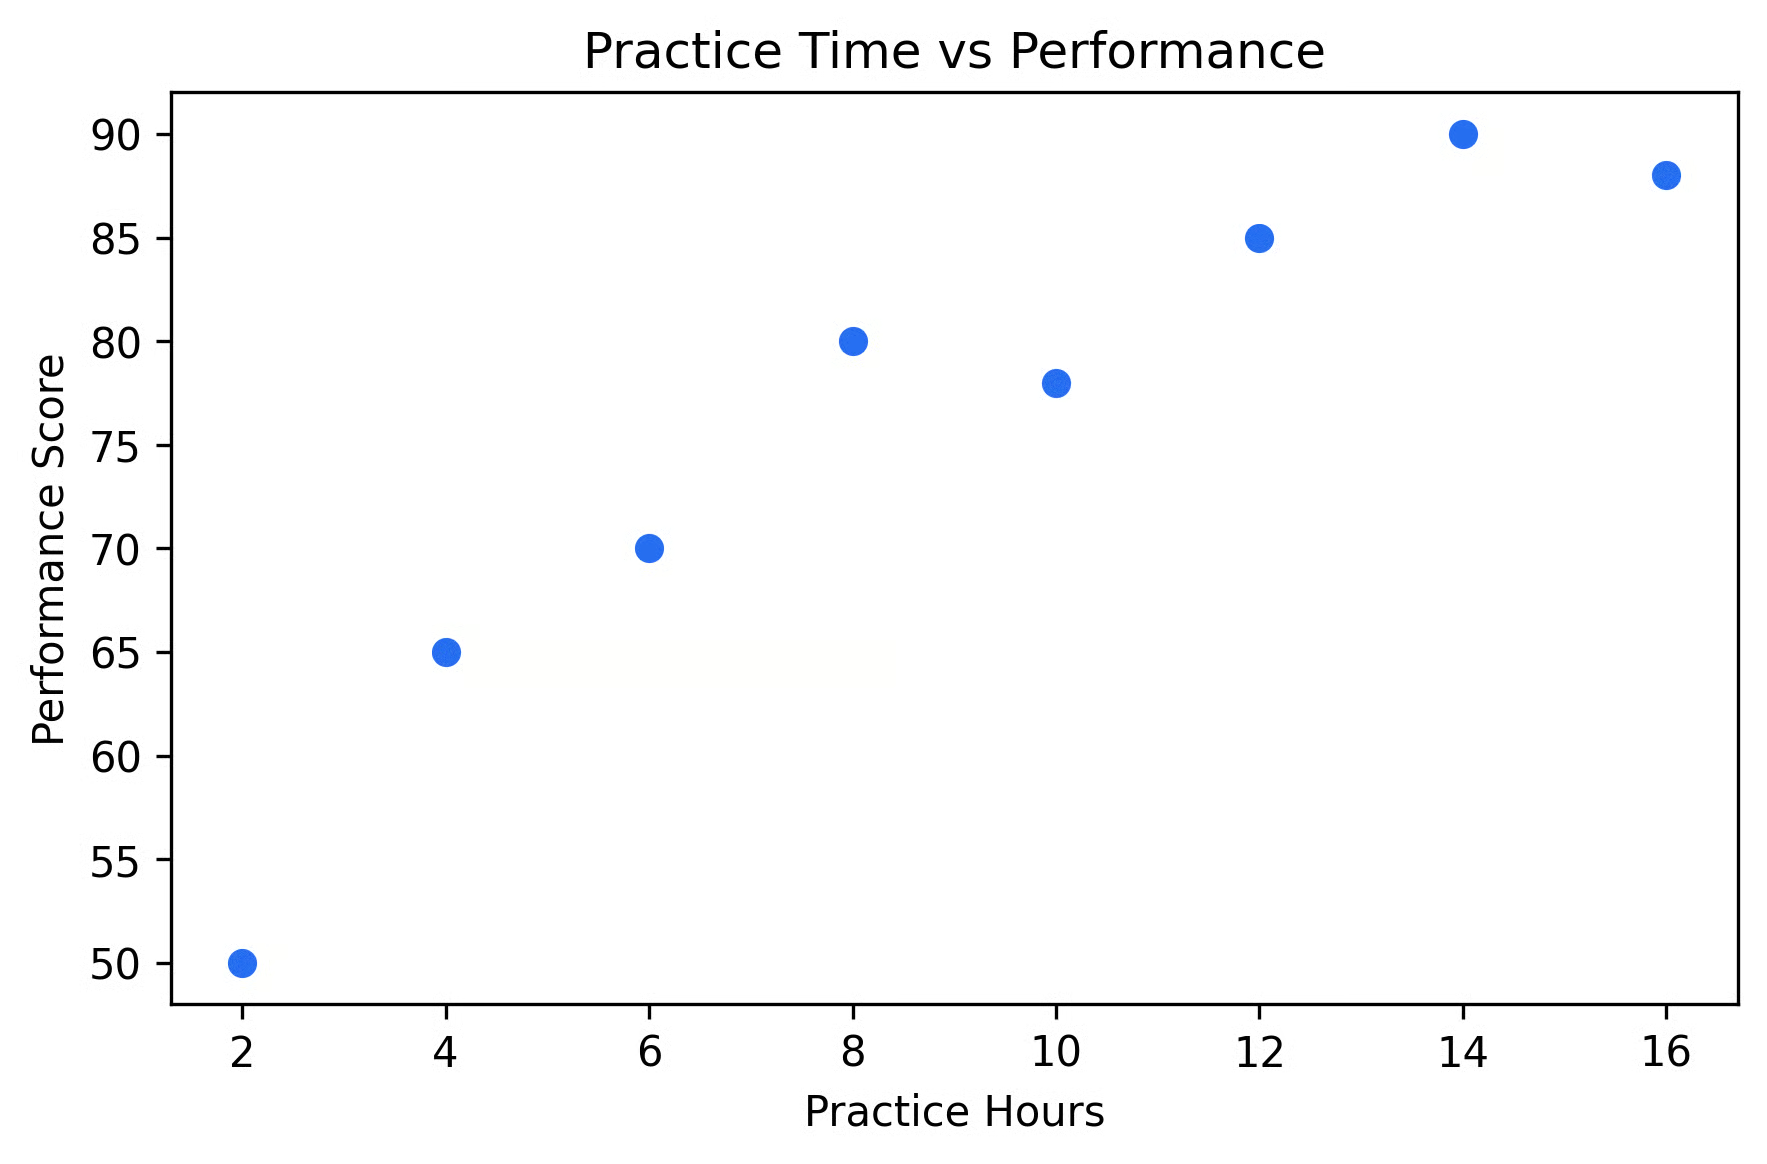
Visivamente, sembra che più pratica porti a punteggi più alti, ma il pattern non appare perfettamente lineare. Sembra ci siano rendimenti decrescenti quando si pratica troppo. Proviamo ad applicare i ranghi di Spearman per quantificare questa relazione.
Passo 1: converti i dati in ranghi
Per prima cosa, assegniamo a ciascun valore il suo rango. All’interno di ogni variabile, assegniamo un rango a ciascun valore dal più piccolo al più grande. Il valore più piccolo in una variabile ottiene il rango 1, il secondo più piccolo il rango 2, e così via.
|
Studente |
Ore di pratica (X) |
Rango (X) |
Punteggio di performance (Y) |
Rango (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Nota che le classifiche per Y sono in un ordine leggermente diverso rispetto a X. È questa variazione che la correlazione di Spearman misurerà.
Passo 2: calcola le differenze tra i ranghi
Successivamente, calcoliamo la differenza tra i ranghi per ciascuna osservazione.
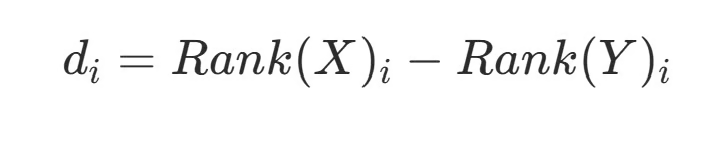
Poi eleviamo al quadrato ciascuna differenza:
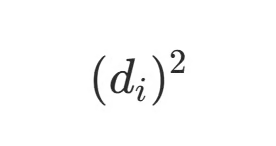
|
Studente |
Rango(X) |
Rango(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Ora sommiamo le differenze quadrate nell’ultima colonna della tabella.
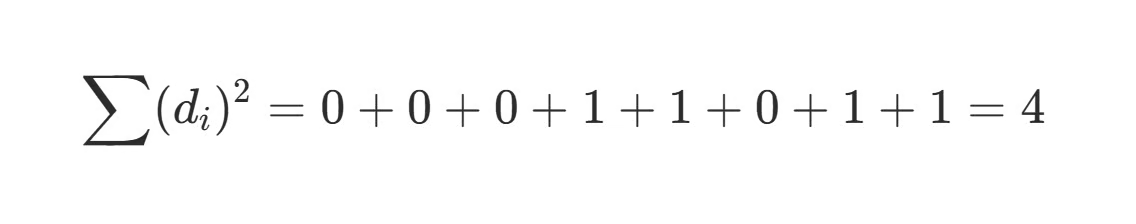
Passo 3: applica la formula
Infine, inseriamo i valori nella formula della correlazione di Spearman.
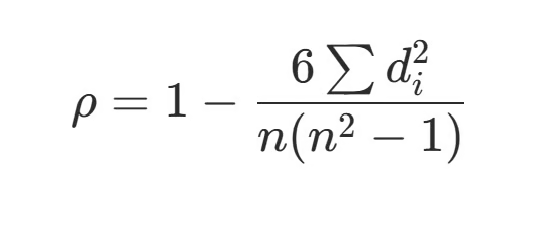
Sappiamo già che (di)2=4 dai nostri calcoli precedenti. La n al denominatore è la dimensione del campione, che per noi è 8. Inserendo i valori, otteniamo:
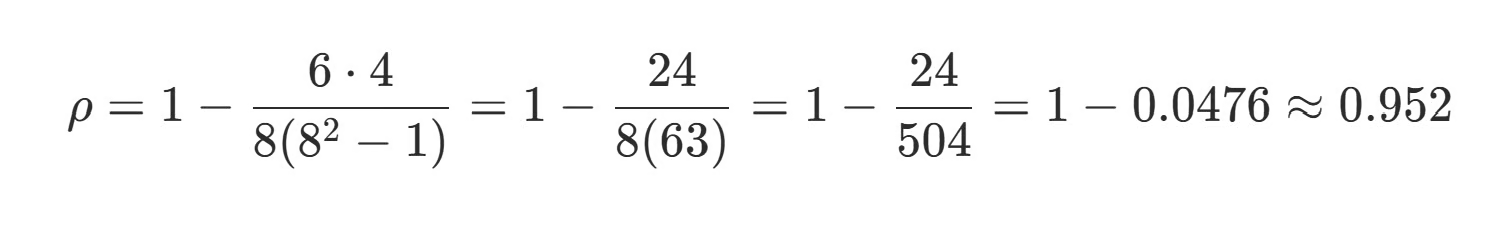
Interpretazione del risultato
Il risultato finale è ρ ~ 0,95. Poiché questo valore è vicino a +1, indica una forte relazione positiva tra tempo di pratica e performance. Anche se la relazione non è perfettamente lineare, i ranghi sono molto simili. Questo significa che quando il valore di x cambia, il valore di y tende a cambiare in modo coerente insieme a lui.
Nella pratica, è piuttosto raro fare questi calcoli a mano. La maggior parte dei software gestisce automaticamente ranking, pareggi e calcoli, il che è utile dato che in genere abbiamo campioni molto più grandi!
Calcolare la correlazione di Spearman con il software
Oggi la maggior parte dei software statistici esegue questo calcolo in pochi secondi. Vediamo brevemente i più comuni.
Python
In Python, in genere usi scipy o pandas, a seconda del flusso di lavoro. Se lavori con array o liste, scipy offre un modo diretto per calcolare la correlazione di Spearman.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Questo restituisce sia il coefficiente di correlazione che un p-value, utile se stai facendo test statistici.
Se lavori con dati tabulari, pandas è spesso più comodo.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Questo calcola la matrice di correlazione, rendendo facile confrontare più variabili in una volta.
In alternativa, se vuoi solo la correlazione tra due colonne specifiche, puoi specificarlo con facilità.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
In R, la correlazione di Spearman è inclusa nelle funzioni statistiche di base.
Per un calcolo rapido, puoi usare cor() specificando il metodo Spearman.
cor(x, y, method = "spearman")Se vuoi anche il p-value e dettagli statistici aggiuntivi, cor.test() lo fornisce facilmente.
cor.test(x,y,method="spearman")Excel
Excel non ha una funzione Spearman integrata, ma puoi calcolarla in due passaggi rapidi: prima classifica i dati, poi calcola la correlazione di quei ranghi.
Ecco un piccolo esempio:
|
A (X) |
B (Y) |
C (Rango X) |
D (Rango Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Puoi creare i ranghi (colonne C e D) usando la funzione RANK.AVG. Per esempio:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Poi, calcola semplicemente la correlazione di Spearman.
=CORREL(C2:C6, D2:D6)In tutti questi strumenti, il processo di base è lo stesso: convertire i valori in ranghi e poi calcolare la correlazione di quei ranghi.
Come interpretare la correlazione per ranghi di Spearman
Se hai già usato la correlazione di Pearson, probabilmente hai una buona intuizione su come interpretare la correlazione di Spearman, dato che l’interpretazione è sostanzialmente la stessa.
La correlazione di Spearman restituisce un valore tra -1 e 1. Questo ti indica direzione e intensità di una relazione monotona.
Un valore di +1 indica una relazione monotona perfettamente crescente: quando una variabile aumenta, l’altra aumenta sempre. Succede quando i ranghi di ciascuna coppia di valori sono esattamente gli stessi.
Un valore di -1 indica una relazione monotona perfettamente decrescente: quando una variabile aumenta, l’altra diminuisce sempre. Succede quando i ranghi di ciascuna coppia di valori sono esattamente invertiti.
Un valore di 0 indica assenza di relazione monotona. Succede quando non c’è un trend coerente nei ranghi.
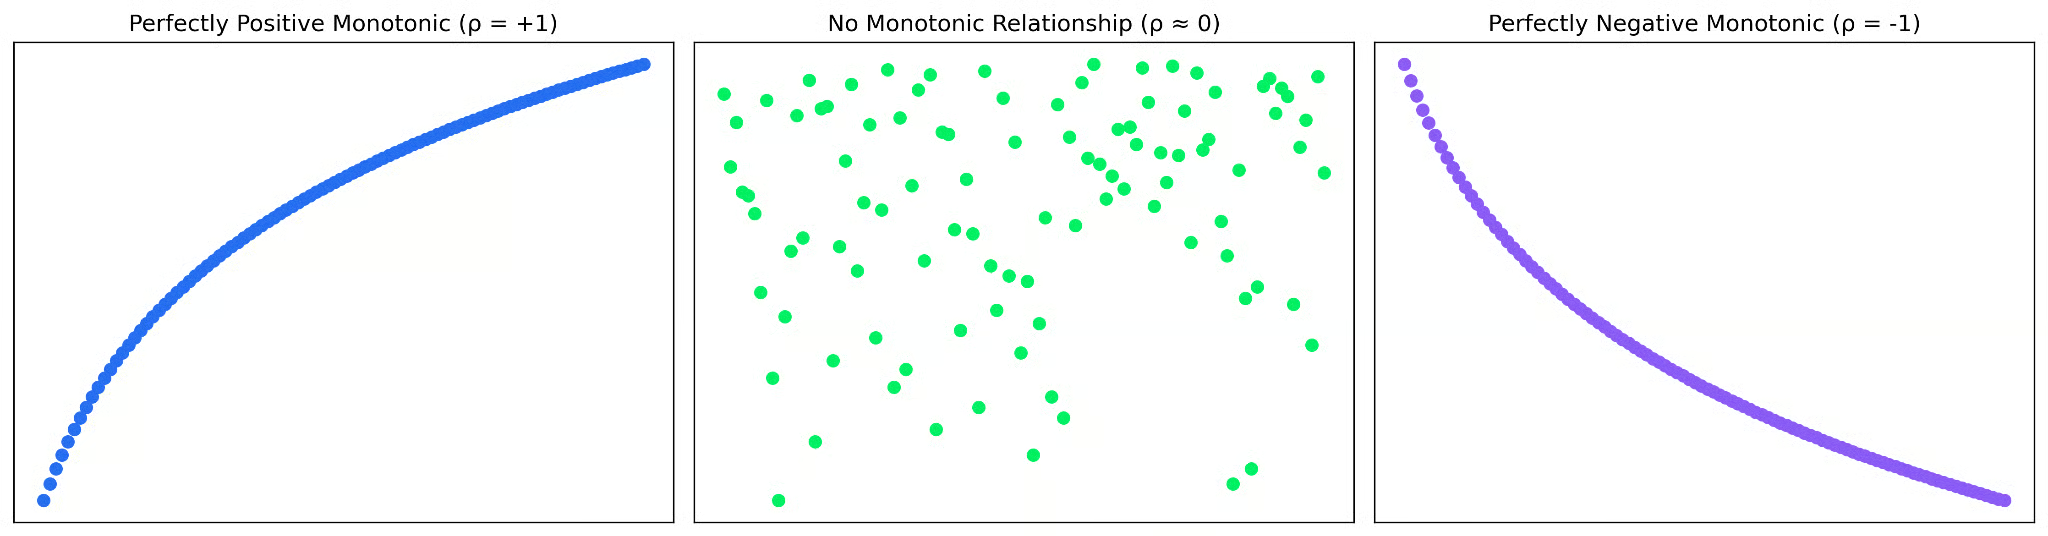
Una distinzione importante rispetto al coefficiente di Pearson è che la correlazione di Spearman riflette quanto bene si allinea l’ordine dei dati, non quanto i valori seguano da vicino una linea retta. Questo significa che una forte correlazione di Spearman indica un trend chiaro nelle classifiche, non necessariamente una relazione lineare o a spaziatura uniforme.
Per questo è sempre una buona idea affiancare ai valori di correlazione una rapida visualizzazione, per comprendere al meglio il pattern sottostante.
Gestione dei pareggi nei ranghi
Tutto bene finché non ti imbatti in un dataset in cui più osservazioni hanno lo stesso valore. Cosa fare allora? Questi sono i cosiddetti pareggi (ties) e richiedono un piccolo aggiustamento nell’assegnazione dei ranghi.
Per esempio, considera i valori: 10, 20, 20, 30. I due valori 20 normalmente occuperebbero i ranghi 2 e 3. Tuttavia, essendo uguali, invece di assegnare loro ranghi diversi, assegniamo a ciascuno la media di quei ranghi; entrambi i 20 ricevono il rango 2,5. Questo approccio garantisce un trattamento equo dei valori a pari merito e mantiene coerente la classifica complessiva.
Poiché il coefficiente di correlazione per ranghi di Spearman si basa interamente sui ranghi, se i pareggi non sono gestiti correttamente la correlazione può risultare distorta.
Limitazioni della correlazione di Spearman
Sebbene il coefficiente di correlazione per ranghi di Spearman sia una misura flessibile e ampiamente usata, ha alcune limitazioni.
La più importante è che può catturare solo relazioni monotone. Se una relazione cambia direzione, come in un andamento a U o a onda sinusoidale, la correlazione può essere vicina a zero anche quando esiste un pattern evidente. In questi casi, è meglio usare un modello non lineare, come la regressione polinomiale.
Inoltre, poiché la correlazione di Spearman si basa sui ranghi, ignora le distanze effettive tra i valori. Questo la rende migliore nella gestione degli outlier, ma comporta anche una perdita di informazione. L’ampiezza della relazione è più difficile da interpretare con la correlazione di Spearman rispetto a quella di Pearson per questo motivo. Ti dice se le variabili si muovono insieme nell’ordine, ma non di quanto una cambi rispetto all’altra.
Infine, quando ci sono molti pareggi, il processo di ranking diventa meno preciso. Questo può portare a un valore di correlazione più debole, che potrebbe non rappresentare appieno la relazione.
Spearman vs. Pearson: quando usare l’uno o l’altro
La correlazione più usata è probabilmente il coefficiente di Pearson. A prima vista sembra molto simile al coefficiente di Spearman. Hanno persino nomi quasi identici! Ma rispondono a domande leggermente diverse.
Pearson chiede: “Queste variabili seguono una relazione lineare?”, mentre Spearman chiede: “Queste variabili si muovono nello stesso ordine?”.
Se i tuoi dati seguono un pattern approssimativamente lineare e le distanze effettive tra i valori sono significative, la correlazione di Pearson è di solito la scelta giusta. Ma se la relazione curva o si appiattisce, Spearman tende a essere più adatta.
Spearman è anche più indulgente. Poiché lavora con i ranghi invece che con i valori grezzi, è meno sensibile agli outlier e fa meno affidamento sulle assunzioni sui dati. Il compromesso è che è meno efficace nel catturare le differenze di magnitudine tra i valori.
In pratica, una buona regola empirica è: se la relazione è lineare, usa Pearson; se è monotona ma non lineare, usa Spearman. E come sempre, visualizza i dati prima di decidere.
Conclusioni
Il coefficiente di correlazione di Spearman è un ottimo strumento per catturare pattern monotoni, soprattutto in dataset che non sono ben descritti dalla correlazione di Pearson. Lavorando con i ranghi, è meno sensibile agli outlier e più tollerante ai dati non lineari.
Puoi approfondire come scegliere la correlazione migliore per il tuo dataset in Understanding Correlation: Measuring Relationships in Data. Potrebbe interessarti anche Understanding Covariance: An Introductory Guide.