Nicht alle Zusammenhänge verlaufen geradlinig.
Vielleicht siehst du: Mit steigendem Marketingbudget verbessert sich die Conversion, aber nicht in konstantem Tempo. Oder das Einkommen nimmt zu, das Glück steigt oft mit, flacht dann aber ab. Das Muster ist klar, nur eben nicht linear. Wie lässt sich das quantifizieren?
Eine Korrelation beschreibt, wie sich zwei Variablen gemeinsam bewegen. Eine gängige Korrelation ist der Pearson-Korrelationskoeffizient, der sehr gut für lineare Beziehungen funktioniert. Viele reale Zusammenhänge sind jedoch nicht linear. Sie können gekrümmt sein, ein Plateau bilden oder einem gleichmäßigen Trend folgen, ohne eine Gerade zu ergeben. In manchen Fällen ist die Reihenfolge wichtiger als die exakten Werte. Hier kommt Spearmans Rangkorrelationskoeffizient ins Spiel.
Spearmans Korrelation arbeitet mit Rängen statt mit Rohwerten und misst, ob zwei Variablen dazu tendieren, sich konsistent gemeinsam zu erhöhen oder zu verringern. Damit eignet sie sich besonders für monotone Beziehungen. Außerdem ist sie robuster gegenüber Ausreißern oder ungleichmäßigen Abständen.
Was ist Spearmans Rangkorrelation?
Spearmans Rangkorrelationskoeffizient misst Stärke und Richtung des Zusammenhangs zwischen zwei Variablen. Er basiert auf den Rängen der Werte, nicht auf den Werten selbst.
Stell dir vor, du analysierst Songs auf einer Streaming-Plattform. Du vergleichst die Anzahl der Streams mit der Platzierung in den „Top 100“. Der Zusammenhang ist nicht perfekt linear – doppelt so viele Streams bedeuten nicht automatisch doppelt so gute Platzierung. Dennoch gilt: Mehr Streams führen tendenziell zu einer besseren Chartposition.
Spearmans Korrelation erfasst dieses Muster, indem sie sich auf die Reihenfolge der Daten konzentriert, nicht auf die exakten Abstände.
Das ist besonders nützlich, wenn der Zusammenhang nicht linear ist, aber einem klaren Trend folgt, die Daten natürlich als Rankings vorliegen oder Ausreißer eine lineare Messung verzerren würden.
Im Gegensatz zur Pearson-Korrelation, die mit Rohwerten arbeitet, werden bei Spearman zuerst Ränge gebildet und dann deren Übereinstimmung gemessen.
Technisch gesprochen misst Spearman monotone Beziehungen. Monoton bedeutet: Eine Variable steigt tendenziell, wenn die andere steigt, oder fällt, wenn die andere fällt – ohne Richtungswechsel.
Monotone vs. lineare Zusammenhänge
Worin genau unterscheiden sich lineare und monotone Zusammenhänge?
Ein linearer Zusammenhang folgt einem Geradenmuster. In einem Plot lägen die Punkte grob auf einer Linie.
Ein monotoner Zusammenhang ist weniger strikt. Er verläuft lediglich in eine Richtung. Beide Variablen bewegen sich gemeinsam, aber nicht zwingend entlang einer Geraden. Das Muster kann sich krümmen, abflachen oder das Tempo wechseln, so lange es nicht die Richtung umkehrt.
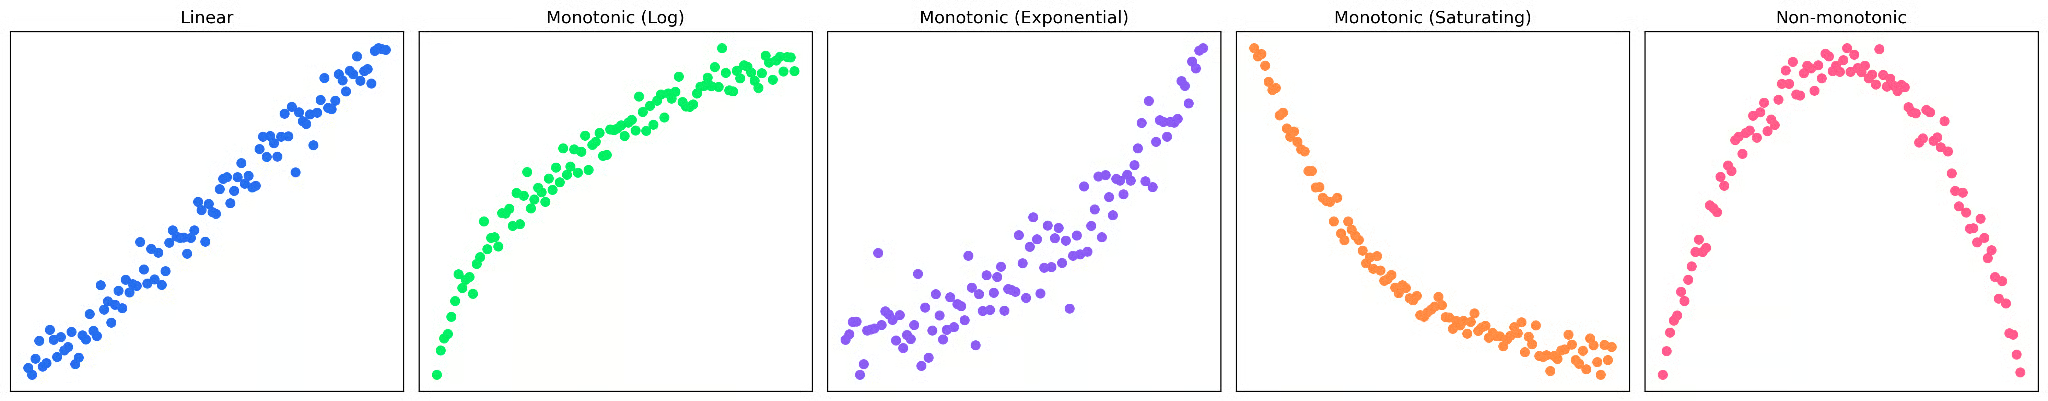
In den obigen Grafiken siehst du vier monotone Beispiele, von denen nur das erste linear ist. Die letzte Grafik ist nicht monoton, weil das Muster die Richtung wechselt: Es startet positiv und endet negativ.
|
Beziehungstyp |
Beschreibung |
Charakteristisches Bild |
|
Linear |
Variablen steigen oder fallen mit konstanter Rate |
Gerade Linie |
|
Monoton (aber nichtlinear) |
Variablen bewegen sich in eine Richtung, aber das Tempo ändert sich |
Gekrümmt, abflachend oder beschleunigend |
|
Nicht monoton |
Die Richtung wechselt (erst steigend, dann fallend, oder umgekehrt) |
U-Form, umgedrehtes U oder wellenförmig |
Spearmans Rangkorrelation Schritt für Schritt berechnen
Grob gesagt, wandelt Spearmans Rangkorrelationskoeffizient deine Daten in Ränge um und misst dann, wie ähnlich sich diese Rankings zwischen den Variablen sind.
Gehen wir ein kleines Beispiel durch. Angenommen, wir betrachten den Zusammenhang zwischen Übungsstunden an einem Instrument und der Platzierung in einem Wettbewerb.
|
Schüler |
Übungsstunden (X) |
Leistungspunktzahl (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Zuerst plotten wir die Daten.
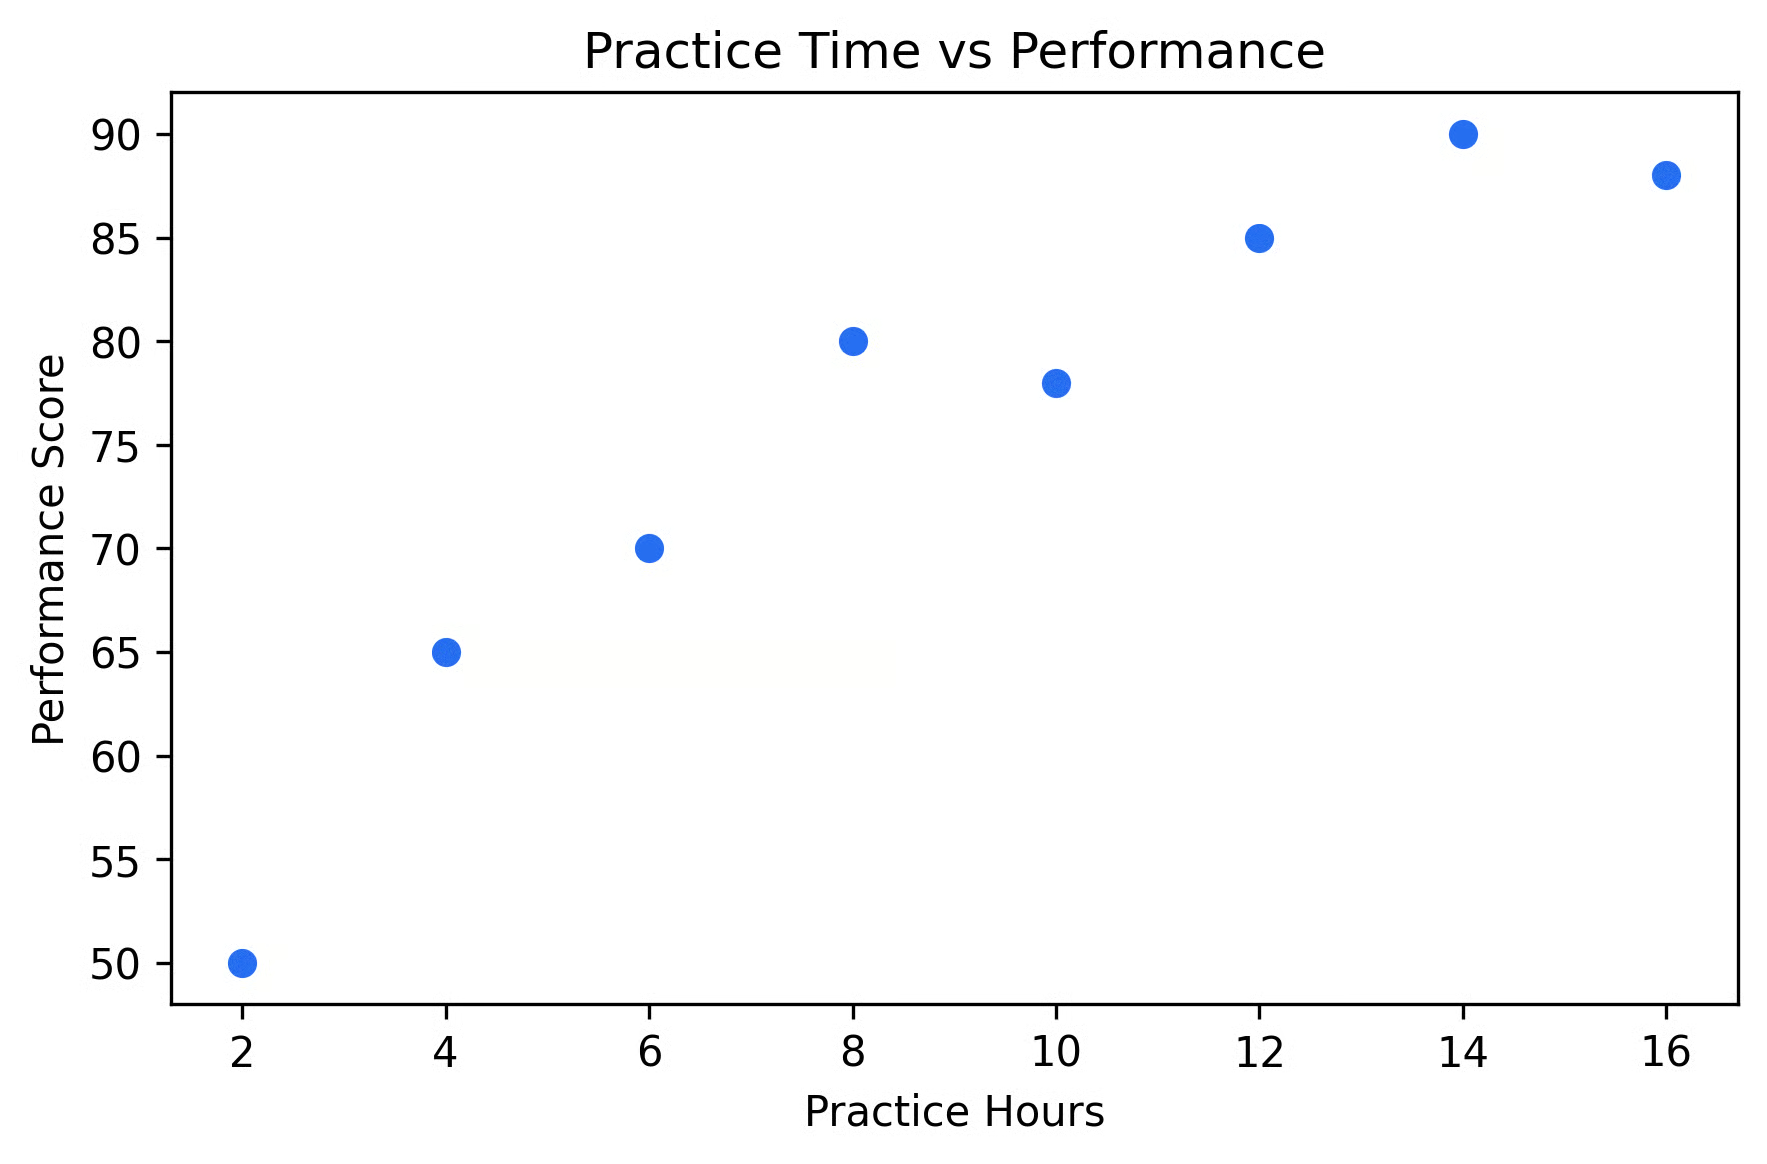
Visuell sieht es so aus, als führten mehr Übungsstunden zu höheren Punktzahlen, aber nicht perfekt linear. Es scheint abnehmende Grenzerträge bei zu viel Übung zu geben. Wenden wir Spearmans Rang an, um den Zusammenhang zu quantifizieren.
Schritt 1: Daten in Ränge umwandeln
Weisen wir jedem Wert seinen Rang zu. Innerhalb jeder Variable vergeben wir Ränge vom kleinsten zum größten Wert. Der kleinste Wert erhält Rang 1, der zweitkleinste Rang 2, und so weiter.
|
Schüler |
Übungsstunden (X) |
Rang (X) |
Leistungspunktzahl (Y) |
Rang (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Beachte, dass die Rangfolgen für Y etwas anders sind als für X. Genau diese Abweichung misst Spearmans Korrelation.
Schritt 2: Rangdifferenzen berechnen
Als Nächstes berechnen wir für jede Beobachtung die Differenz zwischen den Rängen.
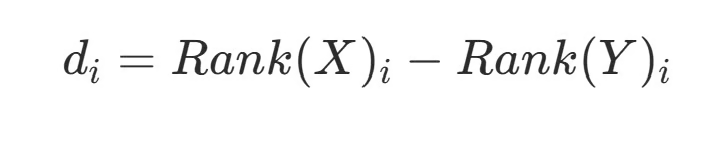
Dann quadrieren wir jede Differenz:
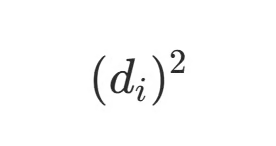
|
Schüler |
Rang(X) |
Rang(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Nun addieren wir die quadrierten Differenzen in der letzten Spalte unserer Tabelle.
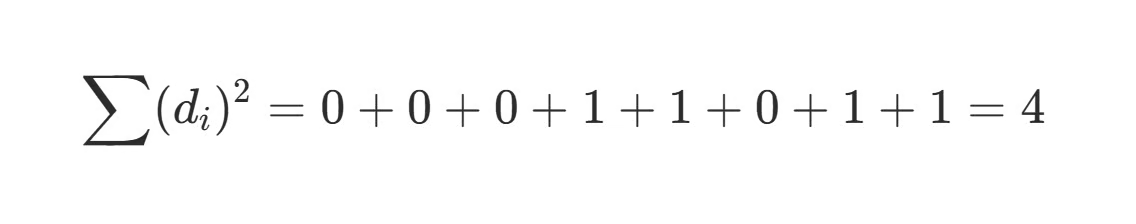
Schritt 3: Formel anwenden
Zum Schluss setzen wir die Werte in die Spearman-Formel ein.
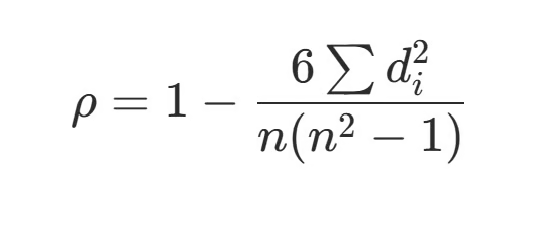
Wir wissen bereits, dass (di)2=4 aus unseren Berechnungen stammt. Das n im Nenner ist der Stichprobenumfang, hier 8. Eingesetzt ergibt das:
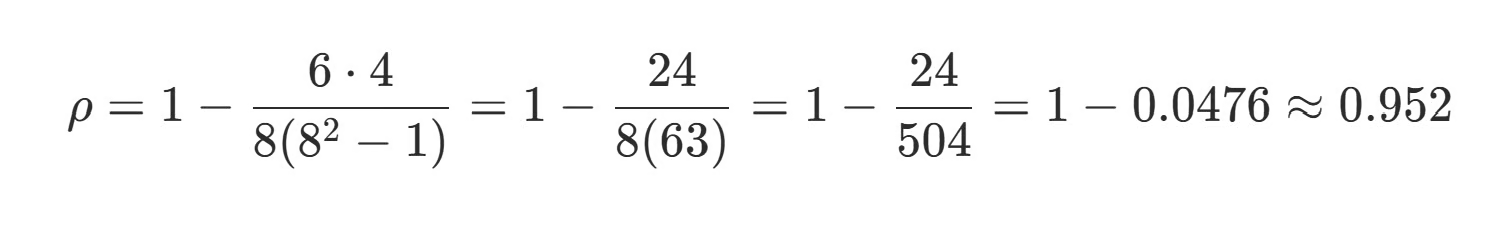
Ergebnis interpretieren
Unser Endergebnis ist ρ ~ 0,95. Da dieser Wert nahe +1 liegt, zeigt er einen starken positiven Zusammenhang zwischen Übungszeit und Leistung. Obwohl der Zusammenhang nicht perfekt linear ist, ähneln sich die Rankings stark. Wenn sich der X-Wert ändert, ändert sich der Y-Wert tendenziell konsistent mit.
Im Alltag rechnet man das selten per Hand. Die meisten Tools übernehmen Ranking, Bindungen und Berechnung automatisch – gut so, denn unsere Stichproben sind meist deutlich größer!
Spearmans Korrelation in Software berechnen
Die meisten Statistikprogramme erledigen das in Sekunden. Schauen wir kurz auf die gängigsten Optionen.
Python
In Python nutzt du je nach Workflow meist scipy oder pandas. Wenn du mit Arrays oder Listen arbeitest, bietet scipy einen direkten Weg, Spearmans Korrelation zu berechnen.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Das liefert sowohl den Korrelationskoeffizienten als auch einen p-Wert – hilfreich für statistische Tests.
Für tabellarische Daten ist pandas oft bequemer.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
So berechnest du die Korrelationsmatrix und kannst mehrere Variablen auf einmal vergleichen.
Alternativ kannst du auch nur zwei bestimmte Spalten gezielt korrelieren.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
In R ist Spearmans Korrelation in den Basisfunktionen enthalten.
Für eine schnelle Berechnung nutzt du cor() und gibst die Spearman-Methode an.
cor(x, y, method = "spearman")Wenn du zusätzlich p-Wert und weitere Details willst, bietet cor.test() das bequem an.
cor.test(x,y,method="spearman")Excel
Excel hat keine eingebaute Spearman-Funktion, aber du kannst sie in zwei Schritten berechnen: Zuerst die Daten ranken, dann die Korrelation dieser Ränge bilden.
Hier ein kleines Beispiel:
|
A (X) |
B (Y) |
C (Rang X) |
D (Rang Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Die Ränge (Spalten C und D) erzeugst du mit der Funktion RANK.AVG. Zum Beispiel:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Anschließend berechnest du einfach Spearmans Korrelation.
=CORREL(C2:C6, D2:D6)In allen Tools ist der Ablauf derselbe: Werte in Ränge umwandeln und dann die Korrelation dieser Ränge berechnen.
Spearmans Rangkorrelation interpretieren
Wenn du schon mit der Pearson-Korrelation gearbeitet hast, hast du ein gutes Gefühl für die Interpretation der Spearman-Korrelation – sie ist im Grunde identisch.
Spearman liefert einen Wert zwischen -1 und 1. Er gibt Richtung und Stärke eines monotonen Zusammenhangs an.
Ein Wert von +1 steht für einen perfekt steigenden monotonen Zusammenhang: Steigt die eine Variable, steigt die andere immer mit. Das passiert, wenn die Rangfolgen jedes Wertepaares exakt übereinstimmen.
Ein Wert von -1 steht für einen perfekt fallenden monotonen Zusammenhang: Steigt die eine Variable, fällt die andere immer. Das passiert, wenn die Rangfolgen exakt umgekehrt sind.
Ein Wert von 0 zeigt keinen monotonen Zusammenhang: Es gibt keinen konsistenten Trend in den Rängen.
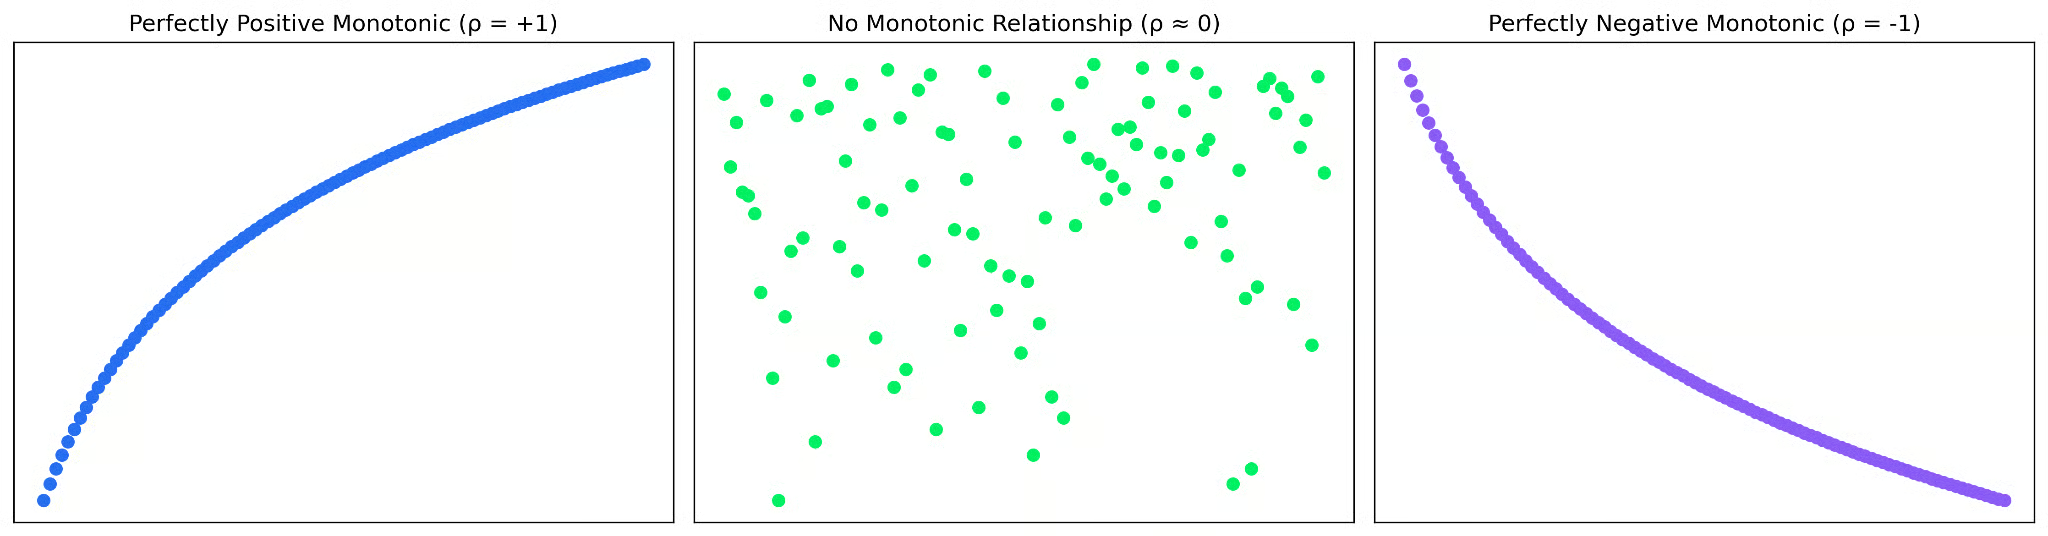
Ein wichtiger Unterschied zur Pearson-Korrelation ist: Spearman spiegelt wider, wie gut die Reihenfolge der Daten übereinstimmt – nicht, wie eng die Werte einer Geraden folgen. Ein hoher Spearman-Wert zeigt also einen klaren Ranking-Trend, nicht zwingend Linearität oder gleichmäßige Abstände.
Deshalb ist es immer sinnvoll, Korrelationen mit einem schnellen Plot zu ergänzen, um das Muster wirklich zu verstehen.
Gleichstände in Rankings behandeln
Klingt alles gut – bis ein Datensatz mehrere identische Werte enthält. Was dann? Solche Gleichstände erfordern eine kleine Anpassung bei der Rangvergabe.
Beispiel: 10, 20, 20, 30. Die beiden 20er würden normalerweise die Ränge 2 und 3 belegen. Da sie identisch sind, vergeben wir stattdessen den Durchschnitt dieser Ränge: Beide 20er erhalten Rang 2,5. So werden Gleichstände fair behandelt und die Gesamtrangfolge bleibt konsistent.
Da Spearmans Rangkorrelation vollständig auf Rängen basiert, kann eine falsche Behandlung von Gleichständen die Korrelation verzerren.
Einschränkungen der Spearman-Korrelation
Spearmans Rangkorrelationskoeffizient ist flexibel und weit verbreitet, hat aber Grenzen.
Am wichtigsten: Er erfasst nur monotone Beziehungen. Wenn sich die Richtung ändert – etwa U-Form oder Sinuswelle – kann die Korrelation nahe Null liegen, obwohl ein klares Muster existiert. In solchen Fällen sind nichtlineare Modelle wie polynomiale Regression sinnvoller.
Zudem ignoriert Spearman als Rangmaß die tatsächlichen Abstände zwischen Werten. Das macht es robuster gegenüber Ausreißern, führt aber auch zum Informationsverlust. Die Größenordnung des Zusammenhangs ist schwerer zu interpretieren als bei Pearson: Man sieht, ob sich Variablen in der Reihenfolge gemeinsam bewegen, nicht wie stark sich eine relativ zur anderen ändert.
Schließlich wird die Rangbildung bei vielen Gleichständen ungenauer. Das kann den Korrelationswert abschwächen und den Zusammenhang unterschätzen.
Spearman vs. Pearson: Wann setzt du welches Maß ein?
Am häufigsten wird wohl der Pearson-Korrelationskoeffizient verwendet. Auf den ersten Blick wirkt er Spearman sehr ähnlich – die Namen sowieso! Tatsächlich beantworten sie aber leicht unterschiedliche Fragen.
Pearson fragt: „Folgen diese Variablen einer Geraden?“ Spearman fragt: „Bewegen sich diese Variablen in derselben Reihenfolge?“
Wenn deine Daten grob einer Geraden folgen und die Abstände zwischen den Werten bedeutsam sind, ist Pearson meist richtig. Wenn sich der Zusammenhang krümmt oder abflacht, passt Spearman oft besser.
Spearman ist zudem fehlertoleranter. Weil nur Ränge zählen, ist es weniger empfindlich gegenüber Ausreißern und macht weniger starke Annahmen über die Daten. Der Trade-off: Unterschiede in der Größenordnung werden schlechter abgebildet.
Pragmatische Faustregel: Ist der Zusammenhang linear, nutze Pearson; ist er monoton, aber nicht linear, nutze Spearman. Und wie immer: Visualisiere die Daten vor der Entscheidung.
Fazit
Spearmans Korrelationskoeffizient ist ideal, um monotone Muster zu erfassen – besonders in Datensätzen, für die Pearson nicht gut geeignet ist. Durch die Arbeit mit Rängen ist er weniger anfällig für Ausreißer und geht gelassener mit nichtlinearen Daten um.
Mehr zur Wahl des passenden Korrelationsmaßes findest du in Understanding Correlation: Measuring Relationships in Data. Spannend dazu ist auch Understanding Covariance: An Introductory Guide.