Niet alle verbanden volgen een rechte lijn.
Je ziet misschien dat naarmate het marketingbudget toeneemt, de klantconversie verbetert, maar niet in een constant tempo. Of dat, naarmate het inkomen stijgt, geluk vaak toeneemt en daarna afvlakt. Het patroon is duidelijk, maar niet lineair. Hoe kun je dat kwantificeren?
Correlatie beschrijft hoe twee variabelen samen bewegen. Een veelgebruikte correlatie is de Pearson-correlatiecoëfficiënt, die werkt heel goed voor lineaire relaties. Maar veel verbanden in de praktijk zijn niet lineair. Ze kunnen krommen, afvlakken of een consistente trend volgen zonder een rechte lijn te vormen. In sommige gevallen zijn de exacte waarden minder belangrijk dan de volgorde waarin ze voorkomen. Daar komt de rangcorrelatiecoëfficiënt van Spearman van pas.
De correlatie van Spearman werkt met rangen in plaats van ruwe waarden en meet of twee variabelen op een consistente manier samen toenemen of afnemen. Dat maakt deze maat geschikt voor monotone relaties. Het maakt haar ook robuuster voor bepaalde data-eigenaardigheden, zoals uitschieters of ongelijke tussenruimtes.
Wat is de rangcorrelatie van Spearman?
De rangcorrelatiecoëfficiënt van Spearman meet de sterkte en richting van een relatie tussen twee variabelen. Ze is gebaseerd op de rangorde van de waarden in plaats van op de waarden zelf.
Om te zien hoe dit werkt, stel je voor dat je liedjes op een streamingplatform analyseert. Je vergelijkt bijvoorbeeld hoe vaak een nummer wordt afgespeeld met de positie op een “Top 100”-lijst. De relatie is mogelijk niet perfect lineair; een verdubbeling van het aantal streams verdubbelt niet per se de positie. Maar over het algemeen scoren nummers met meer streams hoger.
De correlatie van Spearman vangt dit soort patroon door te focussen op de volgorde van de data in plaats van de exacte waarden.
Dit is vooral nuttig wanneer de relatie niet lineair is maar wel een duidelijke trend volgt, de data van nature als rankings wordt uitgedrukt, of wanneer de data uitschieters bevat die een lineaire maat zouden vertekenen.
In tegenstelling tot de Pearson-correlatie, die rechtstreeks met ruwe waarden werkt, zet Spearman de data eerst om in rangen en meet dan hoe goed die rankings overeenkomen.
Technisch gezien meet Spearman monotone relaties. Een relatie is monotoon als de ene variabele de neiging heeft te stijgen wanneer de andere stijgt, of te dalen wanneer de andere daalt, zonder van richting te veranderen.
Monotone vs. lineaire relaties
Wat is nu precies het verschil tussen lineaire en monotone relaties?
Een lineaire relatie is er een waarbij de data een patroon van een rechte lijn volgt. Als je de data zou uitzetten, zie je punten die ruwweg een lijn vormen.
Een monotone relatie is minder strikt. Het betekent simpelweg dat de relatie in één richting beweegt. Met andere woorden: beide variabelen bewegen samen, maar niet per se in een rechte lijn. Het patroon kan krommen, afvlakken of van snelheid veranderen, zolang het maar niet van richting verandert.
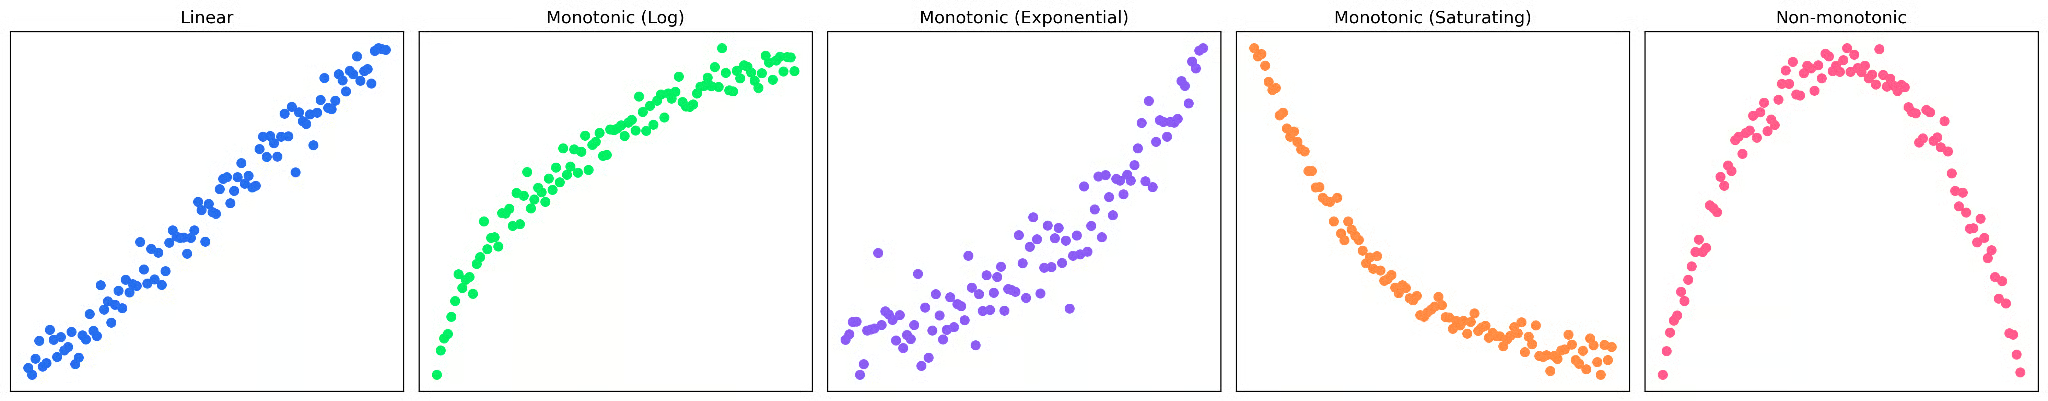
In de grafieken hierboven zie je vier verschillende voorbeelden van monotone relaties, waarvan alleen de eerste lineair is. De laatste grafiek is niet monotoon, omdat het patroon van richting verandert: het begint als een positieve associatie en eindigt als een negatieve.
|
Type relatie |
Beschrijving |
Hoe het eruitziet |
|
Lineair |
Variabelen nemen toe of af met een constant tempo |
Rechte lijn |
|
Monotoon (maar niet-lineair) |
Variabelen bewegen in één richting, maar het tempo verandert |
Gekromd, afvlakkend of versnellend patroon |
|
Niet-monotoon |
Relatie verandert van richting (neemt toe en daarna af, of andersom) |
U-vorm, omgekeerde U of golfachtig patroon |
Spearman's rangcorrelatie stap voor stap bepalen
In grote lijnen werkt de rangcorrelatiecoëfficiënt van Spearman door je data om te zetten in rangen en vervolgens te meten hoe vergelijkbaar de rankings tussen variabelen zijn.
Laten we een klein voorbeeld uitwerken. Stel dat we’ kijken naar de relatie tussen het aantal uren oefenen op een muziekinstrument en de prestatierangschikking in een wedstrijd.
|
Student |
Uren oefenen (X) |
Prestatiescore (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Laten we eerst de data plotten.
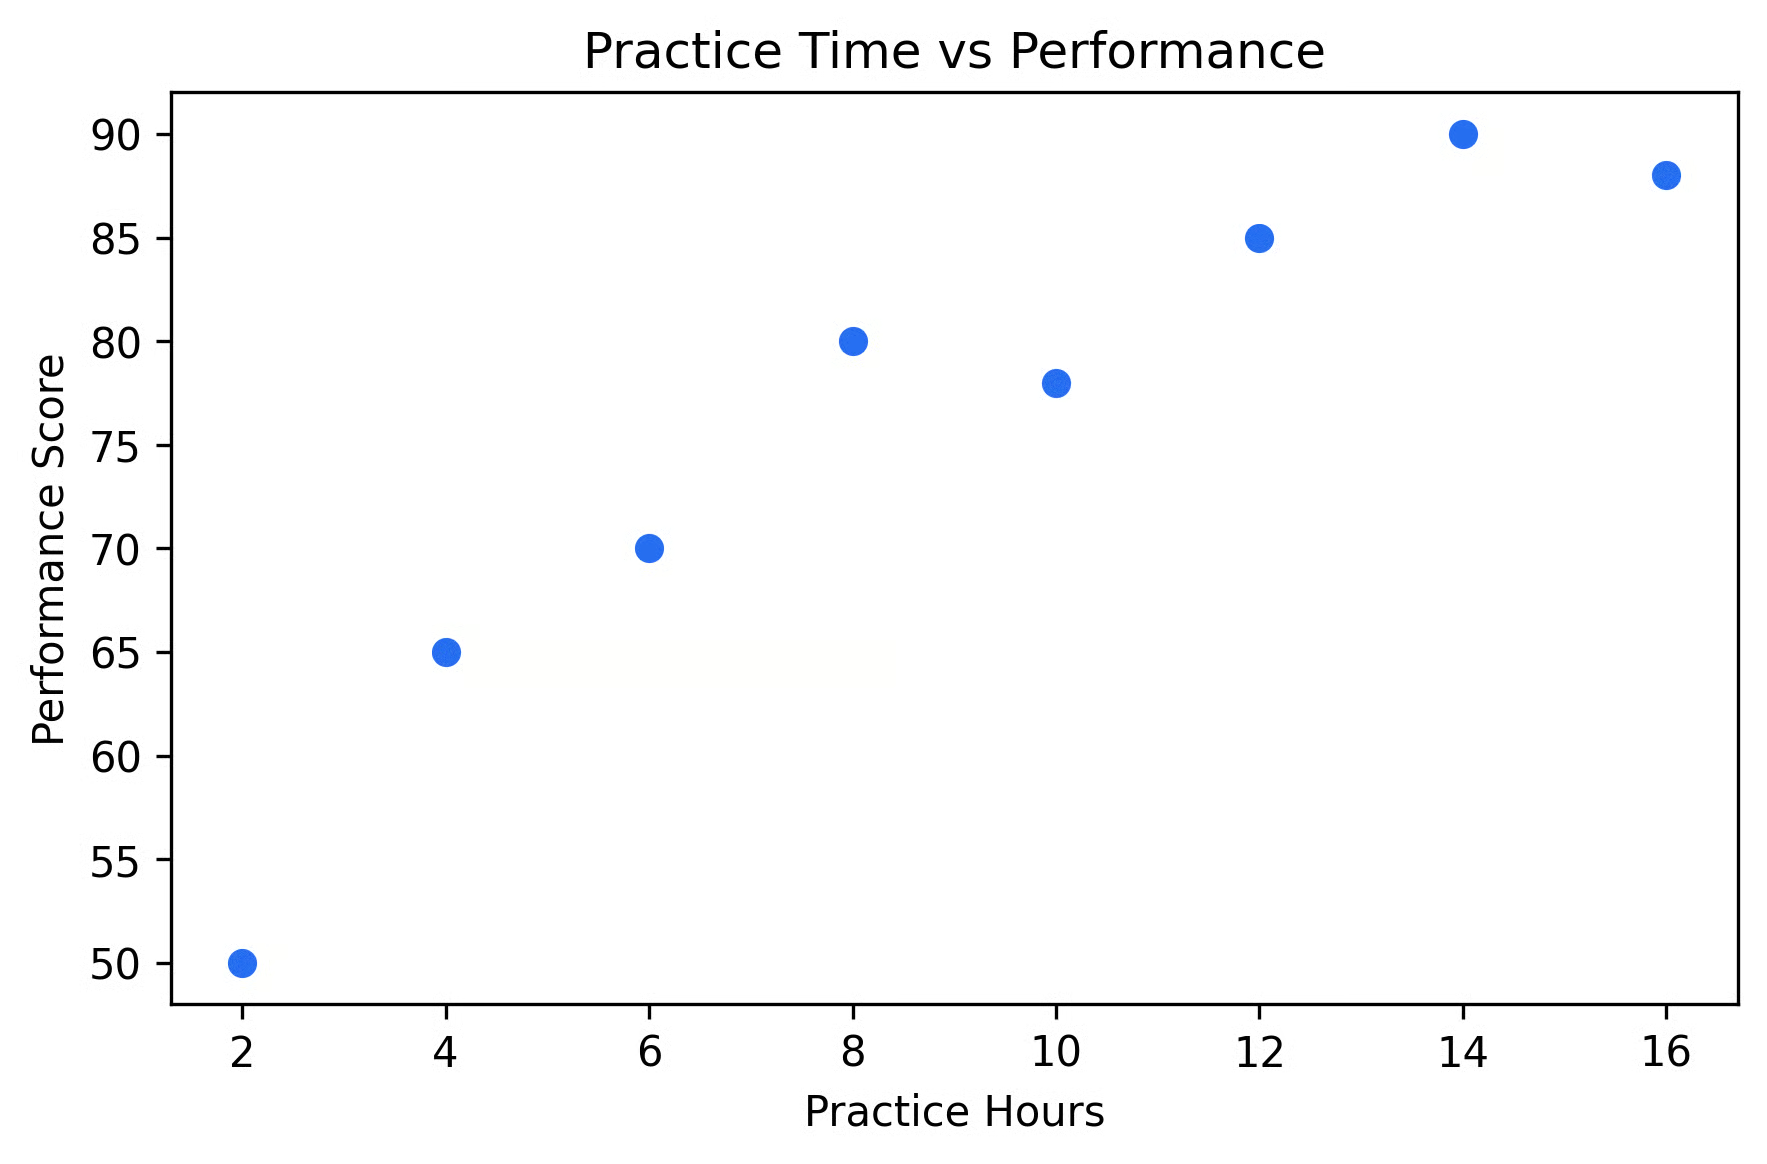
Visueel lijkt het erop dat meer oefenen leidt tot hogere prestatiescores, maar het patroon is niet perfect lineair. Het lijkt alsof er afnemende meeropbrengsten zijn bij heel veel oefenen. Laten we Spearman's rang toepassen om deze relatie te kwantificeren.
Stap 1: zet data om naar rangen
We geven eerst elke waarde een rang. Binnen elke variabele kennen we een rang toe van klein naar groot. De kleinste waarde binnen een variabele krijgt rang 1, de op één na kleinste rang 2, enzovoort.
|
Student |
Uren oefenen (X) |
Rang (X) |
Prestatiescore (Y) |
Rang (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Merk op dat de rangordes voor Y net in een andere volgorde staan dan voor X. Dit is de variatie die de correlatie van Spearman zal meten.
Stap 2: bereken verschillen in rangen
Vervolgens berekenen we het verschil tussen de rangen voor elke observatie.
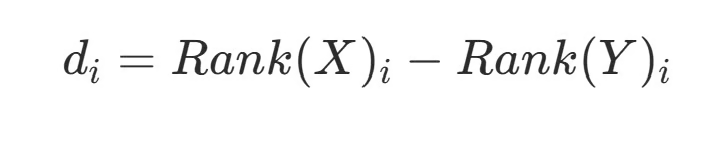
Verhef vervolgens elk verschil tot de tweede macht:
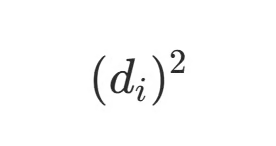
|
Student |
Rang(X) |
Rang(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Nu tellen we de gekwadrateerde verschillen op in de laatste kolom van onze tabel.
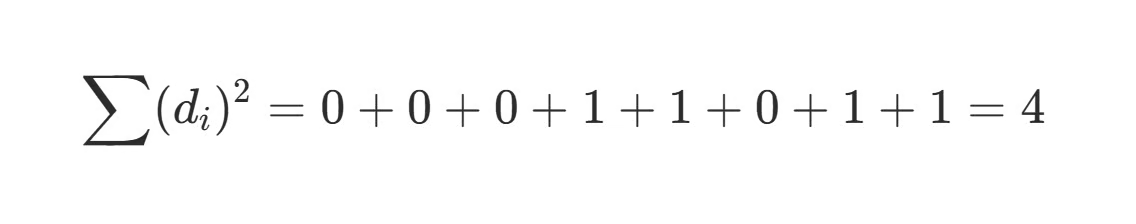
Stap 3: pas de formule toe
Tot slot vullen we de waarden in de formule voor de correlatie van Spearman in.
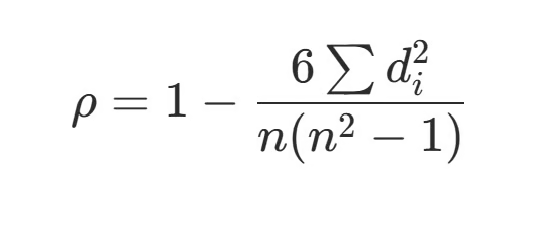
We weten al dat (di)2=4 uit onze eerdere berekeningen. De n in de noemer is de steekproefgrootte, voor ons 8. Als we dat invullen, krijgen we:
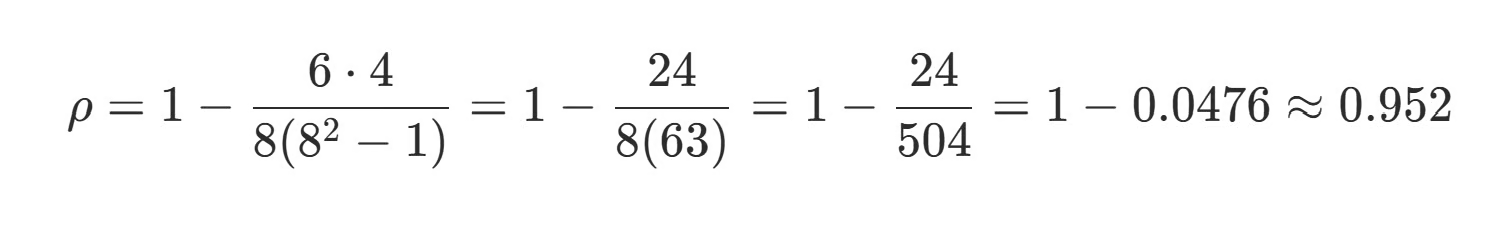
De uitkomst interpreteren
Onze uiteindelijke uitkomst is ρ ~ 0,95. Omdat deze waarde dicht bij +1 ligt, wijst dat op een sterke positieve relatie tussen oefentijd en prestatie. Ook al is de relatie niet perfect lineair, de rangordes lijken sterk op elkaar. Dit betekent dat wanneer de x-waarde verandert, de y-waarde de neiging heeft consistent mee te veranderen.
In de praktijk reken je dit zelden met de hand uit. De meeste software regelt het rangschikken, het omgaan met gelijke waarden en de berekening automatisch, wat fijn is omdat we meestal veel grotere steekproeven hebben!
Spearman's correlatie berekenen met software
De meeste statistische software kan deze berekening tegenwoordig in seconden uitvoeren. Laten we kort de meest gangbare opties doornemen.
Python
In Python gebruik je meestal ofwel scipy of pandas, afhankelijk van je workflow. Werk je met arrays of lijsten, dan biedt scipy een directe manier om Spearman's correlatie te berekenen.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Dit geeft zowel de correlatiecoëfficiënt als een p-waarde terug, wat handig is als je een statistische toets doet.
Werk je met tabeldata, dan is pandas vaak handiger.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Dit berekent de correlatiematrix, waardoor je meerdere variabelen in één keer eenvoudig kunt vergelijken.
Wil je alleen de correlatie tussen twee specifieke kolommen, dan kun je dat makkelijk specificeren.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
In R is Spearman's correlatie ingebouwd in de kernfuncties voor statistiek.
Voor een snelle berekening kun je cor() gebruiken en aangeven dat je de methode van Spearman wilt gebruiken.
cor(x, y, method = "spearman")Wil je ook een p-waarde en extra statistische details, dan biedt cor.test() dit eenvoudig.
cor.test(x,y,method="spearman")Excel
Excel heeft geen ingebouwde Spearman-functie, maar je kunt het in twee snelle stappen berekenen: rangschik eerst de data en neem daarna de correlatie van die rangen.
Hier is een klein voorbeeld:
|
A (X) |
B (Y) |
C (Rang X) |
D (Rang Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
De rangen (kolumnen C en D) kun je maken met de functie RANK.AVG. Bijvoorbeeld:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Bereken daarna eenvoudig Spearman's correlatie.
=CORREL(C2:C6, D2:D6)In al deze tools is het onderliggende proces hetzelfde: zet waarden om naar rangen en bereken vervolgens de correlatie van die rangen.
Spearman's rangcorrelatie interpreteren
Als je eerder Pearson-correlatie hebt gebruikt, heb je waarschijnlijk al een goed gevoel voor hoe je Spearman's rangcorrelatie interpreteert, want de interpretatie is in feite hetzelfde.
Spearman geeft je een waarde tussen -1 en 1. Dit vertelt je zowel de richting als de sterkte van een monotone relatie.
Een waarde van +1 duidt op een perfect toenemende monotone relatie; als de ene variabele toeneemt, neemt de andere altijd toe. Dit gebeurt wanneer de rankings van elk waardepaar exact gelijk zijn.
Een waarde van -1 duidt op een perfect afnemende monotone relatie; als de ene variabele toeneemt, neemt de andere altijd af. Dit gebeurt wanneer de rankings van elk waardepaar precies omgekeerd zijn.
Een waarde van 0 duidt op geen monotone relatie. Dit gebeurt wanneer er geen consistente trend in de rangordes zit.
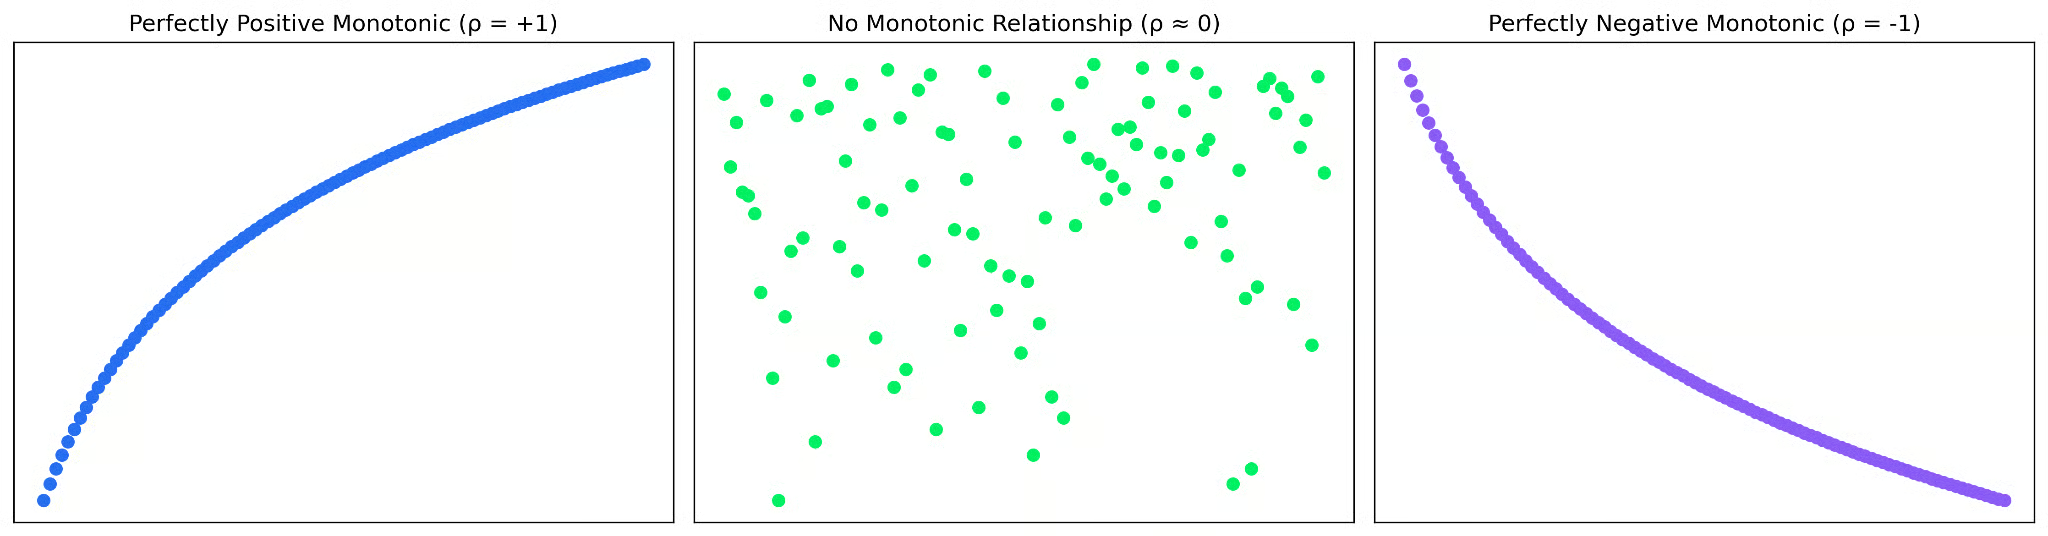
Een belangrijk verschil met de Pearson-correlatiecoëfficiënt is dat Spearman's correlatie weerspiegelt hoe goed de volgorde van de data overeenkomt, niet hoe nauw de daadwerkelijke waarden een rechte lijn volgen. Dit betekent dat een sterke Spearman-correlatie wijst op een duidelijke trend in de rangordes, en niet per se dat de relatie lineair of gelijkmatig gespreid is.
Daarom is het altijd een goed idee om correlatiewaarden te combineren met een snelle visualisatie om het onderliggende patroon het best te begrijpen.
Omgaan met gelijke rangen
Dit klinkt allemaal prima totdat je een dataset tegenkomt waarin meerdere observaties dezelfde waarde hebben. Wat doe je dan? Dit noemen we ties (gelijke waarden), en ze vereisen een kleine aanpassing bij het toekennen van rangen.
Neem bijvoorbeeld de waarden: 10, 20, 20, 30. De twee waarden 20 zouden normaal rang 2 en 3 innemen. Omdat ze gelijk zijn, kennen we in plaats daarvan elk de gemiddelde rang van die posities toe; beide 20's krijgen rang 2,5. Deze aanpak zorgt ervoor dat gelijke waarden eerlijk worden behandeld en dat de algemene rangorde consistent blijft.
Omdat Spearman's rangcorrelatiecoëfficiënt volledig op rangen is gebaseerd, kan de correlatie worden vertekend als je niet correct met gelijke waarden omgaat.
Beperkingen van Spearman's correlatie
Hoewel de rangcorrelatiecoëfficiënt van Spearman een flexibele en veelgebruikte maat is, zijn er ook beperkingen.
Het belangrijkste is dat ze alleen monotone relaties kan vastleggen. Als een relatie van richting verandert, zoals een U-vormig patroon of een sinusgolf, kan de correlatie dicht bij nul liggen, zelfs als er een duidelijk patroon is. In zulke gevallen kun je beter een niet-lineair model gebruiken, zoals polynoomregressie.
Omdat Spearman's correlatie op rangen is gebaseerd, negeert ze ook de werkelijke afstanden tussen waarden. Dat maakt haar beter bestand tegen uitschieters, maar betekent ook dat er informatie verloren gaat. De grootteorde van de relatie is daardoor moeilijker te interpreteren met Spearman dan met Pearson. Ze vertelt je of variabelen qua volgorde samen bewegen, maar niet hoeveel de ene verandert ten opzichte van de andere.
Ten slotte, als veel waarden gelijk zijn, wordt het rangschikkingsproces minder precies. Dat kan resulteren in een zwakkere correlatiewaarde, die mogelijk niet de volledige sterkte van de relatie weergeeft.
Spearman vs. Pearson: wanneer gebruik je welke?
De meest gebruikte correlatie is waarschijnlijk de Pearson-correlatiecoëfficiënt. Op het eerste gezicht lijkt die erg op de correlatiecoëfficiënt van Spearman. De namen zijn zelfs bijna identiek! Maar ze beantwoorden net andere vragen.
Pearson vraagt: “Volgen deze variabelen een rechtlijnige relatie?”, terwijl Spearman vraagt: “Bewegen deze variabelen in dezelfde volgorde?”
Als je data ruwweg een rechte lijn volgt en de werkelijke afstanden tussen waarden betekenisvol zijn, is Pearson-correlatie meestal de juiste keuze. Maar als de relatie kromt of afvlakt, past Spearman vaak beter.
Spearman is ook vergevingsgezinder. Omdat ze met rangen werkt in plaats van ruwe waarden, is ze minder gevoelig voor uitschieters en leunt ze minder op aannames over de data. Het nadeel is dat verschillen in grootteorde tussen waarden minder goed worden vastgelegd.
In de praktijk is een goede vuistregel: is de relatie lineair, gebruik Pearson; is ze monotoon maar niet lineair, gebruik Spearman. En zoals altijd: plot je data voordat je beslist.
Conclusie
De correlatiecoëfficiënt van Spearman is een prima hulpmiddel om monotone patronen vast te leggen, vooral in datasets die minder goed door Pearson-correlatie worden beschreven. Doordat ze met rangen werkt, is ze minder gevoelig voor uitschieters en beter geschikt voor niet-lineaire data.
Je kunt meer lezen over het kiezen van de beste correlatie voor je dataset in Correlation begrijpen: relaties in data meten. Mogelijk ben je ook geïnteresseerd in Covariantie begrijpen: een introductiegids.