并非所有关系都沿直线发展。
您可能会发现,随着营销预算的增加,客户转化往往会提高,但并非以恒定速率。又或者,随着收入上升,幸福感通常会增加,但随后趋于平稳。模式很清晰,却并非线性。那么,如何对其进行量化?
相关性用于描述两个变量如何共同变化。您最常见到的一种相关性是皮尔逊相关系数,它非常适用于线性关系。然而,许多现实世界中的关系并非线性。它们可能会弯曲、平台化,或遵循一致趋势却不成直线。在某些情况下,具体数值不如其出现的顺序重要。这正是斯皮尔曼秩相关系数发挥作用的地方。
斯皮尔曼相关基于名次而非原始数值,衡量两个变量是否以一致方式共同上升或下降。这使其非常适合度量单调关系。它也对某些数据特性更稳健,例如离群值或不均匀间距。
什么是斯皮尔曼秩相关?
斯皮尔曼秩相关系数用于衡量两个变量之间关系的强度和方向。它基于数值的名次,而非数值本身。
为了说明其工作原理,想象您在分析某流媒体平台上的歌曲。您可能会比较一首歌的播放次数与其在“Top 100”榜单上的排名。两者关系可能并不完全线性,播放量翻倍并不一定让名次翻倍。但总体而言,播放量更高的歌曲往往排名更靠前。
斯皮尔曼相关通过关注数据的顺序而非精确数值来捕捉此类模式。
这使其在关系并非线性但仍呈现清晰趋势、数据天然以排名表示、或数据包含可能扭曲线性度量的离群值时尤其有用。
与直接使用原始数值的皮尔逊相关不同,斯皮尔曼相关会先将数据转换为名次,再衡量这些名次之间的吻合程度。
从技术角度看,斯皮尔曼相关衡量的是单调关系。若一个变量随着另一个变量的增加而倾向于增加,或随着另一个变量的减少而倾向于减少,且不改变方向,则该关系是单调的。
单调关系 vs. 线性关系
那么,线性关系与单调关系究竟有何区别?
线性关系是指数据遵循直线模式。如果您绘制数据点,会看到它们大致排列成一直线。
另一方面,单调关系的要求没那么严格。它只要求关系朝一个方向变化。本质上,两个变量同向变化,但不一定呈直线。只要不反转方向,模式可以弯曲、趋于平缓或改变速率。
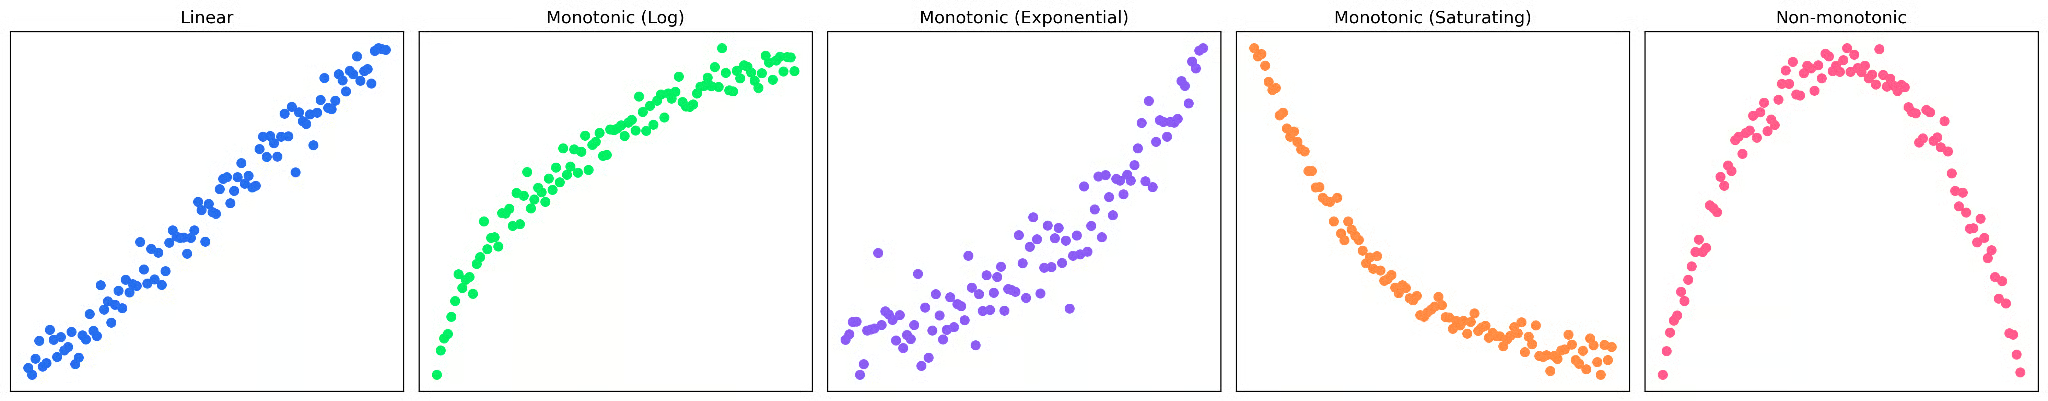
在上图中,您可以看到四种单调关系示例,只有第一种是线性的。最后一张图不是单调关系,因为其模式发生了反转,先是正相关,最后变成负相关。
|
关系类型 |
描述 |
外观特征 |
|
线性 |
变量以恒定速率增加或减少 |
直线 |
|
单调 (但非线性) |
变量同向变化,但速率改变 |
弯曲、趋于平缓或加速的趋势 |
|
非单调 |
关系改变方向(先增后减,或反之) |
U 形、倒 U 形或波浪状 |
逐步求解斯皮尔曼秩相关
从高层看,斯皮尔曼秩相关系数通过将数据转换为名次,然后衡量变量之间名次的相似性来工作。
让我们通过一个小例子来说明。假设我们在考察练习乐器的小时数与比赛中的表现排名之间的关系。
|
学生 |
练习时长(X) |
表现得分(Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
首先,让我们绘制数据。
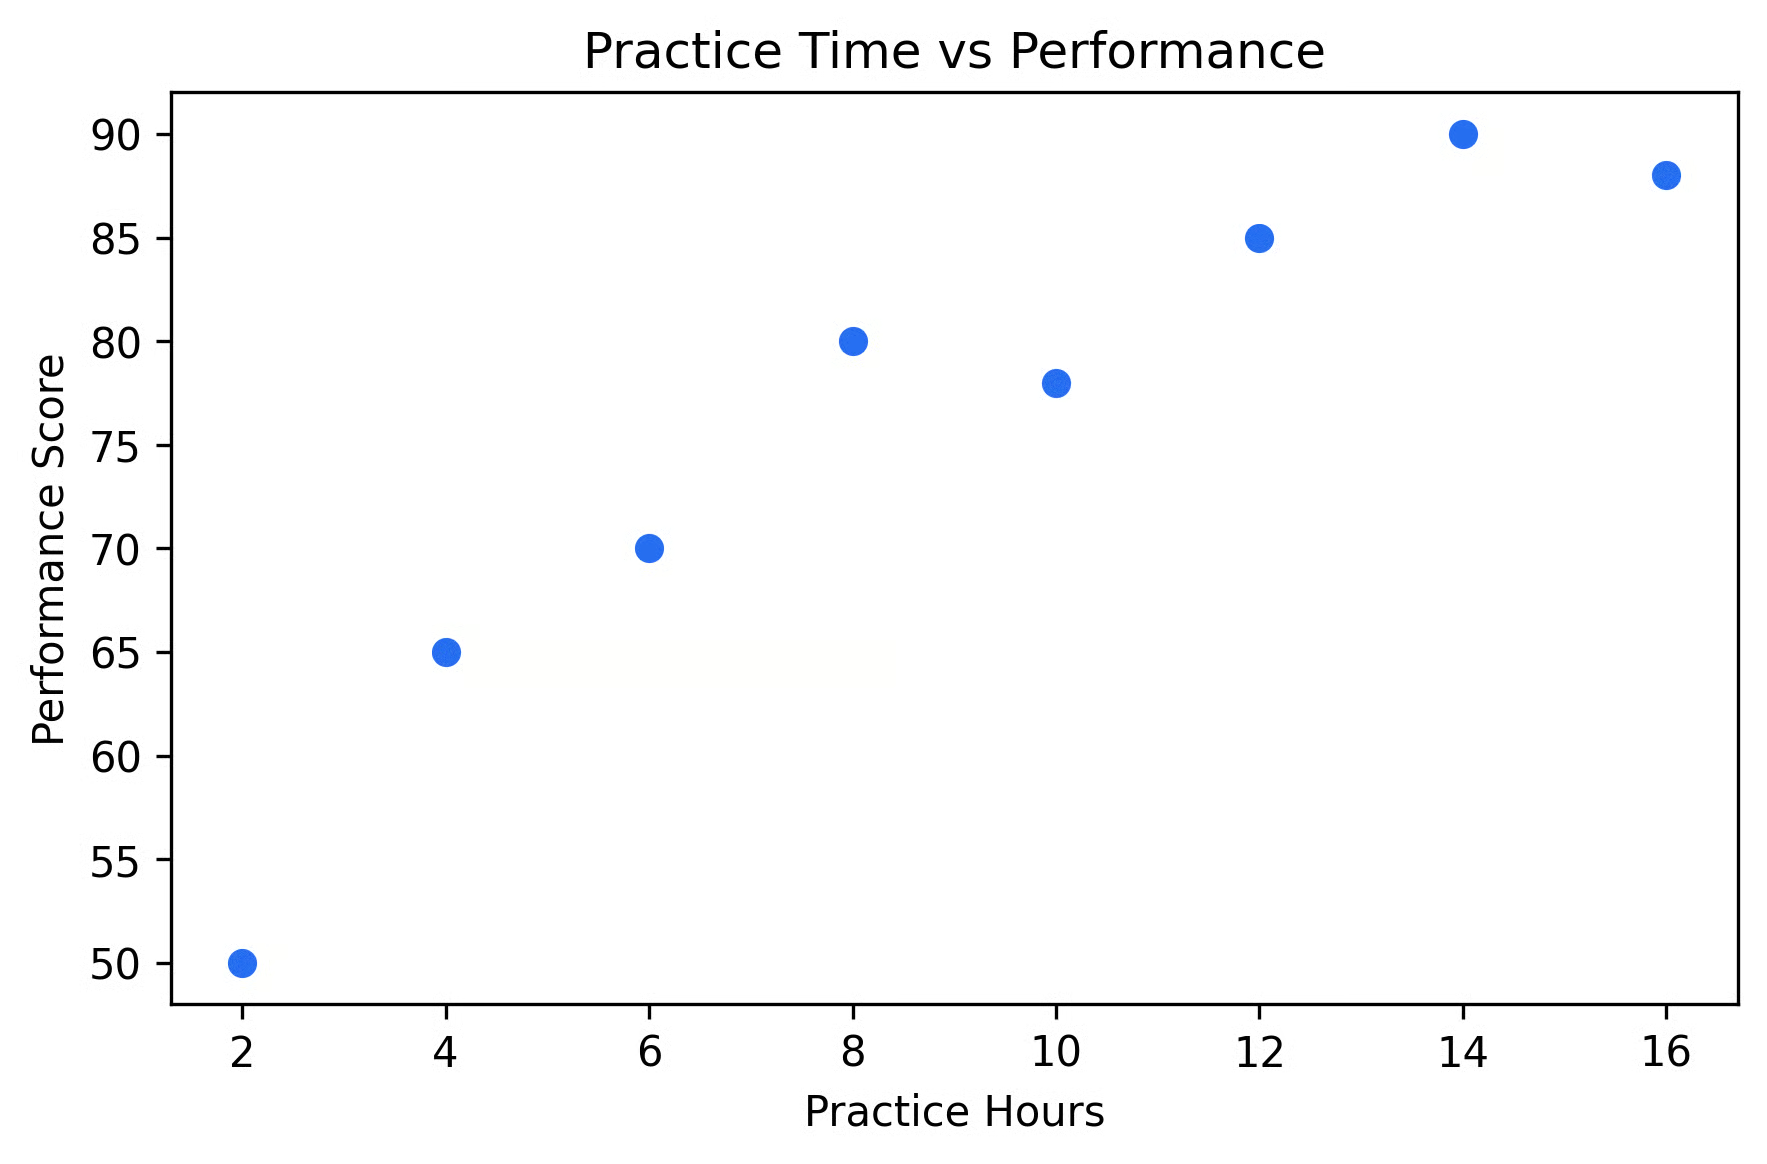
从图上看,更多练习似乎会带来更高的表现得分,但该模式并非完全线性。看起来练习过多可能存在边际效应递减。让我们尝试应用斯皮尔曼秩相关来量化这一关系。
步骤 1:将数据转换为名次
首先,为每个数值分配其名次。在每个变量内,我们将数值从小到大排序并赋名次。某变量内最小的数值名次为 1,第二小为 2,依此类推。
|
学生 |
练习时长(X) |
名次(X) |
表现得分(Y) |
名次(Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
请注意,Y 的排名顺序与 X 略有不同。斯皮尔曼相关正是要度量这种差异。
步骤 2:计算名次差
接下来,我们计算每个观测的名次差。
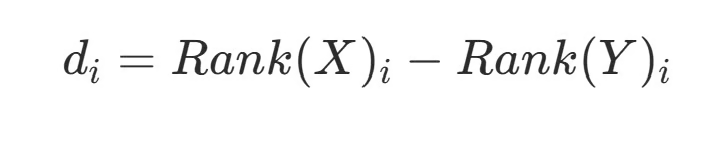
然后将每个差值平方:
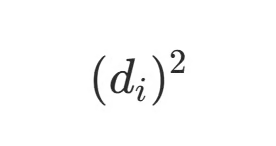
|
学生 |
名次(X) |
名次(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
现在我们将表格最后一列的平方差加总。
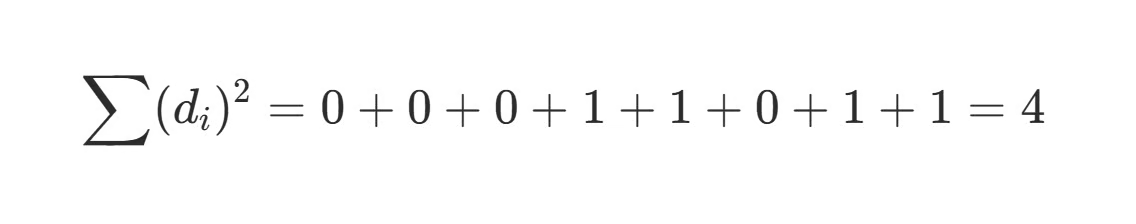
步骤 3:代入公式
最后,我们需要将数值代入斯皮尔曼相关公式。
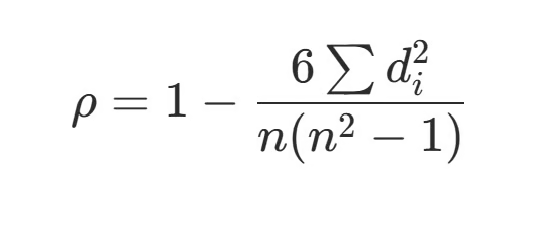
我们已知 (di)2=4(来自前面的计算)。分母中的 n 是样本量,这里为 8。代入得到:
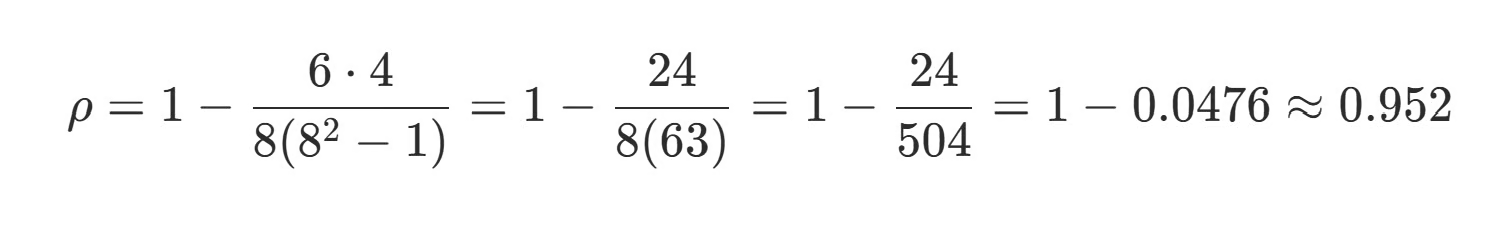
结果解读
最终结果为 ρ ~ 0.95。该值接近 +1,表示练习时间与表现之间存在很强的正向关系。尽管关系并非完全线性,但排名非常相似。这意味着当 x 值变化时,y 值往往也会以一致方式随之变化。
在现实应用中,手工计算的情况很少见。大多数软件都会自动处理排序、并列值和计算,这很好,因为我们的样本量通常要大得多!
使用软件计算斯皮尔曼相关
当今大多数统计软件都能在几秒内完成此计算。我们简要介绍几种最常用的软件。
Python
在 Python 中,您通常会使用 scipy 或 pandas,取决于您的工作流程。如果您处理的是数组或列表,scipy 提供了直接计算斯皮尔曼相关的方法。
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
这将返回相关系数和 p 值,如果您要进行统计检验,这很有用。
如果您处理表格数据,pandas 往往更方便。
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
此操作会计算相关矩阵,方便您一次比较多个变量。
或者,如果您只想计算两列之间的相关性,也可以很容易地进行指定。
corr=df["column_1"].corr(df["column_2"],method="spearman")R
在 R 中,斯皮尔曼相关包含在核心统计函数中。
要快速计算,您可以使用 cor() 并指定使用斯皮尔曼方法。
cor(x, y, method = "spearman")如果您还需要 p 值和更多统计细节,cor.test() 可轻松提供。
cor.test(x,y,method="spearman")Excel
Excel 没有内置的 Spearman 函数,但您可以通过两步快速计算:先对数据进行排名,再对这些名次计算相关性。
下面是一个小示例:
|
A(X) |
B(Y) |
C(X 的名次) |
D(Y 的名次) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
您可以使用 RANK.AVG 函数创建名次(列 C 和列 D)。例如:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
然后,直接计算斯皮尔曼相关。
=CORREL(C2:C6, D2:D6)无论使用哪种工具,其底层过程相同:将数值转换为名次,然后计算这些名次的相关性。
如何解读斯皮尔曼秩相关
如果您使用过皮尔逊相关,那么您大概已经对如何解读斯皮尔曼秩相关有不错的直觉,因为二者的解读基本一致。
斯皮尔曼秩相关给出的数值介于 -1 与 1 之间。这既表明单调关系的方向,也反映其强度。
+1 表示完美递增的单调关系;当一个变量增加时,另一个总是增加。当每对数值的排名完全相同时,会出现这种情况。
-1 表示完美递减的单调关系;当一个变量增加时,另一个总是减少。当每对数值的排名完全相反时,会出现这种情况。
0 表示没有单调关系。即排名中不存在一致的趋势。
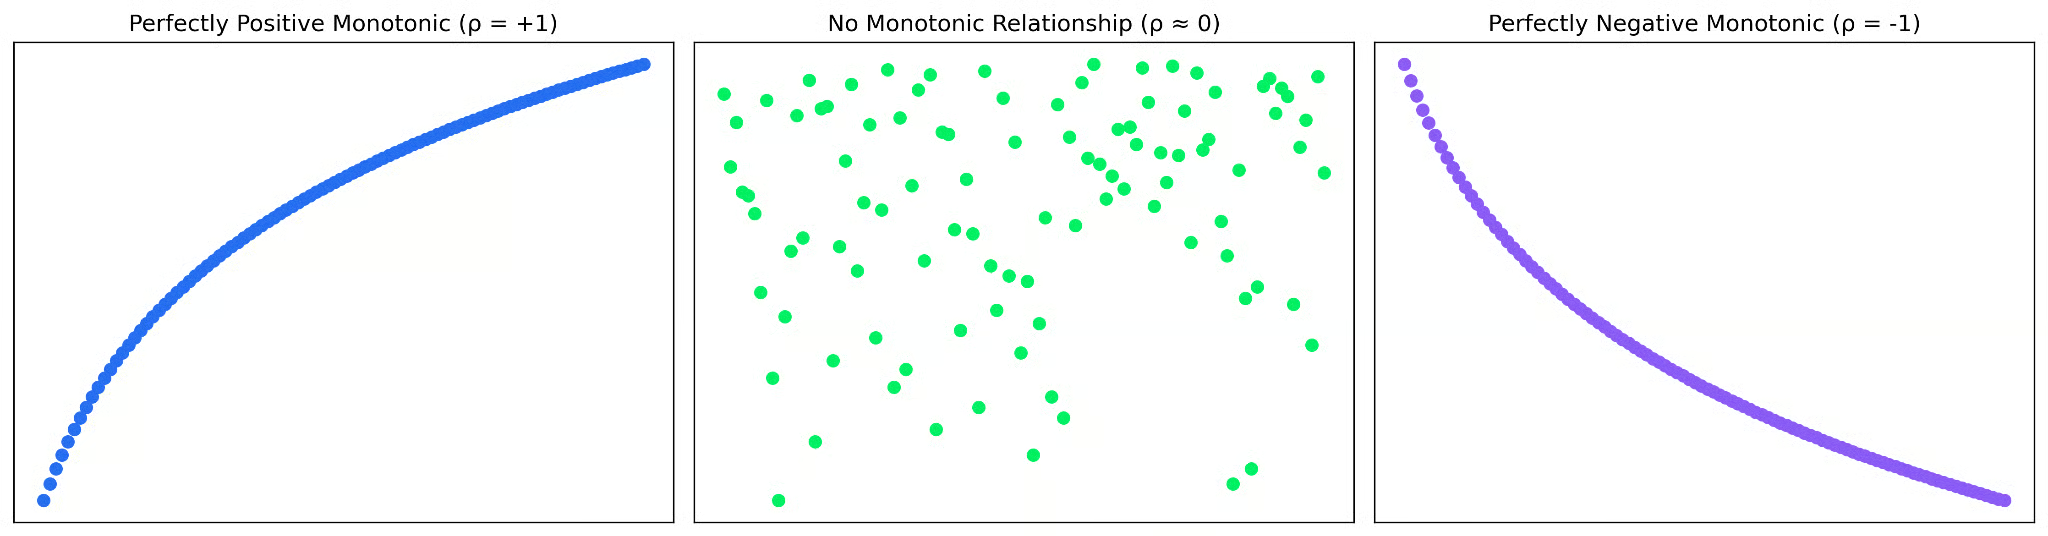
与皮尔逊相关系数的一个重要区别在于,斯皮尔曼相关反映的是数据顺序的吻合程度,而非实际数值与直线的贴合程度。这意味着,较强的斯皮尔曼相关指示排名上存在清晰趋势,并不必然表明关系是线性或间距均匀的。
因此,最好将相关系数与快速可视化结合使用,以更好地理解底层模式。
处理并列名次
一切听起来都很好,直到您遇到多个观测具有相同数值的数据集。此时该怎么办?这些称为并列,需要在赋名次时进行小幅调整。
例如,考虑数值:10、20、20、30。两个 20 正常会占据名次 2 和 3。然而,由于它们相同,我们不再赋予不同名次,而是将这两个名次的平均值分配给它们;两个 20 都得到名次 2.5。此方法确保对并列值的处理公平,且整体名次保持一致。
由于斯皮尔曼秩相关系数完全基于名次,若并列未被正确处理,相关性可能被扭曲。
斯皮尔曼相关的局限
尽管斯皮尔曼秩相关系数灵活且广泛使用,但也存在一些局限。
最重要的是,它只能捕捉单调关系。如果关系会改变方向,例如 U 形或正弦波,即便存在清晰模式,相关性也可能接近零。在这些情况下,使用非线性模型(如多项式回归)会更合适。
此外,由于斯皮尔曼相关基于名次,它忽略了数值之间的实际距离。这使其更能处理离群值,但也意味着会丢失部分信息。与皮尔逊相关相比,斯皮尔曼相关下关系幅度更难解读。它告诉您变量是否按顺序同向变化,但不告诉您一个变量相对于另一个变量变化了多少。
最后,当并列值较多时,排名过程的精度会降低。这可能导致较弱的相关值,无法充分反映关系的强度。
斯皮尔曼 vs. 皮尔逊:何时使用各自方法
最常用的相关性大概是皮尔逊相关系数。乍看之下,它似乎与斯皮尔曼相关系数非常相似,甚至名称几乎相同!但它们回答的问题略有不同。
皮尔逊问的是:“这些变量是否遵循直线关系?”,而斯皮尔曼问的是:“这些变量是否按相同顺序变化?”
如果您的数据大致呈直线模式,且数值间的实际距离具有意义,通常应选择皮尔逊相关。但如果关系会弯曲或趋于平缓,斯皮尔曼往往更合适。
斯皮尔曼也更“宽容”。由于其基于名次而非原始数值,对离群值不那么敏感,也不那么依赖数据分布假设。代价是它不擅长捕捉数值间幅度差异。
实践中,一个不错的经验法则是:若关系为线性,用皮尔逊;若关系为单调但非线性,用斯皮尔曼。且一如既往,在做决定前先绘图查看数据。
总结
斯皮尔曼相关系数是捕捉单调模式的有力工具,尤其适用于皮尔逊相关无法很好处理的数据集。通过使用名次,它对离群值不太敏感,并更能适应非线性数据。
您可以在理解相关性:衡量数据中的关系中进一步了解如何为您的数据集选择最佳的相关性度量。您或许也会对 理解协方差:入门指南感兴趣。