Không phải mọi mối quan hệ đều đi theo một đường thẳng.
Bạn có thể nhận thấy khi ngân sách marketing tăng thì tỷ lệ chuyển đổi khách hàng có xu hướng cải thiện, nhưng không phải với tốc độ cố định. Hoặc khi thu nhập tăng, mức độ hạnh phúc thường tăng rồi chững lại. Mẫu hình khá rõ, nhưng không tuyến tính. Bạn có thể làm gì để định lượng điều đó?
Tương quan được dùng để mô tả cách hai biến cùng biến động. Một thước đo tương quan phổ biến là Hệ số tương quan Pearson, vốn wận hành rất tốt cho các mối quan hệ tuyến tính. Tuy nhiên, nhiều mối quan hệ trong thực tế không tuyến tính. Chúng có thể cong, chững lại, hoặc theo một xu hướng nhất quán mà không tạo thành đường thẳng. Đôi khi, giá trị cụ thể không quan trọng bằng thứ tự xuất hiện của chúng. Đây chính là lúc Hệ số tương quan thứ hạng Spearman phát huy tác dụng.
Tương quan Spearman làm việc với thứ hạng thay vì giá trị thô, đo lường liệu hai biến có xu hướng tăng hoặc giảm cùng nhau theo một cách nhất quán hay không. Điều này khiến nó rất phù hợp với các mối quan hệ đơn điệu. Nó cũng bền vững hơn trước một số đặc thù dữ liệu, như ngoại lệ hoặc khoảng cách không đều.
Tương quan thứ hạng Spearman là gì?
Hệ số tương quan thứ hạng Spearman đo lường độ mạnh và chiều hướng của mối quan hệ giữa hai biến. Nó dựa trên thứ hạng các giá trị của chúng thay vì chính các giá trị.
Để thấy cách nó hoạt động, hãy tưởng tượng bạn đang phân tích các bài hát trên một nền tảng streaming. Bạn có thể so sánh số lần phát của một bài hát với thứ hạng của nó trên bảng xếp hạng “Top 100”. Mối quan hệ có thể không hoàn toàn tuyến tính, số lượt phát tăng gấp đôi không nhất thiết giúp thứ hạng tăng gấp đôi. Nhưng nhìn chung, bài hát có nhiều lượt phát hơn có xu hướng xếp hạng cao hơn.
Tương quan Spearman nắm bắt mẫu hình này bằng cách tập trung vào thứ tự của dữ liệu thay vì giá trị chính xác.
Điều này đặc biệt hữu ích khi mối quan hệ không tuyến tính nhưng vẫn theo một xu hướng rõ ràng, dữ liệu mang tính xếp hạng tự nhiên, hoặc dữ liệu có ngoại lệ có thể làm méo đi một phép đo tuyến tính.
Không giống tương quan Pearson làm việc trực tiếp với giá trị thô, tương quan Spearman trước hết chuyển dữ liệu thành thứ hạng rồi đo xem các thứ hạng đó ăn khớp với nhau như thế nào.
Về mặt kỹ thuật, tương quan Spearman đo lường các mối quan hệ đơn điệu. Một mối quan hệ là đơn điệu nếu một biến có xu hướng tăng khi biến kia tăng, hoặc giảm khi biến kia giảm, mà không đổi chiều.
Quan hệ đơn điệu so với quan hệ tuyến tính
Vậy chính xác sự khác biệt giữa quan hệ tuyến tính và quan hệ đơn điệu là gì?
Quan hệ tuyến tính là khi dữ liệu đi theo một mẫu hình đường thẳng. Nếu bạn vẽ dữ liệu, các điểm sẽ xếp thành một đường.
Quan hệ đơn điệu thì bớt nghiêm ngặt hơn. Nó chỉ có nghĩa là mối quan hệ đi theo một chiều. Về cơ bản, cả hai biến cùng chuyển động, nhưng không nhất thiết theo đường thẳng. Mẫu hình có thể cong, chững lại hoặc thay đổi tốc độ, miễn là không đảo chiều.
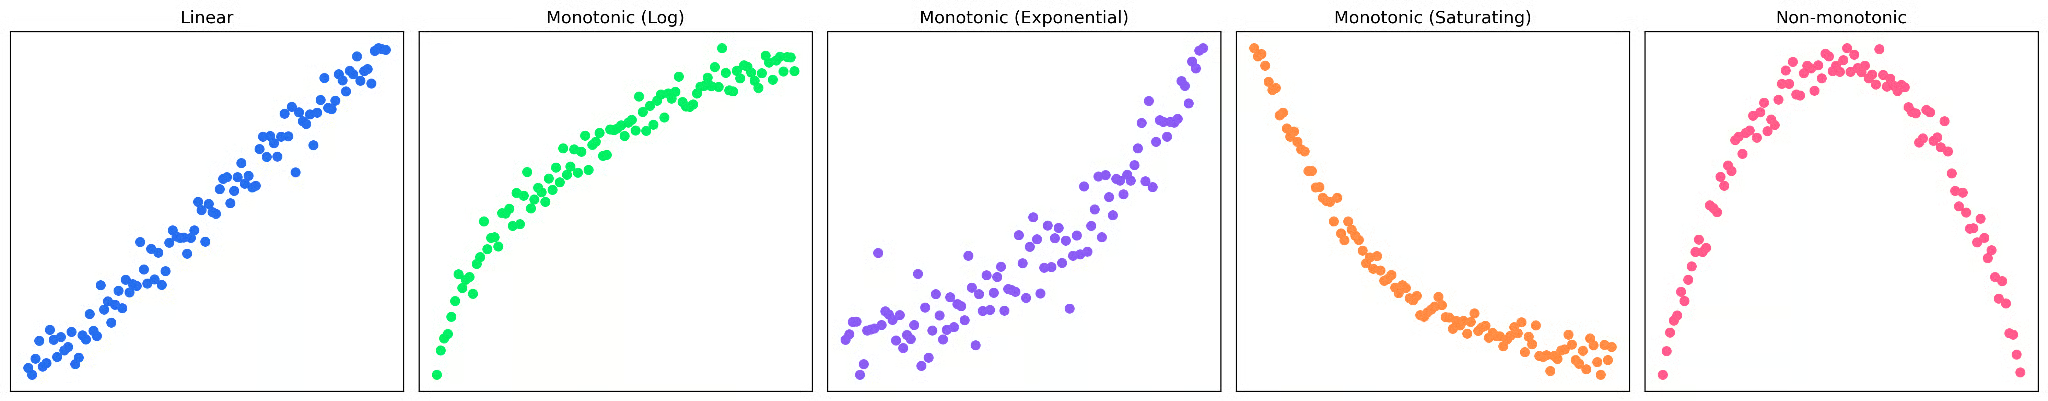
Trong các đồ thị trên, bạn có thể thấy bốn ví dụ khác nhau về quan hệ đơn điệu, chỉ có ví dụ đầu tiên là tuyến tính. Đồ thị cuối không đơn điệu vì mẫu hình đổi chiều, bắt đầu là tương quan dương và kết thúc là tương quan âm.
|
Loại mối quan hệ |
Mô tả |
Hình dạng |
|
Tuyến tính |
Các biến tăng hoặc giảm với tốc độ không đổi |
Đường thẳng |
|
Đơn điệu (Nhưng phi tuyến) |
Các biến chuyển động cùng chiều, nhưng tốc độ thay đổi |
Xu hướng cong, chững lại, hoặc tăng tốc |
|
Không đơn điệu |
Mối quan hệ đổi chiều (tăng rồi giảm, hoặc ngược lại) |
Dạng chữ U, U ngược, hoặc gợn sóng |
Cách tìm tương quan thứ hạng Spearman theo từng bước
Về tổng thể, hệ số tương quan thứ hạng Spearman hoạt động bằng cách chuyển dữ liệu của bạn thành thứ hạng rồi đo lường mức độ giống nhau của các thứ hạng giữa các biến.
Hãy cùng làm một ví dụ nhỏ. Giả sử chúng ta đang xem xét mối quan hệ giữa số giờ luyện tập nhạc cụ và thứ hạng biểu diễn trong một cuộc thi.
|
Học sinh |
Giờ luyện tập (X) |
Điểm biểu diễn (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Trước hết, hãy vẽ đồ thị dữ liệu.
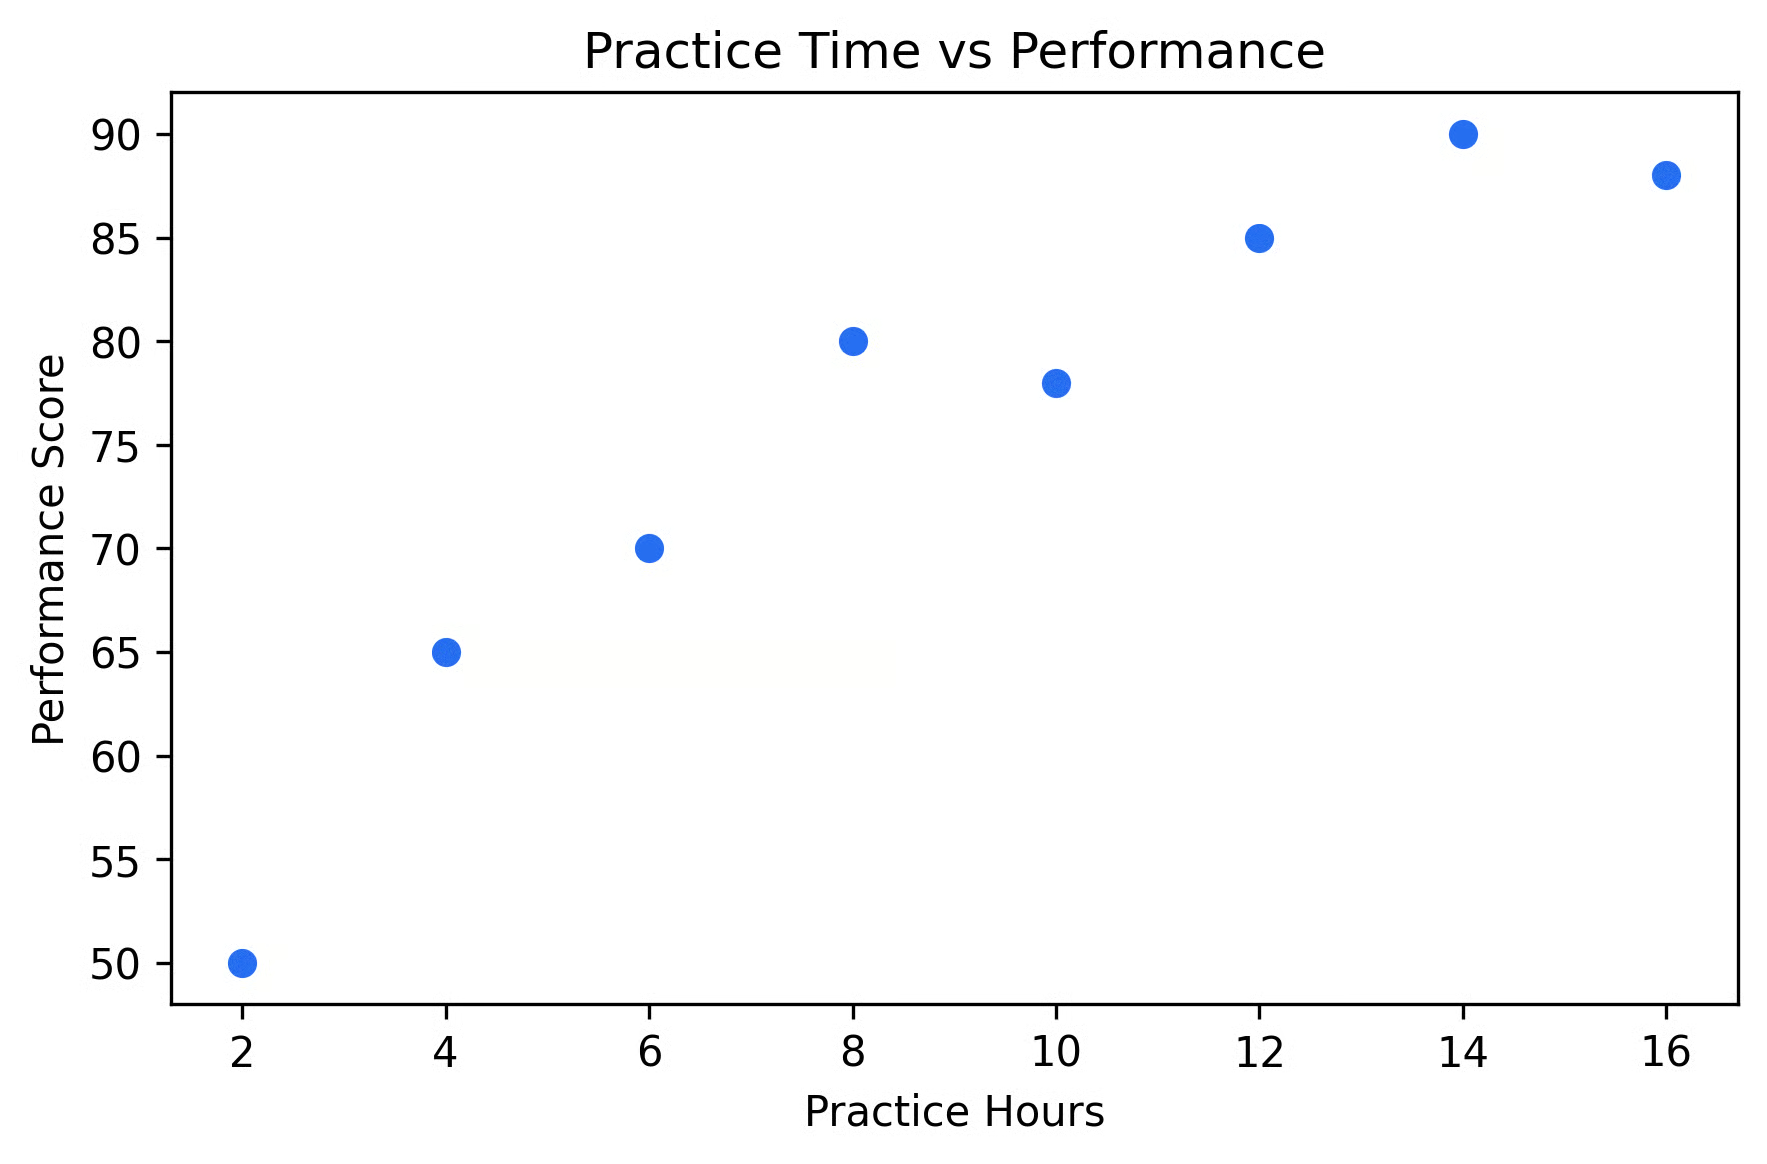
Nhìn trực quan, có vẻ luyện tập nhiều hơn dẫn đến điểm biểu diễn cao hơn, nhưng mẫu hình không hoàn toàn tuyến tính. Có vẻ tồn tại hiệu ứng lợi suất giảm dần khi luyện tập quá nhiều. Hãy thử áp dụng thứ hạng Spearman để định lượng mối quan hệ này.
Bước 1: chuyển dữ liệu thành thứ hạng
Đầu tiên, hãy gán thứ hạng cho mỗi giá trị. Trong từng biến, chúng ta gán thứ hạng cho mỗi giá trị từ nhỏ đến lớn. Giá trị nhỏ nhất trong một biến nhận hạng 1, nhỏ nhì hạng 2, v.v.n.
|
Học sinh |
Giờ luyện tập (X) |
Hạng (X) |
Điểm biểu diễn (Y) |
Hạng (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Lưu ý rằng thứ hạng của Y hơi khác thứ tự so với X. Đây chính là biến thiên mà tương quan Spearman sẽ đo lường.
Bước 2: tính chênh lệch thứ hạng
Tiếp theo, chúng ta tính chênh lệch giữa các thứ hạng cho từng quan sát.
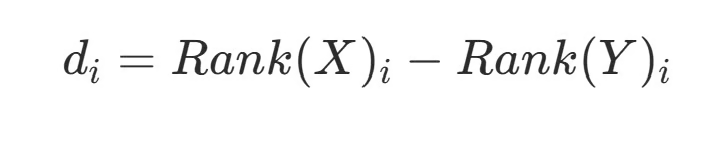
Sau đó bình phương từng chênh lệch:
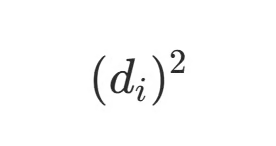
|
Học sinh |
Hạng(X) |
Hạng(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Giờ hãy cộng các bình phương chênh lệch ở cột cuối bảng.
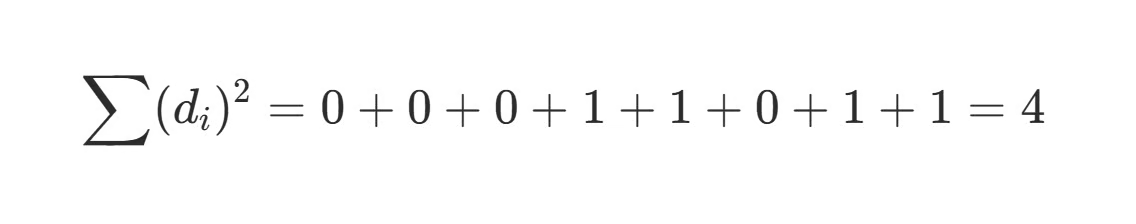
Bước 3: áp dụng công thức
Cuối cùng, chúng ta thế các giá trị vào công thức tương quan Spearman.
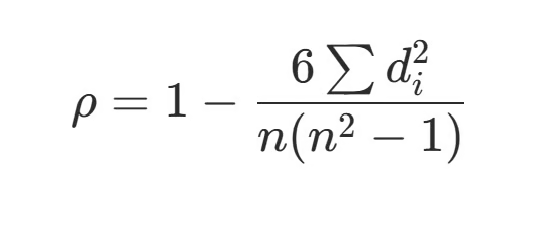
Chúng ta đã biết (di)2=4 từ phép tính trước đó. n ở mẫu số là cỡ mẫu, với chúng ta là 8. Thế vào, ta có:
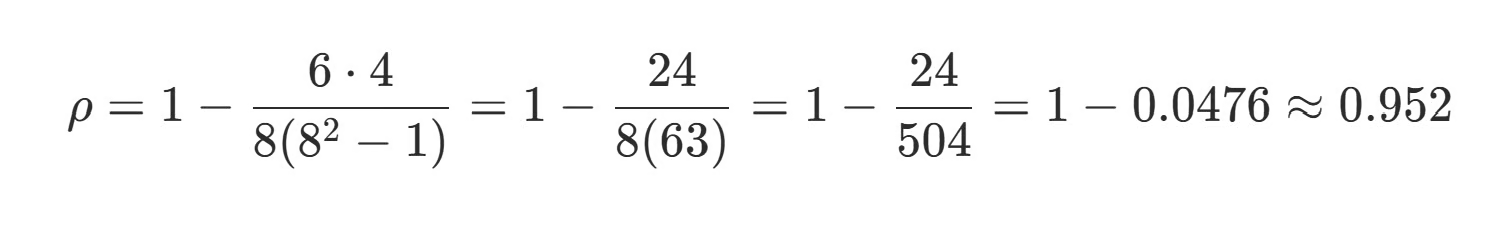
Diễn giải kết quả
Kết quả cuối cùng của chúng ta là ρ ~ 0,95. Vì giá trị này gần +1, nó cho thấy mối quan hệ dương rất mạnh giữa thời gian luyện tập và thành tích. Dù mối quan hệ không hoàn toàn tuyến tính, các thứ hạng rất giống nhau. Điều này nghĩa là khi giá trị x thay đổi, giá trị y cũng có xu hướng thay đổi một cách nhất quán theo.
Trong thực tế, hiếm khi chúng ta tự tính bằng tay. Hầu hết phần mềm sẽ tự động xử lý xếp hạng, các trường hợp đồng hạng và phép tính, điều này rất tốt vì thông thường chúng ta có cỡ mẫu lớn hơn nhiều!
Tính tương quan Spearman bằng phần mềm
Ngày nay, hầu hết phần mềm thống kê đều có thể xử lý phép tính này trong vài giây. Hãy lướt qua một số công cụ phổ biến nhất.
Python
Trong Python, bạn thường dùng scipy hoặc pandas, tùy theo quy trình làm việc. Nếu bạn làm việc với mảng hoặc danh sách, scipy cung cấp cách trực tiếp để tính tương quan Spearman.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
Lệnh này trả về cả hệ số tương quan và p-value, hữu ích khi bạn thực hiện kiểm định thống kê.
Nếu bạn làm việc với dữ liệu dạng bảng, pandas thường thuận tiện hơn.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Lệnh này tính ma trận tương quan, giúp bạn dễ dàng so sánh nhiều biến cùng lúc.
Ngoài ra, nếu bạn chỉ cần tương quan giữa hai cột cụ thể, bạn có thể chỉ định dễ dàng.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
Trong R, tương quan Spearman được tích hợp sẵn trong các hàm thống kê cốt lõi.
Để tính nhanh, bạn có thể dùng cor() và chỉ định phương pháp Spearman.
cor(x, y, method = "spearman")Nếu bạn cũng muốn p-value và các chi tiết thống kê bổ sung, cor.test() cung cấp rất dễ dàng.
cor.test(x,y,method="spearman")Excel
Excel không có hàm Spearman tích hợp, nhưng bạn có thể tính trong hai bước nhanh: trước tiên, xếp hạng dữ liệu, sau đó lấy tương quan của các thứ hạng đó.
Dưới đây là một ví dụ nhỏ:
|
A (X) |
B (Y) |
C (Hạng X) |
D (Hạng Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Bạn có thể tạo thứ hạng (cột C và D) bằng hàm RANK.AVG. Ví dụ:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Sau đó, chỉ cần tính tương quan Spearman.
=CORREL(C2:C6, D2:D6)Trong tất cả các công cụ này, quy trình cơ bản đều giống nhau: chuyển giá trị thành thứ hạng rồi tính tương quan của các thứ hạng đó.
Cách diễn giải tương quan thứ hạng Spearman
Nếu bạn từng dùng tương quan Pearson, có lẽ bạn đã có trực giác khá tốt để diễn giải tương quan thứ hạng Spearman, vì diễn giải của chúng về cơ bản là giống nhau.
Tương quan Spearman cho bạn một giá trị từ -1 đến 1. Giá trị này cho biết cả chiều hướng và độ mạnh của mối quan hệ đơn điệu.
Giá trị +1 cho thấy mối quan hệ đơn điệu tăng hoàn hảo; khi một biến tăng, biến kia luôn tăng. Điều này xảy ra khi thứ hạng của từng cặp giá trị là giống hệt nhau.
Giá trị -1 cho thấy mối quan hệ đơn điệu giảm hoàn hảo; khi một biến tăng, biến kia luôn giảm. Điều này xảy ra khi thứ hạng của từng cặp giá trị đảo ngược chính xác.
Giá trị 0 cho thấy không có mối quan hệ đơn điệu. Điều này xảy ra khi không có xu hướng nhất quán trong thứ hạng.
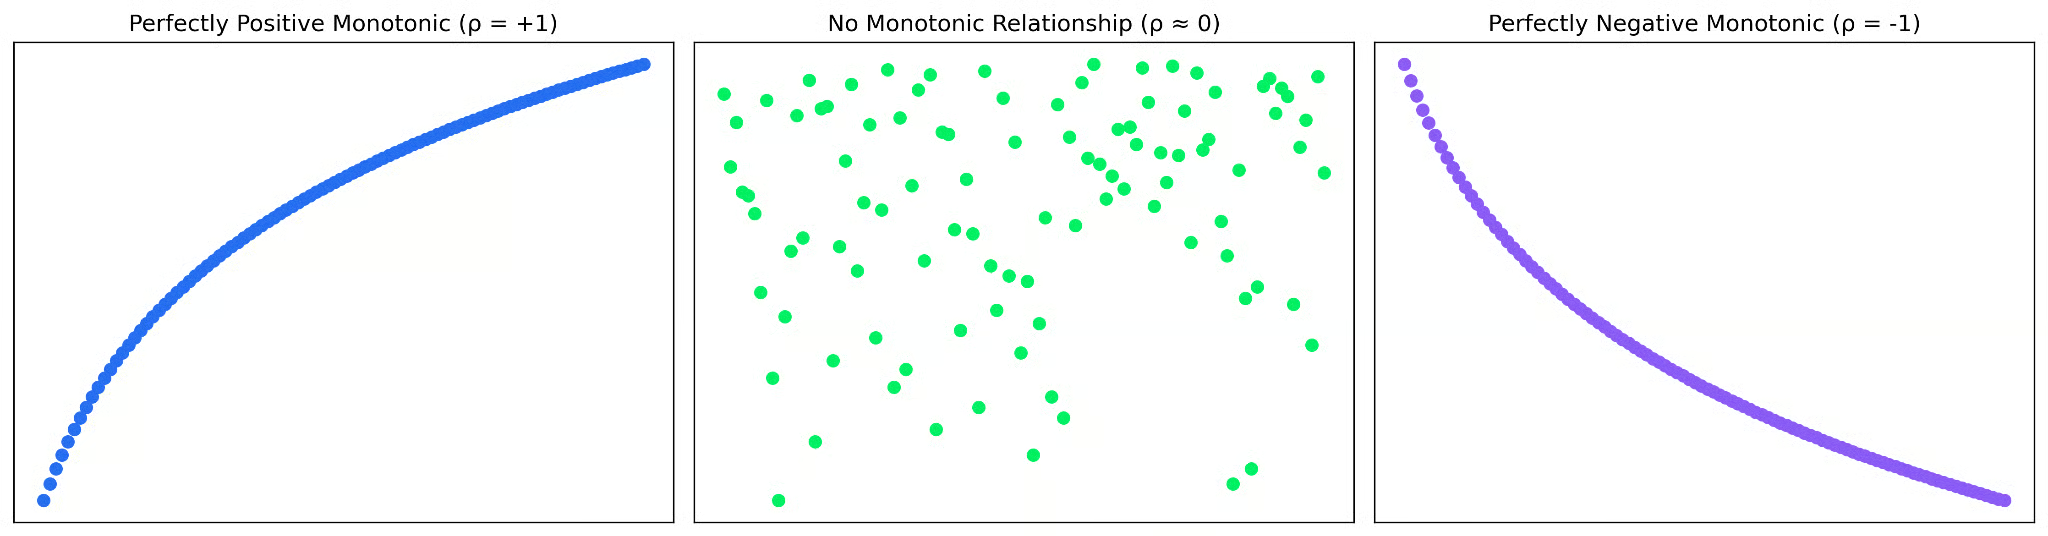
Một điểm khác biệt quan trọng với hệ số tương quan Pearson là tương quan Spearman phản ánh mức độ ăn khớp của thứ tự dữ liệu, chứ không phải mức độ các giá trị thực bám theo đường thẳng. Điều này nghĩa là một tương quan Spearman mạnh cho thấy xu hướng rõ ràng trong thứ hạng, chứ không nhất thiết mối quan hệ là tuyến tính hoặc có khoảng cách đều.
Vì vậy, luôn là ý hay khi kết hợp giá trị tương quan với một hình trực quan nhanh để hiểu rõ nhất mẫu hình cơ bản.
Xử lý đồng hạng trong xếp hạng
Mọi chuyện nghe có vẻ ổn cho đến khi bạn gặp một tập dữ liệu có nhiều quan sát cùng giá trị. Khi đó phải làm gì? Đây gọi là đồng hạng (ties), và cần một điều chỉnh nhỏ khi gán thứ hạng.
Ví dụ, xét các giá trị: 10, 20, 20, 30. Hai giá trị 20 bình thường sẽ chiếm hạng 2 và 3. Tuy nhiên, vì chúng trùng nhau, thay vì gán hạng khác nhau, ta gán cho mỗi giá trị trung bình của hai hạng đó; cả hai giá trị 20 nhận hạng 2,5. Cách tiếp cận này đảm bảo các giá trị đồng hạng được xử lý công bằng và thứ hạng tổng thể vẫn nhất quán.
Vì hệ số tương quan thứ hạng Spearman hoàn toàn dựa trên thứ hạng, nếu không xử lý đúng đồng hạng, tương quan có thể bị sai lệch.
Hạn chế của tương quan Spearman
Dù hệ số tương quan thứ hạng Spearman là một thước đo linh hoạt và được dùng rộng rãi, nó vẫn có một số hạn chế.
Quan trọng nhất, nó chỉ bắt được các mối quan hệ đơn điệu. Nếu một mối quan hệ đổi chiều, như dạng chữ U hoặc sóng sin, tương quan có thể gần bằng không ngay cả khi mẫu hình rõ ràng. Trong các trường hợp này, bạn nên dùng mô hình phi tuyến, như hồi quy đa thức.
Ngoài ra, vì tương quan Spearman dựa trên thứ hạng, nó bỏ qua khoảng cách thực giữa các giá trị. Điều này giúp nó xử lý ngoại lệ tốt hơn, nhưng cũng đồng nghĩa mất đi một phần thông tin. Mức độ (độ lớn) của mối quan hệ khó diễn giải hơn với tương quan Spearman so với Pearson vì lý do này. Nó cho biết liệu các biến có chuyển động cùng thứ tự hay không, chứ không cho biết một biến thay đổi bao nhiêu so với biến kia.
Cuối cùng, khi có nhiều giá trị đồng hạng, quá trình xếp hạng kém chính xác hơn. Điều này có thể dẫn đến giá trị tương quan yếu hơn, có khả năng không phản ánh đầy đủ mức độ của mối quan hệ.
Spearman so với Pearson: Khi nào dùng mỗi loại
Thước đo tương quan được dùng phổ biến nhất có lẽ là hệ số tương quan Pearson. Thoạt nhìn, nó có vẻ rất giống hệ số tương quan Spearman. Tên gọi của chúng thậm chí gần như giống hệt! Nhưng chúng trả lời những câu hỏi hơi khác nhau.
Pearson hỏi: “Các biến này có theo quan hệ đường thẳng không?”, còn Spearman hỏi: “Các biến này có chuyển động theo cùng thứ tự không?”
Nếu dữ liệu của bạn theo mẫu hình gần như đường thẳng và khoảng cách thực giữa các giá trị có ý nghĩa, tương quan Pearson thường là lựa chọn đúng. Nhưng nếu mối quan hệ cong hoặc chững lại, Spearman thường phù hợp hơn.
Spearman cũng “dễ chịu” hơn. Vì nó làm việc với thứ hạng thay vì giá trị thô, nó kém nhạy với ngoại lệ và ít phụ thuộc vào các giả định về dữ liệu. Đổi lại, nó không giỏi trong việc nắm bắt khác biệt về độ lớn giữa các giá trị.
Trong thực tế, một nguyên tắc ngón tay cái hay dùng là: nếu mối quan hệ tuyến tính, dùng Pearson; nếu đơn điệu nhưng phi tuyến, dùng Spearman. Và như mọi khi, hãy vẽ dữ liệu trước khi quyết định.
Kết luận
Hệ số tương quan Spearman là công cụ tuyệt vời để nắm bắt các mẫu hình đơn điệu, đặc biệt trong các tập dữ liệu mà tương quan Pearson không phục vụ tốt. Bằng cách làm việc với thứ hạng, nó kém nhạy với ngoại lệ và bao dung hơn với dữ liệu phi tuyến.
Bạn có thể đọc thêm về cách chọn tương quan phù hợp nhất cho tập dữ liệu của mình trong Hiểu về tương quan: Đo lường các mối quan hệ trong dữ liệu. Bạn cũng có thể quan tâm đến Hiểu về hiệp phương sai: Hướng dẫn nhập môn.