Nem toda relação segue uma linha reta.
Você pode notar que, conforme o orçamento de marketing aumenta, a conversão de clientes tende a melhorar — mas não a uma taxa constante. Ou, talvez, conforme a renda sobe, a felicidade costuma aumentar e depois estabiliza. O padrão é claro, mas não é linear. Como quantificar isso?
A correlação descreve como duas variáveis se movem juntas. Uma medida comum que você verá é o coeficiente de correlação de Pearson, que funciona muito bem para relações lineares. Porém, muitas relações do mundo real não são lineares. Elas podem curvar, atingir um platô ou seguir uma tendência consistente sem formar uma linha reta. Em alguns casos, os valores exatos importam menos do que a ordem em que aparecem. É aí que entra o coeficiente de correlação por postos de Spearman.
A correlação de Spearman trabalha com postos em vez de valores brutos, medindo se duas variáveis tendem a aumentar ou diminuir juntas de maneira consistente. Por isso, é ideal para relações monotônicas. Também é mais robusta a certas peculiaridades dos dados, como outliers ou espaçamentos irregulares.
O que é a correlação por postos de Spearman?
O coeficiente de correlação por postos de Spearman mede a força e a direção da relação entre duas variáveis, com base no posto de seus valores, não nos valores em si.
Para ver isso na prática, imagine que você está analisando músicas em uma plataforma de streaming. Você pode comparar o número de reproduções de uma música com sua posição no “Top 100”. A relação pode não ser perfeitamente linear: dobrar o número de streams não necessariamente dobra a posição no ranking. Mas, em geral, músicas com mais streams tendem a ficar melhor colocadas.
A correlação de Spearman captura esse tipo de padrão ao focar na ordem dos dados, e não nos valores exatos.
Isso a torna especialmente útil quando a relação não é linear, mas ainda segue uma tendência clara; quando os dados são naturalmente expressos como rankings; ou quando há outliers que podem distorcer uma medida linear.
Diferente da correlação de Pearson, que trabalha diretamente com valores brutos, a correlação de Spearman primeiro converte os dados em postos e depois mede quão próximos esses rankings estão entre si.
Tecnicamente, a correlação de Spearman mede relações monotônicas. Uma relação é monotônica quando uma variável tende a aumentar conforme a outra aumenta, ou a diminuir conforme a outra diminui, sem mudar de direção.
Relações monotônicas vs. lineares
Afinal, qual é a diferença entre relações lineares e monotônicas?
Uma relação linear é aquela em que os dados seguem um padrão de linha reta. Se você traçar um gráfico, verá os pontos formando aproximadamente uma linha.
Já uma relação monotônica é menos rígida. Ela apenas significa que a relação se move em uma única direção. Essencialmente, as duas variáveis se movem juntas, mas não necessariamente em linha reta. O padrão pode curvar, estabilizar ou mudar de ritmo, desde que não inverta a direção.
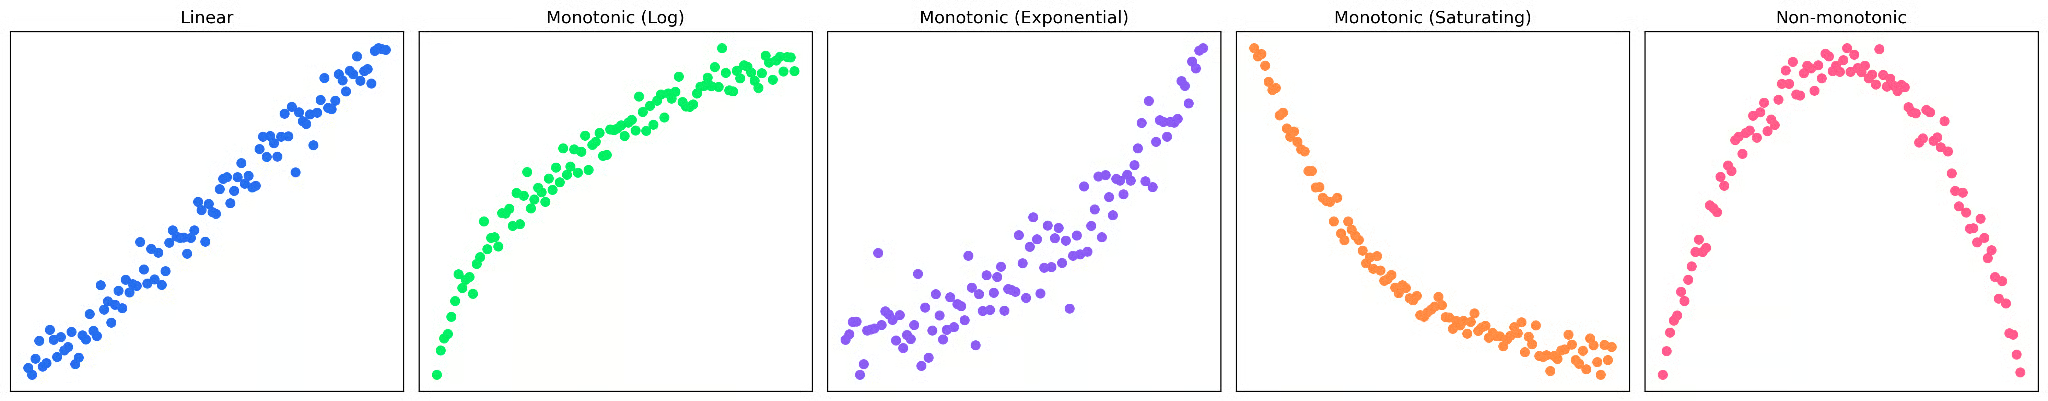
Nos gráficos acima, você vê quatro exemplos de relações monotônicas, dos quais apenas o primeiro é linear. O último gráfico não é monotônico, pois o padrão muda de direção: começa como uma associação positiva e termina como uma associação negativa.
|
Tipo de relação |
Descrição |
Como parece |
|
Linear |
Variáveis aumentam ou diminuem a uma taxa constante |
Linha reta |
|
Monotônica (mas não linear) |
Variáveis se movem em uma direção, mas a taxa muda |
Tendência curva, que estabiliza ou acelera |
|
Não monotônica |
A relação muda de direção (aumenta e depois diminui, ou vice-versa) |
Formato em U, U invertido ou padrão ondulado |
Como encontrar a correlação de Spearman passo a passo
Em linhas gerais, o coeficiente de Spearman funciona convertendo os dados em postos e medindo quão semelhantes são os rankings entre as variáveis.
Vamos ver um exemplo simples. Suponha que estejamos analisando a relação entre horas de prática de um instrumento musical e a classificação de desempenho em uma competição.
|
Aluno |
Horas de prática (X) |
Pontuação de desempenho (Y) |
|
Aladdin |
2 |
50 |
|
Bonnie |
4 |
65 |
|
Clyde |
6 |
70 |
|
Daniel |
8 |
80 |
|
Eloise |
10 |
78 |
|
Franny |
12 |
85 |
|
Gemma |
14 |
90 |
|
Harris |
16 |
88 |
Primeiro, vamos plotar os dados.
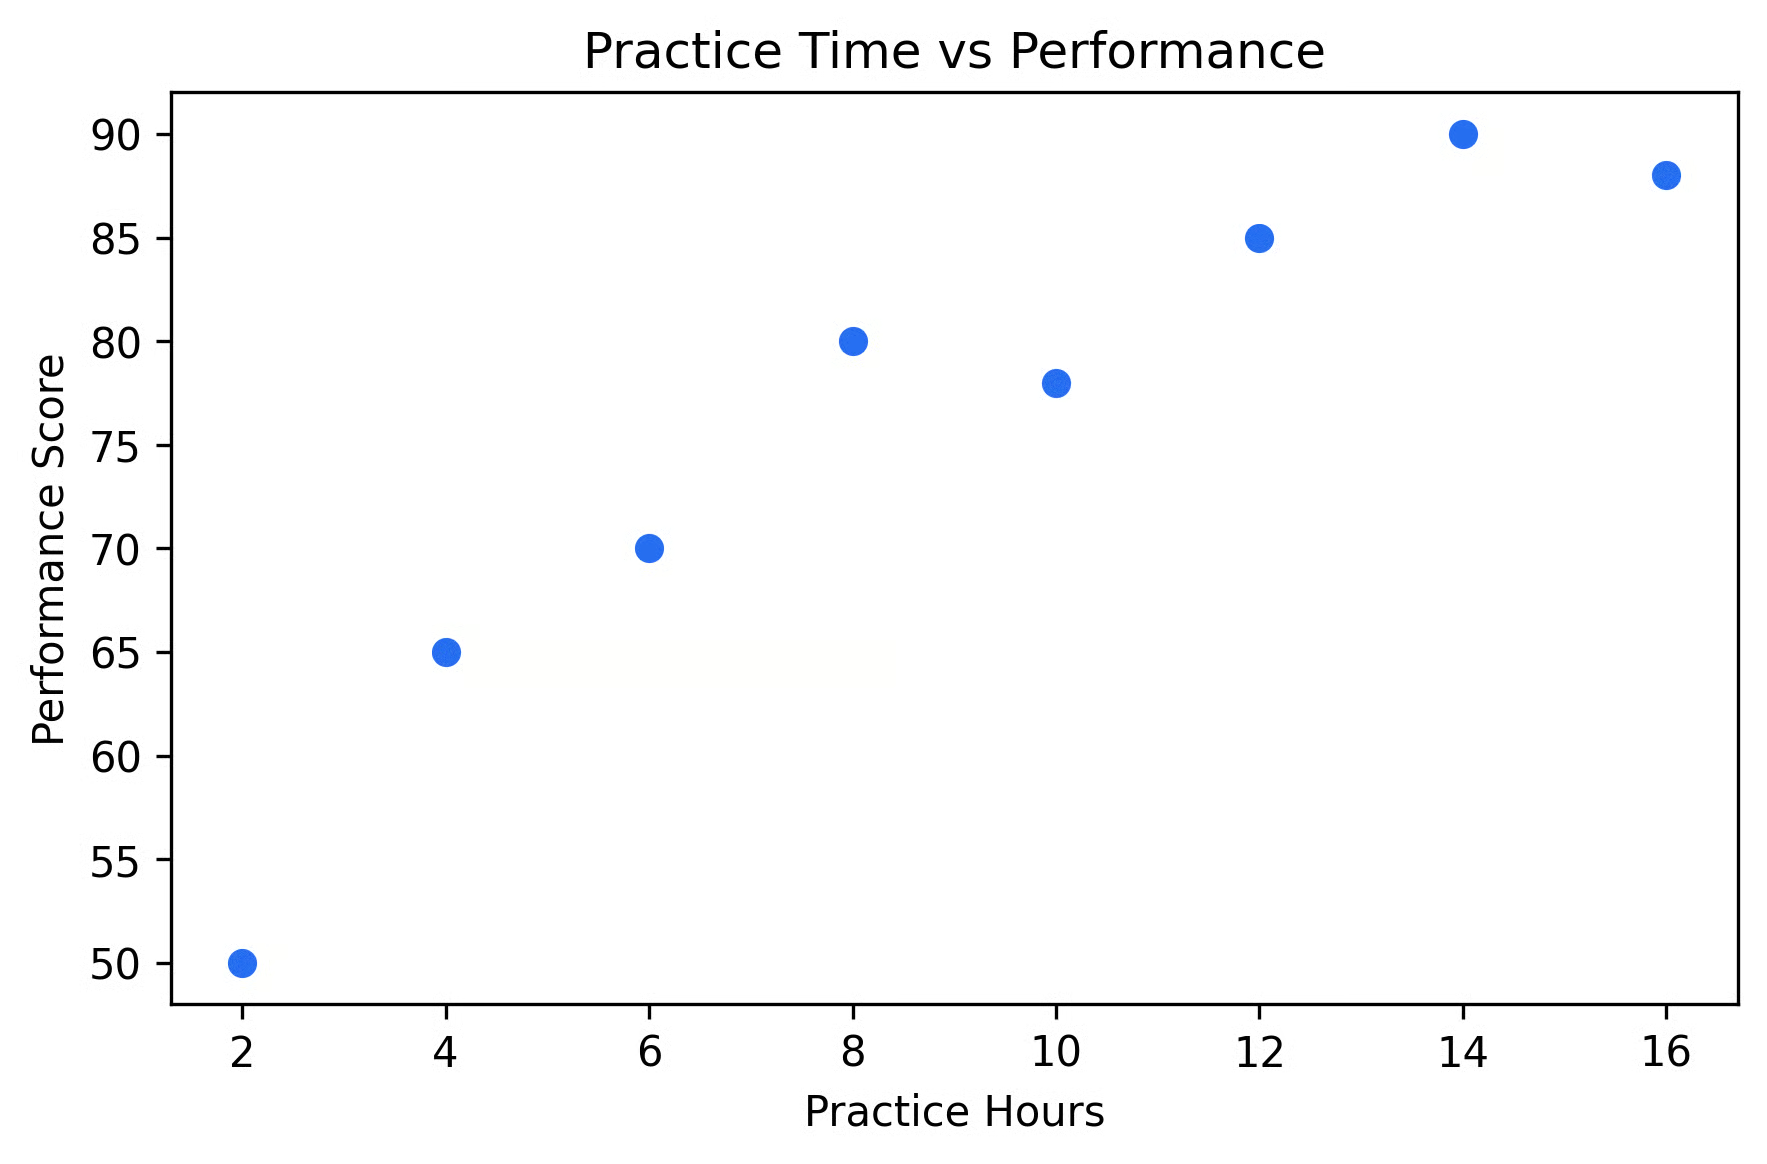
Visualmente, parece que mais prática resulta em pontuações mais altas, mas o padrão não é perfeitamente linear. Ao que tudo indica, há retornos decrescentes quando se pratica demais. Vamos aplicar Spearman para quantificar essa relação.
Passo 1: converter os dados em postos
Primeiro, vamos atribuir um posto a cada valor. Dentro de cada variável, classificamos os valores do menor para o maior. O menor valor recebe posto 1, o segundo menor recebe posto 2 e assim por dia.
|
Aluno |
Horas de prática (X) |
Posto (X) |
Pontuação de desempenho (Y) |
Posto (Y) |
|
Aladdin |
2 |
1 |
50 |
1 |
|
Bonnie |
4 |
2 |
65 |
2 |
|
Clyde |
6 |
3 |
70 |
3 |
|
Daniel |
8 |
4 |
80 |
5 |
|
Eloise |
10 |
5 |
78 |
4 |
|
Franny |
12 |
6 |
85 |
6 |
|
Gemma |
14 |
7 |
90 |
8 |
|
Harris |
16 |
8 |
88 |
7 |
Perceba que os rankings de Y estão em uma ordem um pouco diferente dos de X. É essa variação que a correlação de Spearman mede.
Passo 2: calcular as diferenças entre postos
Agora, calculamos a diferença entre os postos para cada observação.
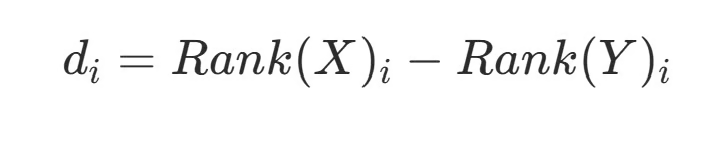
Depois, elevamos cada diferença ao quadrado:
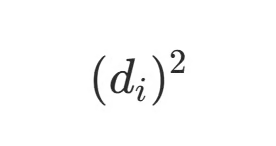
|
Aluno |
Posto(X) |
Posto(Y) |
di |
(di)2 |
|
A |
1 |
1 |
0 |
0 |
|
B |
2 |
2 |
0 |
0 |
|
C |
3 |
3 |
0 |
0 |
|
D |
4 |
5 |
-1 |
1 |
|
E |
5 |
4 |
1 |
1 |
|
F |
6 |
6 |
0 |
0 |
|
G |
7 |
8 |
-1 |
1 |
|
H |
8 |
7 |
1 |
1 |
Agora somamos as diferenças ao quadrado na última coluna da tabela.
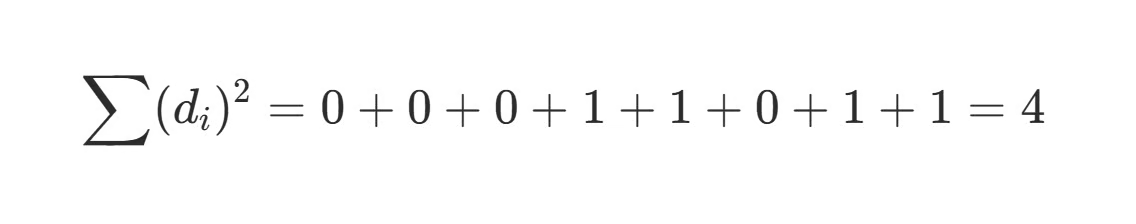
Passo 3: aplicar a fórmula
Por fim, precisamos substituir os valores na fórmula da correlação de Spearman.
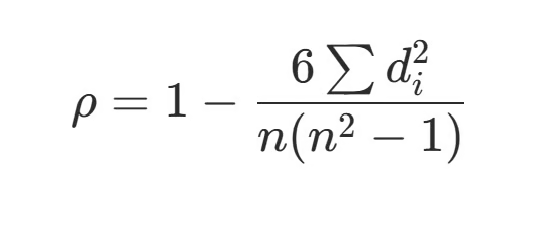
Já sabemos que (di)2=4 pelas contas anteriores. O n no denominador é o tamanho da amostra, que no nosso caso é 8. Substituindo, obtemos:
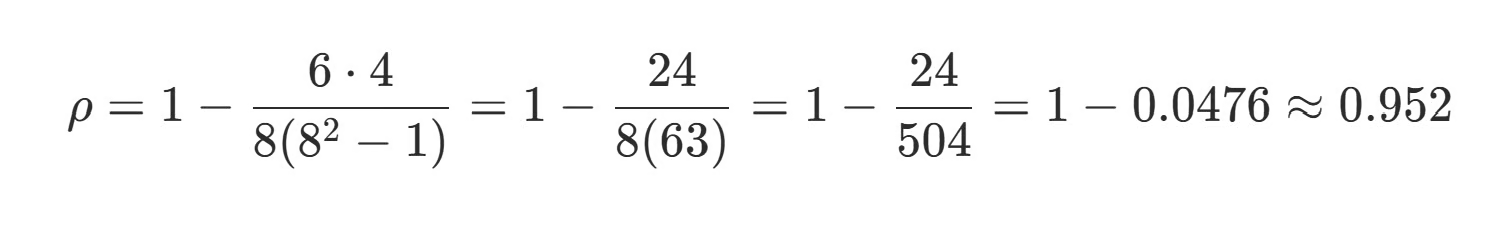
Interpretando o resultado
Nosso resultado final é ρ ~ 0,95. Como esse valor está próximo de +1, indica uma forte relação positiva entre tempo de prática e desempenho. Mesmo que a relação não seja perfeitamente linear, os rankings são muito semelhantes. Isso significa que, quando o valor de x muda, o valor de y tende a mudar de forma consistente junto com ele.
Na prática, é raro fazer isso à mão. A maior parte dos softwares calcula postos, empates e correlação automaticamente — o que é ótimo, já que geralmente trabalhamos com amostras bem maiores!
Calculando a correlação de Spearman com software
Hoje, a maioria dos softwares estatísticos faz esse cálculo em segundos. Vamos ver rapidamente os mais comuns.
Python
No Python, você normalmente usa scipy ou pandas, dependendo do seu fluxo de trabalho. Se estiver trabalhando com arrays ou listas, scipy oferece uma forma direta de calcular a correlação de Spearman.
py
corr, p_value = spearmanr(x, y)
print(corr, p_value)
A função retorna o coeficiente de correlação e o p-valor, úteis caso você esteja fazendo testes estatísticos.
Se você trabalha com dados tabulares, o pandas costuma ser mais conveniente.
corr_matrix = df.corr(method="spearman")
print(corr_matrix)
Isso calcula a matriz de correlação, facilitando comparar várias variáveis de uma vez.
Se quiser apenas a correlação entre duas colunas específicas, dá para especificar facilmente.
corr=df["column_1"].corr(df["column_2"],method="spearman")R
No R, a correlação de Spearman está embutida nas funções estatísticas básicas.
Para um cálculo rápido, você pode usar cor() e especificar o método Spearman.
cor(x, y, method = "spearman")Se quiser também o p-valor e mais detalhes estatísticos, cor.test() resolve facilmente.
cor.test(x,y,method="spearman")Excel
O Excel não tem uma função de Spearman pronta, mas você consegue calcular em dois passos: primeiro, crie os postos; depois, calcule a correlação desses postos.
Aqui vai um pequeno exemplo:
|
A (X) |
B (Y) |
C (Posto X) |
D (Posto Y) |
|
2 |
50 |
1 |
1 |
|
4 |
65 |
2 |
2 |
|
6 |
70 |
3 |
3 |
|
8 |
80 |
5 |
5 |
|
10 |
78 |
4 |
4 |
Você pode criar os postos (colunas C e D) usando a função RANK.AVG. Por exemplo:
=RANK.AVG(A2, $A$2:$A$6,1)
=RANK.AVG(B2, $B$2:$B$6,1)
Em seguida, basta calcular a correlação de Spearman.
=CORREL(C2:C6, D2:D6)Em todas essas ferramentas, o processo é o mesmo: converter valores em postos e então calcular a correlação desses postos.
Como interpretar a correlação de Spearman
Se você já usou a correlação de Pearson, provavelmente tem uma boa intuição para interpretar a correlação de Spearman, já que a interpretação é basicamente a mesma.
A medida de Spearman varia entre -1 e 1 e informa a direção e a força de uma relação monotônica.
Um valor de +1 indica uma relação monotônica perfeitamente crescente: à medida que uma variável aumenta, a outra sempre aumenta. Isso ocorre quando os rankings de cada par de valores são exatamente iguais.
Um valor de -1 indica uma relação monotônica perfeitamente decrescente: à medida que uma variável aumenta, a outra sempre diminui. Isso ocorre quando os rankings de cada par são exatamente invertidos.
Um valor de 0 indica ausência de relação monotônica, quando não há tendência consistente nos rankings.
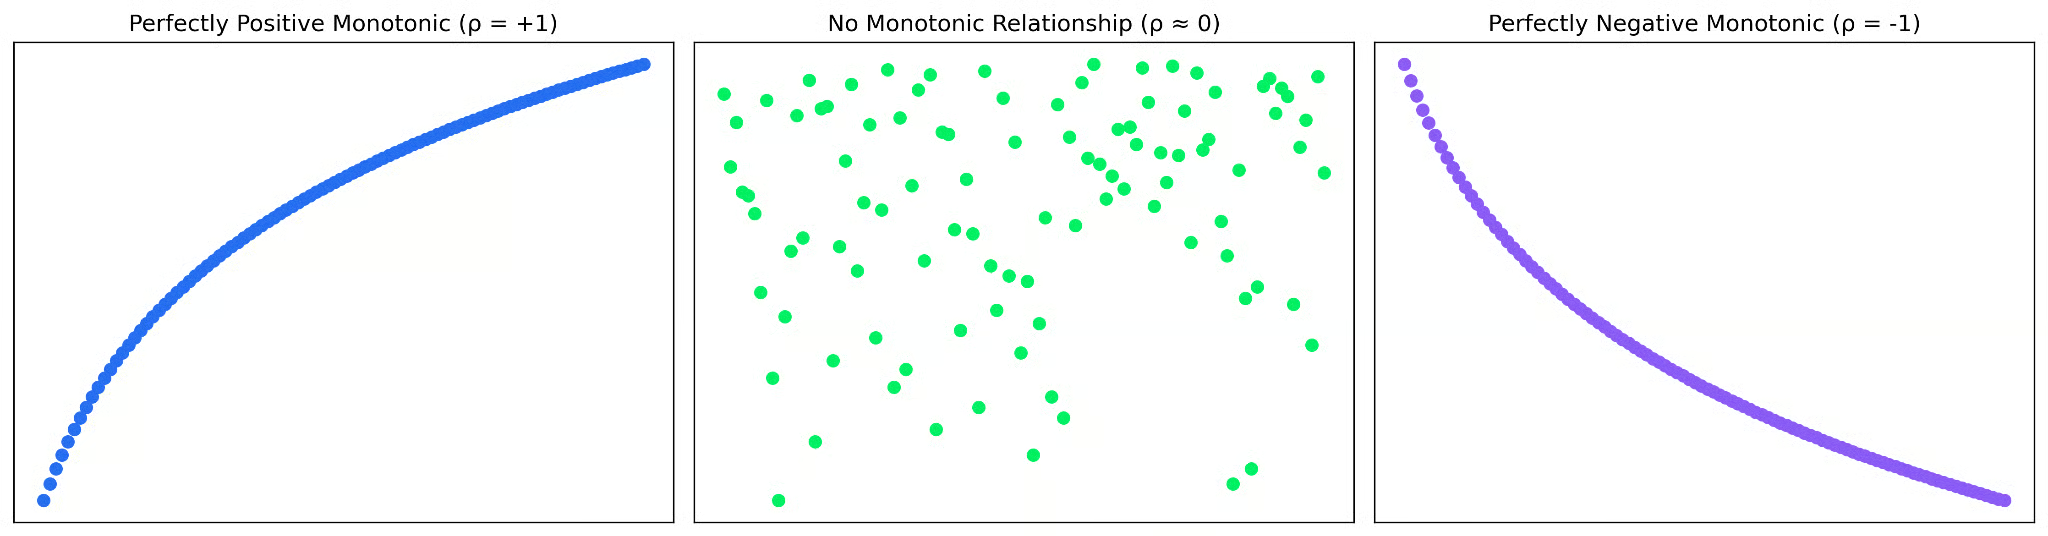
Uma diferença importante em relação ao coeficiente de Pearson é que a correlação de Spearman reflete o quão bem a ordem dos dados se alinha, e não o quão de perto os valores seguem uma linha reta. Isso significa que uma correlação de Spearman alta indica uma tendência clara nos rankings, não necessariamente uma relação linear ou com espaçamento uniforme.
Por isso, vale sempre combinar os valores de correlação com uma visualização rápida para entender melhor o padrão por trás dos números.
Como lidar com empates nos rankings
Tudo parece simples até você se deparar com um conjunto de dados em que várias observações têm o mesmo valor. O que fazer? Esses são os empates, e exigem um pequeno ajuste na hora de atribuir os postos.
Por exemplo, considere os valores: 10, 20, 20, 30. Os dois valores 20 normalmente ocupariam os postos 2 e 3. Como são iguais, em vez de atribuir postos diferentes, atribuímos a cada um a média desses postos: ambos recebem 2,5. Essa abordagem trata os empates de forma justa e mantém o ranking consistente.
Como a correlação de Spearman se baseia inteiramente em postos, se os empates não forem tratados corretamente, a correlação pode ser distorcida.
Limitações da correlação de Spearman
Embora o coeficiente de Spearman seja flexível e muito utilizado, ele tem algumas limitações.
A principal é que ele só captura relações monotônicas. Se a relação muda de direção — como um formato em U ou uma onda senoidal — a correlação pode ficar próxima de zero mesmo havendo um padrão claro. Nesses casos, vale mais a pena usar um modelo não linear, como regressão polinomial.
Além disso, por ser baseada em postos, a correlação de Spearman ignora as distâncias reais entre os valores. Isso a torna mais robusta a outliers, mas também implica perda de informação. A magnitude da relação é mais difícil de interpretar em Spearman do que em Pearson por esse motivo. Ela indica se as variáveis se movem juntas em termos de ordem, mas não quanto uma muda em relação à outra.
Por fim, quando há muitos empates, o processo de ranqueamento fica menos preciso, o que pode enfraquecer o valor da correlação e não representar toda a extensão da relação.
Spearman vs. Pearson: quando usar cada uma
A correlação mais usada provavelmente é a de Pearson. À primeira vista, ela parece muito semelhante à de Spearman — os nomes quase coincidem! — mas respondem a perguntas um pouco diferentes.
Pearson pergunta: “Essas variáveis seguem uma relação de linha reta?” Já Spearman pergunta: “Essas variáveis se movem na mesma ordem?”
Se seus dados seguem algo próximo de uma linha reta e as distâncias entre os valores são significativas, a correlação de Pearson costuma ser a melhor escolha. Mas, se a relação curva ou estabiliza, Spearman tende a se ajustar melhor.
Spearman também é mais tolerante. Por trabalhar com postos, é menos sensível a outliers e depende menos de suposições sobre os dados. A contrapartida é que ela não captura tão bem as diferenças de magnitude entre valores.
Na prática, uma boa regra é: se a relação é linear, use Pearson; se é monotônica, mas não linear, use Spearman. E, como sempre, visualize os dados antes de decidir.
Conclusão
A correlação de Spearman é uma ótima ferramenta para capturar padrões monotônicos, especialmente em conjuntos de dados que não são bem atendidos pela correlação de Pearson. Ao trabalhar com postos, ela é menos sensível a outliers e mais acolhedora com dados não lineares.
Você pode saber mais sobre como escolher a melhor correlação para seu conjunto de dados em Understanding Correlation: Measuring Relationships in Data. Talvez você também se interesse por Understanding Covariance: An Introductory Guide.