
Kursus
Memahami Kecerdasan Buatan
2 Hr
421.5K
Pernah melihat istilah "flow matching" di setiap model gambar dan video baru, tetapi tidak tahu apa maksudnya?
Kebanyakan penjelasan langsung masuk ke persamaan diferensial atau menyebutnya sebagai "diffusion, namun lebih baik." Keduanya tidak memberi tahu Anda apa yang dipelajari model. Stable Diffusion 3 dan Flux sama-sama menggunakan flow matching, dan keduanya menghasilkan gambar hanya dalam beberapa langkah sementara diffusion klasik butuh puluhan.
Inilah gagasan umumnya: alih-alih mempelajari contoh individual, model mempelajari medan kecepatan yang memberi tahu setiap sampel harus bergerak ke arah mana dan seberapa cepat. Setelah Anda memahami itu, proses pelatihan, matematika di baliknya, dan hubungannya dengan diffusion akan terasa masuk akal.
Dalam artikel ini, saya akan memandu Anda melalui intuisi di balik flow matching, bagaimana cara melatihnya, matematikanya (dengan ringan), dan bagaimana perbandingannya dengan diffusion models.
Jika Anda baru di AI untuk data gambar, baca 10 Model Vision-Language Teratas di 2026 kami untuk menemukan model mutakhir saat ini untuk penalaran visual, analisis gambar, dan computer vision.
Flow matching adalah sebuah tujuan pelatihan (training objective), bukan arsitektur model.
Pembedaan ini penting karena Anda bisa memasangkannya dengan transformer atau hampir jaringan apa pun — yang membuatnya disebut flow matching adalah apa yang dilatih jaringan untuk diprediksi, bukan seperti apa bentuk jaringannya.
Dan yang dilatih untuk diprediksi adalah medan vektor yang bergantung waktu. Secara sederhana, itu adalah fungsi yang memberi tahu arah mana dan seberapa cepat sebuah sampel harus bergerak pada setiap titik sepanjang jalurnya dari distribusi sumber ke distribusi target. Saat Anda melatih continuous normalizing flows dengan cara ini, Anda mendapatkan model yang mengubah distribusi sederhana menjadi yang kompleks, selangkah demi selangkah.
Saya suka memecah intuisinya menjadi empat gagasan:
Jika Anda tipe visual, bayangkan awan partikel yang tersebar tanpa pola. Flow matching mengajari setiap partikel arah mana harus bergerak dan seberapa cepat, sehingga seluruh awan perlahan membentuk pola terstruktur (bentuk distribusi target Anda).
Saat Anda menjalankannya pada dataset gambar, "pola terstruktur" berarti foto yang koheren alih-alih noise acak.
Pelatihan dan generasi adalah dua fase terpisah di sini, dan kebingungan sering terjadi saat orang mengira keduanya sama.
Selama pelatihan:
t acak antara 0 dan 1t, berdasar jalur probabilitas yang menghubungkan keduanyat, berdasarkan jalur yang Anda pilihGenerasi tidak memerlukan titik data.
Anda mulai dari noise dan mengintegrasikan medan vektor yang dipelajari ke depan dalam waktu, selangkah kecil demi selangkah, hingga Anda mendapat sampel dari distribusi data.
Itulah idenya — Anda memprediksi kecepatan saat pelatihan, dan mengikutinya saat generasi.
Ada dua gagasan yang menjadi inti dari objective flow matching — medan vektor dan jalur probabilitas. Setelah Anda memahami keduanya, fungsi rugi di bagian berikutnya akan masuk akal.
Medan vektor adalah apa yang diprediksi jaringan. Pada titik mana pun di ruang dan momen waktu mana pun, ia memberi Anda arah dan kecepatan — bagaimana sebuah sampel pada titik itu harus bergerak agar lebih dekat ke distribusi data.
Sebagai contoh, bayangkan Anda berdiri di sungai. Di mana pun Anda berdiri, arus mendorong dengan cara tertentu, dan seberapa kuat serta ke arahnya bergantung pada posisi tepat Anda dan momen waktunya. Medan vektor melakukan hal yang sama untuk sampel Anda — ia memberikan arah dan kecepatan untuk setiap titik di ruang, pada setiap titik waktu.
Jalur probabilitas adalah rangkaian distribusi yang dilalui sampel dalam perjalanannya dari noise ke data. Pada t = 0, Anda men-sampel dari distribusi sumber, biasanya noise Gaussian. Pada t = 1, Anda men-sampel dari distribusi data target. Semua yang di antaranya adalah distribusi perantara, dan jalur probabilitas mendeskripsikan bagaimana satu berubah menjadi yang berikutnya.
Medan vektor dan jalur probabilitas saling terhubung langsung karena medan vektor menggerakkan sampel sepanjang jalur probabilitas, dari satu distribusi perantara ke berikutnya, hingga mencapai distribusi data.
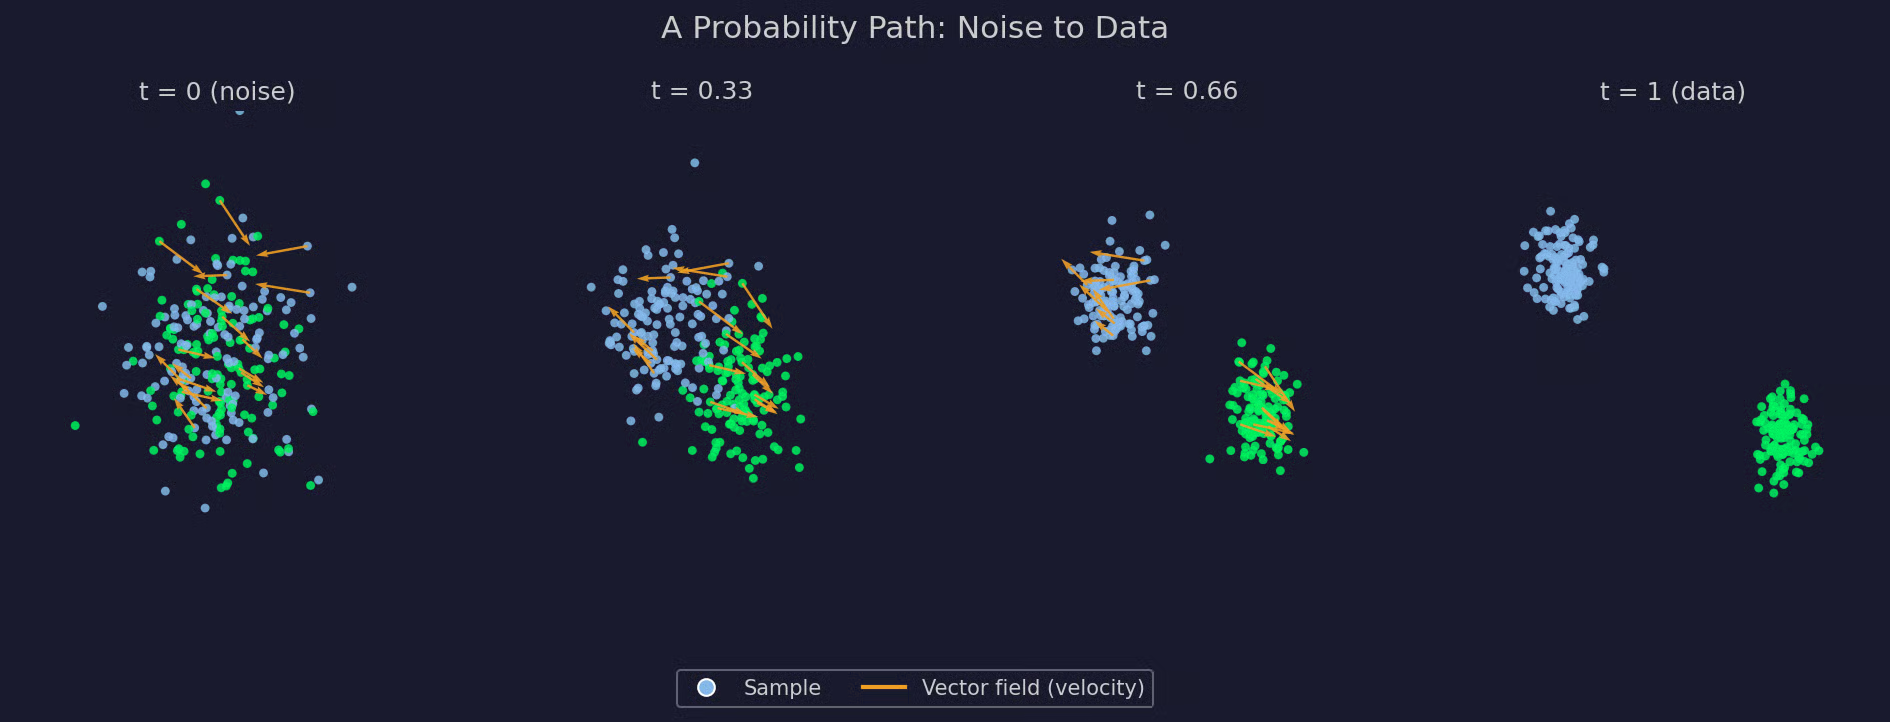
Diagram jalur probabilitas
Objective flow matching mengubah medan vektor dan jalur probabilitas menjadi satu loss regresi.
Setiap langkah pelatihan membandingkan dua kecepatan. Pertama adalah kecepatan target — arah dan kecepatan pergerakan sampel pada titik tersebut sepanjang jalur probabilitas yang dipilih. Kedua adalah kecepatan prediksi model — tebakan jaringan untuk arah dan kecepatan yang sama, berdasarkan sampel dan waktu saat ini. Pelatihan membuat keduanya semirip mungkin.
Berikut fungsi loss-nya:
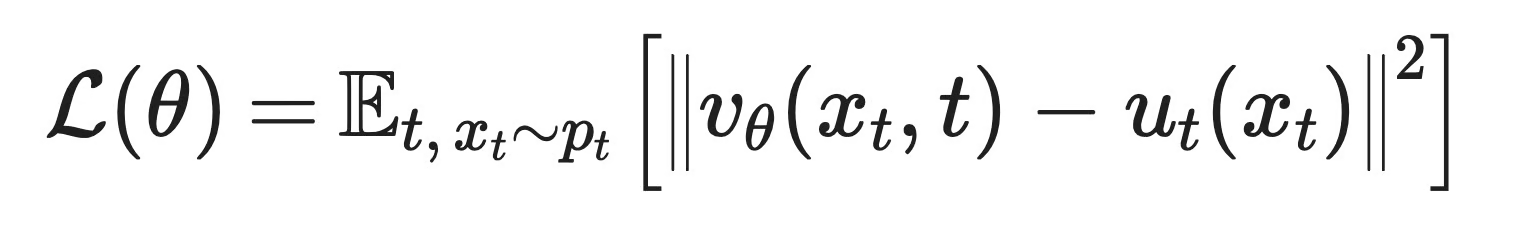
Fungsi loss flow matching
Berikut arti setiap istilahnya:
v_θ(x_t, t): Kecepatan yang diprediksi model pada titik x_t dan waktu t
u_t(x_t): Kecepatan target pada titik dan waktu yang sama, berdasarkan jalur probabilitas yang dipilih
𝔼[...]: Rata-rata atas banyak nilai acak t dan x_t
‖ · ‖^2: Selisih kuadrat antara dua kecepatan — mean squared error biasa
Penurunan lengkapnya tidak terlalu relevan di sini. Yang penting adalah jaringan memprediksi satu vektor pada satu titik dan waktu, dan Anda membandingkannya dengan target yang diketahui. Itu saja!
Jalur probabilitas marginal yang menghubungkan seluruh distribusi noise ke seluruh distribusi data bukanlah sesuatu yang bisa langsung Anda tulis.
Menghitung kecepatan target pada titik tertentu berarti memperhitungkan setiap sampel data yang bisa menghasilkannya — integral atas seluruh dataset Anda, bukan sesuatu yang dihitung setiap langkah pelatihan.
Conditional flow matching mengatasinya dengan melakukan pengondisian pada sampel individual alih-alih jalur penuh. Alih-alih menghitung medan vektor untuk seluruh jalur marginal, Anda memilih satu titik data dan satu titik noise, lalu membangun jalur probabilitas hanya untuk pasangan tersebut. Saat Anda membuat jalur kondisional itu sederhana, misalnya garis lurus antara kedua titik, kecepatan target memiliki bentuk tertutup yang bisa langsung dihitung.
Melatih jaringan pada kecepatan kondisional yang sederhana per pasangan ini, dirata-ratakan di cukup banyak pasangan, akan memberi Anda medan vektor yang sama seperti yang diinginkan objective marginal yang sulit dihitung. Anda tidak pernah secara langsung menghitung jalur marginal — sebagai gantinya, Anda mendekatinya secara tidak langsung, satu jalur kondisional yang mudah pada satu waktu.
Versi kondisional inilah yang hampir semua orang latih. Formulasi marginal membuat matematikanya bekerja, tetapi formulasi kondisional adalah yang bekerja dalam praktik.
Diffusion dan flow matching sering dibandingkan karena alasan yang kuat — sebagian besar "diffusion models" yang telah Anda kenal kini berjalan dengan objective flow matching. Itu tidak berarti flow matching menggantikan diffusion. Artinya, diffusion ternyata merupakan satu kasus spesifik dalam kerangka yang lebih besar, dan flow matching adalah versi umumnya.
Mari mulai dari apa yang diprediksi masing-masing jaringan. Model diffusion memprediksi noise. Diberi sampel ber-noise dan langkah waktu, model memprediksi noise yang dicampurkan, lalu menghapusnya, selangkah demi selangkah. Flow matching sebagai gantinya memprediksi kecepatan. Diberi sampel dan langkah waktu, ia memprediksi arah mana dan seberapa cepat sampel itu harus bergerak menuju distribusi data.
Jalur probabilitas adalah bagian yang paling membedakan keduanya.
Model diffusion menetapkan satu proses pen-noise-an spesifik di awal, biasanya menambahkan noise Gaussian pada jadwal tetap, dan segala sesuatu lainnya mengikuti dari pilihan tunggal itu. Dalam flow matching, Anda memilih jalur apa pun yang menghubungkan noise ke data, dan objective bekerja dengan cara yang sama apa pun jalur yang Anda pilih. Jalur bergaya diffusion Gaussian adalah salah satu opsi. Garis lurus antara noise dan data adalah opsi lain, dan itu sangat berpengaruh pada seberapa cepat Anda dapat melakukan sampling.
Dua prediksi ini tidak sebegitu berbeda seperti kelihatannya.
Prediksi noise pada model diffusion dan prediksi kecepatan pada model flow matching adalah dua sudut pandang dari objek dasar yang sama, terhubung melalui skor distribusi pada setiap titik waktu. Perbedaannya ada pada cara mereka menghasilkan. Sampling diffusion bersifat stokastik secara default, artinya setiap langkah denoising menambahkan sedikit keacakan kembali (meski varian deterministik seperti DDIM ada). Flow matching sebaliknya — formulasi alaminya adalah ODE deterministik, sehingga noise awal yang sama menghasilkan keluaran yang sama setiap kali, dan varian stokastik juga ada di sisi ini.
Sampling pada kedua kasus berarti menyelesaikan persamaan diferensial selangkah demi selangkah, bergerak dari noise menuju data.
Model diffusion cenderung butuh puluhan langkah kecuali Anda menggunakan sampler cepat atau distilasi. Flow matching, terutama saat dilatih pada jalur garis lurus, cenderung butuh jauh lebih sedikit langkah tanpa itu semua — jalur lurus memiliki kecepatan konstan, yang jauh lebih mudah diikuti akurat oleh solver daripada jalur melengkung.
Jalur itu sendiri adalah tempat flow matching unggul.
Model diffusion dibatasi oleh proses pen-noise-an yang menjadi dasar turunannya. Flow matching memperlakukan jalur sebagai pilihan desain, dan pilihan berbeda datang dengan trade-off yang berbeda.
|
Diffusion models |
Flow matching |
|
|
Apa yang diprediksi jaringan |
Noise yang ditambahkan di setiap langkah |
Kecepatan menuju distribusi data |
|
Jalur probabilitas |
Ditetapkan oleh proses pen-noise-an spesifik |
Dipilih secara bebas; garis lurus umum digunakan |
|
Objek dasar |
Skor dari distribusi ber-noise |
Medan vektor bergantung waktu, terkait dengan skor |
|
Generasi |
Stokastik secara default namun ada varian deterministik |
Deterministik secara default namun ada varian stokastik |
|
Langkah sampling |
Sering puluhan tanpa trik tambahan |
Sering jauh lebih sedikit, terutama dengan jalur yang lebih lurus |
|
Pilihan jalur |
Ditetapkan oleh proses maju (forward) |
Pilihan desain terbuka — diffusion adalah salah satu instansinya |
Flow matching dibandingkan dengan diffusion models
Diffusion bukan satu-satunya metode yang dibandingkan dengan flow matching. Ada tiga lagi yang perlu Anda ketahui
Continuous normalizing flows hadir terlebih dahulu, dan flow matching tumbuh langsung dari masalah saat melatihnya.
Continuous normalizing flow adalah jenis model yang dihasilkan flow matching — jaringan yang mendefinisikan transformasi kontinu antar distribusi melalui sebuah ODE. Melatihnya dengan cara asli berarti menyelesaikan ODE tersebut ke depan dan menghitung likelihood yang tepat di setiap langkah, yang berarti melacak bagaimana transformasi mengubah kerapatan probabilitas sepanjang jalur. Perhitungan itu mahal, dan makin parah seiring jaringan membesar.
Flow matching menghindari semua itu. Ia melakukan regresi langsung pada kecepatan target yang diketahui alih-alih menyelesaikan ODE dan menghitung likelihood selama pelatihan. Tidak ada simulasi yang diperlukan. Anda tetap berakhir dengan continuous normalizing flow, hanya saja Anda tidak membayar biaya pelatihan yang dulu untuk sampai ke sana.
Score matching melatih jaringan untuk memprediksi skor — gradien dari log kerapatan probabilitas — pada setiap tingkat noise. Itulah objective di balik diffusion models yang sudah Anda kenal.
Flow matching melatih jaringan untuk memprediksi kecepatan. Keduanya terkait secara matematis, artinya di bawah pilihan jalur tertentu, Anda dapat mengonversi yang satu ke yang lain. Namun mereka merepresentasikan hal yang berbeda. Skor menggambarkan bentuk distribusi probabilitas pada waktu yang tetap. Kecepatan menggambarkan bagaimana sebuah sampel harus bergerak saat waktu berubah.
Score matching bertanya tentang geometri. Flow matching bertanya tentang gerak.
Rectified flow adalah sebuah pilihan spesifik di dalam flow matching.
Flow matching memungkinkan Anda memilih jalur probabilitas apa pun yang menghubungkan noise ke data. Rectified flow memilih satu — garis lurus, dan melangkah lebih jauh dengan prosedur iteratif bernama "reflow" yang meluruskan jalur yang sudah dipelajari model terlatih, sehingga model putaran kedua membutuhkan lebih sedikit langkah integrasi saat generasi.
Itulah mengapa kedua istilah sering muncul berdampingan dalam makalah yang sama. Stable Diffusion 3 dan Flux sama-sama menggunakan flow matching dengan pilihan jalur yang mendekati rectified flow. Namun menyamakan flow matching dan rectified flow melewatkan intinya. Flow matching adalah kerangkanya. Rectified flow adalah salah satu jalur yang dapat Anda pilih di dalamnya.
Flow matching kini berjalan di beberapa sistem generatif terbesar yang diproduksi.
Semua ini karena loss regresi mudah diimplementasikan dan diskalakan. Dan karena jalur adalah pilihan desain, tim yang membangun sistem berparameter miliaran dapat memilih jalur yang butuh lebih sedikit langkah sampling, dan itu penting ketika setiap langkah berbiaya komputasi pada skala tersebut.
Sejauh ini semuanya bersifat konseptual. Sekarang saya akan memandu Anda melalui ide yang sama pada dataset 2D nyata, cukup kecil untuk melihat setiap langkahnya.
Distribusi noise adalah Gaussian 2D standar, berpusat di titik asal. Distribusi target adalah tiga klaster Gaussian yang tersusun segitiga — cukup sederhana untuk dipelajari cepat oleh jaringan kecil, namun cukup terstruktur sehingga Anda benar-benar bisa menilai apakah hasilnya tepat.
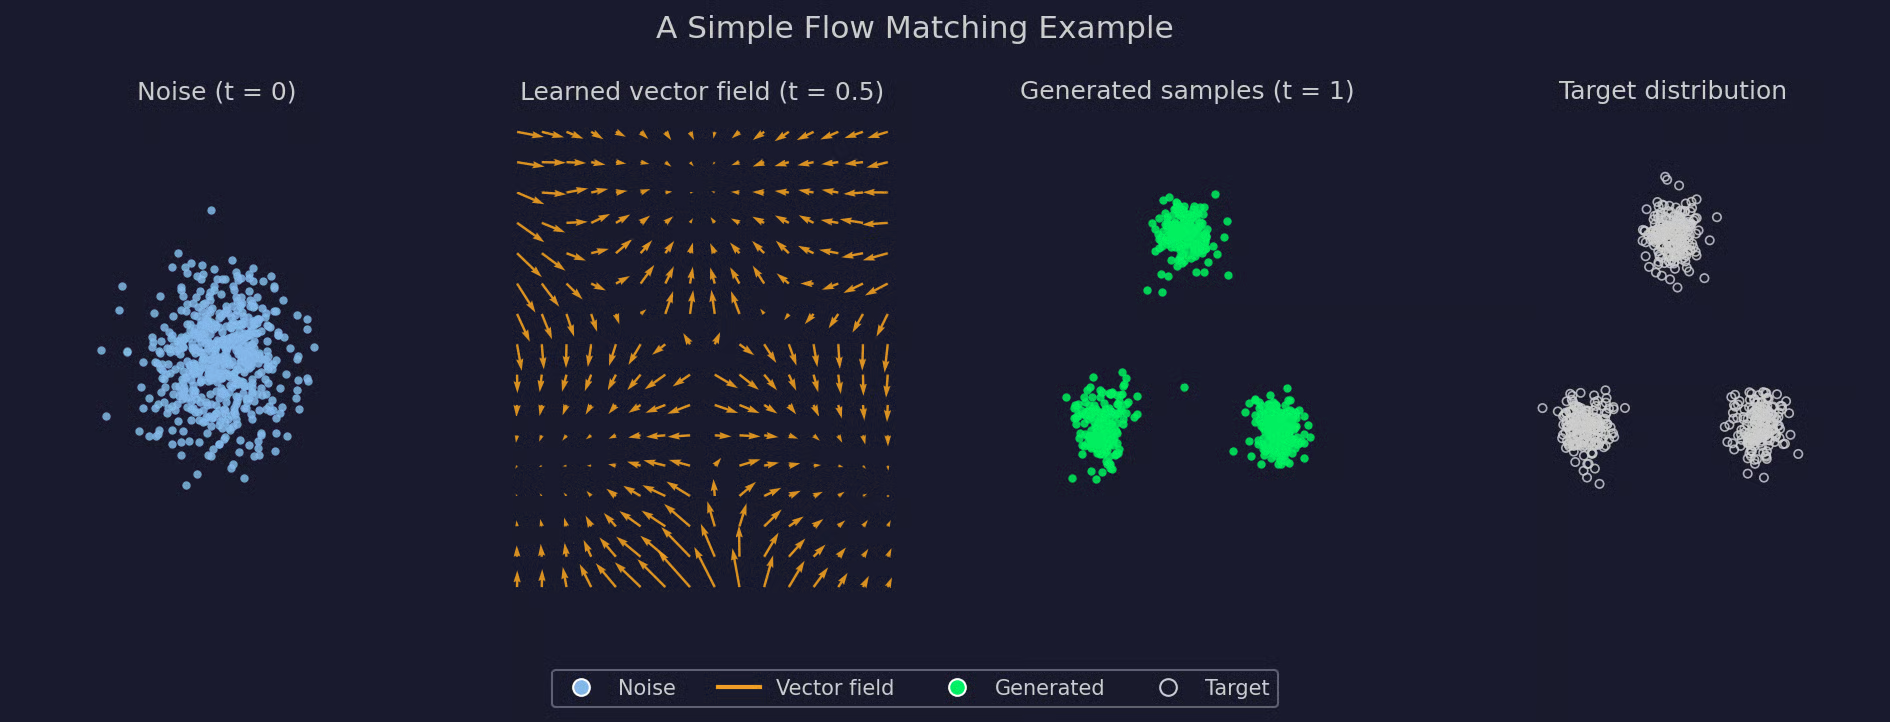
Contoh flow matching sederhana
Panel pertama adalah tempat setiap sampel dimulai — noise tersebar tanpa struktur. Panel kedua adalah medan vektor itu sendiri, dievaluasi pada grid di pertengahan pelatihan. Perhatikan bagaimana panah sudah mengarah ke salah satu dari tiga klaster, jauh sebelum sampel mana pun sampai di sana. Panel ketiga menunjukkan apa yang terjadi saat Anda mulai dari noise baru dan mengikuti medan itu hingga t = 1 — tiga klaster muncul, sangat cocok dengan panel keempat.
Tak ada yang melibatkan hal di luar yang sudah dibahas sebelumnya — distribusi sumber, distribusi target, medan vektor yang dipelajari, dan solver ODE yang menghubungkan ketiganya. Lanjut ke kode.
Berikut implementasi PyTorch kecil dari contoh yang sama, menggunakan sumber noise dan target tiga klaster yang sama.
Mulailah dengan dua distribusi dan cara men-sampelnya:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Jaringannya sendiri menerima sebuah titik dan langkah waktu, lalu memprediksi kecepatan:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Pelatihan men-sampel satu batch titik sumber, titik target, dan langkah waktu di setiap langkah, lalu menginterpolasi antara keduanya dan melakukan regresi pada kecepatan yang dihasilkan:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Generasi menyelesaikan ODE yang dipelajari dengan integrasi Euler biasa. Anda hanya butuh loop yang mengambil langkah-langkah kecil dari t = 0 ke t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`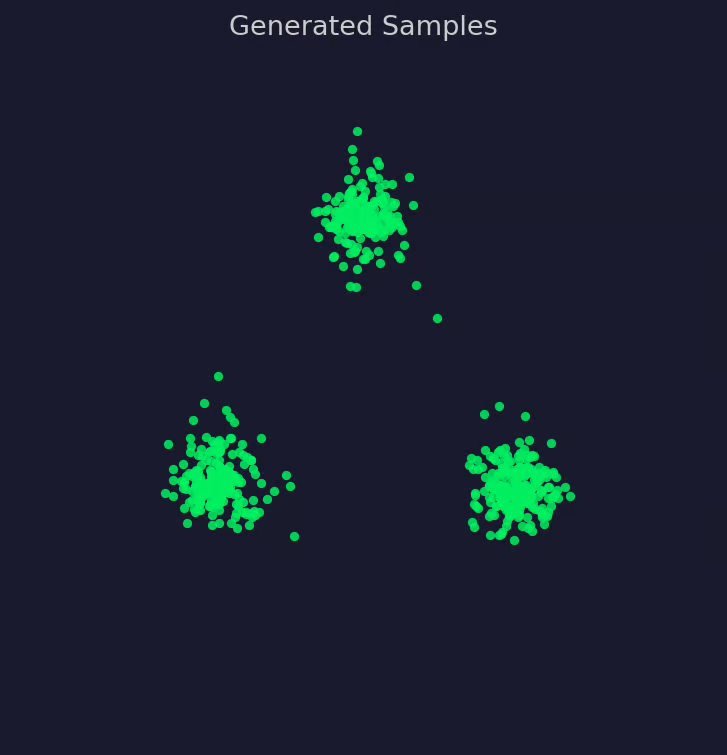
Visualisasi sampel yang dihasilkan
Dan itulah seluruh alurnya! Sampling, interpolasi, regresi, integrasi. Tidak ada yang berubah jika Anda menggunakan jaringan yang lebih besar, jalur berbeda, atau dataset berdimensi lebih tinggi — hanya skalanya.
Semua ini tidak membuat flow matching menjadi peningkatan universal atas diffusion. Ini adalah trade-off, sama seperti pilihan desain lainnya.
Berikut kapan ini menjadi opsi yang baik dan kapan tidak.
Flow matching mengajarkan model bagaimana sampel harus bergerak dari distribusi sederhana menuju distribusi data. Semua hal lain yang saya jelaskan di artikel ini ada untuk membuat satu ide itu dapat dilatih.
Dua gagasan melakukan sebagian besar pekerjaan di sini. Jalur probabilitas menghubungkan noise ke data melalui rangkaian distribusi perantara. Medan vektor mendeskripsikan bagaimana sampel harus bergerak pada titik mana pun sepanjang jalur itu, pada momen waktu apa pun. Jaringan mempelajari medan vektor tersebut, kecepatannya, dan proses generasi hanya mengikuti aliran yang dihasilkan dari noise ke data.
Tidak ada yang berdiri terpisah dari yang sebelumnya. Flow matching adalah cara sistem modern melatih continuous normalizing flows tanpa komputasi likelihood lama, dan diffusion models ternyata merupakan salah satu kasus spesifik di dalamnya.
Jika diffusion models, normalizing flows, atau AI generatif secara umum menarik bagi Anda, inilah yang bisa Anda pelajari selanjutnya:
Belajar AI dengan DataCamp
Kursus
Kursus
Kursus