Courses
ทำความเข้าใจปัญญาประดิษฐ์
2 ชม.
421.5K
เคยเห็นคำว่า "flow matching" อยู่ข้างๆ โมเดลภาพและวิดีโอตัวใหม่แทบทุกตัว แล้วยังไม่แน่ใจว่าหมายถึงอะไรหรือเปล่า?
คำอธิบายส่วนใหญ่มักกระโดดไปที่สมการเชิงอนุพันธ์ทันที หรือไม่ก็สรุปว่าเป็น "diffusion แต่ดีกว่า" ซึ่งทั้งสองอย่างไม่ได้บอกว่าจริงๆ แล้วโมเดลเรียนรู้อะไร Stable Diffusion 3 และ Flux ต่างก็ใช้ flow matching และสร้างภาพได้ในไม่กี่สเต็ป ในขณะที่ diffusion แบบคลาสสิกต้องใช้หลายสิบสเต็ป
แนวคิดหลักคือ: แทนที่จะเรียนรู้ตัวอย่างแบบรายกรณี โมเดลจะเรียนรู้สนามเวกเตอร์ความเร็วที่บอกทุกตัวอย่างว่าควรเคลื่อนที่ไปทิศทางไหนและเร็วเท่าไร เมื่อเข้าใจจุดนี้แล้ว กระบวนการฝึก โมเดลคณิตศาสตร์เบื้องหลัง และความสัมพันธ์กับ diffusion จะเริ่มชัดเจน
บทความนี้จะพาไล่จากสัญชาตญาณเบื้องหลัง flow matching วิธีการฝึกคั่นด้วยคณิตศาสตร์แบบเบาๆ และการเปรียบเทียบกับ diffusion models
หากเพิ่งเริ่มต้นด้าน AI สำหรับข้อมูลภาพ แนะนำให้อ่าน 10 อันดับโมเดล Vision-Language แห่งปี 2026 เพื่อสำรวจโมเดลล้ำหน้าสำหรับการให้เหตุผลเชิงภาพ การวิเคราะห์ภาพ และคอมพิวเตอร์วิทัศน์
Flow matching คือวัตถุประสงค์ในการฝึก ไม่ใช่สถาปัตยกรรมโมเดล
ข้อแยกนี้สำคัญ เพราะสามารถใช้คู่กับ Transformer หรือเครือข่ายประเภทอื่นเกือบทุกแบบ สิ่งที่ทำให้เป็น flow matching คือสิ่งที่เครือข่ายถูกฝึกให้ทำนาย ไม่ใช่หน้าตาของเครือข่าย
และสิ่งที่ถูกฝึกให้ทำนายคือสนามเวกเตอร์ที่ขึ้นกับเวลา กล่าวแบบง่ายๆ คือฟังก์ชันที่บอกว่าตัวอย่างควรเคลื่อนที่ไปทางไหนและเร็วเท่าไร ณ จุดต่างๆ ตลอดเส้นทางจากการแจกแจงต้นทางไปยังการแจกแจงเป้าหมาย เมื่อฝึกเพื่อเทรน continuous normalizing flows ด้วยวิธีนี้ จะได้โมเดลที่เปลี่ยนการแจกแจงง่ายๆ ให้เป็นการแจกแจงซับซ้อนทีละขั้น
สรุปสัญชาตญาณได้เป็น 4 ข้อ:
หากนึกภาพง่ายๆ ให้จินตนาการถึงกลุ่มอนุภาคที่กระจัดกระจายไร้ระเบียบ Flow matching จะสอนให้แต่ละอนุภาครู้ทิศทางและความเร็วที่ควรเคลื่อนที่ จนทั้งกลุ่มค่อยๆ จัดเรียงเป็นรูปแบบที่มีโครงสร้างตามเวลา (คือรูปร่างของการแจกแจงเป้าหมาย)
เมื่อใช้กับชุดข้อมูลภาพ "รูปแบบที่มีโครงสร้าง" ก็คือภาพที่ชัดเจนแทนที่จะเป็น noise แบบสุ่ม
การฝึกและการสร้างเป็นสองเฟสที่แยกกัน ความสับสนมักเกิดเมื่อคิดว่าสองอย่างนี้เหมือนกัน
ระหว่างการฝึก:
t แบบสุ่มระหว่าง 0 ถึง 1t ตามเส้นทางความน่าจะเป็นที่เชื่อมทั้งสองt ตามเส้นทางที่เลือกการสร้าง (generation) ไม่ต้องใช้จุดข้อมูลเป้าหมาย
เริ่มจาก noise แล้วอินทิเกรตสนามเวกเตอร์ที่เรียนรู้ไปข้างหน้าในเวลา ทีละก้าวเล็กๆ จนได้ตัวอย่างจากการแจกแจงข้อมูล
แนวคิดคืออย่างนี้ — ทำนายความเร็วระหว่างฝึก และตามความเร็วนั้นระหว่างสร้างผลลัพธ์
มี 2 แนวคิดหลักที่ขับเคลื่อนวัตถุประสงค์ของ flow matching คือ สนามเวกเตอร์ และเส้นทางความน่าจะเป็น เมื่อเข้าใจสองอย่างนี้ ฟังก์ชันสูญเสียในหัวข้อถัดไปจะเข้าใจได้ไม่ยาก
สนามเวกเตอร์คือสิ่งที่เครือข่ายทำนาย ณ จุดใดๆ ในปริภูมิและเวลาใดๆ มันจะให้ทิศทางและความเร็ว — วิธีที่ตัวอย่าง ณ จุดนั้นควรเคลื่อนเพื่อเข้าใกล้การแจกแจงข้อมูลมากขึ้น
ลองนึกภาพยืนอยู่ในแม่น้ำ ไม่ว่าคุณจะยืนตรงไหน กระแสน้ำจะพัดในทิศทางหนึ่งด้วยแรงที่ต่างกันตามตำแหน่งและช่วงเวลา สนามเวกเตอร์ก็ทำแบบเดียวกันกับตัวอย่างของคุณ — กำหนดทิศทางและความเร็วให้ทุกจุดในปริภูมิ ในทุกช่วงเวลา
เส้นทางความน่าจะเป็นคือชุดของการแจกแจงที่ตัวอย่างเคลื่อนผ่านระหว่างทางจาก noise ไปสู่ข้อมูล ที่ t = 0 จะสุ่มจากการแจกแจงต้นทาง ซึ่งมักเป็น Gaussian noise ที่ t = 1 จะสุ่มจากการแจกแจงข้อมูลเป้าหมาย ช่วงระหว่างนั้นทั้งหมดคือการแจกแจงกึ่งกลาง และเส้นทางความน่าจะเป็นจะอธิบายว่าหนึ่งแปรสภาพเป็นอีกหนึ่งได้อย่างไร
สนามเวกเตอร์และเส้นทางความน่าจะเป็นเชื่อมกันโดยตรง เพราะสนามเวกเตอร์จะพาตัวอย่างไหลตามเส้นทางความน่าจะเป็น จากการแจกแจงกึ่งกลางหนึ่งไปยังอีกอัน จนถึงการแจกแจงข้อมูล
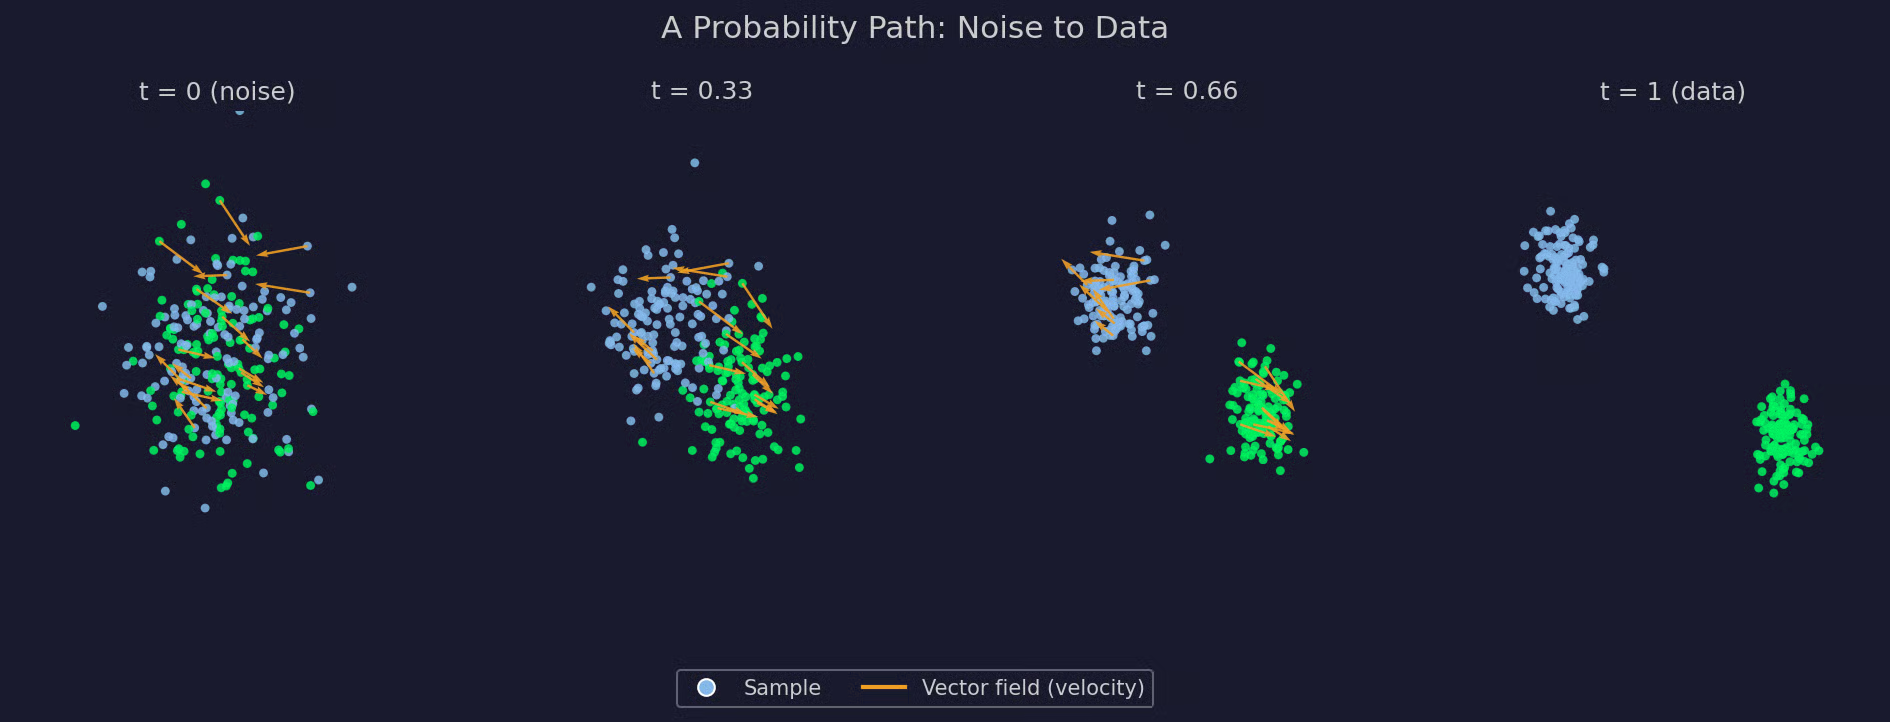
แผนภาพเส้นทางความน่าจะเป็น
วัตถุประสงค์ของ flow matching รวมสนามเวกเตอร์และเส้นทางความน่าจะเป็นเข้าเป็นการถดถอยแบบเดียว
ทุกสเต็ปของการฝึกจะเปรียบเทียบความเร็วสองค่า ค่าหนึ่งคือความเร็วเป้าหมาย — ทิศทางและความเร็วที่ตัวอย่างควรเคลื่อน ณ จุดนั้นตามเส้นทางที่เลือก อีกค่าคือความเร็วที่โมเดลทำนาย — คาดคะเนของเครือข่ายสำหรับทิศทางและความเร็วเดียวกันโดยอิงจากตัวอย่างและเวลา การฝึกจะทำให้ทั้งสองใกล้กันที่สุด
นี่คือฟังก์ชันสูญเสีย:
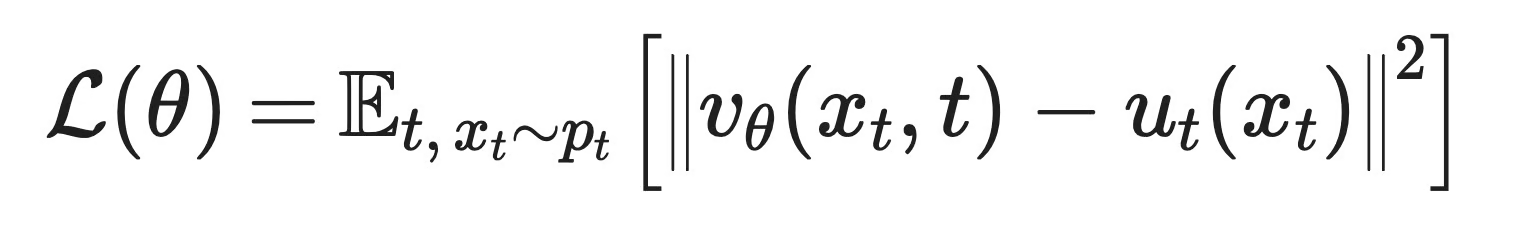
ฟังก์ชันสูญเสียของ Flow Matching
แต่ละพจน์หมายถึงอะไรบ้าง:
v_θ(x_t, t): ความเร็วที่โมเดลทำนาย ณ จุด x_t และเวลา t
u_t(x_t): ความเร็วเป้าหมาย ณ จุดและเวลาเดียวกัน ตามเส้นทางความน่าจะเป็นที่เลือก
𝔼[...]: ค่าเฉลี่ยเหนือค่าของ t และ x_t แบบสุ่มจำนวนมาก
‖ · ‖^2: ผลต่างกำลังสองของความเร็วทั้งสอง — mean squared error ตรงไปตรงมา
การพิสูจน์เต็มไม่ใช่ประเด็น ที่สำคัญคือเครือข่ายทำนายเวกเตอร์ตัวเดียว ณ จุดและเวลาเดียว แล้วนำไปเทียบกับเป้าหมายที่ทราบ จบเท่านั้น
เส้นทางความน่าจะเป็นแบบมาร์จินัลที่เชื่อมการแจกแจง noise ทั้งหมดเข้ากับการแจกแจงข้อมูลทั้งหมด ไม่ใช่สิ่งที่จะเขียนออกมาได้โดยตรง
การคำนวณความเร็วเป้าหมายที่จุดหนึ่งต้องคำนึงถึงทุกตัวอย่างข้อมูลที่อาจทำให้เกิดจุดนั้น — เป็นอินทิกรัลเหนือชุดข้อมูลทั้งหมด ซึ่งไม่ใช่สิ่งที่จะทำทุกสเต็ปของการฝึก
Conditional flow matching แก้ด้วยการกำหนดเงื่อนไขบนตัวอย่างแต่ละคู่แทนทั้งเส้นทาง แทนที่จะคำนวณสนามเวกเตอร์สำหรับเส้นทางมาร์จินัลทั้งหมด ให้เลือกจุดข้อมูลหนึ่งและจุด noise หนึ่ง แล้วสร้างเส้นทางความน่าจะเป็นเฉพาะสำหรับคู่นั้น เมื่อทำให้เส้นทางแบบมีเงื่อนไขนี้เรียบง่าย เช่น เส้นตรงระหว่างสองจุด ความเร็วเป้าหมายจะมีรูปแบบปิดที่คำนวณได้โดยตรง
การฝึกเครือข่ายบนความเร็วแบบมีเงื่อนไขง่ายๆ ต่อคู่ แล้วเฉลี่ยครอบคลุมคู่จำนวนมาก จะได้สนามเวกเตอร์เดียวกับที่วัตถุประสงค์มาร์จินัลที่คำนวณยากต้องการ โดยไม่ต้องคำนวณเส้นทางมาร์จินัลโดยตรง แต่ประมาณผ่านเส้นทางแบบมีเงื่อนไขที่ง่ายทีละเส้น
เวอร์ชันแบบมีเงื่อนไขนี้คือสิ่งที่แทบทุกคนใช้จริง สูตรมาร์จินัลทำให้คณิตศาสตร์ทำงาน ส่วนสูตรมีเงื่อนไขคือสิ่งที่เวิร์กในทางปฏิบัติ
Diffusion และ flow matching มักถูกเทียบกันด้วยเหตุผลที่เข้าใจได้ — “โมเดล diffusion” ส่วนใหญ่ที่รู้จักกัน ปัจจุบันใช้วัตถุประสงค์แบบ flow matching นั่นไม่ได้หมายความว่า flow matching มาแทน diffusion แต่หมายถึง diffusion เป็นกรณีเฉพาะภายในกรอบที่ใหญ่กว่า และ flow matching คือเวอร์ชันทั่วไป
เริ่มจากสิ่งที่แต่ละเครือข่ายทำนาย โมเดล diffusion ทำนาย noise เมื่อให้ตัวอย่างที่มี noise และเวลาหนึ่งสเต็ป มันจะทำนาย noise ที่ถูกผสมและลบออกทีละขั้น ส่วน flow matching ทำนายความเร็ว เมื่อให้ตัวอย่างและเวลา มันทำนายทิศทางและความเร็วที่ตัวอย่างควรเคลื่อนเข้าสู่การแจกแจงข้อมูล
ความต่างใหญ่สุดอยู่ที่เส้นทางความน่าจะเป็น
โมเดล diffusion จะกำหนดกระบวนการเพิ่ม noise แบบหนึ่งตายตัวไว้ล่วงหน้า มักเป็น Gaussian บนตารางเวลาแน่นอน และทุกอย่างตามมาจากตัวเลือกเดียวนี้ ใน flow matching สามารถเลือกเส้นทางใดก็ได้ที่เชื่อม noise กับข้อมูล และวัตถุประสงค์ทำงานเหมือนเดิมไม่ว่าคุณจะเลือกแบบไหน เส้นทางสไตล์ diffusion แบบ Gaussian เป็นตัวเลือกหนึ่ง เส้นตรงระหว่าง noise กับข้อมูลก็เป็นอีกตัวเลือก และสิ่งนี้ส่งผลมากต่อความเร็วในการสุ่มตัวอย่าง
การทำนายทั้งสองไม่ได้ต่างกันสุดขั้ว
การทำนาย noise ของ diffusion และการทำนายความเร็วของ flow matching คือสองมุมมองของวัตถุเดียวกัน เชื่อมกันผ่านสกอร์ของการแจกแจงในแต่ละเวลา ความต่างอยู่ที่วิธีสร้างตัวอย่าง การสุ่มแบบ diffusion เป็นสุ่มโดยธรรมชาติ กล่าวคือแต่ละสเต็ปการลบ noise จะเติมความสุ่มกลับเข้าไปเล็กน้อย (แม้จะมีเวอร์ชันกำหนดแบบ DDIM) ฝั่ง flow matching ตรงกันข้าม — สูตรธรรมชาติคือ ODE เชิงกำหนด ผลคือเริ่มจาก noise เดิมจะได้ผลลัพธ์เดิมทุกครั้ง และก็มีเวอร์ชันสุ่มได้เช่นกัน
การสุ่มตัวอย่างในทั้งสองกรณีคือการแก้สมการเชิงอนุพันธ์ทีละสเต็ป เคลื่อนจาก noise ไปหาข้อมูล
โมเดล diffusion มักต้องใช้หลายสิบสเต็ป เว้นแต่จะใช้ตัวเร่งหรือต้มกลั่น (distillation) Flow matching โดยเฉพาะเมื่อฝึกบนเส้นทางตรง มักใช้สเต็ปน้อยกว่ามากโดยไม่ต้องพึ่งเทคนิคเหล่านั้น — เส้นทางตรงมีความเร็วคงที่ ซึ่งง่ายกว่าสำหรับตัวแก้สมการในการตามอย่างแม่นยำกว่าทางโค้ง
ตัวเส้นทางเองคือจุดที่ flow matching ได้เปรียบ
โมเดล diffusion ถูกจำกัดด้วยกระบวนการเพิ่ม noise ที่มันอ้างอิงมา Flow matching มองเส้นทางเป็นตัวเลือกการออกแบบ และตัวเลือกต่างกันก็มาพร้อมข้อดีข้อเสียต่างกัน
|
โมเดล Diffusion |
Flow Matching |
|
|
สิ่งที่เครือข่ายทำนาย |
Noise ที่ถูกเพิ่มในแต่ละสเต็ป |
ความเร็วที่มุ่งสู่การแจกแจงข้อมูล |
|
เส้นทางความน่าจะเป็น |
ถูกกำหนดตายตัวด้วยกระบวนการเพิ่ม noise แบบหนึ่ง |
เลือกได้อย่างอิสระ; เส้นตรงเป็นตัวเลือกที่พบบ่อย |
|
วัตถุพื้นฐาน |
สกอร์ของการแจกแจงที่มี noise |
สนามเวกเตอร์ที่ขึ้นกับเวลา เชื่อมกับสกอร์ |
|
การสร้างผลลัพธ์ |
เป็นแบบสุ่มโดยค่าเริ่มต้น แต่มีเวอร์ชันกำหนดได้ |
เป็นแบบกำหนดโดยค่าเริ่มต้น แต่มีเวอร์ชันสุ่มได้ |
|
จำนวนสเต็ปในการสุ่มตัวอย่าง |
มักหลายสิบสเต็ปหากไม่มีลูกเล่นเพิ่มเติม |
มักน้อยกว่ามาก โดยเฉพาะเมื่อเส้นทางตรงกว่า |
|
การเลือกเส้นทาง |
ถูกตรึงด้วยกระบวนการเดินหน้า (forward) |
เป็นตัวเลือกการออกแบบแบบเปิด — diffusion เป็นกรณีหนึ่ง |
การเปรียบเทียบ Flow matching กับโมเดล diffusion
ไม่ใช่แค่ diffusion ที่ถูกนำมาเปรียบกับ flow matching ยังมีอีกสามวิธีที่ควรรู้จัก
Continuous normalizing flows มาก่อน และ flow matching เติบโตขึ้นโดยตรงจากปัญหาในการฝึกพวกมัน
Continuous normalizing flow คือประเภทโมเดลที่ flow matching ผลิตขึ้น — เครือข่ายที่กำหนดการแปลงแบบต่อเนื่องระหว่างการแจกแจงผ่าน ODE การฝึกแบบดั้งเดิมหมายถึงการแก้ ODE ไปข้างหน้าและคำนวณ likelihood ที่แม่นยำในทุกสเต็ป ซึ่งต้องติดตามว่าเส้นทางแปลงเปลี่ยนความหนาแน่นความน่าจะเป็นอย่างไร งานคำนวณนี้แพง และยิ่งแพงขึ้นเมื่อเครือข่ายใหญ่
Flow matching หลบสิ่งเหล่านั้นทั้งหมด โดยถดถอยตรงกับความเร็วเป้าหมายที่ทราบ แทนที่จะต้องแก้ ODE และคำนวณ likelihood ระหว่างฝึก จึงไม่ต้องจำลองใดๆ ตอนท้ายยังคงได้ continuous normalizing flow อยู่ แต่ไม่ต้องจ่ายต้นทุนการฝึกแบบเก่า
Score matching ฝึกเครือข่ายให้ทำนายสกอร์ — เกรเดียนต์ของลอคความหนาแน่น — ในแต่ละระดับ noise นั่นคือวัตถุประสงค์เบื้องหลังโมเดล diffusion ที่คุ้นเคย
Flow matching ฝึกเครือข่ายให้ทำนายความเร็วแทน ทั้งสองสิ่งเกี่ยวพันกันทางคณิตศาสตร์ กล่าวคือภายใต้การเลือกเส้นทางบางแบบสามารถแปลงกันได้ แต่แทนความหมายต่างกัน สกอร์อธิบายรูปร่างของการแจกแจง ณ ช่วงเวลาหนึ่ง ขณะที่ความเร็วอธิบายว่าตัวอย่างควรเคลื่อนอย่างไรเมื่อเวลาเปลี่ยน
Score matching ถามเรื่องเรขาคณิต Flow matching ถามเรื่องการเคลื่อนที่
Rectified flow คือการเลือกเฉพาะภายใน flow matching
Flow matching เปิดให้เลือกเส้นทางความน่าจะเป็นใดๆ ที่เชื่อม noise กับข้อมูล Rectified flow เลือกแบบหนึ่ง — เส้นตรง และก้าวต่อไปด้วยกระบวนการวนซ้ำชื่อ "reflow" ที่ทำให้เส้นทางที่โมเดลฝึกไว้แล้วตรงขึ้น เพื่อให้โมเดลรอบที่สองต้องใช้สเต็ปอินทิเกรตน้อยลงตอนสร้างผลลัพธ์
จึงเห็นสองคำนี้ปรากฏเคียงกันในงานวิจัย Stable Diffusion 3 และ Flux ต่างใช้ flow matching กับตัวเลือกเส้นทางที่ใกล้เคียง rectified flow แต่การมองว่า flow matching และ rectified flow แทนกันได้จะพลาดประเด็น Flow matching คือกรอบวิธี Rectified flow คือเส้นทางหนึ่งที่เลือกใช้ภายในนั้น
Flow matching ถูกใช้ภายในระบบกำเนิดขนาดใหญ่ระดับโปรดักชันหลายตัวแล้ว
ทั้งหมดนี้เพราะการสูญเสียแบบถดถอย (regression) นั้นติดตั้งและสเกลง่าย และเพราะเส้นทางเป็นตัวเลือกการออกแบบ ทีมที่สร้างระบบระดับพันล้านพารามิเตอร์จึงเลือกเส้นทางที่ต้องใช้สเต็ปสุ่มน้อยลงได้ ซึ่งส่งผลจริงเมื่อทุกสเต็ปมีต้นทุนคอมพิวต์
ที่ผ่านมาเป็นแนวคิดล้วน ตอนนี้จะพาเดินแนวคิดเดียวกันบนชุดข้อมูล 2 มิติจริงๆ เล็กพอที่จะเห็นทุกขั้นตอน
การแจกแจง noise เป็น Gaussian 2 มาตรฐานที่จุดกำเนิด การแจกแจงเป้าหมายเป็นคลัสเตอร์ Gaussian สามกลุ่มวางเป็นรูปสามเหลี่ยม — ง่ายพอให้เครือข่ายเล็กเรียนได้เร็ว แต่มีโครงสร้างพอจะดูออกว่าเรียนรู้ถูกต้องหรือไม่
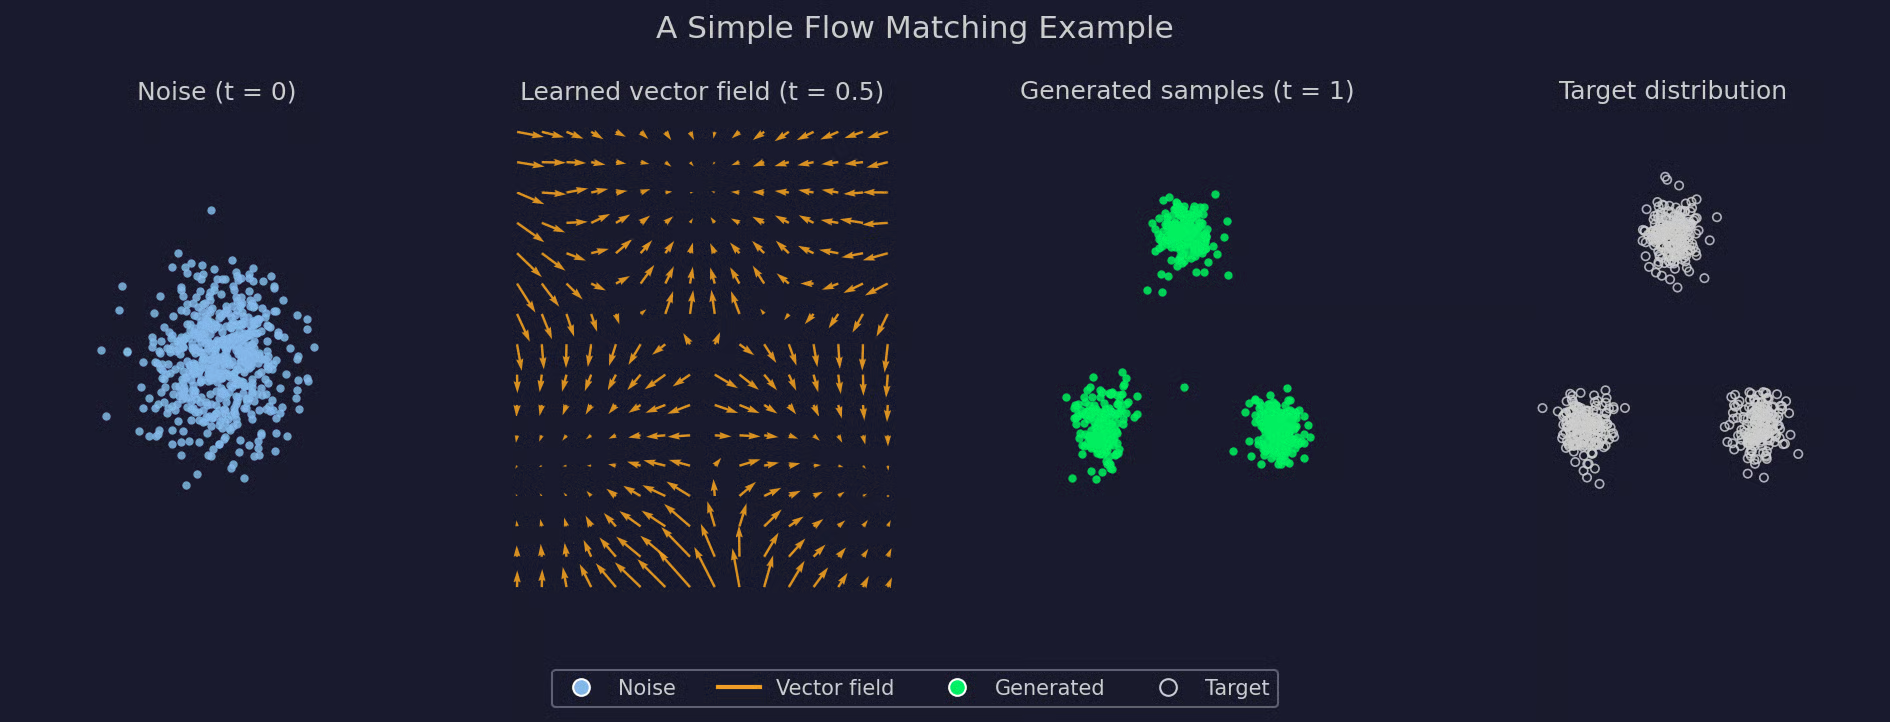
ตัวอย่าง flow matching แบบง่าย
พาเนลแรกคือตำแหน่งเริ่มต้นของทุกตัวอย่าง — noise กระจัดกระจายไร้โครงสร้าง พาเนลที่สองคือสนามเวกเตอร์เอง ประเมินบนกริดช่วงกลางของการฝึก สังเกตว่าลูกศรชี้เข้าหาคลัสเตอร์ทั้งสามแล้ว แม้ก่อนตัวอย่างจะไปถึง พาเนลที่สามแสดงสิ่งที่เกิดขึ้นเมื่อเริ่มจาก noise ใหม่แล้วไหลตามสนามไปจนถึง t = 1 — เกิดคลัสเตอร์สามกลุ่มที่สอดคล้องกับพาเนลที่สี่เกือบสมบูรณ์
ทั้งหมดนี้ไม่มีอะไรเกินจากที่กล่าวมาก่อนหน้า — การแจกแจงต้นทาง การแจกแจงเป้าหมาย สนามเวกเตอร์ที่เรียนรู้ และตัวแก้ ODE ที่เชื่อมทั้งสาม ต่อไปเข้าสู่โค้ด
นี่คือการติดตั้งขนาดเล็กด้วย PyTorch สำหรับตัวอย่างเดียวกัน ใช้แหล่งกำเนิด noise และเป้าหมายสามคลัสเตอร์เหมือนเดิม
เริ่มด้วยการแจกแจงทั้งสองและวิธีสุ่ม:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
ตัวเครือข่ายรับจุดและสเต็ปเวลา แล้วทำนายความเร็ว:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
การฝึกจะสุ่มชุดจุดต้นทาง จุดเป้าหมาย และสเต็ปเวลาทุกสเต็ป แล้วอินเตอร์โพเลตระหว่างสองอันแรกและถดถอยไปยังความเร็วที่ได้:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
การสร้างผลลัพธ์แก้ ODE ที่เรียนรู้ด้วย Euler integration ธรรมดา ใช้ลูปที่ก้าวเล็กๆ จาก t = 0 ถึง t = 1 เท่านั้น:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`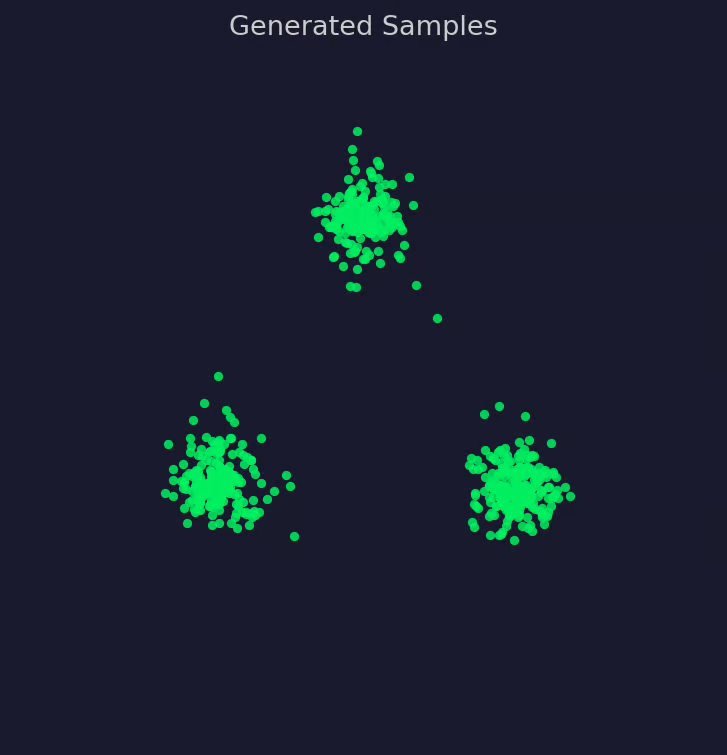
ภาพแสดงตัวอย่างที่สร้างขึ้น
และนี่คือทั้งสายงาน! สุ่ม อินเตอร์โพเลต ถดถอย อินทิเกรต ไม่มีอะไรเปลี่ยนแม้ใช้เครือข่ายใหญ่ขึ้น เส้นทางต่างออกไป หรือชุดข้อมูลมิติสูงขึ้น — เปลี่ยนแค่สเกล
ทั้งหมดนี้ไม่ได้ทำให้ flow matching ดีกว่า diffusion เสมอไป เป็นการแลกเปลี่ยนเช่นเดียวกับตัวเลือกการออกแบบอื่น
จุดที่เหมาะและไม่เหมาะมีดังนี้
Flow matching สอนโมเดลว่าตัวอย่างควรเคลื่อนจากการแจกแจงง่ายไปสู่การแจกแจงข้อมูลอย่างไร ที่เหลือทั้งหมดในบทความนี้มีไว้เพื่อทำให้แนวคิดเดียวนี้ฝึกได้จริง
มีสองแนวคิดที่ทำงานหลัก เส้นทางความน่าจะเป็นเชื่อม noise กับข้อมูลผ่านลำดับของการแจกแจงกึ่งกลาง สนามเวกเตอร์อธิบายว่าตัวอย่างควรเคลื่อนอย่างไร ณ จุดใดๆ บนเส้นทาง ในทุกช่วงเวลา เครือข่ายเรียนรู้สนามเวกเตอร์นี้คือความเร็ว และการสร้างผลลัพธ์คือการไหลตามสนามจาก noise ไปสู่ข้อมูล
ทั้งหมดนี้ไม่แยกขาดจากสิ่งที่มาก่อน Flow matching คือวิธีที่ระบบยุคใหม่ฝึก continuous normalizing flows โดยไม่ต้องคำนวณ likelihood แบบเดิม และโมเดล diffusion ก็เป็นกรณีเฉพาะหนึ่งภายในนั้น
หากโมเดล diffusion โมเดล normalizing flows หรือ Generative AI โดยรวมเป็นสิ่งที่สนใจ ต่อไปนี้คือจุดเริ่มต้น:
เรียนรู้ AI กับ DataCamp
Courses
Courses
Courses