
Curso
Comprender la inteligencia artificial
2 h
421.5K
¿Ves el término "flow matching" junto a cada nuevo modelo de imagen y vídeo y no tienes claro qué significa?
La mayoría de explicaciones saltan directas a ecuaciones diferenciales o lo presentan como "difusión, pero mejor". Ninguna te dice realmente qué aprende el modelo. Stable Diffusion 3 y Flux usan flow matching y generan imágenes en un par de pasos donde la difusión clásica necesita decenas.
La idea general es esta: en lugar de aprender ejemplos individuales, el modelo aprende un campo de velocidades que indica a cualquier muestra en qué dirección moverse y a qué ritmo. Una vez entiendes eso, el proceso de entrenamiento, las matemáticas detrás y su relación con la difusión empiezan a encajar.
En este artículo voy a guiarte por la intuición detrás del flow matching, cómo se entrena, las matemáticas (sin ponernos pesados) y cómo se compara con los modelos de difusión.
Si eres nuevo en IA aplicada a imágenes, lee nuestro Top 10 Vision Language Models in 2026 para descubrir los modelos más punteros en razonamiento visual, análisis de imágenes y visión por ordenador.
Flow matching es un objetivo de entrenamiento, no una arquitectura de modelo.
Esa distinción es importante porque puedes combinarlo con un transformer o casi cualquier otra red: lo que lo convierte en flow matching es lo que se entrena a predecir, no el aspecto de la red.
Y lo que aprende a predecir es un campo vectorial dependiente del tiempo. En cristiano: es una función que te dice en cada punto de la trayectoria desde la distribución de origen hasta la de destino en qué dirección y a qué velocidad debe moverse una muestra. Si entrenas continuous normalizing flows así, obtienes un modelo que transforma una distribución simple en otra compleja, paso a paso.
Me gusta resumir la intuición en cuatro ideas:
Si eres de los que piensan en imágenes, imagina una nube de partículas dispersas sin orden. Flow matching enseña a cada partícula exactamente hacia dónde moverse y a qué velocidad, de modo que toda la nube va tomando con el tiempo una forma estructurada (la de tu distribución objetivo).
En un conjunto de imágenes, "forma estructurada" significa una foto coherente en lugar de ruido aleatorio.
Aquí hay dos fases separadas: entrenamiento y generación, y la confusión suele surgir cuando se piensa que son lo mismo.
Durante el entrenamiento:
t aleatorio entre 0 y 1t, en base a una trayectoria probabilística que conecte ambost, según la trayectoria elegidaPara generar no necesitas el punto de datos.
Empiezas desde el ruido e integras el campo vectorial aprendido hacia adelante en el tiempo, paso a paso, hasta llegar a una muestra de la distribución de datos.
Y esa es la idea: durante el entrenamiento predices la velocidad y, en generación, la sigues.
Dos conceptos sostienen casi todo el objetivo de flow matching: los campos vectoriales y las trayectorias probabilísticas. Una vez los entiendas, la función de pérdida de la siguiente sección tendrá sentido.
Un campo vectorial es lo que predice la red. En cualquier punto del espacio y en cualquier instante, te da una dirección y una velocidad: cómo debe moverse una muestra situada ahí para acercarse a la distribución de datos.
Por ejemplo, imagina que estás de pie en un río. Dondequiera que estés, la corriente te empuja en cierta dirección, y la fuerza y dirección dependen de tu posición exacta y del momento. Un campo vectorial hace lo mismo con tus muestras: asigna una dirección y una velocidad a cada punto del espacio en cada instante.
Una trayectoria probabilística es la secuencia de distribuciones por las que pasa una muestra en su camino del ruido a los datos. En t = 0 muestreas de la distribución de origen, normalmente ruido gaussiano. En t = 1 muestreas de la distribución de datos objetivo. Todo lo que hay entre medias son distribuciones intermedias, y la trayectoria probabilística describe cómo una se transforma en la siguiente.
El campo vectorial y la trayectoria probabilística están conectados directamente porque el campo vectorial mueve las muestras a lo largo de esa trayectoria, de una distribución intermedia a la siguiente, hasta alcanzar la distribución de datos.
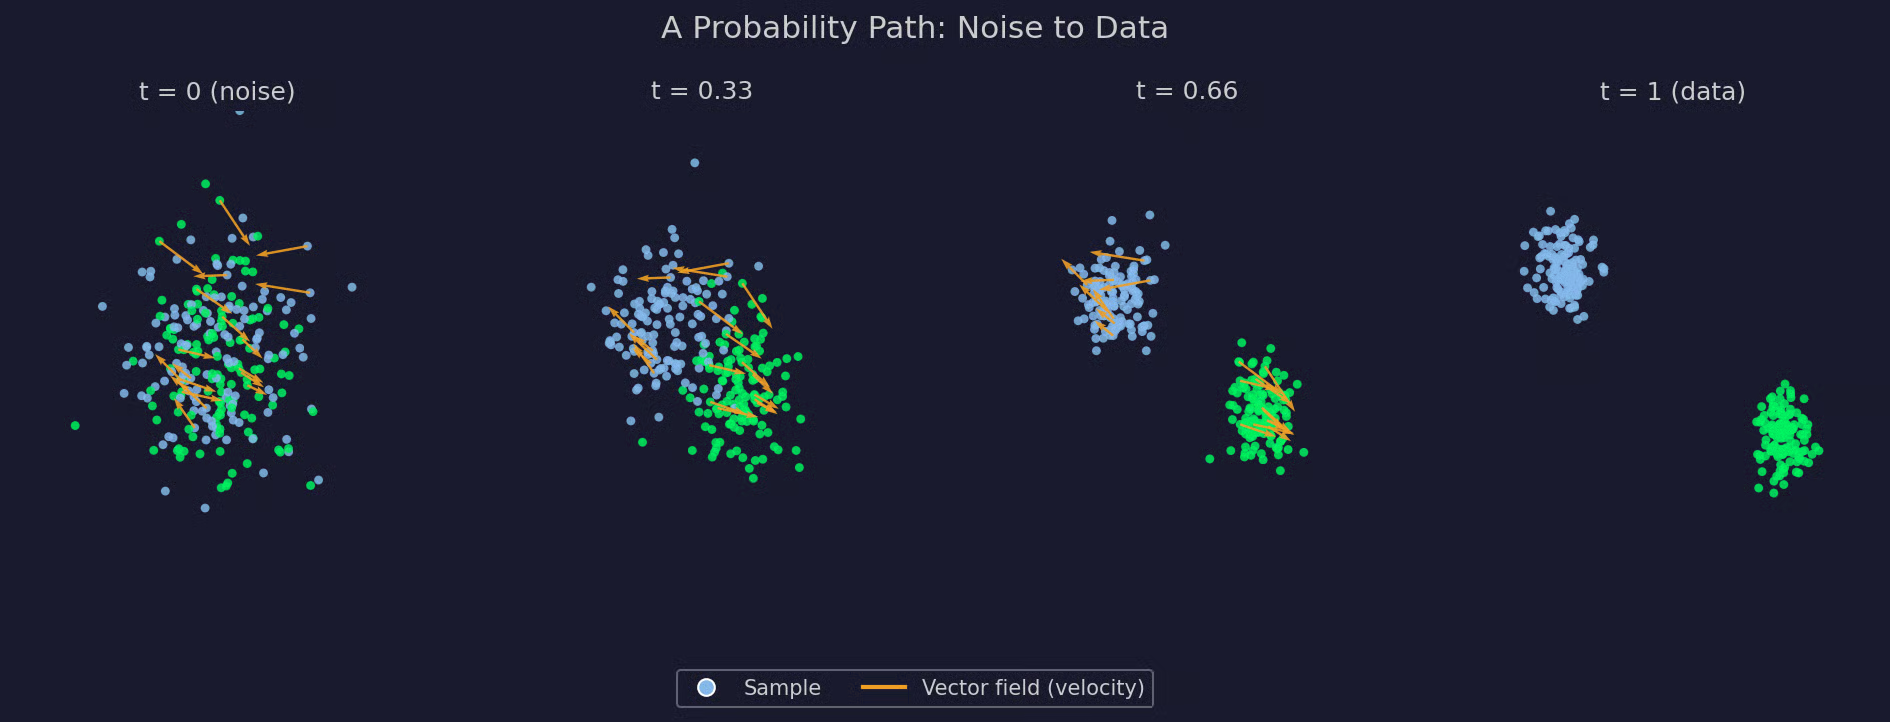
Diagrama de una trayectoria probabilística
El objetivo de flow matching convierte campos vectoriales y trayectorias probabilísticas en una única regresión.
Cada paso de entrenamiento compara dos velocidades. La primera es la velocidad objetivo: la dirección y rapidez a la que debería moverse una muestra en ese punto de la trayectoria elegida. La segunda es la velocidad predicha por el modelo: su estimación para esa misma dirección y rapidez, dada la muestra y el tiempo actuales. El entrenamiento hace que ambas coincidan lo máximo posible.
Esta es la función de pérdida:
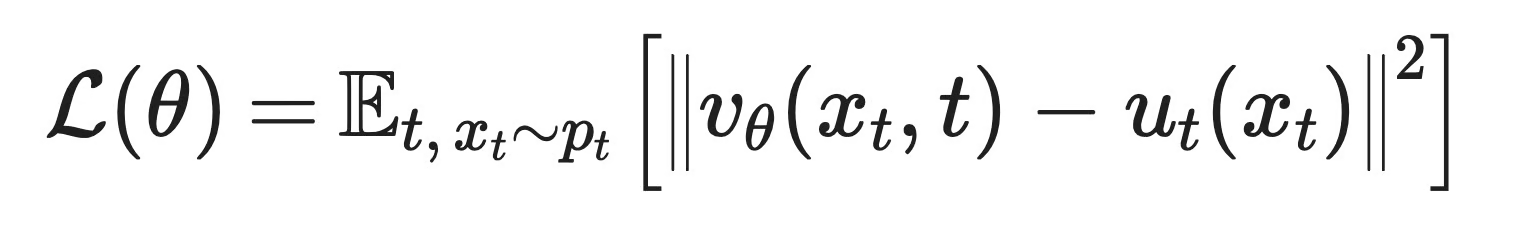
Función de pérdida de flow matching
Qué significa cada término:
v_θ(x_t, t): la velocidad predicha por el modelo en el punto x_t y el instante t
u_t(x_t): la velocidad objetivo en ese mismo punto e instante, según la trayectoria elegida
𝔼[...]: un promedio sobre muchos valores aleatorios de t y x_t
‖ · ‖^2: la diferencia al cuadrado entre ambas velocidades: un MSE sencillo
La derivación completa no viene al caso. Lo importante es que la red predice un único vector en un punto e instante concretos y lo comparas con un objetivo conocido. ¡Ya está!
La trayectoria probabilística marginal que conecta toda la distribución de ruido con toda la distribución de datos no es algo que puedas escribir directamente.
Calcular la velocidad objetivo en un punto dado implica tener en cuenta cada muestra de datos que podría haberlo generado: una integral sobre todo tu conjunto de datos, inviable de computar en cada paso de entrenamiento.
El flow matching condicional lo resuelve condicionando en muestras individuales en lugar de en la trayectoria completa. En vez de calcular el campo vectorial para toda la trayectoria marginal, eliges un único punto de datos y un único punto de ruido, y construyes una trayectoria probabilística solo para ese par. Si haces que esa trayectoria condicional sea simple, por ejemplo una línea recta entre ambos puntos, la velocidad objetivo tiene una expresión en forma cerrada que puedes calcular directamente.
Entrenar la red con estas velocidades condicionales simples por par, promediadas sobre suficientes pares, te lleva al mismo campo vectorial que obtendrías con el objetivo marginal intratable. Nunca calculas directamente la trayectoria marginal: la aproximas indirectamente, una trayectoria condicional sencilla cada vez.
Esta versión condicional es la que casi todo el mundo entrena en la práctica. La formulación marginal hace que las matemáticas cierren, pero la condicional es la que funciona.
Se comparan difusión y flow matching por una buena razón: muchos de los "modelos de difusión" que ya conoces ahora se entrenan con un objetivo de flow matching. Eso no significa que flow matching haya sustituido a la difusión. Significa que la difusión es un caso concreto dentro de un marco más amplio, y flow matching es su versión general.
Empiezo por lo que predice cada red. Un modelo de difusión predice ruido. Dada una muestra ruidosa y un paso temporal, predice el ruido que se mezcló y lo elimina, paso a paso. Flow matching, en cambio, predice una velocidad. Dada una muestra y un instante, predice en qué dirección y a qué ritmo debe moverse esa muestra hacia la distribución de datos.
La trayectoria probabilística es donde más difieren.
Los modelos de difusión fijan de antemano un proceso de añadir ruido concreto, normalmente gaussiano con un calendario fijo, y todo lo demás deriva de esa elección. En flow matching, eliges cualquier trayectoria que conecte ruido y datos, y el objetivo funciona igual elijas la que elijas. Una trayectoria gaussiana al estilo difusión es una opción. Otra es la línea recta entre ruido y datos, y esta decisión resulta clave para muestrear más rápido.
Estas dos predicciones no son tan distintas como parecen.
La predicción de ruido de un modelo de difusión y la predicción de velocidad de un modelo de flow matching son dos vistas del mismo objeto subyacente, conectadas a través del score de la distribución en cada instante. Donde difieren es en cómo generan. El muestreo por difusión es estocástico por defecto, es decir, cada paso de denoising vuelve a añadir algo de aleatoriedad (aunque existen variantes deterministas como DDIM). Flow matching funciona al revés: su formulación natural es una EDO determinista, así que el mismo ruido inicial produce siempre la misma salida, y también existen variantes estocásticas en este marco.
En ambos casos, muestrear significa resolver una ecuación diferencial paso a paso, yendo del ruido a los datos.
Los modelos de difusión suelen necesitar decenas de pasos salvo que uses muestreadores rápidos o destilación. Flow matching, especialmente entrenado con trayectorias rectas, suele necesitar muchos menos pasos sin nada de eso: una trayectoria recta tiene velocidad constante, mucho más fácil de seguir con precisión que una curva.
La propia trayectoria es donde flow matching toma ventaja.
Los modelos de difusión están limitados por el proceso de ruidado del que parten. Flow matching trata la trayectoria como una decisión de diseño, y distintas opciones conllevan distintos compromisos.
|
Modelos de difusión |
Flow matching |
|
|
Qué predice la red |
El ruido añadido en cada paso |
La velocidad hacia la distribución de datos |
|
Trayectoria probabilística |
Fijada por un proceso de ruidado específico |
Se elige libremente; las líneas rectas son comunes |
|
Objeto subyacente |
Score de la distribución ruidosa |
Campo vectorial dependiente del tiempo, ligado al score |
|
Generación |
Estocástica por defecto, con variantes deterministas |
Determinista por defecto, con variantes estocásticas |
|
Pasos de muestreo |
A menudo decenas sin trucos adicionales |
A menudo muchos menos, sobre todo con trayectorias rectas |
|
Elección de la trayectoria |
Fijada por el proceso directo |
Una decisión abierta de diseño — la difusión es un caso |
Flow matching frente a modelos de difusión
La difusión no es el único método con el que se compara flow matching. Hay tres más que deberías conocer.
Los continuous normalizing flows llegaron primero, y flow matching nació directamente de los problemas al entrenarlos.
Un continuous normalizing flow es el tipo de modelo que produce flow matching: una red que define una transformación continua entre distribuciones mediante una EDO. Entrenar uno de la forma original implicaba resolver esa EDO hacia adelante y calcular la verosimilitud exacta en cada paso, lo que supone seguir cómo cambia la densidad de probabilidad a lo largo de la transformación. Ese cómputo es caro, y empeora conforme crece la red.
Flow matching evita todo eso. Ajusta por regresión directamente contra una velocidad objetivo conocida en lugar de resolver la EDO y calcular verosimilitudes durante el entrenamiento. No hace falta simular nada. Sigues obteniendo un continuous normalizing flow, solo que sin pagar el coste de entrenamiento anterior.
Score matching entrena una red para predecir el score — el gradiente del logaritmo de la densidad de probabilidad — en cada nivel de ruido. Es el objetivo detrás de los modelos de difusión que ya conoces.
Flow matching entrena una red para predecir una velocidad. Ambos objetos están relacionados matemáticamente, lo que significa que bajo ciertas elecciones de trayectoria puedes convertir uno en otro. Pero representan cosas distintas. El score describe la forma de la distribución de probabilidad en un instante fijo. La velocidad describe cómo debe moverse una muestra cuando el tiempo cambia.
Score matching va de geometría. Flow matching va de movimiento.
Rectified flow es una elección específica dentro de flow matching.
Flow matching te deja escoger cualquier trayectoria probabilística que conecte ruido y datos. Rectified flow elige una — líneas rectas — y da un paso más con un procedimiento iterativo llamado "reflow" que endereza las trayectorias que ya aprendió un modelo entrenado, para que un modelo de segunda ronda necesite aún menos pasos de integración al generar.
Por eso los dos términos aparecen juntos en los mismos artículos. Stable Diffusion 3 y Flux usan flow matching con una elección de trayectoria cercana a rectified flow. Pero tratar flow matching y rectified flow como sinónimos es perder la idea: flow matching es el marco; rectified flow es una de las trayectorias que puedes elegir dentro de él.
Flow matching ya impulsa algunos de los sistemas generativos más grandes en producción.
Todo esto se debe a que una pérdida de regresión es sencilla de implementar y escalar. Y como la trayectoria es una decisión de diseño, los equipos que construyen sistemas con miles de millones de parámetros pueden elegir una que requiera menos pasos de muestreo, algo que importa cuando cada paso cuesta cómputo a esa escala.
Hasta ahora ha sido conceptual. Ahora te enseño la misma idea funcionando en un conjunto de datos 2D real, lo bastante pequeño como para ver cada paso.
La distribución de ruido es una gaussiana 2D estándar, centrada en el origen. La distribución objetivo son tres grupos gaussianos dispuestos en triángulo: lo bastante simple para que una red pequeña lo aprenda rápido, pero con estructura suficiente como para ver si acierta.
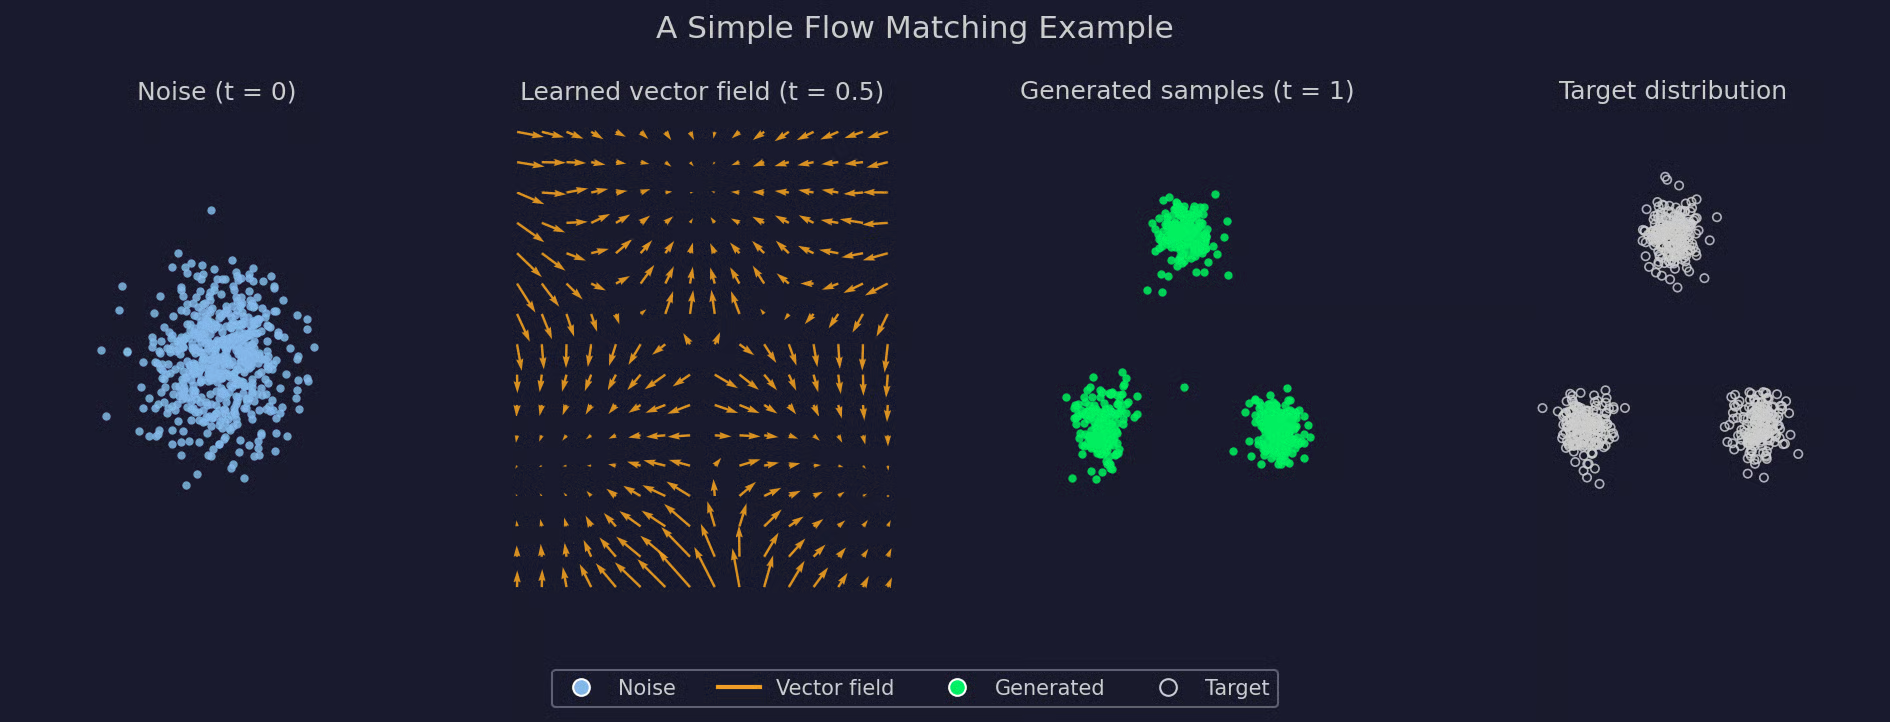
Ejemplo sencillo de flow matching
El primer panel muestra de dónde parte todo: ruido disperso sin estructura. El segundo panel es el propio campo vectorial, evaluado en una cuadrícula a mitad de entrenamiento. Fíjate cómo las flechas ya apuntan hacia uno de los tres grupos, mucho antes de que llegue ninguna muestra. El tercer panel muestra qué pasa si partes de ruido nuevo y sigues ese campo hasta t = 1: emergen tres grupos, que encajan casi perfectamente con el cuarto panel.
Nada de esto requiere algo que no hayamos visto ya: una distribución origen, una objetivo, un campo vectorial aprendido y un solver de EDO que los conecta. Vamos con el código.
Aquí tienes una pequeña implementación en PyTorch del mismo ejemplo, usando la misma fuente de ruido y el objetivo de tres grupos.
Empieza con las dos distribuciones y cómo muestrearlas:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
La red toma un punto y un instante temporal y predice una velocidad:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
En entrenamiento, en cada paso se muestrean lotes de puntos origen, puntos objetivo e instantes temporales; luego se interpola entre los dos primeros y se ajusta por regresión a la velocidad resultante:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Para generar, resuelve la EDO aprendida con una integración de Euler sencilla. Solo necesitas un bucle que dé pequeños pasos desde t = 0 hasta t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`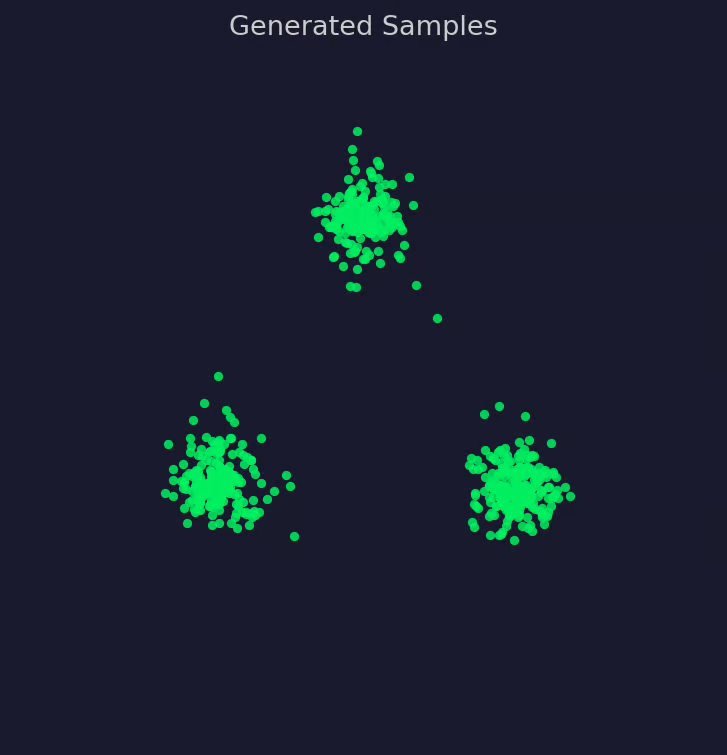
Visualización de muestras generadas
Y ese es todo el pipeline: muestrear, interpolar, ajustar por regresión e integrar. Nada cambia si usas una red más grande, otra trayectoria o datos de mayor dimensión: solo la escala.
Nada de esto convierte al flow matching en una mejora universal sobre la difusión. Es un compromiso más, como cualquier otra decisión de diseño.
Aquí es donde es buena opción y donde no tanto.
Flow matching enseña a un modelo cómo deben moverse las muestras desde una distribución simple hacia la distribución de datos. Todo lo demás que he descrito existe para hacer entrenable esa única idea.
Dos ideas hacen la mayor parte del trabajo. Una trayectoria probabilística conecta el ruido con los datos a través de una secuencia de distribuciones intermedias. Un campo vectorial describe cómo debe moverse una muestra en cualquier punto de esa trayectoria, en cualquier instante. La red aprende ese campo vectorial, su velocidad, y generar consiste en seguir el flujo resultante del ruido a los datos.
Nada de esto está desligado de lo anterior. Flow matching es cómo los sistemas modernos entrenan continuous normalizing flows sin el viejo cálculo de verosimilitud, y los modelos de difusión resultan ser un caso específico dentro de él.
Si los modelos de difusión, los normalizing flows o la IA generativa en general te interesan, estos son los siguientes pasos:
Aprende IA con DataCamp
Curso
Curso
Curso