
Cours
Comprendre l'intelligence artificielle
2 h
421.5K
Vous voyez le terme "flow matching" associé à chaque nouveau modèle d’images et de vidéos, sans vraiment savoir ce qu’il recouvre ?
La plupart des explications plongent directement dans les équations différentielles ou le présentent comme « de la diffusion, en mieux ». Aucune ne dit vraiment ce que le modèle apprend. Stable Diffusion 3 et Flux reposent tous deux sur le flow matching, et génèrent des images en quelques étapes là où une diffusion classique en nécessite des dizaines.
L’idée générale est la suivante : au lieu d’apprendre des exemples individuels, le modèle apprend un champ de vitesses qui indique à n’importe quel échantillon dans quelle direction aller et à quelle vitesse. Une fois que vous avez compris cela, le processus d’entraînement, les mathématiques sous-jacentes et le lien avec la diffusion deviennent limpides.
Dans cet article, je vous guide à travers l’intuition derrière le flow matching, son entraînement, un aperçu des mathématiques (sans lourdeur) et sa comparaison avec les modèles de diffusion.
Si vous débutez avec l’IA appliquée à l’image, lisez notre Top 10 Vision Language Models in 2026 pour découvrir l’état de l’art en raisonnement visuel, analyse d’images et vision par ordinateur.
Le flow matching est un objectif d’entraînement, pas une architecture de modèle.
Cette distinction est importante, car on peut l’associer à un Transformer ou presque n’importe quel autre réseau — ce qui définit le flow matching, c’est ce que le réseau apprend à prédire, pas son apparence.
Et ce qu’il apprend à prédire, c’est un champ vectoriel dépendant du temps. En clair, c’est une fonction qui indique, à chaque point de la trajectoire allant de la distribution source à la distribution cible, dans quelle direction et à quelle vitesse un échantillon doit se déplacer. En entraînant ainsi des continuous normalizing flows, on obtient un modèle qui transforme progressivement une distribution simple en une distribution complexe.
J’aime résumer l’intuition en quatre idées :
Si vous êtes plutôt visuel, imaginez un nuage de particules dispersées sans ordre. Le flow matching apprend à chaque particule exactement dans quelle direction aller et à quelle vitesse, de sorte que l’ensemble du nuage se réorganise progressivement en un motif structuré (la forme de votre distribution cible).
Sur un jeu d’images, ce « motif structuré » devient une photo cohérente plutôt qu’un bruit aléatoire.
L’entraînement et la génération sont deux phases distinctes, et la confusion naît souvent quand on les confond.
Pendant l’entraînement :
t aléatoire entre 0 et 1t, en suivant une trajectoire probabiliste qui les reliet, selon la trajectoire choisieLa génération n’a pas besoin du point de données.
Vous partez du bruit et vous intégrez le champ vectoriel appris vers l’avant dans le temps, à petits pas, jusqu’à obtenir un échantillon de la distribution de données.
Et voilà l’idée : on prédit la vitesse pendant l’entraînement, puis on la suit pendant la génération.
Deux notions portent l’essentiel de l’objectif de flow matching : les champs vectoriels et les trajectoires probabilistes. Une fois que vous les maîtrisez, la fonction de perte présentée ensuite devient naturelle.
Un champ vectoriel est ce que le réseau prédit. Pour tout point de l’espace et à tout instant, il fournit une direction et une vitesse — la manière dont un échantillon à cet endroit doit se déplacer pour se rapprocher de la distribution de données.
Par analogie, imaginez-vous debout dans une rivière. Où que vous soyez, le courant vous pousse d’une certaine façon, avec une intensité et une direction qui dépendent de votre position exacte et du moment. Un champ vectoriel fait la même chose pour vos échantillons — il attribue une direction et une vitesse à chaque point de l’espace, à chaque instant.
Une trajectoire probabiliste est la suite de distributions qu’un échantillon traverse sur son chemin du bruit vers les données. À t = 0, vous échantillonnez la distribution source, en général un bruit gaussien. À t = 1, vous échantillonnez la distribution de données cible. Tout ce qui se trouve entre les deux est une distribution intermédiaire, et la trajectoire probabiliste décrit comment l’une se transforme en l’autre.
Le champ vectoriel et la trajectoire probabiliste sont directement liés : le champ fait évoluer les échantillons le long de la trajectoire, d’une distribution intermédiaire à la suivante, jusqu’à atteindre la distribution de données.
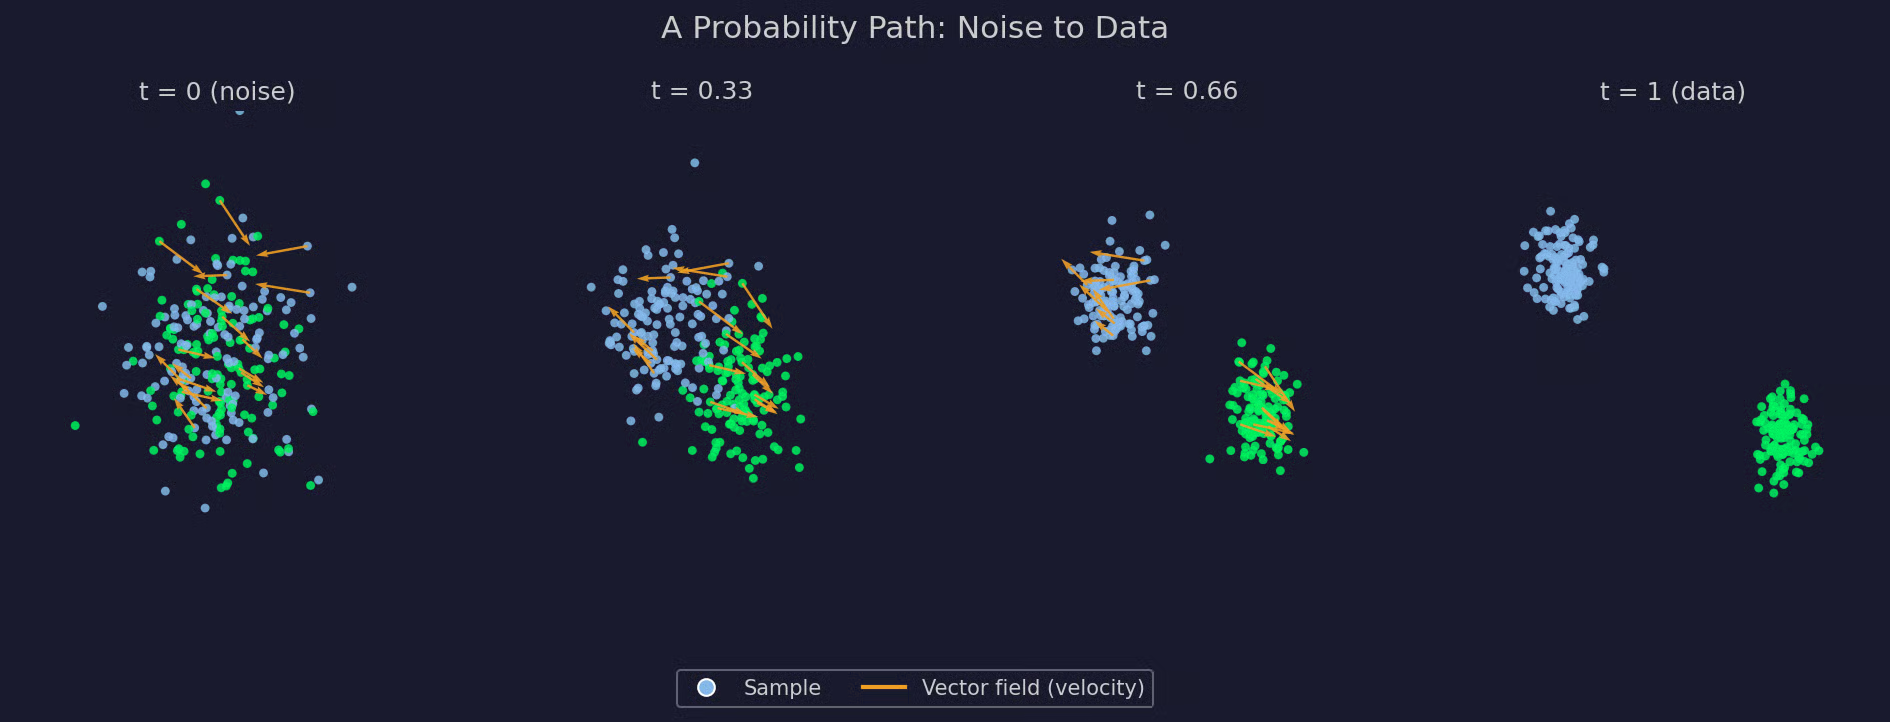
Schéma d’une trajectoire probabiliste
L’objectif de flow matching combine champs vectoriels et trajectoires probabilistes en une unique perte de régression.
Chaque étape d’entraînement compare deux vitesses. La première est la vitesse cible — la direction et la vitesse que doit prendre un échantillon à cet endroit de la trajectoire choisie. La seconde est la vitesse prédite par le modèle — l’estimation du réseau pour cette même direction et vitesse, compte tenu de l’échantillon courant et du temps. L’entraînement rapproche au maximum ces deux valeurs.
Voici la fonction de perte :
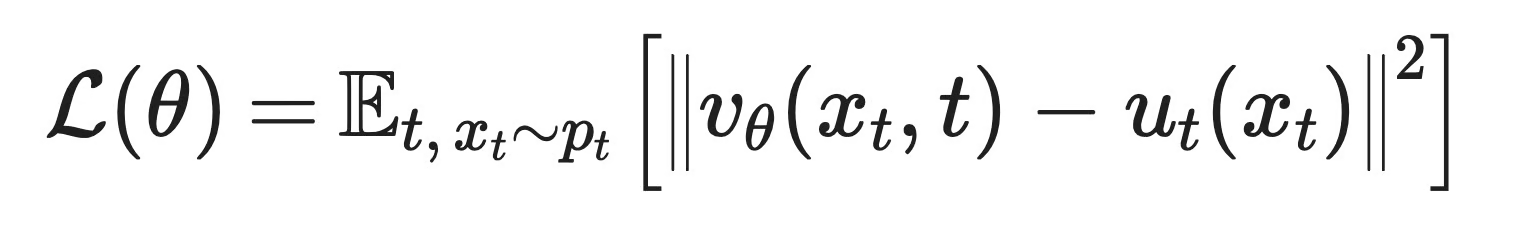
Fonction de perte du flow matching
Voici la signification de chaque terme :
v_θ(x_t, t) : la vitesse prédite par le modèle au point x_t et à l’instant t
u_t(x_t) : la vitesse cible au même point et au même instant, basée sur la trajectoire probabiliste choisie
𝔼[...] : une moyenne sur de nombreuses valeurs aléatoires de t et x_t
‖ · ‖^2 : la différence au carré entre les deux vitesses — une simple erreur quadratique moyenne
La dérivation complète n’est pas l’objet ici. Ce qui compte, c’est que le réseau prédit un seul vecteur en un point et un instant donnés, et qu’on le compare à une cible connue. C’est tout !
La trajectoire probabiliste marginale reliant l’ensemble de la distribution de bruit à l’ensemble de la distribution de données n’est pas quelque chose que l’on peut écrire directement.
Calculer la vitesse cible en un point donné revient à tenir compte de tous les échantillons de données susceptibles de l’avoir produit — une intégrale sur tout votre jeu de données, impossible à effectuer à chaque itération d’entraînement.
Le flow matching conditionnel résout le problème en se conditionnant sur des échantillons individuels plutôt que sur la trajectoire complète. Plutôt que de calculer le champ vectoriel pour le chemin marginal entier, vous choisissez un point de données et un point de bruit, puis construisez une trajectoire probabiliste pour cette paire uniquement. Si vous rendez ce chemin conditionnel simple — par exemple une ligne droite entre les deux points — la vitesse cible admet une expression fermée directement calculable.
En entraînant le réseau sur ces vitesses conditionnelles simples, paire par paire, et en moyennant sur suffisamment de paires, vous retrouvez le même champ vectoriel que l’objectif marginal intraitable. Vous ne calculez jamais directement la trajectoire marginale — vous l’approchez indirectement, un chemin conditionnel facile à la fois.
Cette version conditionnelle est celle que tout le monde entraîne en pratique. La formulation marginale fait tenir les maths, mais la formulation conditionnelle est opérationnelle.
On compare souvent diffusion et flow matching — avec raison : la plupart des « modèles de diffusion » que vous connaissez utilisent désormais un objectif de flow matching. Cela ne signifie pas que le flow matching a remplacé la diffusion. Cela signifie que la diffusion s’avère être un cas particulier au sein d’un cadre plus général, dont le flow matching est la version englobante.
Commençons par ce que chaque réseau prédit. Un modèle de diffusion prédit le bruit. Étant donné un échantillon bruité et un pas de temps, il prédit le bruit ajouté, puis le retire, étape par étape. Le flow matching prédit, lui, une vitesse. Donnez un échantillon et un instant, il prédit dans quelle direction et à quelle vitesse cet échantillon doit se déplacer vers la distribution de données.
La trajectoire probabiliste est le point de divergence le plus marqué.
Les modèles de diffusion fixent à l’avance un processus de bruitage spécifique, généralement l’ajout de bruit gaussien selon un calendrier fixé, et tout découle de ce choix. En flow matching, vous choisissez n’importe quel chemin reliant bruit et données, et l’objectif fonctionne de la même manière quel que soit votre choix. Un chemin gaussien « à la diffusion » est une option. Une ligne droite entre bruit et données en est une autre, et cela compte énormément pour la vitesse d’échantillonnage.
Ces deux prédictions ne sont pas si différentes qu’elles en ont l’air.
La prédiction du bruit d’un modèle de diffusion et la prédiction de vitesse d’un modèle de flow matching sont deux vues d’un même objet sous-jacent, reliées au score de la distribution à chaque instant. La différence majeure tient à la génération. L’échantillonnage par diffusion est stochastique par défaut — chaque étape de débruitage réinjecte un peu d’aléa (même si des variantes déterministes comme DDIM existent). Le flow matching, lui, se formule naturellement comme une EDO déterministe : un même bruit de départ produit le même résultat à chaque fois, et des variantes stochastiques existent également de ce côté.
Dans les deux cas, échantillonner revient à résoudre une équation différentielle pas à pas, en allant du bruit vers les données.
Les modèles de diffusion requièrent souvent des dizaines d’étapes sans astuces supplémentaires ni distillation. Le flow matching, surtout entraîné sur des chemins rectilignes, nécessite souvent beaucoup moins d’étapes — un chemin droit implique une vitesse constante, plus simple à suivre précisément pour un solveur qu’une trajectoire courbe.
Le choix du chemin est l’avantage clé du flow matching.
Les modèles de diffusion sont limités par le processus de bruitage dont ils découlent. Le flow matching traite la trajectoire comme un choix de conception, avec des compromis différents selon l’option retenue.
|
Modèles de diffusion |
Flow matching |
|
|
Ce que le réseau prédit |
Le bruit ajouté à chaque étape |
La vitesse vers la distribution de données |
|
Trajectoire probabiliste |
Fixée par un processus de bruitage spécifique |
Choisie librement ; les lignes droites sont courantes |
|
Objet sous-jacent |
Score de la distribution bruitée |
Champ vectoriel dépendant du temps, lié au score |
|
Génération |
Stochastique par défaut, variantes déterministes possibles |
Déterministe par défaut, variantes stochastiques possibles |
|
Nombre d’étapes d’échantillonnage |
Souvent des dizaines sans artifices |
Souvent bien moins, surtout avec des chemins plus droits |
|
Choix du chemin |
Imposé par le processus direct |
Un choix de conception ouvert — la diffusion en est une instance |
Comparaison du flow matching et des modèles de diffusion
La diffusion n’est pas la seule méthode comparée au flow matching. Trois autres méritent votre attention.
Les continuous normalizing flows sont arrivés en premier, et le flow matching est né directement des difficultés liées à leur entraînement.
Un continuous normalizing flow est le type de modèle que produit le flow matching — un réseau qui définit une transformation continue entre distributions via une EDO. L’entraîner à l’ancienne impliquait de résoudre l’EDO en avant et de calculer une vraisemblance exacte à chaque pas, donc de suivre comment la transformation affecte la densité de probabilité en chemin. Ce calcul est coûteux, et il empire avec la taille du réseau.
Le flow matching évite tout cela. Il régresse directement sur une vitesse cible connue au lieu de résoudre l’EDO et de calculer des vraisemblances pendant l’entraînement. Aucune simulation n’est requise. Vous obtenez toujours un continuous normalizing flow, sans payer l’ancien coût d’entraînement.
Le score matching entraîne un réseau à prédire le score — le gradient du log de la densité de probabilité — à chaque niveau de bruit. C’est l’objectif derrière les modèles de diffusion que vous connaissez déjà.
Le flow matching entraîne un réseau à prédire une vitesse. Les deux objets sont liés mathématiquement et, pour certains choix de chemin, on peut convertir l’un en l’autre. Mais ils représentent des choses différentes. Le score décrit la forme de la distribution de probabilité à un instant donné. La vitesse décrit comment un échantillon doit se déplacer quand le temps évolue.
Le score matching parle de géométrie. Le flow matching parle de mouvement.
Le rectified flow est un choix particulier à l’intérieur du flow matching.
Le flow matching vous laisse choisir n’importe quelle trajectoire entre bruit et données. Le rectified flow en choisit une — des lignes droites — puis va plus loin avec une procédure itérative appelée « reflow » qui redresse les trajectoires déjà apprises par un modèle entraîné, de sorte qu’un second modèle a besoin de encore moins d’étapes d’intégration au moment de la génération.
C’est pourquoi les deux termes apparaissent souvent côte à côte dans les mêmes articles. Stable Diffusion 3 et Flux utilisent tous deux le flow matching avec un choix de chemin proche du rectified flow. Mais confondre flow matching et rectified flow passe à côté de l’essentiel. Le flow matching est le cadre. Le rectified flow est un des chemins possibles en son sein.
Le flow matching propulse aujourd’hui certains des plus grands systèmes génératifs en production.
Tout cela parce qu’une perte de régression est simple à implémenter et à faire passer à l’échelle. Et comme le chemin est un choix de conception, les équipes construisant des systèmes à des milliards de paramètres peuvent opter pour un chemin nécessitant moins d’étapes d’échantillonnage — un point crucial quand chaque étape coûte du calcul à cette échelle.
Jusqu’ici, c’était conceptuel. Passons au même principe sur un véritable jeu 2D, assez petit pour visualiser chaque étape.
La distribution de bruit est une gaussienne 2D standard centrée à l’origine. La distribution cible est composée de trois amas gaussiens formant un triangle — suffisamment simple pour qu’un petit réseau l’apprenne vite, mais assez structuré pour vérifier visuellement le résultat.
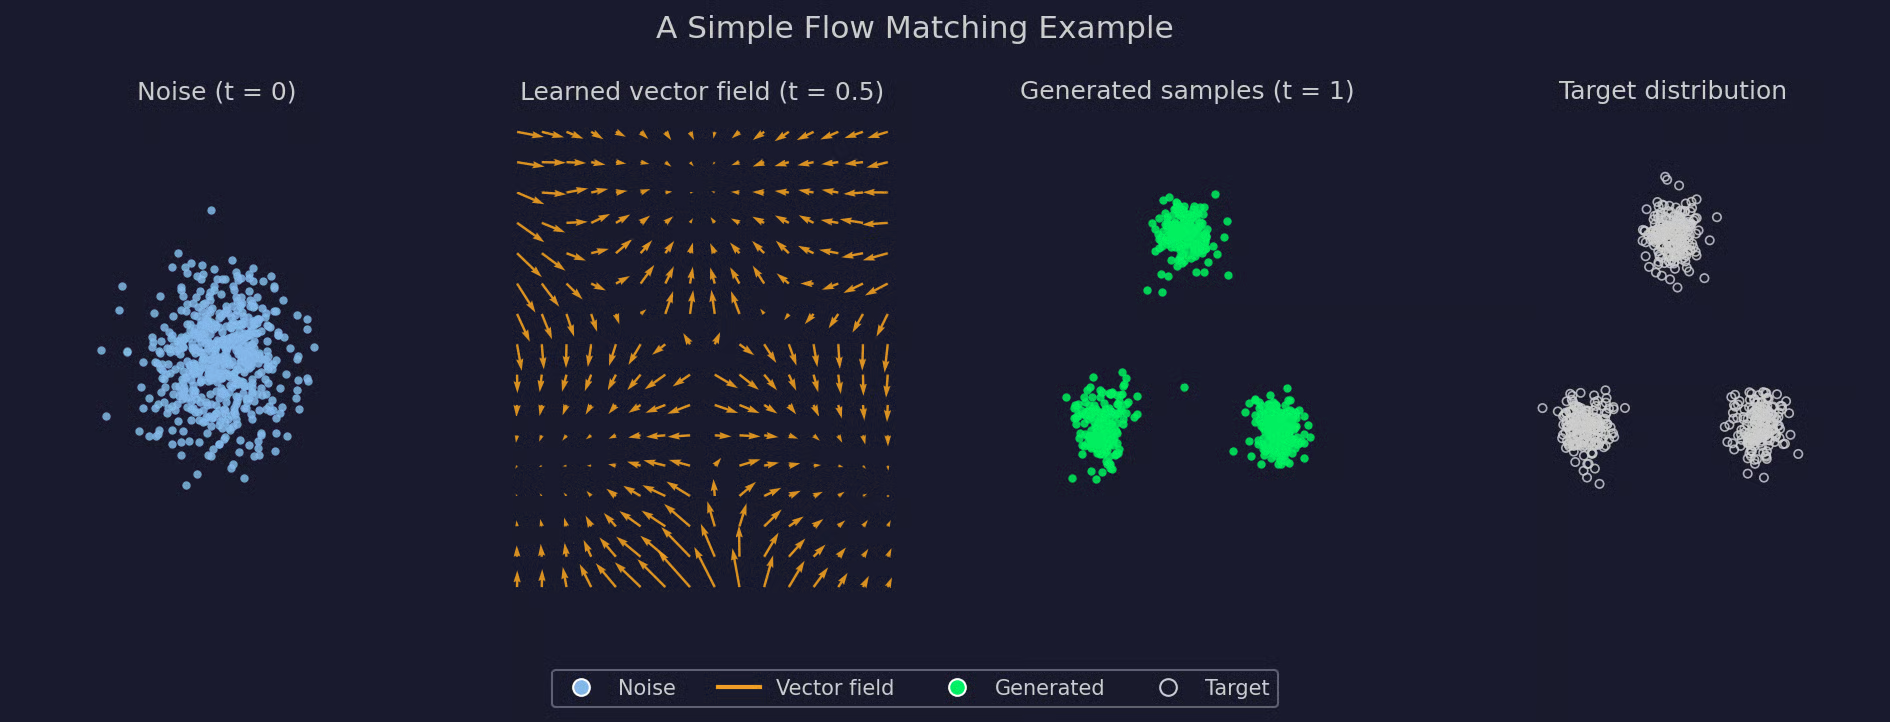
Exemple simple de flow matching
Le premier panneau montre le point de départ de chaque échantillon — du bruit dispersé sans structure. Le second panneau est le champ vectoriel lui-même, évalué sur une grille au milieu de l’entraînement. Notez que les flèches pointent déjà vers l’un des trois amas, bien avant que les échantillons n’y arrivent. Le troisième panneau illustre ce qui se passe quand on part d’un nouveau bruit et qu’on suit ce champ jusqu’à t = 1 — trois amas apparaissent, correspondant presque parfaitement au quatrième panneau.
Tout cela ne fait appel à rien d’autre que ce que nous avons déjà décrit — une distribution source, une distribution cible, un champ vectoriel appris et un solveur d’EDO pour relier le tout. Passons au code.
Voici une petite implémentation PyTorch du même exemple, avec la même source de bruit et la même cible à trois amas.
Commencez par définir les deux distributions et leur échantillonnage :
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Le réseau prend un point et un pas de temps, et prédit une vitesse :
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
L’entraînement échantillonne, à chaque itération, un lot de points source, de points cibles et d’instants, puis interpole entre les deux premiers et régressse sur la vitesse résultante :
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
La génération résout l’EDO apprise via une intégration d’Euler. Il suffit d’une boucle qui avance de petits pas de t = 0 à t = 1 :
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`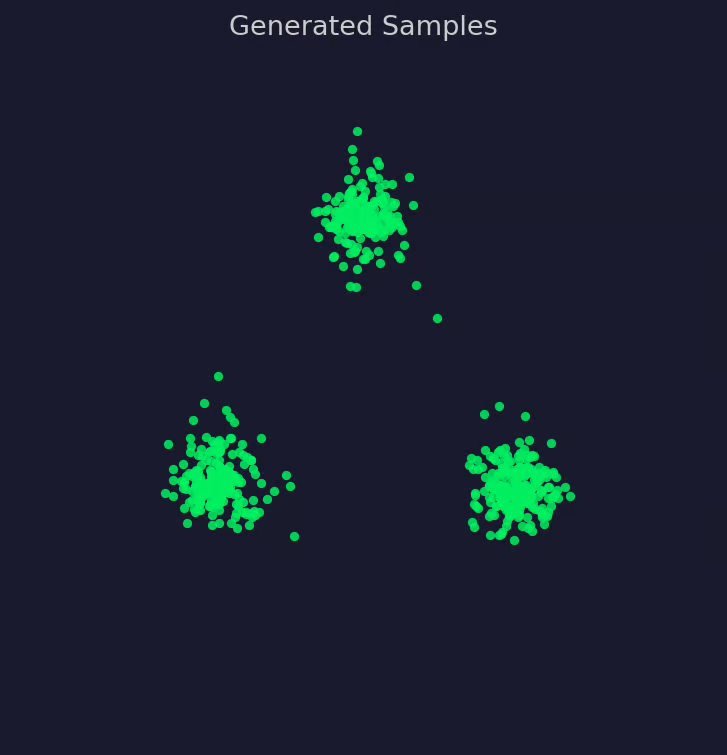
Visualisation des échantillons générés
Et voilà tout le pipeline ! Échantillonner, interpoler, régresser, intégrer. Rien ne change si vous utilisez un réseau plus grand, un autre chemin ou une dimension plus élevée — seule l’échelle évolue.
Rien de tout cela ne fait du flow matching une amélioration universelle par rapport à la diffusion. C’est un compromis, comme tout choix de conception.
Voici quand il est adapté… et quand il l’est moins.
Le flow matching apprend à un modèle comment des échantillons doivent évoluer d’une distribution simple vers la distribution de données. Tout le reste présenté ici sert à rendre cette idée entraînable.
Deux idées font l’essentiel du travail. Une trajectoire probabiliste relie le bruit aux données via une suite de distributions intermédiaires. Un champ vectoriel décrit comment un échantillon doit se déplacer à n’importe quel point de ce chemin, à tout instant. Le réseau apprend ce champ vectoriel — sa vitesse — et la génération consiste simplement à suivre ce flux du bruit vers les données.
Rien de tout cela n’est en rupture avec l’existant. Le flow matching permet d’entraîner des continuous normalizing flows modernes sans l’ancien calcul de vraisemblance, et les modèles de diffusion s’avèrent être un cas particulier de ce cadre.
Si les modèles de diffusion, les normalizing flows ou l’IA générative au sens large vous intéressent, poursuivez ici :
Formez-vous à l’IA avec DataCamp
Cours
Cours
Cours