courses
인공 지능 이해하기
2
421.5K
새로운 이미지·비디오 모델마다 붙는 "flow matching"이라는 용어를 보셨나요? 그런데 정확히 무엇을 의미하는지는 모르시겠나요?
대부분의 설명은 미분방정식으로 곧장 들어가거나 "확산의 업그레이드"로 소개합니다. 하지만 그 둘만으로는 모델이 무엇을 학습하는지 알기 어렵습니다. Stable Diffusion 3와 Flux는 모두 flow matching을 기반으로 하며, 전통적인 확산이 수십 단계를 필요로 하는 곳에서 몇 단계만으로 이미지를 생성합니다.
핵심 아이디어는 이렇습니다. 개별 예시를 학습하는 대신, 모델은 어떤 샘플이 어느 방향으로 얼마나 빠르게 움직여야 하는지를 알려주는 속도장(velocity field)을 학습합니다. 이 관점을 이해하면, 학습 과정과 그 배경 수학, 그리고 확산과의 관계가 모두 자연스럽게 연결됩니다.
이 글에서는 flow matching의 직관, 학습 방식, 가벼운 수학적 배경, 그리고 확산 모델과의 비교를 차례로 설명합니다.
이미지용 AI가 처음이시라면, 2026년 비전-언어 모델 Top 10을 읽고 시각적 추론, 이미지 분석, 컴퓨터 비전의 최신 SOTA 모델을 살펴보세요.
Flow matching은 학습 목표(objective)이지, 모델 아키텍처가 아닙니다.
이 구분은 중요합니다. 트랜스포머든 다른 네트워크든 무엇이든 결합할 수 있으며, 무엇이 flow matching인지 결정하는 것은 네트워크의 모양이 아니라 네트워크가 무엇을 예측하도록 학습되는가입니다.
그리고 그 예측 대상은 시간에 따라 변하는 벡터장입니다. 쉽게 말해, 출발 분포에서 목표 분포로 가는 경로의 각 지점에서 샘플이 어느 방향으로, 얼마나 빠르게 움직여야 하는지 알려주는 함수입니다. 이런 방식으로 연속 정규화 흐름(continuous normalizing flows)을 학습하면, 단순한 분포를 복잡한 분포로 점진적으로 변환하는 모델을 얻게 됩니다.
저는 이 직관을 네 가지 아이디어로 나눠 설명합니다.
시각적 사고가 더 편하시다면, 질서 없이 흩어진 입자 구름을 떠올려 보세요. Flow matching은 각 입자에게 정확한 방향과 속도를 가르쳐, 전체 구름이 시간이 지남에 따라 구조적인 형태(목표 분포의 모양)로 자리 잡도록 만듭니다.
이미지 데이터셋에 적용하면, "구조적인 형태"는 무작위 노이즈 대신 일관된 사진을 의미합니다.
여기서는 학습과 생성이 명확히 분리됩니다. 두 단계를 동일하게 생각할 때 혼란이 자주 생깁니다.
학습 중에는:
t를 선택합니다t에 맞춰 결합합니다t에 가져야 할 방향과 속도를 계산합니다생성 단계에는 데이터 포인트가 필요하지 않습니다.
노이즈에서 시작해 학습된 벡터장을 시간 방향으로 조금씩 적분해 나가면, 데이터 분포에서 샘플을 얻을 때까지 진행됩니다.
즉, 학습에서는 속도를 예측하고, 생성에서는 그 속도를 따라갑니다.
Flow matching 목표의 핵심은 벡터장과 확률 경로, 이 두 가지 개념입니다. 이를 이해하면 다음 절의 손실 함수도 자연스럽게 이해됩니다.
벡터장은 네트워크가 예측하는 대상입니다. 공간의 어느 지점, 어느 시각에서든 한 방향과 속도를 제공합니다 — 그 지점의 샘플이 데이터 분포에 더 가까워지기 위해 움직여야 할 방식입니다.
예를 들어, 강물 속에 서 있다고 상상해 보세요. 서 있는 위치에 따라 물살이 미는 방향과 세기가 달라집니다. 벡터장은 샘플에 대해 같은 일을 합니다 — 시간의 모든 순간, 공간의 모든 지점에 방향과 속도를 할당합니다.
확률 경로는 샘플이 노이즈에서 데이터로 이동하는 동안 거치는 분포들의 연속입니다. t = 0에서는 보통 가우시안 노이즈 같은 출발 분포에서 샘플링하고, t = 1에서는 목표 데이터 분포에서 샘플링합니다. 그 사이의 모든 지점은 중간 분포이며, 확률 경로는 한 분포가 다음 분포로 변하는 방식을 기술합니다.
벡터장과 확률 경로는 직접적으로 연결됩니다. 벡터장은 샘플을 확률 경로를 따라 한 중간 분포에서 다음 중간 분포로 이동시키며, 마침내 데이터 분포에 도달하게 합니다.
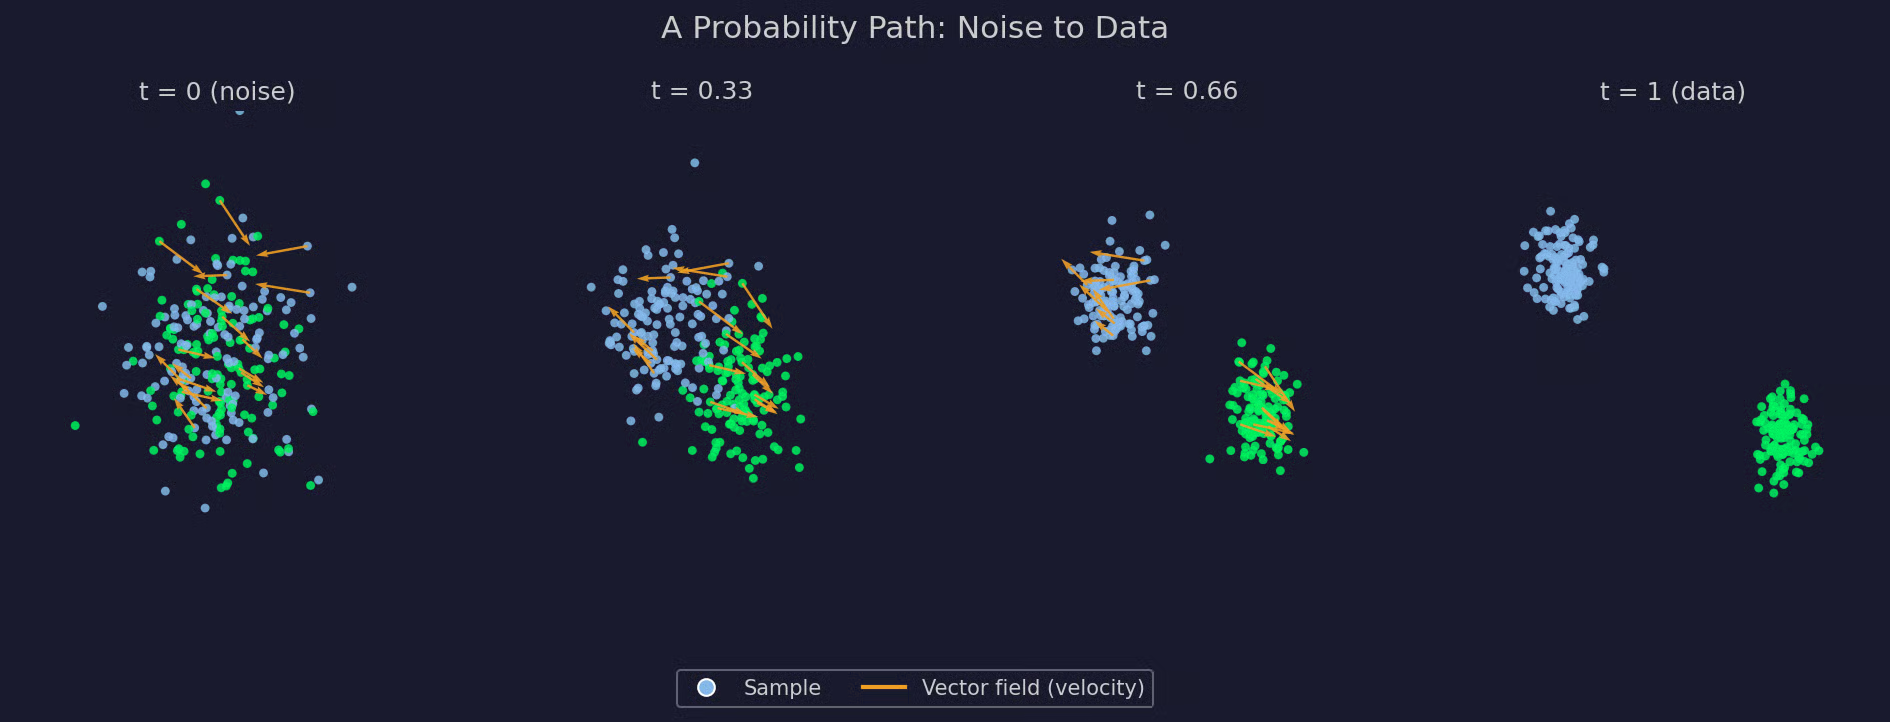
확률 경로 다이어그램
Flow matching 목표는 벡터장과 확률 경로를 하나의 회귀 손실로 결합합니다.
매 학습 단계는 두 개의 속도를 비교합니다. 첫 번째는 목표 속도 — 선택된 확률 경로에서 그 지점이 가져야 할 방향과 속도입니다. 두 번째는 모델이 예측한 속도 — 현재 샘플과 시간에 근거해 네트워크가 추정한 같은 방향과 속도입니다. 학습은 이 둘이 최대한 일치하도록 만듭니다.
손실 함수는 다음과 같습니다.
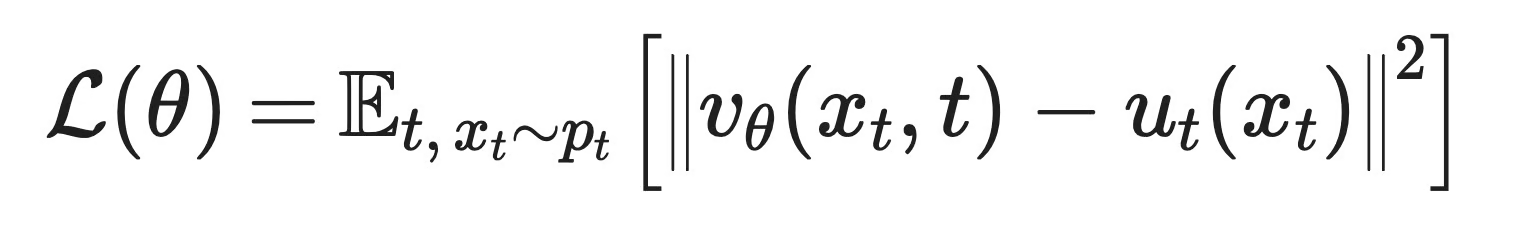
Flow matching 손실 함수
각 항의 의미는 다음과 같습니다.
v_θ(x_t, t): 시점 t와 지점 x_t에서 모델이 예측한 속도
u_t(x_t): 선택한 확률 경로에 근거해 같은 지점과 시각에서의 목표 속도
𝔼[...]: 다수의 임의 t와 x_t에 대한 평균
‖ · ‖^2: 두 속도 간의 제곱차 — 일반적인 평균제곱오차
전체 유도는 여기서 중요하지 않습니다. 핵심은 네트워크가 한 시점, 한 지점에서 하나의 벡터를 예측하고, 그것을 알려진 목표와 비교한다는 점입니다. 그게 전부입니다!
전체 노이즈 분포에서 전체 데이터 분포로 이어지는 주변(marginal) 확률 경로는 직접 기술하기 어렵습니다.
어떤 지점에서의 목표 속도를 계산하려면, 그 지점을 만들어낼 수 있었던 모든 데이터 샘플을 고려해야 합니다 — 데이터셋 전체에 대한 적분으로, 매 학습 단계마다 계산하기에는 비현실적입니다.
조건부(flow) matching은 전체 경로 대신 개별 샘플에 조건을 거는 방식으로 이 문제를 해결합니다. 전체 주변 경로의 벡터장을 계산하는 대신, 하나의 데이터 포인트와 하나의 노이즈 포인트를 선택해 그 쌍만을 위한 확률 경로를 구성합니다. 이 조건부 경로를 단순하게 만들면(예: 두 점을 잇는 직선), 목표 속도가 닫힌형(closed-form)으로 주어져 직접 계산할 수 있습니다.
이러한 단순한 쌍별 조건부 속도를 충분히 많은 쌍에 대해 평균 내며 네트워크를 학습하면, 난해한 주변 목적에서 얻을 벡터장과 같은 것을 얻게 됩니다. 주변 경로를 직접 계산하지 않고, 쉬운 조건부 경로를 하나씩 통해 간접적으로 근사하는 셈입니다.
실제로 거의 모두가 이 조건부 버전으로 학습합니다. 주변 정식화는 수학을 성립시키지만, 조건부 정식화가 실무에서 작동합니다.
확산과 flow matching이 자주 비교되는 데에는 이유가 있습니다 — 여러분이 아는 대부분의 "확산 모델"은 이제 flow matching 목표로 학습됩니다. 이는 flow matching이 확산을 대체했다는 뜻이 아닙니다. 확산이 더 큰 프레임워크 안의 특정한 경우였고, flow matching이 그 일반형이라는 뜻입니다.
각 네트워크가 무엇을 예측하는지부터 보겠습니다. 확산 모델은 노이즈를 예측합니다. 노이즈가 섞인 샘플과 시점을 입력받아 섞인 노이즈를 예측하고, 한 단계씩 제거합니다. Flow matching은 속도를 예측합니다. 샘플과 시점을 입력받아, 그 샘플이 데이터 분포를 향해 어느 방향으로 얼마나 빠르게 이동해야 하는지를 예측합니다.
두 방법의 가장 큰 차이는 확률 경로입니다.
확산 모델은 미리 정해둔 특정 노이즈 추가 과정(보통 고정 스케줄의 가우시안 노이즈 추가)에 의해 경로가 고정되고, 다른 모든 것은 그 한 가지 선택에서 파생됩니다. Flow matching에서는 노이즈에서 데이터로 이어지는 경로를 자유롭게 선택할 수 있으며, 어떤 경로를 고르든 목표는 동일하게 작동합니다. 확산식 가우시안 경로도 한 옵션입니다. 노이즈와 데이터를 잇는 직선 경로도 또 다른 옵션이며, 이는 샘플링 속도에 큰 영향을 줍니다.
두 예측은 보기만큼 다르지 않습니다.
확산 모델의 노이즈 예측과 flow matching의 속도 예측은, 각 시점에서 분포의 스코어(score)를 통해 연결되는 동일한 근본 객체의 두 관점입니다. 차이는 생성 방식에 있습니다. 확산 샘플링은 기본적으로 확률적이며, 각 단계에서 약간의 무작위성이 다시 더해집니다(DDIM 같은 결정론적 변형도 존재). Flow matching은 반대로, 자연스럽게 결정론적 ODE로 정식화되므로 같은 시작 노이즈는 매번 같은 출력을 냅니다(여기에도 확률적 변형이 존재합니다).
두 경우 모두 샘플링은 미분방정식을 단계별로 푸는 것으로, 노이즈에서 데이터로 이동합니다.
확산 모델은 빠른 샘플러나 증류가 없다면 보통 수십 단계가 필요합니다. Flow matching은, 특히 직선 경로로 학습했을 때, 그런 장치 없이도 훨씬 적은 단계를 필요로 하는 경향이 있습니다 — 직선 경로는 속도가 일정해, 곡선 경로보다 해석기가 정확히 따라가기 훨씬 쉽습니다.
경로 자체가 flow matching의 강점입니다.
확산 모델은 유도된 노이즈 추가 과정에 한정됩니다. Flow matching은 경로를 설계 선택지로 보며, 서로 다른 선택지는 각기 다른 트레이드오프를 가져옵니다.
|
확산 모델 |
Flow matching |
|
|
네트워크 예측값 |
각 단계에서 더해진 노이즈 |
데이터 분포를 향한 속도 |
|
확률 경로 |
특정 노이즈 추가 과정으로 고정 |
자유롭게 선택; 직선 경로가 흔함 |
|
근본 객체 |
노이즈가 섞인 분포의 스코어 |
시간 의존 벡터장(스코어와 연결됨) |
|
생성 |
기본은 확률적이나 결정론적 변형 존재 |
기본은 결정론적이나 확률적 변형 존재 |
|
샘플링 단계 수 |
추가 기법이 없으면 흔히 수십 단계 |
대체로 훨씬 적음, 특히 직선 경로에서 |
|
경로 선택 |
정방향 과정으로 고정 |
열린 설계 선택 — 확산은 그중 하나 |
확산 모델과의 비교에서 본 Flow matching
비교 대상은 확산만이 아닙니다. 더 알아둘 만한 세 가지가 있습니다.
먼저 나온 것은 연속 정규화 흐름이며, flow matching은 그것의 학습 문제에서 직접 파생되었습니다.
연속 정규화 흐름은 flow matching이 만들어 내는 유형의 모델입니다 — ODE를 통해 분포 간의 연속 변환을 정의하는 네트워크입니다. 원래 방식대로 학습하려면 ODE를 정방향으로 풀고, 매 단계에서 정확한 가능도(likelihood)를 계산해야 했는데, 이는 변환이 진행되며 확률 밀도가 어떻게 변하는지 추적해야 함을 의미합니다. 이 계산은 비용이 크며, 네트워크가 커질수록 더 악화됩니다.
Flow matching은 이 모든 것을 피합니다. 학습 중 ODE를 풀고 가능도를 계산하는 대신, 알려진 목표 속도에 직접 회귀합니다. 시뮬레이션이 필요 없습니다. 여전히 최종 결과는 연속 정규화 흐름이지만, 그에 따르던 학습 비용을 지불하지 않습니다.
스코어 매칭은 각 노이즈 수준에서 로그 확률 밀도의 기울기(스코어)를 예측하도록 네트워크를 학습합니다. 여러분이 아는 확산 모델의 목표가 바로 이것입니다.
Flow matching은 속도를 예측하도록 학습합니다. 두 객체는 수학적으로 연결되어 있어, 특정 경로 선택 하에서는 서로 변환할 수 있습니다. 하지만 표현하는 대상은 다릅니다. 스코어는 고정된 시점에서 확률 분포의 형태를 기술합니다. 속도는 시간이 변함에 따라 샘플이 어떻게 움직여야 하는지를 기술합니다.
스코어 매칭은 기하(geometry)를 묻고, flow matching은 운동(motion)을 묻습니다.
Rectified flow는 flow matching 안의 특정 선택입니다.
Flow matching에서는 노이즈와 데이터를 잇는 임의의 확률 경로를 고를 수 있습니다. Rectified flow는 직선 경로를 선택하고, 여기에 더해 "reflow"라 불리는 반복 절차로 이미 학습된 모델의 경로를 더 곧게 펴서, 2차 학습 모델이 생성 시 적분 단계를 더 적게 필요로 하게 만듭니다.
이 때문에 두 용어가 같은 논문에 함께 등장합니다. Stable Diffusion 3와 Flux는 모두 rectified-flow에 가까운 경로 선택으로 flow matching을 사용합니다. 하지만 두 용어를 동치로 보는 것은 핵심을 놓치는 일입니다. Flow matching은 프레임워크이고, rectified flow는 그 안에서 선택할 수 있는 하나의 경로입니다.
Flow matching은 이제 대규모 프로덕션 생성 시스템의 핵심에서 작동합니다.
이 모든 것은 회귀 손실이 구현과 확장이 단순하다는 점 때문입니다. 그리고 경로가 설계 선택지이므로, 수십억 매개변수 시스템을 구축하는 팀은 더 적은 샘플링 단계를 요구하는 경로를 선택할 수 있고, 그 규모에서는 각 단계의 연산 비용이 크기 때문에 매우 중요합니다.
지금까지는 개념적 설명이었습니다. 이제 실제 2차원 데이터셋에서 같은 아이디어가 어떻게 작동하는지 단계별로 보여드리겠습니다.
노이즈 분포는 원점에 중심을 둔 표준 2D 가우시안입니다. 목표 분포는 삼각형 형태로 배열된 세 개의 가우시안 클러스터입니다 — 작은 네트워크가 빠르게 학습하기엔 충분히 단순하지만, 제대로 학습했는지 식별할 만큼 구조적입니다.
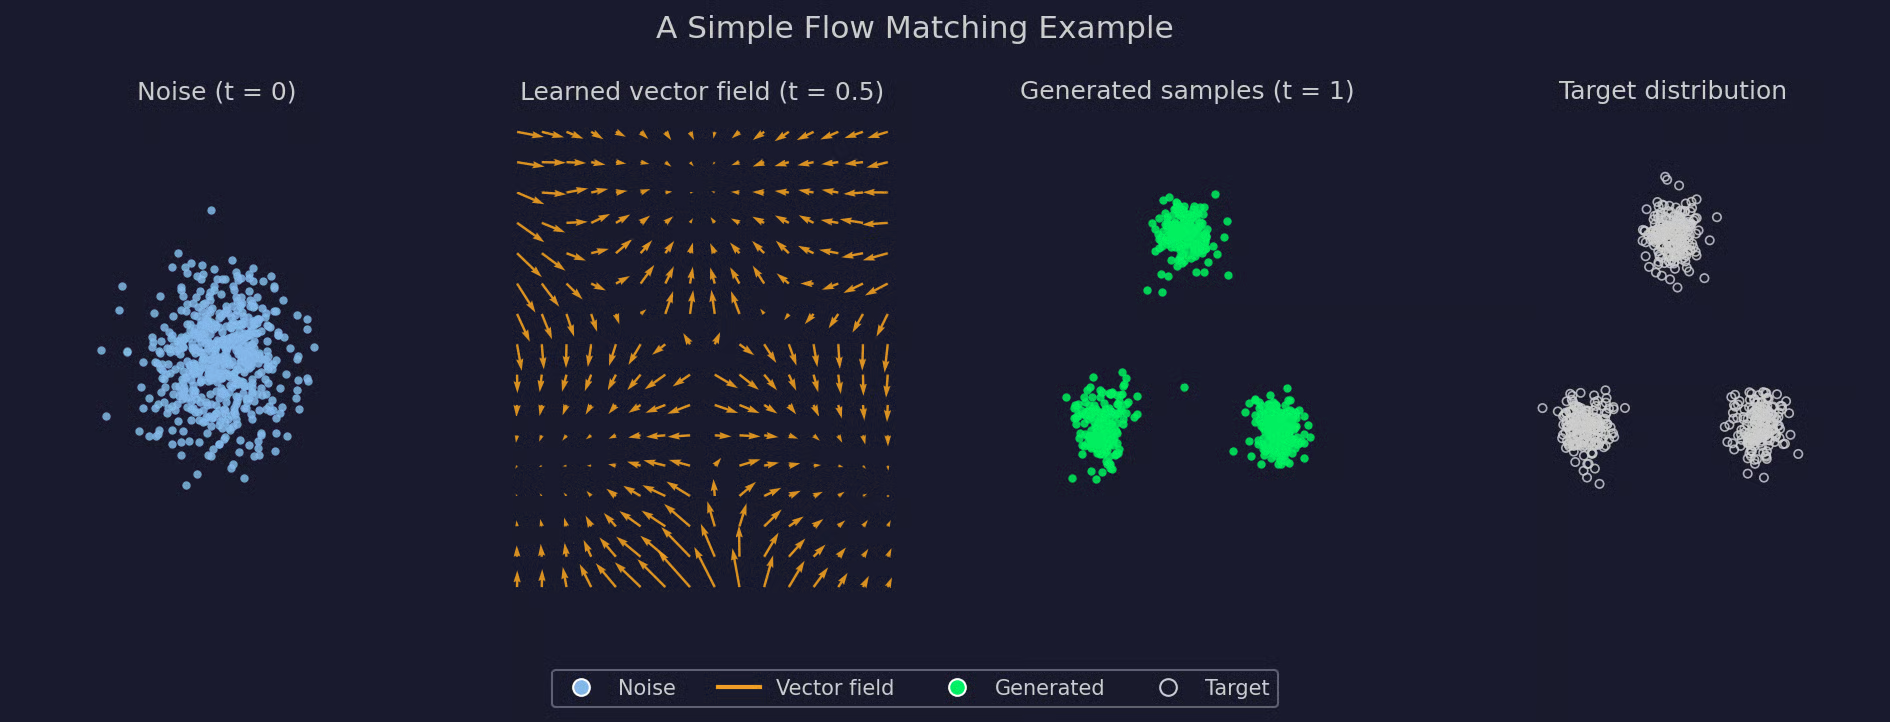
간단한 flow matching 예시
첫 번째 패널은 모든 샘플의 시작점 — 구조 없는 흩어진 노이즈입니다. 두 번째 패널은 학습 중간 시점의 그리드에서 평가한 벡터장입니다. 화살표가 샘플이 도달하기 훨씬 전부터 이미 세 클러스터 중 하나를 향해 가리키고 있음을 볼 수 있습니다. 세 번째 패널은 새 노이즈에서 시작해 t = 1까지 그 벡터장을 따라간 결과를 보여주며 — 네 번째 패널과 거의 완벽히 일치하는 세 클러스터가 나타납니다.
여기에는 앞서 다룬 것 외에 특별한 것은 없습니다 — 출발 분포, 목표 분포, 학습된 벡터장, 그리고 이 셋을 잇는 ODE 해석기. 이제 코드로 넘어가겠습니다.
아래는 같은 예시를 PyTorch로 간단히 구현한 것입니다. 동일한 노이즈 소스와 세 클러스터 목표를 사용합니다.
두 분포와 샘플링 방법부터 시작합니다:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
네트워크는 점과 시점을 입력으로 받아 속도를 예측합니다:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
학습은 매 스텝마다 출발점, 목표점, 시점을 배치로 샘플링하고, 앞의 둘을 보간한 뒤 그에 해당하는 속도로 회귀합니다:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
생성은 학습된 ODE를 단순 오일러 적분으로 풉니다. t = 0에서 t = 1까지 작은 걸음을 쌓아가는 루프가 필요합니다:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`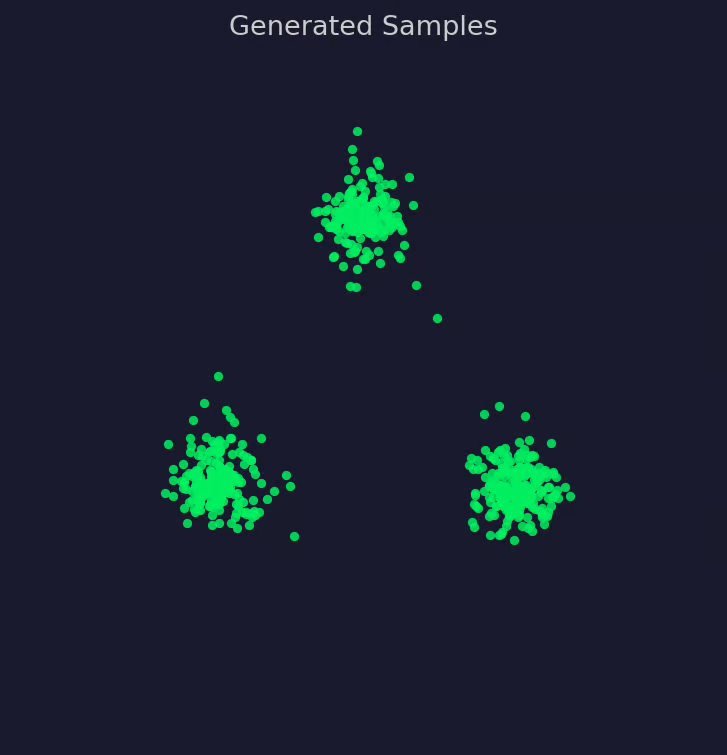
생성된 샘플 시각화
이것이 전체 파이프라인입니다! 샘플링, 보간, 회귀, 적분. 더 큰 네트워크를 쓰든, 다른 경로를 고르든, 더 고차원 데이터셋으로 가든 — 바뀌는 것은 규모뿐입니다.
이 모든 것이 flow matching을 확산의 보편적 업그레이드로 만들지는 않습니다. 다른 설계 선택과 마찬가지로 트레이드오프가 있습니다.
어디에 적합하고 어디에는 덜 적합한지 살펴봅시다.
Flow matching은 샘플이 단순한 분포에서 데이터 분포로 어떻게 이동해야 하는지를 모델에 가르칩니다. 이 글에서 설명한 다른 모든 요소는 그 한 가지 아이디어를 학습 가능하게 만들기 위한 것입니다.
두 가지 개념이 대부분의 역할을 합니다. 확률 경로는 중간 분포의 연속을 통해 노이즈와 데이터를 연결합니다. 벡터장은 그 경로의 어느 지점, 어느 시각에서든 샘플이 어떻게 움직여야 하는지를 기술합니다. 네트워크는 그 벡터장, 즉 속도를 학습하고, 생성은 그 흐름을 따라 노이즈에서 데이터로 이동하는 일입니다.
이 모든 것은 기존 방법과 동떨어져 있지 않습니다. Flow matching은 과거의 가능도 계산 없이 현대 시스템이 연속 정규화 흐름을 학습하는 방식이며, 확산 모델은 그 안의 특정한 경우입니다.
확산 모델, 정규화 흐름, 또는 더 넓게 생성 AI 전반에 관심이 있다면 다음을 살펴보세요:
DataCamp로 AI를 배우세요
courses
courses
courses