
Courses
Hiểu về Trí tuệ Nhân tạo
2 giờ
421.5K
Bạn có thấy thuật ngữ "flow matching" xuất hiện cạnh hầu hết các mô hình ảnh và video mới mà vẫn chưa rõ nó là gì không?
Phần lớn lời giải thích hoặc lao thẳng vào phương trình vi phân, hoặc mô tả nó là "diffusion, nhưng tốt hơn". Cả hai cách đều không cho bạn biết mô hình học gì. Stable Diffusion 3 và Flux đều vận hành theo flow matching, và chúng tạo ảnh chỉ trong vài bước, trong khi diffusion cổ điển cần hàng chục bước.
Ý tưởng chung là: thay vì học từng ví dụ cụ thể, mô hình học một trường vận tốc (velocity field) cho biết bất kỳ mẫu nào nên di chuyển theo hướng nào và nhanh đến mức nào. Khi hiểu điều đó, quy trình huấn luyện, toán học đằng sau, và mối quan hệ với diffusion sẽ đều sáng tỏ.
Trong bài viết này, tôi sẽ dẫn bạn qua trực giác đằng sau flow matching, cách huấn luyện, phần toán (giữ ở mức nhẹ nhàng), và so sánh với các mô hình diffusion.
Nếu bạn mới làm quen với AI cho dữ liệu hình ảnh, hãy đọc Top 10 Mô hình Thị giác-Ngôn ngữ năm 2026 để khám phá các mô hình tiên tiến về suy luận thị giác, phân tích ảnh và thị giác máy tính.
Flow matching là một mục tiêu huấn luyện, không phải kiến trúc mô hình.
Phân biệt này rất quan trọng vì bạn có thể ghép nó với transformer hoặc hầu như bất kỳ mạng nào khác - điều làm nên flow matching là thứ mạng được huấn luyện để dự đoán, không phải hình dạng của mạng.
Và thứ nó được huấn luyện để dự đoán là một trường vector phụ thuộc thời gian. Nói đơn giản, đó là một hàm cho biết ở mỗi điểm trên quãng đường từ phân phối nguồn đến phân phối đích, mẫu nên di chuyển theo hướng nào và nhanh đến đâu. Khi bạn huấn luyện continuous normalizing flows theo cách này, bạn có một mô hình biến một phân phối đơn giản thành phân phối phức tạp, từng bước một.
Tôi thường chia trực giác thành bốn ý:
Nếu bạn thiên về trực quan, hãy tưởng tượng một đám hạt rải rác vô trật tự. Flow matching dạy từng hạt chính xác nên di chuyển hướng nào và nhanh bao nhiêu, để toàn bộ đám hạt dần ổn định thành một mẫu có cấu trúc theo thời gian (hình dạng phân phối đích).
Khi áp dụng lên tập dữ liệu ảnh, "mẫu có cấu trúc" nghĩa là một bức ảnh mạch lạc thay vì nhiễu ngẫu nhiên.
Huấn luyện và sinh mẫu là hai giai đoạn riêng, và nhầm lẫn thường bắt đầu khi mọi người nghĩ chúng là một.
Trong quá trình huấn luyện:
t giữa 0 và 1t, dựa trên một đường đi xác suất nối hai điểmt, dựa trên đường đi bạn đã chọnGiai đoạn sinh mẫu không cần điểm dữ liệu.
Bạn bắt đầu từ nhiễu và tích phân trường vector đã học theo thời gian, từng bước nhỏ, cho tới khi đạt một mẫu từ phân phối dữ liệu.
Và đó là ý chính - bạn dự đoán vận tốc trong huấn luyện, và đi theo nó khi sinh mẫu.
Có hai ý tưởng làm phần lớn công việc đằng sau mục tiêu flow matching - trường vector và đường đi xác suất. Khi đã hiểu chúng, hàm mất mát ở phần tiếp theo sẽ trở nên hợp lý.
Trường vector là thứ mạng dự đoán. Tại bất kỳ điểm nào trong không gian và bất kỳ thời điểm nào, nó cho bạn một hướng và một tốc độ - cách một mẫu tại điểm đó nên di chuyển để tiến gần hơn đến phân phối dữ liệu.
Ví dụ, tưởng tượng bạn đang đứng trong một con sông. Ở bất kỳ vị trí nào, dòng chảy đẩy bạn theo một hướng nhất định, độ mạnh và hướng phụ thuộc vào vị trí chính xác và thời điểm. Trường vector làm điều tương tự cho các mẫu của bạn - nó gán một hướng và tốc độ cho mọi điểm trong không gian, ở mọi thời điểm.
Đường đi xác suất là chuỗi các phân phối mà một mẫu đi qua trên đường từ nhiễu tới dữ liệu. Tại t = 0, bạn lấy mẫu từ phân phối nguồn, thường là nhiễu Gaussian. Tại t = 1, bạn lấy mẫu từ phân phối dữ liệu đích. Mọi thứ giữa hai điểm đó là các phân phối trung gian, và đường đi xác suất mô tả cách cái này biến thành cái kia.
Trường vector và đường đi xác suất liên kết trực tiếp vì trường vector di chuyển các mẫu dọc theo đường đi xác suất, từ phân phối trung gian này sang trung gian tiếp theo, cho đến khi chúng đạt phân phối dữ liệu.
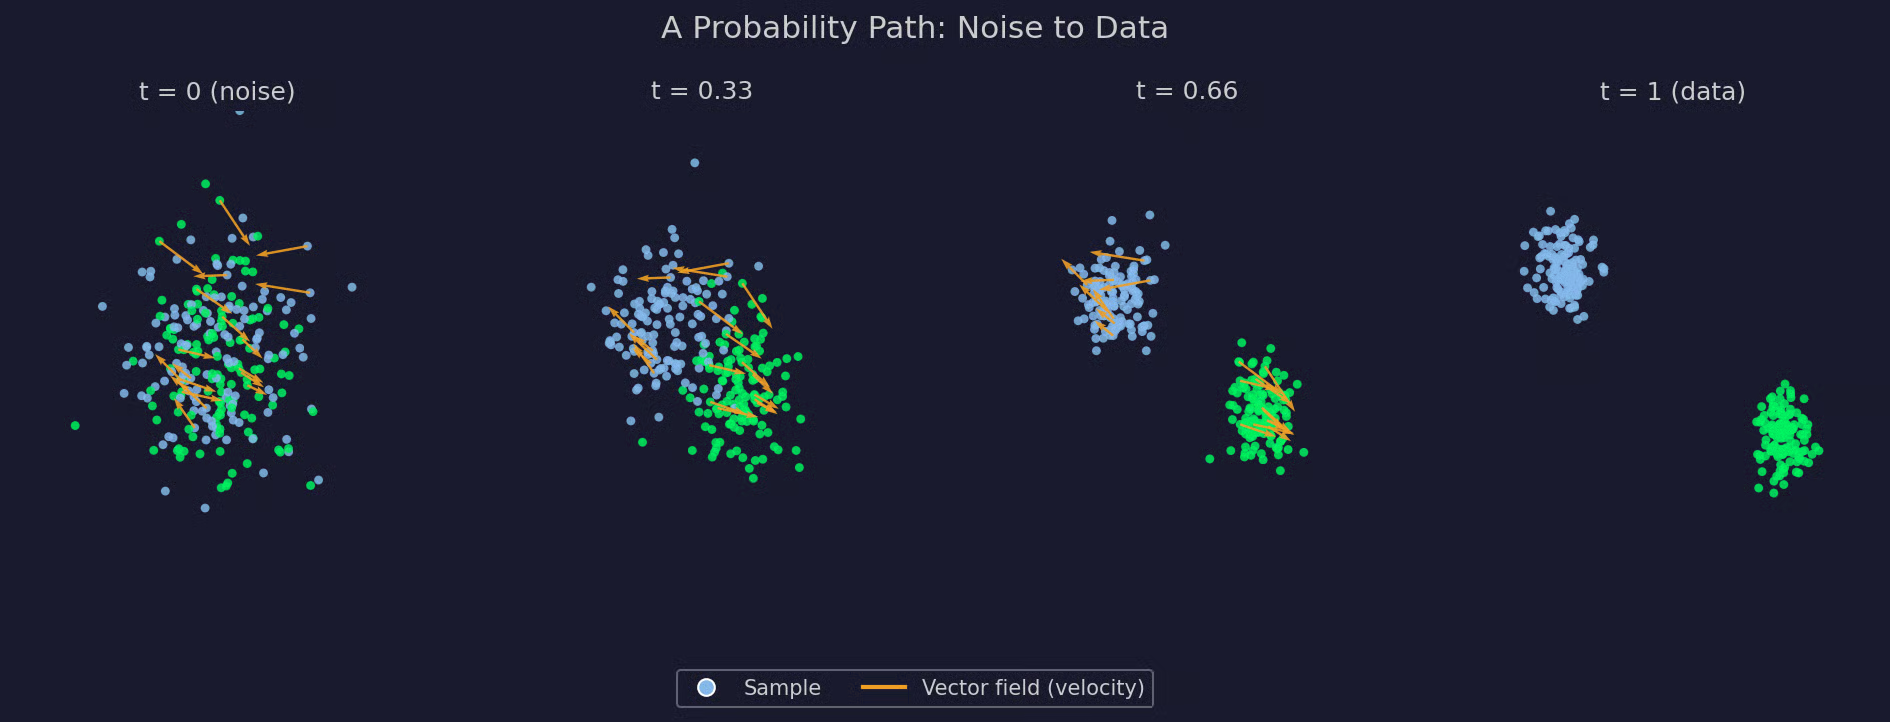
Sơ đồ đường đi xác suất
Mục tiêu flow matching biến trường vector và đường đi xác suất thành một hàm mất mát hồi quy duy nhất.
Mỗi bước huấn luyện so sánh hai vận tốc. Thứ nhất là vận tốc mục tiêu - hướng và tốc độ mà một mẫu nên di chuyển tại điểm đó trên đường đi xác suất đã chọn. Thứ hai là vận tốc do mô hình dự đoán - dự đoán của mạng cho cùng hướng và tốc độ đó, dựa trên mẫu và thời điểm hiện tại. Quá trình huấn luyện làm cho hai thứ này khớp nhau nhất có thể.
Đây là hàm mất mát:
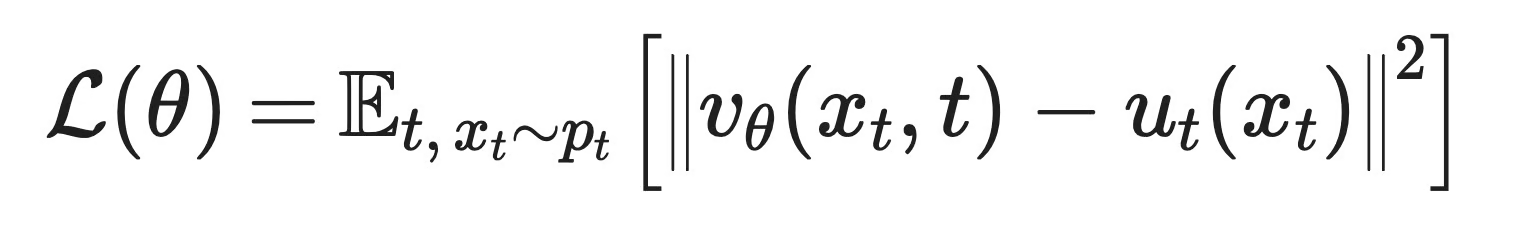
Hàm mất mát flow matching
Ý nghĩa của từng hạng tử:
v_θ(x_t, t): Vận tốc do mô hình dự đoán tại điểm x_t và thời điểm t
u_t(x_t): Vận tốc mục tiêu tại cùng điểm và thời điểm đó, dựa trên đường đi xác suất đã chọn
𝔼[...]: Kỳ vọng trên nhiều giá trị ngẫu nhiên của t và x_t
‖ · ‖^2: Bình phương sai khác giữa hai vận tốc - sai số bình phương trung bình
Việc suy diễn đầy đủ không phải trọng tâm ở đây. Quan trọng là mạng dự đoán một vector tại một điểm và thời điểm cụ thể, và bạn so sánh nó với mục tiêu đã biết. Thế thôi!
Đường đi xác suất biên nối toàn bộ phân phối nhiễu với toàn bộ phân phối dữ liệu không phải thứ bạn có thể viết ra trực tiếp.
Tính vận tốc mục tiêu tại một điểm cho trước nghĩa là phải xét mọi mẫu dữ liệu có thể tạo ra nó - một tích phân trên toàn bộ tập dữ liệu, không ai làm ở mỗi bước huấn luyện cả.
Conditional flow matching giải quyết bằng cách điều kiện hóa theo từng cặp mẫu thay vì toàn bộ đường đi. Thay vì tính trường vector cho toàn bộ đường biên, bạn chọn một điểm dữ liệu và một điểm nhiễu, rồi xây dựng một đường đi xác suất chỉ cho cặp đó. Khi bạn làm đường điều kiện này đơn giản, chẳng hạn dùng đường thẳng nối hai điểm, vận tốc mục tiêu có biểu thức dạng đóng có thể tính trực tiếp.
Huấn luyện mạng trên các vận tốc điều kiện đơn giản theo từng cặp, rồi lấy trung bình trên đủ nhiều cặp, sẽ cho bạn cùng một trường vector như mục tiêu biên bất khả thi kia. Bạn không bao giờ tính trực tiếp đường biên - thay vào đó, bạn xấp xỉ nó gián tiếp, từng đường điều kiện dễ tính một.
Phiên bản điều kiện này là thứ hầu như mọi người thực sự huấn luyện. Công thức biên làm cho phần toán học chặt chẽ, còn công thức điều kiện là cái hoạt động trong thực tế.
Diffusion và flow matching thường được so sánh vì một lý do chính đáng - phần lớn "mô hình diffusion" bạn biết nay chạy trên mục tiêu flow matching. Điều đó không có nghĩa flow matching thay thế diffusion. Nó có nghĩa diffusion hóa ra là một trường hợp cụ thể trong một khuôn khổ rộng hơn, và flow matching là phiên bản tổng quát của nó.
Bắt đầu từ thứ mỗi mạng dự đoán. Một mô hình diffusion dự đoán nhiễu. Với một mẫu có nhiễu và một bước thời gian, nó dự đoán phần nhiễu đã trộn vào, rồi loại bỏ nó, từng bước. Flow matching thay vào đó dự đoán vận tốc. Với một mẫu và một bước thời gian, nó dự đoán hướng và tốc độ mà mẫu đó nên di chuyển về phía phân phối dữ liệu.
Đường đi xác suất là nơi khác biệt lớn nhất giữa hai bên.
Các mô hình diffusion cố định sẵn một quá trình thêm nhiễu cụ thể, thường là thêm nhiễu Gaussian theo một lịch cố định, và mọi thứ khác phát sinh từ lựa chọn duy nhất đó. Trong flow matching, bạn chọn bất kỳ đường đi nào nối nhiễu với dữ liệu, và mục tiêu hoạt động giống nhau bất kể bạn chọn đường nào. Một đường kiểu Gaussian như diffusion là một lựa chọn. Một đường thẳng giữa nhiễu và dữ liệu là lựa chọn khác, và nó ảnh hưởng lớn đến tốc độ lấy mẫu.
Hai kiểu dự đoán này không khác nhau nhiều như vẻ ngoài.
Dự đoán nhiễu của diffusion và dự đoán vận tốc của flow matching là hai góc nhìn về cùng một đối tượng cơ bản, liên hệ qua score của phân phối tại mỗi thời điểm. Khác biệt nằm ở cách sinh mẫu. Lấy mẫu diffusion mặc định là ngẫu nhiên, nghĩa là mỗi bước khử nhiễu lại thêm một chút ngẫu nhiên (dù có biến thể tất định như DDIM). Flow matching thì ngược lại - công thức tự nhiên là một ODE tất định, nên cùng nhiễu đầu vào sẽ cho cùng đầu ra mỗi lần, và cũng có biến thể ngẫu nhiên ở phía này.
Lấy mẫu ở cả hai trường hợp đều là giải một phương trình vi phân theo từng bước, di chuyển từ nhiễu về dữ liệu.
Mô hình diffusion thường cần hàng chục bước trừ khi dùng bộ lấy mẫu nhanh hoặc chưng cất. Flow matching, đặc biệt khi huấn luyện trên đường thẳng, thường cần ít bước hơn nhiều mà không cần các mẹo đó - đường thẳng có vận tốc không đổi, dễ cho bộ giải bám theo chính xác hơn so với đường cong.
Bản thân đường đi là nơi flow matching vươn lên.
Các mô hình diffusion bị giới hạn bởi quá trình thêm nhiễu mà chúng được xây dựng từ đó. Flow matching xem đường đi là một lựa chọn thiết kế, và các lựa chọn khác nhau kéo theo đánh đổi khác nhau.
|
Các mô hình diffusion |
Flow matching |
|
|
Mạng dự đoán gì |
Nhiễu được thêm ở mỗi bước |
Vận tốc hướng về phân phối dữ liệu |
|
Đường đi xác suất |
Cố định bởi một quá trình thêm nhiễu cụ thể |
Tự do lựa chọn; đường thẳng phổ biến |
|
Đối tượng cơ bản |
Score của phân phối đã nhiễu |
Trường vector phụ thuộc thời gian, liên kết với score |
|
Quá trình sinh |
Mặc định ngẫu nhiên nhưng có biến thể tất định |
Mặc định tất định nhưng có biến thể ngẫu nhiên |
|
Số bước lấy mẫu |
Thường hàng chục nếu không dùng mẹo |
Thường ít hơn nhiều, nhất là với đường thẳng |
|
Lựa chọn đường đi |
Cố định bởi quá trình tiến |
Một lựa chọn thiết kế mở — diffusion là một trường hợp |
Flow matching so với mô hình diffusion
Diffusion không phải phương pháp duy nhất thường được so sánh với flow matching. Có ba phương pháp nữa bạn nên biết
Continuous normalizing flows xuất hiện trước, và flow matching nảy sinh trực tiếp từ các vấn đề khi huấn luyện chúng.
Continuous normalizing flow chính là kiểu mô hình mà flow matching tạo ra - một mạng định nghĩa phép biến đổi liên tục giữa các phân phối thông qua một ODE. Huấn luyện theo cách gốc nghĩa là giải ODE tiến và tính đúng xác suất cực đại ở mỗi bước, tức theo dõi cách phép biến đổi làm thay đổi mật độ xác suất trên đường đi. Việc tính toán đó tốn kém, và càng tệ hơn khi mạng lớn lên.
Flow matching tránh tất cả điều đó. Nó hồi quy trực tiếp lên vận tốc mục tiêu đã biết thay vì giải ODE và tính xác suất trong lúc huấn luyện. Không cần mô phỏng. Bạn vẫn thu được một continuous normalizing flow, chỉ là không phải trả cái giá huấn luyện trước đây để đạt được nó.
Score matching huấn luyện mạng dự đoán score - gradient của log mật độ xác suất - tại mỗi mức nhiễu. Đó là mục tiêu đằng sau các mô hình diffusion mà bạn đã biết.
Flow matching huấn luyện mạng dự đoán vận tốc. Hai đối tượng này có liên hệ toán học, nghĩa là dưới một số lựa chọn đường đi nhất định, bạn có thể chuyển đổi qua lại. Nhưng chúng biểu diễn những điều khác nhau. Score mô tả hình dạng của phân phối xác suất tại một thời điểm cố định. Vận tốc mô tả cách một mẫu nên di chuyển khi thời gian thay đổi.
Score matching hỏi về hình học. Flow matching hỏi về chuyển động.
Rectified flow là một lựa chọn cụ thể bên trong flow matching.
Flow matching cho phép bạn chọn bất kỳ đường đi xác suất nào nối nhiễu với dữ liệu. Rectified flow chọn một - đường thẳng, rồi tiến thêm một bước với thủ tục lặp gọi là "reflow" để làm thẳng các đường mà một mô hình đã học, sao cho mô hình vòng hai cần ít bước tích phân hơn khi sinh mẫu.
Đó là lý do hai thuật ngữ này thường xuất hiện cạnh nhau trong cùng bài báo. Stable Diffusion 3 và Flux đều dùng flow matching với lựa chọn đường gần với rectified flow. Nhưng coi flow matching và rectified flow là hoán đổi cho nhau thì bỏ lỡ điểm mấu chốt. Flow matching là khung tổng quát. Rectified flow là một đường đi bạn có thể chọn bên trong nó.
Flow matching hiện đang chạy trong một số hệ thống sinh mẫu lớn nhất ngoài đời thực.
Tất cả vì hàm mất mát hồi quy đơn giản để triển khai và mở rộng. Và vì đường đi là một lựa chọn thiết kế, các đội xây hệ thống hàng tỷ tham số có thể chọn đường cần ít bước lấy mẫu hơn, điều rất quan trọng khi mỗi bước tiêu tốn tài nguyên ở quy mô đó.
Từ nãy đến giờ là phần khái niệm. Giờ tôi sẽ minh họa cùng ý tưởng trên một tập dữ liệu 2D thực tế, đủ nhỏ để bạn thấy từng bước.
Phân phối nhiễu là Gaussian 2D chuẩn, tâm tại gốc tọa độ. Phân phối đích là ba cụm Gaussian sắp thành hình tam giác - đủ đơn giản để một mạng nhỏ học nhanh, nhưng đủ cấu trúc để bạn nhận ra nó học đúng hay chưa.
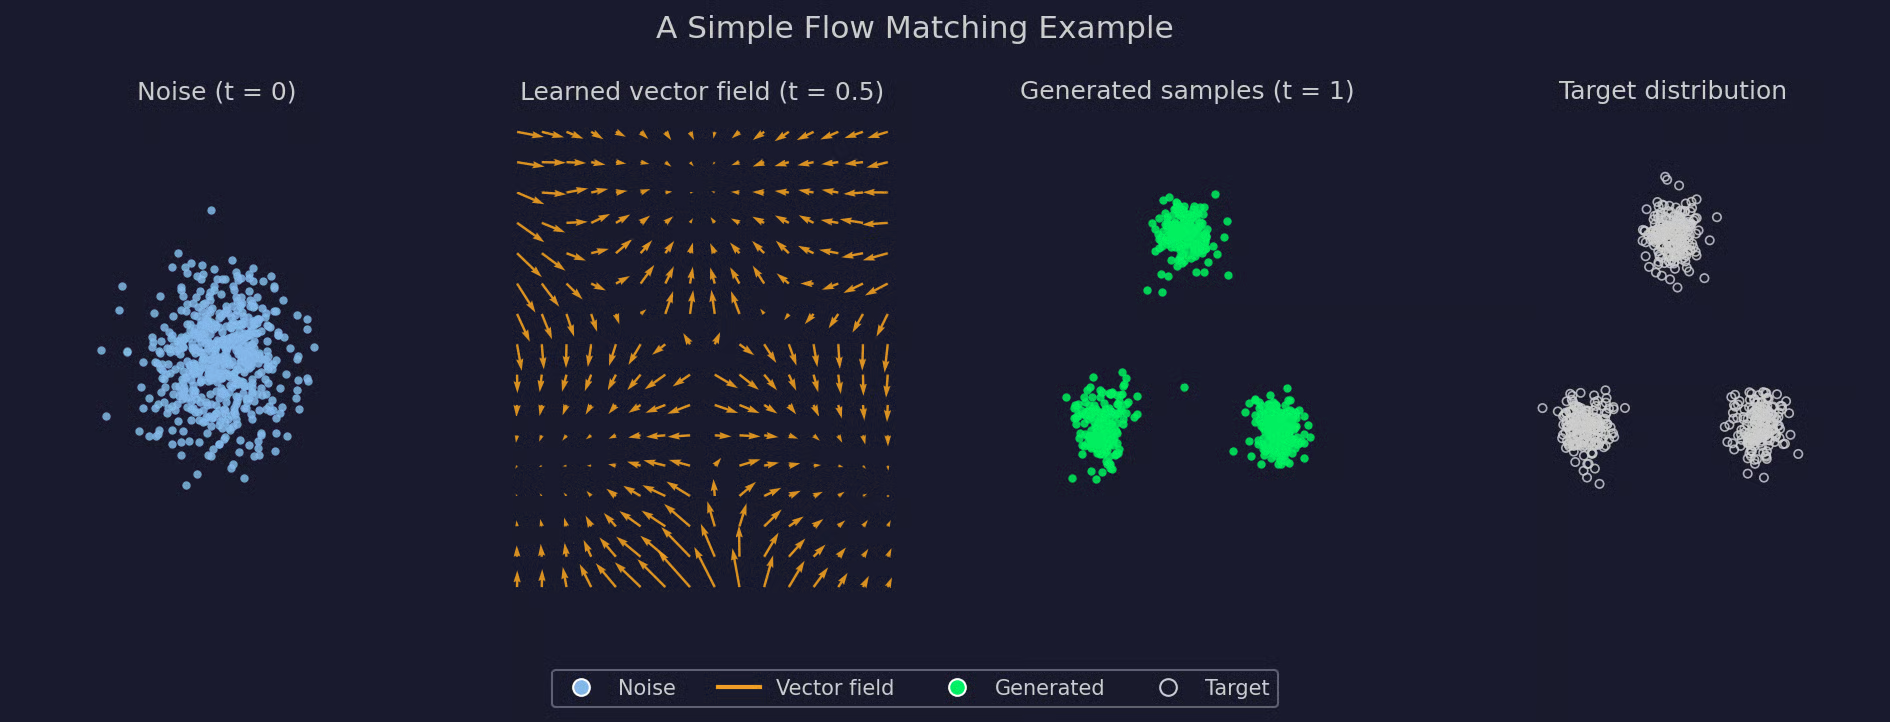
Ví dụ flow matching đơn giản
Khung đầu là nơi mọi mẫu bắt đầu - nhiễu rải rác vô cấu trúc. Khung thứ hai là bản thân trường vector, đánh giá trên lưới tại giữa quá trình huấn luyện. Lưu ý mũi tên đã chỉ về một trong ba cụm, từ lâu trước khi bất kỳ mẫu nào tới đó. Khung thứ ba cho thấy điều gì xảy ra khi bạn bắt đầu từ nhiễu mới và đi theo trường đó cho tới t = 1 - ba cụm hiện ra, khớp gần như hoàn hảo với khung thứ tư.
Không có gì ở đây vượt quá những gì các phần trước đã đề cập - một phân phối nguồn, một phân phối đích, một trường vector đã học, và một bộ giải ODE nối cả ba. Sang phần mã.
Dưới đây là một hiện thực PyTorch nhỏ cho cùng ví dụ, dùng cùng nguồn nhiễu và đích ba cụm.
Bắt đầu với hai phân phối và cách lấy mẫu từ chúng:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Bản thân mạng nhận một điểm và một bước thời gian, và dự đoán vận tốc:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Huấn luyện sẽ lấy mẫu một batch điểm nguồn, điểm đích và bước thời gian ở mỗi bước, rồi nội suy giữa hai điểm đầu và hồi quy về vận tốc thu được:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Sinh mẫu giải ODE đã học bằng tích phân Euler thuần túy. Bạn chỉ cần một vòng lặp đi từng bước nhỏ từ t = 0 tới t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`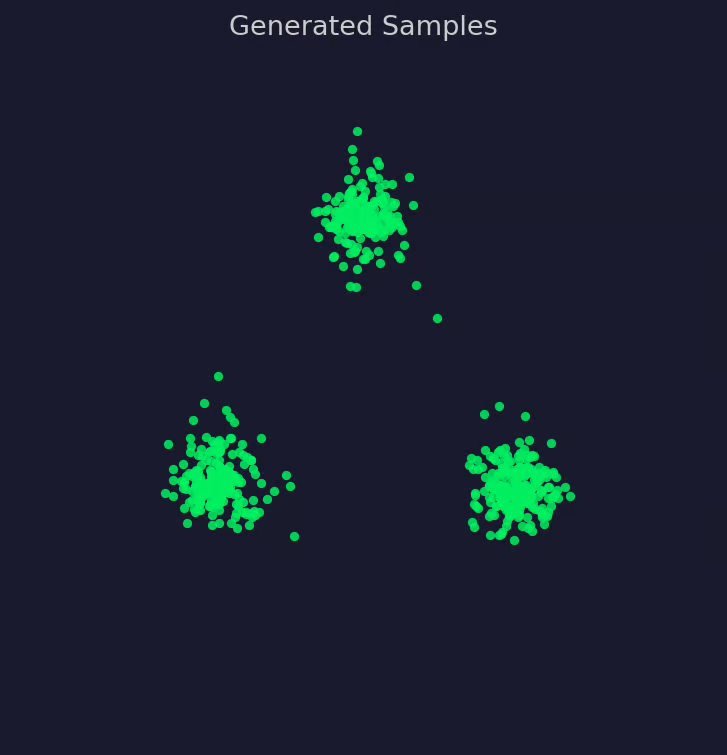
Minh họa các mẫu đã sinh
Và đó là toàn bộ pipeline! Lấy mẫu, nội suy, hồi quy, tích phân. Không có gì ở đây thay đổi nếu bạn dùng mạng lớn hơn, đường đi khác, hay dữ liệu nhiều chiều hơn - chỉ khác về quy mô.
Điều này không biến flow matching thành nâng cấp phổ quát so với diffusion. Đây là một đánh đổi, như mọi lựa chọn thiết kế khác.
Dưới đây là khi nào nó phù hợp và khi nào không.
Flow matching dạy một mô hình cách các mẫu nên di chuyển từ một phân phối đơn giản về phía phân phối dữ liệu. Mọi thứ khác tôi mô tả trong bài viết này tồn tại để biến ý tưởng đó thành có thể huấn luyện được.
Hai ý tưởng làm phần lớn công việc. Một đường đi xác suất nối nhiễu với dữ liệu qua chuỗi các phân phối trung gian. Một trường vector mô tả cách một mẫu nên di chuyển tại bất kỳ điểm nào trên đường đó, ở bất kỳ thời điểm nào. Mạng học trường vector đó, tức vận tốc, và sinh mẫu chỉ là đi theo dòng chảy từ nhiễu tới dữ liệu.
Không có gì tách rời khỏi những gì đi trước. Flow matching là cách các hệ hiện đại huấn luyện continuous normalizing flows mà không cần phép tính likelihood cũ, và các mô hình diffusion hóa ra là một trường hợp cụ thể của nó.
Nếu diffusion models, normalizing flows, hoặc AI sinh nói chung khiến bạn quan tâm, thì đây chính là những nội dung nên xem tiếp theo:
Học AI cùng DataCamp
Courses
Courses
Courses