Courses
AIを理解する
2時間
421.5K
新しい画像・動画モデルのたびに「flow matching」という言葉を目にするものの、何を指すのか分からないと感じたことはありませんか?
多くの解説は微分方程式に一気に踏み込みますし、あるいは「拡散の改良版」とだけ説明します。しかし、それではモデルが何を学ぶのかが見えてきません。Stable Diffusion 3 と Flux はどちらも flow matching を採用しており、古典的な拡散が数十ステップ必要とするところを、数ステップで画像を生成します。
発想はシンプルです。個々の例を学習するのではなく、任意のサンプルに対して「どの方向へ、どの速さで動けばよいか」を教える速度場を学習します。この直観が分かれば、学習過程や背後の数理、拡散との関係も腑に落ちます。
本記事では、flow matching の直観、学習方法、数式(やさしく)、そして拡散モデルとの比較までを順を追って解説します。
画像系AIが初めてであれば、こちらの2026年版・注目のVision Languageモデル10選もどうぞ。視覚的推論、画像解析、コンピュータビジョンの最新モデルを紹介しています。
Flow matching は「学習目標(目的関数)」であり、モデルのアーキテクチャではありません。
この区別は重要です。トランスフォーマーなど、ほぼあらゆるネットワークと組み合わせられます。flow matching を特徴づけるのはネットワークの形ではなく、「ネットワークが何を予測するように学習されるか」です。
学習するのは時間に依存するベクトル場です。平易に言えば、ソース分布からターゲット分布へと進む経路の各地点で、サンプルがどの方向へ、どの速さで動くべきかを教える関数です。連続正規化フローをこの方法で学習すると、単純な分布を複雑な分布へと段階的に変換するモデルが得られます。
直観は次の4点に集約できます。
視覚的なイメージで言うと、秩序のない粒子の雲があります。flow matching は各粒子に「進むべき方向と速さ」を正確に教え、雲全体が時間とともに構造化されたパターン(ターゲット分布の形)へと落ち着くようにします。
これを画像データに適用した場合、「構造化されたパターン」とは、ランダムノイズではなく一貫した写真のことです。
学習と生成は別フェーズです。この2つを同一視すると混乱のもとになります。
学習時には次のことを行います。
t を0から1の間でランダムに選ぶt に従ってデータ点とノイズサンプルを合成するt に持つべき方向と速さを求める生成ではデータ点は不要です。
ノイズから始め、学習済みのベクトル場を時間方向に少しずつ積分し、データ分布からのサンプルに到達するまで進めます。
つまり、学習では速度を予測し、生成ではその速度に従います。
flow matching の目的関数を支える中心概念はベクトル場と確率経路の2つです。これらが分かれば、次節の損失関数も理解できます。
ベクトル場はネットワークが予測する対象です。空間の任意の点・任意の時点で、データ分布に近づくためにサンプルが取るべき方向と速さを返します。
たとえば川の中に立っていることを想像してください。立っている場所ごと、時々刻々で流れは向きも強さも異なります。ベクトル場はそれと同じで、空間のあらゆる点・あらゆる時刻に「向き」と「速さ」を割り当てます。
確率経路とは、ノイズからデータへ向かう途中でサンプルが通過する分布の系列です。t = 0 ではソース分布(通常はガウスノイズ)からサンプリングし、t = 1 ではターゲットのデータ分布からサンプリングします。その間はすべて中間分布であり、確率経路はそれらがどのように移り変わるかを記述します。
ベクトル場と確率経路は不可分です。ベクトル場はサンプルを確率経路に沿って中間分布から次の分布へと動かし、最終的にデータ分布へ到達させます。
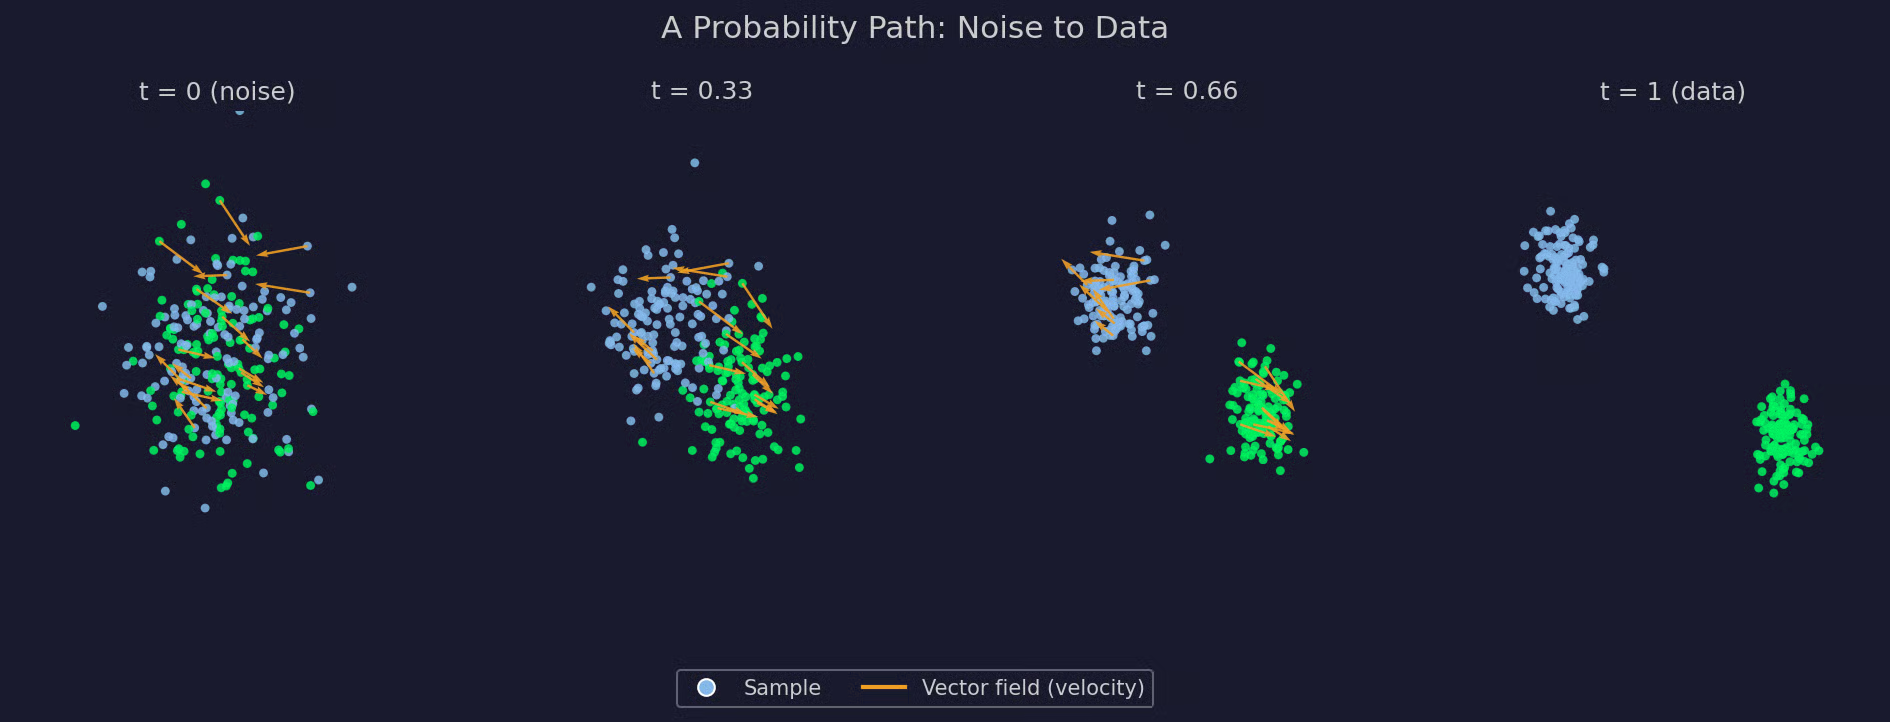
確率経路の概念図
flow matching の目的関数は、ベクトル場と確率経路を1つの回帰損失にまとめます。
各学習ステップで2つの速度を比較します。1つ目は目標速度で、選んだ確率経路に沿って、その点でサンプルが持つべき方向と速さです。2つ目はモデル予測の速度で、同じ点と時刻に対するネットワークの推定です。学習ではこの2つができるだけ一致するようにします。
損失関数は次のとおりです。
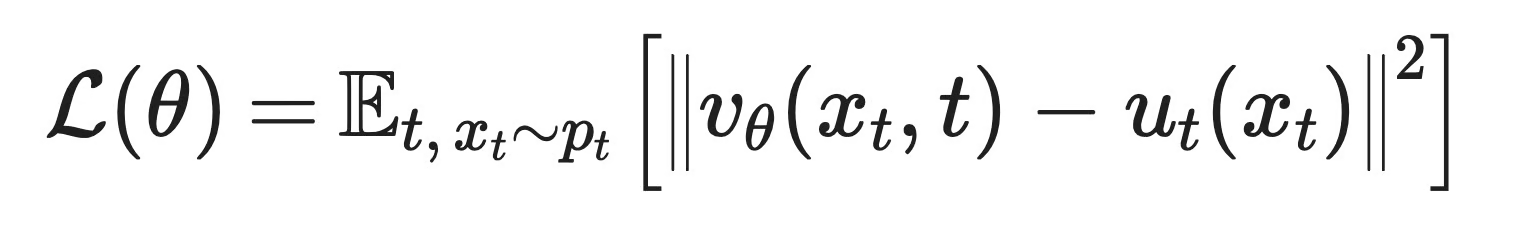
Flow matching の損失関数
各記号の意味は次のとおりです。
v_θ(x_t, t): 点 x_t と時刻 t におけるモデル予測の速度
u_t(x_t): 選んだ確率経路に基づく、同じ点と時刻での目標速度
𝔼[...]: t と x_t の多数のランダム値にわたる平均
‖ · ‖^2: 2つの速度の二乗誤差(平均二乗誤差)
完全な導出はここでは本質ではありません。重要なのは、ネットワークが「ある時刻・ある1点での単一のベクトル」を予測し、それを既知の目標と比較するだけ、という点です。
完全なノイズ分布から完全なデータ分布へとつなぐ周辺(マージナル)確率経路は、直接書き下せるものではありません。
ある点での目標速度を計算するには、その点を生みうるあらゆるデータサンプルを考慮する必要があり、データセット全体にわたる積分になります。毎ステップで計算する類のものではありません。
条件付き flow matching は、周辺経路全体ではなく個々のサンプルに条件づけることでこれを解決します。ベクトル場を周辺経路全体に対して求める代わりに、単一のデータ点と単一のノイズ点を選び、そのペア専用の確率経路を構成します。その条件付き経路を単純に(例えば2点を直線で結ぶ)すれば、目標速度は閉形式で計算できます。
このような単純なペアごとの条件付き速度を十分な数で平均するように学習すれば、扱いづらい周辺目的から得られるのと同じベクトル場に到達します。周辺経路を直接は計算せず、容易な条件付き経路を一つずつ積み上げて近似するわけです。
実際にほとんどの人が学習しているのはこの条件付きのほうです。周辺形式は数理の基礎を与え、条件付き形式が実運用で機能します。
拡散と flow matching が比較され続けるのには理由があります。現在よく知られた「拡散モデル」の多くが、いまや flow matching の目的関数で学習されているからです。これは flow matching が拡散を置き換えたという意味ではありません。拡散はより大きな枠組みの中の一例であり、flow matching はその一般形だということです。
まず、各ネットワークが何を予測するか。拡散モデルは「ノイズ」を予測します。ノイズまみれのサンプルと時刻が与えられると、混入したノイズを推定し、それを一歩ずつ取り除きます。一方、flow matching は「速度」を予測します。サンプルと時刻が与えられると、データ分布へ向かう方向と速さを予測します。
両者の最大の違いは確率経路です。
拡散モデルは前もって特定のノイズ付加過程(多くは固定スケジュールでガウスノイズを加える)を決め、それにすべてが従います。flow matching では、ノイズからデータを結ぶ任意の経路を選べ、どの経路でも同じ目的関数で学習できます。拡散風のガウス経路も選べますし、ノイズとデータを直線で結ぶ経路も選べます。後者はサンプリング速度に大きく効きます。
もっとも、この2つの予測は見た目ほど異なるわけではありません。
拡散モデルのノイズ予測と flow matching の速度予測は、各時点の分布のスコアを介して同じ基底対象に結びついています。違いは生成の仕方です。拡散のサンプリングはデフォルトで確率的で、各ステップでわずかなランダム性を再注入します(DDIM のような決定論的変種もあります)。flow matching は逆で、自然な定式化は決定論的な ODE です。つまり同じ初期ノイズからは毎回同じ出力が得られ(こちらにも確率的変種はあります)、という違いがあります。
どちらもサンプリングは微分方程式をステップごとに解き、ノイズからデータへ進むという点では同じです。
拡散モデルは高速サンプラーや蒸留を使わなければ、しばしば数十ステップを要します。flow matching は、とくに直線経路で学習すると、そのような工夫なしにステップ数が大幅に減る傾向があります。直線経路では速度が一定になり、曲がった経路よりも数値解法が正確に追従しやすいからです。
経路という設計自由度こそが、flow matching の強みです。
拡散モデルは定められたノイズ付加過程に縛られます。flow matching は経路を設計選択とみなし、選択ごとに異なるトレードオフが得られます。
|
拡散モデル |
Flow matching |
|
|
ネットワークが予測するもの |
各ステップで加えられたノイズ |
データ分布へ向かう速度 |
|
確率経路 |
特定のノイズ付加過程で固定 |
自由に選択可能。直線経路が一般的 |
|
基底となる対象 |
ノイズ付き分布のスコア |
時間依存のベクトル場(スコアと関連) |
|
生成 |
標準では確率的(決定論的変種もあり) |
標準では決定論的(確率的変種もあり) |
|
サンプリングのステップ数 |
工夫なしではしばしば数十 |
少ない傾向、特に直線的な経路で |
|
経路の選択 |
順方向過程で固定 |
設計選択の自由 — 拡散はその一例 |
拡散モデルとの比較における Flow matching
比較対象は拡散だけではありません。知っておきたい関連手法が3つあります。
連続正規化フローが先にあり、flow matching はその学習上の課題から直接生まれました。
連続正規化フローとは、ODE を介して分布間の連続変換を定義するモデルで、flow matching が生み出すタイプのモデルです。従来法での学習は、ODE を順方向に解きつつ、各ステップで厳密な尤度を計算し、変換が確率密度をどう変えるかを追跡する必要がありました。これは計算負荷が高く、ネットワークが大きくなるほど悪化します。
flow matching はそれらを避けます。ODE を解いたり尤度を計算したりせず、既知の目標速度への回帰を直接行います。シミュレーションは不要です。最終的に得られるのは同じ連続正規化フローですが、従来の学習コストを払わずに到達できます。
スコアマッチングは、各ノイズレベルで対数確率密度の勾配(スコア)を予測するようネットワークを学習させます。既存の拡散モデルの目的関数がこれです。
flow matching は速度を予測します。両者は数学的に関係しており、ある種の経路選択のもとでは相互変換が可能です。しかし意味するところは異なります。スコアは、ある時点での確率分布の形状(幾何)を記述します。速度は、時間とともにサンプルがどう動くべきか(運動)を記述します。
スコアマッチングが問うのは幾何、flow matching が問うのは運動です。
Rectified Flow は flow matching 内の特定の選択肢です。
flow matching ではノイズからデータをつなぐ任意の確率経路を選べます。Rectified Flow は直線経路を選び、さらに「reflow」と呼ばれる反復手順で、学習済みモデルがすでに学んだ経路をまっすぐに整えます。これにより、2巡目のモデルは生成時の積分ステップをさらに減らせます。
このため論文では両者が並んで登場します。Stable Diffusion 3 と Flux は、Rectified Flow に近い経路選択を備えた flow matching を使っています。ただし両者を同一視すると本質を見誤ります。flow matching は枠組みであり、Rectified Flow はその中の一つの経路選択です。
flow matching は、いまや本番稼働する大規模生成システムの中核でも使われています。
いずれも、回帰損失が実装とスケールの両面で単純であることが背景にあります。さらに経路は設計選択なので、数十億パラメータ級のシステムでも、より少ないサンプリングステップで済む経路を選べます。この規模では各ステップが計算コストに直結するため、効果が大きいのです。
ここまでは概念でした。同じ発想を、各ステップが可視化できる小さな2次元データセットで動かしてみます。
ノイズ分布は原点中心の標準2次元ガウス。ターゲット分布は三つのガウスクラスタが三角形状に配置されたものです。小さなネットワークでも素早く学習でき、かつ正しく学べたか判別しやすい構造です。
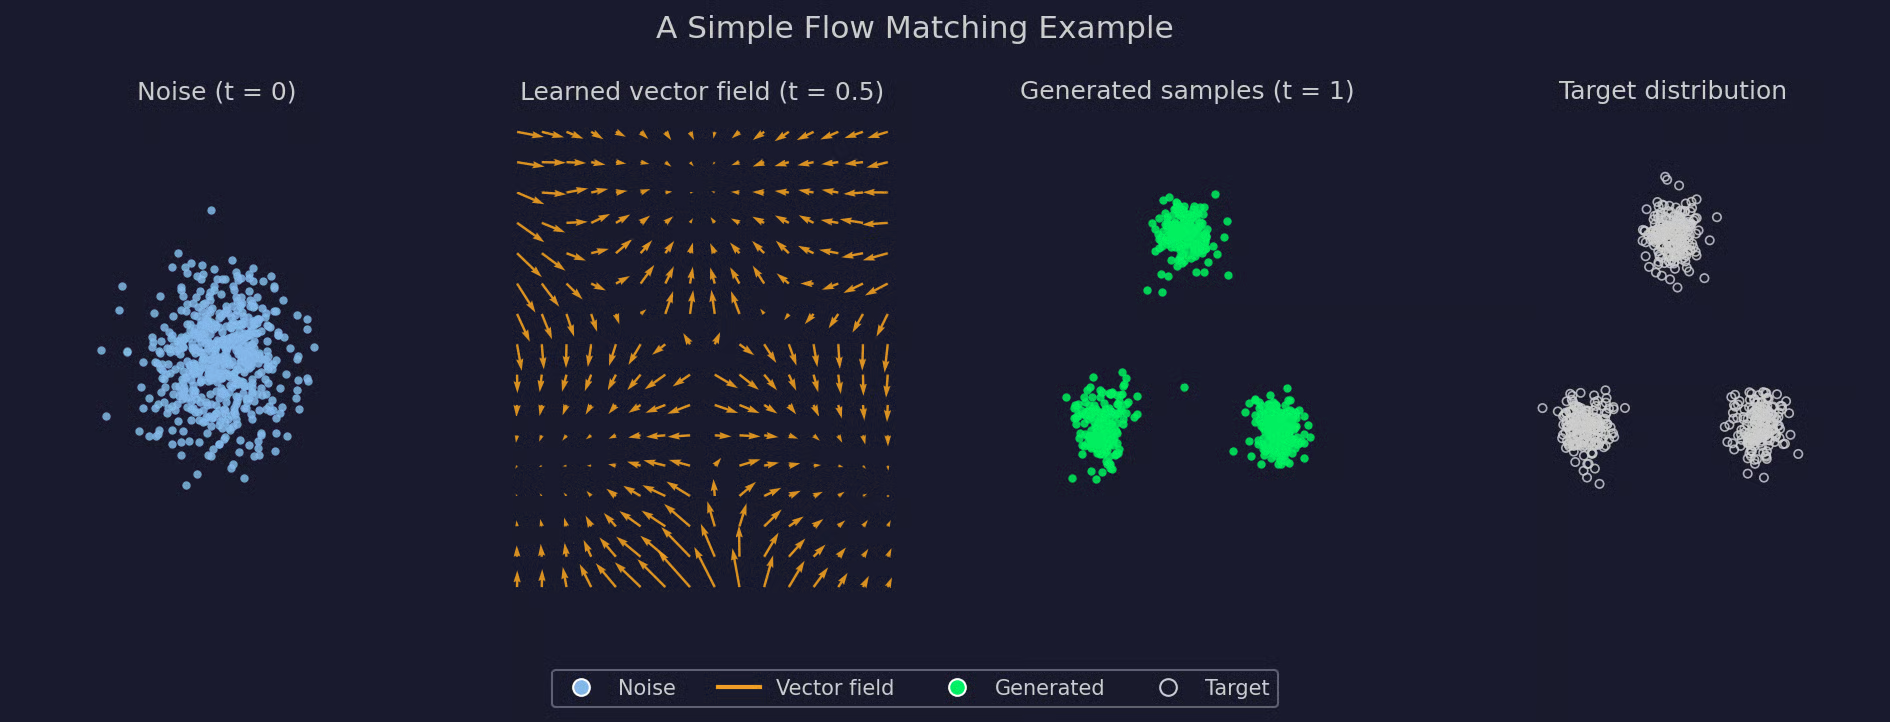
シンプルな flow matching の例
最初のパネルは全サンプルの出発点——構造のない散在ノイズです。2番目は学習中間時点のグリッド上で評価したベクトル場で、矢印がすでに三つのクラスタの一つへ向いているのが分かります。3番目は新たなノイズから開始して t = 1 までこの場に従った結果で、4番目とほぼ一致する三つのクラスタが現れます。
必要なのは、ソース分布・ターゲット分布・学習済みベクトル場・それらを結ぶ ODE ソルバ、というこれまでに述べた要素だけです。ではコードへ。
以下は同じ例を PyTorch で小さく実装したものです。ノイズ源と三つのクラスタのターゲットを用います。
まず二つの分布とサンプリング方法を定義します。
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
ネットワークは点と時刻を受け取り、速度を予測します。
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
学習では各ステップでソース点・ターゲット点・時刻のバッチをサンプリングし、前二者を補間して、その速度に回帰します。
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
生成では、学習した ODE を単純なオイラー積分で解きます。t = 0 から t = 1 まで小刻みに進めるループがあれば十分です。
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`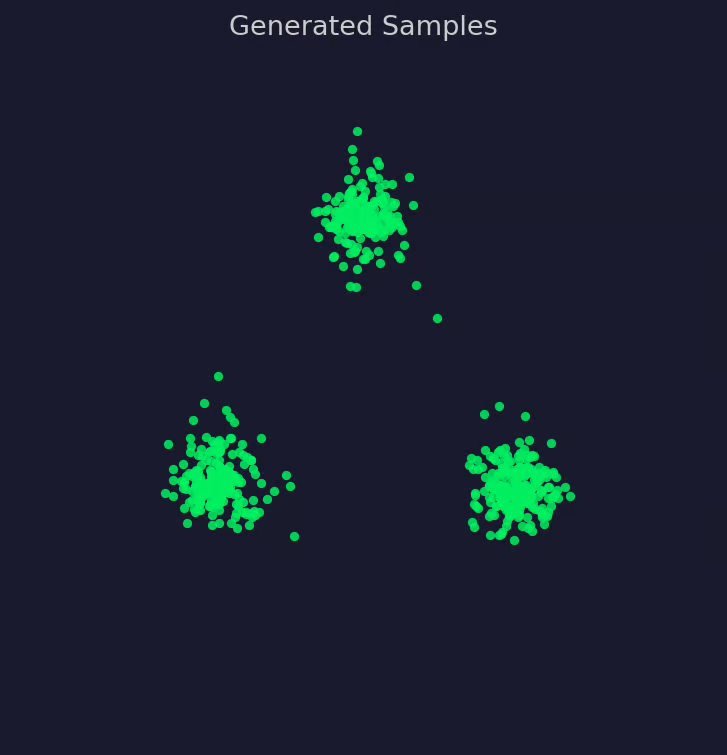
生成サンプルの可視化
以上がパイプライン全体です。サンプル、補間、回帰、積分。ネットワークを大きくしても、経路を変えても、高次元データにしても、変わるのはスケールだけです。
だからといって flow matching が拡散の万能上位互換になるわけではありません。設計選択としてのトレードオフがあります。
向いている場面とそうでない場面を挙げます。
flow matching は、単純な分布からデータ分布へサンプルがどう動くべきかをモデルに教えます。本記事の他の要素は、その一つの発想を学習可能にするための仕組みです。
要となるのは2つ。確率経路は、ノイズからデータへと中間分布の列で結ぶもの。ベクトル場は、経路上の任意の点・任意の時刻でサンプルがどう動くべきかを記述します。ネットワークはこのベクトル場(速度)を学び、生成はその流れに従ってノイズからデータへ進むだけです。
これは従来と無関係な新奇性ではありません。flow matching は、古い尤度計算なしで連続正規化フローを学習する方法であり、拡散モデルはその特別な一例なのです。
拡散モデル、正規化フロー、あるいは生成AI全般に関心があれば、次はこちらをご覧ください。
DataCamp で AI を学ぶ
Courses
Courses
Courses