course
Wprowadzenie do sztucznej inteligencji
2 godz.
421.5K
Widzisz termin „flow matching” przy każdym nowym modelu obrazów i wideo i nie masz pojęcia, o co w nim chodzi?
Większość wyjaśnień od razu wchodzi w równania różniczkowe albo przedstawia to jako „dyfuzję, tylko lepszą”. Żadne nie mówi, czego model się uczy. Stable Diffusion 3 i Flux działają na flow matchingu i generują obrazy w kilku krokach, podczas gdy klasyczna dyfuzja potrzebuje ich dziesiątek.
Ogólny pomysł jest taki: zamiast uczyć się pojedynczych przykładów, model uczy się pola prędkości, które mówi każdej próbce, w którym kierunku i jak szybko ma się poruszać. Gdy to zrozumiesz, proces treningu, stojąca za nim matematyka i związek z dyfuzją staną się jasne.
W tym artykule przeprowadzę cię przez intuicję stojącą za flow matchingiem, sposób jego trenowania, matematykę (w lekkiej formie) oraz porównanie z modelami dyfuzyjnymi.
Jeśli dopiero zaczynasz z AI dla danych obrazowych, przeczytaj nasz Top 10 Vision Language Models w 2026 roku, aby poznać najnowsze modele do rozumowania wizualnego, analizy obrazu i computer vision.
Flow matching to cel treningowy, a nie architektura modelu.
To rozróżnienie jest ważne, bo można go połączyć z transformatorem lub prawie dowolną inną siecią – o flow matchingu decyduje to, czego sieć uczy się przewidywać, a nie to, jak wygląda.
Uczy się przewidywać zależne od czasu pole wektorowe. Po ludzku: to funkcja, która mówi, w którym kierunku i jak szybko próbka powinna się poruszać w każdym punkcie swojej drogi od rozkładu źródłowego do docelowego. Gdy w ten sposób trenujesz continuous normalizing flows, dostajesz model, który krok po kroku zamienia prosty rozkład w złożony.
Lubię rozbić tę intuicję na cztery idee:
Jeśli jesteś wzrokowcem, wyobraź sobie chmurę rozproszonych cząstek bez ładu. Flow matching uczy każdą cząstkę, w którym kierunku i jak szybko ma się poruszać, aby cała chmura z czasem ułożyła się w uporządkowany wzór (kształt twojego rozkładu docelowego).
Na zbiorze obrazów „uporządkowany wzór” oznacza spójne zdjęcie zamiast losowego szumu.
Trening i generowanie to dwie oddzielne fazy i często mylą się, gdy ktoś uznaje, że to to samo.
Podczas treningu:
t między 0 a 1t, według ścieżki prawdopodobieństwa łączącej obat, na podstawie wybranej ścieżkiGenerowanie nie potrzebuje punktu danych.
Zaczynasz od szumu i całkujesz wyuczone pole wektorowe w przód w czasie, małymi krokami, aż dojdziesz do próbki z rozkładu danych.
I to cała idea – podczas treningu przewidujesz prędkość, a podczas generowania za nią podążasz.
Dwie idee stoją za większością pracy w flow matchingu – pola wektorowe i ścieżki prawdopodobieństwa. Gdy je zrozumiesz, funkcja straty w następnej sekcji będzie miała sens.
Pole wektorowe to to, co przewiduje sieć. W dowolnym punkcie przestrzeni i momencie czasu daje kierunek i szybkość – sposób, w jaki próbka w tym punkcie powinna się poruszyć, by zbliżyć się do rozkładu danych.
Na przykład wyobraź sobie, że stoisz w rzece. Gdziekolwiek stoisz, prąd pcha cię w pewien sposób, a siła i kierunek zależą od dokładnej pozycji i chwili w czasie. Pole wektorowe robi to samo dla twoich próbek – przypisuje kierunek i szybkość każdemu punktowi w przestrzeni, w każdej chwili.
Ścieżka prawdopodobieństwa to sekwencja rozkładów, przez które przechodzi próbka w drodze od szumu do danych. Dla t = 0 próbkujesz z rozkładu źródłowego, zwykle szumu Gaussa. Dla t = 1 próbkujesz z docelowego rozkładu danych. Pomiędzy tymi punktami są rozkłady pośrednie i ścieżka prawdopodobieństwa opisuje, jak jeden przechodzi w kolejny.
Pole wektorowe i ścieżka prawdopodobieństwa są bezpośrednio połączone, bo pole wektorowe przesuwa próbki wzdłuż ścieżki prawdopodobieństwa – od jednego rozkładu pośredniego do następnego – aż dotrą do rozkładu danych.
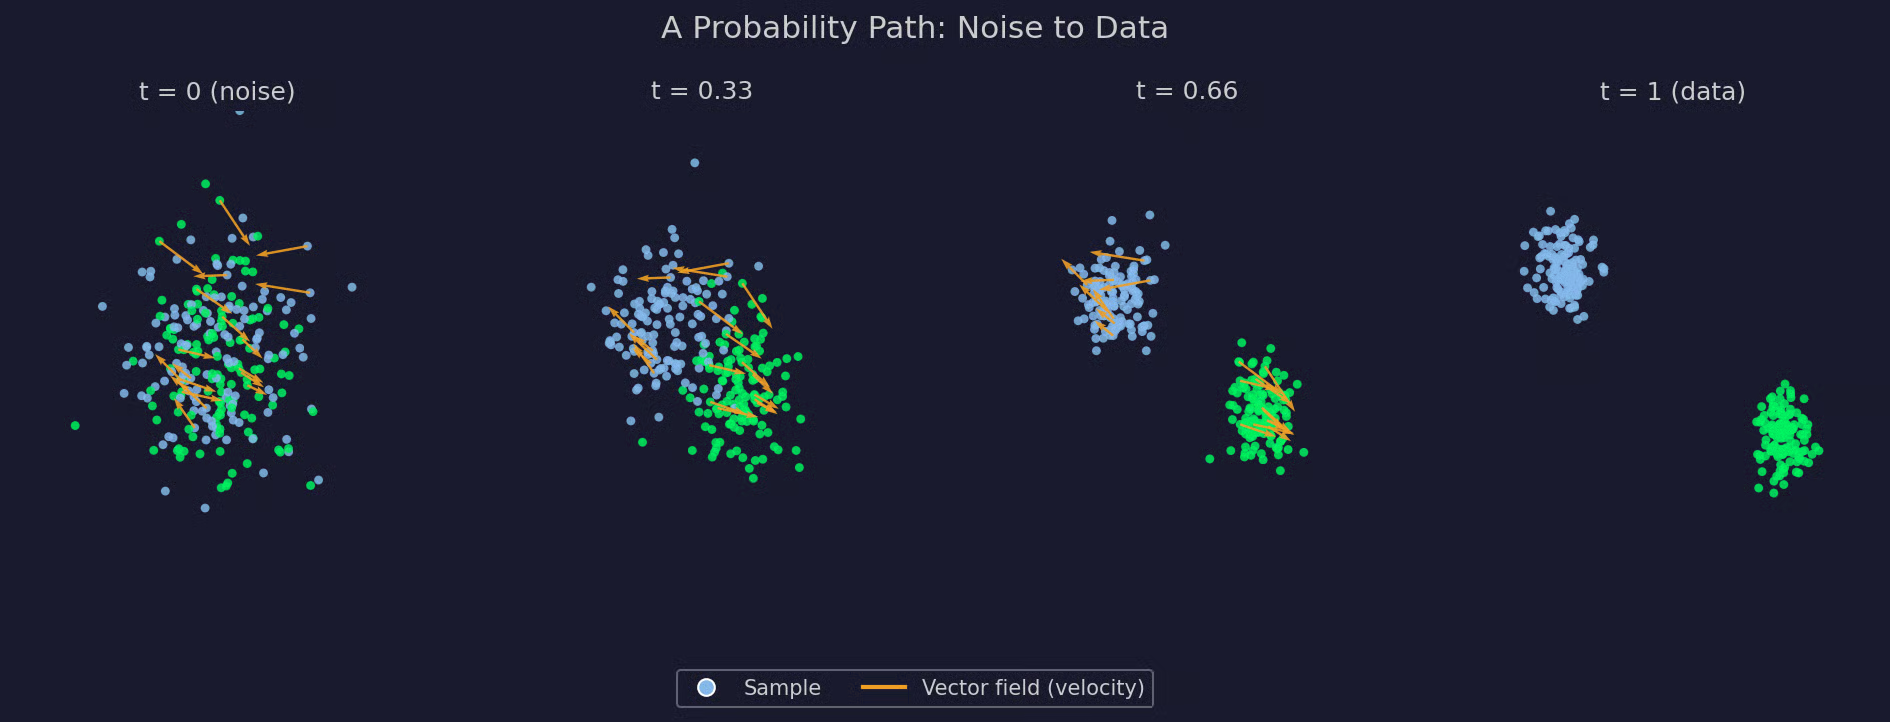
Schemat ścieżki prawdopodobieństwa
Cel flow matchingu łączy pola wektorowe i ścieżki prawdopodobieństwa w jedną stratę regresyjną.
Każdy krok treningu porównuje dwie prędkości. Pierwsza to prędkość docelowa – kierunek i szybkość, z jaką próbka powinna się poruszać wzdłuż wybranej ścieżki prawdopodobieństwa. Druga to prędkość przewidziana przez model – jego przypuszczenie co do tego samego kierunku i szybkości na podstawie bieżącej próbki i czasu. Trening sprawia, że obie jak najbardziej do siebie pasują.
Oto funkcja straty:
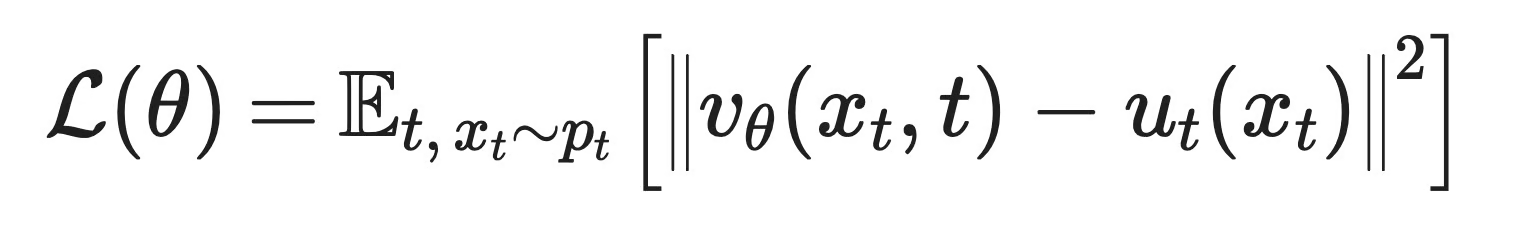
Funkcja straty w flow matchingu
Co oznacza każdy składnik:
v_θ(x_t, t): Prędkość przewidziana przez model w punkcie x_t i chwili t
u_t(x_t): Prędkość docelowa w tym samym punkcie i czasie, wyznaczona przez wybraną ścieżkę prawdopodobieństwa
𝔼[...]: Średnia po wielu losowych wartościach t i x_t
‖ · ‖^2: Różnica kwadratów obu prędkości – zwykły błąd średniokwadratowy
Pełna dedukcja nie jest tu najważniejsza. Liczy się to, że sieć przewiduje jeden wektor w jednym punkcie i czasie, a ty porównujesz go z znanym celem. I tyle!
Brzegowa ścieżka prawdopodobieństwa łącząca pełny rozkład szumu z pełnym rozkładem danych nie jest czymś, co da się bezpośrednio zapisać.
Wyznaczenie prędkości docelowej w danym punkcie wymaga uwzględnienia każdej próbki danych, która mogła go wygenerować – to całka po całym zbiorze danych, której nikt nie liczy na każdym kroku treningu.
Conditional flow matching rozwiązuje to, warunkując na pojedynczych próbkach zamiast na pełnej ścieżce. Zamiast liczyć pole wektorowe dla całej ścieżki brzegowej, wybierasz jeden punkt danych i jeden punkt szumu, a następnie konstruujesz ścieżkę prawdopodobieństwa tylko dla tej pary. Gdy uczynisz tę ścieżkę prostą – na przykład linią prostą między punktami – prędkość docelowa ma postać zamkniętą, którą można policzyć wprost.
Trenowanie sieci na takich prostych, warunkowych prędkościach dla par i uśrednienie po wystarczająco wielu parach daje to samo pole wektorowe, co niewykonalny cel brzegowy. Nigdy bezpośrednio nie liczysz ścieżki brzegowej – zamiast tego przybliżasz ją pośrednio, po jednej łatwej ścieżce warunkowej naraz.
Ta wersja warunkowa to ta, którą prawie wszyscy faktycznie trenują. Formulacja brzegowa porządkuje matematykę, ale to warunkowa działa w praktyce.
Dyfuzję i flow matching porównuje się z dobrego powodu – większość „modeli dyfuzyjnych”, które znasz, działa dziś na celu flow matchingu. To nie znaczy, że flow matching zastąpił dyfuzję. Oznacza to, że dyfuzja okazała się szczególnym przypadkiem w większym frameworku, a flow matching jest jego uogólnieniem.
Zacznijmy od tego, co przewiduje każda sieć. Model dyfuzyjny przewiduje szum. Dla zaszumionej próbki i kroku czasowego przewiduje domieszkany szum i usuwa go krok po kroku. Flow matching zamiast tego przewiduje prędkość. Dla próbki i kroku czasowego przewiduje kierunek i szybkość ruchu próbki w stronę rozkładu danych.
Najbardziej różnią się ścieżką prawdopodobieństwa.
Modele dyfuzyjne z góry ustalają konkretny proces zaszumiania, zwykle dodając szum Gaussa według stałego harmonogramu, i wszystko inne wynika z tego jednego wyboru. W flow matchingu wybierasz dowolną ścieżkę łączącą szum z danymi, a cel działa tak samo, niezależnie od wyboru. Dyfuzyjna, gaussowska ścieżka to jedna opcja. Linia prosta między szumem a danymi to inna – i ma duże znaczenie dla szybkości próbkowania.
Te dwie predykcje nie są aż tak różne, jak wyglądają.
Przewidywanie szumu w dyfuzji i przewidywanie prędkości w flow matchingu to dwa spojrzenia na ten sam obiekt, połączone przez score rozkładu w każdym punkcie czasu. Różnią się sposobem generowania. Próbkowanie w dyfuzji jest domyślnie stochastyczne – każdy krok odszumiania dodaje odrobinę losowości (choć istnieją warianty deterministyczne, jak DDIM). Flow matching działa odwrotnie – jego naturalna formulacja to deterministyczne ODE, więc ten sam szum początkowy daje ten sam wynik za każdym razem, choć istnieją też warianty stochastyczne.
W obu przypadkach próbkowanie oznacza rozwiązywanie równania różniczkowego krok po kroku, przechodząc od szumu do danych.
Modele dyfuzyjne zwykle potrzebują dziesiątek kroków, chyba że użyjesz szybkich samplerów lub destylacji. Flow matching, zwłaszcza trenowany na ścieżkach prostych, potrzebuje ich znacznie mniej bez tych zabiegów – prosta ścieżka ma stałą prędkość, co solverowi ODE dużo łatwiej śledzić dokładnie niż krzywą.
To wybór ścieżki daje flow matchingowi przewagę.
Modele dyfuzyjne są ograniczone procesem zaszumiania, z którego wynikają. Flow matching traktuje ścieżkę jako decyzję projektową, a różne wybory mają różne kompromisy.
|
Modele dyfuzyjne |
Flow matching |
|
|
Co przewiduje sieć |
Szum dodany na każdym kroku |
Prędkość w stronę rozkładu danych |
|
Ścieżka prawdopodobieństwa |
Ustalona przez konkretny proces zaszumiania |
Wybierana dowolnie; często linie proste |
|
Obiekt bazowy |
Score zaszumionego rozkładu |
Zależne od czasu pole wektorowe, powiązane ze score |
|
Generowanie |
Domyślnie stochastyczne, ale istnieją warianty deterministyczne |
Domyślnie deterministyczne, ale istnieją warianty stochastyczne |
|
Kroki próbkowania |
Często dziesiątki bez dodatkowych trików |
Często znacznie mniej, zwłaszcza przy prostszych ścieżkach |
|
Wybór ścieżki |
Zdeterminowany procesem „forward” |
Otwarcie projektowy wybór — dyfuzja to jedna instancja |
Flow matching w porównaniu z modelami dyfuzyjnymi
Dyfuzja to nie jedyna metoda porównywana z flow matchingiem. Są jeszcze trzy, o których warto wiedzieć
Najpierw były continuous normalizing flows, a flow matching wyrósł bezpośrednio z problemów z ich trenowaniem.
Continuous normalizing flow to rodzaj modelu, który powstaje z flow matchingu – sieć definiująca ciągłą transformację między rozkładami poprzez ODE. Oryginalne trenowanie wymagało rozwiązywania tego ODE i liczenia dokładnej wiarygodności na każdym kroku, co oznacza śledzenie, jak transformacja zmienia gęstość prawdopodobieństwa po drodze. To kosztowne obliczeniowo i pogarsza się wraz ze wzrostem sieci.
Flow matching tego unika. Regresuje bezpośrednio do znanej prędkości docelowej zamiast rozwiązywać ODE i liczyć wiarygodności podczas treningu. Nie ma potrzeby symulacji. Nadal kończysz z continuous normalizing flow, tylko bez wcześniejszego kosztu treningu.
Score matching trenuje sieć do przewidywania score – gradientu logarytmu gęstości prawdopodobieństwa – na każdym poziomie szumu. To cel stojący za znanymi ci modelami dyfuzyjnymi.
Flow matching trenuje sieć do przewidywania prędkości. Obiekty te są matematycznie powiązane, więc przy pewnych wyborach ścieżki można jeden przekształcić w drugi. Ale reprezentują różne rzeczy. Score opisuje kształt rozkładu prawdopodobieństwa w ustalonej chwili. Prędkość opisuje, jak próbka powinna się poruszać, gdy czas się zmienia.
Score matching pyta o geometrię. Flow matching pyta o ruch.
Rectified flow to konkretny wybór wewnątrz flow matchingu.
Flow matching pozwala wybrać dowolną ścieżkę prawdopodobieństwa łączącą szum z danymi. Rectified flow wybiera jedną – linie proste – a następnie idzie krok dalej procedurą iteracyjną „reflow”, która prostuje ścieżki już wyuczonego modelu, aby model z drugiej rundy potrzebował jeszcze mniej kroków całkowania podczas generowania.
Dlatego te terminy pojawiają się obok siebie w tych samych pracach. Stable Diffusion 3 i Flux używają flow matchingu z wyborem ścieżki zbliżonym do rectified flow. Ale traktowanie flow matchingu i rectified flow jako zamiennych mija się z celem. Flow matching to framework. Rectified flow to jedna z możliwych ścieżek w jego obrębie.
Flow matching działa dziś w jednych z największych systemów generatywnych w produkcji.
To wszystko dlatego, że strata regresyjna jest prosta w implementacji i skalowaniu. A ponieważ ścieżka to wybór projektowy, zespoły budujące systemy liczone w miliardach parametrów mogą wybrać taką, która wymaga mniej kroków próbkowania – co ma znaczenie, gdy każdy krok kosztuje obliczenia w tej skali.
Dotąd było koncepcyjnie. Teraz pokażę ci ten sam pomysł działający na rzeczywistym 2D zbiorze danych – na tyle małym, że widać każdy krok.
Rozkład szumu to standardowy 2D Gauss centrowany w początku układu. Rozkład docelowy to trzy skupiska Gaussa ułożone w trójkąt – wystarczająco proste, by mała sieć szybko się ich nauczyła, ale na tyle strukturalne, że widać, czy zrobiła to dobrze.
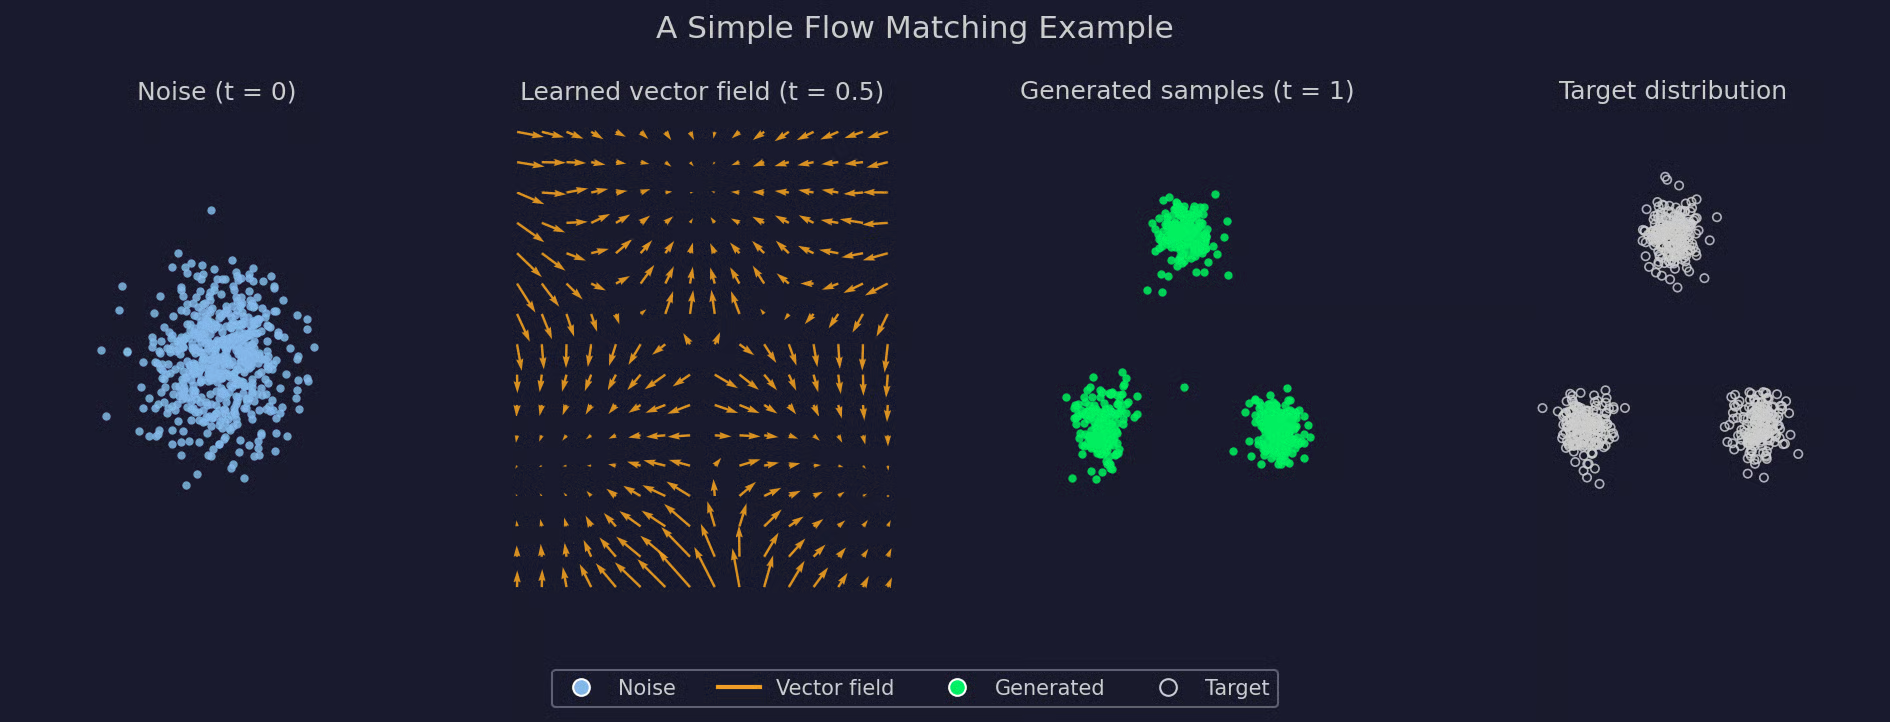
Prosty przykład flow matchingu
Pierwszy panel to punkt startu każdej próbki – rozproszony szum bez struktury. Drugi panel to samo pole wektorowe, ocenione na siatce w połowie treningu. Zwróć uwagę, jak strzałki już wskazują jedno z trzech skupisk, na długo zanim dotrą tam próbki. Trzeci panel pokazuje, co się dzieje, gdy startujesz od świeżego szumu i podążasz za tym polem aż do t = 1 – wyłaniają się trzy skupiska, niemal idealnie pasujące do czwartego panelu.
To wszystko nie wymagało niczego poza tym, co opisano wcześniej – rozkładu źródłowego, docelowego, wyuczonego pola wektorowego i solwera ODE łączącego te trzy. Czas na kod.
Oto mała implementacja w PyTorch tego samego przykładu, z tym samym źródłem szumu i trzema skupiskami jako celem.
Zacznij od dwóch rozkładów i sposobu próbkowania z nich:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Sama sieć przyjmuje punkt i krok czasowy oraz przewiduje prędkość:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Trening na każdym kroku próbkowuje partie punktów źródłowych, docelowych i chwil czasu, następnie interpoluje między pierwszymi dwoma i regresuje do wynikowej prędkości:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Generowanie rozwiązuje wyuczone ODE zwykłą integracją Eulera. Wystarczy pętla, która wykonuje małe kroki od t = 0 do t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`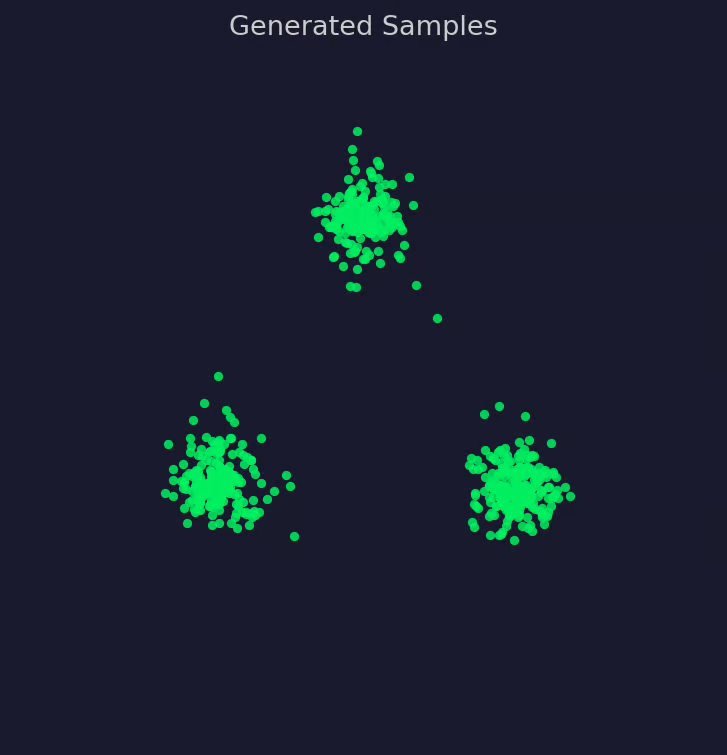
Wizualizacja wygenerowanych próbek
I to cały pipeline! Próbkuj, interpoluj, regresuj, całkuj. Nic się tu nie zmienia, jeśli użyjesz większej sieci, innej ścieżki czy wyższowymiarowego zbioru – zmienia się tylko skala.
To nie czyni flow matchingu uniwersalnym ulepszeniem względem dyfuzji. To kompromis, jak każdy inny wybór projektowy.
Oto kiedy to dobry wybór, a kiedy nie.
Flow matching uczy model, jak próbki powinny się poruszać od prostego rozkładu w kierunku rozkładu danych. Wszystko inne opisane w tym artykule istnieje po to, by tę jedną ideę dało się trenować.
Dwie idee robią tu większość pracy. Ścieżka prawdopodobieństwa łączy szum z danymi przez sekwencję rozkładów pośrednich. Pole wektorowe opisuje, jak próbka powinna poruszać się w dowolnym punkcie tej ścieżki i w dowolnej chwili. Sieć uczy się tego pola wektorowego, czyli prędkości, a generowanie to po prostu podążanie za wynikowym przepływem od szumu do danych.
To nie jest oderwane od wcześniejszych metod. Flow matching to sposób, w jaki nowoczesne systemy trenują continuous normalizing flows bez starego liczenia wiarygodności, a modele dyfuzyjne okazują się jego szczególnym przypadkiem.
Jeśli diffusion models, normalizing flows czy szerzej generatywne AI cię interesują, to właśnie tam warto zajrzeć dalej:
Ucz się AI z DataCamp
course
course
course