
Last chance! 50% off DataCamp Premium
Sale ends in
Видите термин "flow matching" рядом с каждой новой моделью изображений и видео и не понимаете, что он означает?
Большинство объяснений либо сразу уходят в дифференциальные уравнения, либо представляют это как «диффузию, но лучше». Ни то ни другое не объясняет, что именно учит модель. И Stable Diffusion 3, и Flux работают на flow matching и генерируют изображения за пару шагов, тогда как классической диффузии требуются десятки.
Общая идея такова: вместо изучения отдельных примеров модель изучает поле скоростей, которое подсказывает любому образцу, в каком направлении и с какой скоростью двигаться. Поняв это, вы разберётесь и с процессом обучения, и с математикой, и с тем, как это связано с диффузией.
В этой статье мы разберём интуицию за flow matching, как его обучают, математику (без перегруза) и сравнение с диффузионными моделями.
Если вы новичок в ИИ для работы с изображениями, прочитайте нашу десятку лучших vision-language‑моделей 2026 года, чтобы узнать о передовых моделях для визуального рассуждения, анализа изображений и компьютерного зрения.
Flow matching — это цель обучения, а не архитектура модели.
Это важное различие, потому что его можно сочетать с трансформером или почти любой другой сетью — «flow matching» определяет то, чему сеть обучается предсказывать, а не то, как она устроена.
А предсказывает она зависящее от времени векторное поле. Проще говоря, это функция, которая указывает, в каком направлении и с какой скоростью должен двигаться образец в каждой точке своего пути от исходного распределения к целевому. Обучая таким образом непрерывные нормализующие потоки, вы получаете модель, которая шаг за шагом превращает простое распределение в сложное.
Интуитивно это удобно разбить на четыре идеи:
Если вам легче воспринимать визуально, представьте облако беспорядочно разбросанных частиц. Flow matching учит каждую частицу, куда именно двигаться и с какой скоростью, так что со временем всё облако выстраивается в упорядоченный рисунок (форму целевого распределения).
На наборе изображений «упорядоченный рисунок» означает связное фото вместо случайного шума.
Здесь обучение и генерация — это два отдельных этапа, и путаница обычно возникает, когда их считают одним и тем же.
Во время обучения:
t между 0 и 1t на основе вероятностного пути, соединяющего ихt, исходя из выбранного путиДля генерации точка данных не нужна.
Вы начинаете с шума и интегрируете выученное векторное поле вперёд по времени, по маленькому шагу, пока не получите сэмпл из распределения данных.
Вот и вся идея: во время обучения вы предсказываете скорость, а при генерации следуете ей.
За целью flow matching стоят две ключевые идеи — векторные поля и вероятностные пути. Поняв их, вы разберётесь с функцией потерь в следующем разделе.
Векторное поле — это то, что предсказывает сеть. В любой точке пространства и в любой момент времени оно выдаёт направление и скорость — как должен двигаться сэмпл в этой точке, чтобы приблизиться к распределению данных.
Например, представьте, что вы стоите в реке. В зависимости от того, где именно вы стоите и в какой момент, течение толкает вас в определённую сторону с определённой силой. Векторное поле делает то же самое для ваших сэмплов — оно назначает направление и скорость каждой точке пространства в каждый момент времени.
Вероятностный путь — это последовательность распределений, через которые проходит сэмпл, двигаясь от шума к данным. При t = 0 вы сэмплируете из исходного распределения, обычно гауссовского шума. При t = 1 — из целевого распределения данных. Всё между этими моментами — промежуточные распределения, и вероятностный путь описывает, как одно переходит в другое.
Векторное поле и вероятностный путь напрямую связаны: векторное поле перемещает сэмплы вдоль вероятностного пути от одного промежуточного распределения к следующему, пока они не достигнут распределения данных.
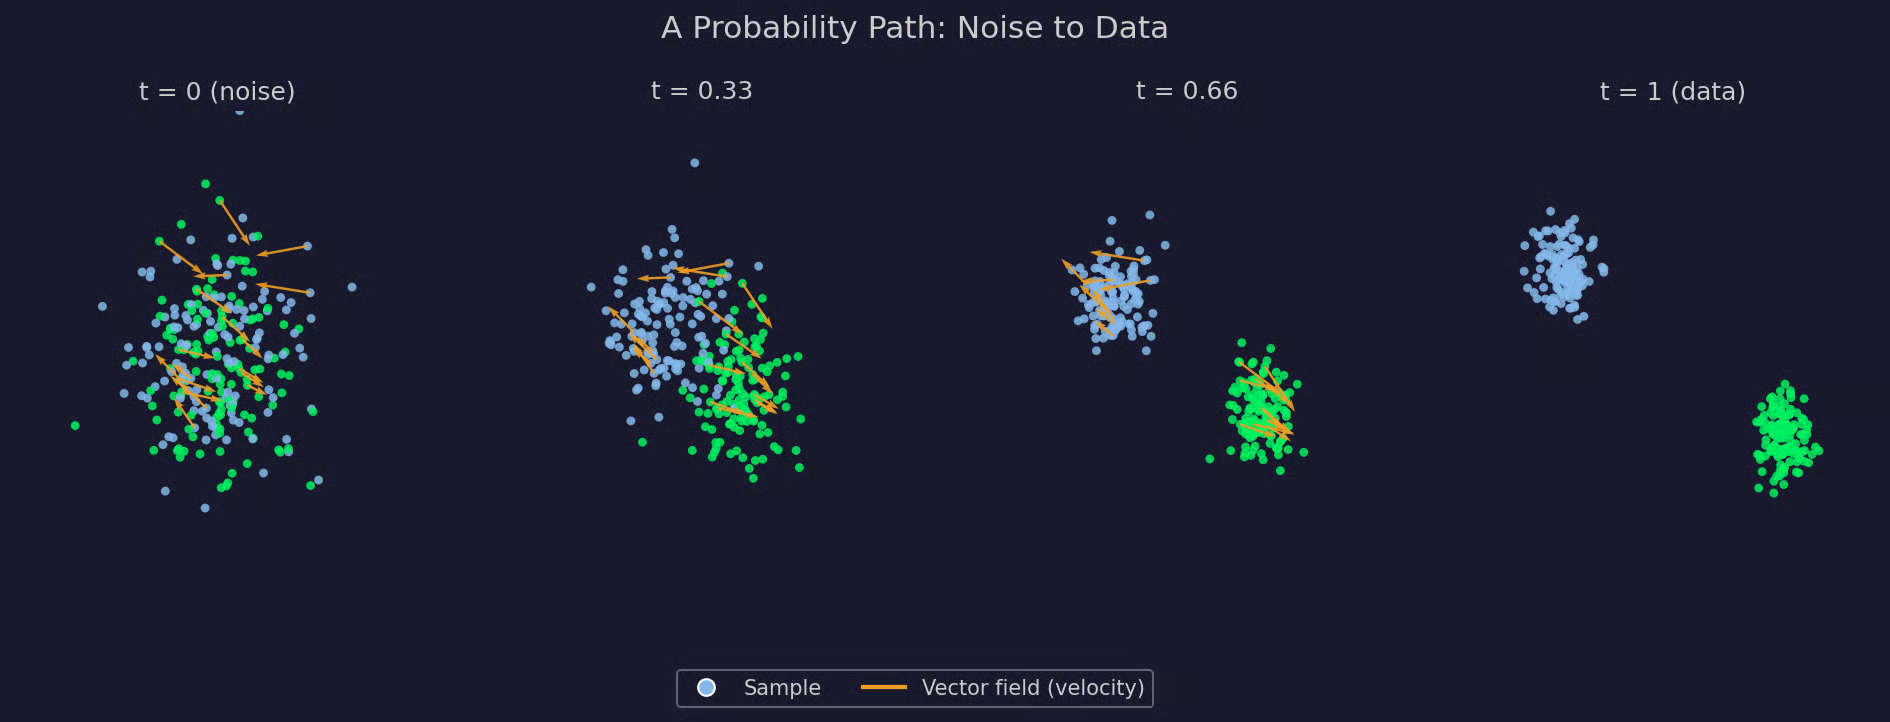
Диаграмма вероятностного пути
Цель flow matching сводит векторные поля и вероятностные пути к одной регрессионной потере.
Каждый шаг обучения сравнивает две скорости. Первая — целевая скорость: направление и скорость, с которыми должен двигаться сэмпл в этой точке выбранного вероятностного пути. Вторая — предсказанная моделью: собственная оценка сети для того же направления и скорости по текущему сэмплу и времени. Обучение делает их как можно более близкими.
Вот функция потерь:
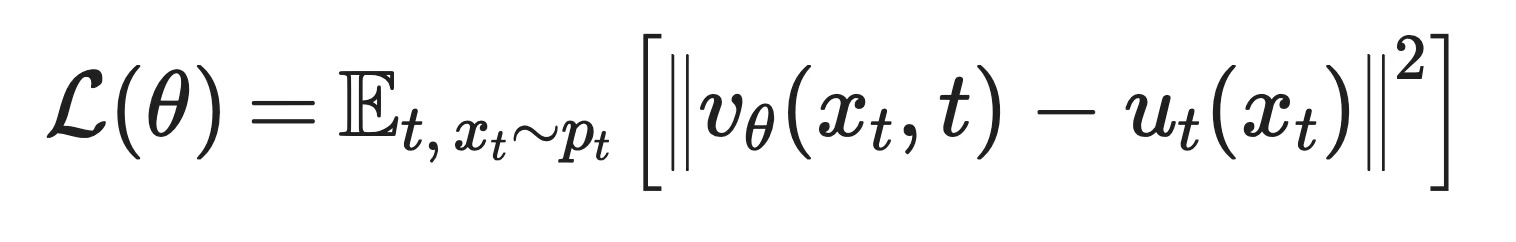
Функция потерь для flow matching
Что означает каждый член:
v_θ(x_t, t): предсказанная моделью скорость в точке x_t и момент времени t
u_t(x_t): целевая скорость в той же точке и момент времени, основанная на выбранном вероятностном пути
𝔼[...]: усреднение по множеству случайных значений t и x_t
‖ · ‖^2: квадрат разницы между двумя скоростями — обычная среднеквадратичная ошибка
Полный вывод здесь не столь важен. Главное, что сеть предсказывает один вектор в одной точке и момент времени, а вы сравниваете его с известной целью. Вот и всё!
Маргинальный вероятностный путь, соединяющий полное распределение шума с полным распределением данных, нельзя выписать напрямую.
Вычисление целевой скорости в заданной точке означает учесть все образцы данных, которые могли её породить — интеграл по всему датасету, что никто не делает на каждом шаге обучения.
Условный flow matching решает это, условливаясь на отдельных сэмплах вместо полного пути. Вместо вычисления векторного поля для всего маргинального пути вы выбираете одну точку данных и одну шумовую точку, затем строите вероятностный путь только для этой пары. Если сделать этот условный путь простым, например взять прямую между двумя точками, целевая скорость имеет аналитическое выражение, которое можно вычислить напрямую.
Обучение сети на этих простых условных скоростях для множества пар в среднем даёт то же векторное поле, что и недостижимая маргинальная цель. Вы никогда напрямую не вычисляете маргинальный путь — вместо этого приближаете его косвенно, по одному простому условному пути за раз.
Именно эту условную версию почти все и обучают. Маргинальная формулировка нужна для математики, а условная — работает на практике.
Диффузия и flow matching постоянно сравниваются не зря — большинство «диффузионных моделей», которые вы уже знаете, теперь обучаются с целью flow matching. Это не значит, что flow matching заменил диффузию. Это значит, что диффузия оказалась частным случаем в более общей рамке, а flow matching — её общий вариант.
Начнём с того, что предсказывает каждая сеть. Диффузионная модель предсказывает шум. Получив зашумлённый сэмпл и шаг по времени, она оценивает примешанный шум и поэтапно его удаляет. Flow matching вместо этого предсказывает скорость: по сэмплу и моменту времени — в каком направлении и с какой скоростью он должен двигаться к распределению данных.
Наиболее сильно они отличаются по вероятностному пути.
Диффузионные модели заранее фиксируют конкретный процесс зашумления, обычно добавление гауссовского шума по фиксированному расписанию, и всё остальное следует из этого выбора. В flow matching вы выбираете любой путь, соединяющий шум с данными, и цель работает одинаково независимо от выбора. Диффузионный гауссовский путь — один из вариантов. Прямая между шумом и данными — другой, и он сильно влияет на скорость сэмплирования.
Эти два предсказания не так уж различаются.
Предсказание шума в диффузии и предсказание скорости в flow matching — два взгляда на один и тот же объект, связанные через скор (градиент лог-плотности) распределения в каждый момент времени. Различие — в генерации. Сэмплирование в диффузии по умолчанию стохастично: на каждом шаге денойзинга добавляется немного случайности (хотя есть детерминированные варианты, как DDIM). В flow matching всё наоборот — естественная формулировка это детерминированное ОДУ, поэтому один и тот же начальный шум даёт один и тот же результат, хотя существуют и стохастические версии.
В обоих случаях сэмплирование означает пошаговое решение дифференциального уравнения — движение от шума к данным.
Диффузионным моделям обычно требуются десятки шагов, если не применять быстрые самплеры или дистилляцию. Flow matching, особенно обученный на прямолинейных путях, обходится гораздо меньшим числом шагов без этих ухищрений — прямой путь имеет постоянную скорость, которую решателю гораздо легче точно отслеживать, чем кривую.
Именно выбор пути даёт flow matching преимущество.
Диффузионные модели ограничены процессом зашумления, из которого они выведены. Flow matching рассматривает путь как элемент дизайна, и разные варианты дают разные компромиссы.
|
Диффузионные модели |
Flow matching |
|
|
Что предсказывает сеть |
Шум, добавленный на каждом шаге |
Скорость в сторону распределения данных |
|
Вероятностный путь |
Фиксирован конкретным процессом зашумления |
Выбирается свободно; часто берут прямые |
|
Базовый объект |
Скор зашумлённого распределения |
Зависящее от времени векторное поле, связанное со скором |
|
Генерация |
По умолчанию стохастическая, есть детерминированные варианты |
По умолчанию детерминированная, есть стохастические варианты |
|
Шаги сэмплирования |
Часто десятки без дополнительных трюков |
Часто значительно меньше, особенно при прямых путях |
|
Выбор пути |
Задан прямым процессом |
Открытое решение дизайна — диффузия это один из случаев |
Сравнение flow matching и диффузионных моделей
Диффузия — не единственный метод для сравнения с flow matching. Есть ещё три, о которых стоит знать.
Сначала появились непрерывные нормализующие потоки, а flow matching вырос напрямую из проблем их обучения.
Непрерывный нормализующий поток — это тип модели, который даёт flow matching: сеть, задающая непрерывное преобразование между распределениями через ОДУ. Изначально обучение означало решать это ОДУ вперёд и на каждом шаге вычислять точное правдоподобие, отслеживая, как преобразование меняет плотность вероятности. Это вычислительно дорого, и с ростом сети становится ещё дороже.
Flow matching этого избегает. Он напрямую регрессирует к известной целевой скорости вместо решения ОДУ и вычисления правдоподобий во время обучения. Никакой симуляции не требуется. В итоге вы всё равно получаете непрерывный нормализующий поток, просто без прежних затрат на обучение.
Score matching обучает сеть предсказывать скор — градиент логарифма плотности вероятности — на каждом уровне шума. Это цель, лежащая в основе знакомых вам диффузионных моделей.
Flow matching обучает предсказывать скорость. Эти два объекта математически связаны, и при определённых выборах пути можно переводить один в другой. Но они описывают разное. Скор описывает форму распределения вероятностей в фиксированный момент времени. Скорость описывает, как должен двигаться сэмпл при изменении времени.
Score matching спрашивает о геометрии. Flow matching — о движении.
Rectified flow — это конкретный выбор внутри flow matching.
Flow matching позволяет выбирать любой вероятностный путь от шума к данным. Rectified flow выбирает прямые линии, а затем идёт дальше с итеративной процедурой «reflow», которая выпрямляет пути, уже выученные моделью, так что модель второго раунда требует ещё меньше шагов интегрирования при генерации.
Поэтому оба термина встречаются рядом в одних и тех же работах. Stable Diffusion 3 и Flux используют flow matching с выбором пути, близким к rectified flow. Но ставить между ними знак равенства — ошибка. Flow matching — это рамка. Rectified flow — один из путей внутри неё.
Flow matching уже используется в крупнейших производственных генеративных системах.
Причина в том, что регрессионная потеря проста в реализации и масштабировании. А так как путь — это выбор дизайна, команды, строящие системы на миллиарды параметров, могут выбрать такой, который требует меньше шагов сэмплирования, и это важно, когда каждый шаг стоит вычислительных ресурсов.
Пока что мы говорили концептуально. Теперь рассмотрим тот же подход на реальном двумерном наборе данных, достаточно маленьком, чтобы увидеть каждый шаг.
Распределение шума — стандартное двумерное гауссовское, центрированное в начале координат. Целевое распределение — три гауссовских кластера, расположенные треугольником: достаточно просто для быстрой сходимости небольшой сети и достаточно структурировано, чтобы визуально оценить результат.
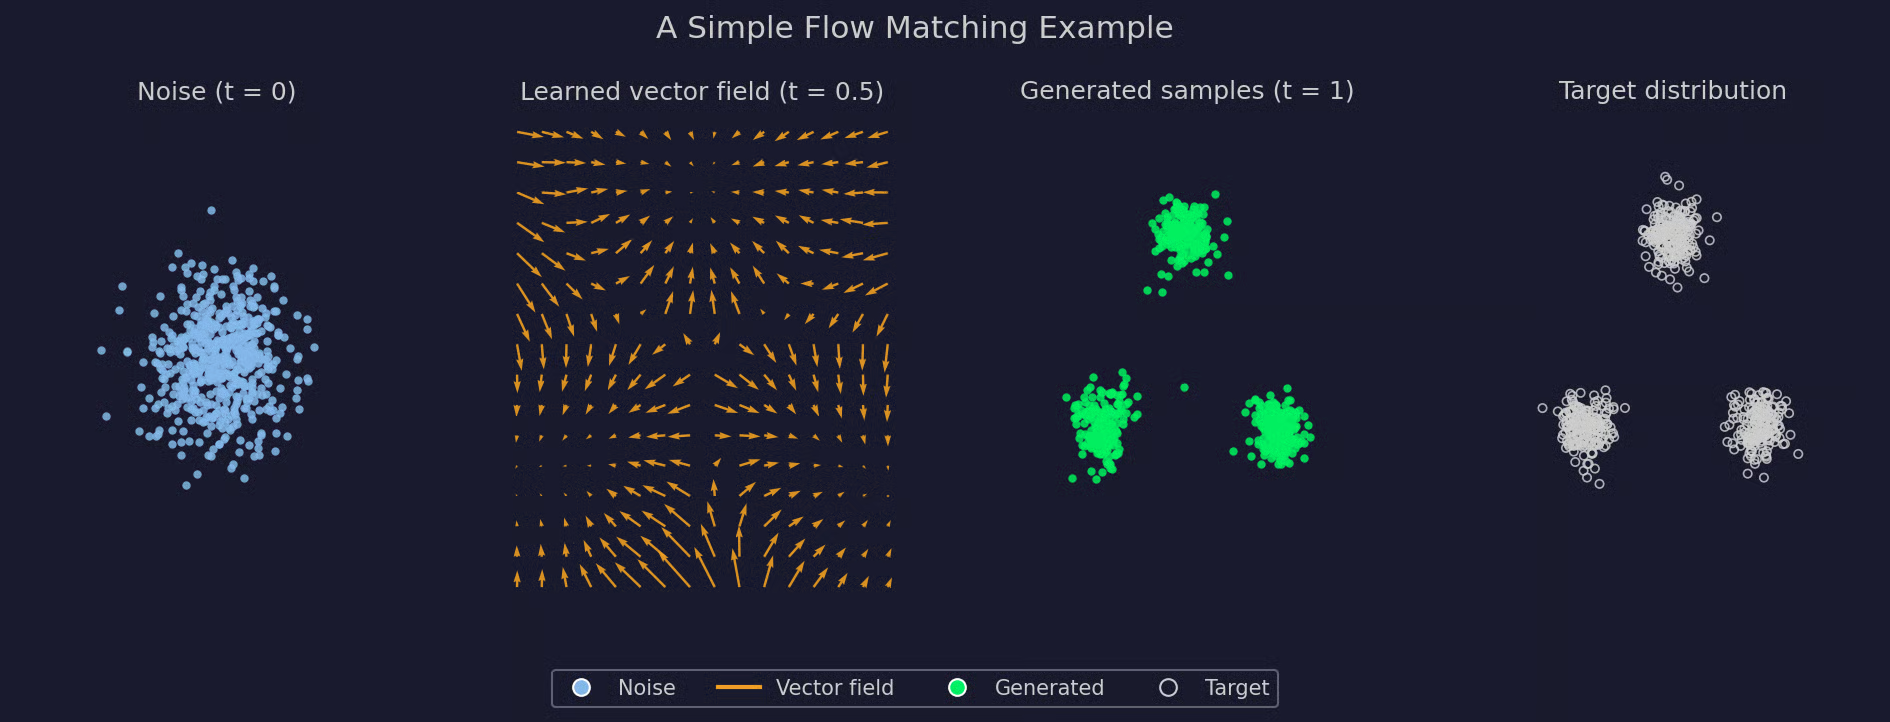
Простой пример flow matching
На первом графике — старт для каждого сэмпла: беспорядочный шум без структуры. Второй — само векторное поле, вычисленное на сетке в середине обучения. Обратите внимание, как стрелки уже указывают к одному из трёх кластеров, задолго до того, как туда попадут сэмплы. Третий показывает, что происходит, если взять новый шум и следовать полю до t = 1 — появляются три кластера, почти идеально совпадающие с четвёртой панелью.
Во всём этом нет ничего сверх сказанного ранее — исходное распределение, целевое распределение, выученное векторное поле и решатель ОДУ, связывающий их. Переходим к коду.
Ниже — небольшая реализация на PyTorch для этого примера с тем же источником шума и трёхкластерной целью.
Начнём с двух распределений и функций сэмплирования:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Сеть принимает точку и шаг по времени и предсказывает скорость:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Обучение на каждом шаге сэмплирует батч исходных точек, целевых точек и меток времени, затем интерполирует между первыми двумя и регрессирует на получившуюся скорость:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Генерация решает выученное ОДУ методом Эйлера. Нужен цикл, который делает маленькие шаги от t = 0 до t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`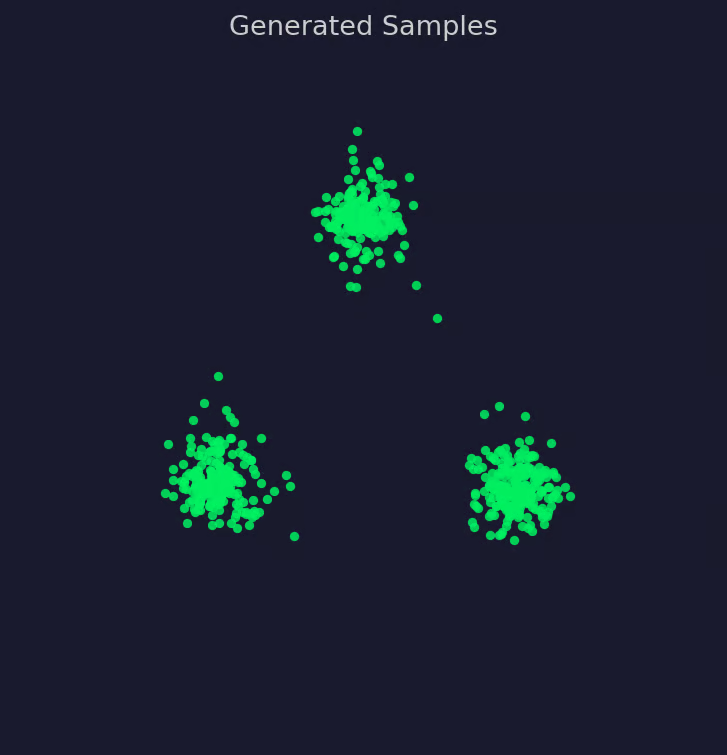
Визуализация сгенерированных сэмплов
И на этом весь конвейер! Сэмплируем, интерполируем, регрессируем, интегрируем. Ничего не меняется, если взять сеть побольше, другой путь или данные большей размерности — меняется только масштаб.
Это не делает flow matching универсальным апгрейдом над диффузией. Это компромисс, как и любой другой выбор дизайна.
Где это хороший вариант, а где — нет:
Flow matching учит модель тому, как сэмплы должны перемещаться от простого распределения к распределению данных. Всё остальное в этой статье нужно лишь затем, чтобы сделать эту идею обучаемой.
Две идеи делают основную работу. Вероятностный путь соединяет шум с данными через последовательность промежуточных распределений. Векторное поле описывает, как должен двигаться сэмпл в любой точке этого пути в любой момент времени. Сеть изучает это векторное поле — его скорость, а генерация — просто следование получившемуся потоку от шума к данным.
Это не оторвано от предшествующих идей. Flow matching — способ обучать современные непрерывные нормализующие потоки без старых вычислений правдоподобия, а диффузионные модели оказываются его частным случаем.
Если диффузионные модели, нормализующие потоки или генеративный ИИ в целом вам интересны, вот что изучать дальше:
Учите ИИ с DataCamp
Курс
Курс
Курс