course
Înțelegerea Inteligenței Artificiale
2 oră
421.5K
Ai tot văzut termenul „flow matching” lângă fiecare nou model de imagini și video și nu-ți e clar ce înseamnă?
Majoritatea explicațiilor sar direct în ecuații diferențiale sau îl prezintă ca „difuzie, dar mai bună”. Niciuna nu-ți spune ce învață de fapt modelul. Stable Diffusion 3 și Flux se bazează pe flow matching și generează imagini în câțiva pași, acolo unde difuzia clasică are nevoie de zeci.
Ideea generală este aceasta: în loc să învețe exemple individuale, modelul învață un câmp de viteză care îi spune oricărei mostre în ce direcție și cât de repede să se miște. Odată ce înțelegi asta, procesul de antrenare, matematica din spate și relația cu difuzia vor avea sens.
În acest articol, te ghidez prin intuiția din spatele flow matching, cum se antrenează, matematica (pe scurt) și cum se compară cu modelele de difuzie.
Dacă ești nou în AI pentru date de imagine, citește Top 10 Vision Language Models în 2026 pentru a descoperi modelele de ultimă generație pentru raționament vizual, analiză de imagini și viziune computerizată.
Flow matching este un obiectiv de antrenare, nu o arhitectură de model.
Această distincție e importantă pentru că îl poți combina cu un transformer sau aproape orice altă rețea — ceea ce îl face flow matching este ce e antrenată rețeaua să prezică, nu cum arată rețeaua.
Iar ceea ce e antrenată să prezică este un câmp vectorial dependent de timp. Pe românește, e o funcție care îți spune în ce direcție și cât de repede ar trebui să se miște o mostră în fiecare punct de pe traseul ei de la distribuția sursă la distribuția țintă. Când antrenezi continuous normalizing flows în acest fel, obții un model care transformă pas cu pas o distribuție simplă într-una complexă.
Îmi place să sparg intuiția în patru idei:
Dacă ești mai vizual, imaginează-ți un nor de particule împrăștiate fără vreo ordine. Flow matching învață fiecare particulă în ce direcție să meargă și cât de repede, astfel încât întregul nor se așază în timp într-un tipar structurat (forma distribuției țintă).
Când rulezi asta pe un set de imagini, „tipar structurat” înseamnă o fotografie coerentă în loc de zgomot aleatoriu.
Antrenarea și generarea sunt două faze separate aici, iar confuzia apare adesea când lumea crede că sunt la fel.
În timpul antrenării:
t aleator între 0 și 1t, pe baza unui traseu probabilistic care le conecteazăt, în funcție de traseul alesGenerarea nu are nevoie de punctul de date.
Pornești din zgomot și integrezi câmpul vectorial învățat înainte în timp, cu pași mici, până când ajungi la o mostră din distribuția de date.
Și asta e ideea — prezici viteza în timpul antrenării și o urmezi în timpul generării.
Două idei fac grosul muncii în spatele obiectivului de flow matching — câmpurile vectoriale și traseele probabilistice. Odată ce le înțelegi, funcția de pierdere din secțiunea următoare va avea sens.
Un câmp vectorial este ceea ce prezice rețeaua. În orice punct din spațiu și în orice moment, îți dă o direcție și o viteză — felul în care o mostră din acel punct ar trebui să se miște ca să se apropie de distribuția de date.
De exemplu, imaginează-ți că stai într-un râu. Oriunde stai, curentul te împinge într-un anumit fel, iar cât de tare și în ce direcție depinde de poziția ta exactă și de momentul în timp. Un câmp vectorial face același lucru pentru mostrele tale — atribuie o direcție și o viteză fiecărui punct din spațiu, în fiecare moment.
Un traseu probabilistic este secvența de distribuții prin care se deplasează o mostră pe drumul de la zgomot la date. La t = 0, eșantionezi din distribuția sursă, de obicei zgomot Gaussian. La t = 1, eșantionezi din distribuția de date țintă. Tot ce se află între aceste două puncte este o distribuție intermediară, iar traseul probabilistic descrie cum se transformă una în alta.
Câmpul vectorial și traseul probabilistic sunt direct legate pentru că câmpul vectorial mută mostrele de-a lungul traseului probabilistic, de la o distribuție intermediară la următoarea, până ajung la distribuția de date.
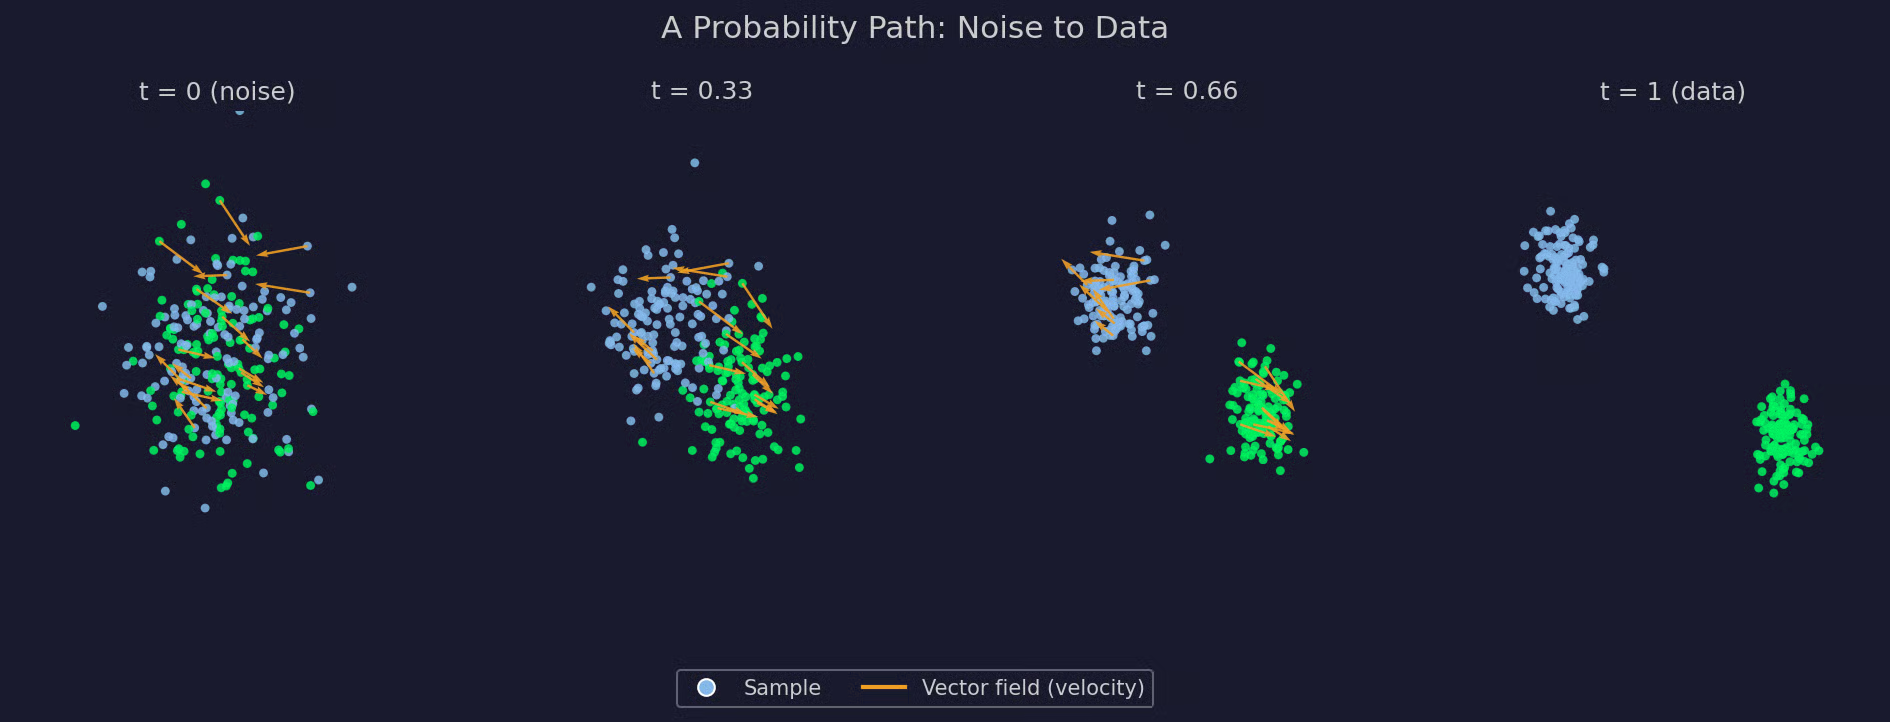
O diagramă a unui traseu probabilistic
Obiectivul de flow matching transformă câmpurile vectoriale și traseele probabilistice într-o singură pierdere de regresie.
Fiecare pas de antrenare compară două viteze. Prima este viteza țintă — direcția și viteza cu care ar trebui să se miște o mostră în acel punct de pe traseul probabilistic ales. A doua este viteza prezisă de model — estimarea rețelei pentru aceeași direcție și viteză, pe baza mostrei și a timpului curent. Antrenarea face ca cele două să se potrivească cât mai bine.
Iată funcția de pierdere:
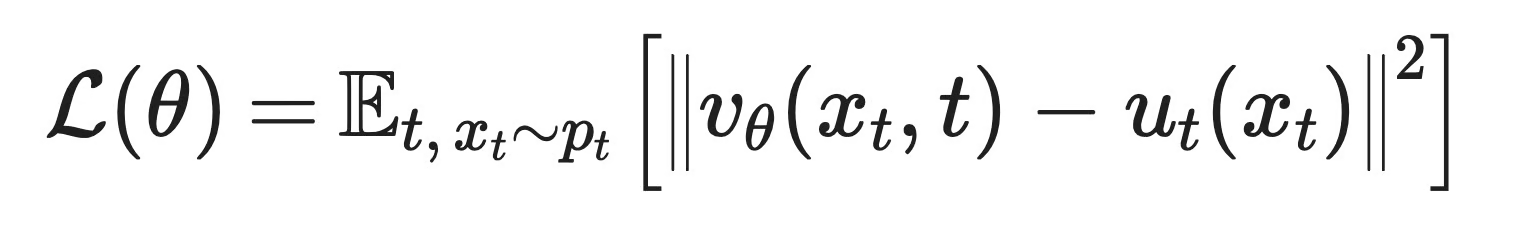
Funcția de pierdere pentru flow matching
Iată ce înseamnă fiecare termen:
v_θ(x_t, t): Viteza prezisă de model în punctul x_t și la momentul t
u_t(x_t): Viteza țintă în același punct și moment, bazată pe traseul probabilistic ales
𝔼[...]: O medie peste multe valori aleatoare ale lui t și x_t
‖ · ‖^2: Diferența pătratică dintre cele două viteze — eroare pătratică medie simplă
Demonstrația completă nu ne interesează aici. Contează că rețeaua prezice un singur vector într-un singur punct și moment, iar tu îl compari cu o țintă cunoscută. Atât!
Traseul probabilistic marginal care conectează întreaga distribuție de zgomot la întreaga distribuție de date nu e ceva ce poți scrie direct.
Calcularea vitezei țintă într-un punct dat înseamnă să iei în considerare fiecare mostră de date care ar fi putut să o producă — o integrală peste întregul set de date, ceva ce nimeni nu calculează la fiecare pas de antrenare.
Flow matching condiționat rezolvă asta condiționând pe mostre individuale în locul întregului traseu. În loc să calculezi câmpul vectorial pentru întregul traseu marginal, alegi un singur punct de date și un singur punct de zgomot, apoi construiești un traseu probabilistic doar pentru acea pereche. Când faci acel traseu condiționat simplu, de exemplu o linie dreaptă între cele două puncte, viteza țintă are o expresie în formă închisă pe care o poți calcula direct.
Antrenând rețeaua pe aceste viteze condiționate simple, pe perechi, mediate peste destule perechi, obții același câmp vectorial pe care l-ai obține din obiectivul marginal intratabil. Nu calculezi niciodată direct traseul marginal — îl aproximezi indirect, câte un traseu condiționat ușor pe rând.
Aceasta este versiunea pe care aproape toată lumea o antrenează în practică. Formularea marginală face matematica să funcționeze, dar formularea condiționată este cea care funcționează efectiv.
Difuzia și flow matching sunt comparate des cu un motiv bun — majoritatea „modelelor de difuzie” pe care le știi rulează acum pe un obiectiv de flow matching. Asta nu înseamnă că flow matching a înlocuit difuzia. Înseamnă că difuzia s-a dovedit a fi un caz specific într-un cadru mai larg, iar flow matching este versiunea generală a acestuia.
Încep cu ce prezice fiecare rețea. Un model de difuzie prezice zgomot. Dată fiind o mostră zgomotoasă și un pas de timp, prezice zgomotul amestecat și apoi îl îndepărtează, pas cu pas. Flow matching prezice în schimb o viteză. Dată fiind o mostră și un pas de timp, prezice în ce direcție și cât de repede ar trebui să se miște acea mostră către distribuția de date.
Traseul probabilistic este locul unde diferă cel mai mult.
Modelele de difuzie fixează din start un proces specific de adăugare a zgomotului, de obicei adăugând zgomot Gaussian pe un program fix, iar restul decurge din acea singură alegere. În flow matching, alegi orice traseu care leagă zgomotul de date, iar obiectivul funcționează la fel indiferent de alegere. Un traseu de tip difuzie Gaussiană este o opțiune. O linie dreaptă între zgomot și date este alta — și contează mult pentru cât de repede poți eșantiona.
Aceste două predicții nu sunt atât de diferite cum par.
Predicția de zgomot a unui model de difuzie și predicția de viteză a unui model de flow matching sunt două vederi ale aceluiași obiect de bază, legate prin scorul distribuției în fiecare moment. Diferența e în modul de generare. Eșantionarea în difuzie este stocastică implicit, adică fiecare pas de denoising adaugă puțină aleatorietate înapoi (deși există variante deterministe precum DDIM). Flow matching funcționează invers — formularea sa naturală este o EDO deterministică, deci același zgomot de start produce același rezultat de fiecare dată, și există și versiuni stocastice pe această parte.
Eșantionarea, în ambele cazuri, înseamnă rezolvarea pas cu pas a unei ecuații diferențiale, deplasându-te dinspre zgomot către date.
Modelele de difuzie au nevoie adesea de zeci de pași dacă nu folosești eșantionatoare rapide sau distilare. Flow matching, mai ales când e antrenat pe trasee în linie dreaptă, are nevoie de mult mai puțini pași fără toate acestea — un traseu drept are viteză constantă, ceea ce e mult mai ușor de urmărit cu acuratețe de către un solver decât unul curbat.
Traseul în sine este locul unde flow matching iese în față.
Modelele de difuzie sunt limitate la procesul de zgomot din care au fost derivate. Flow matching tratează traseul ca pe o alegere de design, iar alegerile diferite vin cu compromisuri diferite.
|
Modele de difuzie |
Flow matching |
|
|
Ce prezice rețeaua |
Zgomotul adăugat la fiecare pas |
Viteza către distribuția de date |
|
Traseu probabilistic |
Fixat de un proces specific de zgomot |
Ales liber; liniile drepte sunt comune |
|
Obiect de bază |
Scorul distribuției zgomotoase |
Câmp vectorial dependent de timp, legat de scor |
|
Generare |
Stocastică implicit, dar există variante deterministe |
Deterministă implicit, dar există variante stocastice |
|
Pași de eșantionare |
Adesea zeci fără artificii suplimentare |
Adesea mult mai puțini, mai ales cu trasee mai drepte |
|
Alegerea traseului |
Fixată de procesul direct |
O alegere deschisă de design — difuzia e o instanță |
Flow matching comparat cu modelele de difuzie
Difuzia nu este singura metodă comparată cu flow matching. Mai sunt încă trei pe care ar trebui să le cunoști
Continuous normalizing flows au apărut primele, iar flow matching a crescut direct din problemele de antrenare ale acestora.
Un continuous normalizing flow este tipul de model pe care îl produce flow matching — o rețea care definește o transformare continuă între distribuții printr-o EDO. Să antrenezi unul în modul original însemna să rezolvi acea EDO înainte și să calculezi un likelihood exact la fiecare pas, ceea ce presupune urmărirea modului în care transformarea schimbă densitatea de probabilitate de-a lungul drumului. Acel calcul e costisitor și devine și mai scump pe măsură ce crește rețeaua.
Flow matching evită toate acestea. Face regresie direct pe o viteză țintă cunoscută, în loc să rezolve EDO și să calculeze likelihood-uri în timpul antrenării. Nu e nevoie de simulare. Tot la un continuous normalizing flow ajungi, doar că nu mai plătești costul de antrenare de altădată ca să ajungi acolo.
Score matching antrenează o rețea să prezică scorul — gradientul log-densității de probabilitate — la fiecare nivel de zgomot. Asta este obiectivul din spatele modelelor de difuzie pe care le cunoști.
Flow matching antrenează o rețea să prezică în schimb o viteză. Cele două obiecte sunt legate matematic, ceea ce înseamnă că, pentru anumite alegeri de traseu, poți converti unul în celălalt. Dar reprezintă lucruri diferite. Scorul descrie forma distribuției de probabilitate într-un moment fix în timp. Viteza descrie cum ar trebui să se miște o mostră pe măsură ce se schimbă timpul.
Score matching vorbește despre geometrie. Flow matching vorbește despre mișcare.
Rectified flow este o alegere specifică în interiorul flow matching.
Flow matching îți permite să alegi orice traseu probabilistic care leagă zgomotul de date. Rectified flow alege unul — liniile drepte, și merge mai departe cu o procedură iterativă numită „reflow” care îndreaptă traseele pe care un model deja antrenat le-a învățat, astfel încât un model din „runda a doua” are nevoie de și mai puțini pași de integrare la generare.
De aceea cei doi termeni apar unul lângă altul în aceleași articole. Stable Diffusion 3 și Flux folosesc ambele flow matching cu o alegere de traseu apropiată de rectified flow. Dar a trata flow matching și rectified flow ca fiind interschimbabile ratează esența. Flow matching este cadrul. Rectified flow este un traseu pe care îl poți alege în interiorul lui.
Flow matching rulează acum în unele dintre cele mai mari sisteme generative din producție.
Toate acestea pentru că o pierdere de regresie e simplu de implementat și scalat. Și pentru că traseul este o alegere de design, echipele care construiesc sisteme cu miliarde de parametri pot alege unul care are nevoie de mai puțini pași de eșantionare — și asta contează când fiecare pas costă resurse la acea scară.
Până acum a fost conceptual. Acum te ghidez prin aceeași idee rulând pe un set de date 2D real, suficient de mic încât să vezi fiecare pas.
Distribuția de zgomot este un Gaussian 2D standard, centrat în origine. Distribuția țintă este formată din trei clustere Gaussiene dispuse într-un triunghi — suficient de simplă ca o rețea mică să învețe rapid, dar destul de structurată încât să poți spune dacă a reușit.
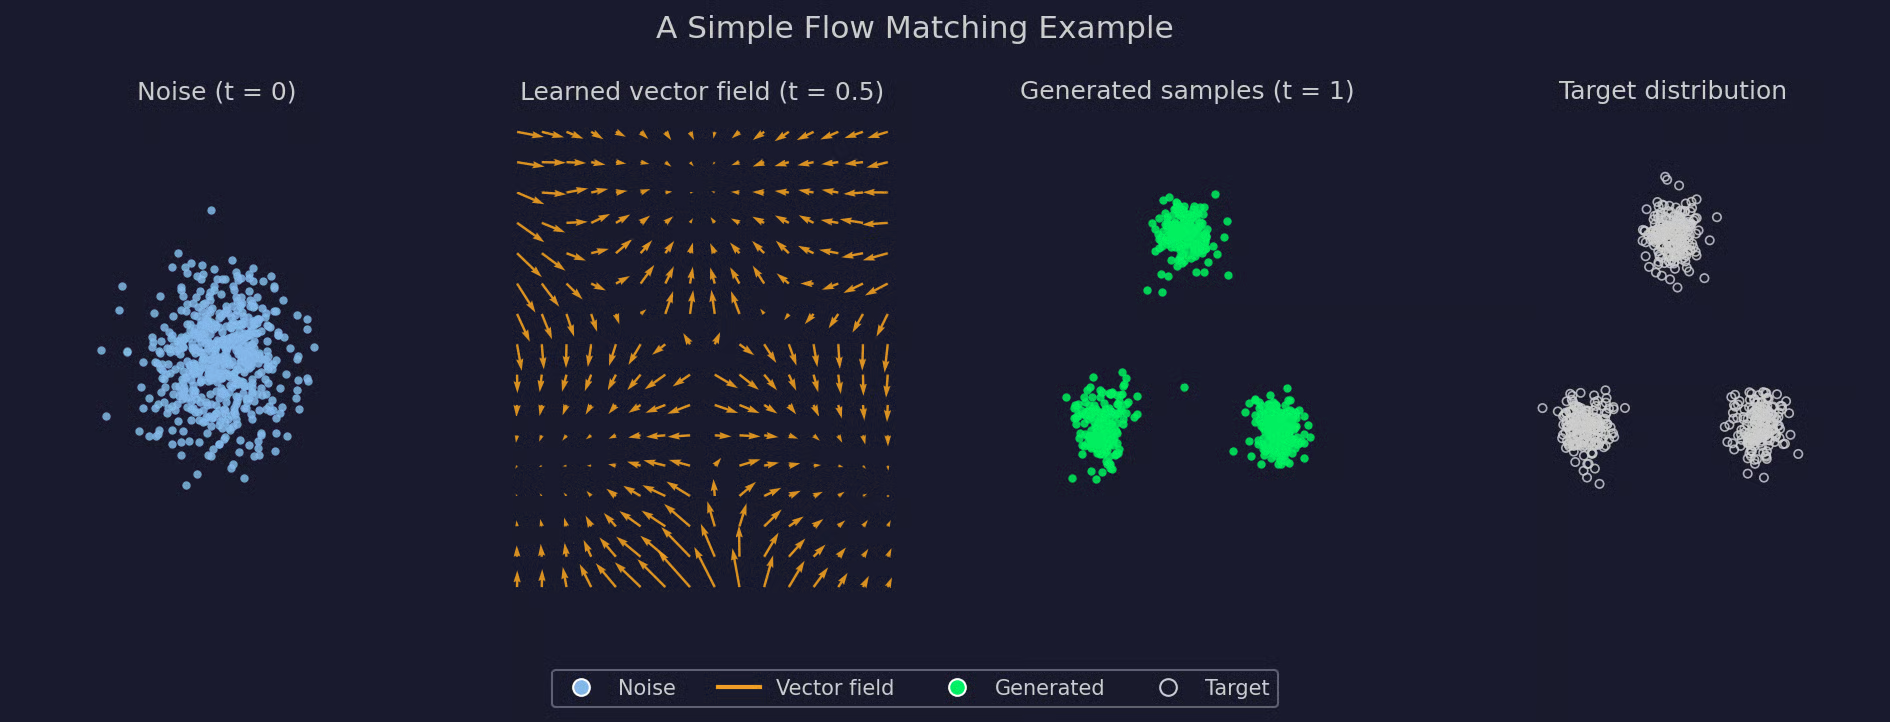
Exemplu simplu de flow matching
Primul panou este locul de unde pornește fiecare mostră — zgomot împrăștiat, fără structură. Al doilea panou este câmpul vectorial în sine, evaluat pe o grilă la jumătatea antrenării. Observă cum săgețile deja indică spre unul dintre cele trei clustere, cu mult înainte ca vreo mostră să ajungă acolo. Al treilea panou arată ce se întâmplă când pornești din zgomot proaspăt și urmezi acel câmp până la t = 1 — apar trei clustere, potrivindu-se aproape perfect cu al patrulea panou.
Nimic din toate acestea nu a implicat altceva decât ce am acoperit deja — o distribuție sursă, o distribuție țintă, un câmp vectorial învățat și un solver EDO care le conectează. Să trecem la cod.
Iată o implementare PyTorch mică a aceluiași exemplu, folosind aceeași sursă de zgomot și aceeași țintă cu trei clustere.
Începe cu cele două distribuții și cum eșantionezi din ele:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Rețeaua în sine primește un punct și un pas de timp și prezice o viteză:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Antrenarea eșantionează la fiecare pas un batch de puncte sursă, puncte țintă și pași de timp, apoi interpolează între primele două și face regresie pe viteza rezultată:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Generarea rezolvă EDO-ul învățat cu o integrare Euler simplă. Ai nevoie doar de un ciclu care face pași mici de la t = 0 la t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`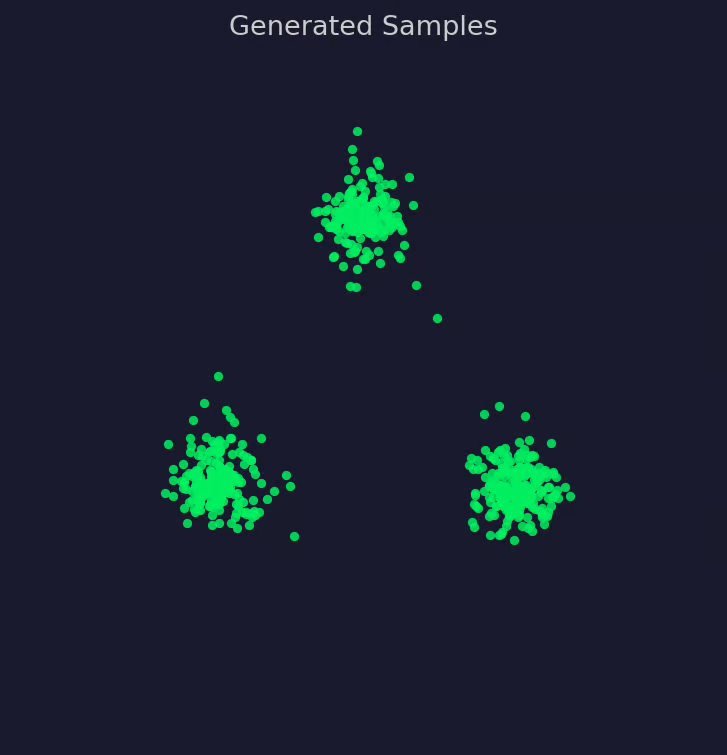
Vizualizare mostre generate
Și acesta e întregul pipeline! Eșantionează, interpolează, regresează, integrează. Nimic nu se schimbă dacă mergi cu o rețea mai mare, un alt traseu sau un set de date de dimensiune mai mare — doar scara.
Nimic din toate acestea nu face din flow matching un upgrade universal față de difuzie. Este un compromis, ca orice altă alegere de design.
Iată unde este o opțiune bună și unde nu este.
Flow matching învață un model cum ar trebui să se miște mostrele de la o distribuție simplă către distribuția de date. Tot restul descris în acest articol există pentru a face această idee antrenabilă.
Două idei fac majoritatea muncii aici. Un traseu probabilistic conectează zgomotul la date printr-o secvență de distribuții intermediare. Un câmp vectorial descrie cum ar trebui să se miște o mostră în orice punct de pe acel traseu, în orice moment. Rețeaua învață acel câmp vectorial, viteza lui, iar generarea înseamnă doar să urmezi fluxul rezultat de la zgomot la date.
Nimic din toate acestea nu stă separat de ce a fost înainte. Flow matching este modul în care sistemele moderne antrenează continuous normalizing flows fără calculul vechi de likelihood, iar modelele de difuzie se dovedesc a fi un caz specific al acestuia.
Dacă modelele de difusion, normalizing flows sau Generative AI în sens mai larg te interesează, iată exact unde să mergi mai departe:
Învață AI cu DataCamp
course
course
course