
Corso
Comprendere l'intelligenza artificiale
2 h
421.5K
Hai visto il termine "flow matching" accanto a ogni nuovo modello di immagini e video e non hai idea di cosa significhi?
Molte spiegazioni passano subito alle equazioni differenziali o lo presentano come "diffusione, ma meglio". Nessuna delle due ti dice cosa impara il modello. Sia Stable Diffusion 3 che Flux usano il flow matching e generano immagini in un paio di passaggi, dove la diffusione classica ne richiede decine.
L'idea generale è questa: invece di imparare esempi individuali, il modello impara un campo di velocità che dice a qualsiasi campione in quale direzione e a quale velocità muoversi. Una volta capito questo, il processo di training, la matematica e il rapporto con la diffusione diventano tutti più chiari.
In questo articolo ti guiderò nell'intuizione dietro il flow matching, come si allena, un po' di matematica (senza appesantire) e come si confronta con i modelli di diffusione.
Se sei alle prime armi con l'IA per i dati visivi, leggi la nostra Top 10 dei modelli Vision Language nel 2026 per scoprire gli attuali modelli all'avanguardia per il ragionamento visivo, l'analisi delle immagini e la computer vision.
Il flow matching è un obiettivo di training, non un'architettura di modello.
Questa distinzione è importante perché puoi abbinarlo a un transformer o a quasi qualsiasi altra rete: ciò che rende flow matching è cosa la rete viene addestrata a predire, non com'è fatta la rete.
E ciò che viene addestrata a predire è un campo vettoriale dipendente dal tempo. In parole semplici, è una funzione che ti dice in quale direzione e a quale velocità un campione dovrebbe muoversi in ogni punto lungo il suo percorso dalla distribuzione sorgente a quella target. Quando lo alleni per addestrare dei continuous normalizing flows in questo modo, ottieni un modello che trasforma una distribuzione semplice in una complessa, passo dopo passo.
Mi piace spezzare l'intuizione in quattro idee:
Se sei più visivo, immagina una nuvola di particelle sparse senza alcun ordine. Il flow matching insegna a ogni particella esattamente in quale direzione muoversi e a quale velocità, così l'intera nuvola si assesta nel tempo in uno schema strutturato (la forma della tua distribuzione target).
Quando lo applichi a un dataset di immagini, "schema strutturato" significa una foto coerente invece di rumore casuale.
Training e generazione sono due fasi distinte, e la confusione spesso nasce quando si pensa che siano la stessa cosa.
Durante il training:
t casuale tra 0 e 1t, basandoti su un percorso di probabilità che li collegat, in base al percorso sceltoLa generazione non ha bisogno del punto dati.
Parti dal rumore e integra in avanti nel tempo il campo vettoriale appreso, un piccolo passo alla volta, finché non ottieni un campione dalla distribuzione dei dati.
E questa è l'idea: durante il training predici la velocità, e durante la generazione la segui.
Ci sono due idee che fanno gran parte del lavoro dietro l'obiettivo di flow matching: i campi vettoriali e i percorsi di probabilità. Una volta capite, la funzione di perdita nella prossima sezione sarà naturale.
Un campo vettoriale è ciò che la rete predice. In qualunque punto dello spazio e in qualunque istante, ti dà una direzione e una velocità: il modo in cui un campione in quel punto dovrebbe muoversi per avvicinarsi alla distribuzione dei dati.
Per esempio, immagina di stare in un fiume. Ovunque tu sia, la corrente ti spinge in un certo modo, e l'intensità e la direzione dipendono dalla tua posizione esatta e dal momento nel tempo. Un campo vettoriale fa lo stesso per i tuoi campioni: assegna una direzione e una velocità a ogni punto dello spazio, in ogni istante.
Un percorso di probabilità è la sequenza di distribuzioni che un campione attraversa andando dal rumore ai dati. A t = 0 campioni dalla distribuzione sorgente, di solito rumore gaussiano. A t = 1 campioni dalla distribuzione dei dati target. Tutto ciò che sta in mezzo sono distribuzioni intermedie, e il percorso di probabilità descrive come una si trasforma nella successiva.
Il campo vettoriale e il percorso di probabilità sono direttamente collegati perché il campo vettoriale muove i campioni lungo il percorso di probabilità, da una distribuzione intermedia alla successiva, finché non raggiungono la distribuzione dei dati.
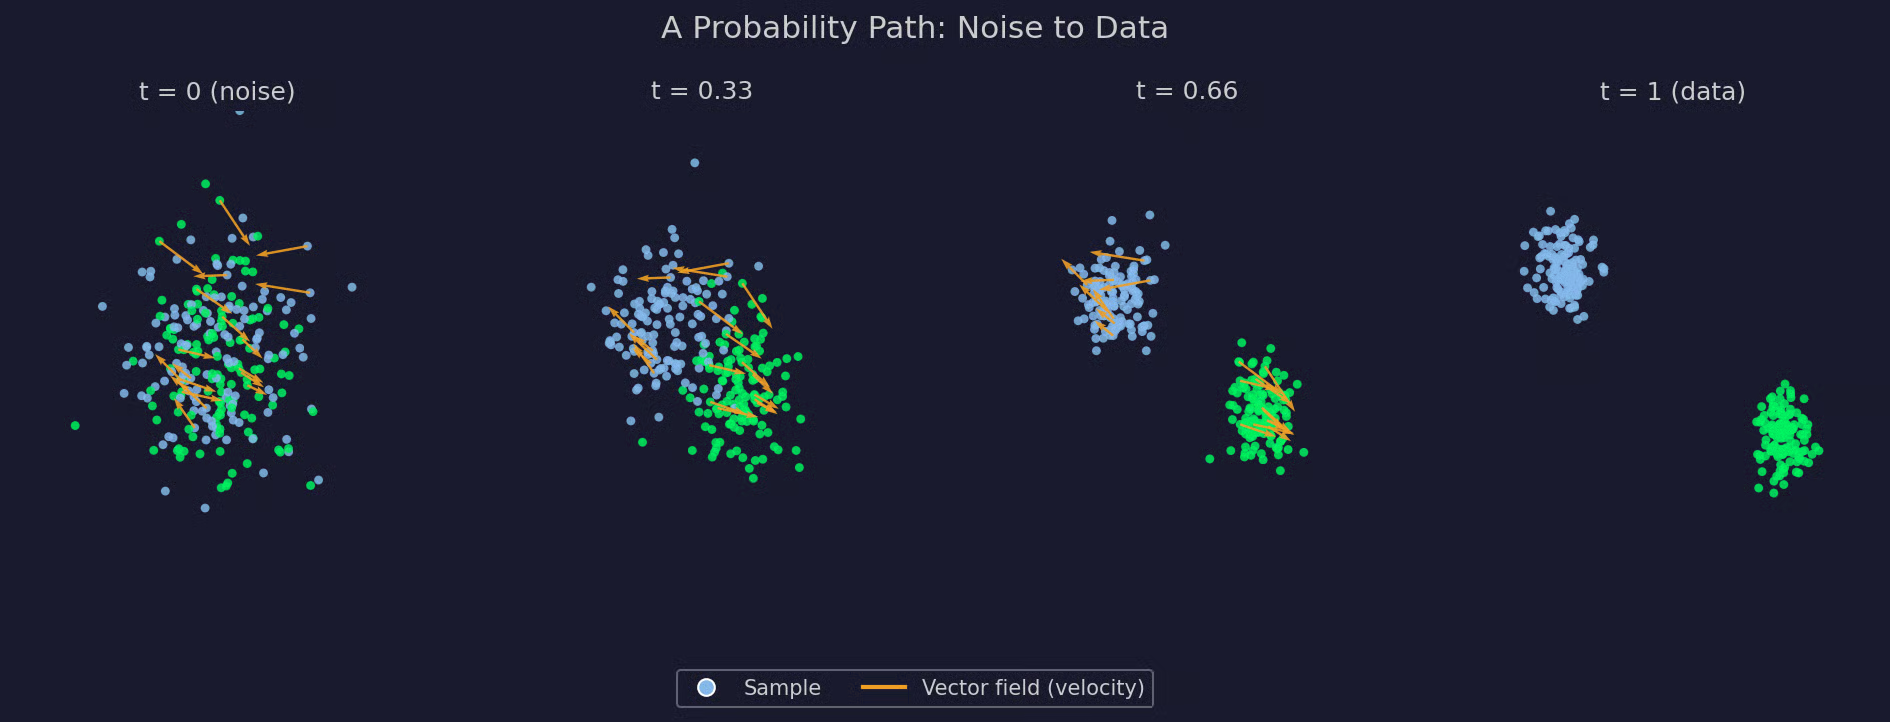
Schema di un percorso di probabilità
L'obiettivo di flow matching unisce campi vettoriali e percorsi di probabilità in un'unica loss di regressione.
Ogni step di training confronta due velocità. La prima è la velocità target: la direzione e la velocità con cui un campione dovrebbe muoversi in quel punto lungo il percorso di probabilità scelto. La seconda è la velocità predetta dal modello: la stima della rete per la stessa direzione e velocità, basata sul campione e sul tempo correnti. Il training fa sì che le due coincidano il più possibile.
Ecco la funzione di perdita:
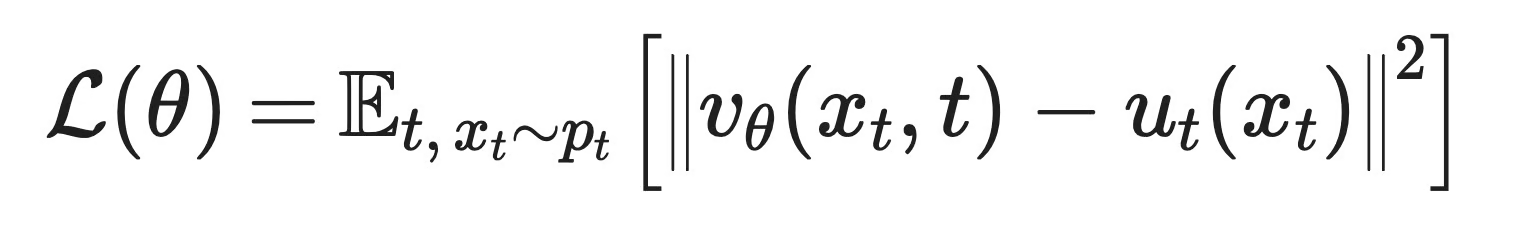
Funzione di perdita del flow matching
Ecco cosa significa ogni termine:
v_θ(x_t, t): la velocità predetta dal modello nel punto x_t e al tempo t
u_t(x_t): la velocità target nello stesso punto e istante, in base al percorso di probabilità scelto
𝔼[...]: una media su molti valori casuali di t e x_t
‖ · ‖^2: la differenza al quadrato tra le due velocità - semplice errore quadratico medio
La derivazione completa qui non è essenziale. Conta che la rete predice un singolo vettore in un singolo punto e istante, e lo confronti con un target noto. Tutto qui!
Il percorso di probabilità marginale che collega l'intera distribuzione di rumore all'intera distribuzione dei dati non è qualcosa che puoi scrivere direttamente.
Calcolare la velocità target in un punto dato significa tenere conto di ogni campione di dati che potrebbe averlo prodotto: un integrale sull'intero dataset, non qualcosa che si calcola a ogni step di training.
Il conditional flow matching risolve questo problema condizionando su singoli campioni invece che sull'intero percorso. Invece di calcolare il campo vettoriale per l'intero percorso marginale, scegli un singolo punto dati e un singolo punto di rumore, poi costruisci un percorso di probabilità solo per quella coppia. Quando rendi semplice quel percorso condizionale, ad esempio una linea retta tra i due punti, la velocità target ha un'espressione in forma chiusa che puoi calcolare direttamente.
Addestrare la rete su queste velocità condizionali semplici, per coppia, e mediarle su abbastanza coppie, ti porta allo stesso campo vettoriale che otterresti dall'obiettivo marginale intrattabile. Non calcoli mai direttamente il percorso marginale: lo approssimi indirettamente, un percorso condizionale facile alla volta.
Questa versione condizionale è quella che quasi tutti addestrano realmente. La formulazione marginale fa tornare la matematica, ma quella condizionale è ciò che funziona in pratica.
Diffusione e flow matching vengono continuamente confrontati per una buona ragione: la maggior parte dei "modelli di diffusione" che già conosci ora usa un obiettivo di flow matching. Non significa che il flow matching abbia sostituito la diffusione. Significa che la diffusione si è rivelata un caso specifico all'interno di un quadro più ampio, e il flow matching ne è la versione generale.
Parto da ciò che ogni rete predice. Un modello di diffusione predice il rumore. Dato un campione rumoroso e uno step temporale, predice il rumore che è stato mescolato e poi lo rimuove, uno step alla volta. Il flow matching invece predice una velocità. Dato un campione e uno step temporale, predice in quale direzione e a quale velocità quel campione dovrebbe muoversi verso la distribuzione dei dati.
Il percorso di probabilità è dove i due differiscono di più.
I modelli di diffusione fissano in partenza un processo di noising specifico, di solito aggiungono rumore gaussiano con una schedule fissa, e tutto il resto discende da quella singola scelta. Nel flow matching, scegli qualsiasi percorso che collega rumore e dati, e l'obiettivo funziona allo stesso modo qualunque sia la tua scelta. Un percorso gaussiano in stile diffusione è un'opzione. Una linea retta tra rumore e dati è un'altra, e risulta molto importante per la velocità di campionamento.
Queste due previsioni non sono così diverse come sembrano.
La previsione del rumore di un modello di diffusione e la previsione della velocità di un modello di flow matching sono due viste dello stesso oggetto sottostante, collegate tramite lo score della distribuzione in ogni istante. Dove differiscono è nel modo di generare. Il campionamento nella diffusione è stocastico per impostazione predefinita, il che significa che a ogni step di denoising si aggiunge un po' di casualità (anche se esistono varianti deterministiche come DDIM). Il flow matching funziona al contrario: la sua formulazione naturale è un'ODE deterministica, quindi lo stesso rumore iniziale produce sempre lo stesso output, e esistono anche versioni stocastiche da questo lato.
In entrambi i casi campionare significa risolvere un'equazione differenziale passo dopo passo, muovendosi dal rumore verso i dati.
I modelli di diffusione tendono ad aver bisogno di decine di step, a meno di usare sampler veloci o distillazione. Il flow matching, soprattutto quando è addestrato su percorsi rettilinei, tende ad aver bisogno di molti meno step senza nulla di tutto ciò: un percorso rettilineo ha velocità costante, molto più facile da seguire con precisione per un risolutore rispetto a uno curvo.
È proprio la scelta del percorso a dare un vantaggio al flow matching.
I modelli di diffusione sono limitati al processo di noising da cui sono derivati. Il flow matching tratta il percorso come una scelta di design, e scelte diverse comportano compromessi diversi.
|
Modelli di diffusione |
Flow matching |
|
|
Cosa predice la rete |
Rumore aggiunto a ogni step |
Velocità verso la distribuzione dei dati |
|
Percorso di probabilità |
Fissato da un processo di noising specifico |
Scelto liberamente; le linee rette sono comuni |
|
Oggetto sottostante |
Score della distribuzione rumorosa |
Campo vettoriale dipendente dal tempo, collegato allo score |
|
Generazione |
Stocastica per default ma esistono varianti deterministiche |
Deterministica per default ma esistono varianti stocastiche |
|
Step di campionamento |
Spesso decine senza trucchi extra |
Spesso molti meno, soprattutto con percorsi più rettilinei |
|
Scelta del percorso |
Fissata dal processo forward |
Una scelta di design aperta — la diffusione è un'istanza |
Confronto tra flow matching e modelli di diffusione
La diffusione non è l'unico metodo paragonato al flow matching. Ce ne sono altri tre che dovresti conoscere
I continuous normalizing flows sono arrivati per primi, e il flow matching è nato direttamente dai problemi nel loro training.
Un continuous normalizing flow è il tipo di modello che il flow matching produce: una rete che definisce una trasformazione continua tra distribuzioni tramite un'ODE. Addestrarne uno nel modo originale significava risolvere quella ODE in avanti e calcolare una likelihood esatta a ogni passaggio, cioè tenere traccia di come la trasformazione cambia la densità di probabilità lungo il percorso. Questo calcolo è costoso, e peggiora all'aumentare della rete.
Il flow matching evita tutto ciò. Esegue una regressione direttamente su una velocità target nota invece di risolvere l'ODE e calcolare le likelihood durante il training. Non serve alcuna simulazione. Ottieni comunque un continuous normalizing flow, semplicemente senza pagare il costo di training di prima.
Lo score matching allena una rete a predire lo score - il gradiente della log-densità di probabilità - a ogni livello di rumore. È l'obiettivo dietro i modelli di diffusione che già conosci.
Il flow matching allena invece una rete a predire una velocità. I due oggetti sono collegati matematicamente, il che significa che, sotto certe scelte di percorso, puoi convertirne uno nell'altro. Ma rappresentano cose diverse. Lo score descrive la forma della distribuzione di probabilità in un istante fissato. La velocità descrive come un campione dovrebbe muoversi al variare del tempo.
Lo score matching parla di geometria. Il flow matching parla di movimento.
Il rectified flow è una scelta specifica all'interno del flow matching.
Il flow matching ti lascia scegliere qualsiasi percorso di probabilità che colleghi rumore e dati. Il rectified flow ne sceglie uno: linee rette, e fa un passo ulteriore con una procedura iterativa chiamata "reflow" che raddrizza i percorsi già appresi da un modello addestrato, così un modello di seconda tornata richiede ancora meno step di integrazione in fase di generazione.
Ecco perché i due termini compaiono fianco a fianco negli stessi paper. Sia Stable Diffusion 3 che Flux usano il flow matching con una scelta di percorso vicina al rectified flow. Ma trattare flow matching e rectified flow come intercambiabili fa perdere il punto. Il flow matching è il framework. Il rectified flow è uno dei percorsi che puoi scegliere al suo interno.
Il flow matching oggi alimenta alcuni dei più grandi sistemi generativi in produzione.
Tutto questo perché una loss di regressione è semplice da implementare e scalare. E poiché il percorso è una scelta di design, i team che costruiscono sistemi da miliardi di parametri possono sceglierne uno che richiede meno step di campionamento, e questo conta quando ogni step costa calcolo a quella scala.
Finora tutto era concettuale. Ora ti mostro la stessa idea su un dataset 2D reale, abbastanza piccolo da vedere ogni passaggio.
La distribuzione del rumore è una Gaussiana 2D standard, centrata all'origine. La distribuzione target sono tre cluster gaussiani disposti a triangolo: abbastanza semplice perché una piccola rete impari rapidamente, ma abbastanza strutturata da permetterti di capire se ha imparato bene.
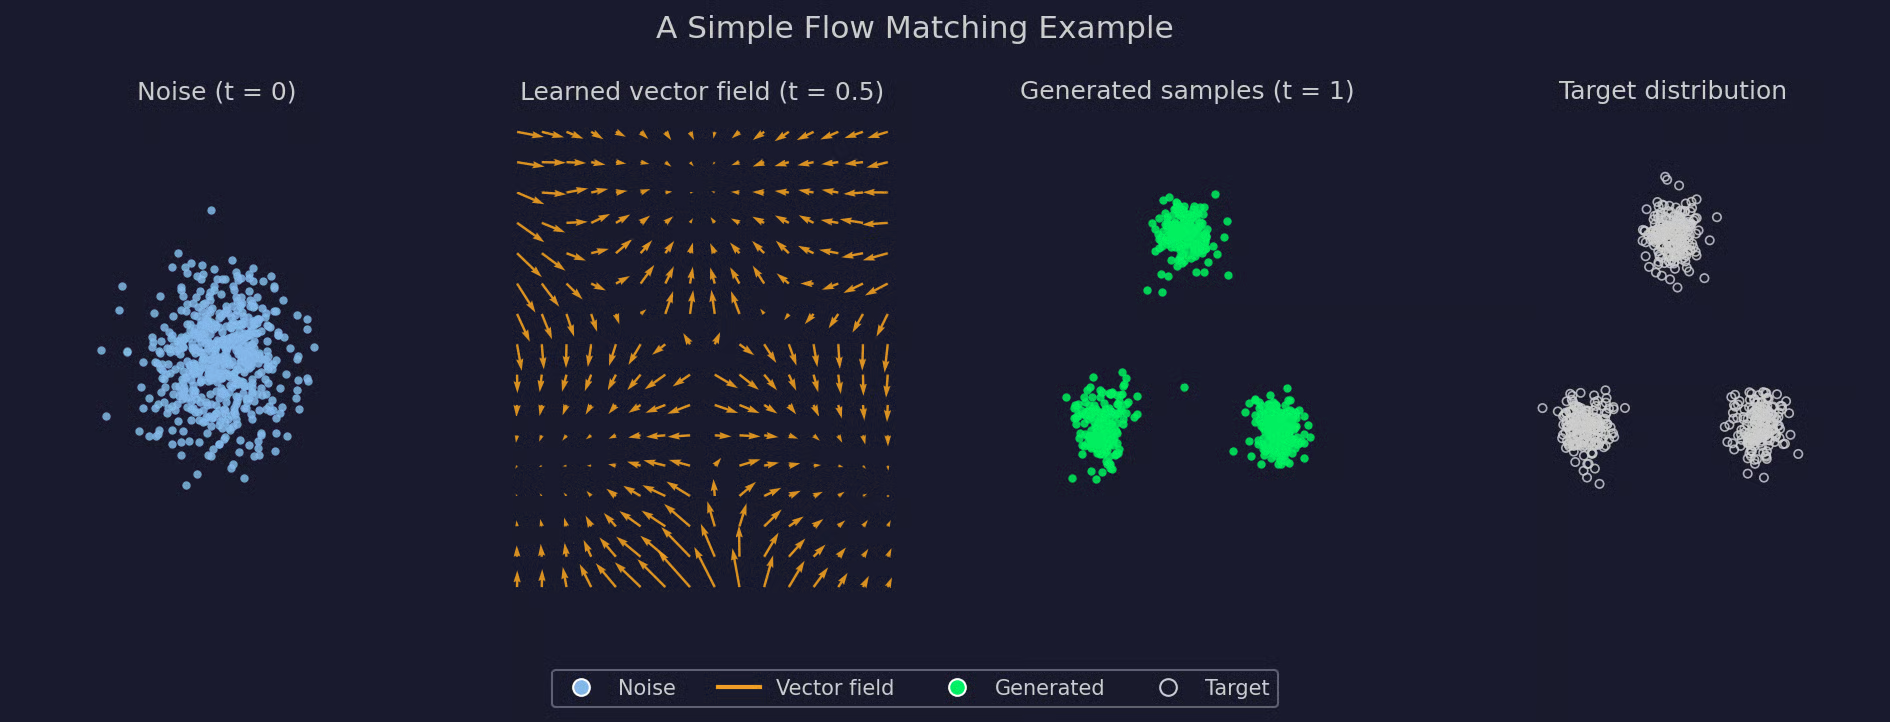
Semplice esempio di flow matching
Il primo pannello è il punto di partenza di ogni campione: rumore sparso senza struttura. Il secondo pannello è il campo vettoriale stesso, valutato su una griglia a metà training. Nota come le frecce puntino già verso uno dei tre cluster, ben prima che un campione ci arrivi. Il terzo pannello mostra cosa succede quando parti da rumore fresco e segui quel campo fino a t = 1: emergono tre cluster, che corrispondono quasi perfettamente al quarto pannello.
Nulla di tutto questo ha richiesto qualcosa che le sezioni precedenti non avessero già coperto: una distribuzione sorgente, una distribuzione target, un campo vettoriale appreso e un risolutore ODE che li collega. Passiamo al codice.
Ecco una piccola implementazione PyTorch dello stesso esempio, usando la stessa sorgente di rumore e il target a tre cluster.
Inizia con le due distribuzioni e come campionarle:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
La rete prende un punto e uno step temporale e predice una velocità:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Il training, a ogni step, campiona un batch di punti sorgente, punti target e istanti temporali, poi interpola tra i primi due e fa regressione sulla velocità risultante:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
La generazione risolve l'ODE appresa con la semplice integrazione di Eulero. Ti serve solo un ciclo che fa piccoli passi da t = 0 a t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`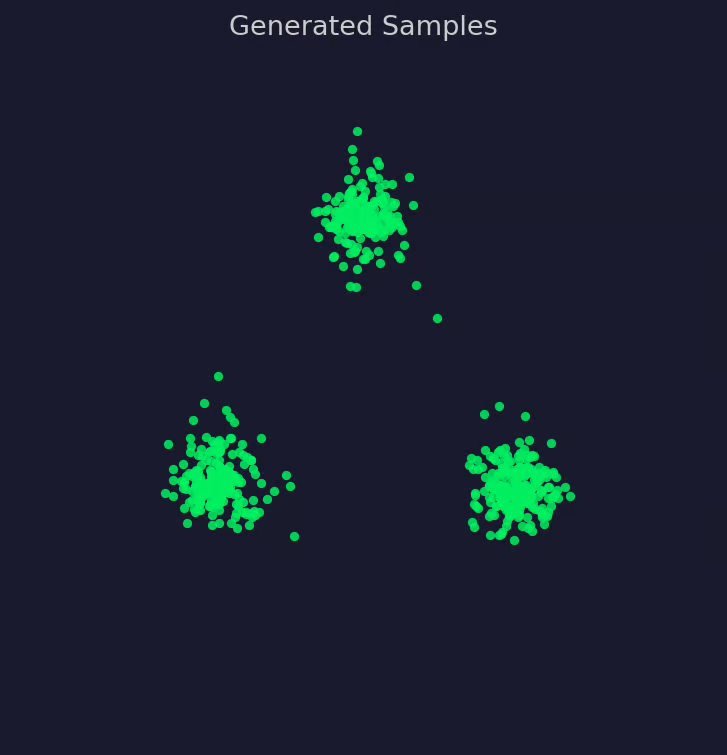
Visualizzazione dei campioni generati
Ed ecco l'intera pipeline! Campiona, interpola, regredisci, integra. Nulla cambia se usi una rete più grande, un percorso diverso o un dataset di dimensione superiore: cambia solo la scala.
Niente di tutto questo rende il flow matching un upgrade universale rispetto alla diffusione. È un compromesso, come qualsiasi altra scelta di design.
Ecco quando è una buona opzione e quando non lo è.
Il flow matching insegna a un modello come i campioni dovrebbero muoversi da una distribuzione semplice verso la distribuzione dei dati. Tutto il resto descritto in questo articolo esiste per rendere addestrabile questa singola idea.
Due idee fanno la maggior parte del lavoro. Un percorso di probabilità collega il rumore ai dati attraverso una sequenza di distribuzioni intermedie. Un campo vettoriale descrive come un campione dovrebbe muoversi in qualsiasi punto lungo quel percorso, in qualunque istante. La rete impara quel campo vettoriale, cioè la sua velocità, e generare significa semplicemente seguire il flusso risultante dal rumore ai dati.
Nulla di questo è separato da ciò che c'era prima. Il flow matching è il modo in cui i sistemi moderni addestrano i continuous normalizing flows senza il vecchio calcolo della likelihood, e i modelli di diffusione risultano essere un caso specifico di esso.
Se i modelli di diffusione, i normalizing flow o più in generale l'IA generativa ti interessano, ecco dove andare dopo:
Impara l'IA con DataCamp
Corso
Corso
Corso