Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
Você tem visto o termo "flow matching" em todo novo modelo de imagem e vídeo, mas não faz ideia do que significa?
Muitas explicações já começam com equações diferenciais ou resumem como "difusão, só que melhor". Nenhuma delas diz o que o modelo realmente aprende. Stable Diffusion 3 e Flux usam flow matching e geram imagens em poucas etapas, enquanto a difusão clássica precisa de dezenas.
A ideia geral é: em vez de aprender exemplos individuais, o modelo aprende um campo de velocidades que indica para qualquer amostra em que direção e a que velocidade ela deve se mover. Depois que você entende isso, o processo de treino, a matemática por trás e a relação com difusão passam a fazer sentido.
Neste artigo, vou apresentar a intuição por trás do flow matching, como ele é treinado, a matemática (de forma leve) e como ele se compara a modelos de difusão.
Se você é novo em IA para imagens, confira nosso Top 10 Vision Language Models em 2026 para conhecer os modelos de ponta em raciocínio visual, análise de imagem e visão computacional.
Flow matching é um objetivo de treinamento, não uma arquitetura de modelo.
Essa distinção é importante porque você pode combiná-lo com um transformer ou praticamente qualquer outra rede — o que define o flow matching é o que a rede é treinada para prever, não como ela é construída.
E o que ela aprende a prever é um campo vetorial dependente do tempo. Em bom português, é uma função que indica em cada ponto do caminho da distribuição de origem até a distribuição-alvo em que direção e a que velocidade a amostra deve se mover. Quando você treina continuous normalizing flows desse jeito, obtém um modelo que transforma uma distribuição simples em uma complexa, passo a passo.
Gosto de resumir a intuição em quatro ideias:
Se você aprende melhor de forma visual, imagine uma nuvem de partículas espalhadas e desordenadas. O flow matching ensina a cada partícula exatamente para onde e a que velocidade se mover, de modo que, com o tempo, a nuvem toda se organiza em um padrão estruturado (o formato da sua distribuição-alvo).
Ao aplicar isso em um dataset de imagens, "padrão estruturado" vira uma foto coerente em vez de ruído aleatório.
Treinamento e geração são fases separadas aqui, e muita confusão começa quando as pessoas acham que são a mesma coisa.
Durante o treinamento:
t aleatório entre 0 e 1t, com base em um caminho de probabilidade que conecta os doist, com base no caminho escolhidoA geração não precisa do ponto de dados.
Você parte do ruído e integra o campo vetorial aprendido ao longo do tempo, um pequeno passo por vez, até chegar a uma amostra da distribuição de dados.
E é isso — você prevê velocidade no treinamento e a segue na geração.
Duas ideias sustentam o objetivo de flow matching: campos vetoriais e caminhos de probabilidade. Entendendo isso, a função de perda na próxima seção fica clara.
O campo vetorial é o que a rede prevê. Em qualquer ponto do espaço e em qualquer instante, ele fornece uma direção e uma velocidade — o modo como uma amostra nesse ponto deve se mover para se aproximar da distribuição de dados.
Por exemplo, imagine-se em um rio. Onde quer que você esteja, a correnteza te empurra de um certo jeito, e a intensidade e direção dependem da sua posição exata e do momento. Um campo vetorial faz o mesmo com suas amostras — atribui direção e velocidade a cada ponto no espaço, em cada instante de tempo.
Um caminho de probabilidade é a sequência de distribuições pelas quais uma amostra passa ao ir do ruído aos dados. Em t = 0, você amostra da distribuição de origem, geralmente ruído Gaussiano. Em t = 1, você amostra da distribuição de dados-alvo. Tudo entre esses dois pontos são distribuições intermediárias, e o caminho de probabilidade descreve como uma vira a outra.
O campo vetorial e o caminho de probabilidade estão diretamente conectados, porque o campo vetorial move as amostras ao longo do caminho, de uma distribuição intermediária para a próxima, até chegarem na distribuição de dados.
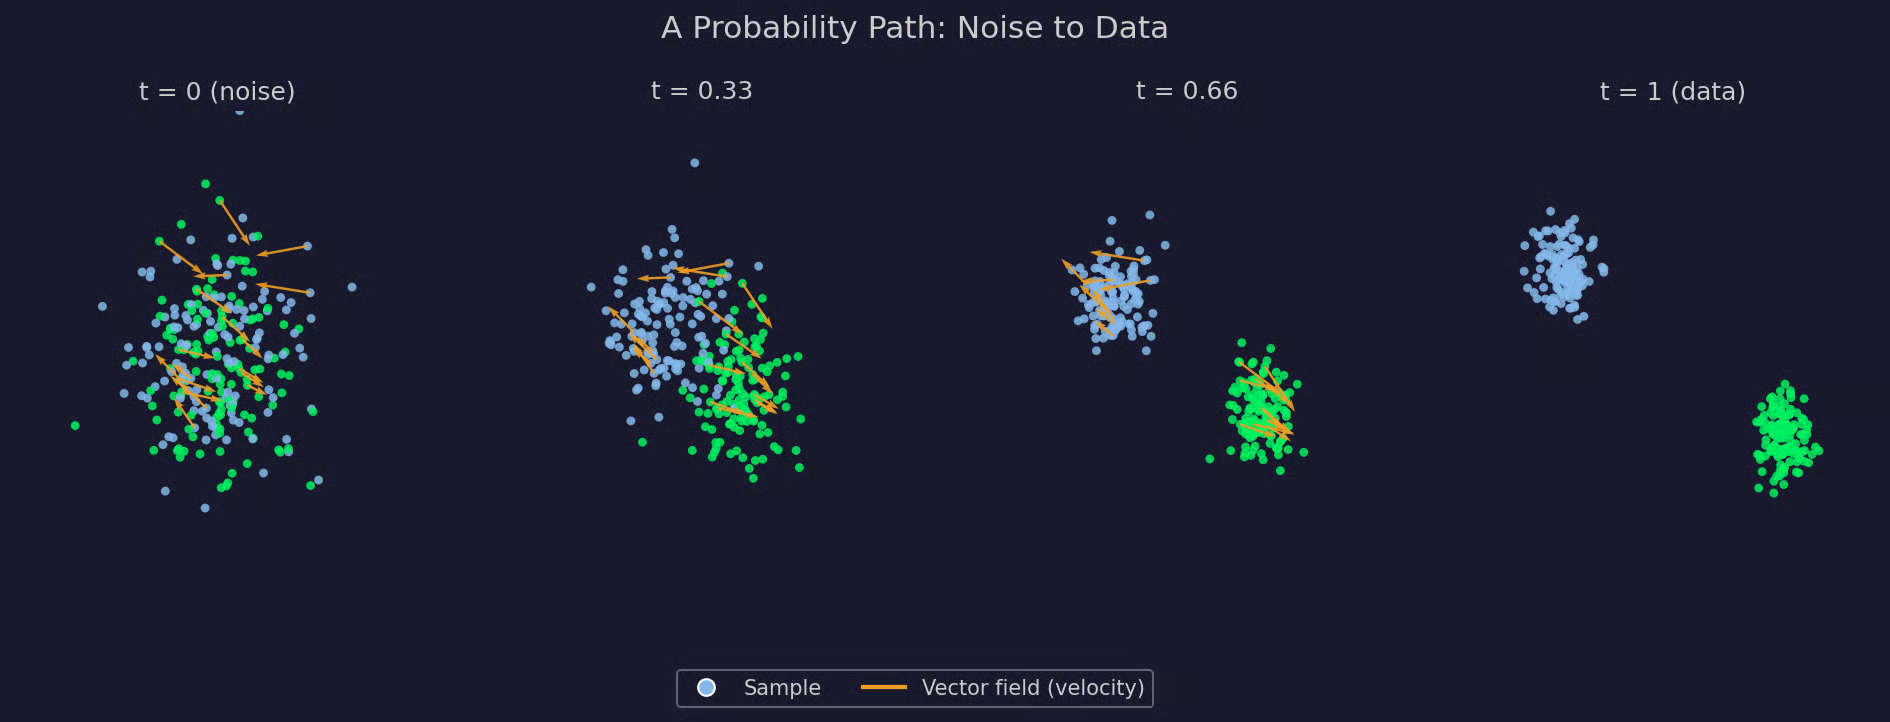
Diagrama de um caminho de probabilidade
O objetivo de flow matching transforma campos vetoriais e caminhos de probabilidade em uma única perda de regressão.
Cada passo de treino compara duas velocidades. A primeira é a velocidade-alvo — a direção e a velocidade que uma amostra deve ter naquele ponto do caminho de probabilidade escolhido. A segunda é a velocidade prevista pelo modelo — o palpite da rede para a mesma direção e velocidade, com base na amostra e no tempo atuais. O treinamento faz essas duas coincidirem o máximo possível.
Aqui está a função de perda:
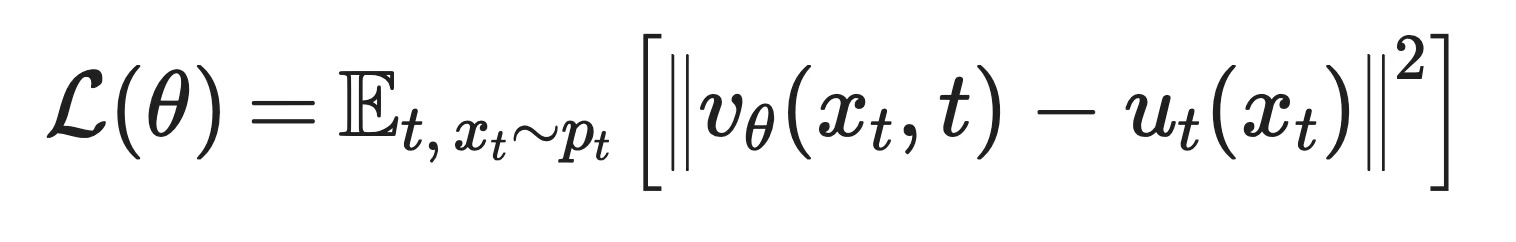
Função de perda de flow matching
O que cada termo significa:
v_θ(x_t, t): a velocidade prevista pelo modelo no ponto x_t e no tempo t
u_t(x_t): a velocidade-alvo nesse mesmo ponto e tempo, baseada no caminho de probabilidade escolhido
𝔼[...]: uma média sobre muitos valores aleatórios de t e x_t
‖ · ‖^2: a diferença ao quadrado entre as duas velocidades — erro quadrático médio
A demonstração completa não é o foco aqui. O que importa é que a rede prevê um único vetor em um ponto e tempo específicos, e você o compara com um alvo conhecido. Só isso!
O caminho de probabilidade marginal que conecta toda a distribuição de ruído a toda a distribuição de dados não é algo que você consiga escrever diretamente.
Calcular a velocidade-alvo em um ponto requer considerar cada amostra de dados que poderia tê-lo gerado — uma integral sobre todo o seu dataset, inviável de computar a cada passo de treino.
O conditional flow matching resolve isso condicionando em pares individuais, em vez do caminho completo. Em vez de calcular o campo vetorial para todo o caminho marginal, você escolhe um único ponto de dados e um único ponto de ruído e constrói um caminho de probabilidade só para esse par. Quando esse caminho condicional é simples — por exemplo, uma linha reta entre os dois pontos — a velocidade-alvo tem expressão fechada e pode ser computada diretamente.
Treinar a rede nessas velocidades condicionais simples, em muitos pares e fazendo a média, leva ao mesmo campo vetorial que o objetivo marginal intratável buscaria. Você nunca calcula diretamente o caminho marginal — em vez disso, o aproxima indiretamente, um caminho condicional fácil por vez.
Essa versão condicional é a que quase todo mundo treina na prática. A formulação marginal fecha a conta na matemática, mas a condicional é a que funciona no dia a dia.
Difusão e flow matching vivem sendo comparados por um bom motivo — a maioria dos "modelos de difusão" que você conhece hoje roda com objetivo de flow matching. Isso não significa que o flow matching substituiu a difusão. Significa que a difusão é um caso específico dentro de um arcabouço maior, e o flow matching é a versão geral.
Começando pelo que cada rede prevê. Um modelo de difusão prevê o ruído. Dada uma amostra ruidosa e um passo de tempo, ele prevê o ruído que foi adicionado e o remove, etapa a etapa. Já o flow matching prevê uma velocidade. Dada uma amostra e um passo de tempo, ele prevê em que direção e a que velocidade essa amostra deve se mover rumo à distribuição de dados.
Onde mais diferem é no caminho de probabilidade.
Modelos de difusão fixam um processo específico de ruidificação, geralmente adicionando ruído Gaussiano em um cronograma fixo — e todo o resto deriva dessa escolha. No flow matching, você escolhe qualquer caminho que conecte ruído a dados, e o objetivo funciona do mesmo jeito, independentemente da escolha. Um caminho Gaussiano ao estilo difusão é uma opção. Uma linha reta entre ruído e dados é outra — e isso impacta bastante a velocidade de amostragem.
Essas duas previsões não são tão diferentes quanto parecem.
A previsão de ruído de um modelo de difusão e a previsão de velocidade de um modelo de flow matching são duas visões do mesmo objeto subjacente, conectadas pelo score da distribuição em cada instante. Onde diferem é na geração. A amostragem por difusão é estocástica por padrão, ou seja, cada etapa de denoising adiciona um pouco de aleatoriedade (embora existam variantes determinísticas como DDIM). O flow matching segue o oposto — sua formulação natural é uma EDO determinística, então o mesmo ruído inicial produz sempre a mesma saída, e também existem versões estocásticas desse lado.
Em ambos os casos, amostrar significa resolver uma equação diferencial passo a passo, movendo-se do ruído até os dados.
Modelos de difusão costumam precisar de dezenas de passos, a menos que você use amostradores rápidos ou destilação. Já o flow matching, especialmente quando treinado com caminhos retos, tende a precisar de bem menos passos sem nada disso — um caminho reto tem velocidade constante, o que é bem mais fácil para um solver seguir com precisão do que um caminho curvo.
O próprio caminho é onde o flow matching sai na frente.
Modelos de difusão ficam limitados ao processo de ruído que os gerou. O flow matching trata o caminho como uma decisão de design, e escolhas diferentes trazem trade-offs diferentes.
|
Modelos de difusão |
Flow matching |
|
|
O que a rede prevê |
Ruído adicionado em cada etapa |
Velocidade rumo à distribuição de dados |
|
Caminho de probabilidade |
Fixo por um processo específico de ruído |
Escolhido livremente; linhas retas são comuns |
|
Objeto subjacente |
Score da distribuição ruidosa |
Campo vetorial dependente do tempo, ligado ao score |
|
Geração |
Estocástica por padrão, com variantes determinísticas |
Determinística por padrão, com variantes estocásticas |
|
Passos de amostragem |
Frequentemente dezenas sem truques extras |
Geralmente bem menos, especialmente com caminhos mais retos |
|
Escolha do caminho |
Definida pelo processo direto |
Uma escolha de design — difusão é um caso particular |
Flow matching comparado a modelos de difusão
Difusão não é o único método comparado ao flow matching. Há mais três que vale conhecer
Os continuous normalizing flows vieram primeiro, e o flow matching nasceu diretamente dos problemas de treiná-los.
Um continuous normalizing flow é o tipo de modelo que o flow matching produz — uma rede que define uma transformação contínua entre distribuições via uma EDO. Treinar do jeito original significava resolver essa EDO adiante e computar a verossimilhança exata a cada passo, acompanhando como a transformação altera a densidade de probabilidade ao longo do caminho. Esse cálculo é caro e piora conforme a rede cresce.
O flow matching evita tudo isso. Ele faz regressão direta para uma velocidade-alvo conhecida, em vez de resolver a EDO e calcular verossimilhança durante o treino. Não há simulação necessária. Você ainda termina com um continuous normalizing flow, só não paga o custo de treinamento de antes para chegar lá.
Score matching treina uma rede para prever o score — o gradiente do log da densidade de probabilidade — em cada nível de ruído. Esse é o objetivo por trás dos modelos de difusão que você já conhece.
Flow matching treina uma rede para prever uma velocidade. Os dois objetos são relacionados matematicamente, o que significa que, sob certas escolhas de caminho, dá para converter um no outro. Mas eles representam coisas diferentes. O score descreve o formato da distribuição de probabilidade em um instante fixo. A velocidade descreve como uma amostra deve se mover conforme o tempo muda.
Score matching fala de geometria. Flow matching fala de movimento.
Rectified flow é uma escolha específica dentro do flow matching.
O flow matching permite escolher qualquer caminho de probabilidade que conecte ruído a dados. O rectified flow escolhe um — linhas retas — e vai além com um procedimento iterativo chamado "reflow", que endireita os caminhos que um modelo já aprendeu, para que um segundo modelo precise de ainda menos passos de integração na hora de gerar.
É por isso que os dois termos aparecem lado a lado nos mesmos artigos. Stable Diffusion 3 e Flux usam flow matching com algo próximo a um caminho de rectified flow. Mas tratar flow matching e rectified flow como sinônimos perde o ponto. Flow matching é o arcabouço. Rectified flow é uma das escolhas de caminho dentro dele.
Hoje, o flow matching está por trás de alguns dos maiores sistemas generativos em produção.
Tudo isso porque uma perda de regressão é simples de implementar e escalar. E, como o caminho é uma escolha de design, times que constroem sistemas com bilhões de parâmetros podem optar por um que exija menos passos de amostragem — o que importa quando cada passo custa compute nessa escala.
Até aqui foi conceitual. Agora vou mostrar a mesma ideia rodando em um dataset 2D real, pequeno o bastante para ver cada etapa.
A distribuição de ruído é uma Gaussiana 2D padrão, centrada na origem. A distribuição-alvo são três aglomerados Gaussianos formando um triângulo — simples o suficiente para uma rede pequena aprender rápido, mas estruturado o bastante para você saber se aprendeu direito.
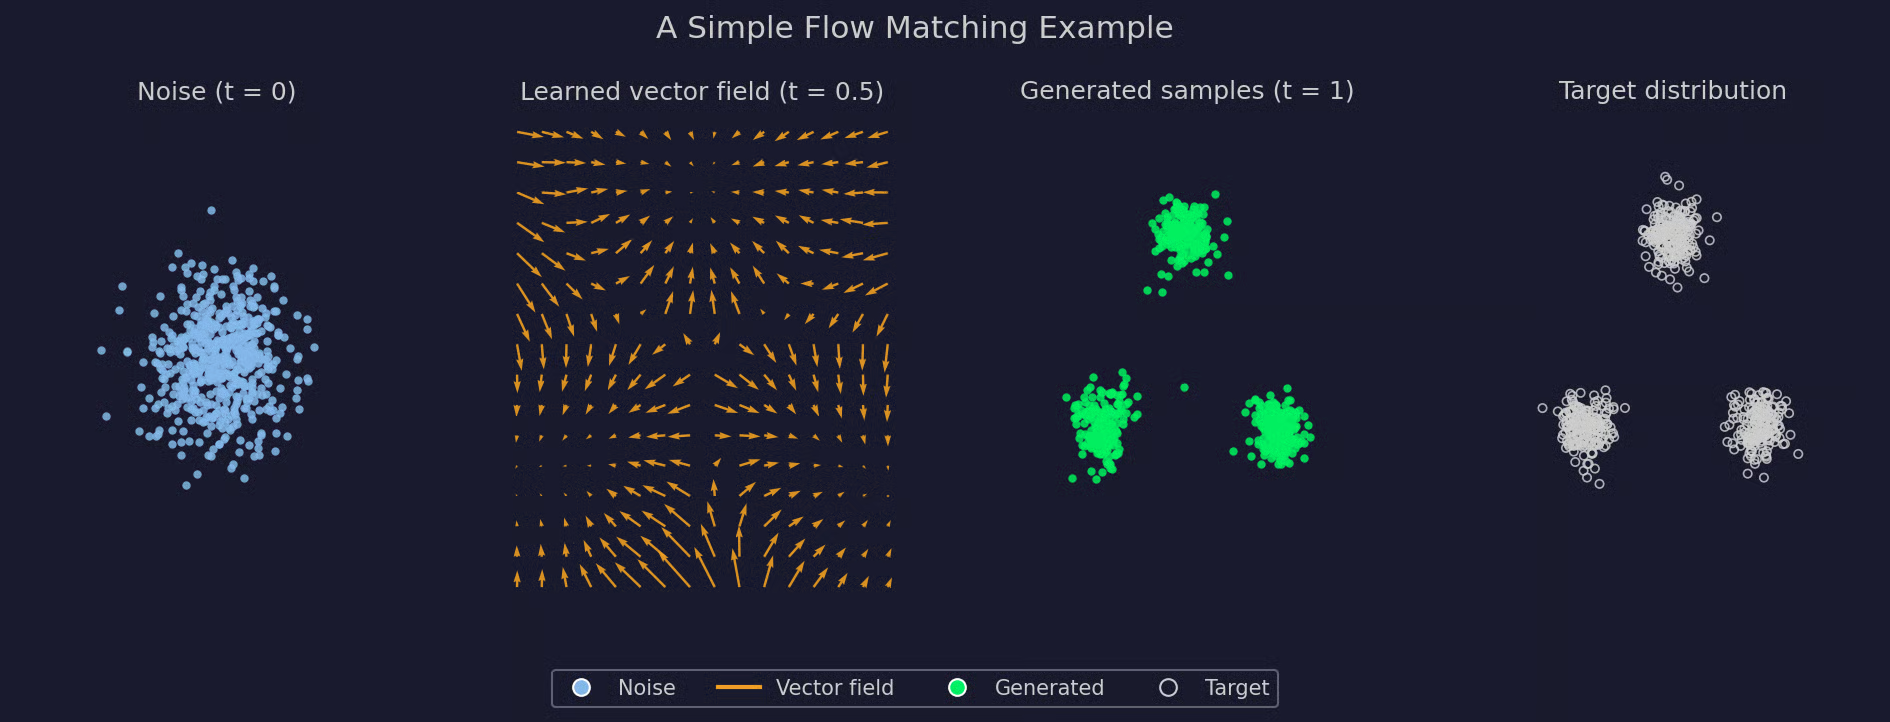
Exemplo simples de flow matching
O primeiro painel mostra de onde tudo começa — ruído espalhado sem estrutura. O segundo painel é o próprio campo vetorial, avaliado em uma grade no meio do treinamento. Note como as setas já apontam para um dos três aglomerados, bem antes de qualquer amostra chegar lá. O terceiro painel mostra o que acontece quando você parte de ruído novo e segue esse campo até t = 1 — três aglomerados emergem, casando quase perfeitamente com o quarto painel.
Nada disso envolve algo além do que já cobrimos — uma distribuição de origem, uma distribuição-alvo, um campo vetorial aprendido e um solver de EDO conectando os três. Vamos ao código.
Aqui vai uma implementação pequena em PyTorch do mesmo exemplo, usando a mesma fonte de ruído e alvo de três aglomerados.
Comece definindo as duas distribuições e como amostrá-las:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
A rede recebe um ponto e um passo de tempo e prevê uma velocidade:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
O treinamento amostra um lote de pontos de origem, pontos-alvo e passos de tempo a cada iteração, depois interpola entre os dois primeiros e faz regressão para a velocidade resultante:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
A geração resolve a EDO aprendida com integração de Euler. Basta um loop que dá passos pequenos de t = 0 até t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`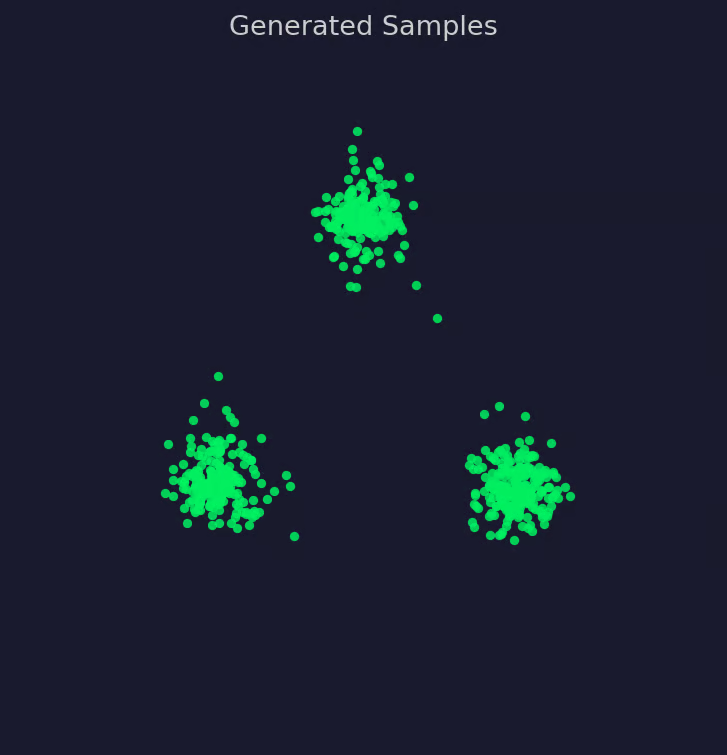
Visualização de amostras geradas
E esse é o pipeline inteiro! Amostrar, interpolar, regredir, integrar. Nada muda se você usar uma rede maior, um caminho diferente ou um dataset de maior dimensão — só a escala.
Nada disso torna o flow matching um upgrade universal sobre a difusão. É um trade-off, como qualquer decisão de design.
Veja onde ele é uma boa opção — e onde não é.
Flow matching ensina um modelo como as amostras devem se mover de uma distribuição simples até a distribuição de dados. Todo o resto que descrevi existe para tornar essa ideia treinável.
Duas ideias fazem quase todo o trabalho aqui. Um caminho de probabilidade conecta ruído a dados por uma sequência de distribuições intermediárias. Um campo vetorial descreve como uma amostra deve se mover em qualquer ponto ao longo desse caminho, em qualquer instante. A rede aprende esse campo vetorial — sua velocidade — e a geração é apenas seguir o fluxo resultante do ruído até os dados.
Nada disso está separado do que veio antes. O flow matching é como sistemas modernos treinam continuous normalizing flows sem o cálculo antigo de verossimilhança, e os modelos de difusão acabam sendo um caso específico dentro dele.
Se modelos de difusão, normalizing flows ou IA generativa de forma mais ampla te interessam, aqui estão os próximos passos:
Aprenda IA com a DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
11 min
blog
Javier Canales Luna
8 min
blog
Abid Ali Awan
5 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
12 min