Courses
理解 Artificial Intelligence
2小时
421.5K
您是否在每个新图像和视频模型旁都看到“flow matching”这个术语,却不知道它究竟是什么意思?
大多数解释要么直接跳进微分方程,要么把它说成“更好的扩散”。两者都没有说明模型到底学到了什么。Stable Diffusion 3 和 Flux 都采用 flow matching,它们只需几步就能生成图像,而经典扩散往往需要几十步。
核心思想是:模型不是学习单个样本,而是学习一个速度场,告诉任意样本应该往哪个方向、以多快的速度移动。一旦理解了这一点,训练流程、背后的数学以及它与扩散的关系就都顺理成章了。
本文将带您直观理解 flow matching、它的训练方式、必要的数学(尽量浅显),以及它与扩散模型的比较。
如果您刚接触图像方向的 AI,欢迎阅读我们的2026 年十大视觉语言模型,了解视觉推理、图像分析与计算机视觉的最新前沿。
Flow matching 是一种训练目标,而不是模型架构。
这个区分很重要,因为它可以与 Transformer 或几乎任何其他网络搭配使用——之所以称为 flow matching,关键在于网络被训练去预测什么,而不是网络长什么样。
它被训练去预测的是一个与时间相关的向量场。通俗地说,这个函数会在样本从源分布到目标分布的路径上,每个位置告诉您应当往哪个方向、以多快的速度移动。如果用这种方式来训练连续归一化流,您会得到一个模型,能把简单分布一步步变成复杂分布。
我喜欢把直觉拆成四点:
如果您更偏视觉化,不妨想象一团杂乱无章的粒子云。Flow matching 会教会每个粒子准确的移动方向与速度,使整团粒子随着时间推移沉降成有结构的图案(也就是目标分布的形状)。
在图像数据集上,“有结构的图案”意味着从随机噪声变成一张连贯的照片。
这里训练与生成是两个独立阶段,而很多困惑源于人们把它们混为一谈。
在训练期间:
tt 将数据点与噪声样本组合起来t 应有的方向与速度生成阶段不需要数据点。
从噪声出发,沿学到的向量场按时间向前积分,一小步一小步,直到得到来自数据分布的样本。
这就是要点——训练时预测速度,生成时跟随速度。
支撑 flow matching 目标的两个关键概念是向量场与概率路径。理解它们后,下一节的损失函数就容易多了。
向量场是网络要预测的对象。在空间中的任一点、任一时刻,它都会给出一个方向与速度——即该点的样本应如何移动,才能更接近数据分布。
例如,想象站在河里。无论您站在哪,水流都会以某种方向、以某种力度推动您,这取决于您的具体位置与当下时刻。向量场对样本做的是同样的事——在每个时空点分配一个方向与速度。
概率路径是样本从噪声走向数据过程中所经历的一系列分布。在 t = 0,您从源分布(通常是高斯噪声)采样;在 t = 1,您从目标数据分布采样。二者之间都是中间分布,而概率路径描述了它们如何逐步演化。
向量场与概率路径直接相关,因为向量场会沿着概率路径推动样本,从一个中间分布前进到下一个,直到到达数据分布。
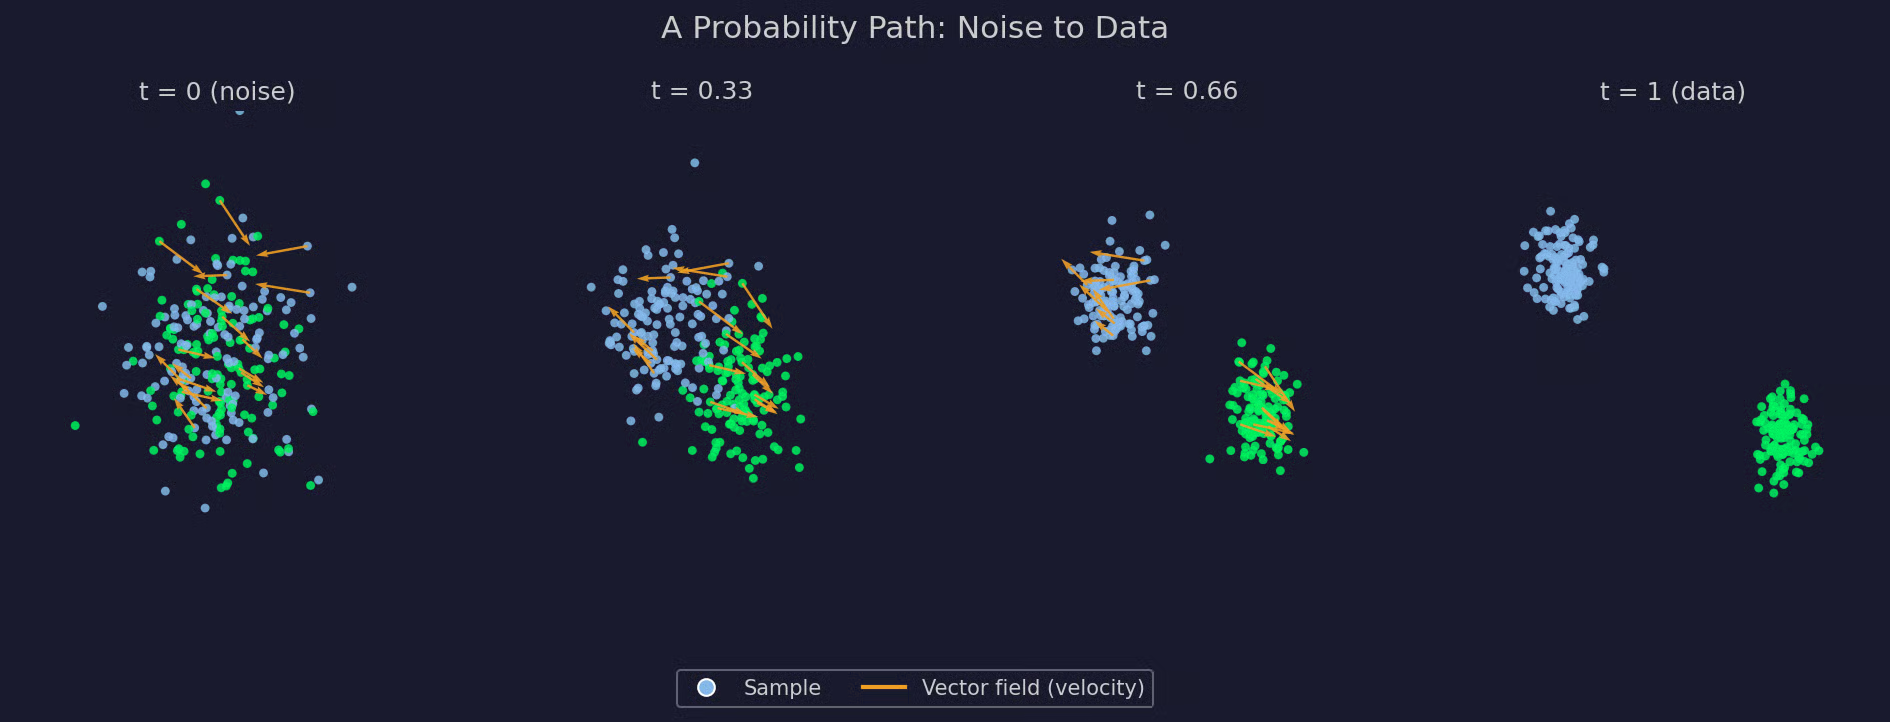
概率路径示意图
Flow matching 训练目标把向量场与概率路径合并成一个回归损失。
每次训练都会比较两个速度:其一是目标速度——即样本沿所选概率路径在该点应有的方向与速度;其二是模型预测速度——网络基于当前样本与时间对同一方向与速度的估计。训练的目标就是让二者尽可能一致。
损失函数如下:
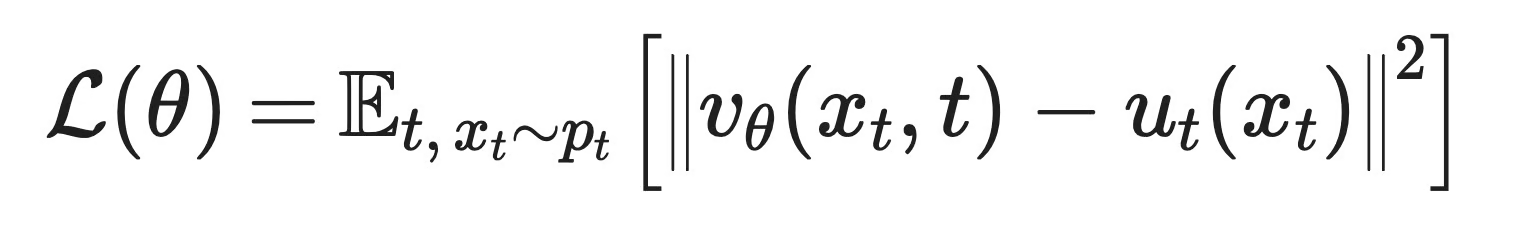
Flow matching 损失函数
各项含义如下:
v_θ(x_t, t):模型在点 x_t 与时间 t 的预测速度
u_t(x_t):基于所选概率路径,在同一时空点的目标速度
𝔼[...]:对许多随机 t 与 x_t 的期望(平均)
‖ · ‖^2:两种速度之间的平方差——即均方误差
完整推导在这里并不重要。关键在于:网络在某个时空点预测一个向量,然后与一个已知目标比较。就是这样!
连接完整噪声分布与完整数据分布的边缘概率路径并不能直接写出来。
在某个点上计算目标速度意味着要考虑所有可能产生该点的数据信息——对整个数据集积分,没人会在每步训练时去算这个。
条件 flow matching 通过对单个样本进行条件化来解决这一问题。与其计算整条边缘路径的向量场,不如选取单个数据点与单个噪声点,只为这一对点构造一条概率路径。若把这条条件路径设得足够简单,例如用两点之间的直线,那么目标速度就有闭式表达,可以直接计算。
在足够多的样本对上,针对这些简单的“逐对”条件速度进行训练并求平均,能得到与不可解的边缘目标相同的向量场。您从不直接计算边缘路径——而是一次一个简单的条件路径,间接逼近它。
几乎所有人实际训练的都是这个条件版本。边缘形式使得数学自洽,而条件形式才是工程上可行的。
扩散与 flow matching 之所以总被比较,有充分理由——您所熟知的大多数“扩散模型”如今都使用 flow matching 目标。但这并不意味着 flow matching 取代了扩散;而是说明扩散是更大框架中的一个特例,而 flow matching 是其更一般的形式。
先说各自的预测对象。扩散模型预测的是噪声。给定一个带噪样本与时间步,它预测被混入的噪声,并逐步去除。Flow matching 则预测速度。给定一个样本与时间步,它预测该样本朝数据分布应移动的方向与速度。
二者最不同的是概率路径。
扩散模型会预先固定一种特定的加噪过程,通常是在固定日程上添加高斯噪声,其它一切都由这一选择导出。Flow matching 则可以任选一条连接噪声与数据的路径,无论选择哪条,目标的形式都相同。扩散式高斯路径是一种选择;噪声与数据之间的直线是另一种,而且它对采样速度影响很大。
这两种预测并没有看起来那么不同。
扩散模型的噪声预测与 flow matching 模型的速度预测是同一底层对象的两种视角,它们通过每个时刻分布的 score(对数密度的梯度)相互联系。不同之处在于生成过程。扩散的采样默认是随机的,即每一步去噪都会再加入一些随机性(尽管也有 DDIM 等确定性变体)。Flow matching 的自然形式则是确定性的 ODE,因此相同的起始噪声每次都会产生相同输出,同时其随机变体也存在。
在两种方法中,采样都意味着逐步求解微分方程,从噪声朝数据前进。
扩散模型往往需要几十步,除非使用快速采样器或蒸馏。Flow matching 尤其在直线路径训练时,通常无需这些技巧就能用更少步数——直线路径对应恒定速度,比曲线路径更容易被求解器准确跟随。
路径本身是 flow matching 领先的地方。
扩散模型受限于其推导出的加噪过程。Flow matching 把路径当作一个设计选择,不同选择对应不同权衡。
|
扩散模型 |
Flow matching |
|
|
网络预测什么 |
每一步添加的噪声 |
朝向数据分布的速度 |
|
概率路径 |
由特定加噪过程固定 |
可自由选择;常用直线路径 |
|
底层对象 |
带噪分布的 score |
与时间相关的向量场,与 score 相联系 |
|
生成方式 |
默认随机,但存在确定性变体 |
默认确定,但存在随机性变体 |
|
采样步数 |
通常需要几十步,若无额外技巧 |
往往更少,尤其在更直的路径下 |
|
路径选择 |
由前向过程固定 |
开放的设计选择——扩散是其中一例 |
Flow matching 与扩散模型对比
被拿来比较的并不只有扩散。还有三种方法值得了解:
连续归一化流更早提出,而 flow matching 正是由其训练问题演化而来。
连续归一化流正是 flow matching 产出的那类模型——通过 ODE 定义分布间的连续变换的网络。按最初方式训练意味着在前向上求解这条 ODE,并在每一步计算精确似然,也就是跟踪变换如何改变概率密度。这一计算代价很高,并且网络越大越昂贵。
Flow matching 避免了这些。它直接对已知目标速度做回归,而不是在训练时求解 ODE 与计算似然。无需模拟。最终您依然得到连续归一化流,只是省去了早先的训练成本。
Score matching 训练网络去预测 score——即对数概率密度的梯度——在各个噪声水平下的值。这正是您熟悉的扩散模型背后的目标。
Flow matching 则训练网络去预测速度。二者在数学上相关,在某些路径选择下可以互相转换,但它们表征的事物不同。Score 描述在某一时刻概率分布的形状;速度描述的是时间变化中样本应如何运动。
Score matching 关注几何,flow matching 关注运动。
Rectified flow 是 flow matching 框架内的一个具体选择。
Flow matching 允许您任选连接噪声与数据的概率路径。Rectified flow 选择了其中一种——直线,并更进一步,使用称为“reflow”的迭代过程,把已训练模型学到的路径拉直,于是第二轮模型在生成时需要更少的积分步数。
因此这两个术语常在同一论文中并列出现。Stable Diffusion 3 与 Flux 都使用接近 rectified flow 的路径选择来进行 flow matching。但把 flow matching 与 rectified flow 视为可互换就错了。Flow matching 是框架,rectified flow 是其中的一种路径选择。
如今,flow matching 已运行在一些最大的生成系统中。
这一切源于回归损失易于实现、易于扩展。而且既然路径是设计选择,构建百亿参数系统的团队就能挑选需要更少采样步数的路径——在这种规模下,每一步都要消耗算力,这点尤为重要。
上面都是概念。现在我用一个真实的二维数据集演示同样的思想,小到可以看清每一步。
噪声分布是标准二维高斯,中心在原点。目标分布是三个高斯簇,呈三角形分布——足够简单,便于小网络快速学习,也足够有结构,便于判断是否学对了。
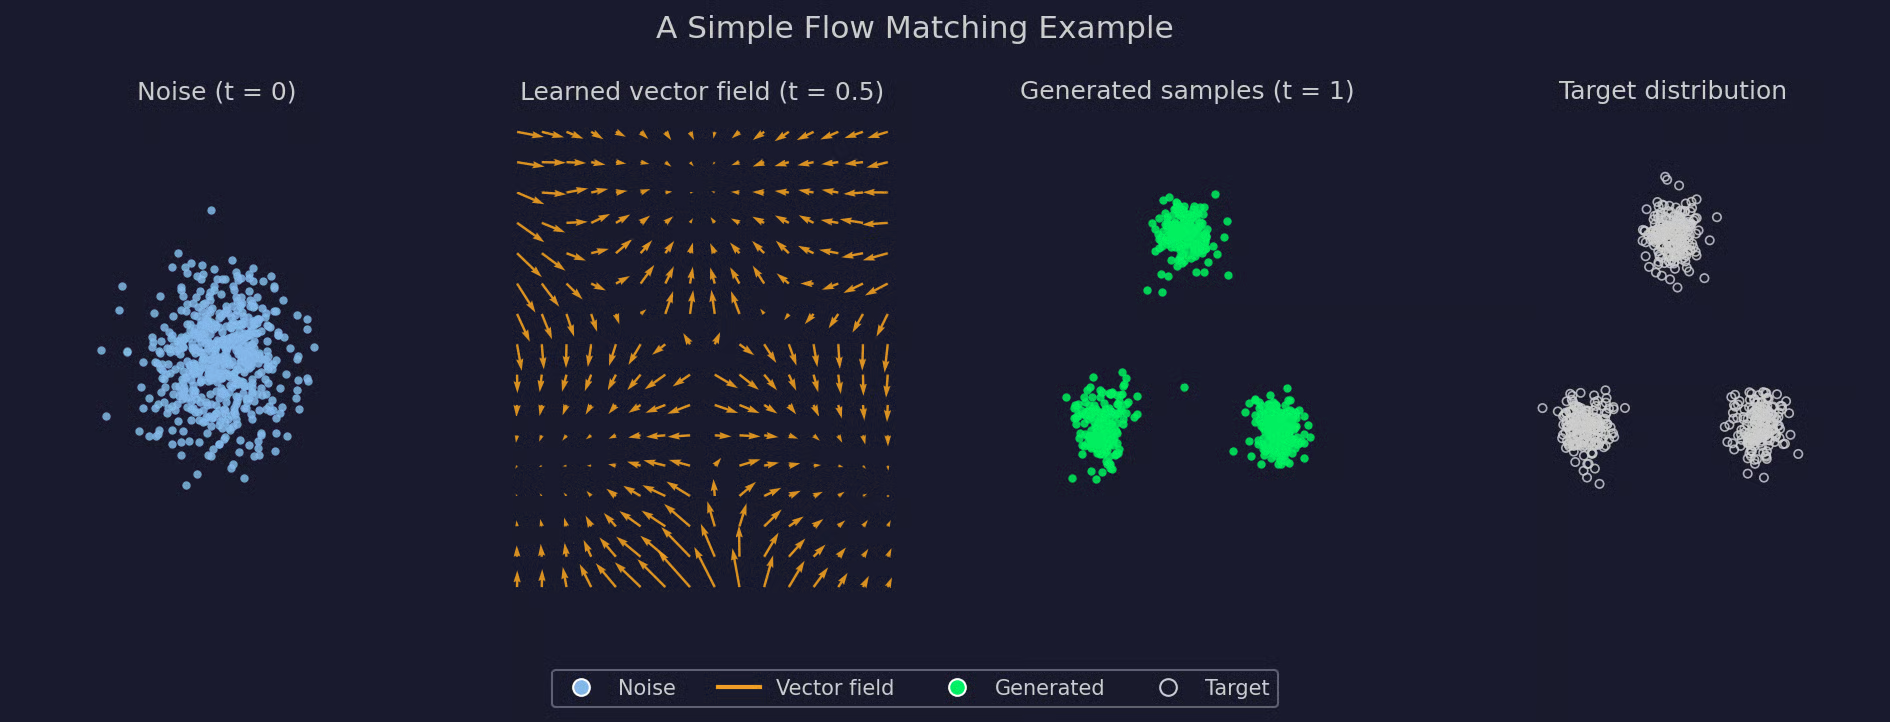
简单的 flow matching 示例
第一幅图是所有样本的起点——杂乱无章的噪声。第二幅图是向量场本身,在训练中点于网格上评估。注意箭头在样本抵达之前就已指向三个簇之一。第三幅图展示从新的噪声出发,沿着该场一路前进到 t = 1 会发生什么——出现三个簇,与第四幅图几乎完美吻合。
上述过程并未超出前文所述——源分布、目标分布、学习到的向量场,以及把三者连接起来的 ODE 求解器。下面上代码。
下面是一个小型的 PyTorch 实现,使用相同的噪声源与三簇目标。
先定义两个分布以及如何采样:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
网络接收一个点与一个时间步,并预测一个速度:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
训练在每一步采样一批源点、目标点与时间步,然后在前两者之间插值,并回归到得到的速度上:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
生成阶段用最简单的欧拉法求解学到的 ODE。只需一个从 t = 0 到 t = 1 小步推进的循环:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`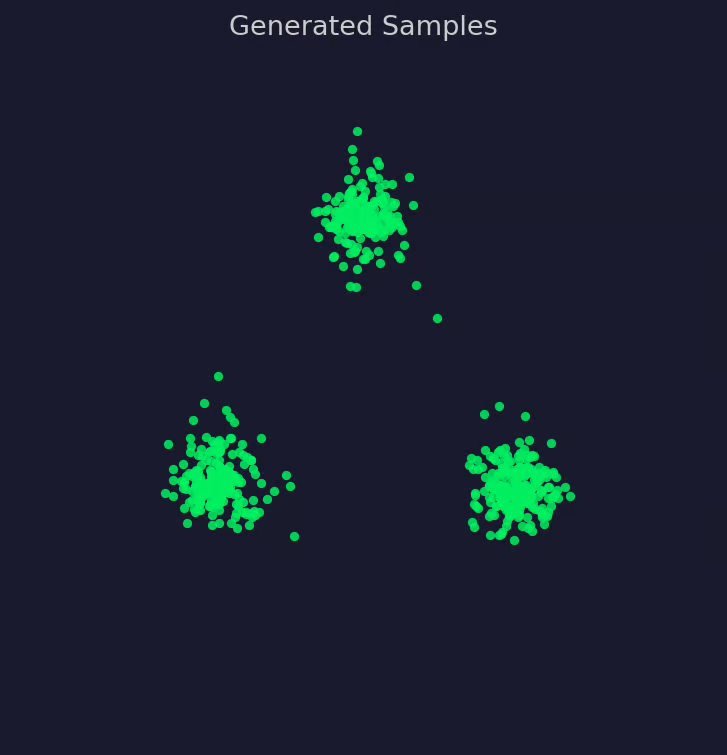
生成样本可视化
这就是完整流程!采样、插值、回归、积分。若换更大的网络、不同路径或更高维的数据集,方法不变,只是规模不同。
这并不意味着 flow matching 对扩散是全面升级。它同样是一种取舍,与其他设计选择别无二致。
下面是它适用与不适用的场景。
Flow matching 教会模型样本应如何从简单分布朝数据分布移动。本文其余内容都是为了让这一核心思想可训练。
两个概念起到了主要作用。概率路径通过一系列中间分布将噪声连接到数据;向量场在路径上任一点、任一时刻刻画样本应如何移动。网络学到的就是这个向量场(即速度),生成则是沿着学到的“流”从噪声走向数据。
这些并不脱离既有方法。Flow matching 让现代系统无需旧式似然计算便能训练连续归一化流,而扩散模型则是其中的一个特例。
如果扩散模型、归一化流或更广义的生成式 AI 引起了您的兴趣,接下来可以看看:
在 DataCamp 学习 AI
Courses
Courses
Courses