
Cursus
Artificial Intelligence begrijpen
2 Hr
421.5K
Zie je de term "flow matching" overal opduiken bij nieuwe beeld- en videomodellen, maar heb je geen idee wat het betekent?
Veel uitleg duikt direct de differentiaalvergelijkingen in of noemt het "diffusie, maar beter". Geen van beide vertelt je wat het model leert. Stable Diffusion 3 en Flux draaien allebei op flow matching, en zij genereren beelden in een paar stappen waar klassieke diffusie er tientallen nodig heeft.
Dit is het algemene idee: in plaats van individuele voorbeelden te leren, leert het model een snelheidsveld dat elke sample vertelt in welke richting en hoe snel te bewegen. Als je dat begrijpt, vallen het trainingsproces, de wiskunde erachter en de relatie met diffusie op hun plek.
In dit artikel neem ik je mee door de intuïtie achter flow matching, hoe je het traint, de wiskunde (licht gehouden) en hoe het zich verhoudt tot diffusiemodellen.
Ben je nieuw met AI voor beelddata? Lees dan onze Top 10 Vision Language Models in 2026 en ontdek de huidige state-of-the-art voor visueel redeneren, beeldanalyse en computer vision.
Flow matching is een trainingsdoel, geen modelarchitectuur.
Dat onderscheid is belangrijk, omdat je het kunt combineren met een transformer of bijna elk ander netwerk — wat het flow matching maakt is wat het netwerk leert voorspellen, niet hoe het netwerk eruitziet.
En wat het leert te voorspellen is een tijdsafhankelijk vectorveld. Simpel gezegd: een functie die je vertelt in welke richting en hoe snel een sample moet bewegen op elk punt langs zijn pad van de brondistributie naar de doeldistributie. Als je hiermee continuous normalizing flows traint, krijg je een model dat een eenvoudige distributie stap voor stap in een complexe verandert.
Ik vat de intuïtie graag samen in vier ideeën:
Als je meer visueel bent ingesteld, stel je dan een wolk van verspreide deeltjes zonder enige orde voor. Flow matching leert elk deeltje precies in welke richting en hoe snel te bewegen, zodat de hele wolk zich in de loop van de tijd tot een gestructureerd patroon vormt (de vorm van je doeldistributie).
Op een afbeeldingsdataset betekent "gestructureerd patroon" een coherent beeld in plaats van willekeurige ruis.
Training en generatie zijn hier twee aparte fasen, en verwarring ontstaat vaak wanneer mensen denken dat het hetzelfde is.
Tijdens het trainen:
t tussen 0 en 1t, gebaseerd op een waarschijnlijkheidspad dat de twee verbindtt moet hebben, op basis van het gekozen padGeneratie heeft het datapunt niet nodig.
Je begint vanuit ruis en integreert het geleerde vectorveld vooruit in de tijd, stap voor stap, totdat je een sample uit de datadistributie krijgt.
En dat is het idee — je voorspelt snelheid tijdens het trainen, en volgt die tijdens de generatie.
Twee ideeën doen het meeste werk achter het flow-matching-doel — vectorvelden en waarschijnlijkheidspaden. Als je die begrijpt, is de verliesfunctie in de volgende sectie logisch.
Een vectorveld is wat het netwerk voorspelt. Op elk punt in de ruimte en elk moment in de tijd geeft het je een richting en een snelheid — de manier waarop een sample op dat punt moet bewegen om dichter bij de datadistributie te komen.
Stel je bijvoorbeeld voor dat je in een rivier staat. Waar je ook staat, de stroming duwt je een bepaalde kant op, en hoe hard en in welke richting hangt af van je exacte positie en het moment in de tijd. Een vectorveld doet hetzelfde voor je samples — het kent elk punt in de ruimte, op elk moment in de tijd, een richting en snelheid toe.
Een waarschijnlijkheidspad is de reeks distributies waar een sample doorheen beweegt op weg van ruis naar data. Bij t = 0 sample je uit de brondistributie, meestal Gaussische ruis. Bij t = 1 sample je uit de doeldistributie. Alles daartussenin is een tussenliggende distributie, en het waarschijnlijkheidspad beschrijft hoe de ene in de andere overgaat.
Het vectorveld en het waarschijnlijkheidspad zijn direct met elkaar verbonden, omdat het vectorveld samples langs het waarschijnlijkheidspad verplaatst, van de ene tussenliggende distributie naar de volgende, totdat ze de datadistributie bereiken.
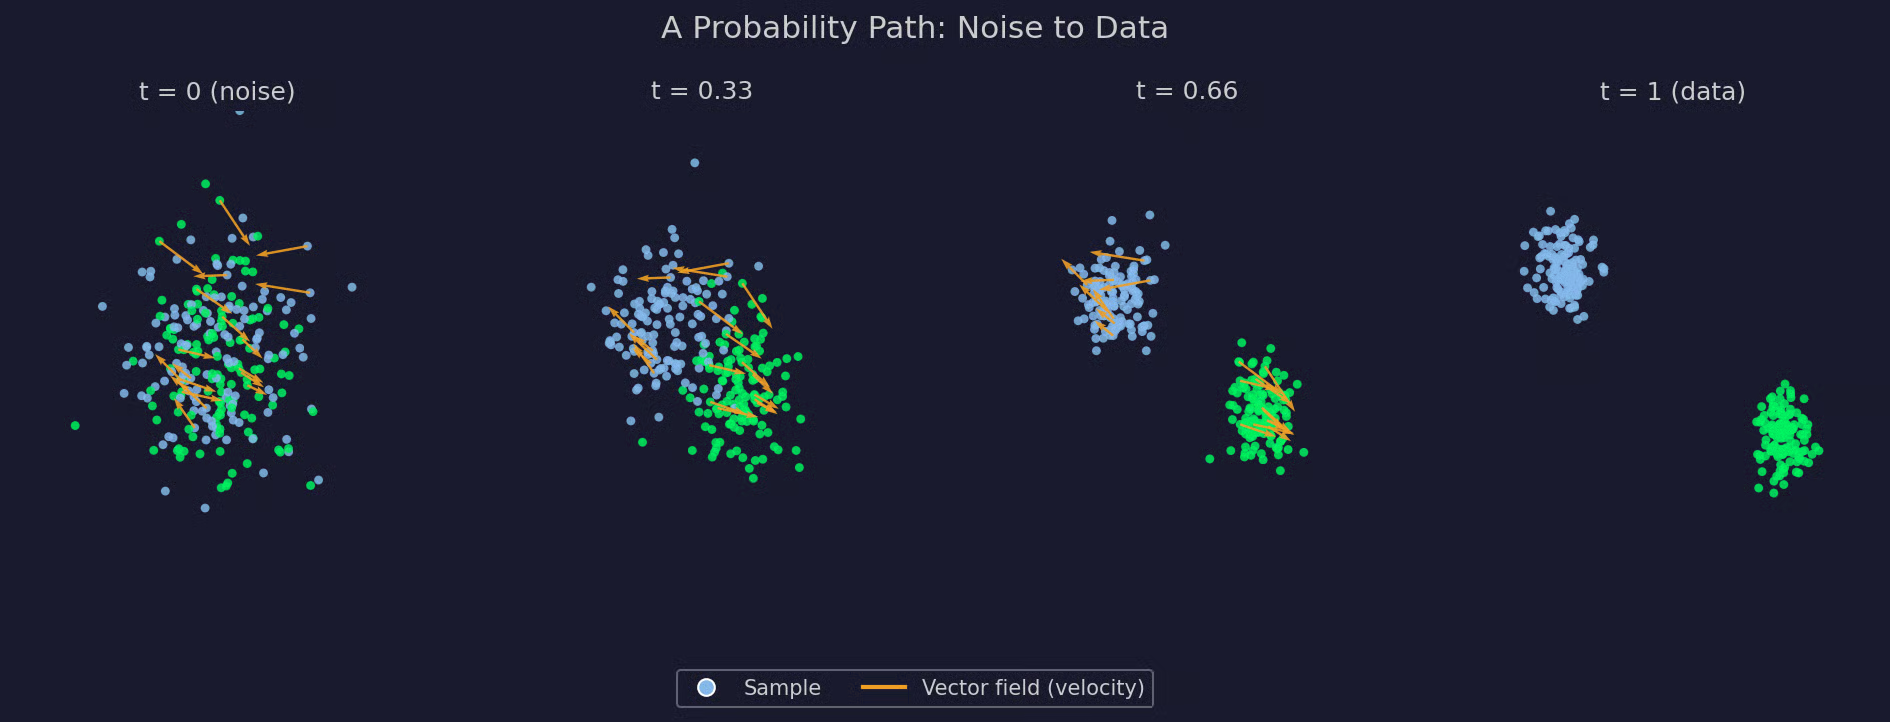
Een diagram van een waarschijnlijkheidspad
Het flow-matching-doel brengt vectorvelden en waarschijnlijkheidspaden samen in één regressieverlies.
Elke trainingsstap vergelijkt twee snelheden. De eerste is de doelsnelheid — de richting en snelheid waarmee een sample op dat punt langs het gekozen waarschijnlijkheidspad moet bewegen. De tweede is de door het model voorspelde snelheid — de gok van het netwerk voor dezelfde richting en snelheid, op basis van de huidige sample en tijd. Training laat die twee zo goed mogelijk op elkaar aansluiten.
Dit is de verliesfunctie:
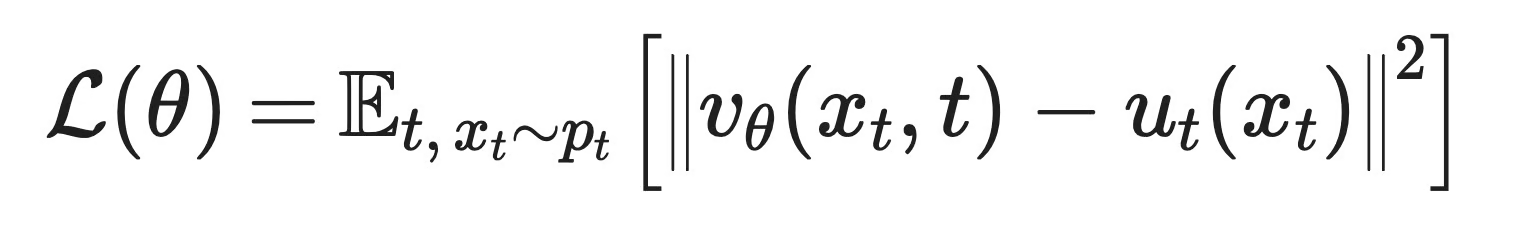
Flow-matching-verliesfunctie
Dit betekent elk onderdeel:
v_θ(x_t, t): De door het model voorspelde snelheid op punt x_t en tijd t
u_t(x_t): De doelsnelheid op hetzelfde punt en tijdstip, gebaseerd op het gekozen waarschijnlijkheidspad
𝔼[...]: Een gemiddelde over veel willekeurige waarden van t en x_t
‖ · ‖^2: Het kwadraat van het verschil tussen de twee snelheden — gewone mean squared error
De volledige afleiding doet er hier niet toe. Waar het om gaat: het netwerk voorspelt één vector op één punt en tijd, en je vergelijkt die met een bekend doel. Dat is alles!
Het marginale waarschijnlijkheidspad dat de volledige ruisdistributie met de volledige datadistributie verbindt, kun je niet direct uitschrijven.
De doelsnelheid op een gegeven punt berekenen betekent rekening houden met elk datapunt dat het had kunnen opleveren — een integraal over je hele dataset, niet iets wat je bij elke trainingsstap uitrekent.
Conditionele flow matching lost dit op door te conditioneren op individuele samples in plaats van op het volledige pad. In plaats van het vectorveld voor het hele marginale pad te berekenen, kies je één datapunt en één ruispunt en construeer je een waarschijnlijkheidspad alleen voor dat paar. Als je dat conditionele pad eenvoudig maakt — bijvoorbeeld een rechte lijn tussen de twee punten — heeft de doelsnelheid een gesloten vorm die je direct kunt uitrekenen.
Het netwerk trainen op deze eenvoudige, per-paar conditionele snelheden, gemiddeld over genoeg paren, levert je hetzelfde vectorveld op als het onhanteerbare marginale doel. Je berekent het marginale pad nooit direct — in plaats daarvan benader je het indirect, één eenvoudig conditioneel pad tegelijk.
Deze conditionele versie is degene die bijna iedereen daadwerkelijk traint. De marginale formulering laat de wiskunde kloppen, maar de conditionele formulering werkt in de praktijk.
Diffusie en flow matching worden vaak vergeleken — om een goede reden. De meeste "diffusiemodellen" die je kent draaien nu op een flow-matching-doel. Dat betekent niet dat flow matching diffusie heeft vervangen. Het betekent dat diffusie een specifiek geval bleek binnen een groter raamwerk, en flow matching daarvan de algemene versie is.
Laat me beginnen met wat elk netwerk voorspelt. Een diffusiemodel voorspelt ruis. Gegeven een ruisige sample en een tijdstap voorspelt het de toegevoegde ruis en verwijdert die, stap voor stap. Flow matching voorspelt in plaats daarvan een snelheid. Gegeven een sample en een tijdstap voorspelt het in welke richting en hoe snel die sample naar de datadistributie moet bewegen.
Het waarschijnlijkheidspad is waar de twee het meest verschillen.
Diffusiemodellen leggen vooraf één specifiek verruisingsproces vast, meestal het toevoegen van Gaussische ruis volgens een vaste planning, en alles volgt uit die ene keuze. In flow matching kies je elk pad dat ruis met data verbindt, en het doel werkt hetzelfde ongeacht welke je neemt. Een diffusie-achtige Gaussische route is één optie. Een rechte lijn tussen ruis en data is een andere, en dat blijkt veel uit te maken voor hoe snel je kunt sampelen.
Deze twee voorspellingen zijn niet zo verschillend als ze lijken.
De ruisvoorspelling van een diffusiemodel en de snelheidsvoorspelling van een flow-matching-model zijn twee gezichtspunten op hetzelfde onderliggende object, verbonden via de score van de distributie op elk moment in de tijd. Waar ze verschillen is in hoe ze genereren. Diffusiesampling is standaard stochastisch, wat betekent dat elke denoising-stap weer een beetje willekeurigheid toevoegt (al bestaan deterministische varianten zoals DDIM). Flow matching werkt andersom — de natuurlijke formulering is een deterministische ODE, dus dezelfde startruis levert elke keer dezelfde output op, en stochastische varianten bestaan daar ook.
In beide gevallen betekent sampelen het stap voor stap oplossen van een differentiaalvergelijking, van ruis naar data.
Diffusiemodellen hebben vaak tientallen stappen nodig tenzij je snelle samplers of distillatie gebruikt. Flow matching, vooral wanneer getraind op rechte paden, heeft vaak veel minder stappen nodig zonder dat — een recht pad heeft een constante snelheid, wat veel makkelijker is voor een oplosser om nauwkeurig te volgen dan een gebogen pad.
Het pad zelf is waar flow matching vooroploopt.
Diffusiemodellen zijn beperkt tot het verruisingsproces waarvan ze zijn afgeleid. Flow matching ziet het pad als een ontwerpkeuze, en verschillende keuzes brengen verschillende trade-offs met zich mee.
|
Diffusiemodellen |
Flow matching |
|
|
Wat het netwerk voorspelt |
Ruis die bij elke stap is toegevoegd |
Snelheid richting de datadistributie |
|
Waarschijnlijkheidspad |
Vastgelegd door een specifiek verruisingsproces |
Vrij te kiezen; rechte lijnen zijn gangbaar |
|
Onderliggend object |
Score van de ruisige distributie |
Tijdsafhankelijk vectorveld, gekoppeld aan de score |
|
Generatie |
Standaard stochastisch maar deterministische varianten bestaan |
Standaard deterministisch maar stochastische varianten bestaan |
|
Sampling-stappen |
Vaak tientallen zonder extra trucs |
Vaak veel minder, vooral met rechtere paden |
|
Padkeuze |
Vastgelegd door het voorwaartse proces |
Een open ontwerpkeuze — diffusie is één instantie |
Flow matching vergeleken met diffusiemodellen
Diffusie is niet de enige methode die met flow matching wordt vergeleken. Er zijn nog drie waar je van moet weten
Continuous normalizing flows kwamen eerst, en flow matching is direct voortgekomen uit de problemen met het trainen ervan.
Een continuous normalizing flow is het soort model dat flow matching oplevert — een netwerk dat via een ODE een continue transformatie tussen distributies definieert. Oorspronkelijk trainen betekende die ODE voorwaarts oplossen en bij elke stap een exacte likelihood berekenen, wat inhoudt dat je moet bijhouden hoe de transformatie de kansdichtheid onderweg verandert. Die berekening is duur, en wordt alleen maar zwaarder naarmate het netwerk groeit.
Flow matching omzeilt dat alles. Het regresseert direct op een bekende doelsnelheid in plaats van de ODE op te lossen en likelihoods te berekenen tijdens training. Er is geen simulatie nodig. Je eindigt nog steeds met een continuous normalizing flow, je betaalt alleen niet meer de eerdere trainingskosten om daar te komen.
Score matching traint een netwerk om de score te voorspellen — de gradiënt van de log-kansdichtheid — op elk ruisniveau. Dat is het doel achter de diffusiemodellen die je kent.
Flow matching traint een netwerk om een snelheid te voorspellen. De twee objecten zijn wiskundig verwant, wat betekent dat je onder bepaalde padkeuzes het ene in het andere kunt omzetten. Maar ze vertegenwoordigen verschillende dingen. De score beschrijft de vorm van de kansdistributie op een vast moment in de tijd. De snelheid beschrijft hoe een sample moet bewegen als de tijd verandert.
Score matching gaat over geometrie. Flow matching gaat over beweging.
Rectified flow is een specifieke keuze binnen flow matching.
Flow matching laat je elk waarschijnlijkheidspad kiezen dat ruis met data verbindt. Rectified flow kiest er één — rechte lijnen — en gaat dan nog een stap verder met een iteratieve procedure genaamd "reflow" die de paden recht trekt die een getraind model al geleerd heeft, zodat een tweede-ronde-model bij generatie nog minder integratiestappen nodig heeft.
Daarom verschijnen de twee termen naast elkaar in dezelfde papers. Stable Diffusion 3 en Flux gebruiken allebei flow matching met iets dat lijkt op een rectified-flow-padkeuze. Maar flow matching en rectified flow als inwisselbaar zien, mist de kern. Flow matching is het raamwerk. Rectified flow is één padkeuze daarin.
Flow matching draait inmiddels in enkele van de grootste generatieve systemen in productie.
Dit alles komt doordat een regressieverlies eenvoudig te implementeren en te schalen is. En omdat het pad een ontwerpkeuze is, kunnen teams die systemen met miljarden parameters bouwen er een kiezen dat minder sampling-stappen nodig heeft — en dat telt wanneer elke stap rekenkracht kost op die schaal.
Tot nu toe was alles conceptueel. Ik laat je nu hetzelfde idee zien op een echte 2D-dataset, klein genoeg om elke stap te kunnen volgen.
De ruisdistributie is een standaard 2D-Gauss, gecentreerd op de oorsprong. De doeldistributie bestaat uit drie Gaussische clusters in een driehoeksopstelling — simpel genoeg voor een klein netwerk om snel te leren, maar gestructureerd genoeg om te kunnen zien of het klopt.
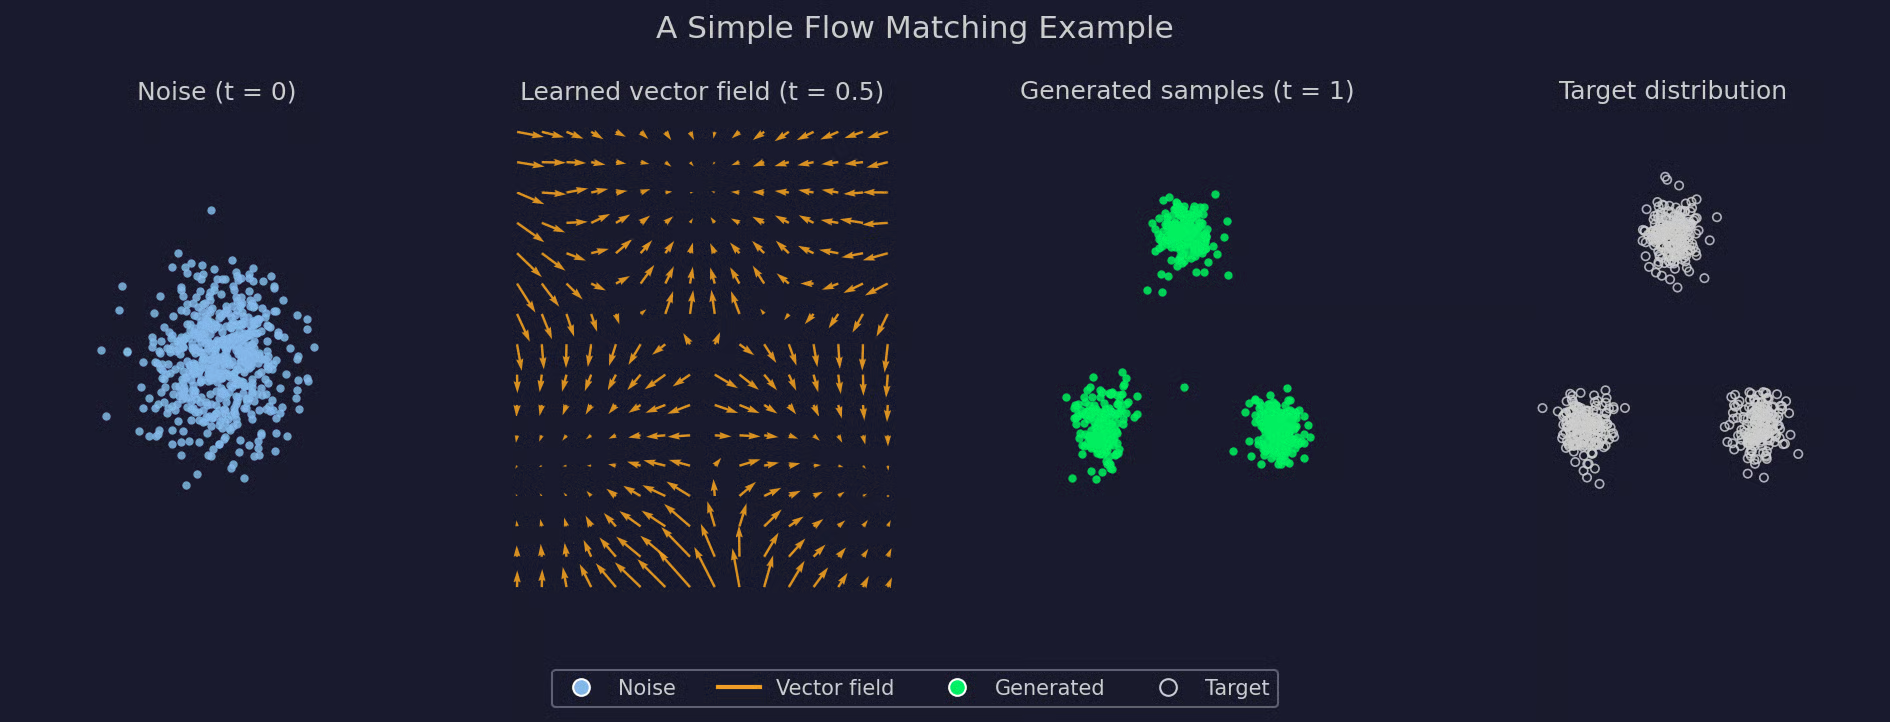
Eenvoudig flow-matching-voorbeeld
Het eerste paneel is waar elke sample begint — verspreide ruis zonder structuur. Het tweede paneel is het vectorveld zelf, geëvalueerd op een raster halverwege de training. Let op hoe de pijlen al naar een van de drie clusters wijzen, ruim voordat een sample daar aankomt. Het derde paneel laat zien wat er gebeurt als je met nieuwe ruis begint en dat veld helemaal tot t = 1 volgt — er ontstaan drie clusters die bijna perfect overeenkomen met het vierde paneel.
Niets hiervan gebruikte iets dat de eerdere secties niet al bespraken — een brondistributie, een doeldistributie, een geleerd vectorveld en een ODE-oplosser die de drie verbindt. Door naar de code.
Hier is een kleine PyTorch-implementatie van hetzelfde voorbeeld, met dezelfde ruisbron en drie-cluster-doel.
Begin met de twee distributies en hoe je eruit sampelt:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Het netwerk zelf neemt een punt en een tijdstap en voorspelt een snelheid:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Training sampelt bij elke stap een batch bronpunten, doelpunten en tijdstappen, interpoleert tussen de eerste twee en regresseert naar de resulterende snelheid:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Generatie lost de geleerde ODE op met eenvoudige Euler-integratie. Je hebt alleen een lus nodig die kleine stappen zet van t = 0 tot t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`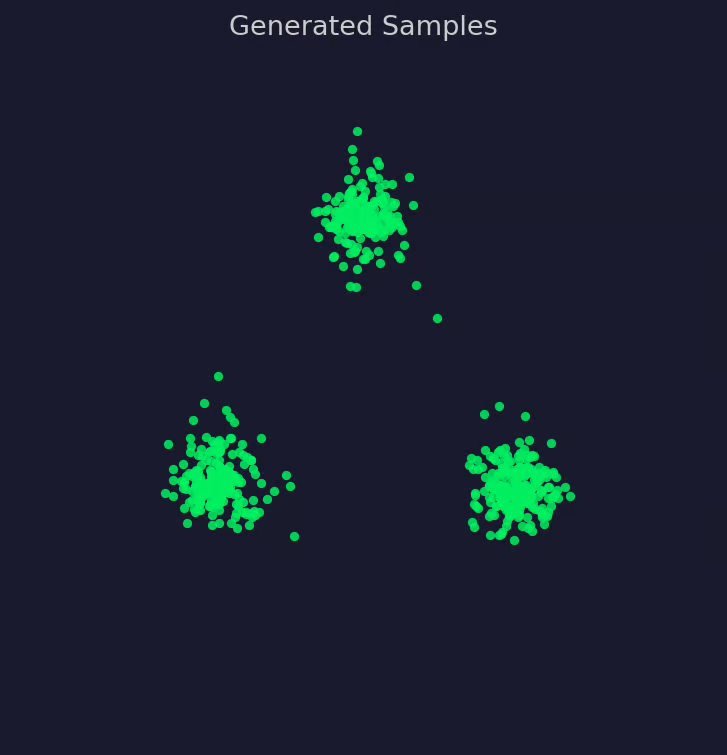
Visualisatie van gegenereerde samples
En dat is de hele pijplijn! Samplen, interpoleren, regressie, integreren. Niets hiervan verandert als je een groter netwerk, een ander pad of een dataset met hogere dimensie neemt — alleen de schaal.
Niets hiervan maakt flow matching een universele upgrade ten opzichte van diffusie. Het is een trade-off, zoals elke ontwerpkeuze.
Hier is waar het een goede optie is en waar niet.
Flow matching leert een model hoe samples zich moeten bewegen van een eenvoudige distributie richting de datadistributie. Alles wat ik in dit artikel beschreef, bestaat om dat ene idee trainbaar te maken.
Twee ideeën doen hier het meeste werk. Een waarschijnlijkheidspad verbindt ruis met data via een reeks tussenliggende distributies. Een vectorveld beschrijft hoe een sample zich op elk punt langs dat pad moet bewegen, op elk moment in de tijd. Het netwerk leert dat vectorveld — de snelheid — en generatie is simpelweg het volgen van de resulterende flow van ruis naar data.
Niets hiervan staat los van wat eraan voorafging. Flow matching is hoe moderne systemen continuous normalizing flows trainen zonder de oude likelihood-berekening, en diffusiemodellen blijken één specifiek geval daarvan.
Als diffusion-modellen, normalizing flows of generatieve AI in het algemeen je interesse hebben, dan is dit precies waar je verder kunt gaan:
Leer AI met DataCamp
Cursus
Cursus
Cursus