course
Förstå artificiell intelligens
2 timmar
421.5K
Har du sett termen "flow matching" bredvid varje ny bild- och videomodell och inte har en aning om vad den betyder?
De flesta förklaringar går antingen direkt in på differentialekvationer eller presenterar det som "diffusion, fast bättre". Inget av det säger vad modellen faktiskt lär sig. Stable Diffusion 3 och Flux bygger båda på flow matching, och de genererar bilder i ett par steg där klassisk diffusion behöver dussintals.
Grundidén är denna: i stället för att lära enskilda exempel lär sig modellen ett hastighetsfält som talar om för varje prov åt vilket håll och hur snabbt det ska röra sig. När du väl förstår det blir träningsprocessen, matematiken bakom och relationen till diffusion begripliga.
I den här artikeln går jag igenom intuitionen bakom flow matching, hur det tränas, matematiken (på en lätt nivå) och hur det står sig mot diffusionsmodeller.
Om du är ny inom AI för bilddata, läs vår Top 10 Vision Language Models 2026 för att upptäcka de senaste toppmodellerna för visuellt resonemang, bildanalys och datorseende.
Flow matching är ett träningsmål, inte en modellarkitektur.
Den skillnaden är viktig eftersom du kan para ihop det med en transformer eller nästan vilket nätverk som helst – det som gör det till flow matching är vad nätverket tränas att förutsäga, inte hur nätverket ser ut.
Och det som tränas är ett tidsberoende vektorfält. På ren svenska är det en funktion som talar om vilken riktning och hur fort ett prov ska röra sig vid varje punkt längs sin bana från källdistributionen till måldistributionen. När du tränar kontinuerliga normaliseringsflöden på detta sätt får du en modell som steg för steg omvandlar en enkel distribution till en komplex.
Jag brukar dela upp intuitionen i fyra idéer:
Om du är mer visuell av dig, föreställ dig ett moln av spridda partiklar utan ordning. Flow matching lär varje partikel exakt åt vilket håll och hur fort den ska röra sig, så att hela molnet över tid lägger sig i ett strukturerat mönster (formen av din måldistribution).
Kör du detta på ett bilddataset betyder "strukturerat mönster" ett sammanhängande foto i stället för slumpmässigt brus.
Träning och generering är två separata faser här, och förvirringen börjar ofta när folk tror att de är samma sak.
Under träning:
t mellan 0 och 1t, baserat på en sannolikhetsbana som kopplar de tvåt, baserat på banan du valdeGenerering behöver inte datapunkten.
Du startar från brus och integrerar det inlärda vektorfältet framåt i tiden, ett litet steg i taget, tills du når ett prov från datadistributionen.
Och det är idén – du förutsäger hastighet under träning och följer den vid generering.
Det finns två idéer som gör det mesta av jobbet bakom flow matching-målet – vektorfält och sannolikhetsbanor. När du förstår dem blir förlustfunktionen i nästa avsnitt logisk.
Ett vektorfält är det som nätverket förutsäger. Vid varje punkt i rummet och vid varje tidpunkt ger det dig en riktning och en fart – hur ett prov vid den punkten ska röra sig för att komma närmare datadistributionen.
Tänk till exempel att du står i en flod. Var du än står trycker strömmen dig åt ett visst håll, och hur hårt och i vilken riktning beror på din exakta position och tidpunkten. Ett vektorfält gör samma sak för dina prover – det tilldelar en riktning och en fart till varje punkt i rummet, vid varje tidpunkt.
En sannolikhetsbana är sekvensen av distributioner som ett prov rör sig igenom på vägen från brus till data. Vid t = 0 sampplar du från källdistributionen, vanligtvis Gaussbrus. Vid t = 1 sampplar du från måldatadistributionen. Allt däremellan är en mellanliggande distribution, och sannolikhetsbanan beskriver hur en övergår i nästa.
Vektorfältet och sannolikhetsbanan är direkt kopplade eftersom vektorfältet flyttar prover längs sannolikhetsbanan, från en mellanliggande distribution till nästa, tills de når datadistributionen.
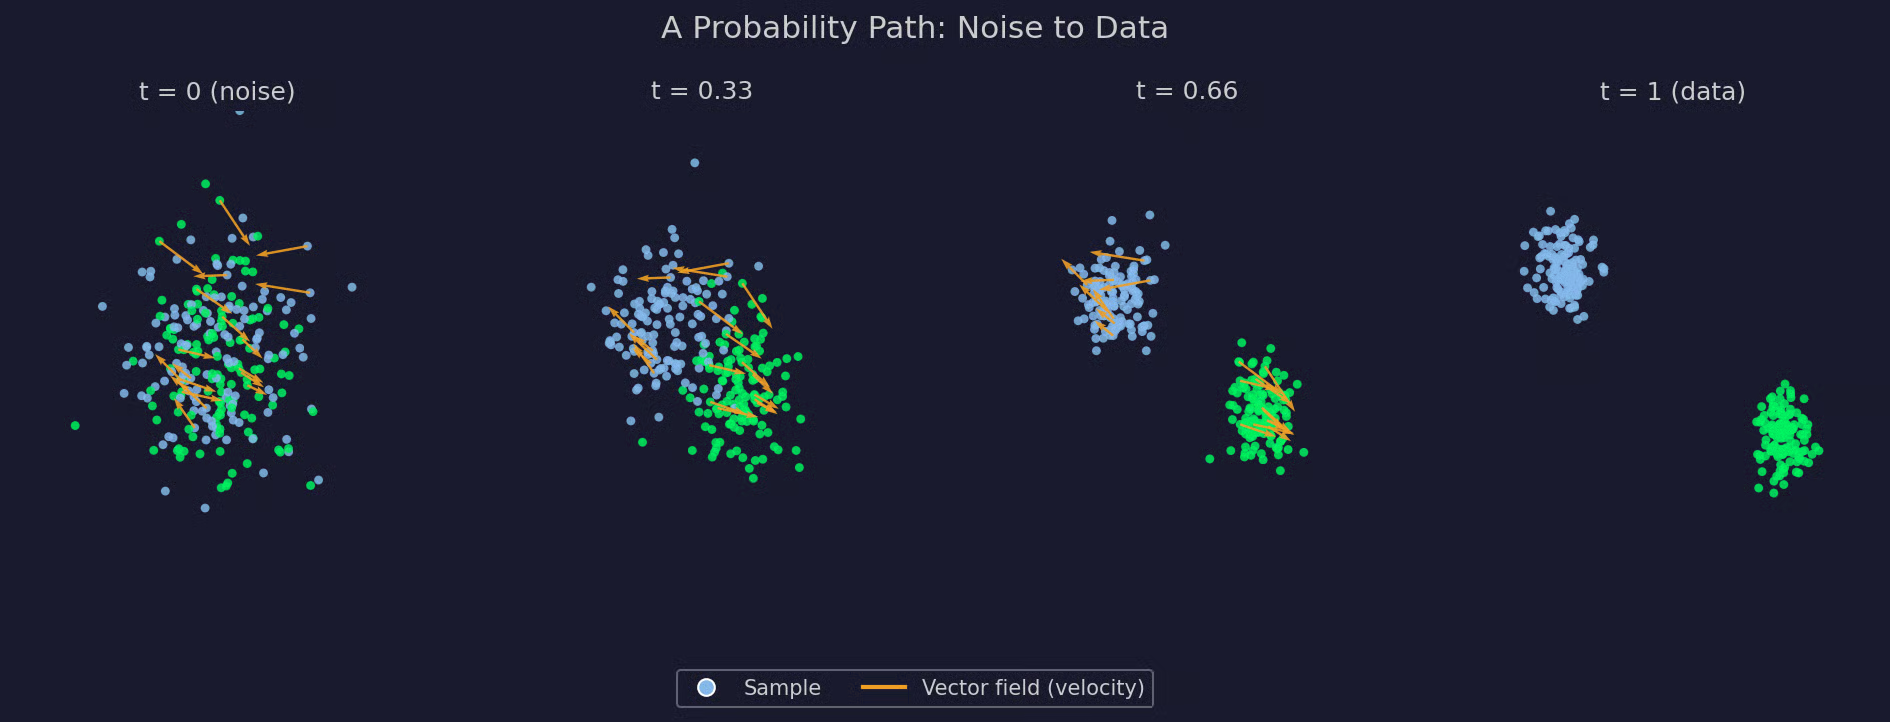
Ett diagram över en sannolikhetsbana
Flow matching-målet omvandlar vektorfält och sannolikhetsbanor till en enda regressionsförlust.
Varje träningssteg jämför två hastigheter. Den första är målhastigheten – riktningen och farten ett prov bör ha vid den punkten längs den valda sannolikhetsbanan. Den andra är modellens förutsagda hastighet – nätverkets egen gissning för samma riktning och fart, baserat på det aktuella provet och tiden. Träningen får de två att matcha så nära som möjligt.
Här är förlustfunktionen:
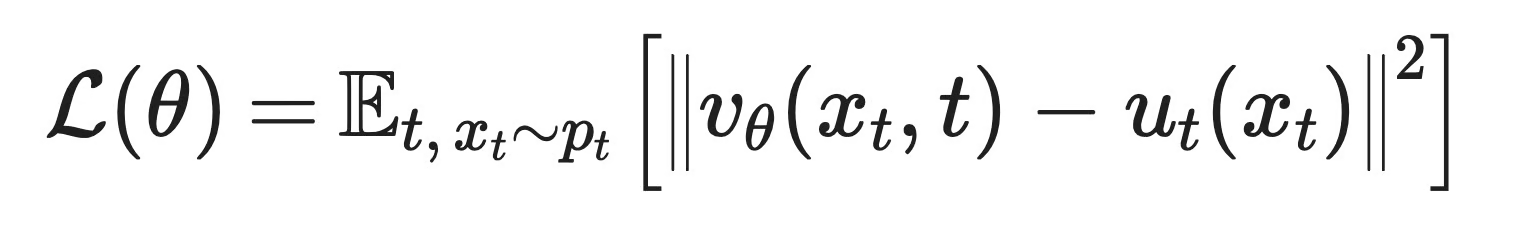
Flow matching-förlustfunktion
Detta betyder varje term:
v_θ(x_t, t): Modellens förutsagda hastighet i punkten x_t och tiden t
u_t(x_t): Målhastigheten i samma punkt och tid, baserat på den valda sannolikhetsbanan
𝔼[...]: Ett medelvärde över många slumpmässiga värden av t och x_t
‖ · ‖^2: Den kvadrerade skillnaden mellan de två hastigheterna – enkel medelkvadratfel
Den fulla härledningen är inte poängen här. Det som spelar roll är att nätverket förutsäger en enda vektor vid en enda punkt och tid, och du jämför den med ett känt mål. Det är allt!
Den marginella sannolikhetsbanan som kopplar hela bruset till hela datadistributionen är inget du kan skriva ner direkt.
Att beräkna målhastigheten i en given punkt innebär att ta hänsyn till varje dataprov som kan ha producerat den – en integral över hela ditt dataset, inget någon räknar ut vid varje träningssteg.
Villkorad flow matching löser detta genom att villkora på enskilda prover i stället för hela banan. I stället för att beräkna vektorfältet för hela den marginella banan väljer du en enda datapunkt och en enda bruspunkt och konstruerar en sannolikhetsbana bara för det paret. När du gör den villkorade banan enkel, till exempel med en rak linje mellan punkterna, får målhastigheten en sluten form som du kan beräkna direkt.
Att träna nätverket på dessa enkla, parvisa villkorade hastigheter, medelvärdesbildade över tillräckligt många par, ger dig samma vektorfält som du skulle få från det intraktabla marginella målet. Du beräknar aldrig den marginella banan direkt – i stället approximerar du den indirekt, en enkel villkorad bana i taget.
Denna villkorade variant är den som nästan alla faktiskt tränar. Den marginella formuleringen får matematiken att gå ihop, men den villkorade är det som fungerar i praktiken.
Diffusion och flow matching jämförs ständigt av en god anledning – de flesta "diffusionsmodeller" du redan känner till körs nu med ett flow matching-mål. Det betyder inte att flow matching ersatte diffusion. Det betyder att diffusion visade sig vara ett specifikt fall inom en större ram, och flow matching är den generella versionen.
Låt mig börja med vad varje nätverk förutsäger. En diffusionsmodell förutsäger brus. Givet ett brusigt prov och ett tidssteg förutsäger den bruset som blandades in, och tar sedan bort det, ett steg i taget. Flow matching förutsäger i stället en hastighet. Givet ett prov och ett tidssteg förutsäger den åt vilket håll och hur snabbt provet ska röra sig mot datadistributionen.
Sannolikhetsbanan är där de skiljer sig mest.
Diffusionsmodeller fixerar en specifik brustillsatsprocess i förväg, vanligtvis att addera Gaussbrus enligt ett fast schema, och allt annat följer av det valet. I flow matching väljer du valfri bana som kopplar brus till data, och målet fungerar likadant oavsett vilken du väljer. En diffusion-liknande Gaussbana är ett alternativ. En rak linje mellan brus och data är ett annat, och det visar sig spela stor roll för hur snabbt du kan samppla.
Dessa två prediktioner är inte så olika som de verkar.
En diffusionsmodells brusförutsägelse och en flow matching-modells hastighetsförutsägelse är två vyer av samma underliggande objekt, kopplade genom distributionens score vid varje tidpunkt. Där de skiljer sig är i hur de genererar. Diffusionssampling är stokastisk som standard, vilket betyder att varje avbrusningssteg lägger till lite slump tillbaka (även om deterministiska varianter som DDIM finns). Flow matching fungerar tvärtom – dess naturliga formulering är en deterministisk ODE, så samma startbrus ger samma utdata varje gång, och stokastiska varianter finns även där.
Sampling i båda fallen innebär att lösa en differentialekvation steg för steg, från brus mot data.
Diffusionsmodeller tenderar att behöva dussintals steg om du inte använder snabba sampplare eller distillering. Flow matching, särskilt när det tränas på raka banor, tenderar att behöva betydligt färre steg utan något av det – en rak bana har konstant hastighet, vilket är mycket enklare för en lösare att följa exakt än en krökt.
Banan i sig är där flow matching drar ifrån.
Diffusionsmodeller är begränsade till vilken brustillsatsprocess de härletts från. Flow matching behandlar banan som ett designval, och olika val kommer med olika avvägningar.
|
Diffusionsmodeller |
Flow matching |
|
|
Vad nätverket förutsäger |
Brus som adderas vid varje steg |
Hastighet mot datadistributionen |
|
Sannolikhetsbana |
Fastställd av en specifik brustillsatsprocess |
Fritt vald; raka linjer är vanliga |
|
Underliggande objekt |
Scoren för den brusiga distributionen |
Tidsberoende vektorfält, kopplat till scoren |
|
Generering |
Stokastisk som standard men deterministiska varianter finns |
Deterministisk som standard men stokastiska varianter finns |
|
Antal samplingssteg |
Ofta dussintals utan extra trick |
Ofta betydligt färre, särskilt med rakare banor |
|
Val av bana |
Fast av framåtprocessen |
Ett öppet designval — diffusion är ett exempel |
Flow matching jämfört med diffusionsmodeller
Diffusion är inte den enda metoden som jämförs med flow matching. Det finns tre till du bör känna till
Kontinuerliga normaliseringsflöden kom först, och flow matching växte fram direkt ur problemen med att träna dem.
Ett kontinuerligt normaliseringsflöde är den typ av modell som flow matching producerar – ett nätverk som definierar en kontinuerlig transformation mellan distributioner via en ODE. Att träna ett på det ursprungliga sättet innebar att lösa ODE:n framåt och beräkna en exakt likelihood vid varje steg, vilket betyder att spåra hur transformationen förändrar sannolikhetstätheten längs vägen. Den beräkningen är dyr, och blir bara värre när nätverket växer.
Flow matching undviker allt detta. Det regresserar direkt på en känd målhastighet i stället för att lösa ODE:n och beräkna likelihood under träning. Ingen simulering krävs. Du slutar ändå med ett kontinuerligt normaliseringsflöde, du slipper bara den tidigare träningskostnaden för att komma dit.
Score matching tränar ett nätverk att förutsäga scoren – gradienten av loggsannolikhetstätheten – vid varje brusnivå. Det är målet bakom de diffusionsmodeller du redan känner till.
Flow matching tränar ett nätverk att förutsäga en hastighet i stället. De två objekten är matematiskt relaterade, vilket betyder att du under vissa val av bana kan omvandla det ena till det andra. Men de representerar olika saker. Scoren beskriver formen på sannolikhetsfördelningen vid en fast tidpunkt. Hastigheten beskriver hur ett prov ska röra sig när tiden förändras.
Score matching frågar om geometri. Flow matching frågar om rörelse.
Rectified flow är ett specifikt val inom flow matching.
Flow matching låter dig välja valfri sannolikhetsbana som kopplar brus till data. Rectified flow väljer en – raka linjer, och går sedan ett steg längre med en iterativ procedur som kallas "reflow" som rätar ut de banor en tränad modell redan lärt sig, så att en andra modellomgång behöver ännu färre integrationssteg vid generering.
Det är därför de två termerna dyker upp sida vid sida i samma artiklar. Stable Diffusion 3 och Flux använder båda flow matching med något som liknar ett rectified-flow-banval. Men att behandla flow matching och rectified flow som utbytbara missar poängen. Flow matching är ramen. Rectified flow är en bana du kan välja inom den.
Flow matching körs nu i några av de största generativa systemen i produktion.
Allt detta beror på att en regressionsförlust är enkel att implementera och skala. Och eftersom banan är ett designval kan team som bygger system med miljarder parametrar välja en som kräver färre samplingssteg, vilket spelar roll när varje steg kostar beräkningar i den skalan.
Allt hittills var konceptuellt. Nu går jag igenom samma idé på ett faktiskt 2D-dataset, tillräckligt litet för att se varje steg.
Brusdistributionen är en standard 2D-Gauss, centrerad i origo. Måldistributionen är tre Gausskluster arrangerade i en triangel – tillräckligt enkelt för att ett litet nätverk snabbt ska lära sig, men tillräckligt strukturerat för att du ska se om det blev rätt.
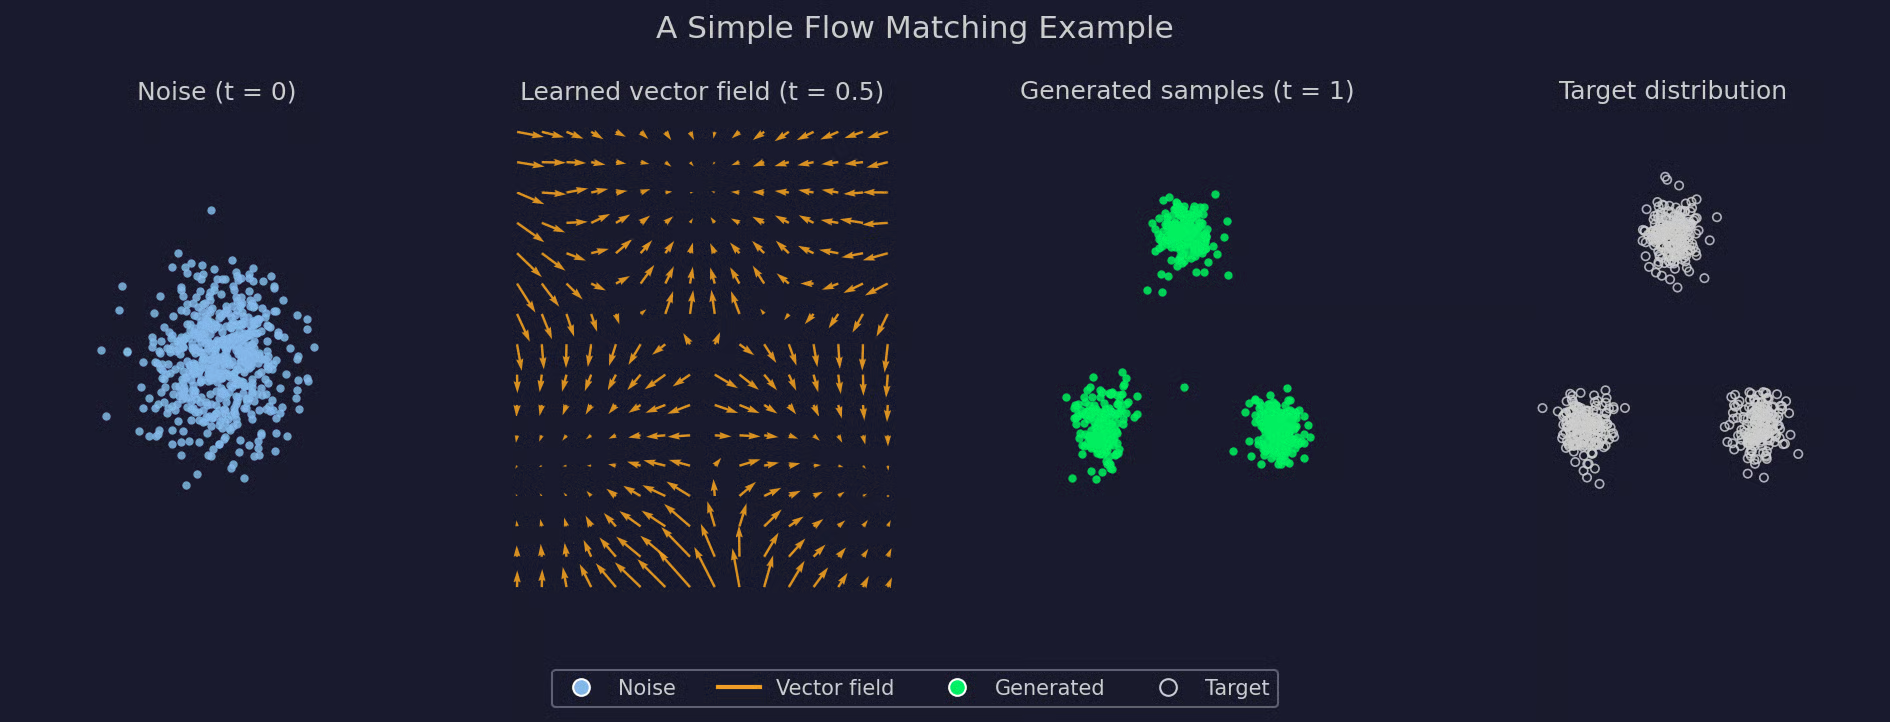
Enkelt exempel på flow matching
Den första panelen är där varje prov börjar – spritt brus utan struktur. Den andra panelen är själva vektorfältet, utvärderat på ett rutnät vid träningsmitten. Lägg märke till hur pilarna redan pekar mot ett av de tre klustren, långt innan något prov kommer dit. Den tredje panelen visar vad som händer när du startar från nytt brus och följer fältet hela vägen till t = 1 – tre kluster framträder och matchar den fjärde panelen nästan perfekt.
Inget av detta involverade något som tidigare avsnitt inte redan täckt – en källdistribution, en måldistribution, ett inlärt vektorfält och en ODE-lösare som kopplar de tre. Dags för kod.
Här är en liten PyTorch-implementation av samma exempel, med samma brus-källa och treklustermål.
Börja med de två distributionerna och hur du sampplar från dem:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Själva nätverket tar en punkt och ett tidssteg och förutsäger en hastighet:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Träningen sampplar en batch av källpunkter, målpunkter och tidssteg vid varje steg, interpolerar mellan de två första och regresserar mot den resulterande hastigheten:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Generering löser den inlärda ODE:n med enkel Euler-integration. Du behöver bara en loop som tar små steg från t = 0 till t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`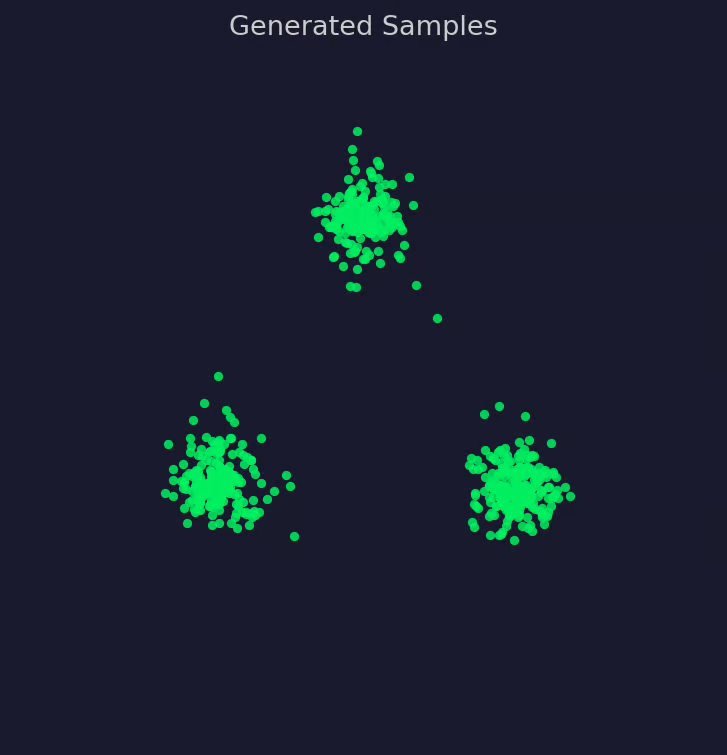
Visualisering av genererade prover
Och det är hela pipelinen! Samppla, interpolera, regressa, integrera. Inget här förändras om du väljer ett större nätverk, en annan bana eller ett högre-dimensionellt dataset – bara skalan.
Inget av detta gör flow matching till en universell uppgradering över diffusion. Det är en avvägning, som alla andra designval.
Här är när det är ett bra alternativ och när det inte är det.
Flow matching lär en modell hur prover ska röra sig från en enkel distribution mot datadistributionen. Allt annat jag beskrev i den här artikeln finns till för att göra den idén träningsbar.
Två idéer gör det mesta av jobbet här. En sannolikhetsbana kopplar brus till data genom en sekvens av mellanliggande distributioner. Ett vektorfält beskriver hur ett prov ska röra sig vid varje punkt längs den banan, vid varje tidpunkt. Nätverket lär sig det vektorfältet, dess hastighet, och generering är bara att följa det resulterande flödet från brus till data.
Inget av detta är frikopplat från det som kom före. Flow matching är hur moderna system tränar kontinuerliga normaliseringsflöden utan den gamla likelihood-beräkningen, och diffusionsmodeller visar sig vara ett specifikt fall av det.
Om diffusionsmodeller, normaliseringsflöden eller generativ AI i bredare bemärkelse intresserar dig, är det precis dit du ska gå härnäst:
Lär dig AI med DataCamp
course
course
course