
Kurs
Künstliche Intelligenz verstehen
2 Std.
421.5K
Bist du in letzter Zeit ständig über den Begriff "Flow Matching" bei neuen Bild- und Videomodellen gestolpert und fragst dich, was dahintersteckt?
Viele Erklärungen springen direkt in Differentialgleichungen oder nennen es schlicht „Diffusion, nur besser“. Beides sagt dir nicht, was das Modell eigentlich lernt. Stable Diffusion 3 und Flux basieren beide auf Flow Matching und erzeugen Bilder in wenigen Schritten, wo klassische Diffusion Dutzende braucht.
Die Grundidee ist diese: Statt einzelne Beispiele zu lernen, lernt das Modell ein Geschwindigkeitsfeld, das jedem Sample sagt, in welche Richtung und wie schnell es sich bewegen soll. Wenn du das verstehst, ergibt der Trainingsablauf, die dahinterstehende Mathematik und der Zusammenhang zur Diffusion Sinn.
In diesem Artikel führe ich dich durch die Intuition hinter Flow Matching, wie es trainiert wird, durch die nötige Mathematik (leicht verdaulich) und den Vergleich mit Diffusionsmodellen.
Wenn du neu in KI für Bilddaten bist, lies unsere Top 10 Vision Language Models 2026 und entdecke aktuelle State-of-the-Art-Modelle für visuelles Schlussfolgern, Bildanalyse und Computer Vision.
Flow Matching ist ein Trainingsziel, keine Modellarchitektur.
Diese Unterscheidung ist wichtig, denn du kannst es mit einem Transformer oder fast jedem anderen Netzwerk kombinieren – Flow Matching definiert, was das Netzwerk vorhersagen soll, nicht wie es aussieht.
Und was es vorhersagt, ist ein zeitabhängiges Vektorfeld. Auf gut Deutsch: eine Funktion, die an jedem Punkt entlang des Wegs von der Quelldistribution zur Zieldistribution angibt, in welche Richtung und wie schnell sich ein Sample bewegen soll. Trainierst du damit Continuous Normalizing Flows, erhältst du ein Modell, das eine einfache Verteilung Schritt für Schritt in eine komplexe überführt.
Ich breche die Intuition gern in vier Punkte herunter:
Wenn du eher visuell veranlagt bist, stell dir eine Wolke verstreuter Partikel ohne jede Ordnung vor. Flow Matching bringt jedem Partikel exakt bei, wohin und wie schnell es sich bewegen soll, sodass sich die Wolke im Zeitverlauf in ein strukturiertes Muster sortiert (die Form deiner Zieldistribution).
Bei Bilddatensätzen bedeutet „strukturiertes Muster“ am Ende: ein kohärentes Foto statt reinem Rauschen.
Training und Generierung sind hier zwei getrennte Phasen – Verwirrung entsteht oft, wenn man sie gleichsetzt.
Im Training:
t zwischen 0 und 1t anhand eines Wahrscheinlichkeitspfads, der beide verbindett gemäß deines Pfads haben sollteFür die Generierung brauchst du den Datenpunkt nicht.
Du startest im Rauschen und integrierst das gelernte Vektorfeld schrittweise vorwärts in der Zeit, bis du bei einem Sample aus der Datendistribution landest.
Und das ist die Idee – im Training wird die Geschwindigkeit vorhergesagt, in der Generierung folgst du ihr.
Zwei Konzepte tragen den Großteil der Arbeit hinter dem Flow-Matching-Ziel: Vektorfelder und Wahrscheinlichkeitspfade. Wenn du sie verstehst, ergibt die Loss-Funktion im nächsten Abschnitt Sinn.
Ein Vektorfeld ist das, was das Netzwerk vorhersagt. An jedem Ort im Raum und zu jedem Zeitpunkt liefert es eine Richtung und ein Tempo – also, wie ein Sample an diesem Ort sich bewegen sollte, um näher an die Datendistribution zu kommen.
Stell dir vor, du stehst in einem Fluss. Wo immer du stehst, drückt dich die Strömung in eine bestimmte Richtung, und Stärke sowie Richtung hängen vom genauen Standort und Zeitpunkt ab. Ein Vektorfeld macht dasselbe für deine Samples – es weist jedem Punkt im Raum zu jedem Zeitpunkt eine Richtung und eine Geschwindigkeit zu.
Ein Wahrscheinlichkeitspfad ist die Abfolge von Verteilungen, die ein Sample auf dem Weg vom Rauschen zu den Daten durchläuft. Bei t = 0 ziehst du aus der Quelldistribution, meist Gaußsches Rauschen. Bei t = 1 ziehst du aus der Zieldistribution. Alles dazwischen sind Zwischenverteilungen, und der Wahrscheinlichkeitspfad beschreibt, wie die eine in die nächste übergeht.
Vektorfeld und Wahrscheinlichkeitspfad sind direkt verknüpft, denn das Vektorfeld bewegt Samples entlang dieses Pfads – von einer Zwischenverteilung zur nächsten –, bis sie die Datendistribution erreichen.
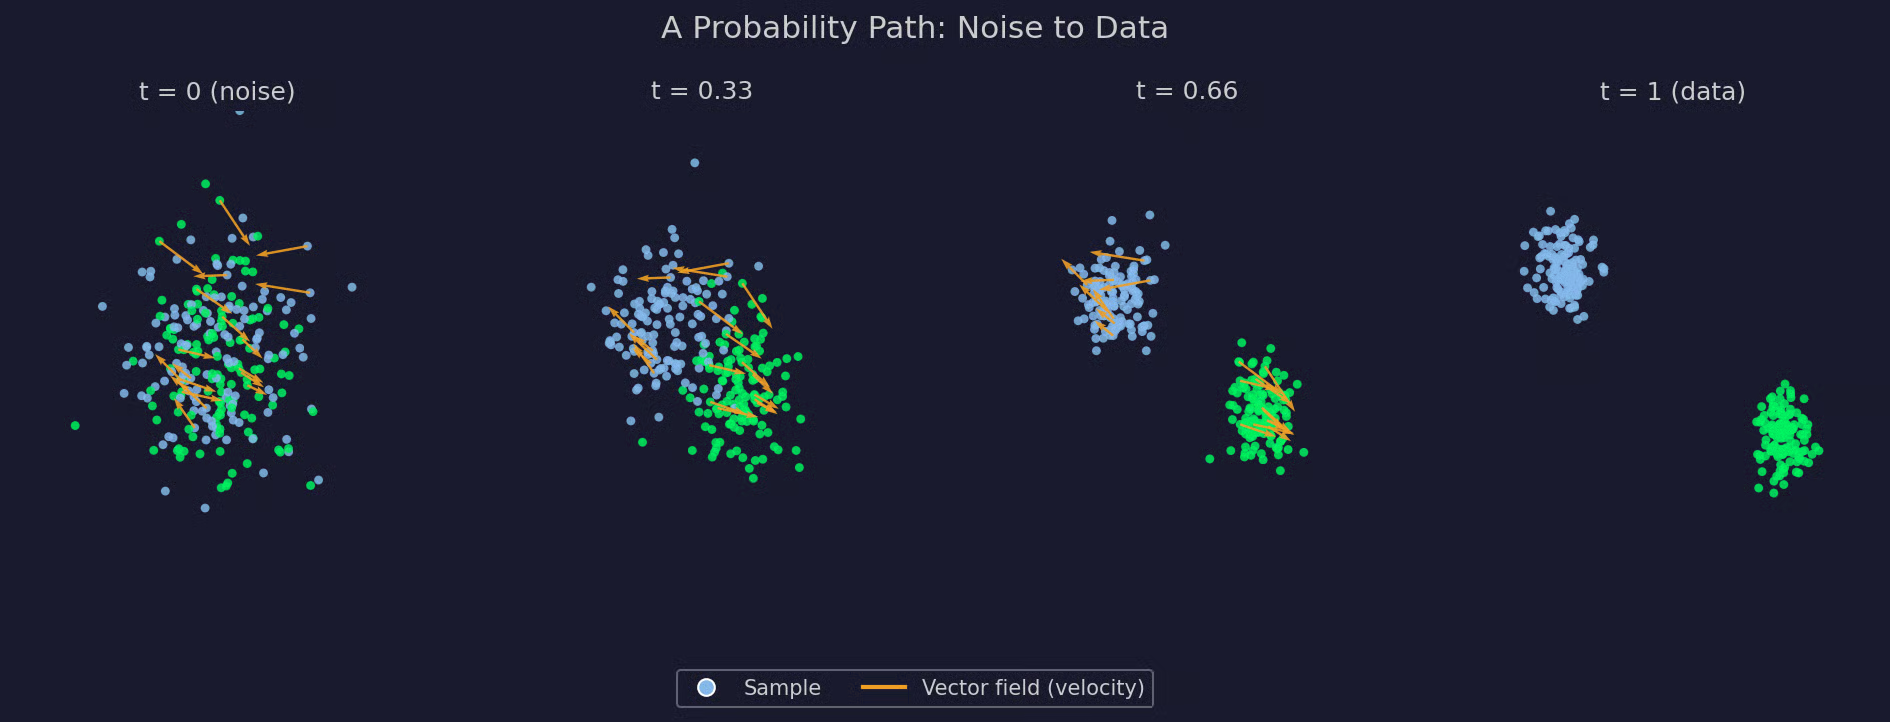
Diagramm eines Wahrscheinlichkeitspfads
Das Flow-Matching-Ziel gießt Vektorfelder und Wahrscheinlichkeitspfade in einen einzigen Regressions-Loss.
Jeder Trainingsschritt vergleicht zwei Geschwindigkeiten. Erstens die Zielgeschwindigkeit – Richtung und Tempo, mit der ein Sample an diesem Punkt entlang des gewählten Pfads laufen sollte. Zweitens die modellierte Geschwindigkeit – die Schätzung des Netzwerks für dieselbe Richtung und dasselbe Tempo, basierend auf dem aktuellen Sample und Zeitpunkt. Das Training bringt beide so nah wie möglich zusammen.
Hier ist die Loss-Funktion:
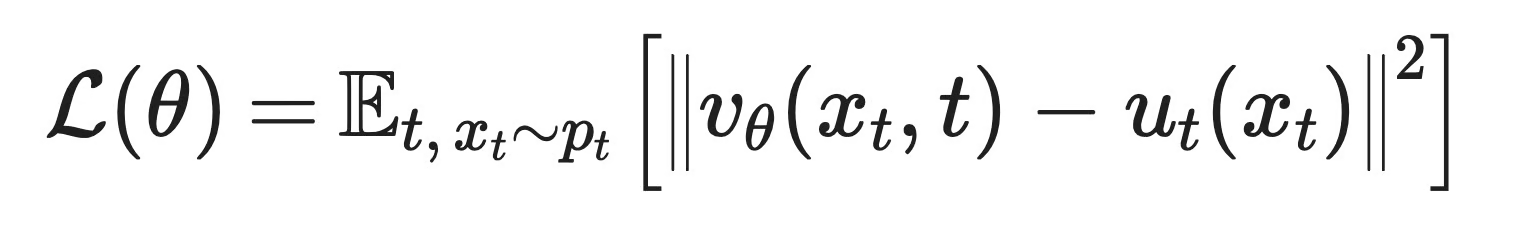
Flow-Matching-Loss-Funktion
Das bedeuten die Terme:
v_θ(x_t, t): Vom Modell vorhergesagte Geschwindigkeit am Punkt x_t zum Zeitpunkt t
u_t(x_t): Die Zielgeschwindigkeit am selben Punkt und Zeitpunkt, basierend auf dem gewählten Wahrscheinlichkeitspfad
𝔼[...]: Ein Mittelwert über viele zufällige Werte von t und x_t
‖ · ‖^2: Das Quadrat der Differenz der beiden Geschwindigkeiten – klassisches Mean Squared Error
Die vollständige Herleitung ist hier nicht entscheidend. Wichtig ist: Das Netzwerk sagt an einem einzelnen Punkt zu einem Zeitpunkt einen Vektor voraus, und du vergleichst ihn mit einem bekannten Ziel. Das war’s!
Der marginale Wahrscheinlichkeitspfad, der die gesamte Rauschverteilung mit der gesamten Datendistribution verbindet, lässt sich nicht direkt hinschreiben.
Die Zielgeschwindigkeit an einem Punkt zu berechnen, hieße, alle Datenpunkte zu berücksichtigen, die ihn hätten erzeugen können – ein Integral über deinen gesamten Datensatz, das niemand bei jedem Trainingsschritt ausrechnet.
Conditional Flow Matching löst das, indem es auf einzelne Samples konditioniert statt auf den vollen Pfad. Statt das Vektorfeld für den gesamten marginalen Pfad zu berechnen, wählst du einen Datenpunkt und einen Rauschpunkt und konstruierst einen Wahrscheinlichkeitspfad nur für dieses Paar. Wenn du diesen konditionalen Pfad einfach machst – etwa als gerade Linie zwischen beiden Punkten –, hat die Zielgeschwindigkeit eine geschlossene Form, die du direkt berechnen kannst.
Trainierst du das Netzwerk auf diesen einfachen, paarweisen konditionalen Geschwindigkeiten und mittelt das über genügend Paare, erhältst du dasselbe Vektorfeld, das auch das unhandliche marginale Ziel liefern würde. Du berechnest den marginalen Pfad nie direkt – du näherst ihn indirekt an, einen einfachen konditionalen Pfad nach dem anderen.
Diese konditionale Variante wird in der Praxis fast immer trainiert. Die marginale Formulierung macht die Mathematik schlüssig, aber die konditionale Formulierung funktioniert praktisch.
Diffusion und Flow Matching werden aus gutem Grund ständig verglichen – viele der „Diffusionsmodelle“, die du kennst, laufen inzwischen mit einem Flow-Matching-Ziel. Das heißt nicht, dass Flow Matching Diffusion ersetzt hat. Es bedeutet, dass Diffusion ein spezieller Fall in einem größeren Rahmen ist – und Flow Matching dessen allgemeinere Variante.
Beginnen wir mit der Vorhersage des Netzwerks. Ein Diffusionsmodell sagt Rauschen voraus. Gegeben ein verrauschtes Sample und einen Zeitschritt, sagt es das beigemischte Rauschen vorher und entfernt es dann Schritt für Schritt. Flow Matching sagt stattdessen eine Geschwindigkeit voraus. Gegeben ein Sample und einen Zeitschritt, sagt es Richtung und Tempo, mit der sich das Sample zur Datendistribution bewegen soll.
Am Wahrscheinlichkeitspfad unterscheiden sich beide am stärksten.
Diffusionsmodelle fixieren von Anfang an einen bestimmten Noising-Prozess, meist Gaußsches Rauschen mit festem Zeitplan – alles andere folgt aus dieser Wahl. Bei Flow Matching kannst du jeden Pfad wählen, der Rauschen und Daten verbindet, und das Ziel funktioniert unabhängig von deiner Wahl gleich. Ein gaußscher Diffusionspfad ist eine Option. Eine Gerade zwischen Rauschen und Daten ist eine andere – und sie beeinflusst stark, wie schnell du samplest.
Diese beiden Vorhersagen sind sich näher, als sie wirken.
Die Rauschvorhersage eines Diffusionsmodells und die Geschwindigkeitsvorhersage eines Flow-Matching-Modells sind zwei Sichten auf dasselbe zugrunde liegende Objekt, verknüpft über den Score der Verteilung zu jedem Zeitpunkt. Der Unterschied liegt in der Generierung. Diffusionssampling ist standardmäßig stochastisch, d. h. jeder Denoising-Schritt fügt wieder etwas Zufall hinzu (deterministische Varianten wie DDIM gibt es auch). Flow Matching ist von Natur aus eine deterministische ODE – dasselbe Startrauschen führt immer zum gleichen Output, und stochastische Varianten gibt es hier ebenfalls.
Sampling heißt in beiden Fällen, eine Differentialgleichung schrittweise zu lösen – vom Rauschen zu den Daten.
Diffusionsmodelle brauchen oft Dutzende Schritte, sofern du keine schnellen Sampler oder Distillation nutzt. Flow Matching – insbesondere bei geraden Pfaden – kommt häufig mit deutlich weniger Schritten aus, ganz ohne diese Tricks. Ein gerader Pfad hat konstante Geschwindigkeit, was für einen Solver viel einfacher exakt zu verfolgen ist als ein gekrümmter.
Der Pfad selbst ist der Vorsprung von Flow Matching.
Diffusionsmodelle sind auf den Noising-Prozess festgelegt, von dem sie abgeleitet wurden. Flow Matching behandelt den Pfad als Designentscheidung, und unterschiedliche Entscheidungen bringen verschiedene Trade-offs mit sich.
|
Diffusionsmodelle |
Flow Matching |
|
|
Was das Netzwerk vorhersagt |
Pro Schritt hinzugefügtes Rauschen |
Geschwindigkeit in Richtung Datendistribution |
|
Wahrscheinlichkeitspfad |
Durch einen spezifischen Noising-Prozess festgelegt |
Frei wählbar; Gerade ist gängig |
|
Zugrunde liegendes Objekt |
Score der verrauschten Verteilung |
Zeitabhängiges Vektorfeld, mit dem Score verknüpft |
|
Generierung |
Standardmäßig stochastisch, deterministische Varianten existieren |
Standardmäßig deterministisch, stochastische Varianten existieren |
|
Sampling-Schritte |
Oft Dutzende ohne Extras |
Oft deutlich weniger, besonders bei geraden Pfaden |
|
Pfadwahl |
Durch den Forward-Prozess fixiert |
Offene Designentscheidung — Diffusion ist ein Spezialfall |
Flow Matching im Vergleich zu Diffusionsmodellen
Diffusion ist nicht die einzige Methode im Vergleich zu Flow Matching. Drei weitere solltest du kennen.
Continuous Normalizing Flows kamen zuerst, und Flow Matching entstand direkt aus deren Trainingsproblemen.
Ein Continuous Normalizing Flow ist die Modellklasse, die Flow Matching hervorbringt – ein Netzwerk, das eine kontinuierliche Transformation zwischen Verteilungen per ODE definiert. Das ursprüngliche Training erforderte, diese ODE vorwärts zu lösen und bei jedem Schritt eine exakte Likelihood zu berechnen, also zu verfolgen, wie sich die Dichte entlang der Transformation ändert. Das ist teuer und skaliert schlecht mit der Netzgröße.
Flow Matching vermeidet all das. Es regressiert direkt auf eine bekannte Zielgeschwindigkeit, statt die ODE zu lösen und Likelihoods im Training zu berechnen. Keine Simulation nötig. Du erhältst weiterhin einen Continuous Normalizing Flow, nur ohne die früheren Trainingskosten.
Score Matching trainiert ein Netzwerk darauf, den Score – den Gradienten der Log-Wahrscheinlichkeitsdichte – auf jedem Rauschlevel vorherzusagen. Das ist das Ziel hinter den Diffusionsmodellen, die du kennst.
Flow Matching trainiert stattdessen auf eine Geschwindigkeit. Beide Größen sind mathematisch verwandt, d. h. unter bestimmten Pfadwahlen kannst du sie ineinander überführen. Aber sie repräsentieren Verschiedenes. Der Score beschreibt die Form der Verteilung zu einem festen Zeitpunkt. Die Geschwindigkeit beschreibt, wie sich ein Sample bewegt, wenn sich die Zeit ändert.
Score Matching fragt nach Geometrie. Flow Matching fragt nach Bewegung.
Rectified Flow ist eine spezielle Wahl innerhalb von Flow Matching.
Flow Matching lässt dich jeden Pfad von Rauschen zu Daten wählen. Rectified Flow wählt gerade Linien – und geht mit einem iterativen Verfahren namens „Reflow“ noch weiter, das die vom trainierten Modell gelernten Pfade begradigt, sodass ein Modell in Runde zwei noch weniger Integrationsschritte zur Generierung braucht.
Deshalb tauchen beide Begriffe oft Seite an Seite auf. Stable Diffusion 3 und Flux nutzen Flow Matching mit einer Pfadwahl nahe Rectified Flow. Flow Matching und Rectified Flow gleichzusetzen, greift jedoch zu kurz. Flow Matching ist der Rahmen. Rectified Flow ist eine Pfadoption darin.
Flow Matching läuft inzwischen in einigen der größten produktiven Generierungssysteme.
Der Grund: Ein Regressions-Loss ist leicht umzusetzen und zu skalieren. Und weil der Pfad eine Designwahl ist, können Teams bei Milliardenparametern einen wählen, der weniger Sampling-Schritte braucht – was in dieser Größenordnung bares Rechnen spart.
Bisher war alles konzeptionell. Jetzt gehen wir das gleiche Prinzip an einem kleinen 2D-Datensatz durch, bei dem du jeden Schritt sehen kannst.
Die Rauschverteilung ist eine Standard-Gauß-Verteilung in 2D, zentriert im Ursprung. Die Zieldistribution sind drei gaußsche Cluster in Dreiecksform – einfach genug für ein kleines Netzwerk und strukturiert genug, um den Lernerfolg zu erkennen.
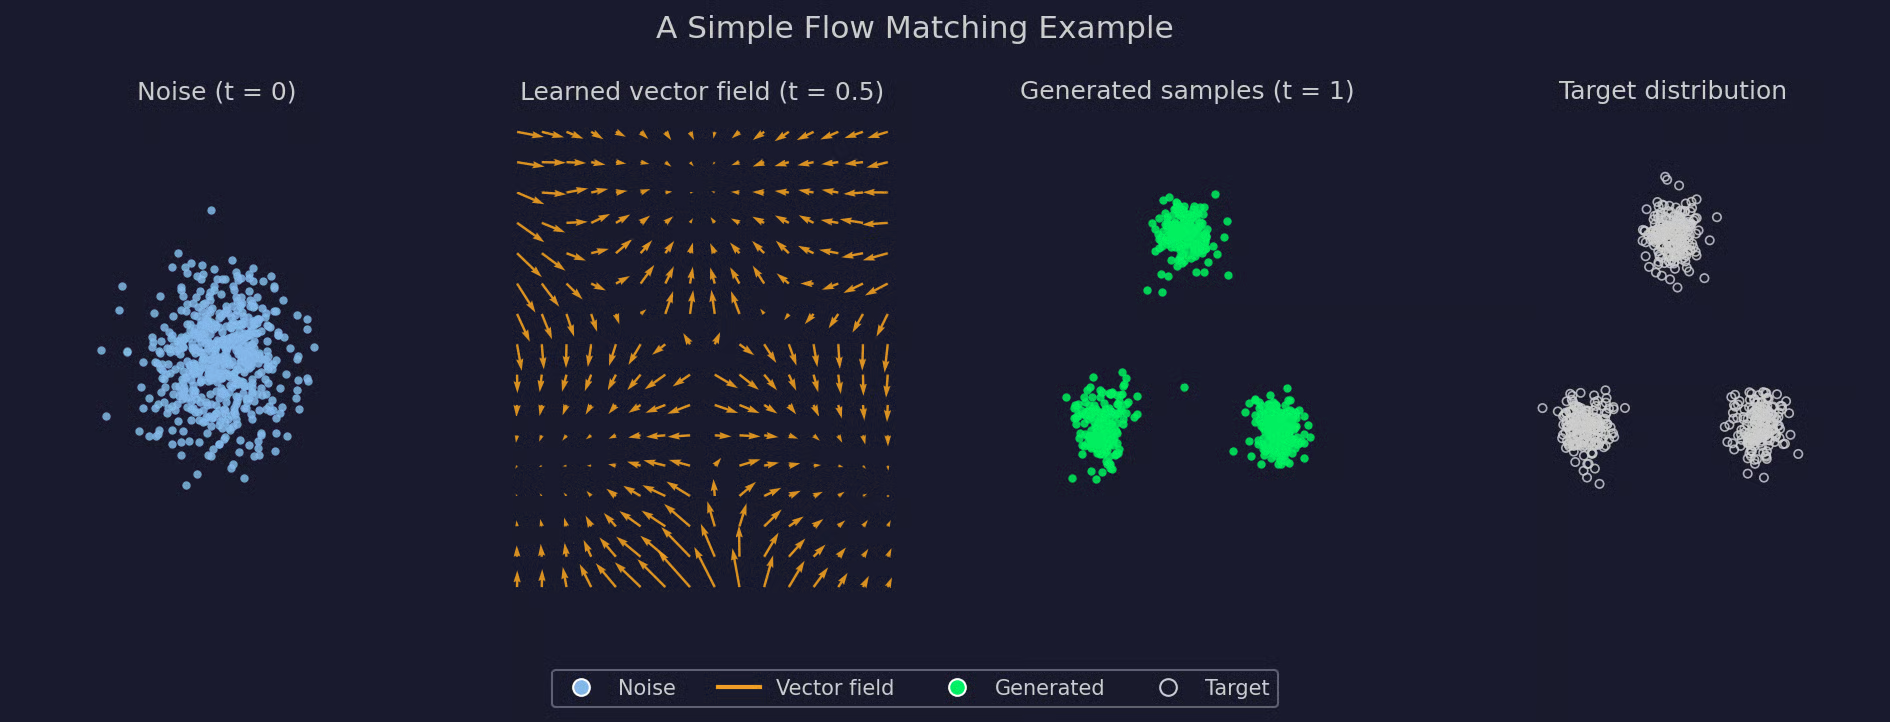
Ein einfaches Flow-Matching-Beispiel
Im ersten Panel starten alle Samples – verstreutes Rauschen ohne Struktur. Das zweite Panel zeigt das Vektorfeld selbst, auf einem Gitter zur Mitte des Trainings ausgewertet. Du siehst, wie die Pfeile bereits zu einem der drei Cluster weisen, lange bevor ein Sample dort ist. Das dritte Panel zeigt, was passiert, wenn du mit frischem Rauschen startest und dem Feld bis t = 1 folgst – drei Cluster entstehen, die das vierte Panel nahezu perfekt widerspiegeln.
Mehr steckt nicht dahinter als in den vorigen Abschnitten: eine Quelle, ein Ziel, ein gelerntes Vektorfeld und ein ODE-Solver, der beides verbindet. Ab zum Code.
Hier ist eine kleine PyTorch-Implementierung desselben Beispiels – mit derselben Rauschquelle und demselben Drei-Cluster-Ziel.
Starte mit den beiden Verteilungen und der Sampling-Logik:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
Das Netzwerk nimmt einen Punkt und einen Zeitschritt und sagt eine Geschwindigkeit vorher:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
Im Training werden pro Schritt Batches aus Quellpunkten, Zielpunkten und Zeitpunkten gesampelt, dann linear interpoliert und auf die resultierende Geschwindigkeit regressiert:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Die Generierung löst die gelernte ODE per einfacher Euler-Integration. Du brauchst nur eine Schleife mit kleinen Schritten von t = 0 bis t = 1:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`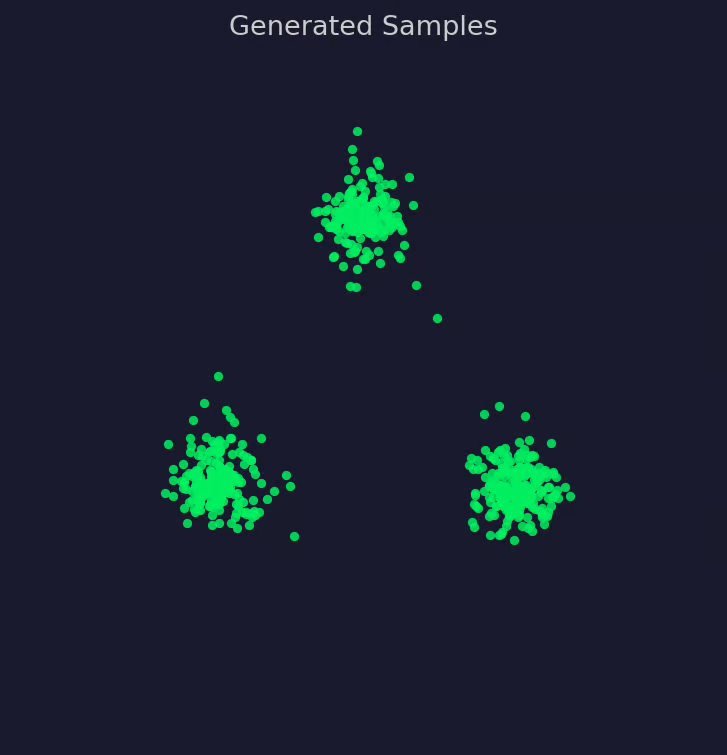
Visualisierung generierter Samples
Und das ist die gesamte Pipeline! Samplen, interpolieren, regressieren, integrieren. Nichts ändert sich konzeptionell, wenn du ein größeres Netzwerk, einen anderen Pfad oder höherdimensionale Daten nutzt – nur der Maßstab.
All das macht Flow Matching nicht zum Allheilmittel gegenüber Diffusion. Es ist eine Abwägung, wie jede Designentscheidung.
Hier spielt es seine Stärken aus – und hier nicht.
Flow Matching bringt einem Modell bei, wie sich Samples von einer einfachen Verteilung in Richtung Datendistribution bewegen sollen. Alles andere in diesem Artikel dient dazu, diese eine Idee trainierbar zu machen.
Zwei Konzepte leisten hier die Hauptarbeit. Ein Wahrscheinlichkeitspfad verbindet Rauschen und Daten über eine Folge von Zwischenverteilungen. Ein Vektorfeld beschreibt, wie sich ein Sample an jedem Punkt dieses Pfads zu jeder Zeit bewegen soll. Das Netzwerk lernt dieses Vektorfeld, seine Geschwindigkeit, und die Generierung ist schlicht das Folgen dieses Flows vom Rauschen zu den Daten.
All das steht nicht losgelöst von früheren Ansätzen. Flow Matching ist, wie moderne Systeme Continuous Normalizing Flows ohne die alte Likelihood-Berechnung trainieren, und Diffusionsmodelle sind ein spezieller Fall davon.
Wenn Diffusionsmodelle, Normalizing Flows oder generative KI allgemein dein Interesse geweckt haben, sind das gute nächste Schritte:
Lerne KI mit DataCamp
Kurs
Kurs
Kurs