course
Understanding Artificial Intelligence
2 घंटा
421.5K
क्या आपने हर नए इमेज और वीडियो मॉडल के साथ "फ्लो मैचिंग" शब्द देखा है, और समझ नहीं पा रहे कि इसका मतलब क्या है?
अधिकतर व्याख्याएँ या तो सीधे डिफरेंशियल इक्वेशंस में कूद जाती हैं या इसे "डिफ्यूजन, लेकिन बेहतर" कहकर छोड़ देती हैं। दोनों ही यह नहीं बताते कि मॉडल क्या सीखता है। Stable Diffusion 3 और Flux दोनों फ्लो मैचिंग पर चलते हैं, और वे कुछ ही स्टेप्स में इमेज जनरेट कर लेते हैं, जबकि पारंपरिक डिफ्यूजन को दर्जनों स्टेप्स चाहिए होते हैं।
सामान्य विचार यह है: अलग-अलग उदाहरण सीखने के बजाय, मॉडल एक वेग क्षेत्र (velocity field) सीखता है जो किसी भी सैंपल को बताता है कि किस दिशा में और कितनी तेजी से आगे बढ़ना है। इसे समझ लेने के बाद, प्रशिक्षण प्रक्रिया, उसके पीछे का गणित, और डिफ्यूजन से संबंध, सब स्पष्ट हो जाता है।
इस लेख में, मैं आपको फ्लो मैचिंग के पीछे की सहज समझ, इसे कैसे प्रशिक्षित किया जाता है, उसका हल्का-फुल्का गणित, और डिफ्यूजन मॉडलों से इसकी तुलना कराऊंगा।
यदि आप इमेज डेटा के लिए AI में नए हैं, तो हमारा 2026 के टॉप 10 विज़न लैंग्वेज मॉडल पढ़ें, जहाँ विज़ुअल रीजनिंग, इमेज विश्लेषण और कंप्यूटर विज़न के अत्याधुनिक मॉडल मिलेंगे।
फ्लो मैचिंग एक प्रशिक्षण उद्देश्य (training objective) है, कोई मॉडल आर्किटेक्चर नहीं।
यह भेद इसलिए महत्वपूर्ण है क्योंकि आप इसे ट्रांसफॉर्मर या लगभग किसी भी नेटवर्क के साथ जोड़ सकते हैं — फ्लो मैचिंग को परिभाषित करता है कि नेटवर्क को क्या भविष्यवाणी करना सिखाया जाता है, न कि नेटवर्क दिखता कैसा है।
और जिसे यह भविष्यवाणी करना सीखता है, वह समय-निर्भर वेक्टर क्षेत्र है। सरल भाषा में, यह एक फ़ंक्शन है जो आपको बताता है कि स्रोत वितरण से लक्ष्य वितरण तक की यात्रा में किसी भी बिंदु पर सैंपल को किस दिशा में और कितनी तेजी से बढ़ना चाहिए। जब आप इसी तरह continuous normalizing flows को प्रशिक्षित करते हैं, तो आपको ऐसा मॉडल मिलता है जो किसी सरल वितरण को क्रमिक रूप से एक जटिल वितरण में बदल देता है।
मैं इस सहज समझ को चार विचारों में बाँटना पसंद करता हूँ:
यदि आप दृश्य-उन्मुख हैं, तो ऐसे बिखरे कणों के बादल की कल्पना करें जिसमें कोई क्रम न हो। फ्लो मैचिंग हर कण को ठीक-ठीक सिखाती है कि किस दिशा में और कितनी तेजी से बढ़ना है, ताकि पूरा बादल समय के साथ एक संरचित पैटर्न में बदल जाए (आपके लक्ष्य वितरण का आकार)।
जब आप इसे एक इमेज डेटासेट पर चलाते हैं, तो "संरचित पैटर्न" का मतलब अनियमित शोर की जगह एक सुसंगत फोटो होता है।
यहाँ प्रशिक्षण और जनरेशन दो अलग-अलग चरण हैं, और अक्सर लोग इन्हें एक मान लेते हैं, यहीं से भ्रम शुरू होता है।
प्रशिक्षण के दौरान:
t चुनेंt के अनुसार डेटा बिंदु और शोर सैंपल को संयोजित करेंt पर उस मध्यवर्ती बिंदु की दिशा और गति निकालेंजनरेशन में डेटा बिंदु की जरूरत नहीं होती।
आप शोर से शुरू करते हैं और सीखे हुए वेक्टर क्षेत्र को समय के साथ छोटे-छोटे कदमों में इंटीग्रेट करते हैं, जब तक कि आप डेटा वितरण से एक सैंपल तक न पहुँच जाएँ।
और बस — प्रशिक्षण के दौरान आप वेग की भविष्यवाणी करते हैं, और जनरेशन के दौरान उसका अनुसरण करते हैं।
फ्लो मैचिंग उद्देश्य के पीछे दो विचार सबसे अधिक काम करते हैं — वेक्टर फ़ील्ड और प्रायिकता-पथ (probability paths)। इन्हें समझ लेने पर अगला लॉस फ़ंक्शन समझ में आ जाएगा।
वेक्टर फ़ील्ड वही है जिसकी नेटवर्क भविष्यवाणी करता है। स्पेस के किसी भी बिंदु और किसी भी समय पर यह आपको दिशा और गति देता है — उस तरीके से जिससे वहाँ मौजूद सैंपल डेटा वितरण के करीब जाए।
उदाहरण के लिए, नदी में खड़े होने की कल्पना करें। आप जहाँ भी खड़े हैं, धारा आपको किसी दिशा में एक निश्चित बल से धकेलती है, और बल व दिशा आपकी सटीक स्थिति और समय पर निर्भर करते हैं। वेक्टर फ़ील्ड आपके सैंपल्स के लिए यही काम करता है — यह स्पेस के हर बिंदु और हर समय पर एक दिशा और एक गति आवंटित करता है।
प्रायिकता-पथ उन वितरणों का क्रम है जिनसे होकर कोई सैंपल शोर से डेटा तक पहुँचता है। t = 0 पर आप स्रोत वितरण (आमतौर पर Gaussian शोर) से सैंपल लेते हैं। t = 1 पर आप लक्ष्य डेटा वितरण से सैंपल लेते हैं। इनके बीच की हर चीज़ एक मध्यवर्ती वितरण है, और प्रायिकता-पथ बताता है कि एक कैसे अगले में बदलता है।
वेक्टर फ़ील्ड और प्रायिकता-पथ सीधे जुड़े होते हैं, क्योंकि वेक्टर फ़ील्ड सैंपल्स को इसी पथ पर एक मध्यवर्ती वितरण से अगले तक ले जाता है, जब तक कि वे डेटा वितरण तक न पहुँच जाएँ।
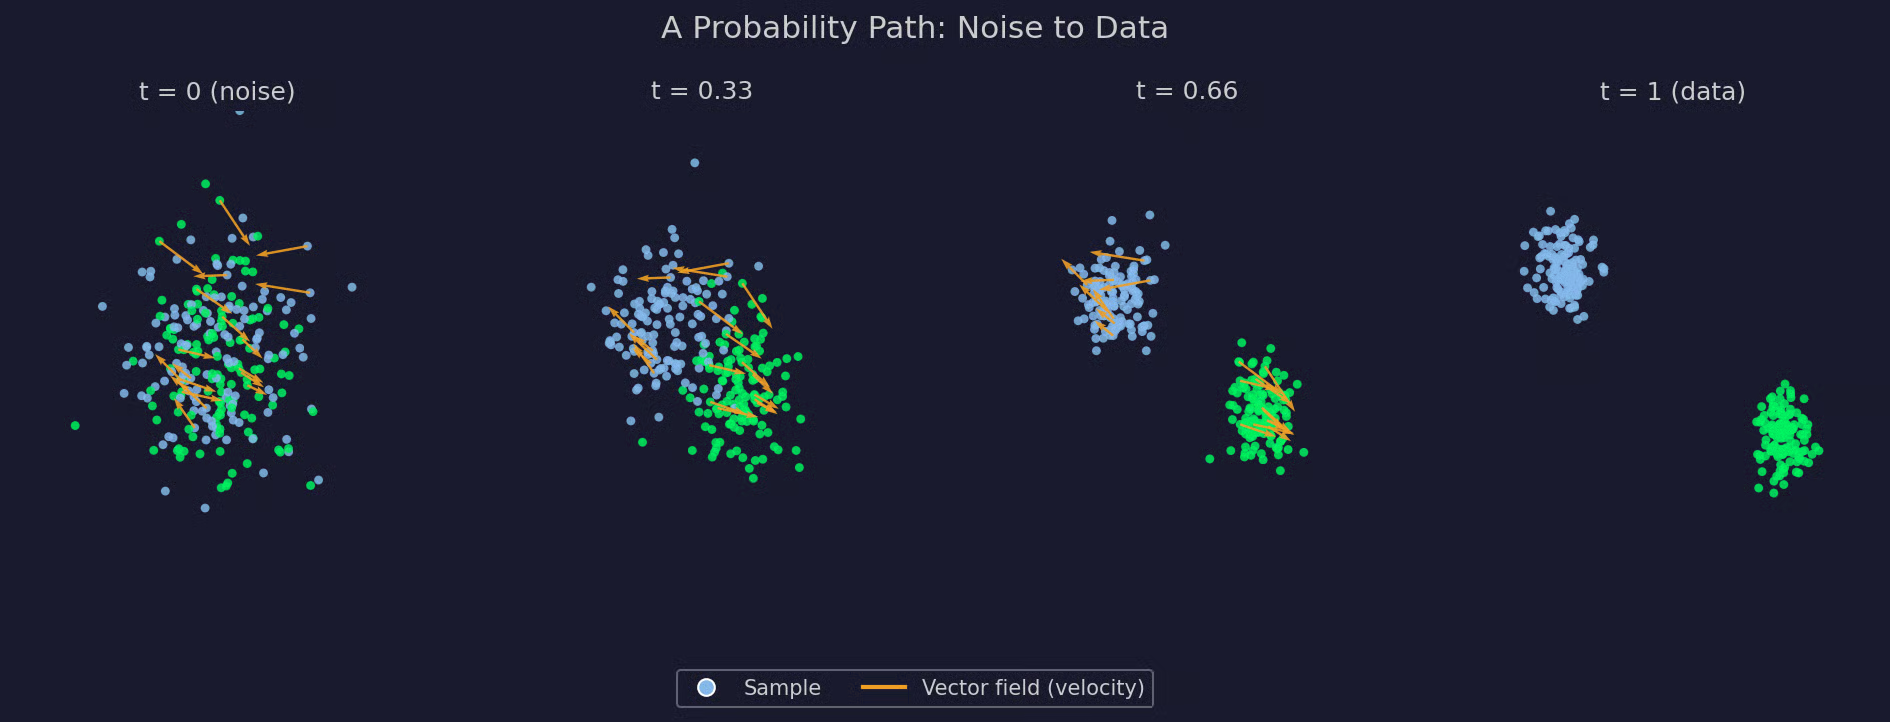
प्रायिकता-पथ का आरेख
फ्लो मैचिंग उद्देश्य वेक्टर फ़ील्ड और प्रायिकता-पथ को एक एकल रिग्रेशन लॉस में बदल देता है।
हर प्रशिक्षण चरण में दो वेगों की तुलना होती है। पहला है लक्ष्य वेग — चुने हुए प्रायिकता-पथ के उस बिंदु पर किसी सैंपल को किस दिशा और गति से बढ़ना चाहिए। दूसरा है मॉडल-प्रीडिक्टेड वेग — वर्तमान सैंपल और समय के आधार पर नेटवर्क का उसी दिशा और गति के लिए अनुमान। प्रशिक्षण इन दोनों को यथासंभव मिलाने की कोशिश करता है।
यह रहा लॉस फ़ंक्शन:
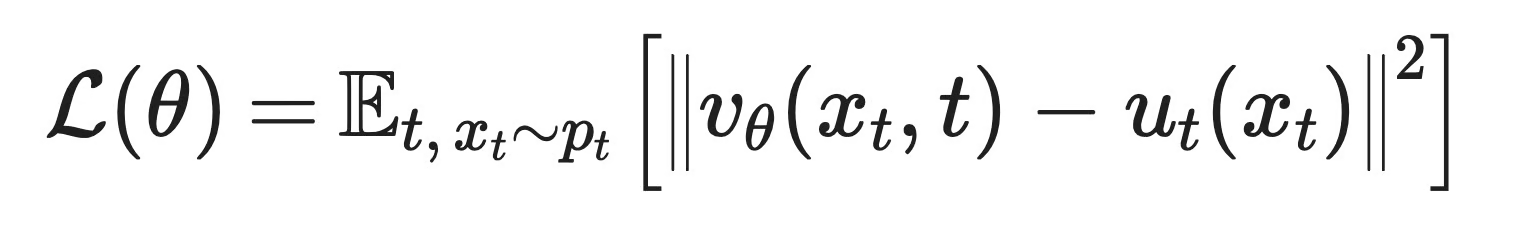
फ्लो मैचिंग लॉस फ़ंक्शन
प्रत्येक पद का अर्थ यह है:
v_θ(x_t, t): बिंदु x_t और समय t पर मॉडल का प्रीडिक्टेड वेग
u_t(x_t): उसी बिंदु और समय पर चुने हुए प्रायिकता-पथ के आधार पर लक्ष्य वेग
𝔼[...]: t और x_t के कई यादृच्छिक मानों पर औसत
‖ · ‖^2: दोनों वेगों के बीच का स्क्वेयर्ड अंतर — साधारण mean squared error
पूर्ण व्युत्पत्ति यहाँ जरूरी नहीं। मायने यह रखता है कि नेटवर्क एक समय और बिंदु पर एक ही वेक्टर की भविष्यवाणी करता है, और आप उसे एक ज्ञात लक्ष्य से तुलना करते हैं। बस इतना ही!
पूर्ण शोर वितरण से पूर्ण डेटा वितरण को जोड़ने वाला मार्जिनल प्रायिकता-पथ सीधे लिख पाना संभव नहीं होता।
किसी दिए गए बिंदु पर लक्ष्य वेग निकालना मतलब उन सभी डेटा सैंपल्स का हिसाब रखना जो उसे पैदा कर सकते थे — आपके पूरे डेटासेट पर एक इंटीग्रल, जिसे कोई भी हर प्रशिक्षण स्टेप पर नहीं गिनता।
कंडीशनल फ्लो मैचिंग इसे पूर्ण पथ की बजाय व्यक्तिगत सैंपल्स पर कंडीशन करके हल करता है। पूरे मार्जिनल पथ के लिए वेक्टर फ़ील्ड निकालने के बजाय, आप एक डेटा बिंदु और एक शोर बिंदु चुनते हैं, फिर उसी जोड़ी के लिए एक प्रायिकता-पथ बनाते हैं। जब आप उस कंडीशनल पथ को सरल रखते हैं, जैसे दोनों बिंदुओं के बीच सीधी रेखा, तो लक्ष्य वेग का एक closed-form मिलता है जिसे सीधे गिना जा सकता है।
काफी जोड़ों पर इन सरल, पेयर-वाइज कंडीशनल वेगों पर नेटवर्क को प्रशिक्षित करने से वही वेक्टर फ़ील्ड मिलता है जो दुर्गम मार्जिनल उद्देश्य देता। आप मार्जिनल पथ को कभी सीधे नहीं गिनते — बल्कि उसे एक-एक करके आसान कंडीशनल पथों के जरिये परोक्ष रूप से करीब पहुँचते हैं।
इसी कंडीशनल संस्करण को लगभग सभी लोग वास्तव में प्रशिक्षित करते हैं। मार्जिनल निर्माण गणित को काम में लाता है, पर कंडीशनल निर्माण व्यवहार में काम आता है।
डिफ्यूजन और फ्लो मैचिंग की तुलना होती रहती है, और वाजिब कारण से — जिन "डिफ्यूजन मॉडलों" को आप जानते हैं, उनमें से अधिकतर अब फ्लो मैचिंग उद्देश्य पर चलते हैं। इसका मतलब यह नहीं कि फ्लो मैचिंग ने डिफ्यूजन को बदल दिया। इसका मतलब है कि डिफ्यूजन एक बड़े ढांचे के भीतर एक खास मामला निकला, और फ्लो मैचिंग उसका सामान्य संस्करण है।
आइए देखें कि प्रत्येक नेटवर्क क्या भविष्यवाणी करता है। एक डिफ्यूजन मॉडल शोर की भविष्यवाणी करता है। किसी noisy सैंपल और समय-चरण के दिए जाने पर, यह मिले हुए शोर का अनुमान लगाता है और उसे एक-एक करके हटाता चलता है। फ्लो मैचिंग इसके बजाय वेग की भविष्यवाणी करता है। किसी सैंपल और समय-चरण के दिए जाने पर, यह अनुमान लगाता है कि डेटा वितरण की ओर उस सैंपल को किस दिशा में और कितनी तेजी से बढ़ना चाहिए।
दोनों में सबसे बड़ा फर्क प्रायिकता-पथ में है।
डिफ्यूजन मॉडल एक तय noising प्रक्रिया पहले से फिक्स कर देते हैं, आमतौर पर एक तय शेड्यूल पर Gaussian शोर जोड़ना, और बाकी सब उसी एक चुनाव से तय होता है। फ्लो मैचिंग में, आप शोर से डेटा तक जोड़ने के लिए कोई भी पथ चुन सकते हैं, और उद्देश्य किसी भी चुने हुए पथ पर एक-सा काम करता है। डिफ्यूजन-शैली का Gaussian पथ एक विकल्प है। शोर और डेटा के बीच सीधी रेखा दूसरा, और यह सैंपलिंग की गति पर काफी असर डालता है।
ये दोनों भविष्यवाणियाँ जितनी अलग दिखती हैं, उतनी हैं नहीं।
डिफ्यूजन मॉडल की शोर-भविष्यवाणी और फ्लो मैचिंग मॉडल की वेग-भविष्यवाणी एक ही अंतर्निहित वस्तु के दो रूप हैं, जो हर समय-बिंदु पर वितरण के स्कोर से जुड़े होते हैं। फर्क जनरेशन के तरीके में है। डिफ्यूजन सैंपलिंग डिफ़ॉल्ट रूप से stochastic है, यानी हर de-noising स्टेप में थोड़ी यादृच्छिकता वापस जुड़ती है (हालाँकि DDIM जैसे deterministic वेरिएंट मौजूद हैं)। फ्लो मैचिंग उल्टा है — इसकी प्राकृतिक संरचना एक deterministic ODE है, इसलिए एक ही शुरुआती शोर हर बार वही आउटपुट देता है, और stochastic रूप यहाँ भी संभव हैं।
दोनों ही मामलों में सैंपलिंग का मतलब एक डिफरेंशियल इक्वेशन को कदम-दर-कदम हल करना है, शोर से डेटा की ओर बढ़ते हुए।
डिफ्यूजन मॉडल अक्सर दर्जनों स्टेप्स मांगते हैं, जब तक कि आप तेज सैंपलर या डिस्टिलेशन न जोड़ें। फ्लो मैचिंग, खासकर जब सीधी-रेखा पथों पर प्रशिक्षित हो, बिना इन तरकीबों के भी कम स्टेप्स में काम कर लेता है — सीधा पथ स्थिर वेग देता है, जिसे कोई सॉल्वर मुड़े हुए पथ की तुलना में अधिक सटीकता से और कम कदमों में फॉलो कर पाता है।
पथ का चुनाव ही वह जगह है जहाँ फ्लो मैचिंग आगे निकलता है।
डिफ्यूजन मॉडल उसी noising प्रक्रिया तक सीमित रहते हैं जिससे वे निकले हैं। फ्लो मैचिंग पथ को एक डिज़ाइन चॉइस मानता है, और अलग-अलग चुनावों के अलग-अलग trade-offs आते हैं।
|
डिफ्यूजन मॉडल |
फ्लो मैचिंग |
|
|
नेटवर्क क्या भविष्यवाणी करता है |
हर स्टेप पर जोड़ा गया शोर |
डेटा वितरण की ओर वेग |
|
प्रायिकता-पथ |
किसी विशिष्ट noising प्रक्रिया द्वारा तय |
स्वतंत्र रूप से चुना जाता है; सीधी रेखाएँ आम हैं |
|
अंतर्निहित वस्तु |
noisy वितरण का स्कोर |
समय-निर्भर वेक्टर फ़ील्ड, स्कोर से जुड़ा |
|
जनरेशन |
डिफ़ॉल्ट रूप से stochastic, पर deterministic रूप मौजूद |
डिफ़ॉल्ट रूप से deterministic, पर stochastic रूप मौजूद |
|
सैंपलिंग स्टेप्स |
अक्सर दर्जनों, बिना अतिरिक्त तरकीबों के |
अक्सर काफी कम, खासकर सीधे पथों के साथ |
|
पथ का चुनाव |
फॉरवर्ड प्रक्रिया द्वारा तय |
एक खुला डिज़ाइन चॉइस — डिफ्यूजन एक उदाहरण |
डिफ्यूजन मॉडलों की तुलना में फ्लो मैचिंग
डिफ्यूजन ही एकमात्र तरीका नहीं जिसकी तुलना फ्लो मैचिंग से होती है। और भी तीन हैं जिनके बारे में आपको जानना चाहिए
Continuous normalizing flows पहले आए, और फ्लो मैचिंग सीधे-सीधे उन्हें प्रशिक्षित करने की दिक्कतों से निकला।
एक continuous normalizing flow वही मॉडल है जिसे फ्लो मैचिंग पैदा करता है — एक नेटवर्क जो ODE के जरिये वितरणों के बीच एक सतत रूपांतरण परिभाषित करता है। इसे मूल तरीके से प्रशिक्षित करने का मतलब था ODE को आगे हल करना और हर स्टेप पर सटीक likelihood निकालना, यानी रास्ते में probability density कैसे बदल रही है उसका हिसाब रखना। यह गणना महँगी है, और नेटवर्क के बड़े होने पर और महँगी हो जाती है।
फ्लो मैचिंग इससे बचाता है। यह प्रशिक्षण के दौरान ODE हल करने और likelihoods गिनने के बजाय सीधे ज्ञात लक्ष्य वेग पर रिग्रेस करता है। कोई सिमुलेशन जरूरी नहीं। अंत में आपको continuous normalizing flow ही मिलता है, बस वहाँ तक पहुँचने की पहले वाली ट्रेनिंग-लागत नहीं चुकानी पड़ती।
स्कोर मैचिंग नेटवर्क को स्कोर — log probability density का ग्रेडिएंट — की भविष्यवाणी करना सिखाता है, हर noise स्तर पर। यही वह उद्देश्य है जिसके पीछे वे डिफ्यूजन मॉडल हैं जिन्हें आप जानते हैं।
फ्लो मैचिंग इसके बजाय वेग की भविष्यवाणी करना सिखाता है। दोनों वस्तुएँ गणितीय रूप से संबंधित हैं, यानी कुछ पथ-चयनों के तहत आप एक को दूसरे में बदल सकते हैं। पर वे अलग चीजें दर्शाती हैं। स्कोर किसी निश्चित समय पर वितरण के आकार का वर्णन करता है। वेग बताता है कि समय बदलने पर सैंपल को कैसे चलना चाहिए।
स्कोर मैचिंग ज्योमेट्री के बारे में पूछता है। फ्लो मैचिंग गति के बारे में।
Rectified flow, फ्लो मैचिंग के भीतर एक विशेष चुनाव है।
फ्लो मैचिंग आपको शोर से डेटा तक कोई भी प्रायिकता-पथ चुनने देता है। Rectified flow एक पथ चुनता है — सीधी रेखाएँ — और फिर "reflow" नाम की एक iterative प्रक्रिया से एक कदम और आगे बढ़ता है, जो पहले से प्रशिक्षित मॉडल के सीखे पथों को और सीधा कर देती है, ताकि दूसरी बार के मॉडल को जनरेशन समय पर और भी कम इंटीग्रेशन स्टेप्स चाहिए हों।
इसीलिए दोनों शब्द एक ही पेपर्स में साथ दिखते हैं। Stable Diffusion 3 और Flux दोनों, फ्लो मैचिंग के साथ किसी हद तक rectified-flow जैसे पथ-चयन का उपयोग करते हैं। लेकिन फ्लो मैचिंग और rectified flow को एक-दूसरे का पर्याय मान लेना गलत है। फ्लो मैचिंग फ्रेमवर्क है। Rectified flow उसके भीतर चुना जाने वाला एक पथ है।
फ्लो मैचिंग अब प्रोडक्शन में चल रही कुछ सबसे बड़ी जेनरेटिव प्रणालियों के अंदर काम कर रहा है।
यह सब इसलिए संभव है क्योंकि रिग्रेशन लॉस लागू करना और स्केल करना सरल है। और क्योंकि पथ एक डिज़ाइन चॉइस है, बिलियन-पैरामीटर सिस्टम बनाने वाली टीमें ऐसा पथ चुन सकती हैं जिसे कम सैंपलिंग स्टेप्स चाहिए — और उस पैमाने पर हर स्टेप की कम्प्यूट लागत मायने रखती है।
अब तक सब अवधारणात्मक था। अब मैं आपको यही विचार एक वास्तविक 2D डेटासेट पर चलाकर दिखाऊँगा, इतना छोटा कि हर चरण को देखा जा सके।
शोर वितरण एक मानक 2D Gaussian है, केंद्र मूलबिंदु पर। लक्ष्य वितरण तीन Gaussian क्लस्टर्स हैं जो एक त्रिभुज में सजे हैं — इतना सरल कि छोटा नेटवर्क जल्दी सीख ले, पर इतना संरचित कि आप पहचान सकें कि यह सही सीखा या नहीं।
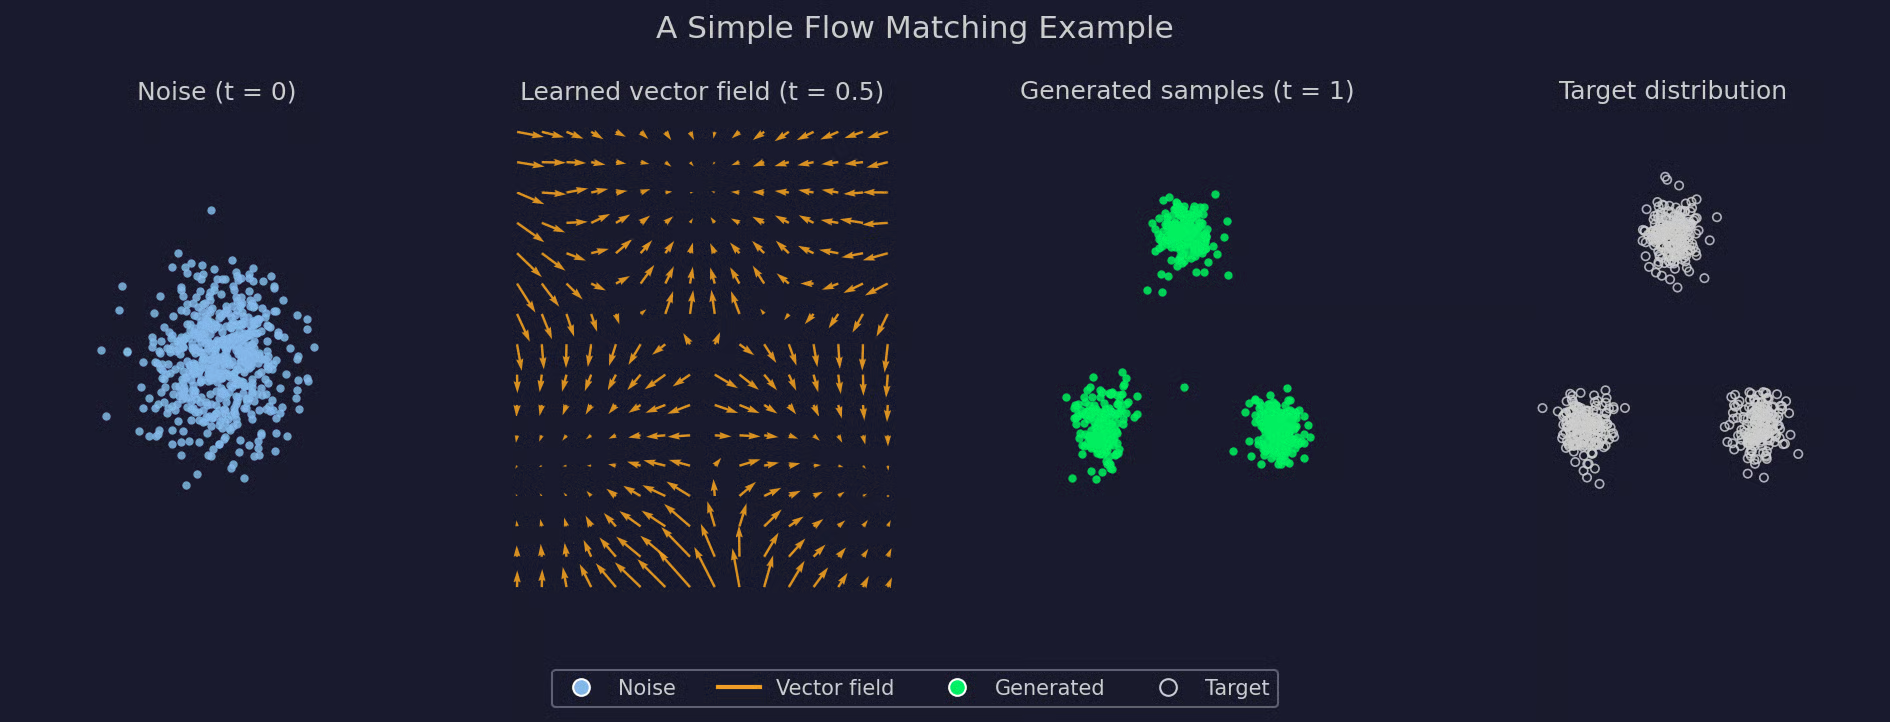
सरल फ्लो मैचिंग उदाहरण
पहला पैनल वह है जहाँ हर सैंपल शुरू होता है — बिना संरचना का बिखरा शोर। दूसरा पैनल खुद वेक्टर फ़ील्ड है, प्रशिक्षण के मध्य में ग्रिड पर मूल्यांकित। ध्यान दें कि तीर पहले से ही तीन क्लस्टर्स में से एक की ओर इशारा कर रहे हैं, काफी पहले कि कोई सैंपल वहाँ पहुँचे। तीसरा पैनल दिखाता है कि नए शोर से शुरू करके जब आप t = 1 तक उस फ़ील्ड का अनुसरण करते हैं तो क्या होता है — तीन क्लस्टर्स उभरते हैं, जो चौथे पैनल से लगभग पूरी तरह मेल खाते हैं।
यहाँ कुछ भी ऐसा नहीं था जो पहले के सेक्शनों में कवर न हुआ हो — एक स्रोत वितरण, एक लक्ष्य वितरण, सीखा हुआ वेक्टर फ़ील्ड, और इन्हें जोड़ने वाला एक ODE सॉल्वर। अब कोड की ओर।
यह रहा उसी उदाहरण का एक छोटा PyTorch इम्प्लीमेंटेशन, जिसमें वही शोर स्रोत और तीन-क्लस्टर लक्ष्य है।
दोनों वितरणों और उनसे सैंपल कैसे लें, इससे शुरू करें:
import torch
import torch.nn as nn

torch.manual_seed(0)

# Three Gaussian clusters as the target ("data") distribution
centers = torch.tensor([[0.0, 3.0], [-2.6, -1.6], [2.6, -1.6]])

def sample_target(n):
    idx = torch.randint(0, 3, (n,))
    return centers[idx] + 0.4 * torch.randn(n, 2)

def sample_source(n):
return torch.randn(n, 2)
नेटवर्क खुद एक बिंदु और एक समय-चरण लेता है, और एक वेग की भविष्यवाणी करता है:
class VelocityNet(nn.Module):
    def __init__(self, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(3, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2),
        )

def forward(self, x, t):
    return self.net(torch.cat([x, t], dim=1))
प्रशिक्षण हर स्टेप पर स्रोत बिंदुओं, लक्ष्य बिंदुओं और समय-चरणों का एक बैच सैंपल करता है, फिर पहले दो के बीच इंटरपोलेट करता है और प्राप्त वेग पर रिग्रेस करता है:
model = VelocityNet()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(3000):
    # source (noise) points
    x0 = sample_source(256)
    # target (data) points
    x1 = sample_target(256)
    # random time steps
    t = torch.rand(256, 1)

    # interpolate along a straight-line path
    xt = (1 - t) * x0 + t * x1
    # target velocity for that path
    target_v = x1 - x0

    pred_v = model(xt, t)
    loss = ((pred_v - target_v) ** 2).mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
जनरेशन सीखे हुए ODE को सादे Euler इंटीग्रेशन से हल करती है। आपको बस एक लूप चाहिए जो t = 0 से t = 1 तक छोटे-छोटे कदम ले:
@torch.no_grad()
def generate(model, n_samples, n_steps=100):
    x = sample_source(n_samples)
    dt = 1.0 / n_steps
    for i in range(n_steps):
        t = torch.full((n_samples, 1), i * dt)
        x = x + model(x, t) * dt
    return x

samples = generate(model, n_samples=600)
`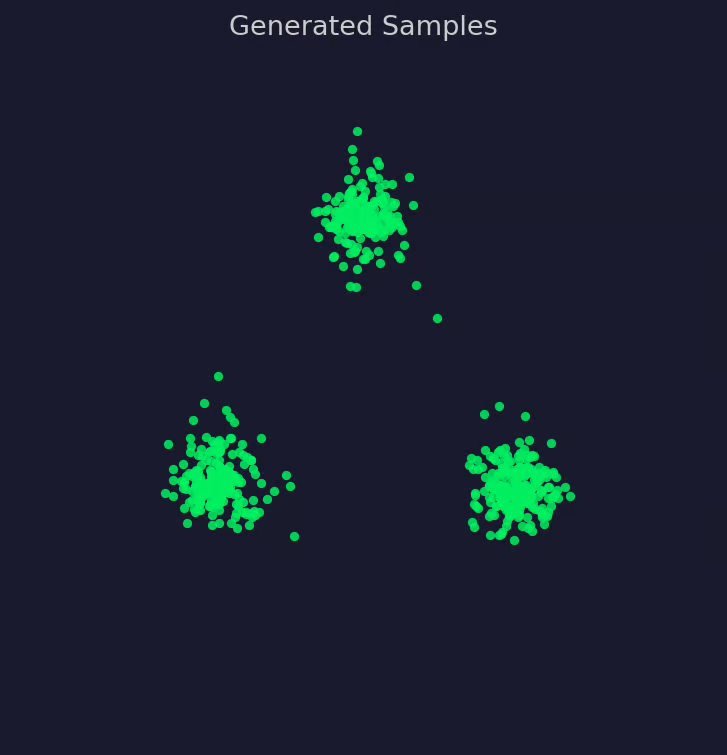
जनरेटेड सैंपल्स का दृश्यांकन
और यही पूरी पाइपलाइन है! सैंपल करें, इंटरपोलेट करें, रिग्रेस करें, इंटीग्रेट करें। आप बड़ा नेटवर्क लें, अलग पथ लें, या उच्च-आयामी डेटासेट — यहाँ कुछ नहीं बदलता, बस स्केल बदलता है।
यह सब फ्लो मैचिंग को डिफ्यूजन पर सार्वभौमिक अपग्रेड नहीं बनाता। यह भी एक trade-off है, जैसे कोई भी डिज़ाइन चॉइस।
यहाँ देखें जहाँ यह अच्छा विकल्प है और जहाँ नहीं।
फ्लो मैचिंग मॉडल को सिखाता है कि सैंपल्स किसी सरल वितरण से डेटा वितरण की ओर कैसे बढ़ें। इस लेख में मैंने जो भी बताया, वह इसी एक विचार को प्रशिक्षित करने योग्य बनाने के लिए है।
दो विचार यहाँ अधिकांश काम करते हैं। एक प्रायिकता-पथ, शोर को मध्यवर्ती वितरणों की श्रृंखला से होते हुए डेटा से जोड़ता है। एक वेक्टर फ़ील्ड बताता है कि उस पथ पर, समय के किसी भी क्षण, सैंपल को कैसे चलना चाहिए। नेटवर्क वही वेक्टर फ़ील्ड — उसका वेग — सीखता है, और जनरेशन शोर से डेटा तक उस फ्लो का अनुसरण करना भर है।
यह सब पहले से मौजूद तरीकों से अलग-थलग नहीं है। फ्लो मैचिंग, पुराने likelihood गणना के बिना आधुनिक प्रणालियाँ continuous normalizing flows कैसे प्रशिक्षित करती हैं, यही है; और डिफ्यूजन मॉडल्स, दरअसल, इसका एक विशिष्ट मामला निकलते हैं।
यदि डिफ्यूsion मॉडल, normalizing flows, या व्यापक तौर पर जेनरेटिव AI में आपकी रुचि है, तो आगे यही पढ़ें:
DataCamp के साथ AI सीखें
course
course
course