Corso
Introduzione al Data Engineering
4 ore
130K
Quando lavoriamo con grandi quantità di dati strutturati e semi-strutturati provenienti da varie fonti, pensiamo a un archivio centralizzato in cui conservarli. La prospettiva sui data warehouse cambia continuamente, e le soluzioni basate sul cloud offrono prestazioni, flessibilità e scalabilità eccezionali. Google BigQuery e Amazon Redshift sono le soluzioni principali in questo ambito.
Le potenti funzionalità di elaborazione, analisi e archiviazione dei dati di entrambi i data warehouse cloud consentono ai professionisti dei dati di gestirli in modo più efficace ed efficiente.
In questo articolo metterò a confronto in modo approfondito queste piattaforme, incluse le loro funzionalità, i vantaggi, gli svantaggi e le buone pratiche. Esaminiamo i dettagli per aiutarti a individuare l’opzione migliore per le tue esigenze!
Google BigQuery è un data warehouse completamente gestito e serverless offerto da Google Cloud Platform (GCP). BigQuery è progettato per gestire dataset enormi, abilitare l’analisi in tempo reale e supportare flussi di lavoro di machine learning con una gestione minima dell’infrastruttura. La sua architettura serverless ti consente di usare query SQL per analizzare i tuoi dati.
BigQuery presenta i dati in tabelle, righe e colonne, supportando le semantiche delle transazioni del database (ACID). L’archiviazione di BigQuery è replicata automaticamente in più posizioni per garantire un’elevata disponibilità.
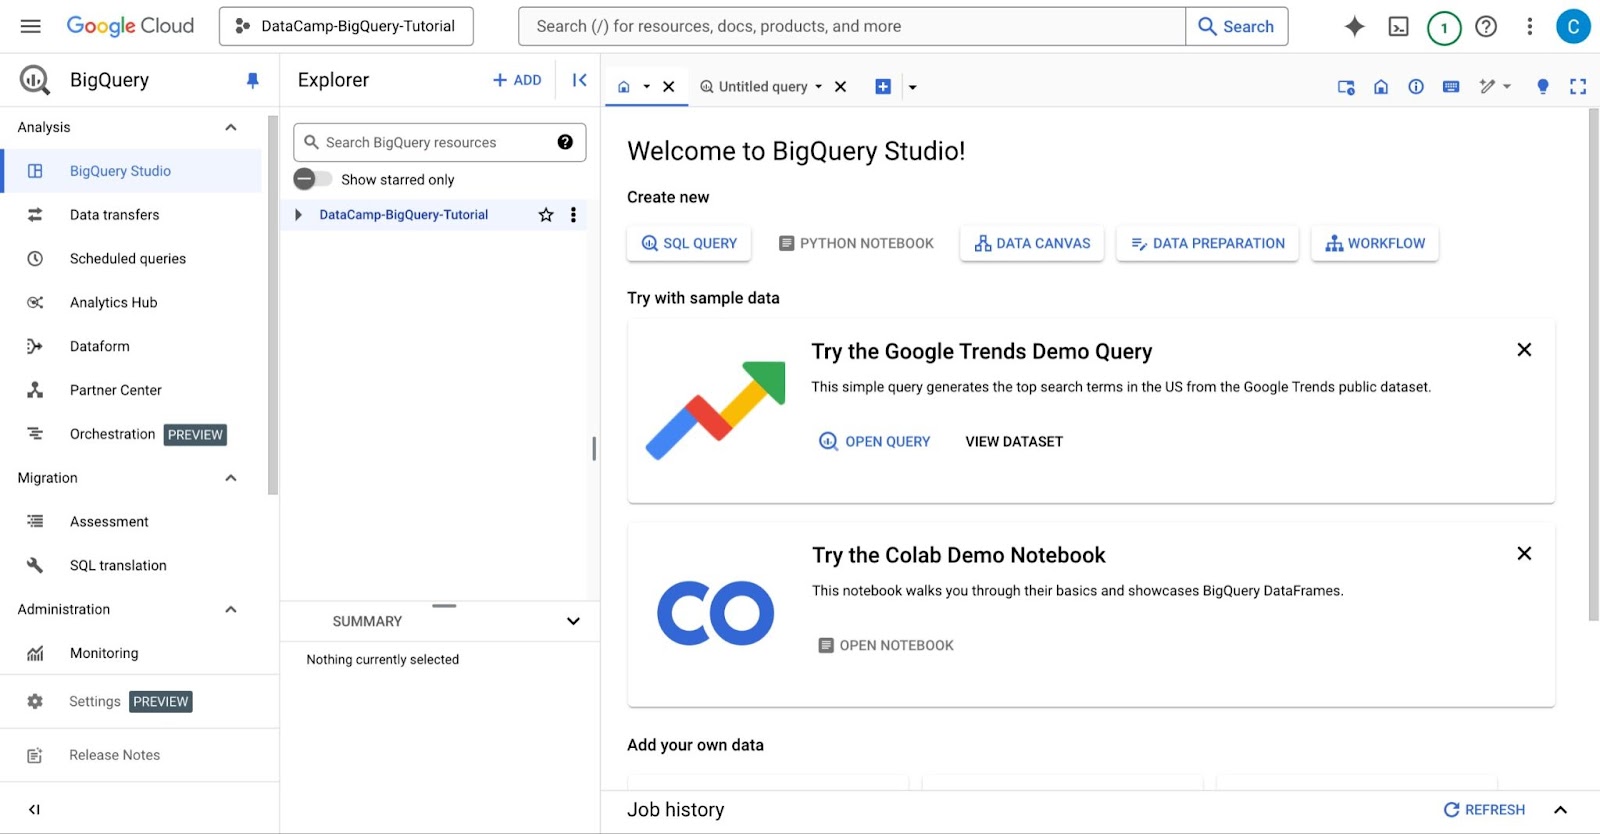
Interfaccia GCP: interfaccia principale della console BigQuery.
Funzionalità principali di BigQuery:
Casi d’uso di BigQuery:
Amazon Redshift è una soluzione di data warehousing basata sul cloud che fa parte della più ampia piattaforma di cloud computing Amazon Web Services (AWS). Con l’architettura a cluster di Redshift, gli utenti possono accedere e analizzare carichi di lavoro su larga scala e prevedibili, senza dover gestire direttamente l’infrastruttura.
Redshift consente di caricare i dati e iniziare subito a eseguire query usando il query editor v2 di Amazon Redshift o il proprio strumento di business intelligence (BI) preferito. Il servizio offre il miglior rapporto prezzo-prestazioni e funzionalità SQL familiari in un ambiente facile da usare e senza amministrazione.
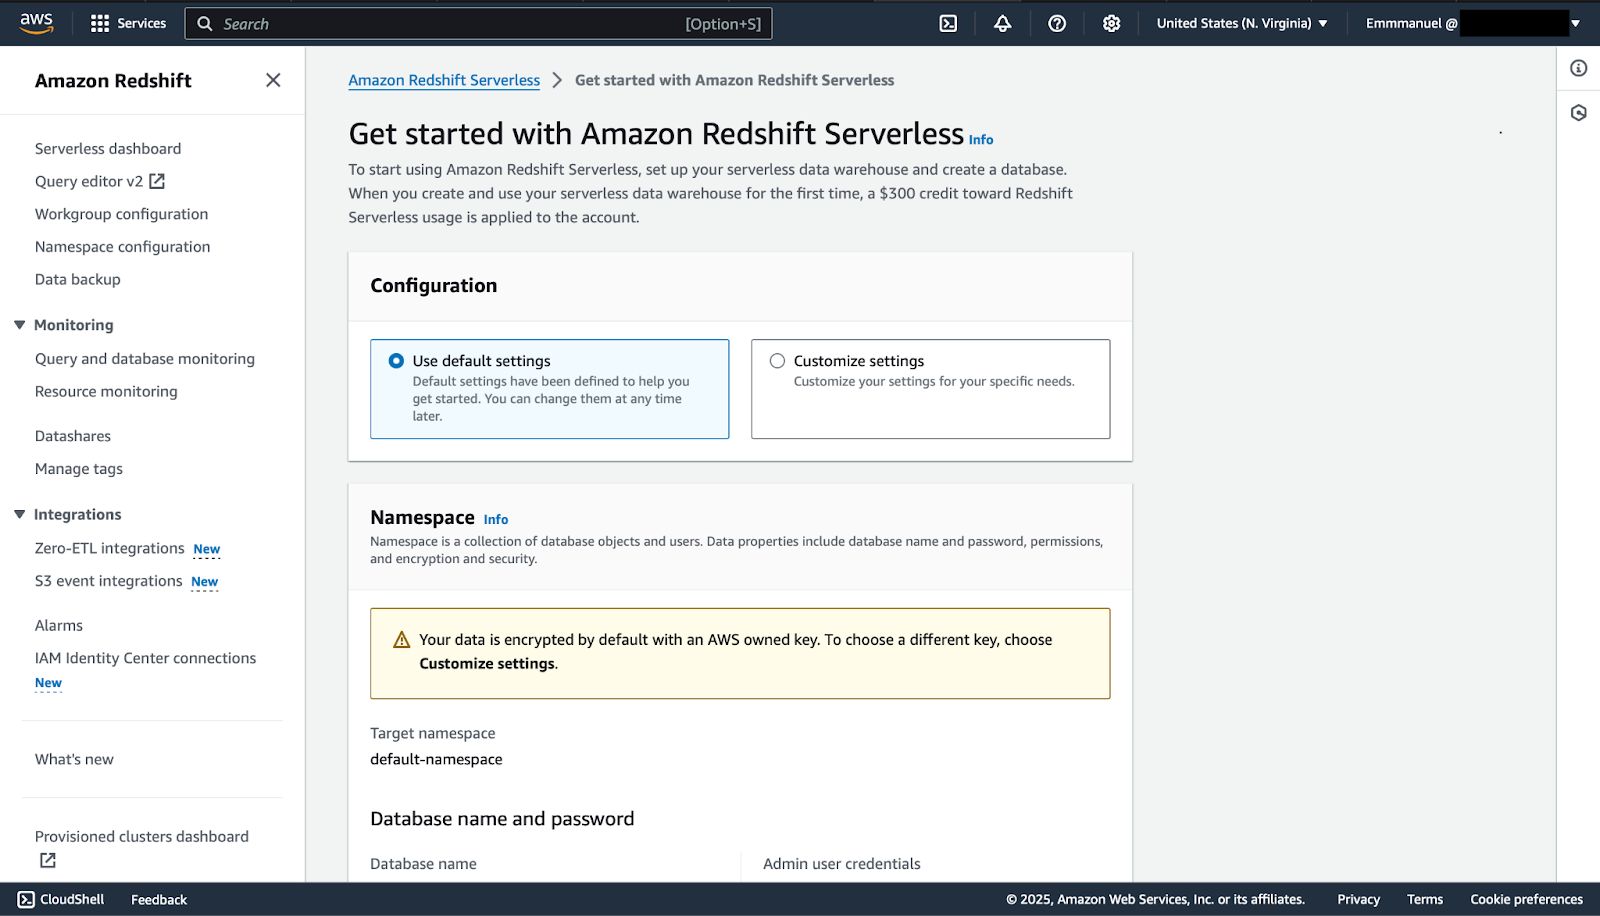
Interfaccia AWS: interfaccia principale della console Amazon Redshift.
Funzionalità principali di Redshift:
Casi d’uso di Redshift:
Dopo una breve panoramica di questi due data warehouse cloud, esaminiamo da vicino le loro differenze in vari ambiti.
L’architettura della piattaforma descrive come dovrebbero funzionare i sistemi. Qui evidenzierò la differenza tra il modello di pricing serverless e basato sulle query di BigQuery e l’approccio basato sui cluster di Redshift.
Se preferisci un approccio hands-off con scalabilità automatica, BigQuery è il tuo punto di riferimento per il data warehousing.
Con BigQuery non devi gestire alcuna infrastruttura; Google si occupa di tutto, dal provisioning alla scalabilità. Con BigQuery paghi solo per le query che esegui e per lo storage che utilizzi. Questo modello pay-as-you-go è conveniente e ti aiuta a non sostenere costi per risorse inattive.
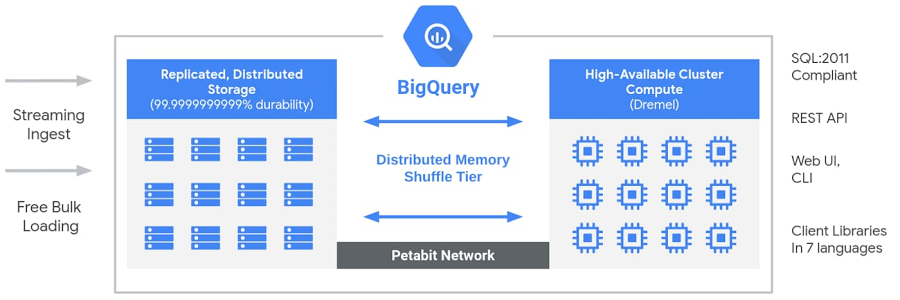
Architettura BigQuery (Fonte: blog Google Cloud).
Se hai bisogno di un maggiore controllo sulla tua infrastruttura e sai gestire efficacemente i cluster, Amazon Redshift sarà più adatto a te. Redshift richiede di configurare e gestire i cluster scegliendo il tipo di istanza, il numero di nodi e la configurazione. Questo ti dà controllo sull’infrastruttura ma, per esperienza, aggiunge anche complessità.
Redshift offre sia un approccio a prenotazione sia on-demand. Con le istanze riservate ricevi uno sconto e ti impegni a una capacità specifica per un periodo predefinito (ad esempio uno o tre anni). Il pricing on-demand ti permette di pagare la capacità utilizzata a ore, ma una gestione impropria può renderlo più costoso.
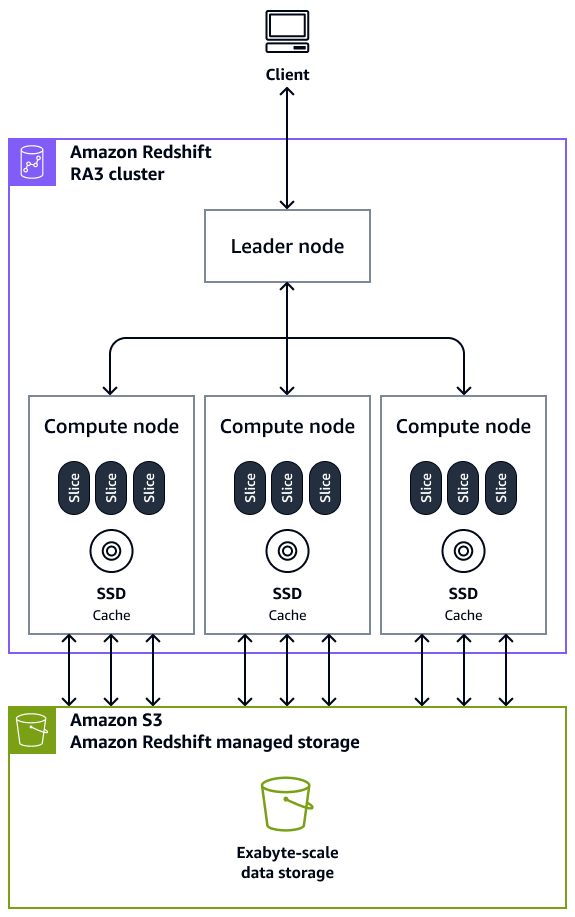
Architetta Amazon Redshift (Fonte: AWS).
Sia Google BigQuery sia Amazon Redshift offrono prestazioni notevoli per query su larga scala, ma danno il meglio in casi diversi. Vediamo come entrambe le piattaforme gestiscono le prestazioni per query di grandi dimensioni, evidenziando l’ottimizzazione di BigQuery per le query ad hoc e il controllo sui cluster di Redshift per carichi prevedibili.
BigQuery è progettato per gestire facilmente carichi di lavoro dinamici grazie alla sua architettura serverless. Questo consente a BigQuery di effettuare l’autoscaling dei carichi, garantendo alte prestazioni per query ad hoc su larga scala. L’archiviazione colonnare di BigQuery è altamente efficiente per le query analitiche: questo formato riduce la quantità di dati letti dal disco, accelerando l’esecuzione delle query.
Redshift può essere un’opzione migliore se sai gestire i cluster per prestazioni affidabili in ambienti con carichi di lavoro prevedibili. Puoi ottimizzare i cluster per prestazioni di query costanti, assicurando che le risorse siano adeguate ai requisiti del tuo business.
Redshift offre diverse opzioni di tuning delle prestazioni, come chiavi di ordinamento e di distribuzione, per ottimizzare l’esecuzione delle query. Questa funzionalità può portare a prestazioni migliori per carichi prevedibili, ma solo se sai quello che stai facendo! Per esperienza, la curva di apprendimento può essere ripida.
Capire prezzi e strutture dei costi è essenziale nella scelta di un data warehouse, perché vogliamo essere responsabili di ogni dollaro speso.
Vediamo come il modello di pagamento per query e le spese di archiviazione di Google BigQuery si confrontano con il pricing basato sui cluster di Amazon Redshift con sconti sulle istanze riservate:
|
Fattore di costo |
BigQuery |
Redshift |
|
Free tier |
10 GB gratis al mese |
Non c’è un free tier, ma offre una prova gratuita di 2 mesi |
|
Costi di storage |
$20 per TB per lo storage logico attivo, $10 per il lungo termine |
$0,025 per GB al mese per SSD, $0,08 per GB per RA3 |
|
Costi delle query |
$5 per TB per le query on-demand |
Basati sull’uso delle istanze di calcolo e sullo storage |
|
Costi di calcolo |
Addebiti basati sulla capacità di calcolo (per slot-ora) |
Fatturazione oraria (on-demand o prezzi riservati) |
|
Scalabilità |
Scalabilità automatica con autoscaler |
Scalabilità manuale con gestione dei nodi |
|
Costi di backup |
Addebiti per lo storage a lungo termine oltre il free tier |
Inclusi per i backup di base, costi extra per ulteriori snapshot |
|
Costi aggiuntivi |
Nessuno per backup o scalabilità |
Addebiti per la concurrency scaling dopo la prova gratuita |
Uno dei fattori più importanti da considerare nella scelta del data warehouse è la scalabilità.
Vediamo come BigQuery aumenta automaticamente capacità di storage e calcolo in base alla domanda e come Redshift richiede lo scaling manuale dei cluster, che può richiedere più tempo.
BigQuery è la piattaforma preferita quando sei certo che il tuo business crescerà insieme ai suoi carichi di lavoro e alle infrastrutture. La funzionalità di autoscaling di BigQuery ti solleva da questo onere, facendoti risparmiare tempo e fatica, così puoi concentrarti interamente sull’analisi dei dati.
In circostanze ideali, Redshift è migliore se la tua azienda ha abbastanza data engineer. Sebbene Redshift richieda una gestione più attiva, può risultare vantaggioso, soprattutto se hai bisogno di un controllo più preciso e vuoi gestire le risorse.
Lo svantaggio è che la gestione richiede molto tempo, anche se ti dà libertà. Il tuo flusso di lavoro può diventare più complesso a causa della necessità di pianificare, monitorare le prestazioni e intervenire quando è necessario scalare.
Sia Google BigQuery sia Amazon Redshift offrono vantaggi specifici quando si integrano con le rispettive piattaforme di cloud computing.
BigQuery funziona in modo fluido per i team che utilizzano GCP e i suoi servizi, come Google Compute Engine, Cloud Storage e Cloud Run; in tal caso, può essere vantaggioso usare BigQuery per mantenere le pipeline di dati all’interno dello stesso ambiente.
Questa integrazione con la suite di strumenti e servizi Google rende BigQuery l’opzione preferita per il data warehousing se la tua azienda utilizza già l’ecosistema Google, perché offre un flusso di lavoro senza soluzione di continuità con i suoi servizi.
Amazon Redshift si sincronizzerà bene con altri servizi nell’ecosistema AWS. Può integrarsi con Amazon S3, AWS Lambda e AWS Glue, offrendoti un facile accesso ad altri servizi e risorse AWS. A mio avviso, questo è un grande vantaggio!
La differenza chiave tra Google BigQuery e Amazon Redshift riguarda il livello di responsabilità operativa che questi servizi demandano ai loro clienti.
Poiché non dobbiamo preoccuparci di gestire l’infrastruttura sottostante, con BigQuery Google si occupa di tutto, dal provisioning alla scalabilità. Questa caratteristica fa risaltare BigQuery per le aziende con pochi ingegneri infrastrutturali che vogliono evitare responsabilità operative.
Redshift, invece, richiede maggiore competenza tecnica ed esperienza. Se il tuo team ha ingegneri infrastrutturali, ci saranno meno problemi nella gestione di backup, scalabilità manuale e provisioning dei cluster. Per l’azienda, questo offre controllo e flessibilità sull’infrastruttura.
Ci sono vari casi d’uso e scenari in cui Google BigQuery diventa la soluzione ideale di data warehousing. Scegli BigQuery se:
Essendo costruito su Google Cloud Platform, BigQuery è più compatibile con chi è fortemente investito in GCP. Se hai la maggior parte delle risorse su Google Cloud Platform, come Google Compute Engine, Cloud Storage e Cloud Run, potrebbe essere vantaggioso mantenere le pipeline di dati nello stesso ambiente.
BigQuery è uno strumento potente per gestire grandi dataset per query ad hoc o analisi in tempo reale. Poiché non devi gestire l’infrastruttura, questo assicura che le tue query vengano elaborate in modo rapido ed efficiente; il carico di lavoro si adatta automaticamente indipendentemente da dimensioni o complessità dei dati.
Se al tuo team mancano le necessarie risorse DevOps, BigQuery è chiaramente il vincitore. Non devi occuparti della parte tecnica della gestione dell’infrastruttura: ci pensa Google. Questo ti aiuta a concentrarti esclusivamente sugli insight dai dati.
Ci sono scenari e casi d’uso in cui Amazon Redshift è la scelta naturale per il data warehousing. Scegli Redshift se:
Se la tua organizzazione ha distribuito le proprie risorse e si è integrata nell’ecosistema AWS, Redshift è una soluzione naturale. Amazon Redshift funziona con altri servizi AWS come Amazon S3, AWS Lambda e AWS Glue, rendendo possibile affidarsi esclusivamente ad AWS per esigenze di gestione dei dati come archiviazione, elaborazione e automazione.
Redshift è compatibile con carichi pesanti che richiedono prestazioni costanti per pattern di query prevedibili e un funzionamento fluido ed efficiente. Poiché i cluster di Redshift sono personalizzabili e puoi controllare l’infrastruttura, puoi ottimizzare Redshift per soddisfare requisiti prestazionali specifici.
Se il tuo team gestisce workflow ETL complessi con data engineer che amministrano l’infrastruttura, allora Redshift è la scelta giusta. Si adatta bene alle aziende con competenze DevOps per gestire carichi di lavoro pesanti: avrai il controllo su scalabilità, backup e prestazioni.
Ora che abbiamo esaminato alcuni componenti significativi di entrambi gli strumenti, rivediamo i loro punti chiave. Questo dovrebbe aiutarti a decidere quale utilizzare per le tue esigenze specifiche:
|
Funzionalità |
BigQuery |
Redshift |
|
Architettura |
L’architettura serverless significa che non devi gestire alcuna infrastruttura. |
Funziona su un’architettura basata su cluster in cui devi gestire manualmente i cluster. |
|
Prestazioni |
Può gestire rapidamente grandi dataset, soprattutto con analisi in tempo reale o query ad hoc. |
Conosciuto per le prestazioni affidabili con pattern di query prevedibili. |
|
Struttura dei costi |
Utilizza un modello pay-per-query, quindi paghi i dati elaborati da ogni query. |
Utilizza istanze riservate per sconti sui costi, pagando anticipatamente una quantità specifica di risorse di calcolo. |
|
Scalabilità |
La scalabilità automatica è uno dei punti di forza di BigQuery. |
È richiesta la scalabilità manuale, quindi devi gestire il resizing dei cluster, l’allocazione delle risorse e l’ottimizzazione delle prestazioni. |
|
Integrazione con l’ecosistema |
Profonda integrazione con i servizi Google Cloud Platform (GCP), scelta ideale per i team che già lavorano nell’ecosistema Google. |
Si integra perfettamente con l’ambiente Amazon Web Services (AWS) e i suoi servizi per i team che già usano l’ecosistema AWS. |
|
Facilità d’uso |
L’architettura completamente gestita e serverless di BigQuery semplifica l’uso senza richiedere profonde competenze di gestione infrastrutturale. |
Redshift richiede una gestione più pratica. Devi monitorare e gestire cluster, scalabilità e prestazioni. |
Questo articolo ha esplorato i principali confronti tra BigQuery e Redshift, due soluzioni di data warehousing nel cloud con punti di forza e compromessi specifici. La scelta migliore dipende dalle tue esigenze, tra cui volume dei dati, pattern di query e budget.
Se vuoi approfondire queste piattaforme, dai un’occhiata a Introduction to Redshift e Introduction to BigQuery su DataCamp. Questi corsi pratici ti aiuteranno a padroneggiare le basi di ciascuno strumento e a sviluppare competenze operative per lavorare in modo efficace con i moderni data warehouse.
Approfondisci data engineering e tecnologie cloud con i seguenti corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



