Cursus
Introductie tot Data Engineering
4 uur
130.1K
Als we werken met grote hoeveelheden gestructureerde en semi-gestructureerde data uit verschillende bronnen, denken we aan een centrale opslagplaats. Het perspectief op datawarehouses verandert continu, en cloudoplossingen bieden uitzonderlijke prestaties, flexibiliteit en schaalbaarheid. Google BigQuery en Amazon Redshift zijn de toonaangevende oplossingen op dit gebied.
De krachtige mogelijkheden voor dataverwerking, analytics en opslag van beide cloudgebaseerde datawarehouses stellen dataprofessionals in staat hun data effectiever en efficiënter te beheren.
In dit artikel vergelijk ik deze platforms grondig, inclusief hun features, voordelen, nadelen en best practices. Laten we de details bekijken en je helpen de beste optie voor jouw vereisten te kiezen!
Google BigQuery is een volledig beheerd, serverloos datawarehouse binnen Google Cloud Platform (GCP). BigQuery is ontworpen voor het verwerken van enorme datasets, real-time analyse en het ondersteunen van machine learning-workflows met minimale infrastructuurzorg. Dankzij de serverloze architectuur kun je je data analyseren met SQL-queries.
BigQuery presenteert data in tabellen, rijen en kolommen en ondersteunt database-transactie-semantiek (ACID). BigQuery-opslag wordt automatisch gerepliceerd over meerdere locaties voor hoge beschikbaarheid.
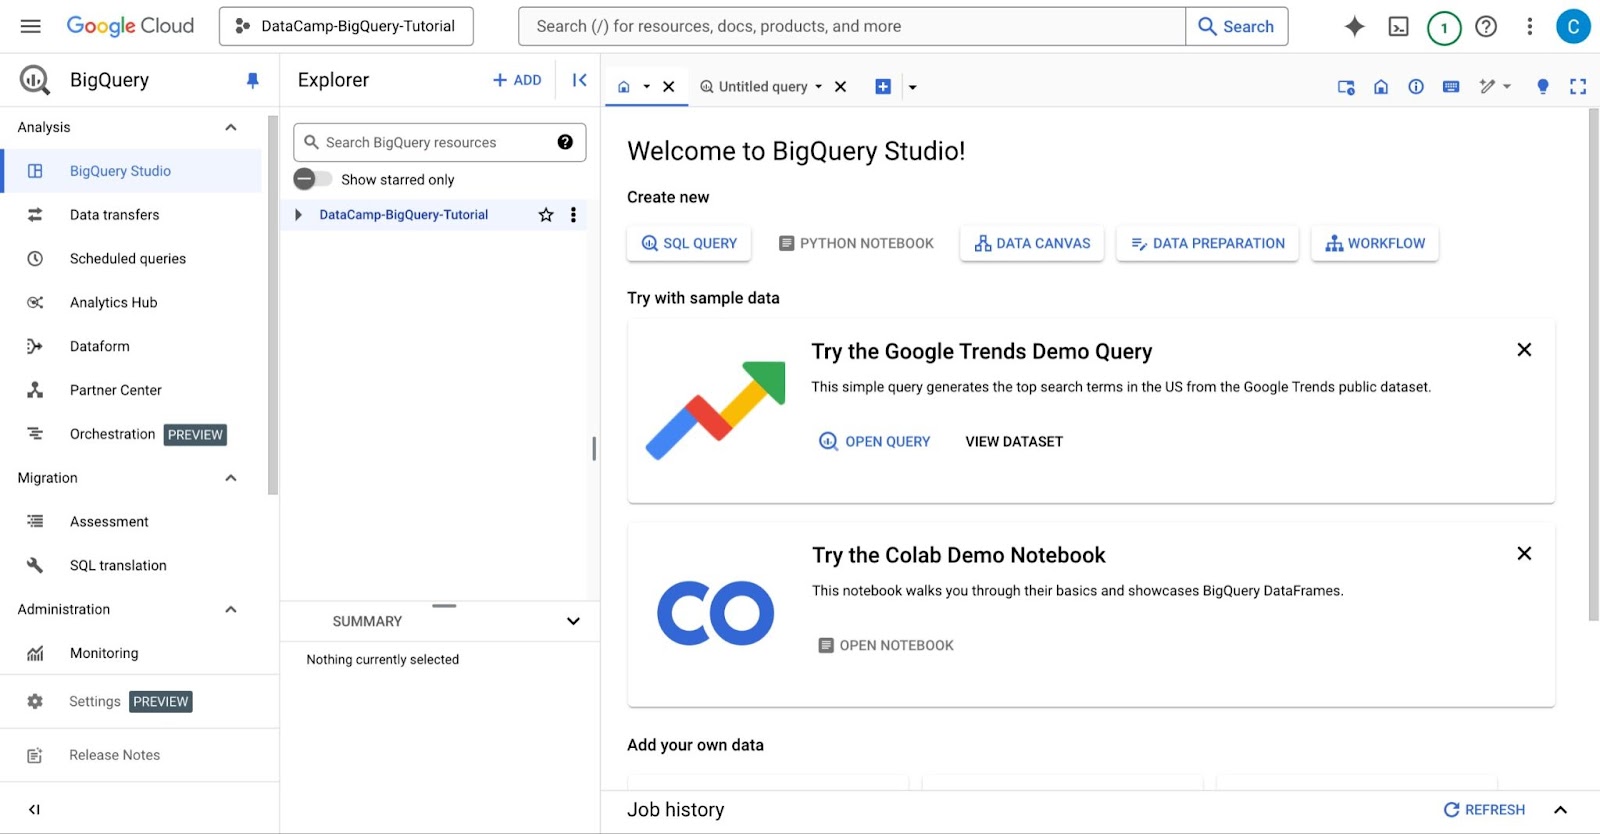
GCP-interface: BigQuery-console hoofdinterface.
Kernfeatures van BigQuery:
Use cases voor BigQuery:
Amazon Redshift is een cloudgebaseerde datawarehouse-oplossing die deel uitmaakt van het bredere cloudplatform Amazon Web Services (AWS). Met Redshifts clustergebaseerde architectuur kunnen gebruikers grootschalige, voorspelbare workloads benaderen en analyseren, met de noodzaak om de infrastructuur zelf te beheren.
Met Redshift kunnen gebruikers data laden en direct beginnen met queryen via de Amazon Redshift query editor v2 of hun favoriete business intelligence (BI)-tool. De service biedt een uitstekende prijs-prestatieverhouding en vertrouwde SQL-functionaliteit in een gebruiksvriendelijke omgeving zonder beheerlast.
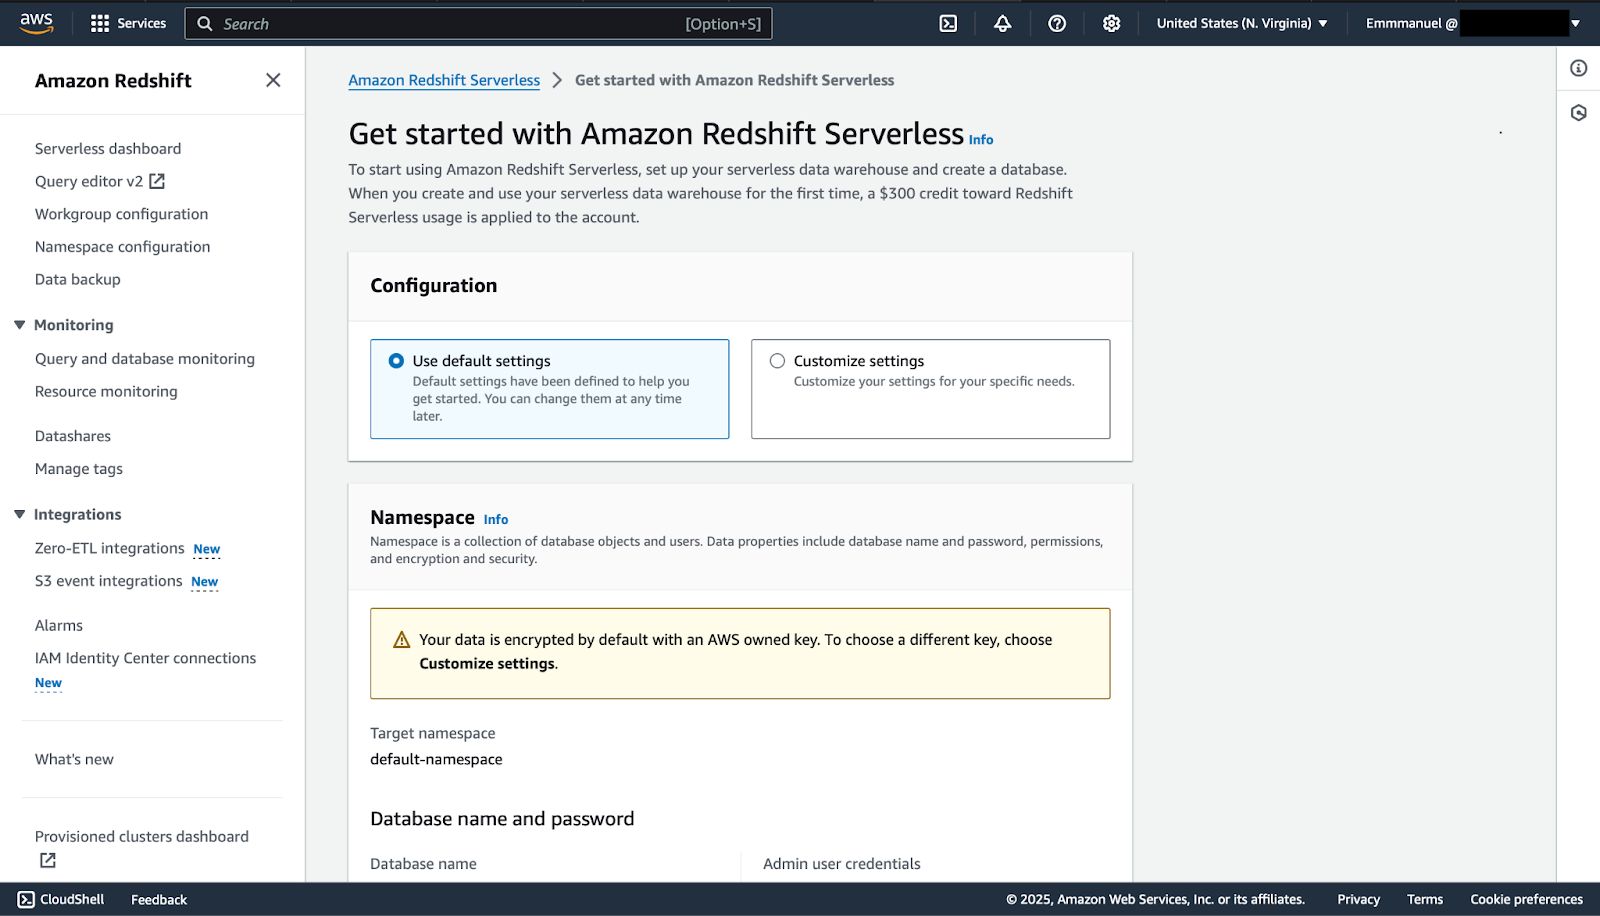
AWS-interface: Amazon Redshift-console hoofdinterface.
Kernfeatures van Redshift:
Use cases voor Redshift:
Na een korte introductie van deze twee clouddatawarehouses kijken we nu van dichtbij naar hun verschillen op diverse vlakken.
De platformarchitectuur beschrijft hoe systemen functioneren. Hier licht ik het verschil uit tussen BigQuery’s serverloze, querygebaseerde prijsmodel en Redshifts clustergebaseerde aanpak.
Als je de voorkeur geeft aan een hands-off aanpak met automatische schaalbaarheid, dan is BigQuery jouw go-to voor datawarehousing.
Bij BigQuery hoef je geen infrastructuur te beheren; Google regelt alles van provisioning tot schalen. Je betaalt alleen voor de queries die je draait en de opslag die je gebruikt. Deze pay-as-you-go-prijsbenadering is kosteneffectief en helpt om kosten voor idle resources te vermijden.
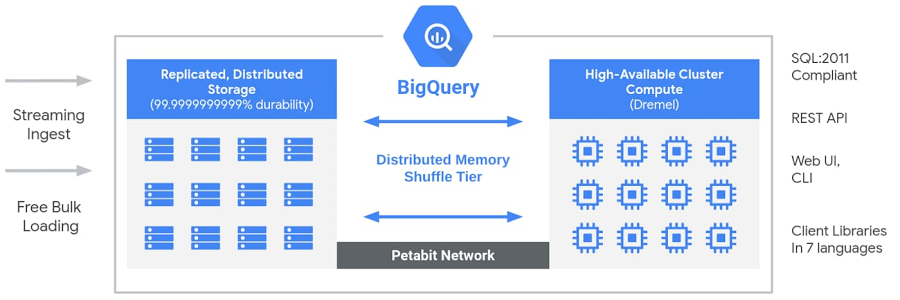
Architectuur van BigQuery (Bron: Google Cloud-blog).
Als je meer controle over je infrastructuur nodig hebt en je clusters kunt beheren, is Amazon Redshift waarschijnlijk geschikter. Je moet clusters opzetten en beheren door het instancetype, het aantal nodes en de configuratie te kiezen. Dit geeft controle over de infrastructuur, maar voegt naar mijn ervaring ook complexiteit toe.
Redshift biedt zowel gereserveerde als on-demand prijsmodellen. Met gereserveerde instances krijg je korting en committeer je je aan een specifieke capaciteit voor een vooraf bepaalde periode (zoals één of drie jaar). On-demand prijzen laten je per uur betalen voor de capaciteit die je gebruikt, maar bij onjuist beheer kan dit duurder uitvallen.
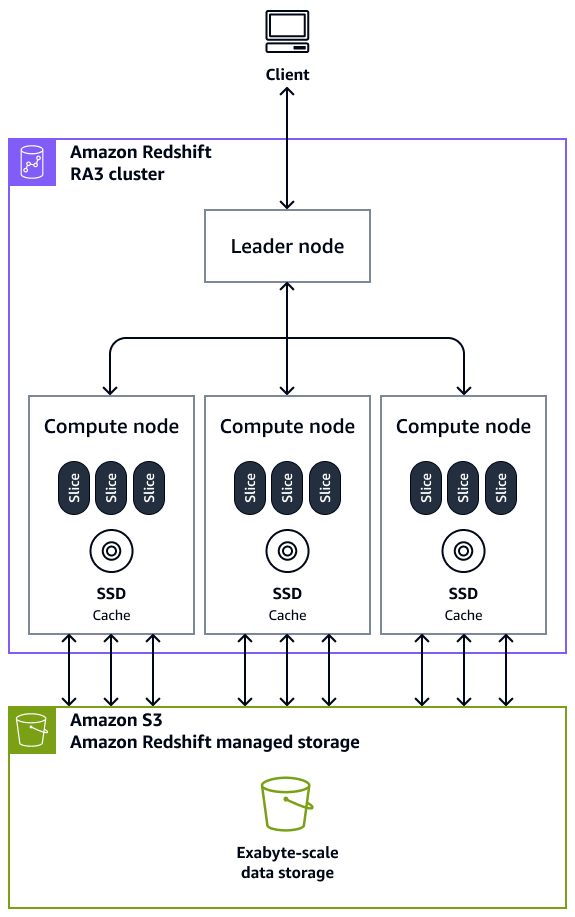
Architectuur van Amazon Redshift (Bron: AWS).
Zowel Google BigQuery als Amazon Redshift leveren indrukwekkende prestaties bij grootschalige queries, maar blinken uit in verschillende situaties. Laten we bekijken hoe beide platforms performance managen voor grootschalige queries, met BigQuery’s optimalisatie voor ad-hocqueries en Redshifts controle over clusters voor voorspelbare workloads.
BigQuery is gebouwd om dynamische workloads moeiteloos aan te kunnen dankzij de serverloze architectuur. Hierdoor kan BigQuery automatisch schalen, wat hoge performance mogelijk maakt voor grootschalige ad-hocqueries. BigQuery’s kolomopslag is zeer efficiënt voor analytische queries. Dit formaat vermindert de hoeveelheid data die van disk gelezen wordt en versnelt zo de queryperformance.
Redshift kan een betere optie zijn als je clusters kunt beheren voor betrouwbare prestaties in omgevingen met voorspelbare workloads. Je kunt clusters tunen voor consistente queryperformance, zodat je resources zijn geoptimaliseerd voor je bedrijfsbehoeften.
Redshift biedt verschillende performance-tuningopties, zoals sorteer- en distributiesleutels, om query-executie te optimaliseren. Dit kan tot betere prestaties leiden bij voorspelbare workloads, maar alleen als je weet wat je doet! Naar mijn ervaring is de leercurve behoorlijk steil.
Inzicht in prijs- en kostenstructuren is essentieel bij het kiezen van een datawarehouse, want we willen verantwoord omgaan met elke euro die we uitgeven.
Laten we bekijken hoe het pay-per-query-model en de opslagkosten van Google BigQuery zich verhouden tot Redshifts clustergebaseerde prijsstelling met korting voor gereserveerde instances:
|
Kostenfactor |
BigQuery |
Redshift |
|
Gratis tier |
10 GB gratis per maand |
Geen gratis tier, maar wel een proefperiode van 2 maanden |
|
Opslagkosten |
$20 per TB voor actieve logische opslag, $10 voor langetermijn |
$0,025 per GB per maand voor SSD, $0,08 per GB voor RA3 |
|
Querykosten |
$5 per TB voor on-demand queries |
Gebaseerd op gebruik van compute-instances en opslag |
|
Computekosten |
Kosten op basis van compute-capaciteit (per slot-uur) |
Uurafrekening (on-demand of gereserveerde prijsstelling) |
|
Schalen |
Automatisch schalen met autoscaler |
Handmatig schalen met nodebeheer |
|
Back-upkosten |
Kosten voor langetermijnopslag buiten de gratis tier |
Inbegrepen voor basisback-ups, extra kosten voor meer snapshots |
|
Aanvullende kosten |
Geen voor back-ups of schalen |
Kosten voor concurrency scaling na proefperiode |
Schaalbaarheid is een van de belangrijkste factoren bij het kiezen van een datawarehouse.
Laten we bekijken hoe BigQuery opslag en compute automatisch vergroot op basis van de vraag, en hoe Redshift handmatige clusterschaal vereist, wat langer kan duren.
BigQuery is de voorkeur als je zeker weet dat je bedrijf groeit, net als de workloads en infrastructuren. De autoscaling-functionaliteit van BigQuery ontzorgt je, bespaart tijd en moeite, en laat je volledig focussen op data-analyse.
In ideale omstandigheden is Redshift beter als je bedrijf genoeg data engineers heeft. Hoewel Redshift meer actief beheer vraagt, kan dat voordelig zijn, zeker als je preciesere controle wilt en resources zelf wilt aansturen.
Het nadeel is dat beheer veel tijd kost, ook al geeft het je vrijheid. Je workflow kan complexer worden doordat je moet plannen, performance monitoren en ingrijpen wanneer opschalen nodig is.
Zowel Google BigQuery als Amazon Redshift bieden voordelen die specifiek zijn voor hun ecosystemen bij integratie met hun cloudplatform.
BigQuery werkt soepel voor teams die GCP en diens services gebruiken, zoals Google Compute Engine, Cloud Storage en Cloud Run; dan is het handig om BigQuery te gebruiken om je datapijplijnen binnen dezelfde omgeving te houden.
Deze integratie met Google’s suite aan tools en services maakt BigQuery de voorkeursoptie voor datawarehousing als je bedrijf al in het Google-ecosysteem zit, omdat het een soepele workflow met die services biedt.
Amazon Redshift sluit goed aan op andere services in het AWS-ecosysteem. Het integreert met Amazon S3, AWS Lambda en AWS Glue, waardoor je eenvoudig toegang hebt tot andere AWS-services en -resources. Naar mijn mening is dit een groot voordeel!
Het belangrijkste verschil tussen Google BigQuery en Amazon Redshift is de operationele verantwoordelijkheid die deze services bij hun klanten neerleggen.
Omdat we ons geen zorgen hoeven te maken over de onderliggende infrastructuur, regelt Google via BigQuery alles van provisioning tot schalen. Dit maakt BigQuery aantrekkelijk voor bedrijven met weinig infrastructuurengineers die operationele verantwoordelijkheden willen vermijden.
Redshift daarentegen vereist meer technische knowhow en expertise. Als je team infrastructuurengineers heeft, zijn back-ups, handmatig schalen en clusterprovisioning beter te behappen. Als bedrijf geeft dit je controle en flexibiliteit over je infrastructuur.
Er zijn diverse use cases en scenario’s waarin Google BigQuery de aangewezen datawarehouse-oplossing is. Kies BigQuery als je:
Omdat het op Google Cloud Platform is gebouwd, is BigQuery geschikter voor wie zwaar investeert in GCP. Stel dat je het merendeel van je resources op GCP hebt, zoals Google Compute Engine, Cloud Storage en Cloud Run. Dan is het handig je datapijplijnen binnen dezelfde omgeving te houden.
BigQuery is krachtig voor grote datasets bij ad-hocqueries of realtime analytics. Omdat je geen infrastructuur hoeft te beheren, worden je queries snel en efficiënt verwerkt; je workload schaalt automatisch, ongeacht de omvang of complexiteit van je data.
Als je team niet over de benodigde DevOps-resources beschikt, is BigQuery hier de duidelijke winnaar. Je hoeft je niet bezig te houden met de technische kant van infrastructuurbeheer; Google regelt dat voor je. Zo kun je je volledig richten op de inzichten uit je data.
Er zijn ook scenario’s en use cases waarin Amazon Redshift de logische keuze is voor datawarehousing. Kies Redshift als je:
Als je organisatie haar resources heeft uitgerold en geïntegreerd binnen AWS, is Redshift een natuurlijke match. Amazon Redshift werkt samen met andere AWS-services zoals Amazon S3, AWS Lambda en AWS Glue, zodat je volledig op AWS kunt vertrouwen voor databeheer zoals opslag, verwerking en automatisering.
Redshift is compatibel met zware workloads die consistente prestaties vereisen voor voorspelbare querypatronen en een soepele, efficiënte run. Omdat Redshifts clusters aanpasbaar zijn en je de infrastructuur kunt controleren, kun je Redshift tunen voor specifieke performance-eisen.
Als je team complexe ETL-workflows afhandelt met data engineers die de infrastructuur beheren, is Redshift de juiste keuze. Dit past goed bij bedrijven met DevOps-expertise voor zware workflows; je hebt controle over schalen, back-ups en performance.
Nu we enkele belangrijke onderdelen van beide tools hebben doorgenomen, bekijken we hun belangrijkste highlights. Dit helpt je te beslissen welke tool je het beste kunt gebruiken voor jouw specifieke behoeften:
|
Features |
BigQuery |
Redshift |
|
Architectuur |
Serverloze architectuur betekent dat je geen infrastructuur hoeft te beheren. |
Werkt met een clustergebaseerde architectuur waarbij je clusters handmatig moet beheren. |
|
Prestaties |
Kan grote datasets snel verwerken, vooral bij realtime analytics of ad-hocqueries. |
Bekend om betrouwbare prestaties bij voorspelbare querypatronen. |
|
Kostenstructuur |
Gebruikt een pay-per-query-model: je betaalt voor de data die per query wordt verwerkt. |
Gebruikt gereserveerde instances voor kostenkorting, waarbij je vooraf betaalt voor specifieke compute-resources. |
|
Schaalbaarheid |
Automatische schaalbaarheid is een van BigQuery’s sterkste punten. |
Handmatig schalen is vereist; je beheert cluster resizing, resource-allocatie en performance-tuning. |
|
Ecosysteemintegratie |
Diepe integratie met Google Cloud Platform (GCP)-services maakt het topkeuze voor teams die al met het Google-ecosysteem werken. |
Integreert naadloos met de Amazon Web Services (AWS)-omgeving en -services voor teams die al in het AWS-ecosysteem zitten. |
|
Gebruiksgemak |
De volledig beheerde, serverloze architectuur van BigQuery vereenvoudigt het gebruik zonder diepe infrastructuurkennis. |
Redshift vereist meer hands-on beheer. Je moet clusters, schaling en performance monitoren en beheren. |
In dit artikel hebben we de belangrijkste vergelijkingen behandeld tussen BigQuery en Redshift, twee clouddatawarehouses met elk hun sterke punten en trade-offs. De beste keuze hangt af van jouw behoeften, waaronder datavolume, querypatronen en budget.
Wil je dieper in deze platforms duiken? Bekijk dan Introduction to Redshift en Introduction to BigQuery op DataCamp. Deze hands-on cursussen helpen je de basis van beide tools te beheersen en praktische skills op te doen om effectief met moderne datawarehouses te werken.
Leer meer over data engineering en cloudtechnologieën met de volgende cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

