Last chance! 50% off DataCamp Premium
Sale ends in
जब विभिन्न स्रोतों से बड़े पैमाने पर संरचित और अर्ध-संरचित डेटा से निपटना होता है, तो हम उन्हें संग्रहीत करने के लिए एक केंद्रीकृत रिपॉज़िटरी के बारे में सोचते हैं। डेटा वेयरहाउस पर दृष्टिकोण लगातार बदल रहा है, और क्लाउड-आधारित समाधान असाधारण प्रदर्शन, लचीलापन और स्केलेबिलिटी प्रदान करते हैं। Google BigQuery और Amazon Redshift इस क्षेत्र के शीर्ष समाधान हैं।
दोनों क्लाउड-आधारित डेटा वेयरहाउस की शक्तिशाली डेटा प्रोसेसिंग, एनालिटिक्स और स्टोरेज सुविधाएँ डेटा प्रोफेशनल्स को अपने डेटा को अधिक प्रभावी और कुशलता से प्रबंधित करने में सक्षम बनाती हैं।
इस लेख में, मैं इन प्लेटफ़ॉर्म्स की उनकी विशेषताओं, फायदे-नुकसान और सर्वोत्तम प्रथाओं सहित विस्तृत तुलना करूँगा। आइए विवरण देखें और आपकी आवश्यकताओं के लिए सबसे अच्छा विकल्प पहचानने में सहायता करें!
Google BigQuery Google Cloud Platform (GCP) द्वारा प्रदत्त एक पूर्ण-प्रबंधित, सर्वरलेस डेटा वेयरहाउस है। BigQuery विशाल डेटासेट्स को संभालने, रियल-टाइम विश्लेषण सक्षम करने और न्यूनतम इन्फ्रास्ट्रक्चर प्रबंधन के साथ मशीन लर्निंग वर्कफ़्लोज़ का समर्थन करने के लिए डिज़ाइन किया गया है। इसकी सर्वरलेस आर्किटेक्चर आपको SQL क्वेरीज़ का उपयोग करके अपने डेटा का विश्लेषण करने देती है।
BigQuery डेटा को टेबल, रो और कॉलम में प्रस्तुत करता है, और डेटाबेस ट्रांज़ैक्शन सेमान्टिक्स (ACID) का समर्थन करता है। उच्च उपलब्धता प्रदान करने के लिए BigQuery स्टोरेज स्वचालित रूप से कई लोकेशन्स में प्रतिलिपित होता है।
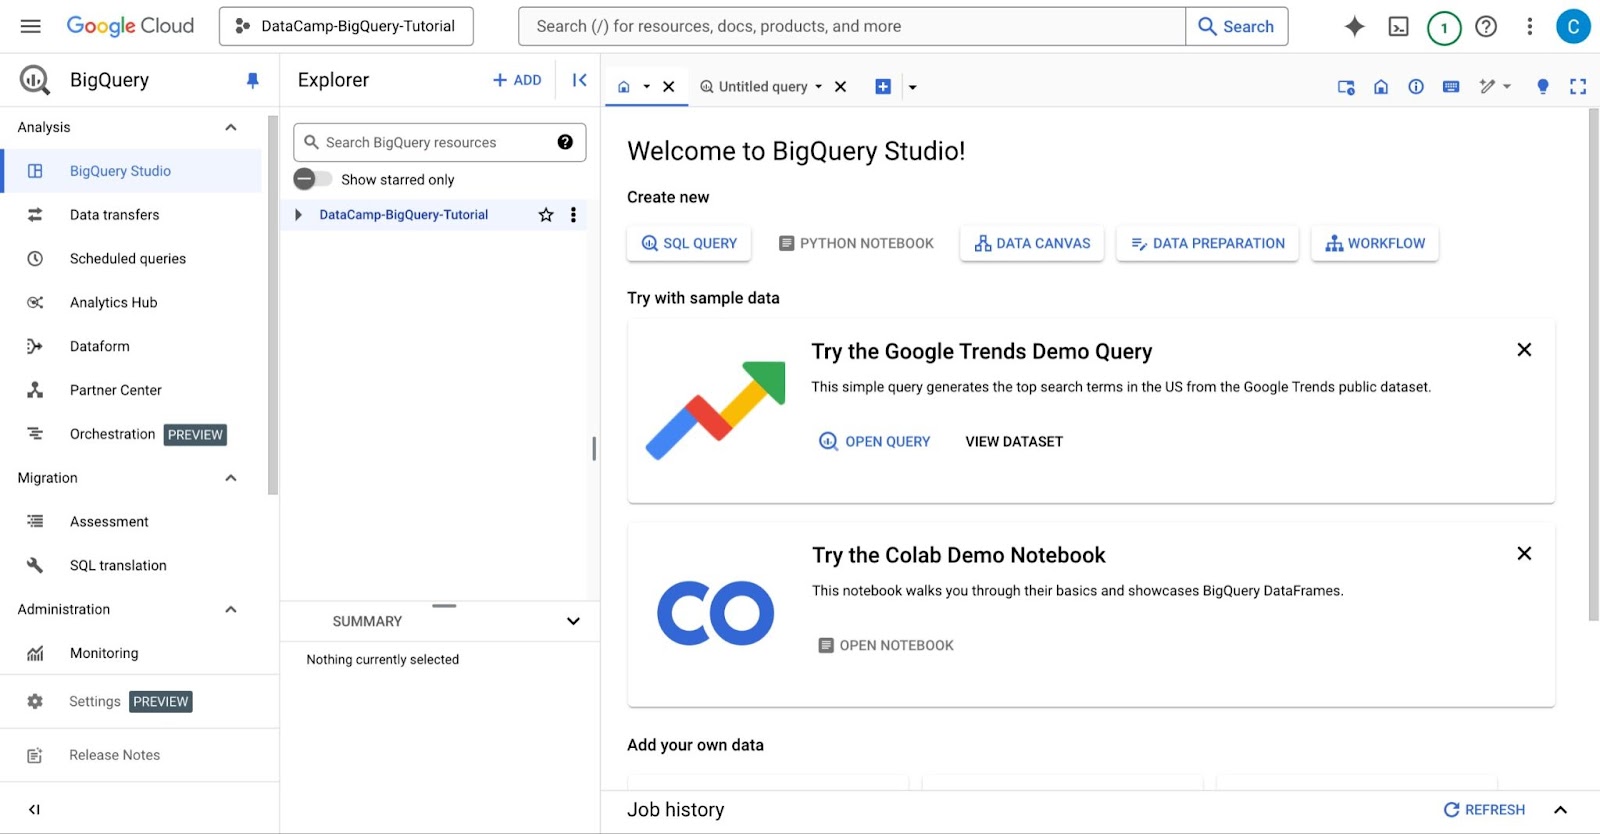
GCP इंटरफ़ेस: BigQuery कंसोल का मुख्य इंटरफ़ेस।
BigQuery की मुख्य विशेषताएँ:
BigQuery के उपयोग के मामले:
Amazon Redshift एक क्लाउड-आधारित डेटा वेयरहाउस समाधान है जो बड़े क्लाउड-कंप्यूटिंग प्लेटफ़ॉर्म Amazon Web Services (AWS) का हिस्सा है। Redshift की क्लस्टर-आधारित आर्किटेक्चर के साथ, उपयोगकर्ता इन्फ्रास्ट्रक्चर को स्वयं प्रबंधित करने की आवश्यकता के बिना बड़े पैमाने पर, पूर्वानुमेय वर्कलोड्स तक पहुँच और उनका विश्लेषण कर सकते हैं।
Redshift उपयोगकर्ताओं को डेटा लोड करने और Amazon Redshift query editor v2 या अपनी पसंद के बिज़नेस इंटेलिजेंस (BI) टूल का उपयोग करके तुरंत क्वेरी करना शुरू करने देता है। यह सेवा आसान-से-उपयोग, शून्य-प्रशासन वाले वातावरण में सर्वोत्तम प्राइस-परफॉर्मेंस और परिचित SQL सुविधाएँ प्रदान करती है।
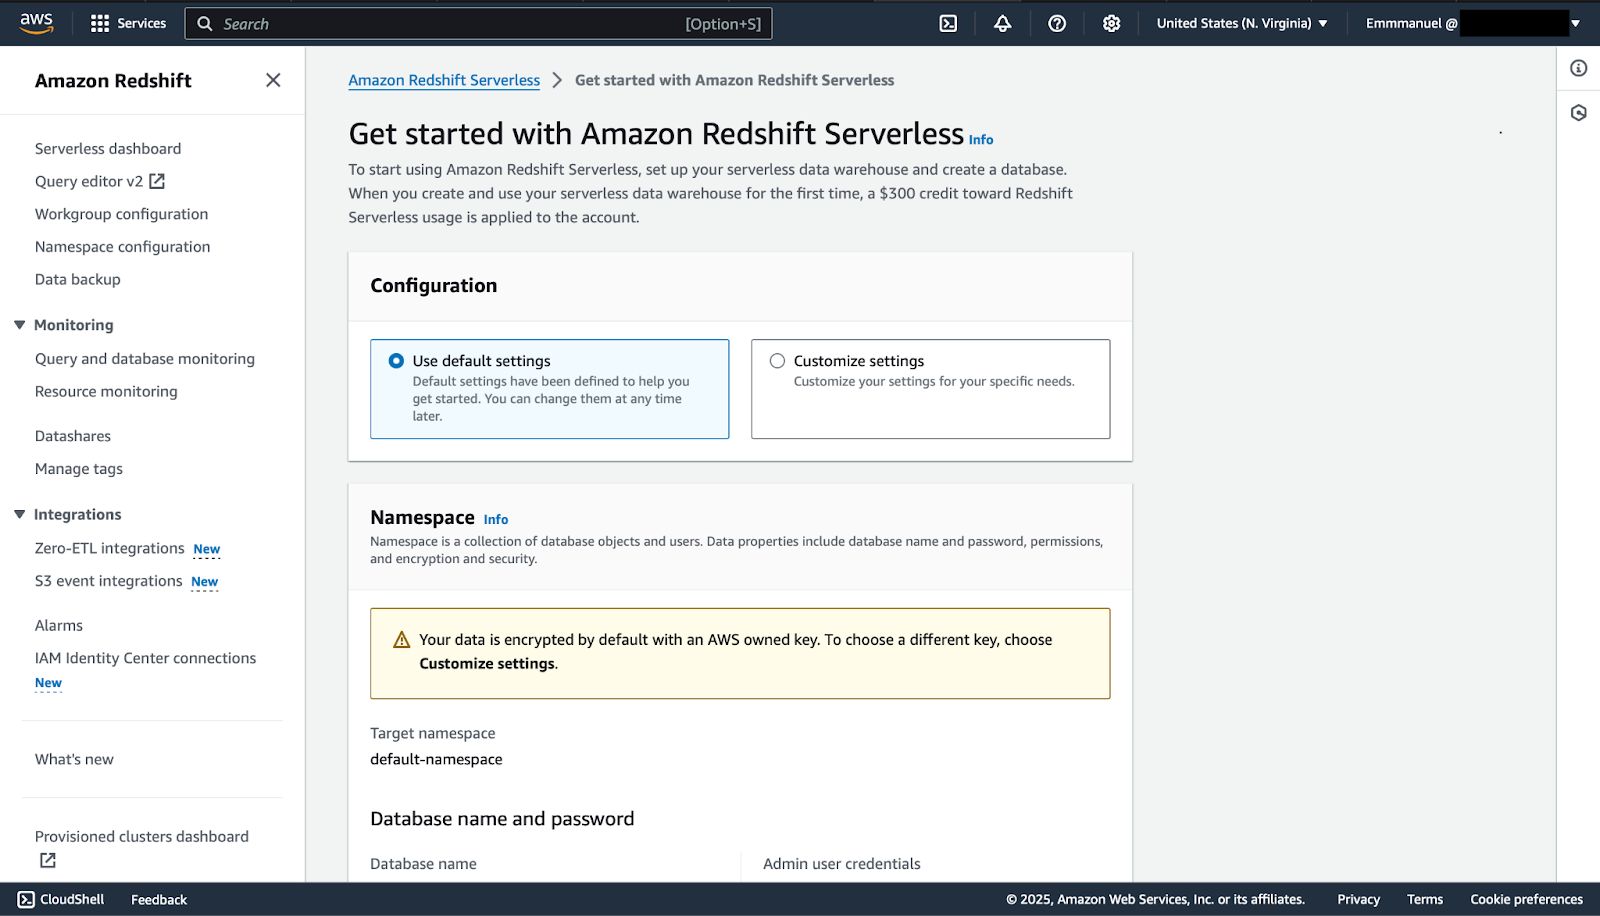
AWS इंटरफ़ेस: Amazon Redshift कंसोल का मुख्य इंटरफ़ेस।
Redshift की मुख्य विशेषताएँ:
Redshift के उपयोग के मामले:
इन दो क्लाउड डेटा वेयरहाउस का संक्षिप्त परिचय लेने के बाद, आइए विभिन्न क्षेत्रों में उनके अंतर को करीब से देखें।
प्लेटफ़ॉर्म आर्किटेक्चर यह बताता है कि सिस्टम्स कैसे कार्य करने चाहिए। यहाँ, मैं BigQuery के सर्वरलेस, क्वेरी-आधारित प्राइसिंग मॉडल और Redshift के क्लस्टर-आधारित दृष्टिकोण के बीच अंतर को रेखांकित करूँगा।
यदि आप स्वचालित स्केलिंग के साथ हैंड्स-ऑफ अप्रोच पसंद करते हैं, तो डेटा वेयरहाउसिंग के लिए BigQuery आपका उपयुक्त विकल्प है।
BigQuery में आपको कोई इन्फ्रास्ट्रक्चर प्रबंधित नहीं करना होता; Google प्रोविजनिंग से लेकर स्केलिंग तक सब संभालता है। BigQuery के साथ, आप केवल चलने वाली क्वेरीज़ और उपयोग की गई स्टोरेज के लिए भुगतान करते हैं। यह पे-ऐज़-यू-गो प्राइसिंग दृष्टिकोण किफायती है और आपको निष्क्रिय संसाधनों की लागत से बचने में मदद करता है।
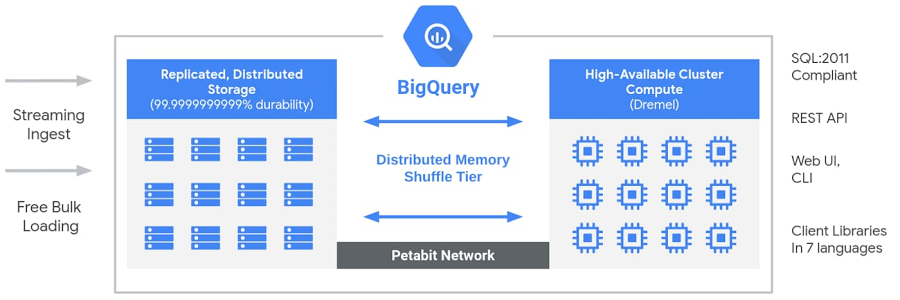
BigQuery आर्किटेक्चर (स्रोत: Google Cloud ब्लॉग).
यदि आपको अपने इन्फ्रास्ट्रक्चर पर अधिक नियंत्रण चाहिए और आप अपने क्लस्टर्स को प्रभावी ढंग से प्रबंधित कर सकते हैं, तो Amazon Redshift आपके लिए बेहतर अनुकूल होगा। Redshift में आपको इंस्टेंस टाइप, नोड्स की संख्या और कॉन्फ़िगरेशन चुनकर क्लस्टर्स सेटअप और प्रबंधित करने होते हैं। यह आपको इन्फ्रास्ट्रक्चर पर नियंत्रण देता है, लेकिन मेरे अनुभव में, यह जटिलता भी बढ़ाता है।
Redshift आरक्षित और ऑन-डिमांड दोनों प्राइसिंग विकल्प प्रदान करता है। आरक्षित इंस्टेंसेज़ के साथ, आपको छूट मिलती है और आप एक निर्धारित अवधि (जैसे एक या तीन वर्ष) के लिए एक निश्चित क्षमता के लिए प्रतिबद्ध होते हैं। ऑन-डिमांड प्राइसिंग आपको उपयोग की गई क्षमता के लिए प्रति घंटा भुगतान करने देती है, लेकिन गलत प्रबंधन इसे महँगा बना सकता है।
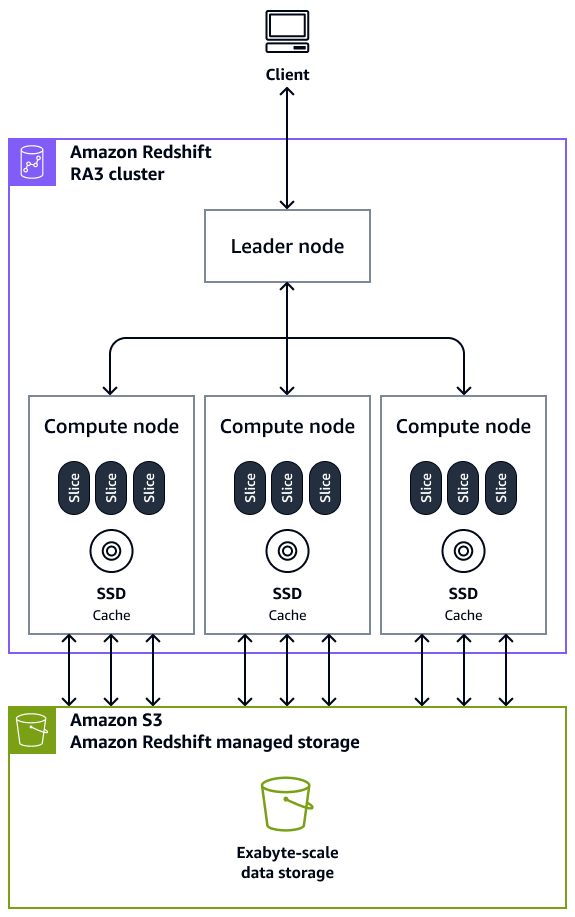
Amazon Redshift आर्किटेक्टचर (स्रोत: AWS).
Google BigQuery और Amazon Redshift दोनों बड़े पैमाने की क्वेरीज़ के लिए प्रभावशाली प्रदर्शन प्रदान करते हैं, लेकिन वे अलग-अलग परिस्थितियों में सर्वश्रेष्ठ प्रदर्शन करते हैं। आइए देखें कि दोनों प्लेटफ़ॉर्म बड़े पैमाने की क्वेरीज़ के लिए प्रदर्शन कैसे प्रबंधित करते हैं—जहाँ BigQuery ऐड-हॉक क्वेरीज़ के लिए अनुकूलित है और Redshift पूर्वानुमेय वर्कलोड्स के लिए क्लस्टर्स पर नियंत्रण देता है।
BigQuery अपनी सर्वरलेस आर्किटेक्चर के कारण डायनेमिक वर्कलोड्स को आसानी से संभालने के लिए बना है। यह BigQuery को वर्कलोड्स को ऑटो-स्केल करने देता है, जिससे बड़े पैमाने की ऐड-हॉक क्वेरीज़ के लिए उच्च प्रदर्शन सक्षम होता है। BigQuery का कॉलमनर स्टोरेज विश्लेषणात्मक क्वेरीज़ के लिए अत्यंत कुशल है। यह फ़ॉर्मेट डिस्क से पढ़े जाने वाले डेटा की मात्रा को कम करता है, जिससे क्वेरी प्रदर्शन तेज़ होता है।
यदि आप पूर्वानुमेय वर्कलोड्स वाले वातावरण में विश्वसनीय प्रदर्शन के लिए क्लस्टर्स को प्रबंधित कर सकते हैं, तो Redshift बेहतर विकल्प हो सकता है। आप सुसंगत क्वेरी प्रदर्शन के लिए क्लस्टर्स को ट्यून कर सकते हैं, यह सुनिश्चित करते हुए कि आपके संसाधन आपके व्यावसायिक आवश्यकताओं के अनुरूप अनुकूलित हों।
Redshift सॉर्ट और डिस्ट्रीब्यूशन कीज़ जैसी विभिन्न परफॉर्मेंस ट्यूनिंग विकल्प प्रदान करता है, जिससे क्वेरी निष्पादन को अनुकूलित किया जा सकता है। यह सुविधा पूर्वानुमेय वर्कलोड्स के लिए बेहतर प्रदर्शन दे सकती है, लेकिन तभी जब आप अच्छे से समझते हों! मेरे अनुभव में, सीखने की वक्र काफ़ी खड़ी हो सकती है।
डेटा वेयरहाउस का चयन करते समय कीमत और लागत संरचनाओं को समझना आवश्यक है, क्योंकि हम खर्च किए गए प्रत्येक डॉलर के लिए जवाबदेह रहना चाहते हैं।
आइए देखें कि Google BigQuery के पे-पर-क्वेरी मॉडल और स्टोरेज खर्च Amazon Redshift की क्लस्टर-आधारित प्राइसिंग और आरक्षित इंस्टेंस से होने वाली बचत की तुलना में कैसे हैं:
|
लागत कारक |
BigQuery |
Redshift |
|
फ्री टियर |
प्रति माह 10GB फ्री |
फ्री टियर नहीं है, लेकिन 2 महीने का फ्री ट्रायल देता है |
|
स्टोरेज लागत |
सक्रिय लॉजिकल स्टोरेज के लिए $20 प्रति TB, दीर्घकालिक के लिए $10 |
SSD के लिए $0.025 प्रति GB प्रति माह, RA3 के लिए $0.08 प्रति GB |
|
क्वेरी लागत |
ऑन-डिमांड क्वेरीज़ के लिए $5 प्रति TB |
कंप्यूट इंस्टेंस उपयोग और स्टोरेज के आधार पर |
|
कंप्यूट लागत |
क्षमता कंप्यूट (प्रति स्लॉट घंटा) के आधार पर चार्ज |
प्रति घंटा बिलिंग (ऑन-डिमांड या आरक्षित प्राइसिंग) |
|
स्केलिंग |
ऑटोस्केलर के साथ स्वचालित स्केलिंग |
नोड प्रबंधन के साथ मैनुअल स्केलिंग |
|
बैकअप लागत |
फ्री टियर से परे दीर्घकालिक स्टोरेज के लिए शुल्क |
बेसिक बैकअप के लिए शामिल, अधिक स्नैपशॉट्स पर अतिरिक्त लागत |
|
अतिरिक्त लागत |
बैकअप या स्केलिंग के लिए कोई नहीं |
फ्री ट्रायल के बाद कंकरेन्सी स्केलिंग के लिए शुल्क |
हमारे डेटा वेयरहाउस का चयन करते समय विचार करने के लिए सबसे महत्वपूर्ण कारकों में से एक स्केलेबिलिटी है।
आइए देखें कि BigQuery कैसे माँग के अनुसार स्टोरेज और कंप्यूटिंग क्षमता को स्वचालित रूप से बढ़ाता है और Redshift मैनुअल क्लस्टर स्केलिंग की माँग करता है, जिसमें अधिक समय लग सकता है।
जब आपको यक़ीन हो कि आपका व्यवसाय अपने वर्कलोड्स और इन्फ्रास्ट्रक्चर के साथ बढ़ेगा, तो BigQuery वरीय प्लेटफ़ॉर्म है। BigQuery की ऑटोस्केलिंग क्षमता आपको इस बोझ से मुक्त करती है, आपका समय और प्रयास बचाती है ताकि आप पूरी तरह डेटा विश्लेषण पर ध्यान केंद्रित कर सकें।
आदर्श परिस्थितियों में, यदि आपकी कंपनी के पास पर्याप्त डेटा इंजीनियर्स हैं, तो Redshift बेहतर रहेगा। यद्यपि Redshift अधिक सक्रिय प्रबंधन की माँग करता है, यह आपके व्यवसाय के लिए लाभकारी हो सकता है—विशेषकर तब जब आपको सटीक नियंत्रण चाहिए और आप संसाधनों का प्रबंधन करना चाहते हैं।
खामी यह है कि भले ही यह आपको स्वतंत्रता दे, प्रबंधन में काफी समय लगता है। स्केल की आवश्यकता होने पर योजना बनाना, प्रदर्शन ट्रैक करना और कार्रवाई करना आवश्यक होने से आपका वर्कफ़्लो अधिक जटिल हो सकता है।
अपने-अपने क्लाउड कंप्यूटिंग प्लेटफ़ॉर्म्स के साथ इंटीग्रेशन में Google BigQuery और Amazon Redshift दोनों अपने इकोसिस्टम-विशिष्ट लाभ प्रदान करते हैं।
BigQuery उन टीमों के लिए सुचारू रूप से काम करता है जो GCP और उसकी सेवाओं—जैसे Google Compute Engine, Cloud Storage और Cloud Run—का उपयोग करती हैं; तब अपने डेटा पाइपलाइंस को उसी वातावरण में रखना लाभकारी हो सकता है।
Google के टूल्स और सेवाओं के सूट के साथ यह इंटीग्रेशन BigQuery को डेटा वेयरहाउसिंग के लिए वरीय विकल्प बनाता है यदि आपका व्यवसाय पहले से Google इकोसिस्टम का उपयोग करता है, क्योंकि यह अपनी सेवाओं के साथ एक सुगम वर्कफ़्लो प्रदान करता है।
Amazon Redshift AWS इकोसिस्टम की अन्य सेवाओं के साथ अच्छी तरह सिंक होगा। यह Amazon S3, AWS Lambda और AWS Glue के साथ इंटीग्रेट हो सकता है, जिससे आपको अन्य AWS सेवाओं और संसाधनों तक आसान पहुँच मिलती है। मेरी राय में, यह एक बड़ा लाभ है!
Google BigQuery और Amazon Redshift के बीच प्रमुख अंतर वह ऑपरेशनल ज़िम्मेदारी है जो ये सेवाएँ अपने ग्राहकों पर छोड़ती हैं।
क्योंकि हमें अंडरलाइंग इन्फ्रास्ट्रक्चर का प्रबंधन करने की चिंता नहीं करनी पड़ती, Google BigQuery के माध्यम से प्रोविजनिंग से लेकर स्केलिंग तक सब कुछ संभालता है। यह सुविधा उन व्यवसायों के लिए BigQuery को अलग खड़ा करती है जिनके पास कम इन्फ्रास्ट्रक्चर इंजीनियर्स हैं और जो ऑपरेशनल ज़िम्मेदारियों से बचना चाहते हैं।
दूसरी ओर, Redshift अधिक तकनीकी समझ और विशेषज्ञता की माँग करता है। यदि आपकी टीम में इन्फ्रास्ट्रक्चर इंजीनियर्स हैं, तो बैकअप्स, मैनुअल स्केलिंग और क्लस्टर प्रोविजनिंग संभालने में कम दिक्कत होगी। एक व्यवसाय के रूप में, यह आपको अपने इन्फ्रास्ट्रक्चर पर नियंत्रण और लचीलापन देता है।
ऐसे कई उपयोग के मामले और परिदृश्य हैं जहाँ Google BigQuery प्रमुख डेटा वेयरहाउसिंग समाधान बन जाता है। BigQuery चुनें यदि आप:
चूँकि यह Google Cloud Platform पर बना है, BigQuery उन लोगों के लिए अधिक उपयुक्त है जो GCP में गहराई से निवेशित हैं। मान लें कि आपके अधिकांश संसाधन Google Cloud Platform—जैसे Google Compute Engine, Cloud Storage और Cloud Run—में हैं। उसी वातावरण में अपनी डेटा पाइपलाइंस का उपयोग करना लाभकारी हो सकता है।
BigQuery ऐड-हॉक क्वेरीज़ या रियल-टाइम एनालिटिक्स के लिए बड़े डेटासेट्स को संभालने का एक शक्तिशाली टूल है। चूँकि आपको इन्फ्रास्ट्रक्चर प्रबंधन की चिंता नहीं करनी पड़ती, यह सुनिश्चित करता है कि आपकी क्वेरीज़ तेज़ और कुशलता से प्रोसेस हों; आपका वर्कलोड आपके डेटा के आकार या जटिलता की परवाह किए बिना ऑटो-स्केल होता है।
यदि आपकी टीम के पास आवश्यक DevOps संसाधन नहीं हैं, तो यहाँ BigQuery स्पष्ट विजेता है। आपको इन्फ्रास्ट्रक्चर प्रबंधन की तकनीकीताओं से जूझने की ज़रूरत नहीं; Google यह आपके लिए करता है। यह आपको केवल डेटा इनसाइट्स पर ध्यान केंद्रित करने में मदद करता है।
कुछ परिदृश्य और उपयोग के मामले ऐसे हैं जहाँ Amazon Redshift स्पष्ट रूप से उपयुक्त डेटा वेयरहाउसिंग समाधान है। Redshift चुनें यदि आप:
यदि आपके संगठन ने अपने संसाधन तैनात किए हैं और AWS इकोसिस्टम में इंटीग्रेट किया है, तो Redshift स्वाभाविक विकल्प है। Amazon Redshift, Amazon S3, AWS Lambda और AWS Glue जैसी अन्य AWS सेवाओं के साथ काम करेगा, जिससे डेटा स्टोरेज, प्रोसेसिंग और ऑटोमेशन जैसी डेटा प्रबंधन आवश्यकताओं के लिए केवल AWS पर निर्भर रहना संभव हो जाता है।
Redshift उन भारी वर्कलोड्स के साथ अनुकूल है जिन्हें पूर्वानुमेय क्वेरी पैटर्न्स के लिए सुसंगत प्रदर्शन और सुचारू, कुशल रन की आवश्यकता होती है। चूँकि Redshift के क्लस्टर्स कस्टमाइज़ेबल हैं और आप इन्फ्रास्ट्रक्चर नियंत्रित कर सकते हैं, आप अपने किसी भी विशिष्ट परफॉर्मेंस आवश्यकताओं को पूरा करने के लिए Redshift को ट्यून कर सकते हैं।
यदि आपकी टीम इन्फ्रास्ट्रक्चर का प्रबंधन करने वाले डेटा इंजीनियर्स के साथ जटिल ETL वर्कफ़्लोज़ संभालती है, तो Redshift उपयुक्त है। यह DevOps विशेषज्ञता वाली कंपनियों के लिए भारी वर्कफ़्लोज़ संभालने में उपयुक्त है; आपके पास स्केलिंग, बैकअप्स और प्रदर्शन पर नियंत्रण होगा।
अब जब हमने दोनों टूल्स के कुछ महत्वपूर्ण घटकों की समीक्षा कर ली है, तो आइए उनके प्रमुख हाइलाइट्स की समीक्षा करें। यह आपकी विशिष्ट जरूरतों के लिए किस टूल का उपयोग करना है, यह तय करने में मदद करेगा:
|
फ़ीचर्स |
BigQuery |
Redshift |
|
आर्किटेक्चर |
सर्वरलेस आर्किटेक्चर का मतलब है कि आपको कोई इन्फ्रास्ट्रक्चर प्रबंधित नहीं करना होता। |
क्लस्टर-आधारित आर्किटेक्चर पर काम करता है जहाँ आपको क्लस्टर्स को मैन्युअली प्रबंधित करना होता है। |
|
प्रदर्शन |
बड़े डेटासेट्स को तेज़ी से संभाल सकता है, खासकर रियल-टाइम एनालिटिक्स या ऐड-हॉक क्वेरीज़ के साथ। |
पूर्वानुमेय क्वेरी पैटर्न्स के साथ अपने विश्वसनीय प्रदर्शन के लिए जाना जाता है। |
|
लागत संरचना |
पे-पर-क्वेरी मॉडल उपयोग करता है, यानी आप प्रत्येक क्वेरी द्वारा प्रोसेस किए गए डेटा के लिए भुगतान करते हैं। |
कास्ट डिस्काउंट के लिए आरक्षित इंस्टेंसेज़ का उपयोग करता है, जहाँ आप अग्रिम में विशिष्ट कंप्यूट संसाधनों के लिए भुगतान करते हैं। |
|
स्केलेबिलिटी |
स्वचालित स्केलेबिलिटी BigQuery की सबसे मज़बूत विशेषताओं में से एक है। |
मैनुअल स्केलिंग की आवश्यकता होती है, इसलिए आपको क्लस्टर रीसाइज़िंग, संसाधन आवंटन और परफॉर्मेंस ट्यूनिंग प्रबंधित करनी होगी। |
|
इकोसिस्टम इंटीग्रेशन |
Google Cloud Platform (GCP) सेवाओं के साथ गहरा इंटीग्रेशन इसे Google इकोसिस्टम में पहले से काम कर रही टीमों के लिए शीर्ष विकल्प बनाता है। |
Amazon Web Services (AWS) वातावरण और इसकी सेवाओं के साथ सहज रूप से इंटीग्रेट होता है, AWS इकोसिस्टम का उपयोग कर रही टीमों के लिए। |
|
उपयोग में सरलता |
BigQuery का पूर्ण-प्रबंधित, सर्वरलेस आर्किटेक्चर गहन इन्फ्रास्ट्रक्चर प्रबंधन कौशल की आवश्यकता के बिना काम को सरल बनाता है। |
Redshift अधिक हैंड्स-ऑन प्रबंधन की माँग करता है। आपको क्लस्टर्स, स्केलिंग और परफॉर्मेंस की निगरानी और प्रबंधन करना होता है। |
इस लेख में BigQuery और Redshift—दो क्लाउड डेटा वेयरहाउसिंग समाधानों—के बीच प्रमुख तुलनाएँ खोजी गईं, जिनकी अपनी-अपनी ताकतें और समझौते हैं। सर्वोत्तम विकल्प आपकी आवश्यकताओं पर निर्भर करता है, जिनमें डेटा वॉल्यूम, क्वेरी पैटर्न और बजट शामिल हैं।
यदि आप इन प्लेटफ़ॉर्म्स को और गहराई से समझना चाहते हैं, तो DataCamp पर Introduction to Redshift और Introduction to BigQuery देखें। ये हैंड्स-ऑन कोर्सेज़ आपको प्रत्येक टूल की बुनियादी बातों में निपुण होने और आधुनिक डेटा वेयरहाउस के साथ प्रभावी ढंग से काम करने के लिए व्यावहारिक कौशल हासिल करने में मदद करेंगे।
निम्नलिखित कोर्स के साथ डेटा इंजीनियरिंग और क्लाउड तकनीकों के बारे में और जानें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}