Corso
Concetti di sicurezza e gestione dei costi su AWS
3 ore
11.2K
Tenendo presenti le funzionalità appena viste, ecco una panoramica concisa dei vantaggi di Athena:
|
Vantaggio |
Funzionalità |
Descrizione |
|
Convenienza economica |
Modello pay-per-query |
Paghi solo per i dati con cui interagiscono le tue query; nessun costo iniziale o licenze complesse; è possibile ottimizzare i costi con partizionamento, compressione dei dati e formati colonnari. |
|
Facilità d’uso |
Serverless e SQL standard |
Nessuna necessità di configurare o gestire l’infrastruttura; puoi iniziare a interrogare i dati in pochi minuti usando una sintassi SQL familiare, rendendolo accessibile e semplice da usare. |
|
Flessibilità |
Supporto multi-formato |
Supporta un’ampia gamma di formati (ad es. CSV, JSON, Parquet), permettendo di interrogare i dati nel loro formato nativo direttamente da S3 senza richiedere processi ETL. |
|
Insight rapidi |
Analisi veloce e query dirette su S3 |
Abilita analisi immediate grazie all’architettura serverless, consentendo l’estrazione rapida di insight direttamente dai dati in S3 e riducendo il time-to-value per decisioni data-driven. |
Abbiamo definito Athena e menzionato funzionalità e vantaggi, ma a cosa serve? In questa sezione, vedremo alcuni dei casi d’uso più diffusi.
Amazon Athena è spesso utilizzato per l’analisi dei log, in particolare per interrogare e analizzare log archiviati in Amazon S3. Le organizzazioni generano spesso volumi enormi di log da varie fonti, come log applicativi, di server e di accesso.
Archiviando questi log in S3 e interrogandoli con Athena, è possibile identificare rapidamente trend, diagnosticare problemi e monitorare le prestazioni dei sistemi senza una configurazione complessa.
L’architettura serverless di Athena e il supporto per SQL standard lo rendono uno strumento eccellente per l’esplorazione ad hoc dei dati. Che tu sia data scientist, analyst o engineer, Athena ti consente di interrogare rapidamente dati archiviati in S3 senza caricarli in un database tradizionale.
Poiché le organizzazioni adottano sempre più i data lake per archiviare grandi quantità di dati grezzi e lavorati, Athena funge da potente motore di query per questi data lake. Consente di eseguire analytics direttamente sui dati in S3, rendendolo parte integrante di un’architettura moderna di data lake.
Athena è spesso utilizzato anche come parte di uno stack di business intelligence (BI), dove si integra con strumenti BI come Amazon QuickSight per abilitare visualizzazioni e report. Interrogando i dati in S3 con Athena e visualizzandoli in QuickSight, le organizzazioni possono creare dashboard e report interattivi per il decision-making.
Se conosci Amazon Redshift, potresti chiederti in cosa differisca da Athena.
Sebbene sia Athena sia Redshift lavorino con dataset, i loro obiettivi sono diversi. Il caso d’uso principale di Redshift è il data warehousing e l’analisi regolare di big data. AWS Athena è focalizzato sul consentire analisi ad hoc sui dati archiviati in S3.
Ecco un confronto dettagliato tra Athena e Redshift:
|
Criterio |
Amazon Athena |
Amazon Redshift |
|
Architettura |
Servizio di query serverless; esegue query SQL direttamente sui dati archiviati in Amazon S3 con scalabilità automatica; nessuna gestione dell’infrastruttura. |
Data warehouse completamente gestito; richiede un cluster con infrastruttura dedicata; può scalare in base alle esigenze. È disponibile l’opzione Redshift Serverless. |
|
Casi d’uso |
Ideale per query e analytics ad hoc su dati in S3 e per scenari che privilegiano flessibilità ed economicità senza trasformazione dei dati. |
Adatto per analytics e reportistica complessi su larga scala; ideale per dati strutturati che richiedono query e trasformazioni frequenti. |
|
Struttura dei costi |
Modello pay-per-query: addebiti basati sui dati scansionati dalle query, conveniente per carichi intermittenti o variabili. |
Prezzi basati sulla dimensione e sull’utilizzo del cluster; sono disponibili prezzi per istanze riservate per query prevedibili ad alto volume. |
|
Prestazioni |
Dipendono da dimensione e formato dei dati; ottimizzabili con partizionamento e compressione; ideale per query più piccole e meno complesse. |
Prestazioni elevate per query complesse; utilizza storage colonnare, elaborazione parallela e ottimizzazione avanzata per carichi intensivi. |
|
Integrazione dei dati |
Interroga direttamente i dati in S3 senza necessità di trasformazione o caricamento; supporta vari formati e connettori estendibili, incluso Redshift. |
Richiede il caricamento dei dati nel warehouse, si integra con i servizi AWS e supporta vari metodi di ingestione ma legge solo dai dati memorizzati al suo interno. |
È il momento di passare alla pratica: configuriamo Athena ed eseguiamo alcune query!
Per usare AWS Athena serve un account AWS. Se non ne hai uno, devi crearlo. Per farlo, segui le istruzioni nella guida di configurazione AWS.
Sebbene non esista un free tier per AWS Athena, dovresti riuscire a eseguire 2-3 piccole query di test (~10MB) per capire come funziona il sistema. Segui le istruzioni sul portale e verifica la tua identità. Poi accedi al tuo account AWS.
Come tutti i prodotti Amazon AWS, Athena utilizza le policy IAM (identity and access management) per le autorizzazioni. Sei l’utente root del tuo account e dovresti avere i permessi necessari per eseguire query Athena sui tuoi bucket S3.
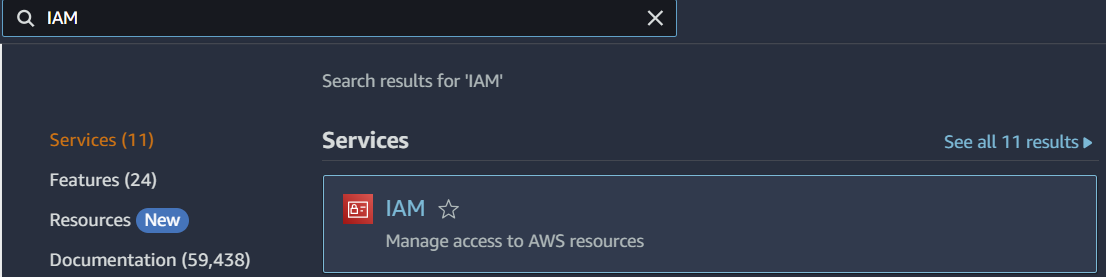
Puoi gestire i permessi IAM cercando il servizio IAM nella barra di ricerca in alto nella home di AWS e utilizzando questa guida completa IAM. La documentazione AWS fornisce anche ulteriori informazioni sulla configurazione specifica di Athena.
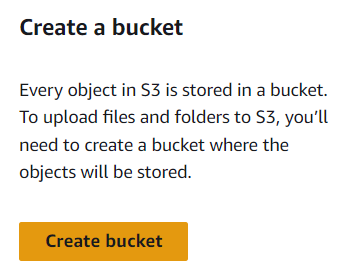
Prima di eseguire query, dobbiamo creare un bucket S3 in cui archiviare i nostri dati.
Amazon S3 sta per Simple Storage Service ed è un componente fondamentale del modo in cui AWS gestisce storage e dati nel cloud. Seguendo questa guida ben fatta sulla creazione di bucket Amazon S3, possiamo creare l’ambiente di archiviazione per i nostri dati e le nostre query.
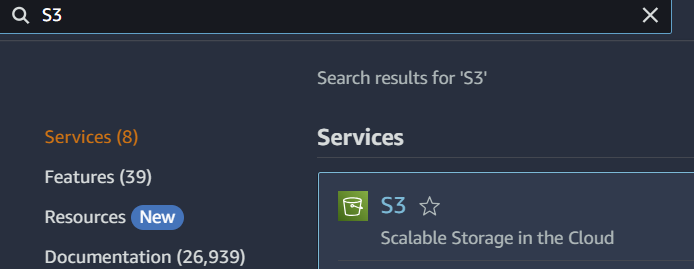
In breve, cerca il servizio S3 nella barra di ricerca per raggiungere la homepage di S3:
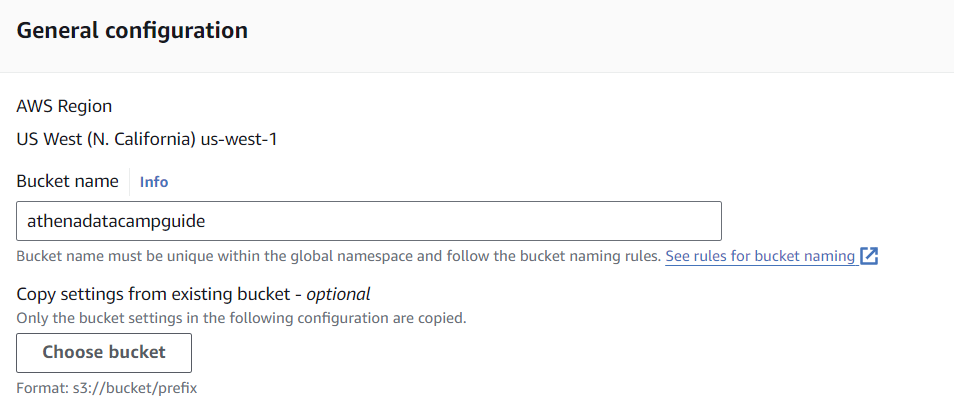
Vedrai un pulsante “Create Bucket” nella barra laterale destra della homepage. Seguendo le istruzioni in pagina, creerai un bucket che permetterà al tuo servizio Athena di salvare i risultati delle query.
Creerò un bucket chiamato “athenadatacampguide” usando tutte le altre opzioni predefinite. Poiché i bucket devono essere univoci a livello globale in AWS, per questo tutorial dovrai scegliere un altro nome.
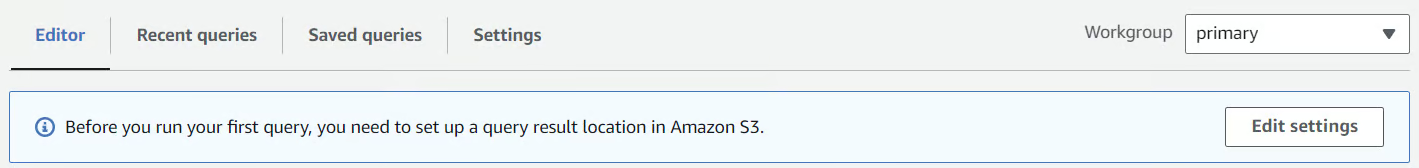
Ora dobbiamo collegare questo bucket ad Athena. Andrò nella console di Athena e farò clic su “Edit Settings” nella piccola barra di notifica in alto.
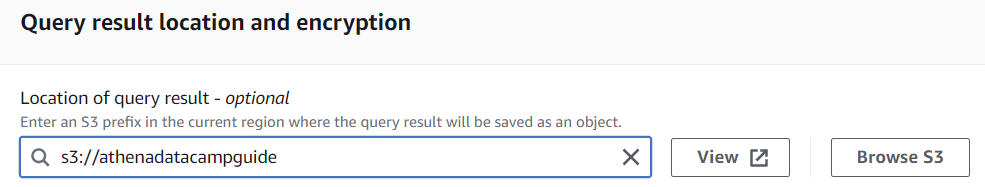
Selezionerò poi il bucket appena creato. Per trovare il tuo bucket, usa il pulsante “Browse S3” a destra o digita il nome preceduto da “s3://”.
Una volta selezionato il bucket, fai clic su “Save” e torna all’Editor cliccando su di esso nella barra degli strumenti in alto.
AWS Athena organizza i dati in modo gerarchico. Utilizza “data catalog”, un gruppo di database noto anche come schema.
Le tabelle che interroghiamo si trovano all’interno dei database. Per creare un nuovo data catalog, potresti usare Amazon Lambda e collegarti a una sorgente dati esterna. Il data catalog può poi essere salvato come Lambda, Hive o Glue data catalog.
L’impostazione predefinita su AWS è usare il servizio Glue come repository centrale del data catalog. Ci concentreremo sulla creazione di un database che conterrà le nostre tabelle per le query.
Nell’Editor, vai al riquadro Query Editor. Qui scriveremo le query per creare database, interrogare tabelle ed eseguire analytics.
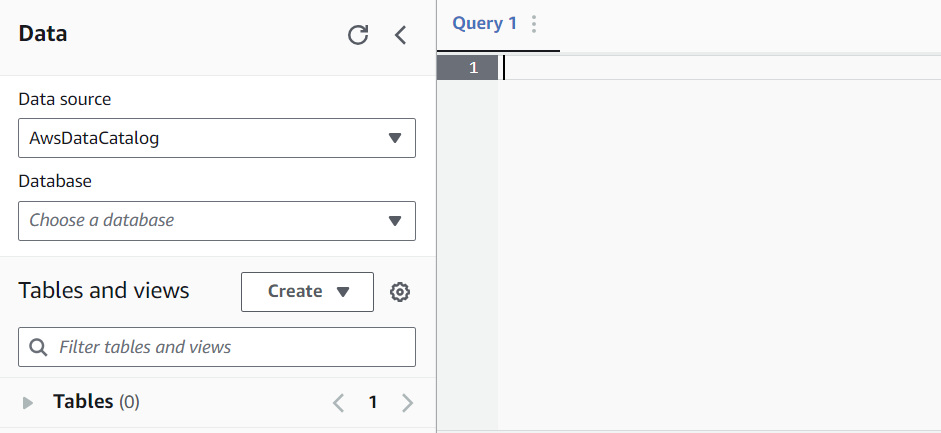
Per creare il nostro primo database, eseguiremo la seguente query:
CREATE DATABASE mydatabaseEseguendo questa query, potrai selezionare un database dal menu a discesa sotto “Database” nella barra laterale sinistra.
Ora che abbiamo un database, ci concentreremo sulla creazione di una tabella per avere qualcosa da interrogare!
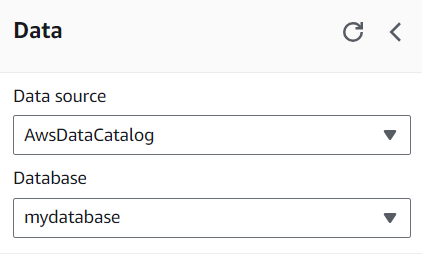
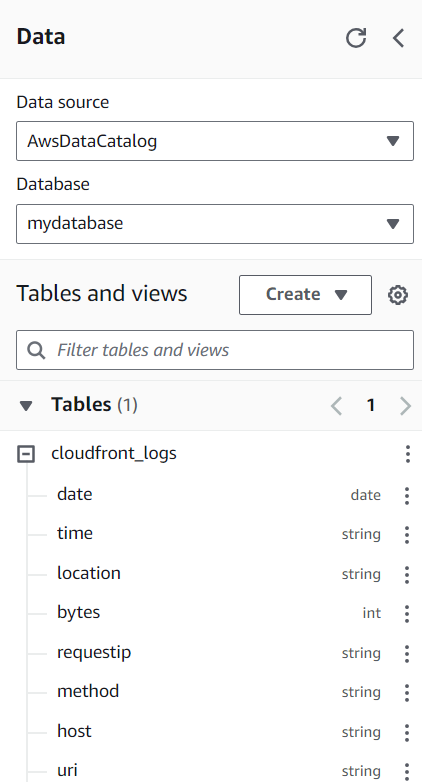
L’inserimento dei dati nel tuo database varierà leggermente in base alla tua configurazione AWS. Puoi utilizzare dati archiviati in un data warehouse come Redshift oppure dati in streaming usando AWS Kinesis e Lambda per generare dati tabellari.
Oggi useremo dati di esempio dai log AWS CloudFront. A causa della complessità dei dati, parte del processo di creazione utilizza gruppi RegEx per analizzare i dati URL in colonne.
Con il seguente SQL possiamo creare una tabella. Nota: qui sotto, sostituisci “myregion” con la tua regione AWS.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Se la tabella appare nella barra laterale sinistra, sei pronto per iniziare a eseguire query!
Scrivere query in Athena è simile a scriverle in SQL tradizionale. Scrivi e invii la query ad Athena e ottieni i risultati desiderati.
Una buona pratica è scrivere le istruzioni FROM con la seguente sintassi: “DataSource”.”database”.”table”. In questo modo non ci sono dubbi sull’origine dei dati.
Proviamo una semplice istruzione SELECT per iniziare.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
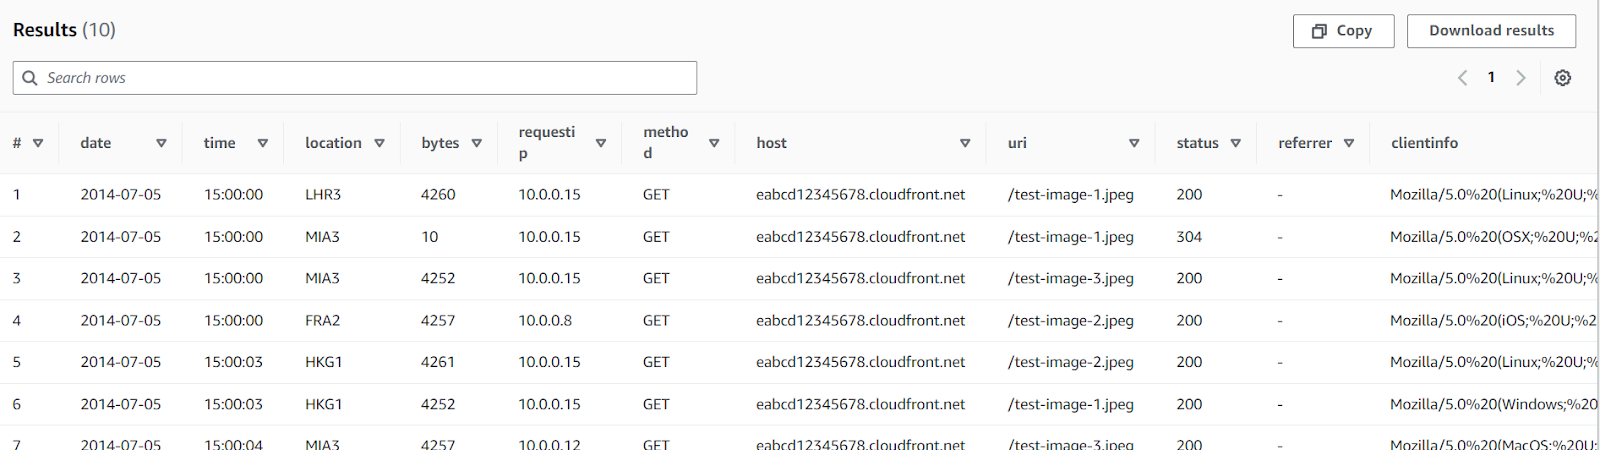
Dovrebbe restituire una tabella con 10 risultati. Athena ti consente di copiare o scaricare i risultati. Allo stesso tempo, questi risultati vengono salvati nel bucket S3 collegato al tuo servizio Athena.
Possiamo anche scrivere semplici query con GROUP BY. Questa, in particolare, ci indica quante requestip (non necessariamente uniche) sono coinvolte con specifici metodi HTTP.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Un ottimo modo per utilizzare Athena è con query più complesse, come le funzioni finestra. Grazie all’ottimizzazione di Athena, possiamo eseguire calcoli complicati più rapidamente.
Per esempio, possiamo usare Athena per generare il ROW NUMBER() per ogni record, partizionato per regione e data e ordinato per ora decrescente. Possiamo poi selezionare il record più recente per ogni regione e data usando un filtro WHERE per prendere la prima riga.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Questo è solo l’inizio con Athena. Puoi continuare a scrivere qualsiasi query che pensi possa permetterti di sfruttare le capacità di Athena.
Come ogni altro strumento di elaborazione dati, AWS Athena richiede una serie di best practice. Queste pratiche non solo ti semplificheranno la vita, ma ne miglioreranno anche le prestazioni.
Inoltre, poiché AWS è un servizio cloud e i costi per gli utenti dipendono da vari fattori di storage e calcolo, queste pratiche possono portare a un notevole risparmio!
Alcuni formati di dati sono più comodi da usare in AWS Athena. Poiché Athena legge da un bucket S3, scegliere un formato facile da leggere e compresso migliorerà prestazioni e costi.
I dati grezzi in CSV possono essere i più semplici, ma sono inefficienti. Archiviare i dati in un formato compresso come Parquet o ORC ridurrà i costi di lettura dei dati.
Un ulteriore vantaggio di Parquet e ORC è la compressione basata su colonne. L’ottimizzatore di Athena permette di cercare solo specifiche colonne di dati invece di scorrere l’intera tabella per eseguire i calcoli.
Il partizionamento dei dati significa suddividere regolarmente un dataset in base a una chiave specifica, come la data. Ad esempio, potremmo avere partizioni giornaliere in cui i dati sono impostati per essere automaticamente divisi e archiviati per giorni.
Quando i dati sono partizionati, il motore SQL può ottimizzare meglio cercando nelle sole partizioni rilevanti. Questo comporta una riduzione diretta dei dati scansionati e quindi dei costi complessivi.
Sebbene una certa complessità sia prevista nell’analisi dei dati, ottimizzare le query può aiutare a ridurre tempi di calcolo e costi. Parte dei costi non deriva direttamente da Athena ma da altri servizi che Athena utilizza su AWS.
La componente principale del costo di Athena è la scansione ed elaborazione dei dati, ma potresti sostenere costi da S3 se salvi risultati molto grandi. Possiamo anche migliorare le prestazioni e ridurre i costi assicurandoci che le query siano ottimizzate secondo le consuete best practice SQL.
Ad esempio, tutti i seguenti punti aiutano nell’ottimizzazione:
SELECT * quando possibileLIMIT durante i test delle queryQueste best practice miglioreranno le prestazioni delle query e ridurranno i costi!
AWS Athena può connettersi ad Amazon CloudWatch per archiviare metriche sulle query. Analizzando i log delle prestazioni delle query possiamo individuare query inefficienti o problemi.
Come detto, AWS Athena si integra con diversi altri servizi AWS, migliorando le sue capacità di catalogazione, visualizzazione, elaborazione e data warehousing.
Di seguito come Athena lavora con servizi come AWS Glue, Amazon QuickSight, AWS Lambda e Amazon Redshift.
Integrato con AWS Athena, AWS Glue funge da repository centrale dei metadati che cataloga automaticamente i dati in Amazon S3. Questa integrazione elimina la necessità di definizioni manuali degli schemi, semplificando le query in Athena.
Glue offre anche funzionalità ETL, trasformando e preparando i dati per query ottimali in Athena automatizzando attività come compressione, partizionamento e conversione di formato, garantendo un’elaborazione efficiente ed efficace.
Amazon QuickSight si integra con AWS Athena per trasformare i risultati delle query in dashboard e report interattivi. Questa connessione ti permette di visualizzare i dati direttamente dalle query di Athena, creando rapidamente insight visivi.
QuickSight supporta funzionalità come aggiornamenti automatici dei dati e analytics avanzati, rendendolo uno strumento potente per esplorare e presentare i dati.
AWS Lambda automatizza i flussi di elaborazione dati con Athena in un ambiente serverless. Le funzioni Lambda possono attivare query Athena in risposta a eventi, come l’arrivo di nuovi dati in S3, abilitando l’elaborazione in tempo reale.
Lambda può anche automatizzare azioni successive in base ai risultati delle query, creando workflow scalabili e guidati dagli eventi senza intervento manuale.
Mentre Athena è ideale per interrogazioni ad hoc su dati in S3, Amazon Redshift offre una soluzione robusta, strutturata e adatta ad analytics complessi. Puoi usare Athena per analisi rapide di dati grezzi e Redshift per query più intensive e ad alte prestazioni.
L’integrazione consente il movimento dei dati tra S3 e Redshift, sfruttando i punti di forza di entrambi per una soluzione di analytics completa.
AWS Athena è un potente motore di query integrato nell’ecosistema AWS. Consentendo di accedere rapidamente ai dati archiviati nei bucket S3 e salvando i risultati delle query negli stessi bucket, AWS Athena offre grande flessibilità nell’esplorazione dei dati. Sfrutta i vantaggi degli altri servizi AWS, come essere serverless, scalabile e semplice.
Se vuoi saperne di più su AWS, DataCamp offre diverse risorse:
Approfondisci AWS e il data engineering con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



