Khóa học
Introduction to Data Engineering
4 giờ
130.1K
Khi xử lý lượng lớn dữ liệu có cấu trúc và bán cấu trúc từ nhiều nguồn, chúng ta nghĩ đến một kho lưu trữ tập trung để chứa chúng. Quan điểm về kho dữ liệu liên tục thay đổi, và các giải pháp dựa trên đám mây mang lại hiệu năng, tính linh hoạt và khả năng mở rộng vượt trội. Google BigQuery và Amazon Redshift là những giải pháp hàng đầu trong lĩnh vực này.
Các kho dữ liệu trên đám mây này cung cấp khả năng xử lý dữ liệu, phân tích và lưu trữ mạnh mẽ, giúp các chuyên gia dữ liệu quản lý dữ liệu hiệu quả hơn.
Trong bài viết này, tôi sẽ so sánh kỹ lưỡng hai nền tảng, bao gồm tính năng, lợi ích, nhược điểm và thực tiễn tốt nhất. Hãy đi vào chi tiết để giúp bạn xác định lựa chọn phù hợp nhất với yêu cầu của mình!
Google BigQuery là kho dữ liệu được quản lý hoàn toàn, không máy chủ (serverless) do Google Cloud Platform (GCP) cung cấp. BigQuery được thiết kế để xử lý bộ dữ liệu khổng lồ, cho phép phân tích thời gian thực và hỗ trợ quy trình machine learning với yêu cầu quản trị hạ tầng tối thiểu. Kiến trúc serverless cho phép bạn dùng truy vấn SQL để phân tích dữ liệu.
BigQuery trình bày dữ liệu theo bảng, hàng và cột, hỗ trợ ngữ nghĩa giao dịch của cơ sở dữ liệu (ACID). Lưu trữ của BigQuery được tự động sao chép trên nhiều vị trí để đảm bảo tính sẵn sàng cao.
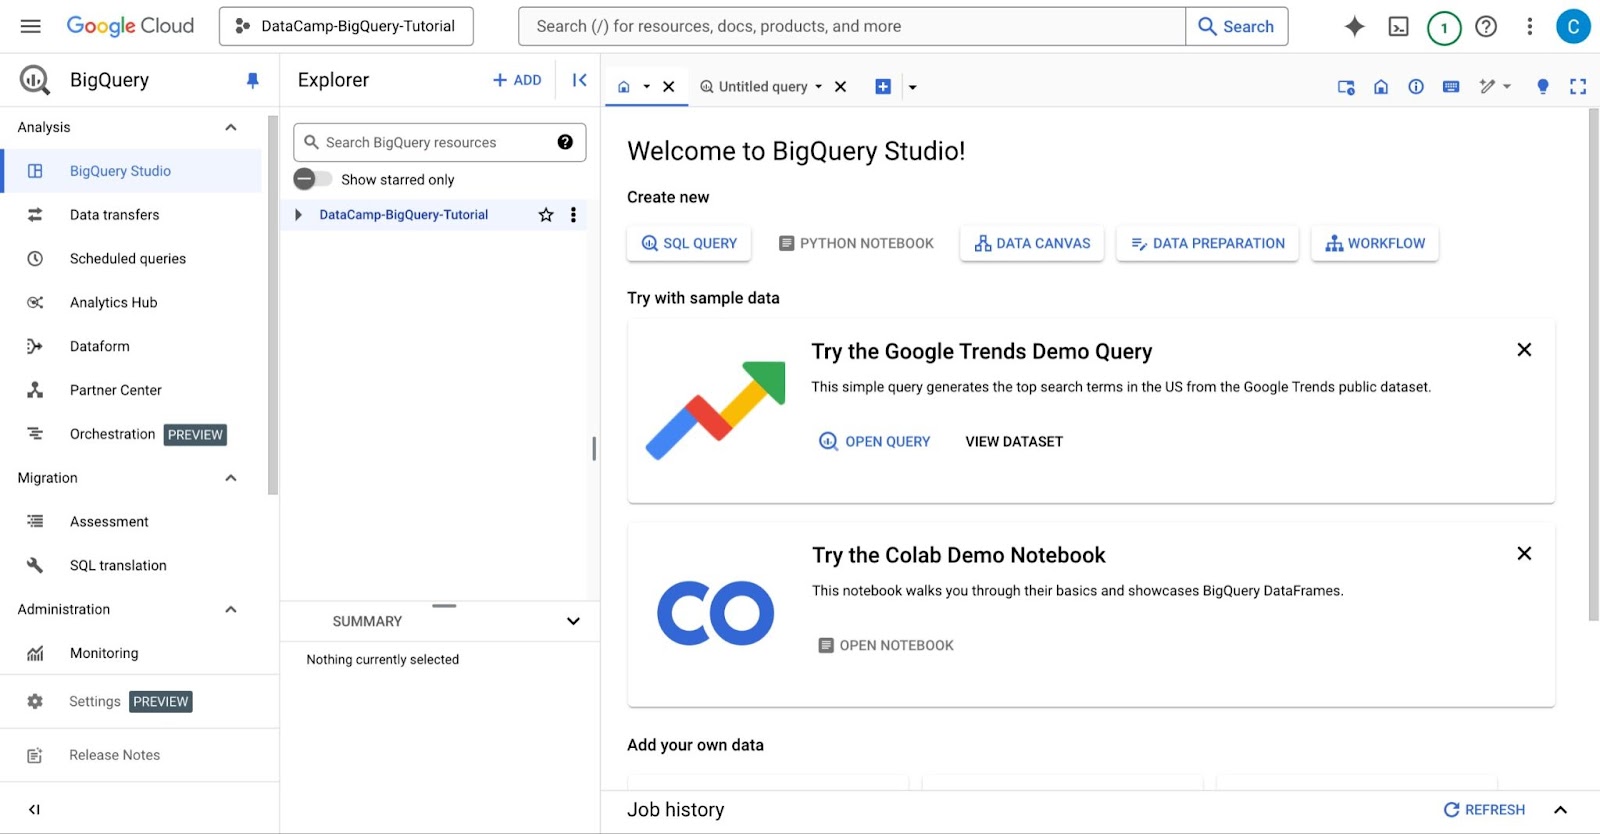
Giao diện GCP: Giao diện chính của bảng điều khiển BigQuery.
Các tính năng cốt lõi của BigQuery:
Trường hợp sử dụng BigQuery:
Amazon Redshift là giải pháp kho dữ liệu dựa trên đám mây, là một phần của nền tảng điện toán đám mây Amazon Web Services (AWS). Với kiến trúc dựa trên cụm (cluster) của Redshift, người dùng có thể truy cập và phân tích các khối lượng công việc lớn, có tính dự đoán mà tự quản lý hạ tầng.
Redshift cho phép người dùng nạp dữ liệu và bắt đầu truy vấn ngay bằng Amazon Redshift query editor v2 hoặc công cụ business intelligence (BI) ưa thích. Dịch vụ mang lại tỷ lệ giá/hiệu năng tốt và các tính năng SQL quen thuộc trong một môi trường dễ dùng, không cần quản trị.
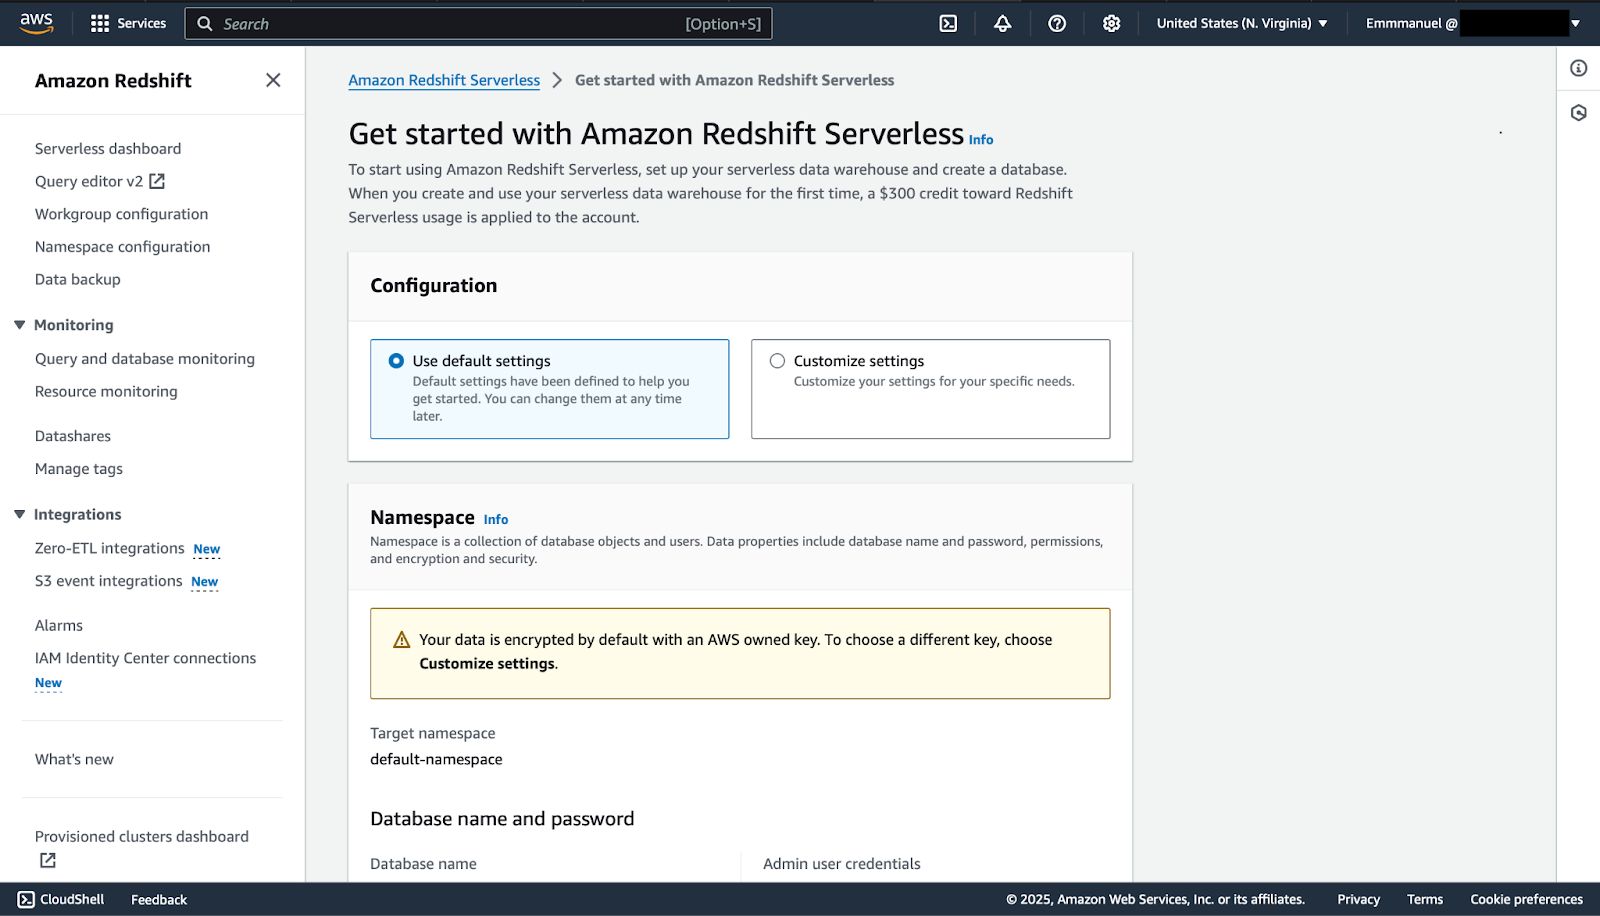
Giao diện AWS: Giao diện chính của bảng điều khiển Amazon Redshift.
Các tính năng cốt lõi của Redshift:
Trường hợp sử dụng Redshift:
Sau phần tổng quan ngắn về hai kho dữ liệu đám mây này, hãy xem xét kỹ những khác biệt của chúng ở các khía cạnh khác nhau.
Kiến trúc nền tảng phác thảo cách hệ thống vận hành. Ở đây, tôi sẽ nêu bật sự khác biệt giữa mô hình serverless với định giá theo truy vấn của BigQuery và cách tiếp cận dựa trên cụm của Redshift.
Nếu bạn ưa thích cách tiếp cận “rảnh tay” với khả năng tự động mở rộng, BigQuery là lựa chọn lý tưởng cho kho dữ liệu.
Với BigQuery, bạn không phải quản lý hạ tầng; Google xử lý mọi thứ từ cấp phát đến mở rộng. Bạn chỉ trả tiền cho truy vấn chạy và dung lượng lưu trữ sử dụng. Cách tính phí theo mức dùng này hiệu quả về chi phí và giúp bạn không phải chịu chi phí tài nguyên nhàn rỗi.
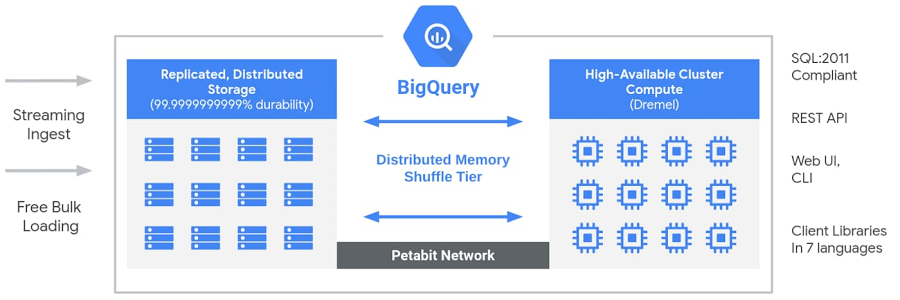
Kiến trúc BigQuery (Nguồn: Google Cloud blog).
Nếu bạn cần nhiều quyền kiểm soát hạ tầng hơn và có thể quản lý cụm của mình hiệu quả, Amazon Redshift sẽ phù hợp hơn. Redshift yêu cầu bạn thiết lập và quản lý các cụm bằng cách chọn loại phiên bản, số lượng nút và cấu hình. Điều này cho bạn quyền kiểm soát hạ tầng, nhưng theo kinh nghiệm của tôi, nó cũng làm tăng độ phức tạp.
Redshift cung cấp cả định giá đặt trước và theo nhu cầu. Với phiên bản đặt trước, bạn được giảm giá và cam kết một năng lực cụ thể trong khoảng thời gian xác định (ví dụ một hoặc ba năm). Định giá theo nhu cầu cho phép bạn trả tiền theo giờ cho năng lực sử dụng, nhưng nếu quản lý không đúng cách có thể tốn kém hơn.
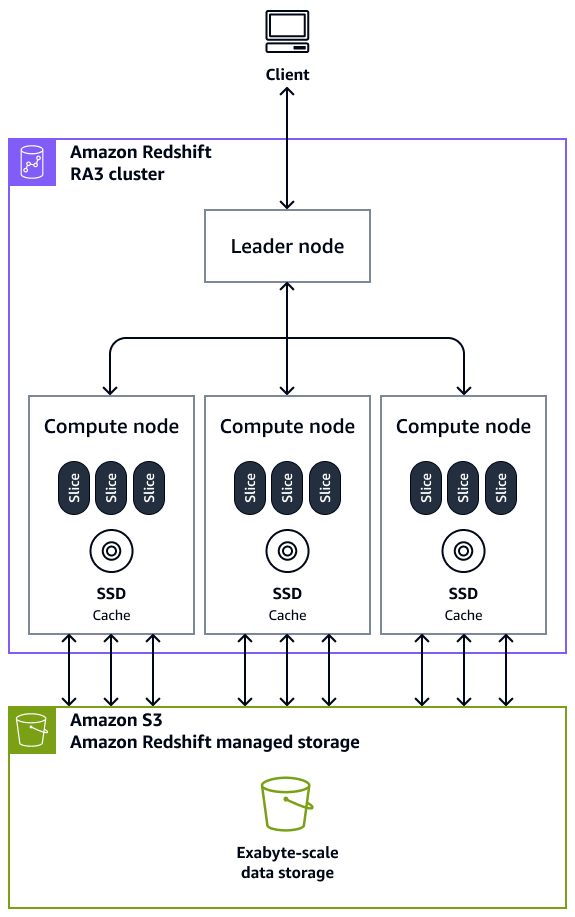
Kiến trúc Amazon Redshift (Nguồn: AWS).
Cả Google BigQuery và Amazon Redshift đều cung cấp hiệu năng ấn tượng cho các truy vấn quy mô lớn, nhưng chúng phát huy tốt nhất trong các trường hợp khác nhau. Hãy xem cách mỗi nền tảng quản lý hiệu năng cho truy vấn lớn, nêu bật hiệu năng tối ưu của BigQuery cho truy vấn ad-hoc và khả năng kiểm soát cụm của Redshift cho khối lượng công việc có thể dự đoán.
BigQuery được xây dựng để dễ dàng xử lý khối lượng công việc động nhờ kiến trúc serverless. Điều này cho phép BigQuery tự động mở rộng, mang lại hiệu năng cao cho các truy vấn ad-hoc quy mô lớn. Lưu trữ theo cột của BigQuery rất hiệu quả cho truy vấn phân tích, giảm lượng dữ liệu đọc từ đĩa, tăng tốc độ truy vấn.
Redshift có thể là lựa chọn tốt hơn nếu bạn có thể quản lý cụm để đạt hiệu năng ổn định trong môi trường có khối lượng công việc có thể dự đoán. Bạn có thể tinh chỉnh cụm để có hiệu năng truy vấn nhất quán, đảm bảo tài nguyên được tối ưu theo yêu cầu kinh doanh.
Redshift cung cấp nhiều tùy chọn tinh chỉnh hiệu năng như khóa sắp xếp (sort key) và khóa phân phối (distribution key) để tối ưu thực thi truy vấn. Tính năng này có thể mang lại hiệu năng tốt hơn cho khối lượng công việc có thể dự đoán, nhưng chỉ khi bạn thực sự nắm vững! Theo trải nghiệm của tôi, đường cong học tập có thể khá dốc.
Hiểu giá và cấu trúc chi phí là điều thiết yếu khi chọn kho dữ liệu vì chúng ta muốn chịu trách nhiệm cho từng đồng chi tiêu.
Hãy xem xét cách mô hình tính phí theo truy vấn và chi phí lưu trữ của Google BigQuery so với định giá theo cụm của Amazon Redshift với ưu đãi đặt trước:
|
Yếu tố chi phí |
BigQuery |
Redshift |
|
Gói miễn phí |
10GB miễn phí mỗi tháng |
Không có gói miễn phí, nhưng cung cấp dùng thử 2 tháng |
|
Chi phí lưu trữ |
20 USD/TB cho lưu trữ logic đang hoạt động, 10 USD cho lưu trữ dài hạn |
0,025 USD/GB mỗi tháng cho SSD, 0,08 USD/GB cho RA3 |
|
Chi phí truy vấn |
5 USD/TB cho truy vấn theo nhu cầu |
Dựa trên mức sử dụng phiên bản tính toán và lưu trữ |
|
Chi phí tính toán |
Tính phí dựa trên năng lực tính toán (theo giờ slot) |
Tính phí theo giờ (giá theo nhu cầu hoặc đặt trước) |
|
Mở rộng |
Tự động mở rộng với bộ tự động mở rộng |
Mở rộng thủ công bằng quản lý nút |
|
Chi phí sao lưu |
Tính phí cho lưu trữ dài hạn vượt ngoài gói miễn phí |
Bao gồm cho sao lưu cơ bản, tốn thêm cho snapshot bổ sung |
|
Chi phí bổ sung |
Không phát sinh cho sao lưu hoặc mở rộng |
Tính phí cho mở rộng đồng thời sau thời gian dùng thử miễn phí |
Một trong những yếu tố quan trọng nhất cần cân nhắc khi chọn kho dữ liệu là khả năng mở rộng.
Hãy xem BigQuery tự động tăng dung lượng lưu trữ và tính toán theo nhu cầu như thế nào, và cách Redshift yêu cầu mở rộng cụm thủ công, có thể mất nhiều thời gian hơn.
BigQuery là nền tảng ưu tiên khi bạn chắc chắn doanh nghiệp sẽ mở rộng cùng với khối lượng công việc và hạ tầng. Tính năng tự động mở rộng của BigQuery giúp bạn nhẹ gánh, tiết kiệm thời gian và công sức để bạn tập trung hoàn toàn vào phân tích dữ liệu.
Trong điều kiện lý tưởng, Redshift sẽ tốt hơn nếu công ty bạn có đủ kỹ sư dữ liệu. Dù Redshift đòi hỏi quản lý chủ động hơn, điều này có thể có lợi, đặc biệt nếu bạn cần kiểm soát chính xác và muốn tự quản lý tài nguyên.
Điểm trừ là việc quản lý tốn nhiều thời gian, dù nó mang lại sự chủ động. Quy trình làm việc có thể phức tạp hơn do cần lập kế hoạch, theo dõi hiệu năng và hành động khi cần mở rộng.
Cả Google BigQuery và Amazon Redshift đều mang lại lợi thế khi tích hợp trong hệ sinh thái đám mây của riêng mình.
BigQuery hoạt động trơn tru cho các đội ngũ dùng GCP và các dịch vụ như Google Compute Engine, Cloud Storage và Cloud Run; khi đó, việc dùng BigQuery để giữ các pipeline dữ liệu trong cùng một môi trường có thể hữu ích.
Sự tích hợp với bộ công cụ và dịch vụ của Google khiến BigQuery là lựa chọn ưu tiên cho kho dữ liệu nếu doanh nghiệp bạn đã dùng hệ sinh thái Google, vì mang lại quy trình liền mạch với các dịch vụ của họ.
Amazon Redshift sẽ đồng bộ tốt với các dịch vụ trong hệ sinh thái AWS. Nó có thể tích hợp với Amazon S3, AWS Lambda và AWS Glue, giúp bạn dễ dàng truy cập các dịch vụ và tài nguyên AWS khác. Theo tôi, đây là một lợi thế lớn!
Khác biệt then chốt giữa Google BigQuery và Amazon Redshift là mức độ trách nhiệm vận hành mà các dịch vụ này đặt lên khách hàng.
Vì chúng ta không cần lo quản lý hạ tầng bên dưới, Google xử lý mọi thứ từ cấp phát đến mở rộng trong BigQuery. Tính năng này giúp BigQuery nổi bật cho các doanh nghiệp có ít kỹ sư hạ tầng và muốn tránh gánh nặng vận hành.
Ngược lại, Redshift đòi hỏi nhiều hiểu biết kỹ thuật và chuyên môn hơn. Nếu đội ngũ của bạn có kỹ sư hạ tầng, việc xử lý sao lưu, mở rộng thủ công và cấp phát cụm sẽ ít gặp vấn đề. Ở cấp doanh nghiệp, điều này mang lại cho bạn quyền kiểm soát và linh hoạt với hạ tầng.
Có nhiều trường hợp và kịch bản mà Google BigQuery trở thành giải pháp kho dữ liệu ưu tiên. Hãy chọn BigQuery nếu bạn:
Vì được xây dựng trên Google Cloud Platform, BigQuery tương thích hơn với những ai đầu tư mạnh vào GCP. Giả sử bạn có phần lớn tài nguyên trong GCP như Google Compute Engine, Cloud Storage và Cloud Run. Khi đó, duy trì pipeline dữ liệu trong cùng môi trường có thể có lợi.
BigQuery là công cụ mạnh để xử lý bộ dữ liệu lớn cho truy vấn ad-hoc hoặc phân tích thời gian thực. Vì bạn không phải lo quản lý hạ tầng, các truy vấn được xử lý nhanh và hiệu quả; khối lượng công việc tự động mở rộng bất kể kích thước hay độ phức tạp dữ liệu.
Nếu đội ngũ của bạn không có đủ nguồn lực DevOps, BigQuery là lựa chọn rõ ràng. Bạn không cần bận tâm đến kỹ thuật quản lý hạ tầng; Google sẽ đảm nhiệm. Điều này giúp bạn tập trung hoàn toàn vào insight từ dữ liệu.
Có những kịch bản trong đó Amazon Redshift là lựa chọn kho dữ liệu rõ ràng. Hãy chọn Redshift nếu bạn:
Nếu tổ chức của bạn đã triển khai tài nguyên và tích hợp vào hệ sinh thái AWS, Redshift là lựa chọn tự nhiên. Amazon Redshift sẽ hoạt động với các dịch vụ AWS khác như Amazon S3, AWS Lambda và AWS Glue, giúp bạn có thể dựa hoàn toàn vào AWS cho lưu trữ, xử lý và tự động hóa dữ liệu.
Redshift tương thích với khối lượng công việc nặng đòi hỏi hiệu năng ổn định cho mẫu truy vấn có thể dự đoán và vận hành trơn tru. Vì cụm Redshift có thể tùy biến và bạn kiểm soát hạ tầng, bạn có thể tinh chỉnh Redshift để đáp ứng yêu cầu hiệu năng cụ thể.
Nếu đội ngũ của bạn xử lý quy trình ETL phức tạp với các kỹ sư dữ liệu quản lý hạ tầng, Redshift là lựa chọn phù hợp. Điều này phù hợp với các công ty có chuyên môn DevOps để xử lý khối lượng công việc nặng; bạn sẽ kiểm soát việc mở rộng, sao lưu và hiệu năng.
Giờ đây chúng ta đã xem xét một số thành phần quan trọng của cả hai công cụ, hãy điểm lại các điểm nổi bật chính. Điều này sẽ giúp bạn quyết định công cụ nào phù hợp với nhu cầu cụ thể:
|
Tính năng |
BigQuery |
Redshift |
|
Kiến trúc |
Kiến trúc serverless nghĩa là bạn không cần quản lý hạ tầng. |
Vận hành trên kiến trúc dựa trên cụm, nơi bạn cần quản lý cụm thủ công. |
|
Hiệu năng |
Có thể xử lý nhanh bộ dữ liệu lớn, đặc biệt với phân tích thời gian thực hoặc truy vấn ad-hoc. |
Nổi tiếng với hiệu năng ổn định cho mẫu truy vấn có thể dự đoán. |
|
Cấu trúc chi phí |
Dùng mô hình tính phí theo truy vấn, tức bạn trả cho lượng dữ liệu được xử lý bởi mỗi truy vấn. |
Dùng phiên bản đặt trước để được giảm chi phí, bạn trả trước cho một lượng tài nguyên tính toán cụ thể. |
|
Khả năng mở rộng |
Tự động mở rộng là một trong những điểm mạnh nhất của BigQuery. |
Cần mở rộng thủ công, vì vậy bạn phải quản lý thay đổi kích thước cụm, phân bổ tài nguyên và tinh chỉnh hiệu năng. |
|
Tích hợp hệ sinh thái |
Tích hợp sâu với các dịch vụ Google Cloud Platform (GCP), là lựa chọn hàng đầu cho đội ngũ đã làm việc trong hệ sinh thái Google. |
Tích hợp liền mạch với môi trường Amazon Web Services (AWS) và các dịch vụ của nó cho đội ngũ đã dùng hệ sinh thái AWS. |
|
Dễ sử dụng |
Kiến trúc serverless, được quản lý hoàn toàn của BigQuery giúp đơn giản hóa, không cần kỹ năng quản trị hạ tầng chuyên sâu. |
Redshift cần quản lý thủ công nhiều hơn. Bạn phải giám sát và quản lý cụm, mở rộng và hiệu năng. |
Bài viết này đã khám phá những so sánh chính giữa BigQuery và Redshift, hai giải pháp kho dữ liệu đám mây với điểm mạnh và đánh đổi riêng. Lựa chọn tốt nhất phụ thuộc vào nhu cầu của bạn, bao gồm khối lượng dữ liệu, mẫu truy vấn và ngân sách.
Nếu bạn muốn tìm hiểu sâu hơn về các nền tảng này, hãy xem Introduction to Redshift và Introduction to BigQuery trên DataCamp. Các khóa học thực hành này sẽ giúp bạn nắm vững nền tảng của từng công cụ và có kỹ năng thực tế để làm việc hiệu quả với các kho dữ liệu hiện đại.
Tìm hiểu thêm về kỹ thuật dữ liệu và công nghệ đám mây với các khóa học sau!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
