Cursus
Ingénieur de données en Python
40 h
Se lancer en ingénierie des données n’est pas simple. En présentiel comme en ligne, vous maîtrisez les fondamentaux de Python et de SQL. Vous découvrez parfois quelques frameworks et des outils comme Airflow, Databricks et Snowflake.
Écrire du code qui fonctionne, c’est une chose. Écrire des tests pour ce code et le déployer en production dans un contexte d’entreprise, c’en est une autre. Heureusement, l’ingénierie logicielle a débroussaillé le terrain, et l’ingénierie des données rattrape son retard.
Comment y parvient-on, vous demandez-vous ? Avec le CI/CD. Comment s’assurer qu’un code tournera « dans la nature » ? Comment vérifier qu’il n’est pas cassé ? Comment expédier le code final en production une fois validé ? Dans cet article, nous explorons le CI/CD en ingénierie des données. Nous proposons aussi un guide dédié au CI/CD pour le machine learning.
CI/CD signifie intégration continue et livraison/déploiement continus. Pour l’instant, cela ne vous dit peut-être pas grand-chose ; détaillons.
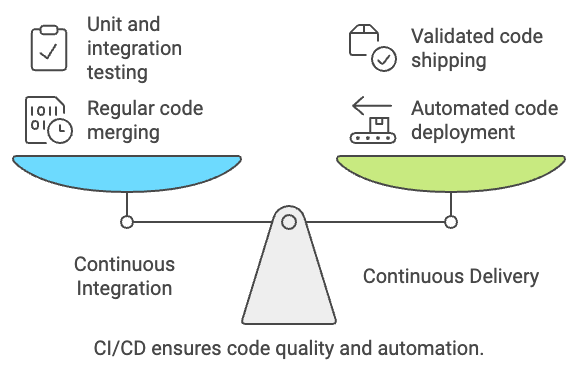
L’intégration continue consiste à fusionner régulièrement les modifications de code dans un dépôt central. Par exemple, vous avez apporté avec succès un changement à une fonction Python dans le code de pipeline de données de votre équipe. L’intégration continue stipule que ce code doit ensuite être rapatrié dans le dépôt central.
Mais cela ne s’arrête pas là. Ce code doit être suivi avec un outil de gestion de versions (comme git) et testé via des tests unitaires et d’intégration à chaque modification. L’objectif est double : rendre les derniers changements disponibles pour tous et vérifier que la modification fonctionne bien comme prévu.
Une fois votre code fusionné et testé, comment arrive-t-il en production ? C’est là qu’intervient le CD. CD signifie livraison/déploiement continus (nous parlerons ici de livraison continue) et désigne la mise en production automatisée des modifications de code.
Certains estiment que les tests unitaires et d’intégration font partie du déploiement continu, mais dans tous les cas, seul du code validé sera envoyé en production
Créé avec Napkin.AI
En résumé, le CI/CD est le processus de bout en bout qui garantit le bon fonctionnement du code (intégration continue) avant son expédition en production (livraison continue), de manière automatisée. Pour le mettre en place, nous utiliserons des pipelines CI/CD, que nous allons détailler.
Les bonnes pratiques en ingénierie des données convergent vers les repères établis par l’ingénierie logicielle. Des tâches comme le développement et l’exécution de tests unitaires, ou la maintenance d’un environnement de test/QA dédié, ne sont plus l’apanage de nos collègues du logiciel. Le CI/CD en fait partie.
Les cas d’usage du CI/CD ne manquent pas dans une stack d’ingénierie des données. En voici quelques exemples courants :
Intégrer le CI/CD au cycle de développement « ingénierie des données » présente de nombreux atouts : gouvernance de la qualité du code livré en production et réduction des efforts manuels de mise en production, entre autres.
Le CI/CD apporte aussi de la visibilité sur les étapes de chaque livraison et permet de restreindre certaines actions à des personnes autorisées.
Pour mettre en œuvre le CI/CD, vous aurez besoin d’un pipeline CI/CD. Un pipeline CI/CD est une suite d’étapes exécutées pour tester (CI) et déployer (CD) du code en production après son retour dans le dépôt central. Voici à quoi cela peut ressembler.
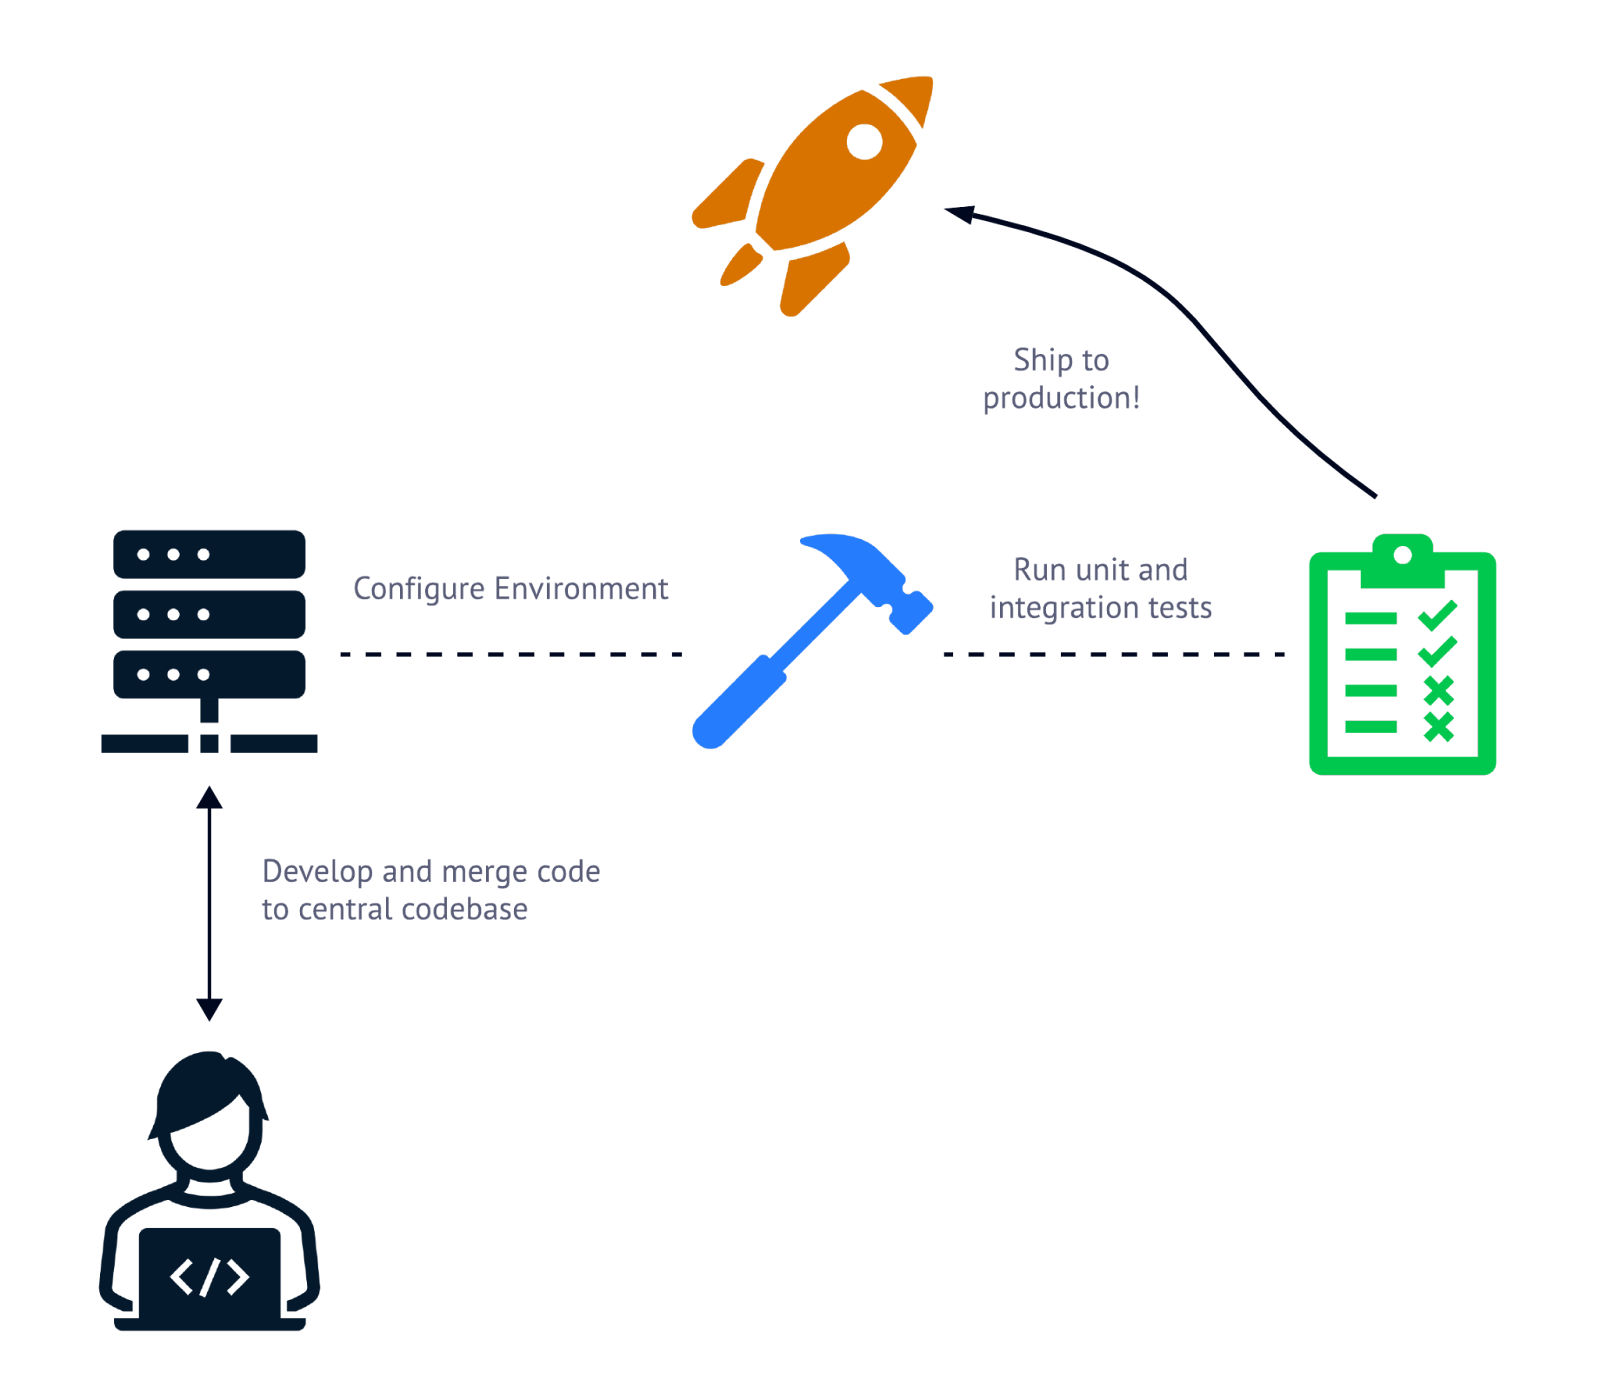
Les pipelines CI/CD regroupent généralement trois étapes : configurer l’environnement de build/déploiement, exécuter les tests, puis expédier le code en production.
On distingue en général trois types d’opérations dans un pipeline CI/CD. D’abord, il faut configurer l’environnement où le pipeline s’exécute pour tester et déployer le code : installer une CLI, récupérer des secrets et, surtout, rapatrier le code mis à jour.
Une fois l’environnement en place, le code à publier doit être testé. C’est là que les tests unitaires et d’intégration s’exécutent sur la base de code mise à jour. Après validation de tous les cas de test, le code peut être déployé en production.
Vous cherchez un outil pour exécuter vos pipelines CI/CD ? Bonne nouvelle, il y en a une multitude ! Des solutions open source aux services entièrement managés, les options ne manquent pas pour orchestrer vos processus CI/CD. Voici quelques outils parmi les plus populaires.
Quand on pense gestion de versions, on pense souvent à GitHub. GitHub est l’un des endroits les plus utilisés pour héberger du code, et donc l’un des plus attrayants pour gérer des pipelines CI/CD.
GitHub Actions est une offre CI/CD entièrement managée qui permet aux utilisateurs de GitHub de créer, exécuter et piloter leurs pipelines. Les pipelines sont définis en YAML et se déclenchent généralement lors d’actions comme un push sur une branche donnée ou la fusion d’une pull request. Utiliser GitHub Actions offre une expérience développeur unifiée et une vue centrale sur la gestion du code et des mises en production.
À l’autre bout du spectre, on trouve Jenkins. Jenkins est une solution CI/CD open source qui facilite la création et la maintenance de pipelines sur mesure et est souvent considérée comme un standard du secteur.
Jenkins se distingue par son extensibilité, avec des plugins prêts à l’emploi et la prise en charge d’une architecture distribuée. Avec Jenkins, si vous l’imaginez, vous pouvez sans doute le construire. Mais cette flexibilité a un prix : il faut administrer Jenkins lui-même.
Contrairement à GitHub Actions, Jenkins est un programme qui doit être hébergé et géré par les utilisateurs. Une équipe data devra donc configurer et maintenir le serveur Jenkins, les agents de build, les accès de sécurité, les intégrations avec le client de gestion de versions et une JVM. Cela représente une charge importante et peut ne pas convenir aux petites structures.
Pour les équipes data présentes dans le cloud, les solutions CI/CD du fournisseur sont souvent séduisantes. AWS propose CodeBuild et CodePipeline. Azure offre DevOps et Pipelines, et GCP fournit Cloud Build.
En général, les applications déjà présentes dans l’environnement cloud n’ont pas besoin de passer par des achats et ne requièrent pas d’engagement de dépenses. Ces outils sont souvent intuitifs pour des data engineers habitués au cloud et simples à prendre en main.
Lors de la configuration de votre propre workflow CI/CD, quelques bonnes pratiques permettent de fluidifier l’expérience. Première étape : le contrôle de versions.
Le contrôle de versions est le socle d’une plateforme data robuste. Les outils de versioning (comme git) permettent non seulement de tracer le code, mais aussi de maintenir une version de production. Les clients de gestion de versions (comme GitHub) peuvent ensuite déclencher un pipeline CI/CD à la survenue d’un événement donné.
Exemple de workflow : vous êtes data engineer et devez créer un workflow ETL. Vous créez une branche de fonctionnalité et y apportez vos changements. Quand vous êtes prêt à les mettre en production, vous fusionnez votre branche de fonctionnalité dans la branche main, ce qui déclenche un pipeline CI/CD déployant votre code en production.
Il n’est pas toujours possible d’ajouter de la visibilité à un pipeline CI/CD, mais quand c’est faisable, c’est important. Selon l’outil utilisé, vous pouvez découper chaque étape du pipeline en tâche distincte. Ainsi, si une tâche échoue, l’identification et la remédiation sont facilitées. Si vous utilisez GitHub Actions, séparez la configuration de l’environnement, les tests et le déploiement en trois tâches.
Tout aussi essentielle que la visibilité sur l’exécution : la documentation. Précisez comment le pipeline est déclenché, quels tests s’exécutent sur la base de code et quelle est la cible de déploiement ; cela accélère fortement le diagnostic.
Il y a de fortes chances que vous deviez utiliser un mot de passe ou une clé pour déployer votre code une fois testé. Ne stockez jamais ces informations sensibles dans la configuration du pipeline CI/CD (rien de tel pour affoler votre équipe sécurité). Utilisez plutôt les capacités de votre outil CI/CD pour stocker et référencer ces secrets comme des variables. Avec un outil comme AWS CodeBuild, les valeurs sensibles sont conservées hors de la définition du pipeline via des variables d’environnement, puis référencées en toute sécurité.
Jusqu’ici, nous avons surtout parlé d’un pipeline CI/CD qui pousse directement en production. Dans un contexte d’entreprise, le processus est différent. Plutôt que de déployer immédiatement, les data engineers publient d’abord le code dans un environnement de test dédié.
Cela leur permet de tester manuellement la solution et de vérifier qu’elle produit bien les résultats attendus. Pour ce faire, des branches test et main sont maintenues via le contrôle de versions, chacune déclenchant un job CI/CD légèrement différent selon l’événement.
Oui, le CI/CD peut être délicat. Et oui, sa configuration initiale peut prendre du temps. Mais c’est un investissement pour des mises en production gouvernées et efficaces. Prendre le temps de bâtir un pipeline CI/CD réduit l’effort manuel consacré aux tests et à l’empaquetage du code pour la production.
Comprendre et mettre en œuvre le CI/CD est l’un des moyens les plus rapides de faire progresser votre carrière ; si vous savez construire un projet en Python ou SQL, vous possédez déjà de solides fondamentaux en tant que data engineer. Mais si vous savez bâtir un workflow CI/CD avec des cas de test exécutés à chaque changement et automatiser la mise en production, vous prouvez que vous êtes prêt à concevoir des solutions de niveau entreprise.
Lancez-vous dès aujourd’hui sur la voie de l’ingénierie des données avec les parcours DataCamp Data Engineer in Python et la Data Engineer Career certification.
Les meilleurs cours DataCamp
Cursus
Cursus
Cours