Lộ trình
Kỹ sư dữ liệu trong Python
40 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleBắt đầu với kỹ thuật dữ liệu không hề dễ. Trong lớp học, và thậm chí cả các khóa học trực tuyến, bạn nắm vững những kiến thức cơ bản về viết Python và SQL. Bạn thậm chí có thể học đôi chút về các framework và công cụ như Airflow, Databricks và Snowflake.
Viết được mã chạy được là một chuyện. Viết kiểm thử cho mã đó và đưa nó vào sản xuất, nơi nó chạy trong môi trường doanh nghiệp, lại là chuyện khác. May mắn là kỹ thuật phần mềm đã giải quyết được điều này, và kỹ thuật dữ liệu đang dần bắt kịp.
Bạn có thể hỏi: Họ làm điều này như thế nào? CI/CD. Làm sao chúng ta biết mã sẽ chạy ổn ngoài “thực địa”? Làm sao biết nó không bị hỏng? Làm sao chuyển mã cuối cùng vào môi trường sản xuất sau khi đã được phê duyệt? Trong bài viết này, chúng tôi khám phá CI/CD trong kỹ thuật dữ liệu. Chúng tôi cũng có một hướng dẫn riêng về CI/CD trong học máy.
CI/CD là viết tắt của continuous integration (tích hợp liên tục), continuous delivery/deployment (phân phối/triển khai liên tục). Ngay lúc này, có thể điều đó chưa nói lên nhiều điều; hãy cùng phân tích kỹ hơn.
Tích hợp liên tục là quy trình thường xuyên hợp nhất các thay đổi mã vào một kho trung tâm. Ví dụ, giả sử bạn đã thay đổi thành công một hàm Python trong codebase đường ống dữ liệu của nhóm kỹ thuật. Tích hợp liên tục cho rằng đoạn mã này sau đó cần được đưa trở lại kho trung tâm.
Nhưng còn nhiều điều ẩn sau đó. Mã này cần được theo dõi bằng một công cụ quản lý phiên bản (chẳng hạn như git) và được kiểm thử bằng unit test và integration test mỗi khi có thay đổi mới. Điều này cho phép hai việc: thứ nhất, đảm bảo các thay đổi mới nhất của codebase có sẵn cho tất cả người dùng khác; thứ hai, xác thực rằng thay đổi mã thực sự hoạt động như mong đợi.
Sau khi bạn đã hợp nhất mã trở lại codebase trung tâm và kiểm thử xong, làm sao nó lên được sản xuất? Đó là nơi CD xuất hiện. CD là viết tắt của continuous delivery/deployment (chúng ta sẽ dùng phân phối liên tục), và là thực hành triển khai các thay đổi mã theo cách tự động hóa.
Một số người có thể cho rằng unit test và integration test là một phần của triển khai liên tục, nhưng dù thế nào, chỉ những mã đã được xác thực mới được chuyển vào sản xuất
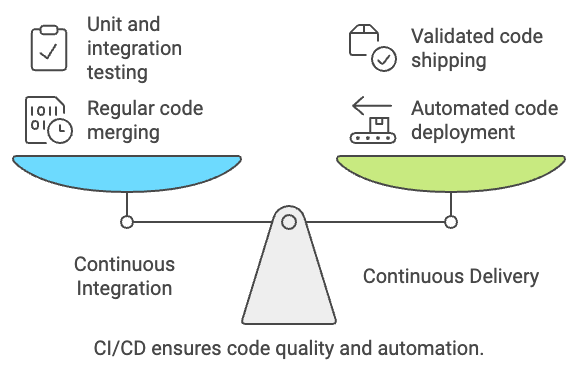
Tạo bằng Napkin.AI
Tóm lại, CI/CD là quy trình đầu-cuối để đảm bảo mã hoạt động (tích hợp liên tục) trước khi đưa vào sản xuất (phân phối liên tục) theo cách tự động hóa. Để triển khai CI/CD, chúng ta sẽ cần dùng các pipeline CI/CD, phần tiếp theo sẽ tìm hiểu kỹ hơn.
Các thực tiễn tốt trong kỹ thuật dữ liệu đang tiến gần hơn với những chuẩn mực đã được thiết lập bởi kỹ thuật phần mềm. Các tác vụ như phát triển và chạy unit test, duy trì môi trường kiểm thử/QA chuyên biệt không còn chỉ thuộc về các đồng nghiệp kỹ sư phần mềm. Điều này bao gồm cả CI/CD.
Bạn không cần tìm đâu xa để thấy các trường hợp sử dụng CI/CD trong ngăn xếp kỹ thuật dữ liệu. Dưới đây là một vài trường hợp phổ biến:
Thêm CI/CD vào vòng đời phát triển “kỹ thuật dữ liệu” mang lại rất nhiều lợi ích, bao gồm quản trị chất lượng mã đưa vào sản xuất và giảm công sức thủ công khi phát hành các thay đổi này.
CI/CD cũng mang lại một lớp khả năng quan sát các bước trong mỗi lần phát hành và có thể giới hạn quyền thực hiện một số hành động cho một nhóm cá nhân nhất định.
Để thực hiện CI/CD, bạn sẽ cần dùng một pipeline CI/CD. Pipeline CI/CD là một chuỗi bước được thực thi để kiểm thử (CI) và triển khai (CD) mã vào sản xuất sau khi mã đã được trả về kho trung tâm. Dưới đây là cái nhìn nhanh về một pipeline CI/CD có thể trông như thế nào.
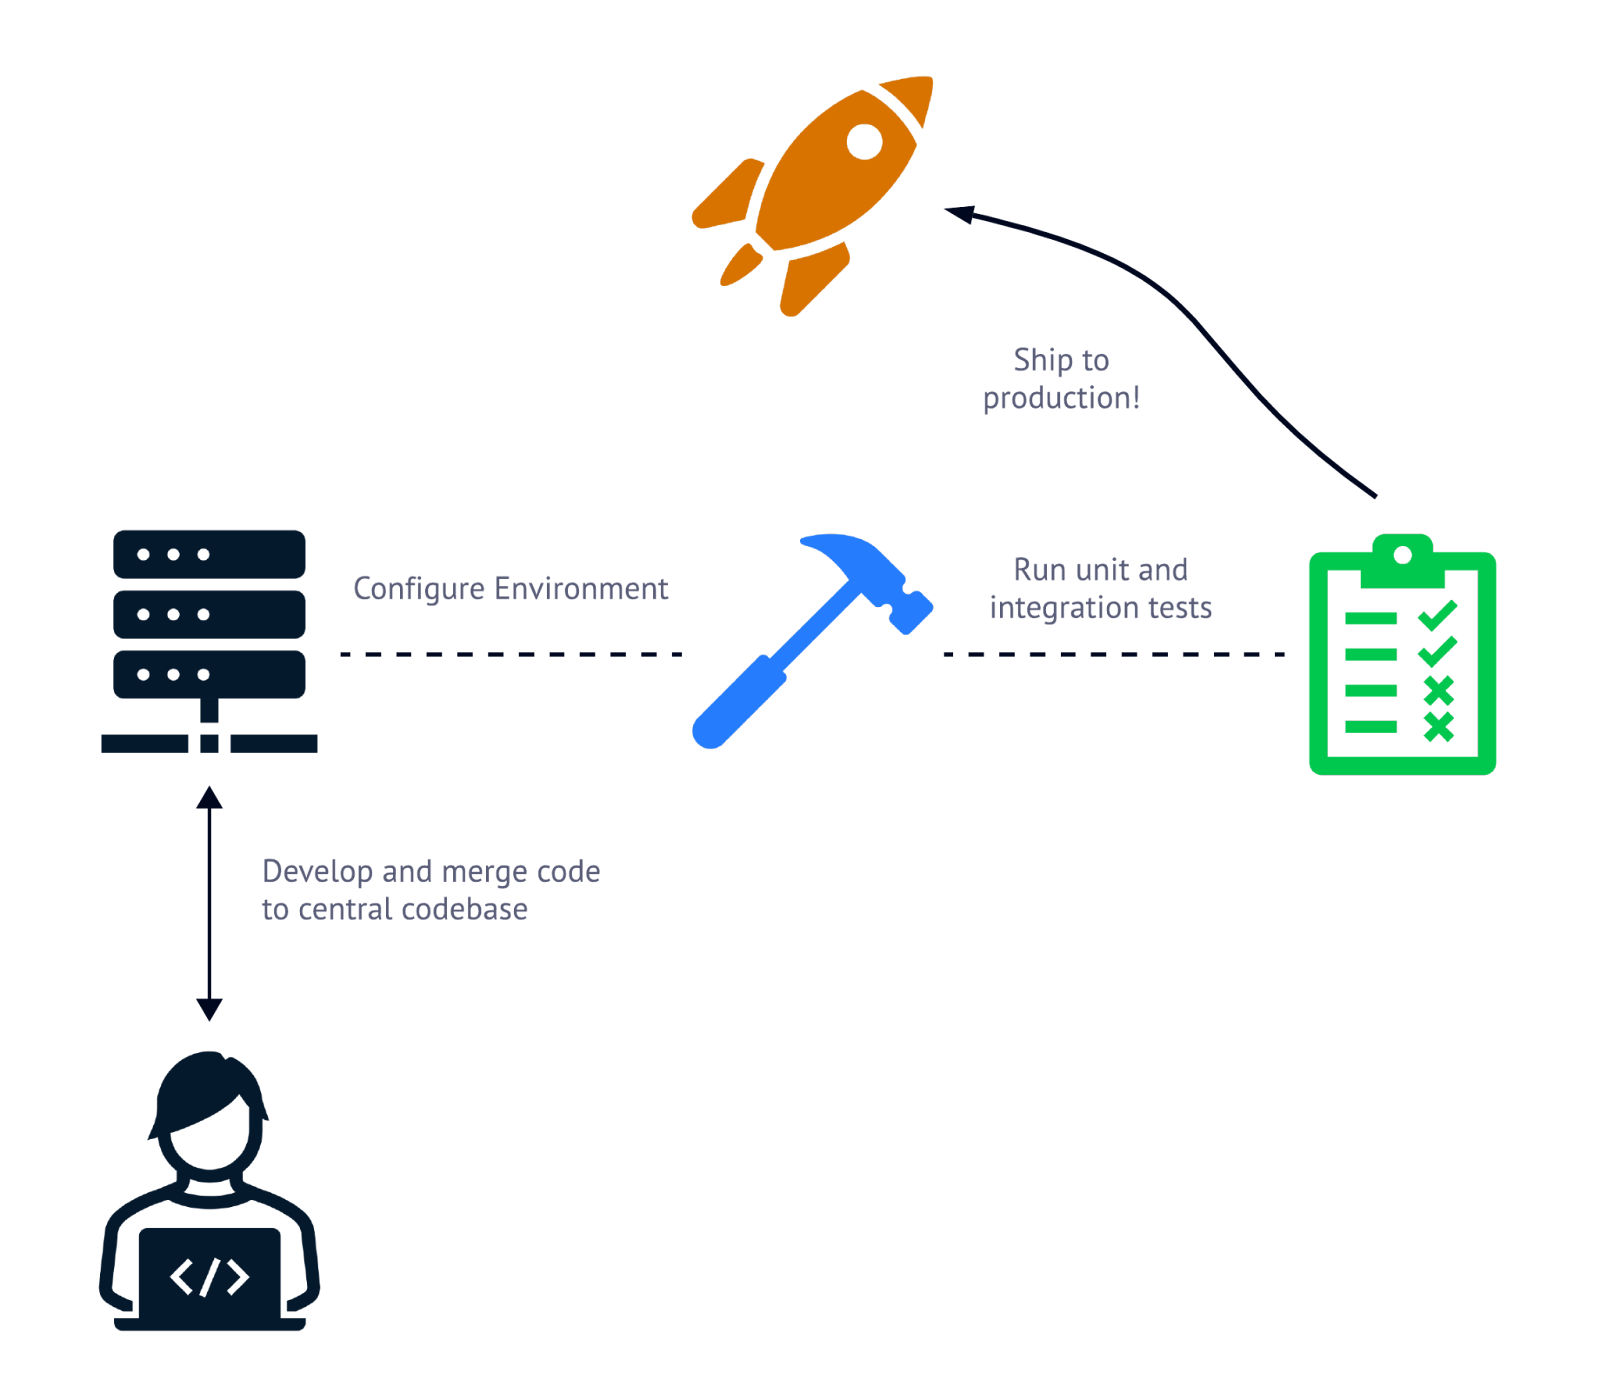
Các pipeline CI/CD thường gồm ba bước: cấu hình môi trường xây dựng/triển khai, chạy kiểm thử và đưa mã vào sản xuất.
Thông thường, có ba nhóm thao tác trong một pipeline CI/CD. Đầu tiên, cần cấu hình môi trường để kiểm thử và triển khai mã tại nơi pipeline chạy. Điều này có thể bao gồm các tác vụ như cài đặt CLI, lấy secrets và quan trọng nhất là kéo về codebase vừa được cập nhật.
Sau khi thiết lập môi trường, mã được phát hành phải được kiểm thử. Đây là lúc chạy unit test và integration test trên codebase vừa cập nhật. Sau khi vượt qua từng trường hợp kiểm thử, mã cập nhật có thể được triển khai vào sản xuất.
Tìm công cụ để chạy pipeline CI/CD của bạn? May mắn là có rất nhiều! Từ các lựa chọn mã nguồn mở đến dịch vụ quản lý hoàn toàn, không thiếu các phương án để điều phối quy trình CI/CD. Sau đây là một vài công cụ CI/CD phổ biến nhất hiện nay.
Khi nghĩ về quản lý phiên bản, có lẽ bạn sẽ nghĩ đến GitHub. GitHub là một trong những nơi phổ biến nhất để lưu trữ mã, và vì lý do đó, cũng là nơi hấp dẫn để quản lý các pipeline CI/CD.
GitHub Actions là một dịch vụ CI/CD được quản lý hoàn toàn, cho phép người dùng GitHub xây dựng, chạy và quản lý các pipeline CI/CD của họ. Pipeline được định nghĩa bằng các tệp YAML, thường được kích hoạt bởi một hành động như đẩy mã lên một nhánh nhất định hoặc hợp nhất pull request. Sử dụng GitHub Actions mang lại trải nghiệm nhà phát triển thống nhất và một “bảng điều khiển” tập trung cho cả quản lý phiên bản lẫn quản lý phát hành.
Ở đầu bên kia của phổ là Jenkins. Jenkins là một giải pháp CI/CD mã nguồn mở giúp dễ dàng xây dựng và duy trì các pipeline tùy chỉnh, và thường được xem là tiêu chuẩn ngành cho CI/CD.
Jenkins còn có lớp khả năng mở rộng bổ sung, bao gồm plugin dựng sẵn và hỗ trợ kiến trúc phân tán. Với Jenkins, nếu bạn có thể hình dung, rất có thể bạn có thể xây dựng được. Nhưng đi kèm với sự tùy biến này là trách nhiệm, bao gồm một mức độ quản trị nhất định đối với chính Jenkins.
Khác với GitHub Actions, Jenkins là một chương trình cần được người dùng tự lưu trữ và quản lý. Để làm điều này, nhóm kỹ thuật dữ liệu cần cấu hình và quản lý các yếu tố như máy chủ Jenkins, build agent, quyền truy cập bảo mật, tích hợp với client quản lý phiên bản và môi trường chạy Java. Điều này đồng nghĩa với chi phí quản trị đáng kể và có thể không phù hợp với các nhóm nhỏ.
Đối với các nhóm kỹ thuật dữ liệu đang sử dụng đám mây, dùng giải pháp CI/CD từ nhà cung cấp đám mây của họ thường rất hấp dẫn. AWS cung cấp các công cụ như CodeBuild và CodePipeline. Azure hỗ trợ DevOps và Pipelines, còn GCP cung cấp Cloud Build.
Thông thường, các ứng dụng trong môi trường đám mây hiện có không cần qua quy trình mua sắm và không yêu cầu cam kết chi tiêu. Những công cụ này thường trực quan với các kỹ sư dữ liệu vốn quen làm việc trên đám mây và dễ bắt đầu.
Khi cấu hình quy trình CI/CD của riêng bạn, có một vài thực tiễn tốt giúp trải nghiệm trở nên trơn tru. Đầu tiên là quản lý phiên bản.
Theo dõi mã của bạn bằng quản lý phiên bản là bước đầu tiên để xây dựng một nền tảng dữ liệu vững chắc. Công cụ quản lý phiên bản (như git) không chỉ cho phép theo dõi mã mà còn duy trì một phiên bản sản xuất của mã. Ứng dụng khách quản lý phiên bản (như GitHub) sau đó có thể được dùng để kích hoạt pipeline CI/CD khi một sự kiện nhất định xảy ra.
Ví dụ một quy trình: bạn là kỹ sư dữ liệu được giao tạo một workflow ETL mới. Để làm điều này, bạn checkout một nhánh tính năng và thực hiện thay đổi trên nhánh đó. Khi sẵn sàng đẩy các thay đổi này vào sản xuất, bạn sẽ hợp nhất nhánh tính năng vào nhánh main, từ đó kích hoạt pipeline CI/CD để triển khai mã của bạn vào sản xuất.
Không phải lúc nào cũng có thể tăng khả năng quan sát cho một pipeline CI/CD, nhưng khi có thể, điều đó rất quan trọng. Tùy theo công cụ CI/CD bạn đang dùng, bạn có thể tách mỗi bước trong pipeline thành một tác vụ riêng. Khi một tác vụ thất bại, sẽ dễ xác định và bắt đầu khắc phục. Nếu bạn dùng GitHub Actions để chạy pipeline CI/CD, hãy thử tách cấu hình môi trường, kiểm thử và triển khai thành ba tác vụ khác nhau.
Tài liệu cũng quan trọng không kém khả năng quan sát quá trình thực thi pipeline. Ghi chú về cách pipeline được kích hoạt, các kiểm thử chạy trên codebase và đích triển khai sẽ giúp khởi động nhanh quá trình xử lý sự cố
Nhiều khả năng bạn sẽ cần dùng một loại mật khẩu hoặc khóa nào đó để triển khai codebase sau khi đã kiểm thử. Điều quan trọng là không bao giờ lưu trữ các thông tin nhạy cảm này ngay trong cấu hình pipeline CI/CD (làm vậy sẽ khiến đội an ninh của bạn đau đầu). Thay vào đó, hãy tận dụng công cụ CI/CD để lưu trữ và tham chiếu các secrets dưới dạng biến. Với công cụ như AWS CodeBuild, các giá trị nhạy cảm có thể được lưu bên ngoài định nghĩa pipeline bằng biến môi trường và được tham chiếu an toàn.
Cho đến giờ, chúng ta mới chỉ bàn về việc dùng pipeline CI/CD để đẩy mã lên sản xuất. Tuy nhiên, quy trình phát triển cấp doanh nghiệp trông hơi khác. Thay vì đẩy thẳng lên sản xuất khi có thay đổi mã, các kỹ sư dữ liệu thường đẩy mã sang một môi trường kiểm thử chuyên dụng.
Điều này cho phép họ kiểm thử thủ công giải pháp, đảm bảo kết quả như mong đợi. Để làm vậy, cả nhánh test và main sẽ được duy trì bằng quản lý phiên bản, mỗi nhánh kích hoạt một job CI/CD hơi khác nhau khi một sự kiện xảy ra.
Đúng là CI/CD có thể phức tạp. Và đúng là ban đầu có thể mất thời gian để cấu hình. Nhưng CI/CD là khoản đầu tư giúp việc phát hành mã vào môi trường sản xuất có quản trị và hiệu quả. Dành thời gian ngay từ đầu để xây dựng pipeline CI/CD sẽ giúp giảm thời gian kiểm thử thủ công các thay đổi và đóng gói mã để đưa vào sản xuất.
Hiểu và triển khai CI/CD là một trong những cách nhanh nhất để nâng tầm sự nghiệp; nếu bạn có thể xây dựng một dự án bằng Python hoặc SQL, bạn đã phát triển vững kỹ năng nền tảng của một kỹ sư dữ liệu. Nhưng nếu bạn có thể xây dựng một quy trình CI/CD với các trường hợp kiểm thử được thực thi mỗi khi có thay đổi, và tự động đẩy lên sản xuất, bạn đã chứng tỏ mình sẵn sàng xây dựng các giải pháp cấp doanh nghiệp.
Bắt đầu con đường trở thành kỹ sư dữ liệu của bạn hôm nay với lộ trình Data Engineer in Python của DataCamp và chứng chỉ Nghề nghiệp Kỹ sư Dữ liệu.
Các khóa học hàng đầu của DataCamp
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
