Lernpfad
Dateningenieur in Python
40 Std.
Der Einstieg ins Data Engineering ist nicht einfach. In Schulungen und sogar Online-Kursen lernst du die Grundlagen in Python und SQL. Vielleicht streifst du auch erste Frameworks und Tools wie Airflow, Databricks und Snowflake.
Code zu schreiben, der funktioniert, ist das eine. Tests dafür zu schreiben und ihn in eine Produktivumgebung zu bringen, in der er im Unternehmenskontext läuft, ist etwas ganz anderes. Zum Glück hat die Softwareentwicklung dafür erprobte Methoden – und das Data Engineering zieht nach.
Wie gelingt das, fragst du dich? Mit CI/CD. Woher wissen wir, dass Code „in freier Wildbahn“ läuft? Woher wissen wir, dass nichts kaputt ist? Wie bringen wir finalen Code nach dem Review in die Produktion? In diesem Artikel schauen wir uns CI/CD im Data Engineering an. Außerdem haben wir einen separaten Leitfaden zu CI/CD im Machine Learning.
CI/CD steht für Continuous Integration und Continuous Delivery/Deployment. Das klingt erstmal abstrakt – schauen wir genauer hin.
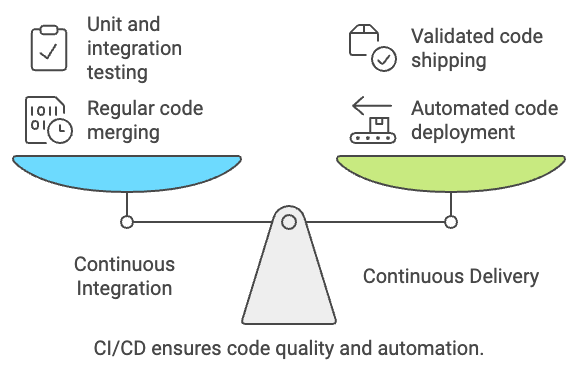
Continuous Integration ist der Prozess, Codeänderungen regelmäßig in ein zentrales Repository zusammenzuführen. Beispiel: Du hast erfolgreich eine Python-Funktion im Code deiner Data-Pipeline überarbeitet. Continuous Integration bedeutet, dass dieser Code zurück ins zentrale Repository gebracht wird.
Dabei steckt mehr dahinter: Der Code wird mit einem Versionskontrollsystem (z. B. git) nachverfolgt und bei jeder Änderung per Unit- und Integrationstests geprüft. Das hat zwei Vorteile: Erstens stehen die neuesten Änderungen allen zur Verfügung, und zweitens wird validiert, dass die Änderung wie erwartet funktioniert.
Sobald du deinen Code zurückgeführt und getestet hast, stellt sich die Frage: Wie kommt er in die Produktion? Hier kommt CD ins Spiel. CD steht für Continuous Delivery/Deployment (wir bleiben bei Continuous Delivery) und beschreibt die automatisierte Auslieferung von Codeänderungen.
Manche zählen Unit- und Integrationstests zur Continuous Deployment-Phase. Unabhängig davon gilt: Nur validierter Code wird in Produktion gebracht.
Erstellt mit Napkin.AI
Zusammengefasst ist CI/CD der End-to-End-Prozess, der sicherstellt, dass Code funktioniert (Continuous Integration), bevor er automatisiert in die Produktion gelangt (Continuous Delivery). Zur Umsetzung brauchen wir CI/CD-Pipelines – die schauen wir uns als Nächstes an.
Best Practices aus der Softwareentwicklung setzen sich zunehmend auch im Data Engineering durch. Aufgaben wie Unit-Tests, Integrationstests und eine eigene Test-/QA-Umgebung sind längst nicht mehr nur Sache der Software-Teams. Das gilt auch für CI/CD.
Use Cases für CI/CD im Data-Engineering-Stack gibt es reichlich. Hier ein paar typische Beispiele:
CI/CD im „Data-Engineering“-Lebenszyklus bringt viele Vorteile: mehr Governance über die Codequalität, die in Produktion geht, und weniger manuellen Aufwand beim Release von Änderungen.
Zudem schafft CI/CD Transparenz über die einzelnen Schritte eines Releases und ermöglicht, bestimmte Aktionen auf klar definierte Personenkreise zu beschränken.
Um CI/CD umzusetzen, brauchst du eine CI/CD-Pipeline. Eine CI/CD-Pipeline ist eine Abfolge von Schritten, die nach dem Einchecken in das zentrale Repository ausgeführt werden, um Code zu testen (CI) und in die Produktion zu deployen (CD). So könnte eine Pipeline aussehen:
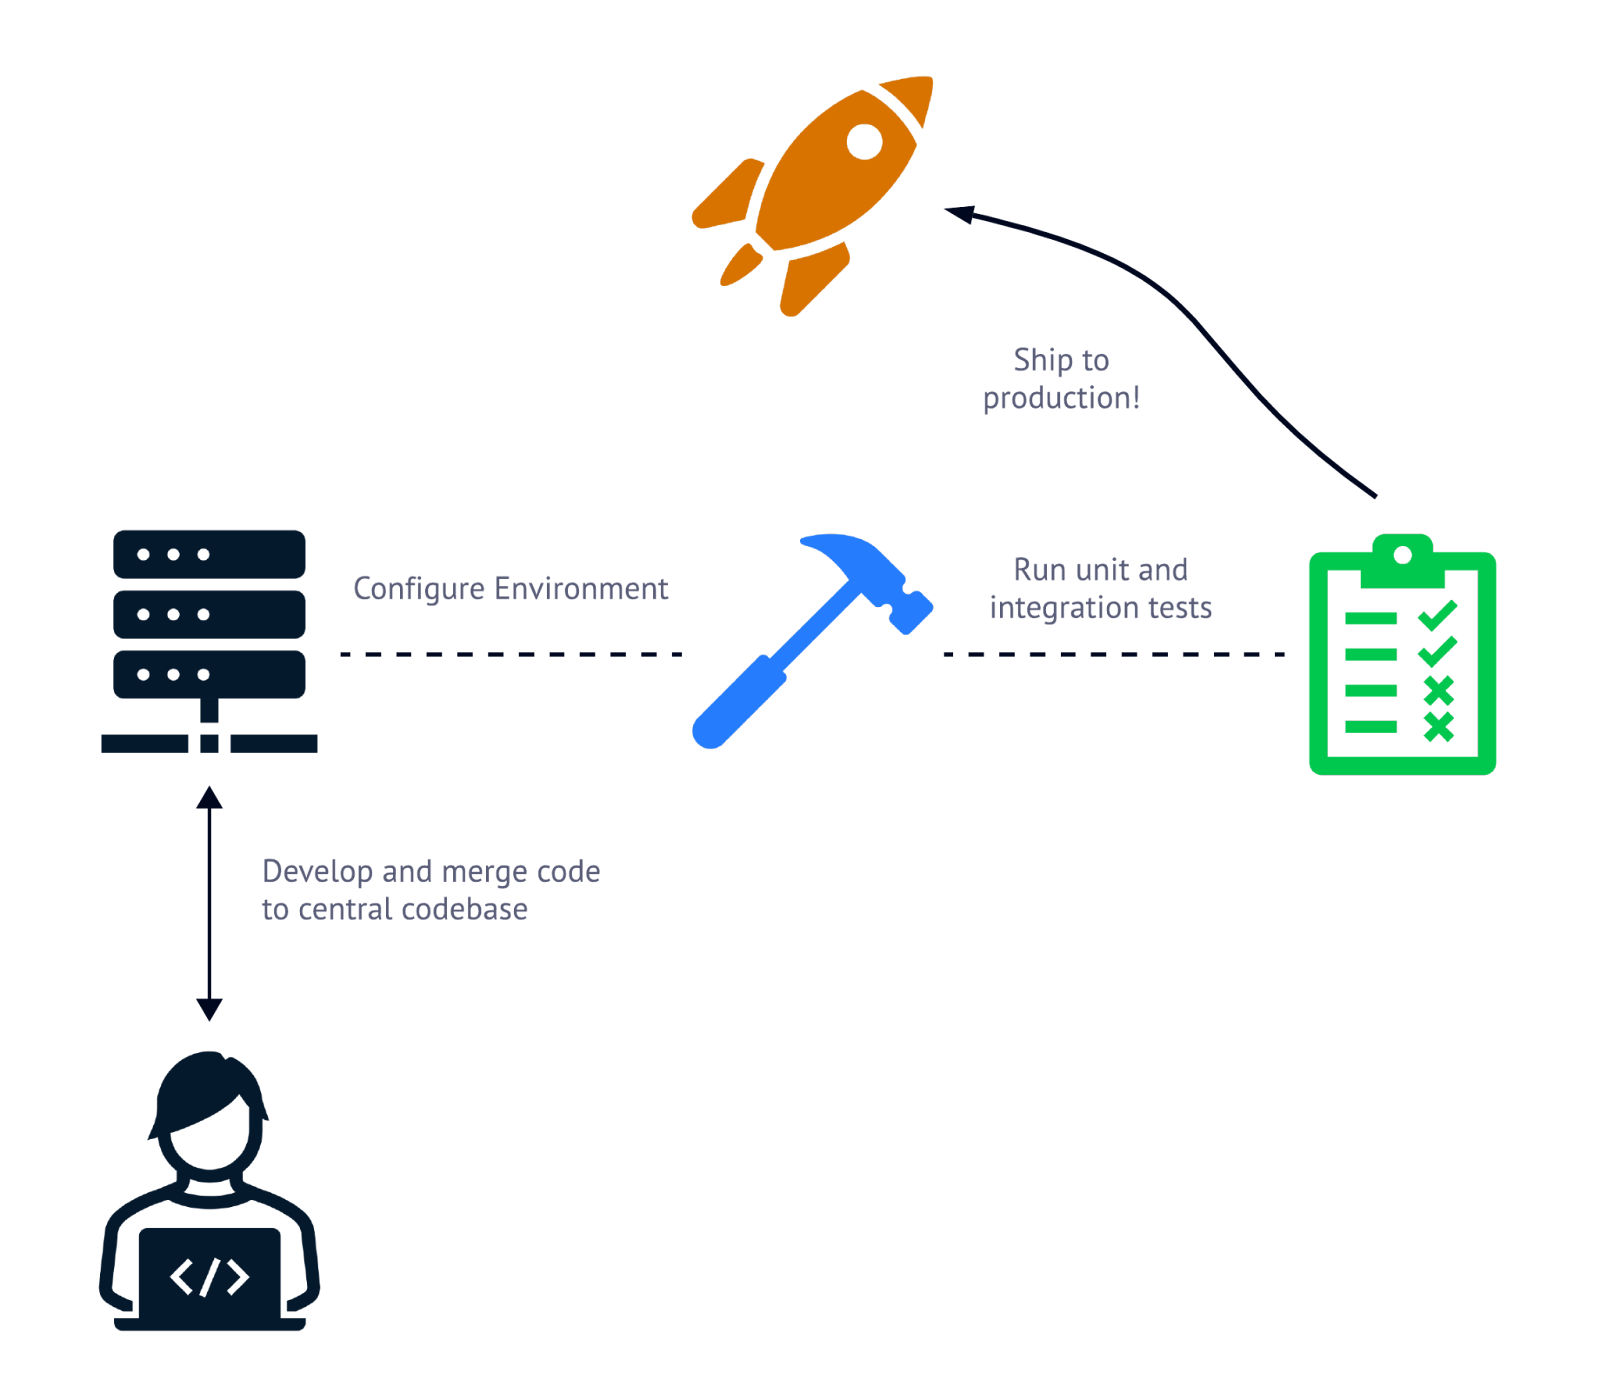
Typischerweise besteht eine CI/CD-Pipeline aus drei Schritten: Build-/Deployment-Umgebung konfigurieren, Tests ausführen und Code in Produktion bringen.
In einer CI/CD-Pipeline fallen meist drei Arten von Operationen an. Zuerst wird die Umgebung eingerichtet, in der getestet und deployed wird. Dazu zählen etwa das Installieren einer CLI, das Abrufen von Secrets und vor allem das Herunterziehen des aktualisierten Codebase-Stands.
Nach dem Setup wird der auszuliefernde Code getestet. Hier laufen Unit- und Integrationstests gegen die aktualisierte Codebasis. Bestehen alle Tests, kann der Code in Produktion deployt werden.
Du suchst ein Tool für deine CI/CD-Pipelines? Die Auswahl ist groß – von Open Source bis Fully Managed ist alles dabei. Hier sind einige der beliebtesten CI/CD-Tools.
Bei Versionskontrolle denkst du vermutlich an GitHub. GitHub ist einer der populärsten Orte für Code – und damit auch ein naheliegender Ort, um CI/CD-Pipelines zu verwalten.
GitHub Actions ist ein vollständig gemanagtes CI/CD-Angebot, mit dem GitHub-Nutzer Pipelines definieren, ausführen und steuern können. Pipelines werden in YAML beschrieben und typischerweise durch Events wie Pushes auf einen Branch oder das Mergen eines Pull Requests ausgelöst. GitHub Actions ermöglicht ein einheitliches Developer-Erlebnis und eine zentrale Sicht auf Versionskontrolle und Release-Management.
Am anderen Ende des Spektrums steht Jenkins. Jenkins ist ein Open-Source-CI/CD-Tool, mit dem sich individuelle Pipelines einfach aufbauen und pflegen lassen – und gilt vielerorts als Industriestandard.
Jenkins punktet mit hoher Erweiterbarkeit, vorgefertigten Plugins und Unterstützung für verteilte Architekturen. Mit Jenkins gilt: Was du dir ausdenkst, kannst du in der Regel auch bauen. Die Kehrseite der Flexibilität: Du musst Jenkins selbst betreiben und administrieren.
Anders als GitHub Actions ist Jenkins eine Anwendung, die von den Nutzerinnen und Nutzern selbst gehostet und gemanagt wird. Ein Data-Engineering-Team muss also Jenkins-Server, Build-Agents, Zugriffsrechte, die Anbindung an den Versionskontroll-Client und eine Java-Laufzeitumgebung einrichten und betreuen. Das verursacht spürbaren Overhead und lohnt sich für kleinere Teams oft nicht.
Für Data-Engineering-Teams mit Cloud-Footprint sind CI/CD-Lösungen des jeweiligen Cloud-Providers attraktiv. AWS bietet etwa CodeBuild und CodePipeline, Azure stellt DevOps und Pipelines bereit, GCP liefert Cloud Build.
In bestehenden Cloud-Umgebungen müssen solche Services meist nicht beschafft werden und erfordern keine vorab gebundenen Budgets. Für Dateningenieurinnen und -ingenieure, die in der Cloud arbeiten, sind diese Tools oft intuitiv und schnell startklar.
Beim Aufsetzen eines eigenen CI/CD-Workflows helfen ein paar Best Practices für einen reibungslosen Ablauf. Los geht’s mit der Versionskontrolle.
Deinen Code per Versionskontrolle zu tracken, ist der erste Schritt zu einer robusten Datenplattform. Tools wie git ermöglichen nicht nur die Nachverfolgung, sondern auch das Pflegen einer Produktionsversion des Codes. Clients wie GitHub können dann bei bestimmten Events eine CI/CD-Pipeline auslösen.
Ein Beispiel-Workflow: Du sollst als Data Engineer einen neuen ETL-Workflow entwickeln. Dafür checkst du einen Feature-Branch aus und arbeitest dort. Wenn du bereit bist, deine Änderungen in die Produktion zu bringen, mergst du den Feature-Branch in den main-Branch – das triggert die CI/CD-Pipeline und deployt deinen Code in die Produktion.
Transparenz in der CI/CD-Pipeline ist nicht immer möglich, aber wo es geht, solltest du sie schaffen. Je nach Tool kannst du jeden Schritt der Pipeline als eigene Aufgabe definieren. Scheitert eine Aufgabe, ist die Ursache schnell identifiziert und die Fehlerbehebung kann starten. Wenn du GitHub Actions nutzt, teile das Umgebungs-Setup, die Tests und das Deployment in drei getrennte Jobs auf.
Genauso wichtig wie die Transparenz bei der Ausführung ist gute Dokumentation. Notiere, wie die Pipeline getriggert wird, welche Tests laufen und wohin deployt wird – das beschleunigt die Fehlersuche.
Sehr wahrscheinlich brauchst du Passwörter oder Keys, um nach bestandenen Tests zu deployen. Diese sensiblen Daten dürfen niemals direkt in der Pipeline-Konfiguration liegen (damit treibst du das Security-Team in den Wahnsinn). Nutze stattdessen die Secret-Verwaltung deines CI/CD-Tools und referenziere sie als Variablen. In AWS CodeBuild können sensible Werte beispielsweise außerhalb der Pipeline-Definition als Umgebungsvariablen sicher gespeichert und referenziert werden.
Bisher haben wir nur darüber gesprochen, Code per Pipeline in die Produktion zu pushen. In Enterprise-Setups läuft es anders: Statt direkt in Produktion zu gehen, deployen Data Engineers typischerweise zuerst in eine eigene Testumgebung.
So lassen sich Ergebnisse manuell prüfen. Dafür werden per Versionskontrolle sowohl ein test- als auch ein main-Branch gepflegt, die jeweils bei bestimmten Events unterschiedliche CI/CD-Jobs auslösen.
Ja, CI/CD kann knifflig sein. Und ja, das initiale Setup kostet Zeit. Aber CI/CD ist eine Investition in kontrollierte und effiziente Releases in Produktionsumgebungen. Wer upfront in eine gute Pipeline investiert, spart später viel manuelle Test- und Verpackungsarbeit vor dem Go-Live.
CI/CD zu verstehen und umzusetzen, ist einer der schnellsten Wege, deine Karriere voranzubringen: Wenn du Projekte in Python oder SQL bauen kannst, hast du dir solide Grundlagen als Data Engineer erarbeitet. Wenn du zusätzlich einen CI/CD-Workflow mit automatischen Tests bei jeder Änderung und einem automatisierten Production Push aufsetzen kannst, zeigst du, dass du bereit für Enterprise-Lösungen bist.
Starte heute deinen Weg zum Data Engineer mit DataCamps Data Engineer in Python-Lernpfad und der Data Engineer Career-Zertifizierung.
Top-DataCamp-Kurse
Lernpfad
Lernpfad
Kurs