Leerpad
Data-engineer in Python
40 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleBeginnen met data-engineering is niet makkelijk. In klaslokalen en zelfs online cursussen leer je de basis van het schrijven van Python en SQL. Misschien leer je zelfs wat over frameworks en tools zoals Airflow, Databricks en Snowflake.
Het is één ding om code te schrijven die werkt. Het is iets anders om tests voor die code te schrijven en die naar productie te brengen, waar het in een enterprise-omgeving draait. Gelukkig heeft software-engineering dit al grotendeels opgelost, en data-engineering begint bij te benen.
Hoe doen ze dat, vraag je je misschien af? CI/CD. Hoe weten we dat code “in het wild” zal draaien? Hoe weten we dat het niet stuk is? Hoe brengen we de definitieve code naar productie zodra die is goedgekeurd? In dit artikel verkennen we CI/CD in data-engineering. We hebben ook een aparte gids over CI/CD in machine learning.
CI/CD staat voor continuous integration, continuous delivery/deployment. Dat zegt je nu misschien nog niet zoveel; laten we het verder toelichten.
Continuous integration is het proces waarbij codewijzigingen regelmatig worden samengevoegd in een centrale repository. Stel bijvoorbeeld dat je met succes een wijziging hebt aangebracht in een Python-functie in de codebase van de datapijplijn van je engineeringteam. Continuous integration houdt in dat die code vervolgens wordt teruggebracht naar de centrale repository.
Maar er komt meer bij kijken dan je denkt. Deze code moet worden bijgehouden met een vorm van versiebeheer (zoals git) en elke keer dat er een wijziging wordt doorgevoerd, getest worden met unit- en integratietests. Dit levert twee dingen op: ten eerste zorg je ervoor dat de meest recente wijzigingen in de codebase beschikbaar zijn voor alle andere gebruikers, en ten tweede valideer je dat de codewijziging inderdaad werkt zoals verwacht.
Zodra je je code hebt teruggesynchroniseerd met de centrale codebase en getest, hoe komt die dan in productie? Daar komt CD om de hoek kijken. CD staat voor continuous delivery/deployment (we houden het hier bij continuous delivery) en is de praktijk om wijzigingen in code geautomatiseerd te deployen.
Sommigen zullen aanvoeren dat unit- en integratietests onderdeel zijn van continuous deployment, maar hoe dan ook: alleen gevalideerde code wordt naar productie verscheept.
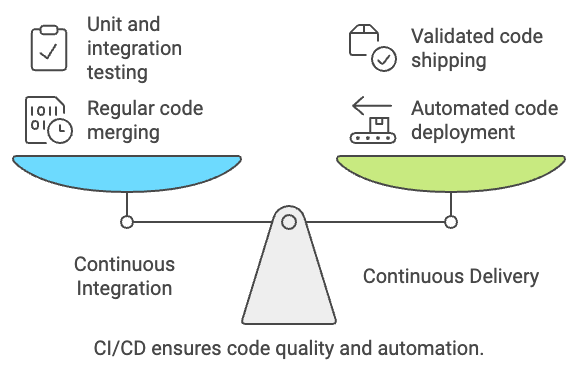
Gemaakt met Napkin.AI
Alles bij elkaar: CI/CD is het end-to-endproces om ervoor te zorgen dat code werkt (continuous integration) voordat je die geautomatiseerd naar productie brengt (continuous delivery). Om CI/CD te implementeren, hebben we CI/CD-pijplijnen nodig; daar kijken we hierna dichter naar.
Best practices in data-engineering schuiven steeds meer op richting de bakens die in software-engineering zijn gezet. Taken zoals het ontwikkelen en draaien van unit-tests en het onderhouden van een aparte test-/QA-omgeving zijn niet langer alleen voor onze collega’s in software. Dit geldt ook voor CI/CD.
Je hoeft niet lang te zoeken naar use-cases in de data-engineeringstack voor CI/CD. Hier zijn een paar veelvoorkomende voorbeelden:
CI/CD toevoegen aan een “data-engineering”-ontwikkelcyclus heeft veel voordelen, zoals governance over de kwaliteit van code die naar productie gaat en minder handmatig werk om wijzigingen te releasen.
CI/CD biedt ook meer zichtbaarheid in de stappen van elke release en kan de toegang tot bepaalde acties beperken tot een specifieke groep mensen.
Om CI/CD uit te voeren, heb je een CI/CD-pijplijn nodig. Een CI/CD-pijplijn is een reeks stappen die worden uitgevoerd om code te testen (CI) en te deployen (CD) naar productie nadat die is teruggezet in de centrale repository. Hier is een snelle blik op hoe zo’n pijplijn eruit kan zien.
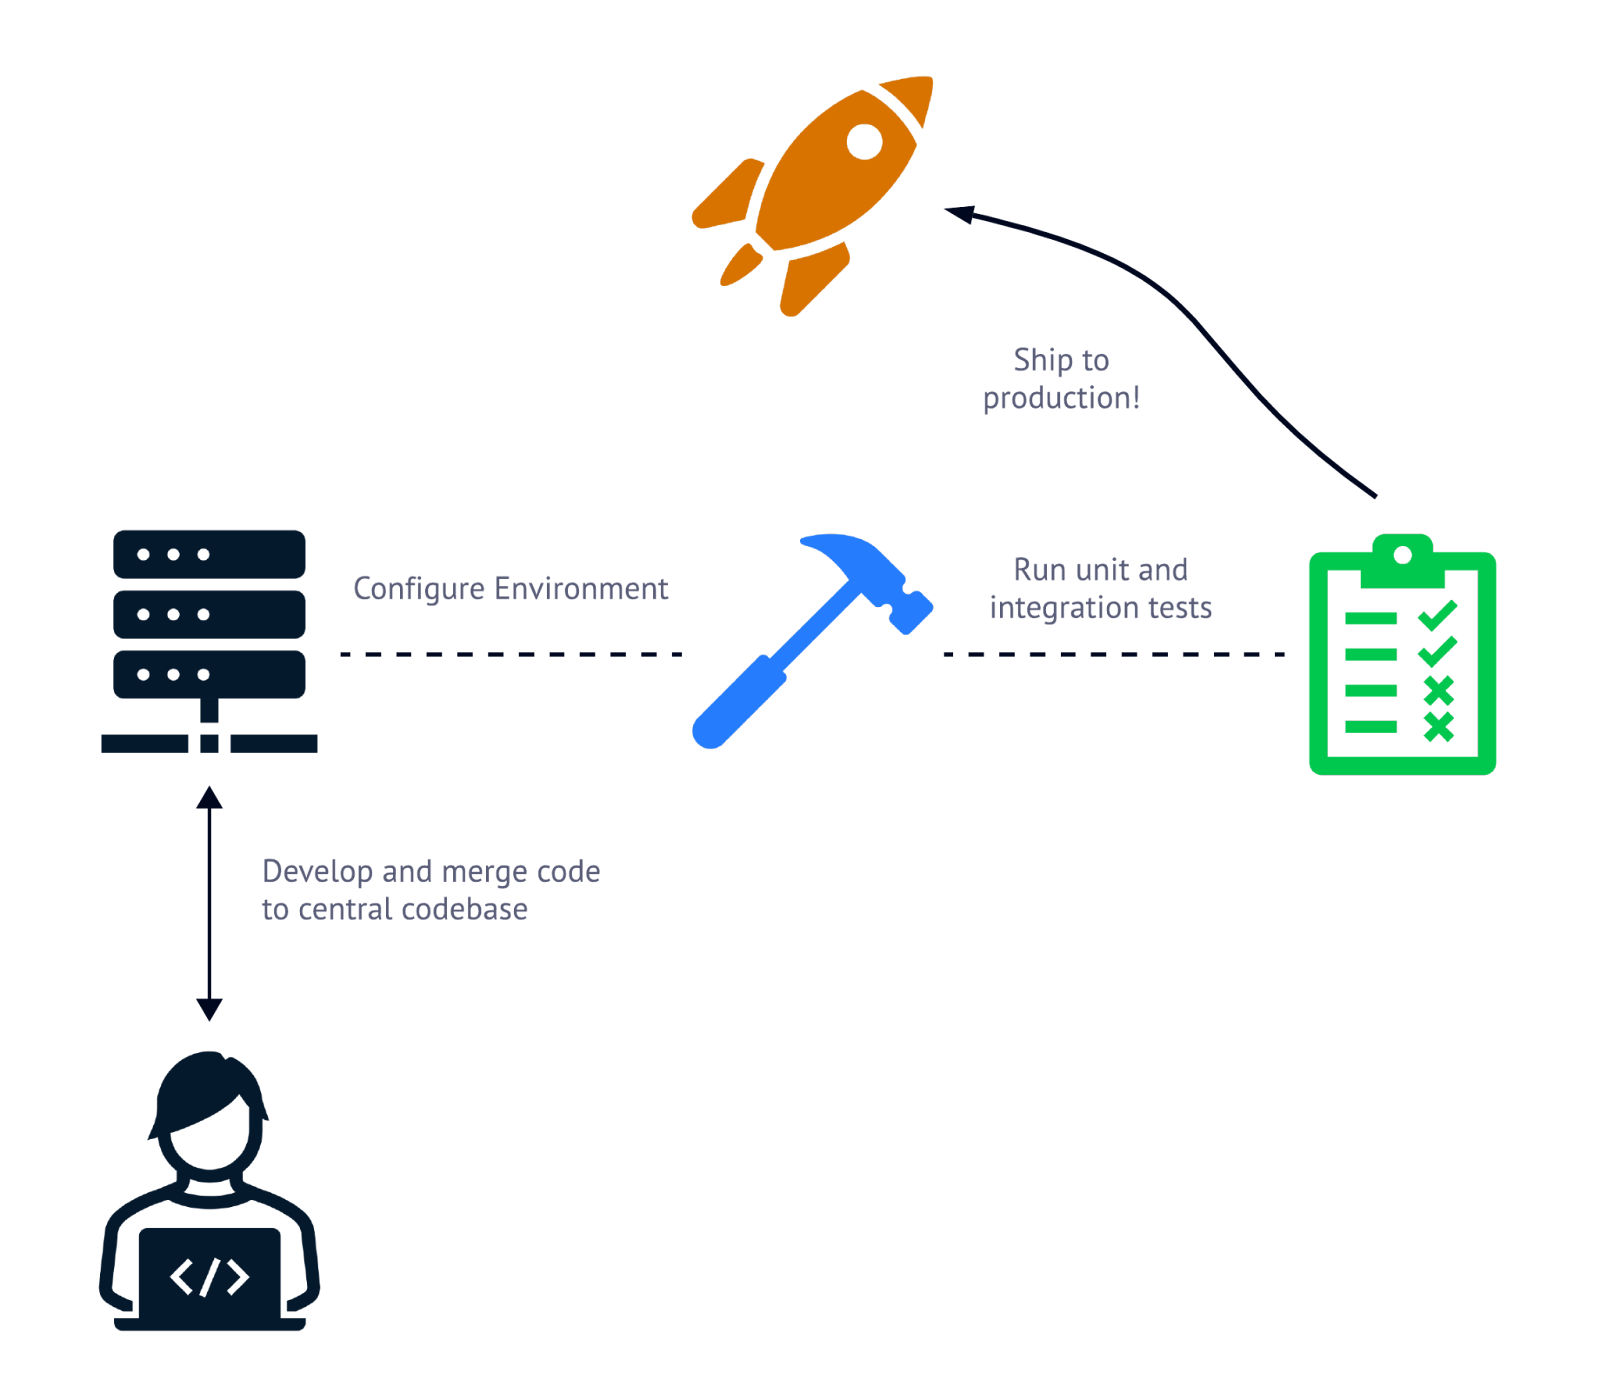
CI/CD-pijplijnen bestaan doorgaans uit drie stappen: de build-/deploymentomgeving configureren, tests uitvoeren en de code naar productie brengen.
Gewoonlijk zijn er drie soorten handelingen in een CI/CD-pijplijn. Eerst moet de omgeving worden geconfigureerd waarin de pijplijn draait om de code te testen en te deployen. Dit kan omvatten: een CLI installeren, secrets ophalen en, vooral, de nieuw bijgewerkte codebase binnenhalen.
Na het inrichten van de omgeving moet de te releasen code worden getest. Hier voer je unit- en integratietests uit op de nieuw bijgewerkte codebase. Nadat alle testcases zijn geslaagd, kan de bijgewerkte code naar productie worden gedeployed.
Op zoek naar een tool om je CI/CD-pijplijnen te draaien? Gelukkig zijn er er talloze! Van open-source tot volledig beheerde services: het aanbod om je CI/CD-processen te orkestreren is ruim. Hier zijn enkele van de populairste CI/CD-tools.
Als je aan versiebeheer denkt, denk je waarschijnlijk aan GitHub. GitHub is een van de populairste plekken om je code op te slaan, en daarom ook een van de aantrekkelijkste om je CI/CD-pijplijnen te beheren.
GitHub Actions is een volledig beheerde CI/CD-oplossing waarmee GitHub-gebruikers hun CI/CD-pijplijnen kunnen ontwikkelen, draaien en beheren. Pijplijnen worden gedefinieerd met YAML-bestanden en worden doorgaans getriggerd door een actie zoals een push naar een bepaalde branch of het mergen van een pull request. Met GitHub Actions krijg je een uniforme developer-ervaring en één centrale plek voor zowel versiebeheer als releasemanagement.
Aan de andere kant van het spectrum staat Jenkins. Jenkins is een open-source CI/CD-oplossing die het eenvoudig maakt om aangepaste pijplijnen te bouwen en te onderhouden, en wordt vaak gezien als de industriestandaard voor CI/CD.
Jenkins biedt een extra laag uitbreidbaarheid, met kant-en-klare plugins en ondersteuning voor een gedistribueerde architectuur. Met Jenkins geldt: als je het kunt bedenken, kun je het waarschijnlijk bouwen. Maar die mate van aanpasbaarheid brengt ook verantwoordelijkheid met zich mee, waaronder beheer van Jenkins zelf.
In tegenstelling tot GitHub Actions is Jenkins een programma dat door de gebruikers zelf moet worden gehost en beheerd. Een data-engineeringteam moet dan zaken configureren en beheren zoals de Jenkins-server, build agents, toegangsbeveiliging, integraties met een versiebeheerclient en een Java-runtimeomgeving. Dit betekent aanzienlijke overhead en is mogelijk niet logisch voor kleinere teams.
Voor data-engineeringteams met een cloudfootprint is het vaak aantrekkelijk om een CI/CD-oplossing van hun cloudprovider te gebruiken. AWS biedt tools zoals CodeBuild en CodePipeline. Azure ondersteunt DevOps en Pipelines, en GCP biedt Cloud Build.
Doorgaans hoeven toepassingen binnen een bestaande cloudomgeving niet door inkoopprocedures en is er geen vaste besteding nodig. Deze tools zijn vaak intuïtief voor data-engineers die gewend zijn in de cloud te werken en zijn eenvoudig om mee te beginnen.
Bij het configureren van je eigen CI/CD-workflow zijn er een paar best practices die het proces soepel maken. Om te beginnen: versiebeheer.
Je code bijhouden met versiebeheer is de eerste stap naar een robuust dataplatform. Tools voor versiebeheer (zoals git) maken niet alleen het bijhouden van code mogelijk, maar ook het onderhouden van een productieversie van de code. Versiebeheerclients (denk aan GitHub) kunnen vervolgens een CI/CD-pijplijn triggeren wanneer een bepaalde gebeurtenis plaatsvindt.
Een voorbeeldworkflow: je bent een data-engineer en moet een nieuwe ETL-workflow bouwen. Je checkt een featurebranch uit en doet je wijzigingen op die branch. Wanneer je klaar bent om deze wijzigingen naar productie te pushen, merge je je featurebranch naar de main-branch, wat vervolgens een CI/CD-pijplijn triggert die je code naar productie deployt.
Het is niet altijd mogelijk om extra zichtbaarheid toe te voegen aan een CI/CD-pijplijn, maar als het kan, is het belangrijk om dat te doen. Afhankelijk van de CI/CD-tool die je gebruikt, kun je elke stap in de pijplijn opsplitsen in een losse taak. Als zo’n taak faalt, is het dan eenvoudig te identificeren en te verhelpen. Gebruik je GitHub Actions voor je CI/CD-pijplijnen, probeer je omgevingsconfiguratie, tests en deploystappen dan op te delen in drie verschillende taken.
Net zo belangrijk als zichtbaarheid in de uitvoering van de pijplijn is documentatie. Notities toevoegen over hoe een pijplijn wordt getriggerd, welke tests tegen de codebase draaien en wat het deploymentdoel is, helpt het troubleshootproces snel op gang.
De kans is groot dat je een wachtwoord of sleutel nodig hebt om je codebase te deployen zodra die is getest. Sla deze gevoelige gegevens nooit op in de configuratie van de CI/CD-pijplijn zelf (dat is een garantie om je securityteam gek te maken). Maak in plaats daarvan gebruik van je CI/CD-tooling om deze secrets op te slaan en als variabelen te refereren. Met een tool als AWS CodeBuild kunnen gevoelige waarden buiten de pijplijndefinitie worden opgeslagen met omgevingsvariabelen, die vervolgens veilig worden aangeroepen.
Tot nu toe hebben we het alleen gehad over een CI/CD-pijplijn om code naar productie te pushen. Maar enterprise-grade ontwikkelprocessen zien er wat anders uit. In plaats van direct naar productie te pushen bij een codewijziging, pushen data-engineers doorgaans eerst naar een aparte testomgeving.
Zo kunnen ze hun oplossing handmatig testen en zeker weten dat die de verwachte resultaten oplevert. Hiervoor worden zowel een test- als een main-branch onderhouden met versiebeheer, die elk bij bepaalde events een iets andere CI/CD-job triggeren.
Ja, CI/CD kan lastig zijn. En ja, het kan even duren om het in eerste instantie te configureren. Maar CI/CD is een investering om gecontroleerde en efficiënte releases van code naar een productieomgeving mogelijk te maken. Door vooraf tijd te steken in het ontwikkelen van een CI/CD-pijplijn verminder je de tijd die je handmatig besteedt aan het testen van codewijzigingen en het verpakken van code voor productie.
CI/CD begrijpen en implementeren is een van de snelste manieren om je carrière te boosten; als je een project in Python of SQL kunt bouwen, heb je solide, fundamentele skills ontwikkeld als data-engineer. Maar als je een CI/CD-workflow kunt bouwen met testcases die elke keer bij wijzigingen draaien, en een productiepush kunt automatiseren, laat je zien dat je klaar bent om enterprise-grade oplossingen te bouwen.
Begin vandaag nog aan je pad naar data-engineer met DataCamp’s Data Engineer in Python-carrièreroute en Data Engineer Career-certificering.
Topcursussen bij DataCamp
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

